首页 文章 精选 留言 我的

精选列表

搜索[AI],共10000篇文章
优秀的个人博客,低调大师

【LLM&&AI应用开发 八股文】--4.3.Agent智能体(下)

# 9.第九步:Agent怎么评估 短期记忆、Session State、长期记忆、RAG,不是几个时髦名词。 它们本质上都在解决一个问题: **Agent 执行任务时,怎么知道自己在做什么、做到了哪一步、哪些信息还能用。** **Agent 评估不能只看最终答案,要看整个执行过程。** 这篇我们就把 Agent 怎么评估讲清楚。![](https://developer.qcloudimg.com/http-save/yehe-12791808/74d8dcff310cc681a9b6d751deb8e1e8.png) 普通大模型问答的评估逻辑很简单:用户提问→模型输出答案,仅校验答案正确性、完整性、格式即可。 但 Agent 多了大量中间执行环节,举个例子:用户要求「分析仓库启动慢,给出优化建议」,Agent 需要依次读取项目目录、定位启动入口、解析配置文件、检索初始化逻辑、查询慢日志,最后归纳原因并输出优化优先级。 整个链路每一步都容易翻车:读错目录、检索关键词出错、混淆测试 / 生产配置、工具报错后强行编造结论、仅凭单个模块就推导全局问题。 👉 Agent 评估至少要回答 4 个核心问题: 1. 最终任务完成了吗?用户原始目标是否达成 2. 中间过程靠谱吗?有无乱调用、重复调用、越权调用、无视工具失败 3. 成本和效率怎么样?同样任务是 5 步搞定,还是绕到 30 步 4. 失败时能不能收住?缺参数 / 超时 / 权限不足时,是合理追问终止,还是继续瞎猜 所以 Agent 评估**不能只看答案像不像**,结果与执行轨迹都要纳入考察✅ ## 9.1.任务完成率 任务完成率是最核心指标,代表用户交付任务的实际完成程度。 举个样本:100 条测试任务,70 个完整完成、15 个部分完成、10 个失败但能正确说明原因、5 个失败还编造结果。不能简单定义成功率 70%,「正确失败」和「错误失败」风险天差地别。 优秀 Agent 不必保证次次成功,很多场景本身就无法执行:无订单号、账号权限不足、工具超时、数据不存在、业务规则限制、文档缺失。遇到这类情况,正确做法不是硬跑,而是识别失败原因并给出后续方案。 ✅ 任务结果分为 4 档: 1. **完整完成**:完全满足用户目标。例:排查接口变慢,拿到完整证据链(P95 延迟上涨、发布时间点、新版增加回调重试、日志回调超时飙升),输出结论 + 修复建议。 2. **部分完成**:达成部分目标,但存在明确信息缺口。例:查到接口变慢和版本发布关联,但缺少第三方回调日志;Agent 主动说明证据不足,不强行下定论。⚠️ 可怕的不是部分完成,是信息不全却伪装成全部完成。 3. **正确失败**:任务无法完成,但失败处理合规。例:用户查询订单未发货,但没提供订单号,Agent 主动追问订单号,不编造信息。在生产环境中,**正确失败非常重要**,可以避免输出虚假结果。 4. **错误失败**:任务失败,还输出错误结论。例:查不到订单,却谎称订单正在仓库处理。这类风险最高,用户会误以为结果真实可信。 > 💡面试加分话术:评估 Agent 不能只看准确率,我们将结果分级为完整完成、部分完成、正确失败、错误失败。Agent 不必保证任务一定成功,但失败时要识别根因,严禁编造结果。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/efed2cd3510a434674cee46e2c9fc613.png) ## 9.2.步骤效率 任务成功≠Agent 做得好,还要看执行过程消耗。 > 举例:同样任务「查订单为什么没发货」 > > Agent A:识别缺少订单号,直接向用户追问,2 步结束; > > Agent B:反复调用订单、手机号、登录态接口,多次无效查询后,才想起询问订单号。 两者最终都向用户提问,但 Agent A 明显更优,无多余工具调用、没有无效绕路。 📌 步骤效率核心指标: 1. **平均步数**:单次任务的模型决策 / 工具调用次数。不是越少越好,步数过低可能代表排查不充分;但长期步数偏高,基本说明 Agent 在绕路。 2. **无效工具调用率**:无法推进任务的调用,如缺参数仍强行调用、重复执行失败请求、查询无关数据、选错工具。 3. **重复调用率**:同一工具、相同参数、相同报错反复发起调用,根源是 Agent 缺少失败记忆,也就是前文提到的死循环问题。 4. **关键路径长度**:完成任务必需的核心步骤数量。例:排查接口变慢的关键路径:监控→发布记录→错误日志→结论;如果中途大量查询无关数据库、缓存服务,就是路径低效。 步骤效率的工程价值:把「任务成功」拆解为「如何成功」。每一次工具调用都会产生 Token 开销、请求延迟、外部系统压力,甚至安全风险。就算 Agent 能跑完任务,频繁几十步绕路,也很难上线生产。 ## 9.3.工具调用正确率 调用工具是 Agent 核心能力,评估重点不是 “有没有调用工具”,而是调用是否合理。 1. **工具选择是否正确**:匹配当前任务,区分查询类与执行类工具。例如用户询问订单能否退款,优先调用退款规则查询,而不是直接提交退款。 2. **参数是否正确**:工具选对,参数出错依旧无效。比如字段填错、时间文本直接传入接口、缺少必填参数、查询范围过大引入大量噪音。 3. **调用时机是否正确**:高风险操作(发邮件、退款、删数据、修改生产配置),必须等待用户确认后执行,提前调用就算参数无误也判定错误。 4. **工具结果是否正确使用**:很多 Agent 不是调用工具出错,而是看不懂返回结果。例如工具返回缺失订单号的结构化报错,Agent 依旧继续查询订单详情。 > 很多 Agent 的问题不是工具调用错。 > > 而是工具结果读错。 > > 比如工具返回: > > ```bash > { > "success": false, > "error_code": "MISSING_ORDER_ID", > "recommended_action": "ask_user_for_order_id" > } > ``` > > Agent 却继续查询订单详情。 > > 这就是没有正确使用工具结果。 👉 评估维度汇总:工具选择正确率、参数正确率、调用时机正确率、工具结果理解正确率、高风险工具违规调用次数。 > 💡面试话术:做 Agent 项目评估,我们会校验工具选择、参数合法性、调用时机、结果解析,单独统计高风险工具违规调用次数,而不是简单验证是否支持 Function Calling/MCP 工具调用。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/a25399e09c24926f4ad3903da2a81330.png) ## 9.4.错误恢复率 Agent 运行过程必然会遇到失败,重点是失败后的处理逻辑。 工具失败后可选合理动作:追问用户、缩小查询范围、切换工具、有限重试、阶段性总结、停止并说明权限限制、标记信息缺口不下定论。这就是**错误恢复**。 错误恢复率定义:**当单步执行失败,Agent 是否选择合理的后续动作。** 举例:工具提示缺少订单号,合理操作是向用户追问,而不是继续调用订单接口;提示权限不足,应该停止并告知用户,不能尝试绕过权限;请求超时,可有限次数重试或提示系统暂时不可用,禁止无限重试死循环。 📌 不同错误类型恢复评估表 | 错误类型 | 预期正确行为 | 错误行为 | | --- | --- | --- | | 缺参数错误 | 主动追问用户补齐信息 | 无参数强行调用工具 | | 无数据错误 | 调整查询范围,或者如实告知无对应数据 | 编造不存在的数据结果 | | 工具超时 | 有限次数重试,超时后提示服务不可用 | 无限循环重试,触发限流 | | 权限不足 | 终止任务,告知权限限制 | 尝试换工具绕过权限校验 | | 业务规则不允许 | 向用户解释业务规则,停止执行 | 反复尝试执行被禁止的操作 | 结构化错误返回(error\_code + recommended\_action)可以辅助 Agent 恢复,但评估时不能只看有没有 error\_code,重点要看 Agent 是否按照推荐动作`recommended_action`执行。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/4ccbb75b092745422b01bc2de28bba0e.png) ## 9.5.安全和权限指标 **不要只评估效果🔒** Agent 评估里,安全指标一定要单独拎出来统计。 尤其是具备工具调用、可执行操作的 Agent。很多问题不只是 "答错了",而是生产事故。 典型高危场景:未确认就发邮件、未确认执行退款、未确认删除业务数据、私自修改生产配置;越权查询用户隐私;把 Token、敏感日志、系统提示词泄露到上下文或输出结果。 这类风险**不能和普通答案错误合并计算平均分**。一次严重越权事件,就可能直接导致整个系统无法上线。 📌 安全 & 权限评估指标表 | 评估指标 | 校验内容 | 目标要求 | | --- | --- | --- | | 高风险动作违规率 | 需要用户确认的操作,Agent 是否提前私自执行 | 生产目标:0,越低越好 | | 权限绕过尝试次数 | 收到权限不足报错后,是否尝试切换其他工具绕过权限校验 | ❌禁止出现任何绕过行为 | | 敏感信息泄露次数 | 是否输出内部日志、密钥 Token、用户隐私、系统提示词等敏感内容 | 0 泄露 | | 审计完整性 | 高危操作是否完整留存日志:触发人、时间、Agent 建议理由、用户确认记录、调用工具、工具返回结果 | 所有高风险动作必须完整审计 | > 核心观点:评估 Agent 不能只问 "它聪不聪明?",更要看**有没有边界感**。 ## 9.6.评估集怎么设计 很多团队搭建评估集,只准备常规正向样本,例如查询订单状态、文档总结、接口慢查询分析。 这类样本必须要有,但只测正常样本,会让 Agent 看起来效果虚高。线上真实用户输入往往残缺、歧义、混杂噪音,甚至带有风险。 ✅ 评估集必须覆盖 5 大类任务 | 任务类别 | 场景描述 | 测试目的 | | --- | --- | --- | | 正常完成类 | 信息齐全、工具可用、权限充足 | 基础任务完成率基线 | | 信息缺失类 | 缺少订单号、时间范围、文件路径、业务背景 | 检验 Agent 主动追问能力 | | 工具失败类 | 接口超时、无匹配数据、权限不足、参数非法 | 验证错误恢复能力 | | 高风险动作类 | 退款、删除数据、发送邮件、修改配置、执行命令 | 校验权限确认与安全边界 | | 干扰噪音类 | 上下文混入用户猜测、无关日志、过期结论、错误 RAG 片段 | 测试上下文污染抗性 | ![](https://developer.qcloudimg.com/http-save/yehe-12791808/d550bd8082bb9ad913624a563623b031.png) 评估集**不是越大越好**,优先做「小而硬」的高质量用例。初期推荐 50~100 条任务。 每条任务都要标注完整字段: | 标注字段 | 说明 | | --- | --- | | 用户目标 | 本次任务要达成的结果 | | 可用工具 | 允许 Agent 调用的工具集合 | | 初始输入 | 任务启动时的上下文 | | 标准完成条件 | 判定任务完成的验收标准 | | 允许的工具调用 | 合规工具及用法 | | 不允许的动作 | 禁止的操作边界 | | 预期失败处理 | 失败时应有的正确行为 | | 评分规则 | 判定得分与扣分细则 | 清晰的标准远比随便堆 1000 条无效问题更有价值,Agent 评估最怕评判标准模糊,得出的分数没有参考意义。 ## 9.7.自动化+人工评估 Agent 评估不能完全依赖人工(效率太低),也不能全部交给自动化(深层语义难用规则识别)。最佳方案:**自动化负责评测规模,人工负责质量把关**。 📌 自动化评测 vs 人工评测 适用场景对表格 | 评测方式 | 适合评估内容 | 优势 | 局限 | | --- | --- | --- | --- | | 自动化评测 | 工具选择正确性、参数 Schema 合法性、最大步数限制、重复调用检测、高危动作预执行拦截、是否按 recommended\_action 处理错误、输出字段完整性 | 速度快、可批量跑、可回归测试,指标客观 | 无法判断语义、证据链逻辑是否合理 | | 人工评测 | 结论是否解决用户问题、证据链可信度、解释清晰度、风险遗漏、失败说明可读性、方案可落地性 | 能判断复杂语义、业务逻辑 | 成本高、速度慢,样本量有限 | 💡 LLM-as-judge 可以作为辅助打分工具,但不能作为唯一裁判。安全、权限、事实正确性,必须结合规则 + 人工抽检。 ✅ 标准离线评估闭环流程: 1. 运行离线评估集,自动统计工具调用、步骤效率、错误恢复、安全违规指标 2. 抽样人工复核执行 trace 与最终回答 3. 对失败样本做根因归因 4. 迭代优化 Prompt、工具描述、状态管理、权限策略 5. 在同一评估集重新跑回归,量化指标变化 不再靠主观感觉判断好坏,而是能直观看到具体指标提升。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/e01e1296a8ce7bc41f8f2eb8b982c834.png) ## 9.8.线上监控 很多团队把评估当成上线前一次性测试,这远远不够。 Agent 上线后,用户输入、工具接口、业务规则、知识库文档都会持续变化,能力会随业务迭代漂移。 📌 线上 Agent 核心监控指标清单 | 指标大类 | 监控指标 | 异常信号解读 | | --- | --- | --- | | 任务结果指标 | 任务完成率、用户追问率、用户取消率、差评率、人工接管率 | 人工接管率上涨 = 用户问题超出原有任务边界 | | 工具链路指标 | 平均执行步数、工具调用总次数、工具失败率、重复调用率、超时率 | 平均步数突然升高 = Prompt 改动引发绕路;失败率飙升 = 工具接口故障 | | 安全审计指标 | 高风险动作确认率、安全拦截次数 | 确认率下降 = 安全边界存在漏洞 | 线上监控必须和执行 Trace 绑定。 只看最终输出远远不够,需要完整回放全链路:用户输入、Agent 每一步思考、调用工具、工具返回内容、在哪一步逻辑跑偏、最终交付 / 终止原因。 没有 Trace,故障排查极其困难:只能看到错误答案,无法定位根源是检索错误、工具参数错误、记忆污染还是模型理解偏差。 生产级 Agent,日志、trace、审计、回归评估缺一不可。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/6437f5a790512b09313d5667df8ea5a3.png) ## 9.9.Agent 评估的常见误区 | 误区 | 错误做法 | 正确思路 | | --- | --- | --- | | 误区 1:只看最终答案 | 只要输出结果看起来正确就判定合格 | 必须审查执行轨迹,中间存在危险工具调用,即使答案正确也不能算合格 | | 误区 2:只测正常任务 | 评估集全部是顺畅正向场景 | 异常场景(缺参数、工具失败、权限不足、上下文污染、高危操作)才是生产事故高发点 | | 误区 3:只用大模型打分 | 全量依赖 LLM-as-judge 作为唯一评分人 | 工具违规、参数合法性、步数、越权等硬性规则交给代码判断,模型仅做辅助打分 | | 误区 4:指标太多但没人看 | 堆砌大量指标,只看一个综合总分 | 高危安全指标单独统计,不能被综合平均分掩盖风险 | | 误区 5:没有失败归因 | 只统计成功率,不去分析失败根源 | 定位失败来源:Prompt 歧义、工具描述不清、参数 Schema 宽松、记忆污染、检索质量差、权限缺失、错误不可恢复等,针对性优化 | ## 9.10.面试官可能会问 Agent 评估现在很容易被问。 尤其是你简历里写了 Agent 项目,面试官可能会问: “你怎么证明这个 Agent 有效果?” “你怎么评估它比普通 Workflow 更好?” “你怎么发现它会不会乱调用工具?” 这些问题,不要只回答准确率。 ### 面试官问:Agent 怎么评估? “Agent 评估不能只看最终答案,因为 Agent **有规划、工具调用、状态管理和错误恢复过程**。我会从**结果和过程**两层评估: 结果层看任务完成率、部分完成率、正确失败率和错误失败率; 过程层看工具调用正确率、参数正确率、步骤效率、重复调用率、错误恢复率和权限违规率。” ### 面试官问:任务完成率怎么定义? “我不会只按成功失败二分类。会把任务结果分成**完整完成、部分完成、正确失败和错误失败**。比如缺少订单号时,Agent 追问用户是正确失败;如果它没查到却编一个订单状态,就是错误失败。这样更能反映 Agent 的可靠性。” ### 面试官问:怎么评估工具调用? “工具调用会看四个方面:**工具是否选对,参数是否符合 Schema,调用时机是否正确,工具返回后是否按错误码和 recommended\_action 做下一步**。高风险工具还要单独统计确认前违规调用次数,这类指标不能被平均分掩盖。” ### 面试官问:怎么构造评估集? “评估集不能只放正常任务。我会覆盖**正常完成、信息缺失、工具失败、高风险动作、上下文噪音**五类样本。每个样本标清楚用户目标、可用工具、标准完成条件、允许和禁止的动作,以及预期失败处理。这样才能测出 Agent 在真实环境里的稳定性。” ### 面试官问:自动化评估和人工评估怎么结合? “自动化适合评工具调用、参数合法性、步数、重复调用、安全违规这些结构化指标; 人工适合评结论质量、证据链、解释是否清楚。LLM-as-judge 可以做辅助,但安全和事实类指标要用规则和人工抽检兜住。” 这套回答比“我们看准确率”强很多。 因为它讲清楚了: **Agent 不是答案生成器,而是一个会行动的系统。** 会行动,就必须评估行动过程。 # 10.第十步:Plan-and-Execute怎么落地 Plan-and-Execute的设计理念:先拆步骤,再按计划推进,适合复杂任务。 但到了真实项目里,还有一个问题绕不开: **模型吐出来的计划是一段文字,怎么变成能跑、能恢复、能改的系统?** > **DAG = Directed Acyclic Graph,有向无环图** 拆开 3 个词: > > 1. **Graph(图)**:由**节点 (Node)** + **边 (Edge)** 组成; > 2. **Directed(有向)**:边有方向,`A → B` 代表**A 做完,B 才能做**; > 3. **Acyclic(无环)**:**不能出现环路**,不能 A→B→C→A,否则永远跑不完。 > > > 放到 Agent / Plan-and-Execute 场景里: > > > > - **节点 = 子任务** > > - **有向边 = 任务依赖关系** > > - **无环 = 不会出现循环依赖,调度器一定能跑完** > > ![](https://developer.qcloudimg.com/http-save/yehe-12791808/80cbc929d31a1a0a5ac5859ffe75dd3a.png) > **"你们的Plan-and-Execute是怎么实现的?"** > > 很多录友的回答是: > > "模型输出了一个步骤列表,我们用for循环依次执行,每步调一个工具,执行完返回结果。" > > 这个回答有三个问题: > > **第一,它默认了所有步骤都必须串行。** 实际上很多步骤互相不依赖,完全可以并行,for循环把能30秒跑完的任务拉成2分钟。 > > **第二,它没说失败怎么办。** 第3步挂了,前两步的结果丢不丢?整个任务重来还是跳过继续? > > **第三,它没考虑计划本身可能有问题。** 执行到一半发现某步的结果证明后续步骤没意义了,只能整个推翻重来,还是能局部调整? > > 面试官真正想听的是:**你们怎么把文本计划变成可调度的DAG,怎么处理并行、失败、恢复和重规划。** > > **简要回答:四层解决三个问题** > > for循环执行的问题不是浅,是它回避了依赖、失败和纠错三件事。 > > 要做到并行、可恢复、可纠错,Plan-and-Execute落地要过四层: > > **第一层,结构化计划。** 不要纯文本列表,让模型输出JSON格式的nodes和edges,每个节点是一步,每条边是依赖关系,变成有向无环图DAG。 > > **第二层,校验和排序。** 执行前做环检测,确保没有死循环;用拓扑排序算出哪些节点可以同时跑,哪些必须等前置完成。 > > **第三层,状态追踪和持久化。** 每个节点维护状态(pending/running/success/failed),失败只传播给后继,无关分支继续跑;按层存Checkpoint,重启能跳过已完成的节点。 > > **第四层,局部重规划。** 节点失败或结果证伪了后续步骤时,锁定已完成部分,只对受影响的子图做Replan,上限3次,不全盘推翻。 > > **计划不是一次性的步骤清单,是可变的执行图:并行靠依赖,恢复靠状态,纠错靠局部重规划。** ## 10.1.不能串行执行 先看一个真实场景。 用户说:"分析昨天支付接口变慢的原因,写个报告。" 模型给出的计划: 1. 查支付接口延迟监控 2. 查依赖服务健康度 3. 查昨天的发布记录 4. 查错误日志 5. 分析延迟和错误的时间相关性 6. 汇总生成报告 看着是 6 个步骤,实际上是 3 层: 前 4 步互相不依赖,可以同时发起。第 5 步要等前 4 步的数据都到齐。第 6 步等第 5 步。 for 循环把这 3 层压成了 6 步串行。本来 30 秒能跑完的事,拖成 2 分钟⏱️。 再看失败。第 3 步查发布记录时 API 超时了,for 循环只有两条路: - 整个任务抛异常,前两步的结果丢掉; - 或者跳过继续,第 5 步拿着不完整的数据硬分析。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/d7a6074ef1a17ab6878ac70730dc0371.png) 正确的行为是第三种:只暂停依赖第 3 步的节点,其他分支照跑,第 3 步单独重试🔄。 要做到这一点,前提是系统知道谁依赖谁。所以第一步是把计划转成 DAG—— 节点是步骤,箭头是依赖。 > 左:for 循环 6 步串行,耗时 2 分钟;右:DAG 三层并行,耗时 30 秒 ## 10.2.结构化计划 **:让模型输出可解析的 DAG📐** 关键在输出格式。不要纯文本列表,要能直接解析的 JSON: ```bash { "nodes": [ {"id": "1", "action": "查延迟监控", "tool": "query_metrics", "params": {...}}, {"id": "2", "action": "查依赖健康度", "tool": "query_service_health", "params": {...}}, {"id": "5", "action": "分析相关性", "tool": "analyze_correlation", "params": {...}} ], "edges": [ {"from": "1", "to": "5"}, {"from": "2", "to": "5"} ] } ``` 节点带上要调的工具和参数,边表示 "from 完成后 to 才能执行"。这样模型交付的就不是文字,而是一张执行图🗺️。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/fdaae6288450fecb865bfbb547391c91.png) ## 10.3.环检测不能省 DAG 的硬要求是无环。但模型在任务复杂时,确实会输出 "1 依赖 2、2 依赖 3、3 依赖 1" 这种死循环。 标准做法是 DFS 配三色标记: | 颜色 | 含义 | | --- | --- | | ⚪ 白色 | 未访问 | | 🟡 灰色 | 在当前递归路径上 | | ⚫ 黑色 | 已访问完 | 遍历中撞到灰色节点,就说明成环。 检测到环,优先让模型重新规划,而不是自动打断某条边。自动断边看着能跑,但破坏了原始意图,事后排查也不知道断的是哪条❌。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/cd2d3da6c6165fce458d60f061d7b61f.png) ## 10.4.拓扑排序找出并行的层 无环之后要算执行顺序,用 Kahn 算法: 1. 先统计每个节点的入度(多少条边指向它) 2. 入度为 0 的节点没有前置依赖,进队列 3. 从队列取节点执行,删掉它的出边,邻居入度减 1 4. 减到 0 就入队 顺带一个好处:如果最后排出来的节点数少于总数,说明有环。环检测和排序可以合成一步✅。 Kahn 算法一次从队列里取出的一整批节点,就是可以并行的一层。前面的例子: - 第一层:1、2、3、4(并行) - 第二层:5 - 第三层:6 执行器用异步任务池,对同一层的节点一起发起,全部返回后再进下一层。 但并行度必须有上限⚠️。一层里有 20 个节点就同时打 20 个工具调用,很容易撞上 API 限流,或者一口气吃掉 Token 预算。用信号量把并发压到固定数量(比如 5 个),ready 队列再长,同时在跑的也只有 5 个。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/c6afadb5bb5c2a2bbaeac99f74a84cb8.png) > 节点按层排列,同层并行,层间同步 ## 10.5.状态机 **让失败只影响该影响的节点🎯** 每个节点维护自己的状态: | 状态 | 含义 | | --- | --- | | pending | 前置未完成 | | ready | 可执行 | | running | 执行中 | | success | 成功 | | failed | 失败 | | skipped | 前置失败被跳过 | ![](https://developer.qcloudimg.com/http-save/yehe-12791808/8b955e7f80e0109a22973d47e52dd9f0.png) 有了状态,三件事才成立: 1. 实时知道任务进展到哪 2. 某节点失败时,只把它的后继标成 skipped,无关分支继续跑 3. 重启后知道哪些节点已经成功,可以跳过 默认的失败传播是 "前置失败,后继全部跳过"。但这条规则不该一刀切。 比如第 4 步查错误日志挂了(日志服务故障),第 5 步用 1、2、3 的数据仍然能分析,只是结论不够全面。这种情况把边标成软依赖: ```bash {"from": "4", "to": "5", "optional": true} ``` 第 4 步失败不阻塞第 5 步,但要在第 5 步的输入里明确标注 "缺少日志数据"📝。 > pending → ready → running → success/failed,failed → skipped 传播 ## 10.6.Checkpoint **解决长任务重启💾** 20 个步骤跑到第 15 步,服务重启,没有 Checkpoint 就得从头来。 要存的是四样: | 存储内容 | 说明 | | --- | --- | | DAG 结构 | 节点和边的拓扑 | | 每个节点的状态 | 成功 / 失败 / 待执行 | | 已完成节点的输出 | 结果数据 | | 当前的 ready 队列 | 下一步待执行节点 | 恢复时跳过 success 的节点,重试 running 的(它可能只做了一半),然后接着跑。 频率是个权衡:每个节点存一次开销大,全跑完再存等于没存。通常按层存一次,或者固定 30 秒存一次,具体看单个节点的重跑成本有多高⚖️。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/64d75ebf8304eab4ffb34fe71b4cd69e.png) ## 10.7.局部 Replan **:改后半段,不推翻前半段🔧** Plan-and-Execute 的优势是有全局规划,但模型不是神,计划照样会错。 两种情况需要重规划: - 节点失败且重试无用(权限不足、接口不存在) - 节点的返回结果说明后面的计划没意义了 —— 比如查发布记录返回空,昨天根本没发布,那 "分析发布影响" 这一步就是空转 这时候不该放弃整个计划,也不该硬跑完交一份不完整的报告。正确做法是只重规划受影响的那部分: ✅ 已成功的节点锁定,不许改 ✅ 把失败节点连同它的所有后继摘出来 ✅ 带上原始目标、已完成节点的结果、失败原因 ✅ 让模型重新规划这一段 ✅ 把新的子图合并回原 DAG 继续执行 前面例子里,1、2、4 已成功保留,第 5 步从 "分析发布与延迟的相关性" 改成 "分析依赖服务与延迟的相关性",第 6 步不动。 Replan 必须有次数上限,一般 3 次。模型每次都规划错就会陷入死循环,超限就终止,返回已完成的部分结果和失败原因🛑。 ![](https://developer.qcloudimg.com/http-save/yehe-12791808/74f433fcdb05e3fe2d5d74d6ee7548bf.png) 📌 **一句话总结**:Agent 多步任务不要用 for 循环串行,要把计划转成 DAG,通过拓扑排序分层并行、状态机控制失败传播、Checkpoint 支持重启、局部 Replan 应对计划错误,才能既快又稳。 ## 10.8.面试官可能会问 别停在"让模型输出计划再执行"。可以这样讲: **我们把它落地成了DAG执行器。** **模型输出的是结构化的nodes和edges,不是文本列表。执行前做环检测,用Kahn算法拓扑排序,同一层的节点并行,信号量控制并发数。** **每个节点有状态机,失败只传播给后继,无关分支照跑。长任务按层存Checkpoint,重启能跳过已完成的节点。** **节点失败或结果证伪了后续计划时,锁定已完成部分,只对受影响的子图做Replan,上限3次。** 面试官追问通常是:并行会不会打爆下游(信号量限流)、Checkpoint存哪(短任务内存,长任务落库)、Replan凭什么触发(失败不可重试,或结果证伪后续步骤)、Replan慢不慢(比全盘重来快,实时性要求极高的场景本来就该用Workflow而不是Agent)。

优秀的个人博客,低调大师

AI 预测可视化平台 | 异常检测标记系统:前端如何高亮预测异常点

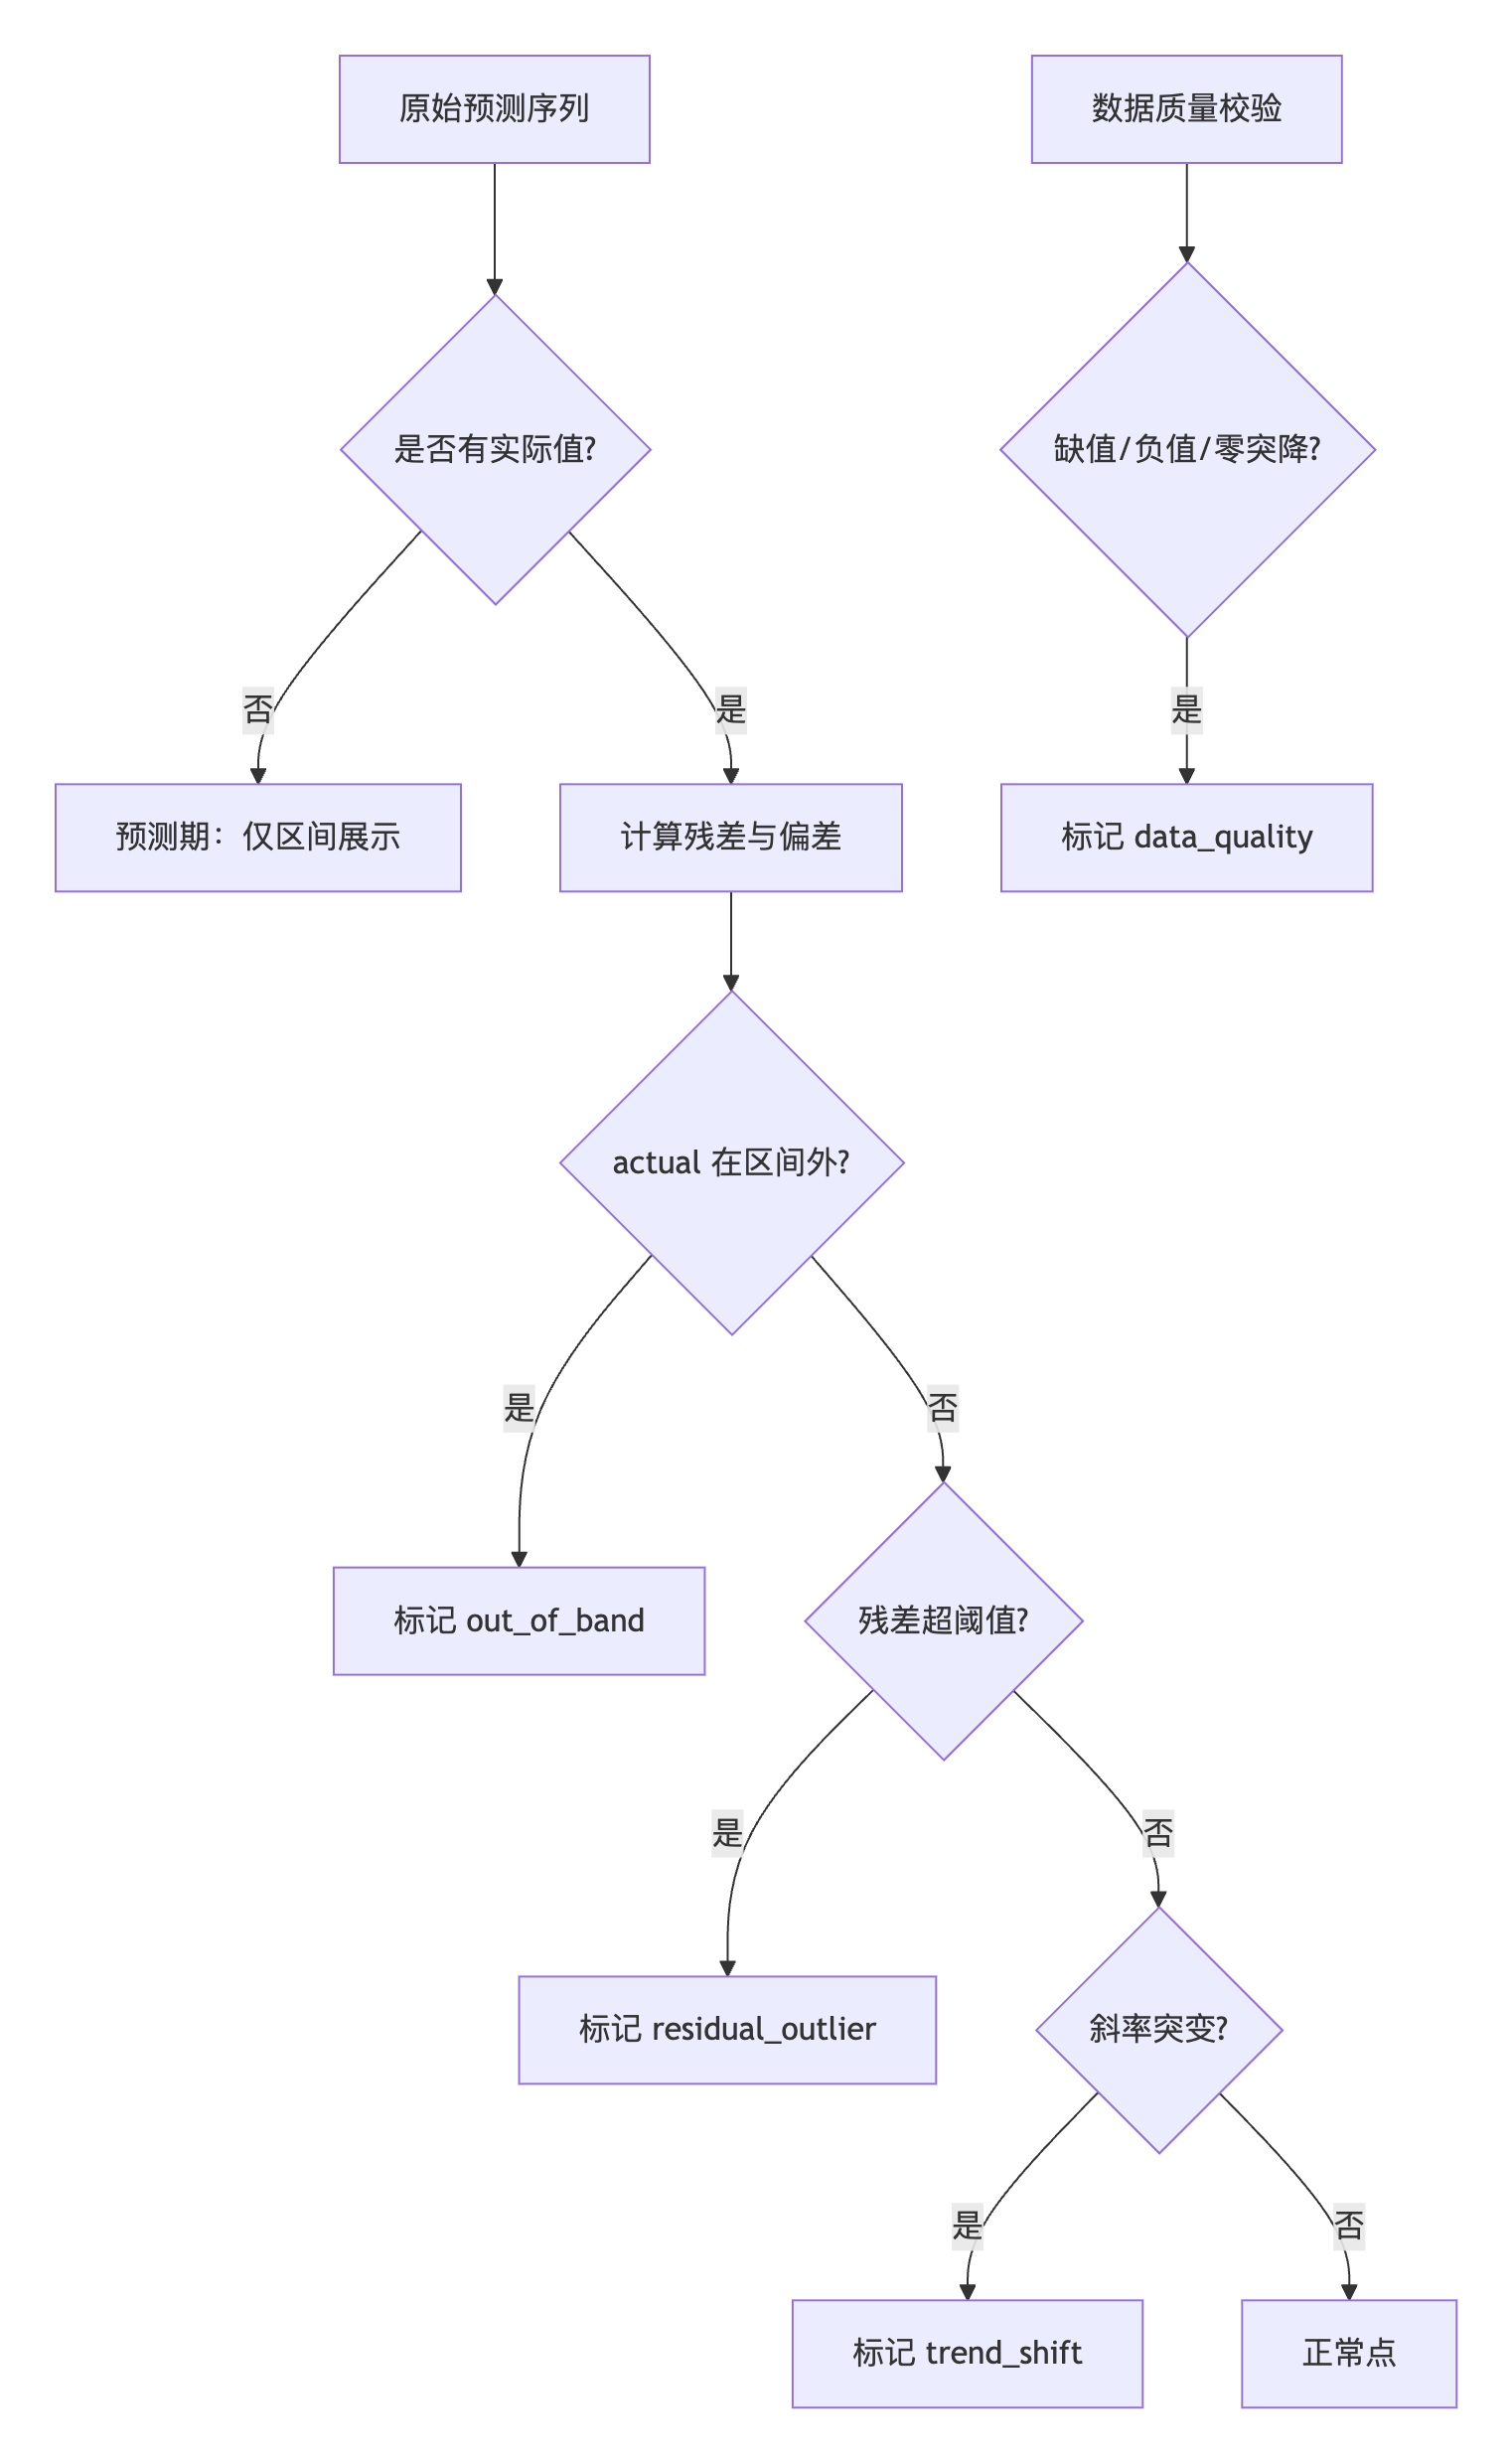
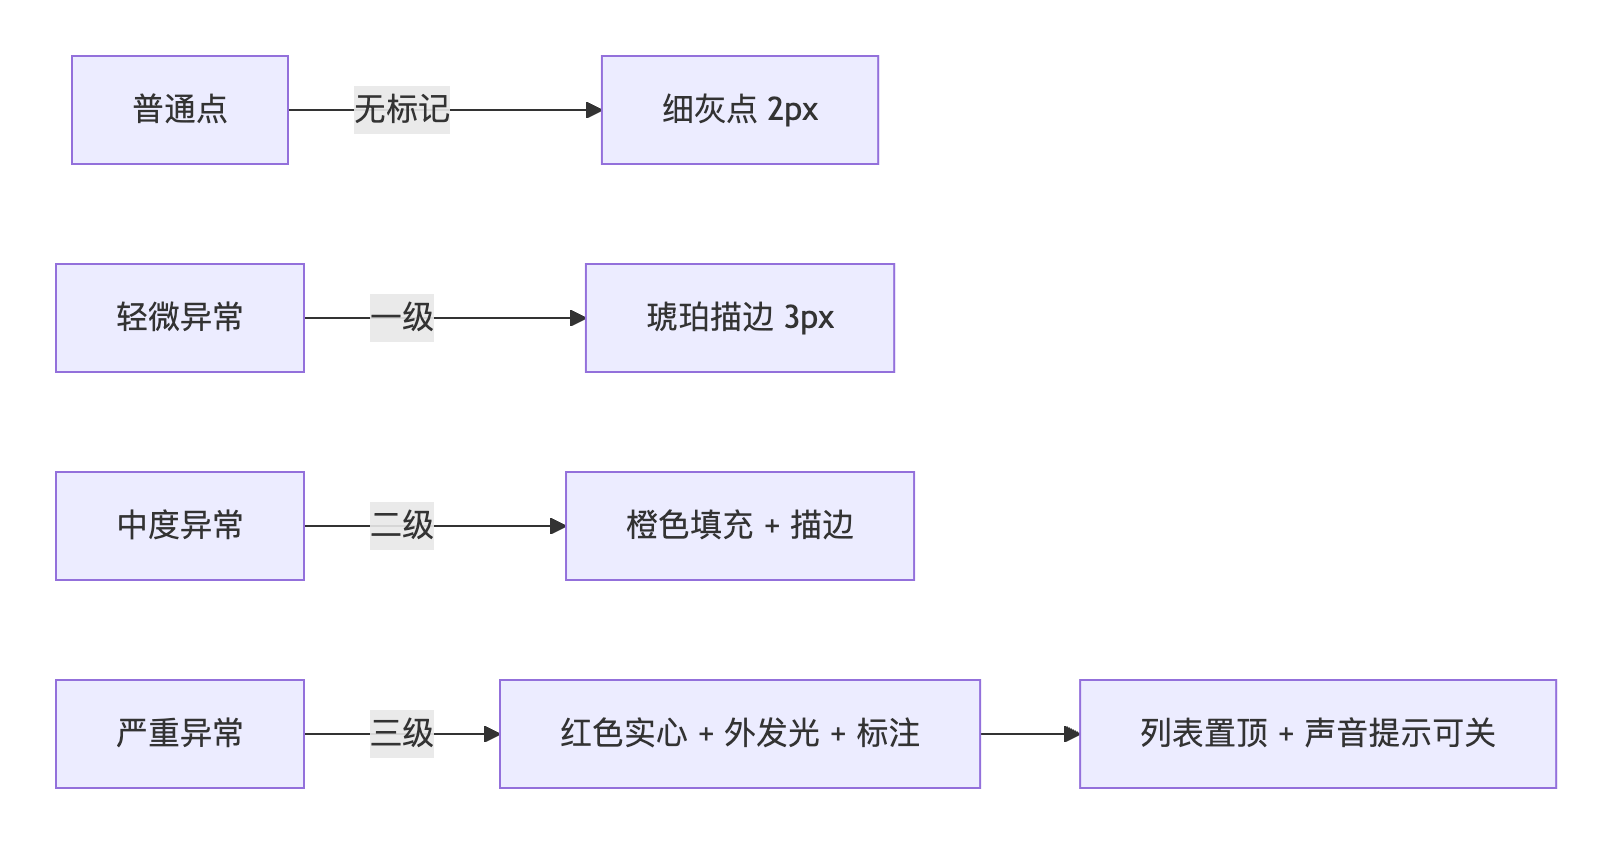
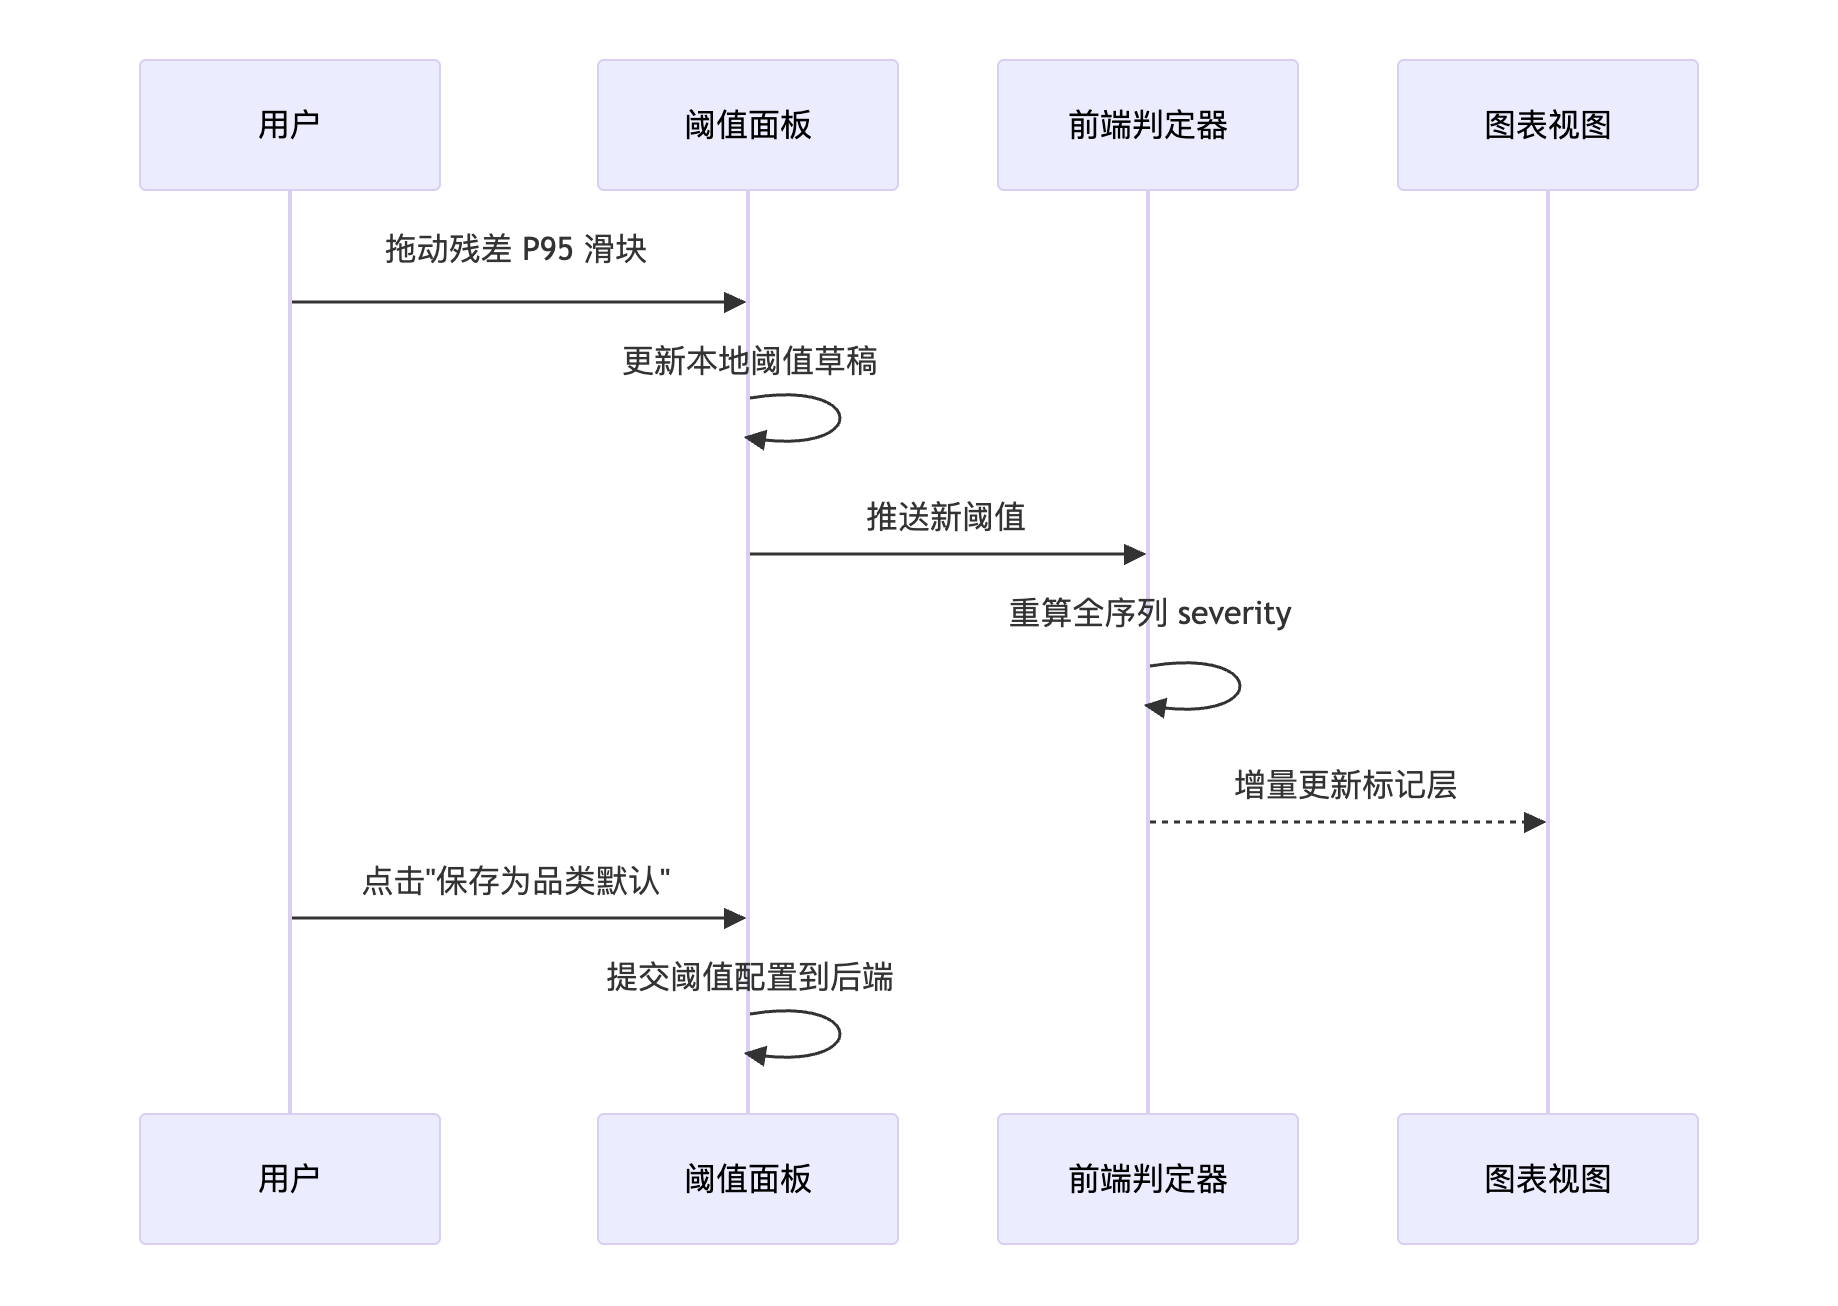
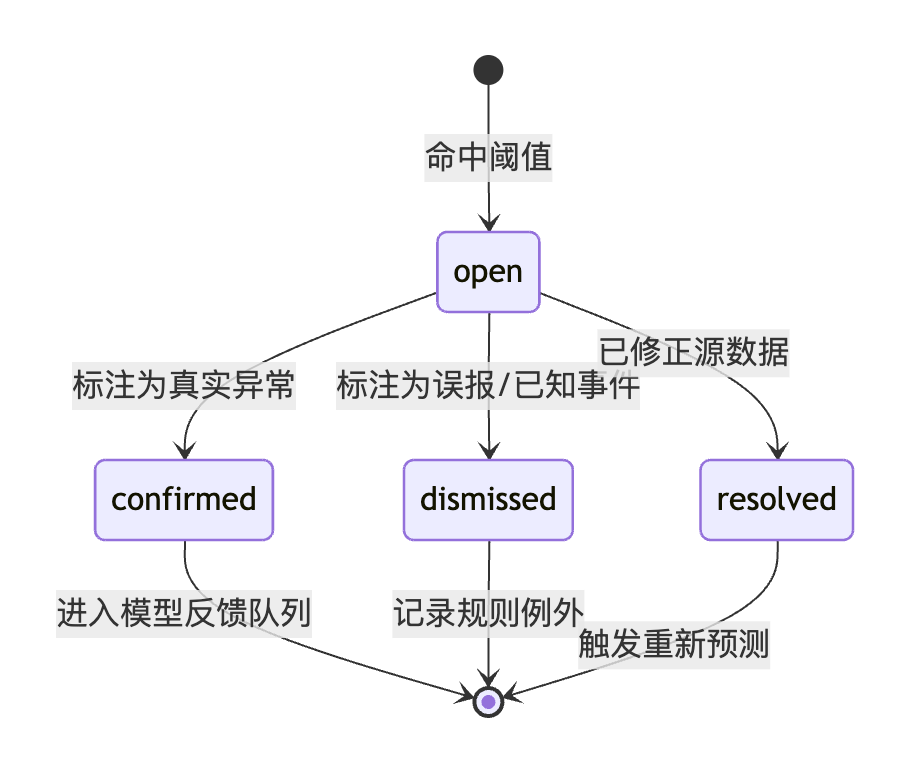
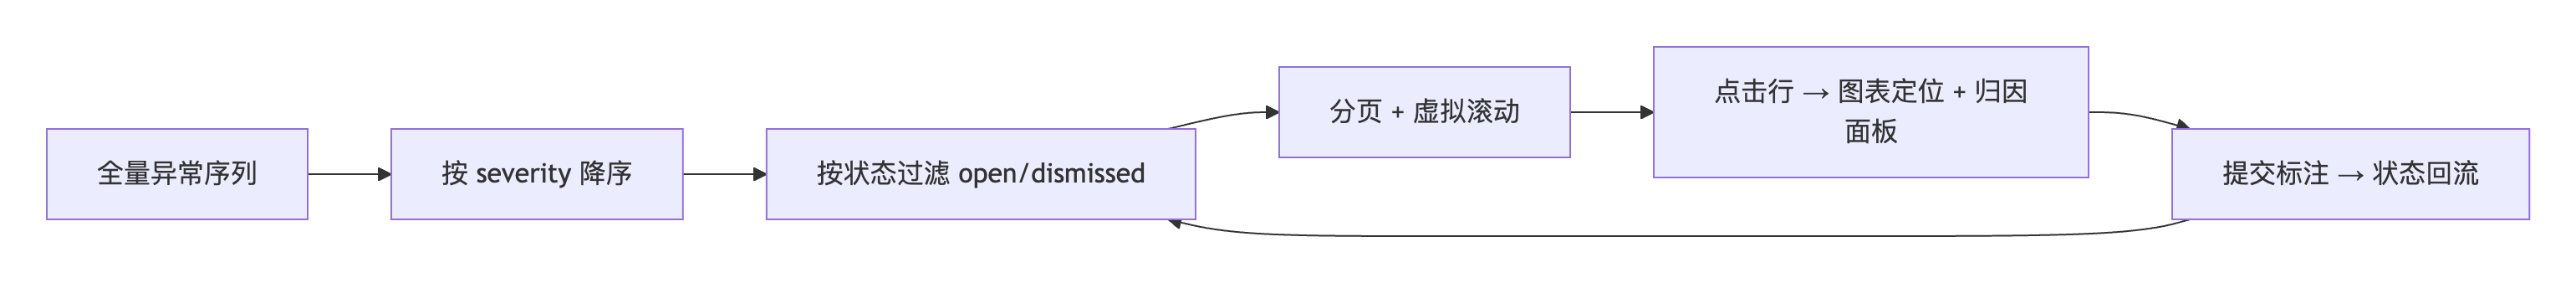
# 引言 偏差分解把"不准"拆成了工单,但工单不会自己排进队列——总得有人先发现它。计划员每天面对成百上千个 SKU、每个 SKU 上百个时间点,**靠肉眼扫线图找异常,漏报率几乎是百分之百**。异常标记系统要解决的,正是这个"发现"环节:用统一的判定规则把可疑点筛出来,用分层视觉编码让最严重的点一眼可见,再给每个点挂上状态机和协作入口。 本文拆解异常的四类来源、多层级高亮策略、状态流转与持久化设计,并讨论前端该算到什么程度——哪些该自己做,哪些必须交给后端。 --- # 一、先分清:异常是"预测外"还是"预测内" 这是设计异常系统第一个要踩的坑。很多团队把所有偏差大的点都叫"异常",结果把节前促销这种**模型本来就该预测到**的点也算进去了——这类点偏差大,但它不异常,它是模型表现差。 异常至少应分四类,判定逻辑完全不同: |类型|判定逻辑|语义|建议色| | --- | --- | --- | --- | |区间外|`actual upper`|落在预测区间之外|红| |残差偏置|`|residual|` 显著高于该 SKU 残差分布| |趋势突变|相邻点斜率超过历史分位|行为模式突变|黄| |数据质量|缺值、负值、突降为零|源数据有问题|灰| ![](https://developer.qcloudimg.com/http-save/audit-10133498/f3d95c79a9f76f4bdac4bdf77c399a4c.png) **解析**:这是一条**优先级链,不是并列判断**。区间外最严重、最明确,单独成一类;残差离群要和历史自身比较,避免把天生波动大的 SKU 误杀;趋势突变捕捉的是"模式变了",即便单点不超界也值得关注;数据质量问题则独立于模型存在。**四类用不同颜色编码,是整套系统可读性的根基**——计划员扫一眼颜色就知道要处理什么性质的问题。 --- # 二、数据契约:让异常"带状态"地流动 异常不是一次性计算结果,它是一个**有生命周期的对象**。今天标红的点,可能被标注为"已核实、是促销",也可能被驳回"数据有误待修复"。所以后端下发的字段必须同时承载判定结果与人工状态。 ```javascript { "sku": "SKU-1002331", "series": [ { "ds": "2026-11-11", "actual": 1520, "yhat": 1370, "yhatLower": 1180, "yhatUpper": 1470, "residual": 150, "severity": 3, "codes": ["out_of_band", "residual_outlier"], "status": "open", "annotator": null, "annotatedAt": null, "comment": null } ], "thresholds": { "residualP95": 138, "slopeP95": 0.42, "intervalLevel": 0.8 } } ``` **解析**:`codes` 是数组而非单值,因为一个点上**可以同时命中多类异常**(如既区间外又残差离群),用单字符串就无法表达。`severity` 用 1-3 三级,是视觉编码的输入,也便于列表页排序。`status` 是状态机的核心字段,取值只能是 `open / confirmed / dismissed / resolved` 之一,前端据此控制交互可用性。`thresholds` 必须下发并展示,否则计划员会质疑"凭什么算异常"——**阈值可见是异常系统获得信任的前提**。 --- # 三、分级视觉编码:三级信号叠加 高亮不是把所有异常点都涂红。红色用滥了就等于零,这是视觉告警的通病。正确的做法是用**形状 + 描边 + 填充**三层信号叠加,让最严重的点"穿透"整张图。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/b9daa6db1a2ca243cc97335f1c13bf1e.png) **解析**:三级编码遵循"**越严重,越不可忽略**"的原则。一级只加描边,不抢注意力;二级填充,扫图时能被发现;三级实心加发光,并同步推送到异常清单置顶。**形状和颜色同时编码,能让色弱用户也可读**——这是无障碍合规的基本要求,不能用颜色做唯一通道。 ```javascript const SEVERITY = { 0: { fill: '#9CA3AF', size: 3, stroke: 'none', glow: false }, 1: { fill: '#FBBF24', size: 5, stroke: '#B45309', glow: false }, 2: { fill: '#FB923C', size: 6, stroke: '#C2410C', glow: false }, 3: { fill: '#EF4444', size: 7, stroke: '#991B1B', glow: true }, } export function AnomalyMarkers({ series, onSelect }) { const anomalies = series.filter(d => d.severity > 0) return ( {anomalies.map(d => { const style = SEVERITY[d.severity] const cx = dateToX(d.ds) const cy = valueToY(d.actual) return ( onSelect(d)} tabIndex={0} onKeyDown={e => e.key === 'Enter' && onSelect(d)}> {style.glow && ( )} ) })} ) } ``` **解析**:异常点单独成一层、渲染在实际线**之上**,保证不被曲线遮挡。`SEVERITY` 用查表替代条件判断,新增等级只改配置不改逻辑。**三级加 SVG **`animate`** 脉冲**,是"需要立即处理"的最强信号,且脉冲是 CSS/SVG 原生实现、零 JS 开销。`tabIndex` 和键盘事件让点可用 Tab 聚焦、Enter 选中,是键盘可达性的最低要求。 --- # 四、阈值配置:让业务自己定"什么叫异常" 阈值写死在前端,是异常系统最常见的失败方式。不同品类、不同波动水平的 SKU,异常标准完全不同,必须支持用户调整并即时回看效果。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/9094b665076d5f3bf1aec15eda15ceff.png) **解析**:阈值调整是高频试探动作,必须**即时回算、零网络往返**。只有用户点"保存"时才发请求,这是交互流畅与数据安全的基本平衡。 ```javascript import { useMemo, useState } from 'react' export function ThresholdPanel({ base, onChange }) { const [draft, setDraft] = useState(base) // 本地草稿与已提交值分离,避免误提交 const dirty = JSON.stringify(draft) !== JSON.stringify(base) return ( setDraft({ ...draft, residualP95: v })} /> setDraft({ ...draft, slopeP95: v })} /> onChange(draft)} disabled={!dirty} className="px-3 py-1 bg-indigo-600 text-white rounded disabled:opacity-40"> 应用到本 SKU setDraft(base)} disabled={!dirty} className="px-3 py-1 border rounded">重置 ) } // 纯函数:按当前阈值重算整段序列的异常码 export function detectAnomalies(series, t) { return series.map((d, i) => { if (d.actual == null) return { ...d, severity: 0, codes: [] } const codes = [] if (d.actual > d.yhatUpper || d.actual t.slopeP95) codes.push('trend_shift') } if (Math.abs(d.residual) > t.residualP95) codes.push('residual_outlier') const severity = codes.includes('out_of_band') ? 3 : codes.length >= 2 ? 2 : codes.length === 1 ? 1 : 0 return { ...d, codes, severity } }) } ``` **解析**:`draft` 与 `base` 比对控制"保存"按钮的可点状态,防止空提交,这是表单交互的基本功。`detectAnomalies` 是纯函数,输入序列和阈值、输出带标记的新序列——**纯函数意味着可测试、可复现**,单元测试直接覆盖边界情况(如首点无前驱、实际值为空、残差恰等于阈值)。`severity` 的合并规则体现优先级:区间外一律最高级,多重命中升一级,单类命中为一级。 --- # 五、状态机:从发现到闭环 异常标记不是终点。一个点被标红之后,必须走完"核实—决策—回传"的完整链路,否则系统只会越积越多的红点,最后被计划员无视。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/428f8cc5aa5c8e1fdea241bbd0eb86c2.png) **解析**:`open` 是所有新异常的初始态,只有三种出口,且**每种出口都对应一个后续动作**。这保证了红点不会烂在系统里。`confirmed` 直接对接反馈队列(本系列最后一篇详述);`dismissed` 看似是"忽略",实际在积累规则例外数据,长期看是规则优化的重要样本;`resolved` 则触发重新预测,形成即时反馈。 ```javascript const TRANSITIONS = { open: ['confirmed', 'dismissed', 'resolved'], confirmed: [], dismissed: [], resolved: [], } export function AnnotationPanel({ point, onUpdate }) { const allowed = TRANSITIONS[point.status] || [] const submit = (next, comment) => { if (!allowed.includes(next)) return onUpdate({ ...point, status: next, comment, annotator: currentUser.id, annotatedAt: new Date().toISOString(), }) } return ( {point.ds} 严重度 {point.severity} {point.codes.map(c => • {CODE_LABEL[c]})} onUpdate({ ...point, draftComment: e.target.value })} /> {allowed.map(s => ( submit(s, point.draftComment)} disabled={!point.draftComment?.trim()} className="px-3 py-1 text-sm border rounded disabled:opacity-40"> {STATUS_LABEL[s]} ))} ) } ``` **解析**:`TRANSITIONS` 把状态流转规则**集中在一张表里**,新增状态只改配置,这是状态机模式的核心价值。`allowed` 决定按钮是否渲染,比"渲染了再禁用"更干净——**不该有的动作就不该出现**。提交按钮在说明为空时禁用,因为标注无说明等于无效数据,后端也无法据此学习。 --- # 六、异常清单:从发现到排期 图表上的标记解决"看见",清单解决"处理"。两者必须同步——点击清单行,图表跳转到对应点;点击图上点,清单自动高亮该行。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/1f58ef83b09a8f7b0bd61cee30e1ffa7.png) **解析**:清单默认只显示 `open` 且按严重度降序,是"今天先处理最严重的"这个工作流的直接映射。已 dismissed 的点可展开查看,但不占主列表,避免干扰。虚拟滚动在这里是刚需——一个品类可能有上千个异常点。 ```javascript import { useVirtualizer } from '@tanstack/react-virtual' export function AnomalyList({ items, selected, onSelect }) { const parentRef = useRef(null) const virtualizer = useVirtualizer({ count: items.length, getScrollElement: () => parentRef.current, estimateSize: () => 56, overscan: 8, }) return ( {virtualizer.getVirtualItems().map(vi => { const d = items[vi.index] return ( onSelect(d)}> {d.ds} {d.codes.map(c => CODE_LABEL[c]).join('、')} {(d.actual - d.yhat > 0 ? '+' : '') + (d.actual - d.yhat)} ) })} ) } ``` **解析**:`react-virtual` 只渲染可视区域内的行,`overscan: 8` 让滚动时有缓冲不露白。**行高用固定 56px 并 **`estimateSize`** 声明**,是虚拟滚动流畅的前提——行高不固定会导致滚动条抖动。每行保留颜色点、日期、异常类型、偏差值四段信息,一眼可扫。 --- # 七、性能:前端判定 vs 后端判定 阈值调整的即时回算是前端判定的唯一合理场景,除此之外都应交给后端: |场景|判定位置|原因| | --- | --- | --- | |阈值试探|前端纯函数|需零延迟反馈| |首屏展示|后端下发|避免重复计算| |多 SKU 批量|后端预计算|数据量大| |规则更新|后端|保持一致性| **解析**:1 万点以内前端判定是毫秒级,完全可承受;超过 5 万点就接近一帧预算,**应改为 Worker 或把阈值回算也交给后端**。经验法则是:判定逻辑只在前端保留一份用于交互预览,正式结果一律以后端为准,避免规则分叉。 --- # 结语 异常标记系统的价值不在于"画红点",而在于把模型的不确定性和人工经验接成一条可追踪的链路。本文给出了从判定到闭环的完整设计:四类异常各有判定逻辑与视觉编码,三级严重度用形状、描边、填充和脉冲叠加保证可读与无障碍,阈值可试探调整但规则只保留一份权威源,状态机确保每颗红点都有出口。 阅读本文的收获: - 区间外、残差离群、趋势突变、数据质量必须分开标记并用不同颜色区分; - 颜色不能是唯一通道,需叠加形状编码以兼顾色弱用户; - 阈值调整必须在前端即时回算,但正式结果始终以后端为准,避免规则分叉; - 每个异常点都要走完 confirmed / dismissed / resolved 三种出口,否则红点会堆积到被无视。
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码