首页 文章 精选 留言 我的

精选列表

搜索[socket编程],共10000篇文章
优秀的个人博客,低调大师

Java编程笔记,spring boot常用属性汇总

这些属性是否生效取决于对应的组件是否声明为 Spring 应用程序上下文里的 Bean(基本是自动配置的),为一个不生效的组件设置属性是没有用的。 multipart multipart.enabled 开启上传支持(默认:true) multipart.file-size-threshold : 大于该值的文件会被写到磁盘上 multipart.location 上传文件存放位置 multipart.max-file-size 最大文件大小 multipart.max-request-size 最大请求大小 server server.address 服务器地址 server.port 服务器端口 server.context-parameters.[param name] 设置 servlet 上下文参数 server.context-path 应用上下文路径 Jsp-servelt server.jsp-servelt.class-name 针对 jsp 使用的 Servlet 类名(默认:org.apache.jasper.servlet.JspServlet) server.jsp-servlet.registered JspServelt 是否要注册到内嵌的 Servlet 容器里(默认 true) server.jsp-servlet.init-parameters[param name] 设置 Jsp Servlet 初始化参数 server.servlet-path 主分发器 Servlet 的路径(默认:/) Session server.session.cookie.domain 回话 Cookie 的域 server.session.cookie.comment Cookie 注释 server.session.cookie.max-age Cookie 最大保存时间(单位 s) server.session.cookie.name Cookie 名称 server.session.cookie.timeout 超时时间 tomcat server.tomcat.accesslog.directory 创建日志文件的目录 server.tomcat.accesslog.enabled 是否开启访问日志(默认:false) server.tomcat.accesslog.pattern 访问日志的格式(默认:common) server.tomcat.accesslog.prefix 日志名前缀(默认:access_log) server.tomcat.accesslog.suffix 日志名后缀(默认:.log) server.tomcat.max-http-header-size Http 消息头最大字节数(默认:0) server.tomcat.uri-encoding 用来解码 URI 的字符编码 Cache spring.cache.cache-names 如果底层缓存管理器支持缓存名的话,可以在这里指定要创建的缓存名列表,用逗号分 隔。通常这会禁用运行时创建其他额外缓存的能力。 spring.cache.config 用来初始化 EhCache 的配置文件位置 spring.cache.guava.spec 用来创建缓存 Spec spring.cache.hazelcast.config 用来初始化 Hazeleast 的配置文件位置 spring.cache.infinispan.config 用来初始化 Infinispan 配置文件位置 spring.cache.jcache.config 用来初始化缓存管理器的配置文件的位置,配置文件依赖于底层的缓存实现 spring.cache.jcache.provider CachingProvider 实现的全限定类名,用来获取 JSR-107 兼容的缓存管理器,仅在 Classpath 里有不只一个 JSR-107 实现时才需要这个属性。 spring.cache.type 缓存类型,默认根据环境自动检测 Data spring.data.jpa.repositories.enabled 开启 JPA 仓库(默认:true) spring.data.mongodb.authentication-database 身份认证数据库名 spring.data.mongodb.database 数据库名 spring.data.mongodb.field-naming-strategy 要使用的 FieldNamingStrategy 的全限定名。 spring.data.mongodb.grid.fs.database GridFS 数据库名称 spring.data.mongodb.host MongoDB 服务器地址 spring.data.mongodb.username MongoDB 账号 spring.data.mongodb.password MongoDB 密码 spring.data.mongodb.port 端口号 spring.data.mongodb.repositories.enabled 开启 Mongo 仓库(默认值:true) spring.data.mongodb.uri Mongo 数据库 URI。设置了该属性后就主机和端口号会被忽略。(默认值: mongodb:// localhost/test) spring.data.rest.base-path 用于发布仓库资源的基本路径 spring.data.rest.default-page-size 分页数据的默认页大小(默认:20) spring.data.rest.limit-param-name 用于标识一次返回多少记录的 URL 查询字符串参数名。(默认值: size ) spring.data.rest.max-page-sieze : 最大分页大小(默认:1000) spring.data.rest.page-param-name URL 查询字符串参数的名称,用来标识返回哪一页。(默认值: page ) spring.data.rest.return-body-on-create 在创建实体后是否返回一个响应体(默认:false) spring.data.rest.return-body-on-update 在更新实体后是否返回一个响应体(默认:false) spring.data.rest.sort-param-name URL 查询字符串参数的名称,用来表示结果排序的方向(默认:name) spring.data.solr.host Solr 的主机地址。如果设置了 zk-host 则忽略该属性。(默认值: http://127.0.0.1: 8983/solr ) spring.data.solr.repositories.enabled 开启 solr 仓库(默认:true) spring.data.solr.zk-host zk 主机地址,格式为 "主机 - 端口" spring.datasource.allow-pool-suspension 是否允许池暂停(pool suspension)。在开启池暂停后会有性能会受到一定影响,除非你 真的需要这个功能(例如在冗余的系统下),否则不要开启它。该属性只在使用 Hikari 数 据库连接池时有用。(默认值: false 。) 欢迎加入Java高级架构学习交流群:468947140,获取Java工程化管理、高性能、分布式、高可用架构、zookeeper、Spring cloud,MyBatis,Netty源码分析和大数据等资料。 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=52j2FVO DataSource spring.datasource.name 数据源的名称。 spring.datasource.username 数据库的登录用户名。 spring.datasource.password 数据库的登录密码。 spring.datasource.url 数据库的 JDBC URL。 spring.datasource.jdbc-url 用来创建连接的 JDBC URL。 spring.datasource.driver-class-name JDBC 驱动的全限定类名。默认根据 URL 自动检测。 spring.datasource.pool-name 连接池名称。 spring.datasource.max-active 连接池中的最大活跃连接数。 spring.datasource.connection-timeout 连接超时(单位毫秒) spring.datasource.max-age 连接池中连接的最长寿命。 spring.datasource.max-idle 连接池中的最大空闲连接数。 spring.datasource.max-lifetime 连接池中连接的最长寿命(单位为毫秒)。 spring.datasource.max-open-prepared-statements 开启状态的 PreparedStatement 的数量上限。 spring.datasource.max-wait 连接池在等待返回连接时,最长等待多少毫秒再抛出异常。 spring.datasource.maximum-pool-size 连接池能达到的最大规模,包含空闲连接的数量和使用中的连接数量。 spring.datasource.min-evictable-idle-time-millis 一个空闲连接被空闲连接释放器(如果存在的话)优雅地释放前,最短会在连接池里停 留多少时间。 spring.datasource.min-idle 连接池里始终应该保持的最小连接数。(用于 DBCP 和 Tomcat 连接池。) spring.datasource.minimum-idle : HikariCP 试图在连接池里维持的最小空闲连接数。 spring.datasource.alternate-username-allowed 是否允许其它用户名 spring.datasource.auto-commit 更新操作是否自动提交 spring.datasource.abandon-when-percentage-full 一个百分比形势的阈值,超过该阈值则关闭并报告被弃用的连接 spring.datasource.catalog 默认的 Catalog 名称 spring.datasource.commit-on-return 在连接归还时,连接池是否要提交挂起的事务 spring.datasource.connection-init-sql 在所有新连接创建时都会执行的 SQL 语句,该语句会在连接加入连接池前执行。 spring.datasource.connection-init-sqls 在物理连接第一次创建时执行的 SQL 语句列表。(用于 DBCP 连接池。) spring.datasource.connection-properties.[key] 设置创建连接时使用的属性。(用于 DBCP 连接池。) spring.datasource.continue-on-error 初始化数据库时发生错误不要终止。(默认值: false) spring.datasource.data 指向数据(数据库操纵语言,Data Manipulation Language,DML)脚本资源的引用。 spring.datasource.data-source-class-name 用于获取连接的数据源的全限定类名。 spring.datasource.data-source-jndi 用于获取连接的数据源的 JNDI 位置。 spring.datasource.data-source-properties.[key] 设置创建数据源时使用的属性。(用于 Hikari 连接池。) spring.datasource.db-properties 设置创建数据源时使用的属性。(用于 Tomcat 连接池。) spring.datasource.default-auto-commit 连接上的操作是否自动提交。 spring.datasource.default-catalog 连接的默认 Catalog。 spring.datasource.default-read-only 连接的默认只读状态。 spring.datasource.default-transaction-isolation 连接的默认事务隔离级别。 spring.datasource.fair-queue 是否以 FIFO 方式返回连接。 spring.datasource.health-check-properties.[key] 设置要纳入健康检查的属性。(用于 Hikari 连接池。) spring.datasource.idle-timeout 连接池中的连接能保持闲置状态的最长时间,单位为毫秒。(默认值: 10 。) spring.datasource.ignore-exception-on-pre-load 初始化数据库连接池时是否要忽略连接。 spring.datasource.init-sql 在连接第一次创建时运行的自定义查询。 spring.datasource.initial-size 在连接池启动时要建立的连接数。 spring.datasource.initialization-fail-fast 在连接池创建时,如果达不到最小连接数是否要抛出异常。(默认值: true 。) spring.datasource.initialize 使用 data.sql 初始化数据库。(默认值: true 。) spring.datasource.isolate-internal-queries 是否要隔离内部请求。(默认值: false 。) spring.datasource.jdbc-interceptors 一个分号分隔的类名列表,这些类都扩展了 JdbcInterceptor 类。这些拦截器会插入 java.sql.Connection 对象的操作链里。(用于 Tomcat 连接池。) spring.datasource.jmx-enabled 开启 JMX 支持(如果底层连接池提供该功能的话)。(默认值: false 。) spring.datasource.jndi-name 数据源的 JNDI 位置。设置了该属性则忽略类、URL、用户名和密码属性。 spring.datasource.leak-detection-threshold 用来检测 Hikari 连接池连接泄露的阈值,单位为毫秒。 spring.datasource.log-abandoned 是否针对弃用语句或连接的应用程序代码记录下跟踪栈。用于 DBCP 连接池。(默认值: false 。) spring.datasource.log-validation-errors 在使用 Tomcat 连接池时是否要记录验证错误。 spring.datasource.login-timeout 连接数据库的超时时间(单位为秒)。 spring.datasource.num-tests-per-eviction-run 空闲对象释放器线程(如果存在的话)每次运行时要检查的对象数。 spring.datasource.platform 在 Schema 资源(schema-${platform}.sql)里要使用的平台。(默认值: all 。) spring.datasource.pool-prepared-statements 是否要将 Statement 放在池里。 spring.datasource.propagate-interrupt-state 对于等待连接的中断线程,是否要传播中断状态。 spring.datasource.read-only 在使用 Hikari 连接池时将数据源设置为只读。 spring.datasource.register-mbeans Hikari 连接池是否要注册 JMX MBean。 spring.datasource.remove-abandoned 被弃用的连接在到达弃用超时后是否应该被移除。 spring.datasource.remove-abandoned-timeout 连接在多少秒后应该考虑弃用。 spring.datasource.rollback-on-return 在连接归还连接池时,是否要回滚挂起的事务。 spring.datasource.schema Schema(数据定义语言,Data Definition Language,DDL)脚本资源的引用。 spring.datasource.separator SQL 初始化脚本里的语句分割符。(默认值: ; 。) spring.datasource.sql-script-encoding SQL 脚本的编码。 spring.datasource.suspect-timeout 在记录一个疑似弃用连接前要等待多少秒。 spring.datasource.test-on-borrow 从连接池中借用连接时是否要进行测试。 spring.datasource.test-on-connect 在建立连接时是否要进行测试。 spring.datasource.test-on-return 在将连接归还到连接池时是否要进行测试。 spring.datasource.test-while-idle 在连接空闲时是否要进行测试。 spring.datasource.time-between-eviction-runs-millis 在两次空闲连接验证、弃用连接清理和空闲池大小调整之间睡眠的毫秒数。 spring.datasource.transaction-isolation 在使用 Hikari 连接池时设置默认事务隔离级别。 spring.datasource.use-disposable-connection-facade 连接是否要用一个门面(facade)封装起来,在调用了 Connection.close() 后就不能 再使用这个连接了。 spring.datasource.use-equals 在比较方法名时是否使用 String.equals() 来代替 == 。 spring.datasource.use-lock 在操作连接对象时是否要加锁。 spring.datasource.validation-interval 执行连接验证的间隔时间,单位为毫秒。 spring.datasource.validation-query 在连接池里的连接返回给调用者或连接池时,要执行的验证 SQL 查询。 spring.datasource.validation-query-timeout 在连接验证查询执行失败前等待的超时时间,单位为秒。 spring.datasource.validation-timeout 在连接验证失败前等待的超时时间,单位为秒。(用于 Hikari 连接池。) spring.datasource.validator-class-name 可选验证器类的全限定类名,用于执行测试查询。 spring.datasource.xa.data-source-class-name XA 数据源的全限定类名。 spring.datasource.xa.properties 要传递给 XA 数据源的属性。 FreeMarker spring.freemarker.allow-request-override HttpServletRequest 的属性是否允许覆盖(隐藏)控制器生成的同名模型属性。 spring.freemarker.allow-session-override HttpSession 的属性是否允许覆盖(隐藏)控制器生成的同名模型属性。 spring.freemarker.cache 开启模板缓存。 spring.freemarker.charset 模板编码。 spring.freemarker.check-template-location 检查模板位置是否存在。 spring.freemarker.content-type Content-Type 的值。 spring.freemarker.enabled 开启 FreeMarker 的 MVC 视图解析。 spring.freemarker.expose-request-attributes 在模型合并到模板前,是否要把所有的请求属性添加到模型里。 spring.freemarker.expose-session-attributes 在模型合并到模板前,是否要把所有的 HttpSession 属性添加到模型里。 spring.freemarker.expose-spring-macro-helpers 是否发布供 Spring 宏程序库使用的 RequestContext ,并将命其名为 springMacro- RequestContext spring.freemarker.prefer-file-system-access 加载模板时优先通过文件系统访问。文件系统访问能够实时检测到模板变更。(默认值: true 。) spring.freemarker.prefix 在构建 URL 时添加到视图名称前的前缀。 spring.freemarker.request-context-attribute 在所有视图里使用的 RequestContext 属性的名称。 spring.freemarker.settings 要传递给 FreeMarker 配置的各种键。 spring.freemarker.suffix 在构建 URL 时添加到视图名称后的后缀。 spring.freemarker.template-loader-path 模板路径列表,用逗号分隔。(默认值: ["classpath:/templates/"] 。) spring.freemarker.view-names 可解析的视图名称的白名单。 Groovy spring.groovy.template.allow-request-override HttpServletRequest 的属性是否允许覆盖(隐藏)控制器生成的同名模型属性。 spring.groovy.template.allow-session-override HttpSession 的属性是否允许覆盖(隐藏)控制器生成的同名模型属性。 spring.groovy.template.cache 开启模板缓存。 spring.groovy.template.charset 模板编码。 spring.groovy.template.check-template-location 检查模板位置是否存在。 spring.groovy.template.configuration.auto-escape 模型变量在模板里呈现时是否要做转义。(默认值: false 。) spring.groovy.template.configuration.auto-indent 模板是否要自动呈现缩进。(默认值: false 。) spring.groovy.template.configuration.auto-indent-string 开启自动缩进时用于缩进的字符串,可以是 SPACES ,也可以是 TAB 。(默认值: SPACES 。) spring.groovy.template.configuration.auto-new-line 模板里是否要呈现新的空行。(默认值: false 。) spring.groovy.template.configuration.base-template-class 模板基类。 spring.groovy.template.configuration.cache-templates 模板是否应该缓存。(默认值: true 。) spring.groovy.template.configuration.declaration-encoding 用来写声明头的编码。 spring.groovy.template.configuration.expand-empty-elements 没有正文的元素该用短形式(例如, )还是扩展形式(例如, )来书 写。(默认值: false) spring.groovy.template.configuration.locale 设置模板地域。 spring.groovy.template.configuration.new-line-string 在自动空行开启后用来呈现空行的字符串。(默认为系统的 line.separator 属性值。) spring.groovy.template.configuration.resource-loader-path Groovy 模板的路径。(默认值: classpath:/templates/ 。) spring.groovy.template.configuration.use-double-quotes 属性是该用双引号还是单引号。(默认值: false 。) spring.groovy.template.content-type Content-Type 的值。 spring.groovy.template.enabled 开启 Groovy 模板的 MVC 视图解析。 spring.groovy.template.expose-request-attributes 在模型合并到模板前,是否要把所有的请求属性添加到模型里。 spring.groovy.template.expose-session-attributes 在模型合并到模板前,是否要把所有的 HttpSession 属性添加到模型里。 spring.groovy.template.expose-spring-macro-helpers 是否发布供 Spring 宏程序库使用的 RequestContext ,并将其命名为 springMacro- RequestContext spring.groovy.template.prefix 在构建 URL 时,添加到视图名称前的前缀。 spring.groovy.template.request-context-attribute 所有视图里使用的 RequestContext 属性的名称。 spring.groovy.template.resource-loader-path 模板路径(默认值: classpath:/ templates/ 。) spring.groovy.template.suffix 在构建 URL 时,添加到视图名称后的后缀。 spring.groovy.template.view-names 可解析的视图名称白名单。 H2 spring.h2.console.enabled 开启控制台。(默认值: false 。) spring.h2.console.path 可以找到控制台的路径。(默认值: /h2-console 。) Hornetq spring.hornetq.embedded.cluster-password 集群密码。默认在启动时随机生成。 spring.hornetq.embedded.data-directory 日志文件目录。如果关闭了持久化功能则不需要该属性。 spring.hornetq.embedded.enabled 如果有 HornetQ 服务器 API,则开启嵌入模式。(默认值: true 。) spring.hornetq.embedded.persistent 开启持久化存储。(默认值: false 。) spring.hornetq.embedded.queues 启动时要创建的队列列表,用逗号分隔。(默认值: [] 。) spring.hornetq.embedded.server-id 服务器 ID。默认使用自增长计数器。(默认值: 0 。) spring.hornetq.embedded.topics 启动时要创建的主题列表,用逗号分隔。(默认值: [] 。) spring.hornetq.host HornetQ 的主机。(默认值: localhost 。) spring.hornetq.mode HornetQ 的部署模式,默认为自动检测。可以显式地设置为 native 或 embedded 。 spring.hornetq.port HornetQ 的端口。(默认值: 5445 。) Http spring.http.converters.preferred-json-mapper HTTP 消息转换时优先使用 JSON 映射器。 spring.http.encoding.charset HTTP 请求和响应的字符集。如果没有显式地指定 Content-Type 头,则将该属性值作为 这个头的值。(默认值: UTF-8 。) spring.http.encoding.enabled 开启 HTTP 编码支持。(默认值: true 。) spring.http.encoding.force 强制将 HTTP 请求和响应编码为所配置的字符集。(默认值: true 。) Jackson spring.jackson.date-format 日期格式字符串(yyyy-MM-dd HH:mm:ss)或日期格式类的全限定类名。 spring.jackson.deserialization 影响 Java 对象反序列化的 Jackson on/off 特性。 spring.jackson.generator 用于生成器的 Jackson on/off 特性。 spring.jackson.joda-date-time-format Joda 日期时间格式字符串(yyyy-MM-dd HH:mm:ss)。如果没有配置,而 date-format 又配置了一个格式字符串的话,会将它作为降级配置。 spring.jackson.local e 用于格式化的地域值。 spring.jackson.mapper Jackson 的通用 on/off 特性。 spring.jackson.parser 用于解析器的 Jackson on/off 特性。 spring.jackson.property-naming-strategy Jackson 的 PropertyNamingStrategy 中的一个常量( CAMEL_CASE_TO_LOWERCASE WITH_UNDERSCORES )。也可以设置 PropertyNamingStrategy 的子类的全限定类名。 spring.jackson.serialization 影响 Java 对象序列化的 Jackson on/off 特性。 spring.jackson.serialization-inclusion 控制序列化时要包含哪些属性。可选择 Jackson 的 JsonInclude.Include 枚举里的某个值。 spring.jackson.time-zone 格式化日期时使用的时区。可以配置各种可识别的时区标识符,比如 America/Los_ Angeles 或者 GMT+10 。 Jersey spring.jersey.filter.order Jersey 过滤器链的顺序。(默认值: 0 。) spring.jersey.init 通过 Servlet 或过滤器传递给 Jersey 的初始化参数。 spring.jersey.type Jersey 集成类型。可以是 servlet 或者 filter 。 Jms spring.jms.jndi-name 连接工厂的 JNDI 名字。设置了该属性,则优先于其他自动配置的连接工厂。 spring.jms.listener.acknowledge-mode 容器的应答模式(acknowledgment mode)。默认情况下,监听器使用自动应答。 spring.jms.listener.auto-startup 启动时自动启动容器。(默认值: true 。) spring.jms.listener.concurrency 并发消费者的数量下限。 spring.jms.listener.max-concurrency 并发消费者的数量上限。 spring.jms.pub-sub-domain 如果是主题而非队列,指明默认的目的地类型是否支持 Pub/Sub。(默认值: false 。) Jmx spring.jmx.default-domain JMX 域名。 spring.jmx.enabled 将管理 Bean 发布到 JMX 域里。(默认值: true 。) spring.jmx.server MBeanServer 的 Bean 名称。(默认值: mbeanServer 。) Jpa spring.jpa.database 要操作的目标数据库,默认自动检测。也可以通过 databasePlatform 属性进行设置。 spring.jpa.database-platform 要操作的目标数据库,默认自动检测。也可以通过 Database 枚举来设置。 spring.jpa.generate-ddl 启动时要初始化 Schema。(默认值: false 。) spring.jpa.hibernate.ddl-auto DDL 模式( none 、 validate 、 update 、 create 和 create-drop )。这是 hibernate. hbm2ddl.auto 属性的一个快捷方式。在使用嵌入式数据库时,默认为 create-drop , 其他情况下默认为 none 。 spring.jpa.hibernate.naming-strategy Hibernate 命名策略的全限定类名。 spring.jpa.open-in-view 注册 OpenEntityManagerInViewInterceptor ,在请求的整个处理过程中,将一个 JPA EntityManager 绑定到线程上。(默认值: true) spring.jpa.properties JPA 提供方要设置的额外原生属性。 spring.jpa.show-sql 在使用 Bitronix Transaction Manager 时打开 SQL 语句日志。(默认值: false 。) Jta spring.jta.allow-multiple-lrc 在使用 Bitronix Transaction Manager 时,事务管理器是否应该允许一个事务涉及多个 LRC 资源。(默认值: false) spring.jta.asynchronous2-pc 在使用 Bitronix Transaction Manager 时,是否异步执行两阶段提交。(默认值: false 。) spring.jta.background-recovery-interval 在使用 Bitronix Transaction Manager 时,多久运行一次恢复过程,单位为分钟。(默认值: 1 ) spring.jta.background-recovery-interval-seconds 在使用 Bitronix Transaction Manager 时,多久运行一次恢复过程,单位为秒。(默认值: 60 ) spring.jta.current-node-only-recovery 在使用 Bitronix Transaction Manager 时,恢复是否要滤除不包含本 JVM 唯一 ID 的 XID。(默认值: true ) spring.jta.debug-zero-resource-transaction 在使用 Bitronix Transaction Manager 时,对于没有涉及任何资源的事务,是否要跟踪并记 录它们的创建和提交调用栈。(默认值: false) spring.jta.default-transaction-timeout 在使用 Bitronix Transaction Manager 时,默认的事务超时时间,单位为秒。(默认值: 60 。) spring.jta.disable-jmx 在使用 Bitronix Transaction Manager 时,是否要禁止注册 JMX MBean。(默认值: false 。) spring.jta.enabled 开启 JTA 支持。(默认值: true 。) spring.jta.exception-analyzer 在使用 Bitronix Transaction Manager 时用到的异常分析器。设置为 null 时使用默认异常分析器,也可以设置自定义异常分析器的全限定类名。 spring.jta.filter-log-status 在使用 Bitronix Transaction Manager 时,是否只记录必要的日志。开启该参数时能减少分 段(fragment)空间用量,但调试更复杂了。(默认值: false) spring.jta.force-batching-enabled 在使用 Bitronix Transaction Manager 时,是否批量输出至磁盘。禁用批处理会严重降低事 务管理器的吞吐量。(默认值: true 。) spring.jta.forced-write-enabled 在使用 Bitronix Transaction Manager 时,日志是否强制写到磁盘上。在生产环境里不要设 置为 false ,因为不强制写到磁盘上无法保证完整性。(默认值: true) spring.jta.graceful-shutdown-interval 在使用 Bitronix Transaction Manager 时,要关闭的话,事务管理器在放弃事务前最多等它 多少秒。(默认值: 60) spring.jta.jndi-transaction-synchronization-registry-name 在使用 Bitronix Transaction Manager 时,事务同步注册表应该绑定到哪个 JNDI 下。(默认 值: java:comp/TransactionSynchronizationRegistry) spring.jta.jndi-user-transaction-name 在使用 Bitronix Transaction Manager 时,用户事务应该绑定到哪个 JNDI 下。(默认值: java:comp/UserTransaction 。) spring.jta.journal 在使用 Bitronix Transaction Manager 时,要用的日志名。可以是 disk 、 null 或者全限定类 名。(默认值: disk 。) spring.jta.log-dir 事务日志目录。 spring.jta.log-part1-filename 日志分段文件 1 的名称。(默认值: btm1.tlog 。) spring.jta.log-part2-filename 日志分段文件 2 的名称。(默认值: btm2.tlog 。) spring.jta.max-log-size-in-mb 在使用 Bitronix Transaction Manager 时,日志分段文件的最大兆数。日志越大,事务就被 允许在未终结状态停留越长时间。但是,如果文件大小限制得太小,事务管理器在分段 满了的时候就会暂停更长时间。(默认值: 2 。) spring.jta.resource-configuration-filename Bitronix Transaction Manager 的配置文件名。 spring.jta.server-id 唯一标识 Bitronix Transaction Manager 实例的 ID。 spring.jta.skip-corrupted-logs 是否跳过损坏的日志文件。(默认值: false 。) spring.jta.transaction-manager-id 事务管理器的唯一标识符。 spring.jta.warn-about-zero-resource-transaction 在使用 Bitronix Transaction Manager 时,是否要对执行时没有涉及任何资源的事务作出告 警。(默认值: true 。) Mail spring.mail.default-encoding 默认的 MimeMessage 编码。(默认值: UTF-8 。) spring.mail.host SMTP 服务器主机地址。 spring.mail.jndi-name 会话的 JNDI 名称。设置之后,该属性的优先级要高于其他邮件设置。 spring.mail.password SMTP 服务器的登录密码。 spring.mail.port SMTP 服务器的端口号。 spring.mail.properties 附加的 JavaMail 会话属性。 spring.mail.protocol SMTP 服务器用到的协议。(默认值: smtp 。) spring.mail.test-connection 在启动时测试邮件服务器是否可用。(默认值: false 。) spring.mail.username SMTP 服务器的登录用户名。 Messages spring.messages.basename 逗号分隔的基本名称列表,都遵循 ResourceBundle 的惯例。本质上这就是一个全限定 的 Classpath 位置,如果不包含包限定符(比如 org.mypackage ),就会从 Classpath 的根部开始解析。(默认值: messages 。) spring.messages.cache-seconds 加载的资源包文件的缓存失效时间,单位为秒。在设置为 -1 时,包会永远缓存。(默认值: -1 。) spring.messages.encoding 消息包的编码。(默认值: UTF-8 。) Mobile spring.mobile.devicedelegatingviewresolver.enable-fallback 开启降级解析支持。(默认值: false 。) spring.mobile.devicedelegatingviewresolver.enabled 开启设备视图解析器。(默认值: false 。) spring.mobile.devicedelegatingviewresolver.mobile-prefix 添加到移动设备视图名前的前缀。(默认值: mobile/ 。) spring.mobile.devicedelegatingviewresolver.mobile-suffix 添加到移动设备视图名后的后缀。 spring.mobile.devicedelegatingviewresolver.normal-prefix 添加到普通设备视图名前的前缀。 spring.mobile.devicedelegatingviewresolver.normal-suffix 添加到普通设备视图名后的后缀。 spring.mobile.devicedelegatingviewresolver.tablet-prefix 添加到平板设备视图名前的前缀。(默认值: tablet/ 。) spring.mobile.devicedelegatingviewresolver.tablet-suffix 添加到平板设备视图名后的后缀。 spring.mobile.sitepreference.enabled 开启 SitePreferenceHandler 。(默认值: true 。) Mongodb spring.mongodb.embedded.features 要开启的特性列表,用逗号分隔。 spring.mongodb.embedded.version 要使用的 Mongo 版本。(默认值: 2.6.10 。) Mustache spring.mustache.cache 开启模板缓存。 spring.mustache.charset 模板编码。 spring.mustache.check-template-location 检查模板位置是否存在。 spring.mustache.content-type Content-Type 的值。 spring.mustache.enabled 开启 Mustache 的 MVC 视图解析。 spring.mustache.prefix 添加到模板名前的前缀。(默认值: classpath:/ templates/ 。) spring.mustache.suffix 添加到模板名后的后缀。(默认值: .html 。) spring.mustache.view-names 可解析的视图名称的白名单。 Mvc spring.mvc.async.request-timeout 异步请求处理超时前的等待时间(单位为毫秒)。如果没有设置该属性,则使用底层实现 的默认超时时间,比如,Tomcat 上使用 Servlet 3 时超时时间为 10 秒。 spring.mvc.date-format 要使用的日期格式(比如 dd/MM/yyyy )。 spring.mvc.favicon.enabled 开启 favicon.ico 的解析。(默认值: true 。) spring.mvc.ignore-default-model-on-redirect 在重定向的场景下,是否要忽略“默认”模型对象的内容。(默认值: true 。) spring.mvc.locale 要使用的地域配置。 spring.mvc.message-codes-resolver-format 消息代码格式( PREFIX_ERROR_CODE 、 POSTFIX_ERROR_CODE )。 spring.mvc.view.prefix Spring MVC 视图前缀。 spring.mvc.view.suffix Spring MVC 视图后缀。 Mybatis mybatis.mapper-locations mybatis 映射文件位置。mybatis.type-aliases-package 别名包位置。 Rabbitmq spring.rabbitmq.addresses 客户端应该连接的地址列表,用逗号分隔。 spring.rabbitmq.dynamic 创建一个 AmqpAdmin Bean。(默认值: true 。) spring.rabbitmq.host RabbitMQ 主机地址。(默认值: localhost 。) spring.rabbitmq.listener.acknowledge-mode 容器的应答模式。 spring.rabbitmq.listener.auto-startup 启动时自动开启容器。(默认值: true 。) spring.rabbitmq.listener.concurrency 消费者的数量下限。 spring.rabbitmq.listener.max-concurrency 消费者的数量上限。 spring.rabbitmq.listener.prefetch 单个请求里要处理的消息数。该数值不应小于事务数(如果用到的话)。 spring.rabbitmq.listener.transaction-size 一个事务里要处理的消息数。为了保证效果,应该不大于预先获取的数量。 spring.rabbitmq.password 进行身份验证的密码。 spring.rabbitmq.port RabbitMQ 端口。(默认值: 5672 。) spring.rabbitmq.requested-heartbeat 请求心跳超时,单位为秒; 0 表示不启用心跳。 spring.rabbitmq.ssl.enabled 开启 SSL 支持。(默认值: false 。) spring.rabbitmq.ssl.key-store 持有 SSL 证书的 KeyStore 路径。 spring.rabbitmq.ssl.key-store-password 访问 KeyStore 的密码。 spring.rabbitmq.ssl.trust-store 持有 SSL 证书的 TrustStore。 spring.rabbitmq.ssl.trust-store-password 访问 TrustStore 的密码。 spring.rabbitmq.username 进行身份验证的用户名。 spring.rabbitmq.virtual-host 在连接 RabbitMQ 时的虚拟主机。 Redis spring.redis.database 连接工厂使用的数据库索引。(默认值: 0 。) spring.redis.host Redis 服务器主机地址。(默认值: localhost 。) spring.redis.password Redis 服务器的登录密码。 spring.redis.pool.max-active 连接池在指定时间里能分配的最大连接数。负数表示无限制。(默认值: 8 。) spring.redis.pool.max-idle 连接池里的最大空闲连接数。负数表示空闲连接数可以是无限大。(默认值: 8 。) spring.redis.pool.max-wait 当连接池被耗尽时,分配连接的请求应该在抛出异常前被阻塞多长时间(单位为秒)。负 数表示一直阻塞。(默认值: -1 。) spring.redis.pool.min-idle 连接池里要维持的最小空闲连接数。该属性只有在设置为正数时才有效。(默认值: 0 。) spring.redis.port Redis 服务器端口。(默认值: 6379 。) spring.redis.sentinel.master Redis 服务器的名字。 spring.redis.sentinel.nodes 形如“主机: 端口”配对的列表,用逗号分隔。 spring.redis.timeout 连接超时时间,单位为秒。(默认值: 0 。) Resources spring.resources.add-mappings 开启默认资源处理。(默认值: true 。) spring.resources.cache-period 资源处理器对资源的缓存周期,单位为秒。 spring.resources.chain.cache 对资源链开启缓存。(默认值: true 。) spring.resources.chain.enabled 开启 Spring 资源处理链。(默认关闭的,除非至少开启了一个策略。) spring.resources.chain.html-application-cache 开启 HTML5 应用程序缓存证明重写。(默认值: false 。) spring.resources.chain.strategy.content.enabled 开启内容版本策略。(默认值: false 。) spring.resources.chain.strategy.content.paths 要运用于版本策略的模式列表,用逗号分隔。(默认值: [/**] 。) spring.resources.chain.strategy.fixed.enabled 开启固定版本策略。(默认值: false 。) spring.resources.chain.strategy.fixed.paths 要运用于固定版本策略的模式列表,用逗号分隔。 spring.resources.chain.strategy.fixed.version 用于固定版本策略的版本字符串。 spring.resources.static-locations 静态资源位置。默认为 classpath: [/META-INF/resources/, /resources/, /static/, /public/] 加上 context:/(Servlet 上下文的根目录)。 SendGrid spring.sendgrid.password SendGrid 密码。 spring.sendgrid.proxy.host SendGrid 代理主机地址。 spring.sendgrid.proxy.port SendGrid 代理端口。 spring.sendgrid.username SendGrid 用户名。 Social spring.social.auto-connection-views 针对所支持的提供方开启连接状态视图。(默认值: false 。) spring.social.facebook.app-id 应用程序 ID。 spring.social.facebook.app-secret 应用程序的密钥。 spring.social.linkedin.app-id 应用程序 ID。 spring.social.linkedin.app-secret 应用程序的密钥。 spring.social.twitter.app-id 应用程序 ID。 spring.social.twitter.app-secret 应用程序的密钥。 Thymeleaf spring.thymeleaf.cache 开启模板缓存。(默认值: true 。) spring.thymeleaf.check-template-location 检查模板位置是否存在。(默认值: true 。) spring.thymeleaf.content-type Content-Type 的值。(默认值: text/html 。) spring.thymeleaf.enabled 开启 MVC Thymeleaf 视图解析。(默认值: true 。) spring.thymeleaf.encoding 模板编码。(默认值: UTF-8 。) spring.thymeleaf.excluded-view-names 要被排除在解析之外的视图名称列表,用逗号分隔。 spring.thymeleaf.mode 要运用于模板之上的模板模式。另见 StandardTemplate- ModeHandlers 。(默认值: HTML5 。) spring.thymeleaf.prefix 在构建 URL 时添加到视图名称前的前缀。(默认值: classpath:/templates/ 。) spring.thymeleaf.suffix 在构建 URL 时添加到视图名称后的后缀。(默认值: .html 。) spring.thymeleaf.template-resolver-order Thymeleaf 模板解析器在解析器链中的顺序。默认情况下,它排在第一位。顺序从 1 开始只有在定义了额外的 TemplateResolver Bean 时才需要设置这个属性。 spring.thymeleaf.view-names 可解析的视图名称列表,用逗号分隔。 Velocity spring.velocity.allow-request-override HttpServletRequest 的属性是否允许覆盖(隐藏)控制器生成的同名模型属性。 spring.velocity.allow-session-override HttpSession` 的属性是否允许覆盖(隐藏)控制器生成的同名模型属性。 spring.velocity.cache 开启模板缓存。 spring.velocity.charset 模板编码。 spring.velocity.check-template-location 检查模板位置是否存在。 spring.velocity.content-type Content-Type 的值。 spring.velocity.date-tool-attribute DateTool 辅助对象在视图的 Velocity 上下文里呈现的名字。 spring.velocity.enabled 开启 Velocity 的 MVC 视图解析。 spring.velocity.expose-request-attributes 在模型合并到模板前,是否要把所有的请求属性添加到模型里。 spring.velocity.expose-session-attributes 在模型合并到模板前,是否要把所有的 HttpSession 属性添加到模型里。 spring.velocity.expose-spring-macro-helpers 是否发布供 Spring 宏程序库使用的 RequestContext ,并将其名命为 springMacro- RequestContext 。 spring.velocity.number-tool-attribute NumberTool 辅助对象在视图的 Velocity 上下文里呈现的名字。 spring.velocity.prefer-file-system-access 加载模板时优先通过文件系统访问。文件系统访问能够实时检测到模板变更。(默认值: true 。) spring.velocity.prefix 在构建 URL 时添加到视图名称前的前缀。 spring.velocity.properties 额外的 Velocity 属性。 spring.velocity.request-context-attribute 所有视图里使用的 Request- Context 属性的名称。 spring.velocity.resource-loader-path 模板路径。(默认值: classpath:/ templates/ 。) spring.velocity.suffix 在构建 URL 时添加到视图名称后的后缀。 spring.velocity.toolbox-config-location Velocity Toolbox 的配置位置,比如 /WEB-INF/toolbox.xml。自动加载 Velocity Tools 工具定 义文件,将所定义的全部工具发布到指定的作用域内。 spring.velocity.view-names 可解析的视图名称白名单。 View spring.view.prefix Spring MVC 视图前缀。 spring.view.suffix Spring MVC 视图后缀。 其它 spring.aop.auto 添加 @EnableAspectJAutoProxy(默认:true) spring.application.admin.enabled 开启应用程序的管理功能 (默认:false) spring.artemis.embedded.cluster-password 集群密码。默认在启东市随机生成 spring.artemis.embedded.persistent 开启持久化存储 (默认:false) spring.autoconfigure.exclude 要排除的自动配置类 欢迎加入Java高级架构学习交流群:468947140,获取Java工程化管理、高性能、分布式、高可用架构、zookeeper、Spring cloud,MyBatis,Netty源码分析和大数据等资料。 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=52j2FVO
优秀的个人博客,低调大师

Java编程——jvm优化之 图解垃圾回收

多世纪,目前已经十分成熟了。因此本篇主要从这两个方面来了解: 1. 哪些对象需要被回收? 2. 如何回收? 一、谁要被回收 java虚拟机在执行java程序的过程中会把它所管理的内存划分为若干个不同是数据区域,这些区域有各自各自的用途。主要包含以下几个部分组成: 1、程序计数器 程序计数器占用的内存空间我们可以忽略不计,它是每个线程所执行的字节码的行号指示器。 2、虚拟机栈 java的虚拟机栈是线程私有的,生命周期和线程相同。它描述的是方法执行的内存模型。同时用于存储局部变量、操作数栈、动态链接、方法出口等。 3、本地方法栈 本地方法栈,类似虚拟机栈,它调用的是是native方法。 4、堆 堆是jvm中管理内存中最大一块。它是被共享,存放对象实例。也被称为“gc堆”。垃圾回收的主要管理区域 5、方法区 方法区也是共享的内存区域。它主要存储已被虚拟机加载的类信息、常量、静态变量、即时编译器(jit)编译后的代码数据。 以上就是jvm在运行时期主要的内存组成,我们看到常见的内存使用不但存在于堆中,还会存在于其他区域,虽然堆的管理对程序的管理至关重要,但我们不能只局限于这一个区域,特别是当出现内存泄露的时候,我们除了要排查堆内存的情况,还得考虑虚拟机栈的以及方法区域的情况。 知道了要对谁以及那些区域进行内存管理,我还需要知道什么时候对这些区域进行垃圾回收。 二、如何回收 上述的两点讲解之后,我们大概明白了,哪些对象会被回收,以及回收的依据是什么,但回收的这个工作实现起来并不简单,首先它需要扫描所有的对象,鉴别谁能够被回收,其次在扫描期间需要 ”stop the world“ 对象能被冻结,不然你刚扫描,他的引用信息有变化,你就等于白做了。 分代回收 我们从一个object1来说明其在分代垃圾回收算法中的回收轨迹。 1、object1新建,出生于新生代的Eden区域。 2、minor GC,object1 还存活,移动到Fromsuvivor空间,此时还在新生代。 3、minor GC,object1 仍然存活,此时会通过复制算法,将object1移动到ToSuv区域,此时object1的年龄age+1。 4、minor GC,object1 仍然存活,此时survivor中和object1同龄的对象并没有达到survivor的一半,所以此时通过复制算法,将fromSuv和Tosuv 区域进行互换,存活的对象被移动到了Tosuv。 5、minor GC,object1 仍然存活,此时survivor中和object1同龄的对象已经达到survivor的一半以上(toSuv的区域已经满了),object1被移动到了老年代区域。 6、object1存活一段时间后,发现此时object1不可达GcRoots,而且此时老年代空间比率已经超过了阈值,触发了majorGC(也可以认为是fullGC,但具体需要垃圾收集器来联系),此时object1被回收了。fullGC会触发 stop the world。 在以上的新生代中,我们有提到对象的age,对象存活于survivor状态下,不会立即晋升为老生代对象,以避免给老生代造成过大的影响,它们必须要满足以下条件才可以晋升: 1、minor gc 之后,存活于survivor 区域的对象的age会+1,当超过(默认)15的时候,转移到老年代。 2、动态对象,如果survivor空间中相同年龄所有的对象大小的综合和大于survivor空间的一半,年级大于或等于该年级的对象就可以直接进入老年代。 以上采用分代垃圾收集的思想,对一个对象从存活到死亡所经历的历程。期间,在新生代的时刻,会用到复制算法,在老年代时,有可能会用到标记-清楚算法(mark-sweep)算法或者标记-整理算法,这些都是垃圾回收算法基于不同区域的实现,我们看下这几种回收算法的实现原理。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5zMN6JB 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导 欢迎关注,欢迎留言探讨。

优秀的个人博客,低调大师

Java并发编程笔记之基础总结(一)

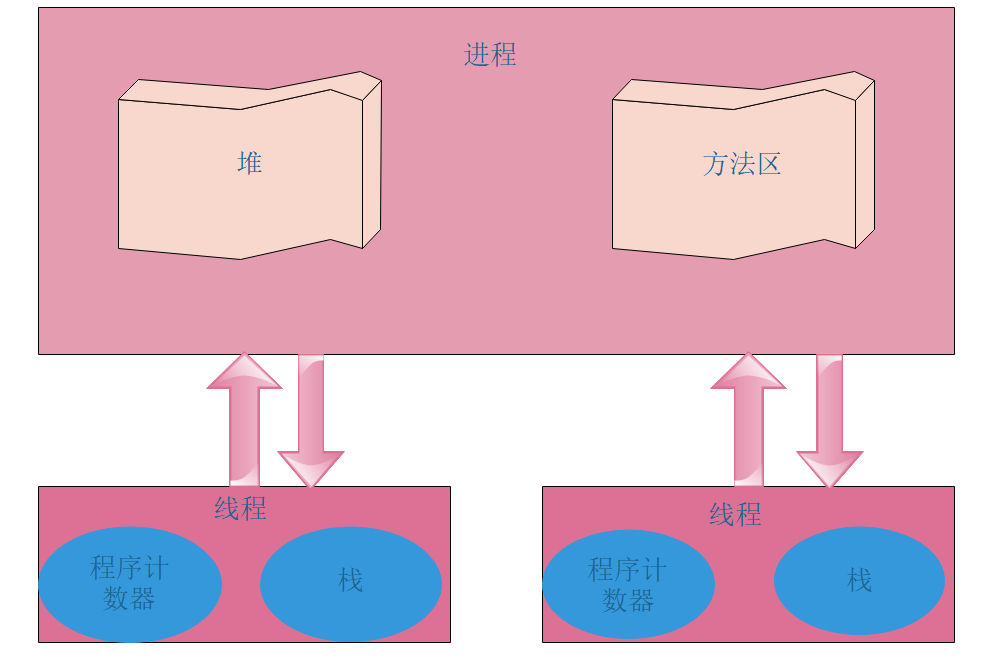
一.线程概念 说到线程就必须要提一下进程,因为线程是进程中的一个实体,线程本身是不会独立存在的。进程是代码在数据集合上的一次运行活动,是系统进行资源分配和调度的基本单位,线程则是进程的一个执行路径,一个进程至少有一个线程,进程中的多个线程是共享进程的资源的。操作系统在分配资源时候是把资源分配给进程的,但是 CPU 资源就比较特殊,它是分派到线程的,因为真正要占用 CPU 运行的是线程,所以也说线程是 CPU 分配的基本单位。 Java 中当我们启动 main 函数时候其实就启动了一个 JVM 的进程,而 main 函数所在线程就是这个进程中的一个线程,也叫做主线程。 如上图一个进程中有多个线程,多个线程共享进程的堆和方法区资源,但是每个线程有自己的程序计数器,栈区域。、 其中程序计数器是一块内存区域,用来记录线程当前要执行的指令地址,那么程序计数器为何要设计为线程私有的呢? 前面说了线程是占用 CPU 执行的基本单位,而 CPU 一般是使用时间片轮转方式让线程轮询占用的,所以当前线程 CPU 时间片用完后,要让出 CPU,等下次轮到自己时候在执行。 那么如何知道之前程序执行到哪里了? 其实程序计数器就是为了记录该线程让出 CPU 时候的执行地址,待再次分配到时间片时候就可以从自己私有的计数器指定地址继续执行了。 另外每个线程有自己的栈资源,用于存储该线程的局部变量,这些局部变量是该线程私有的,其它线程是访问不了的,另外栈还用来存放线程的调用栈帧。 堆是一个进程中最大的一块内存,堆是被进程中的所有线程共享的,是进程创建时候分配的,堆里面主要存放使用 new 操作创建的对象实例。 方法区则是用来存放进程中的代码片段的,是线程共享的。 二.线程创建方式与运行 Java 中有三种线程创建方法,分别为实现 Runnable 接口的run方法、继承 Thread 类并重写 run 方法、使用 FutureTask 方式。 1.继承 Thread 方法的实现,如下所示: /** * Created by cong on 2018/7/17. */ public class ThreadTest { //继承Thread类并重写run方法 public static class MyThread extends Thread { @Override public void run() { System.out.println("-----子线程-----"); } } public static void main(String[] args) { // 创建线程 MyThread thread = new MyThread(); // 启动线程 thread.start(); } } 运行结果如下: 如上代码 MyThread 类继承了 Thread 类,并重写了 run 方法,然后调用了线程的 start 方法启动了线程,当创建完 thread 对象后该线程并没有被启动执行.当调用了 start 方法后才是真正启动了线程。其实当调用了 start 方法后线程并没有马上执行而是处于就绪状态,这个就绪状态是指该线程已经获取了除 CPU 资源外的其它资源,等获取 CPU 资源后才会真正处于运行状态。 当 run 方法执行完毕,该线程就处于终止状态了。使用继承方式好处是 run 方法内获取当前线程直接使用 this 就可以,无须使用 Thread.currentThread() 方法,不好的地方是 Java 不支持多继承,如果继承了 Thread 类那么就不能再继承其它类,另外任务与代码没有分离,当多个线程执行一样的任务时候需要多份任务代码,而 Runable 则没有这个限制。 2.实现 Runnable 接口的 run 方法方式,例子如下所示: /** * Created by cong on 2018/7/17. */ public class RunableTest implements Runnable { @Override public void run() { System.out.println("----子线程----"); } public static void main(String[] args) throws InterruptedException{ RunableTest runableTest = new RunableTest(); new Thread(runableTest).start(); new Thread(runableTest).start(); } } 运行结果如下: 如上面代码,两个线程公用一个 task 代码逻辑,需要的话 RunableTask 可以添加参数进行任务区分,另外 RunableTask 可以继承其他类,但是上面两种方法都有一个缺点就是任务没有返回值, 3.使用 FutureTask方式,例子如下所示: /** * Created by cong on 2018/7/17. */ public class FutureTaskTest implements Callable<String> { @Override public String call() throws Exception { return "hello"; } public static void main(String[] args) throws InterruptedException { // 创建异步任务 FutureTask<String> futureTask = new FutureTask<>(new FutureTaskTest()); //启动线程 new Thread(futureTask).start(); try { //等待任务执行完毕,并返回结果 String result = futureTask.get(); System.out.println(result); } catch (ExecutionException e) { e.printStackTrace(); } } } 运行结果如下: 总结:每种方式都有自己的优缺点,应该根据实际场景进行选择。 三.线程通知与等待 Java 中 Object 类是所有类的父类,鉴于继承机制,Java 把所有类都需要的方法放到了 Object 类里面,其中就包含本节要讲的通知等待系列函数,这些通知等待函数是组成并发包中线程同步组件的基础。 下面讲解下 Object 中关于线程同步的通知等待函数。如下所示: 1.void wait() 方法:首先谈下什么是共享资源,所谓共享资源是说该资源被多个线程共享,多个线程都可以去访问或者修改的资源。当一个线程调用一个共享对象的 wait() 方法时候,调用线程会被阻塞挂起,直到下面几个事情之一发生才返回: 其它线程调用了该共享对象的 notify() 或者 notifyAll() 方法; 其它线程调用了该线程的 interrupt() 方法设置了该线程的中断标志,该线程会抛出 InterruptedException 异常返回 另外需要注意的是如果调用 wait() 方法的线程没有事先获取到该对象的监视器锁,则调用 wait() 方法时候调用线程会抛出 IllegalMonitorStateException 异常。 那么一个线程如何获取到一个共享变量的监视器呢? 1.执行使用 synchronized 同步代码块时候,使用该共享变量作为参数,例子如下: synchronized(共享变量){ //doSomething } 2.调用该共享变量的方法,并且该方法使用了 synchronized 修饰,代码如下: synchronized void add(int a,int b){ //doSomething } 另外需要注意的是一个线程可以从挂起状态变为可以运行状态(也就是被唤醒)即使该线程没有被其它线程调用 notify(),notifyAll() 进行通知,或者被中断,或者等待超时,这就是所谓的虚假唤醒。 虽然虚假唤醒在应用实践中很少发生,但是还是需要防范于未然的,做法就是不停的去测试该线程被唤醒的条件是否满足,不满足则继续等待,也就是说在一个循环中去调用 wait() 方法进行防范,退出循环的条件是条件满足了唤醒该线程。代码如下: synchronized (obj) { while (条件不满足){ obj.wait(); } } 如上代码是经典的调用共享变量 wait() 方法的实例,首先通过同步块获取 obj 上面的监视器锁,然后通过 while 循环内调用 obj 的 wait() 方法。 下面从生产者消费者例子来加深理解,例子如下: 生产者: //生产线程 synchronized (queue) { //消费队列满,则等待队列空闲 while (queue.size() == MAX_SIZE) { try { //挂起当前线程,并释放通过同步块获取的queue上面的锁,让消费线程可以获取该锁,然后获取队列里面元素 queue.wait(); } catch (Exception ex) { ex.printStackTrace(); } } //空闲则生成元素,并通知消费线程 queue.add(ele); queue.notifyAll(); } } 消费者: //消费线程 synchronized (queue) { //消费队列为空 while (queue.size() == 0) { try { //挂起当前线程,并释放通过同步块获取的queue上面的锁,让生产线程可以获取该锁,生产元素放入队列 queue.wait(); } catch (Exception ex) { ex.printStackTrace(); } } //消费元素,并通知唤醒生产线程 queue.take(); queue.notifyAll(); } 如上面代码所示是一个生产者的例子,其中 queue 为共享变量,生产者线程在调用 queue 的 wait 方法前,通过使用 synchronized 关键字拿到了该共享变量 queue 的监视器,所以调用 wait() 方法才不会抛出 IllegalMonitorStateException 异常,如果当前队列没有空闲容量则会调用 queued 的 wait() 挂起当前线程,这里使用循环就是为了避免上面说的虚假唤醒问题,这里假如当前线程虚假唤醒了,但是队列还是没有空余容量的话,当前线程还是会调用 wait() 把自己挂起。 另外当一个线程调用了共享变量的 wait() 方法后该线程会被挂起,同时该线程会暂时释放对该共享变量监视器的持有,直到另外一个线程调用了共享变量的 notify() 或者 notifyAll() 方法才有可能会重新获取到该共享变量的监视器的持有权(这里说有可能,是因为考虑到多个线程第一次都调用了 wait() 方法,所以多个线程会竞争持有该共享变量的监视器)。、 接下来讲解下调用共享变量 wait() 方法后当前线程会释放持有的共享变量的锁的理解。 如上代码假如生产线程 A 首先通过 synchronized 获取到了 queue 上的锁,那么其它生产线程和所有消费线程都会被阻塞,线程 A 获取锁后发现当前队列已满会调用 queue.wait() 方法阻塞自己,然后会释放获取的 queue 上面的锁,这里考虑下为何要释放该锁?如果不释放,由于其它生产线程和所有消费线程已经被阻塞挂起,而线程 A 也被挂起,这就处于了死锁状态。这里线程 A 挂起自己后释放共享变量上面的锁就是为了打破死锁必要条件之一的持有并等待原则。关于死锁下面章节会有讲到,线程 A 释放锁后其它生产线程和所有消费线程中会有一个线程获取 queue 上的锁进而进入同步块,这就打破了死锁。 最后再举一个例子说明当一个线程调用共享对象的 wait() 方法被阻塞挂起后,如果其它线程中断了该线程,则该线程会抛出 InterruptedException 异常后返回,代码如下: /** * Created by cong on 2018/7/17. */ public class WaitNotifyInteruptTest { static Object obj = new Object(); public static void main(String[] args) throws InterruptedException { //创建线程 Thread threadA = new Thread(new Runnable() { public void run() { try { System.out.println("---开始---"); //阻塞当前线程 obj.wait(); System.out.println("---结束---"); } catch (InterruptedException e) { e.printStackTrace(); } } }); threadA.start(); Thread.sleep(1000); System.out.println("---开始打断线程A---"); threadA.interrupt(); System.out.println("---线程A已经被打断---"); } } 运行结果如下: 如上代码 threadA 调用了共享对 obj 的 wait() 方法后阻塞挂起了自己,然后主线程在休眠1s后中断了 threadA 线程,可知中断后 threadA 在 obj.wait() 处抛出了 java.lang.IllegalMonitorStateException 异常后返回后终止。 2.void wait(long timeout) 方法:该方法相比 wait() 方法多一个超时参数,不同在于如果一个线程调用了共享对象的该方法挂起后,如果没有在指定的 timeout ms 时间内被其它线程调用该共享变量的 notify() 或者 notifyAll() 方法唤醒,那么该函数还是会因为超时而返回。需要注意的是如果在调用该函数时候 timeout 传递了负数会抛出 IllegalArgumentException 异常。 3.void wait(long timeout, int nanos) 方法:内部是调用 wait(long timeout),如下代码:只是当 nanos>0 时候让参数一递增1。源码如下: public final void wait(long timeout, int nanos) throws InterruptedException { if (timeout < 0) { throw new IllegalArgumentException("timeout value is negative"); } if (nanos < 0 || nanos > 999999) { throw new IllegalArgumentException( "nanosecond timeout value out of range"); } if (nanos > 0) { timeout++; } wait(timeout); } 4.void notify() 方法:一个线程调用共享对象的 notify() 方法后,会唤醒一个在该共享变量上调用 wait 系列方法后被挂起的线程,一个共享变量上可能会有多个线程在等待,具体唤醒哪一个等待的线程是随机的。另外被唤醒的线程不能马上从 wait 返回继续执行,它必须获取了共享对象的监视器后才可以返回,也就是唤醒它的线程释放了共享变量上面的监视器锁后,被唤醒它的线程也不一定会获取到共享对象的监视器,这是因为该线程还需要和其它线程一块竞争该锁,只有该线程竞争到了该共享变量的监视器后才可以继续执行。 类似 wait 系列方法,只有当前线程已经获取到了该共享变量的监视器锁后,才可以调用该共享变量的 notify() 方法,否者会抛出 IllegalMonitorStateException 异常。 5.void notifyAll() 方法:不同于 nofity() 方法在共享变量上调用一次就会唤醒在该共享变量上调用 wait 系列方法被挂起的一个线程,notifyAll() 则会唤醒所有在该共享变量上由于调用 wait 系列方法而被挂起的线程。 最后讲一个例子来说明 notify() 和 notifyAll() 的具体含义和一些需要注意的地方,代码实例如下: /** * Created by cong on 2018/7/17. */ public class Test1 { private static volatile Object resourceA = new Object(); public static void main(String[] args) throws InterruptedException { // 创建线程 Thread threadA = new Thread(new Runnable() { public void run() { // 获取resourceA共享资源的监视器锁 synchronized (resourceA) { System.out.println("threadA get resourceA lock"); try { System.out.println("threadA begin wait"); resourceA.wait(); System.out.println("threadA end wait"); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } }); // 创建线程 Thread threadB = new Thread(new Runnable() { public void run() { synchronized (resourceA) { System.out.println("threadB get resourceA lock"); try { System.out.println("threadB begin wait"); resourceA.wait(); System.out.println("threadB end wait"); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } }); // 创建线程 Thread threadC = new Thread(new Runnable() { public void run() { synchronized (resourceA) { System.out.println("threadC begin notify"); resourceA.notifyAll(); } } }); // 启动线程 threadA.start(); threadB.start(); Thread.sleep(1000); threadC.start(); // 等待线程结束 threadA.join(); threadB.join(); threadC.join(); System.out.println("main over"); } } 运行结果如下: 如上代码开启了三个线程,其中线程 A 和 B 分别调用了共享资源 resourceA 的 wait() 方法,线程 C 则调用了 nofity() 方法。 这里启动线程 C 前首先调用 sleep 方法让主线程休眠 1s,目的是让线程 A 和 B 全部执行到调用 wait 方法后在调用线程 C 的 notify 方法。 这个例子企图希望在线程 A 和线程 B 都因调用共享资源 resourceA 的 wait() 方法而被阻塞后,线程 C 在调用 resourceA 的 notify() 方法,希望可以唤醒线程 A 和线程 B,但是从执行结果看只有一个线程 A 被唤醒了,线程 B 没有被唤醒, 从结果看线程调度器这次先调度了线程 A 占用 CPU 来运行,线程 A 首先获取 resourceA 上面的锁,然后调用 resourceA 的 wait() 方法挂起当前线程并释放获取到的锁,然后线程 B 获取到 resourceA 上面的锁并调用了 resourceA 的 wait(),此时线程 B 也被阻塞挂起并释放了 resourceA 上的锁。 线程 C 休眠结束后在共享资源 resourceA 上调用了 notify() 方法,则会激活 resourceA 的阻塞集合里面的一个线程,这里激活了线程 A,所以线程 A 调用的 wait() 方法返回了,线程 A 执行完毕。而线程 B 还处于阻塞状态。 如果把线程 C 里面调用的 notify() 改为调用 notifyAll() 而执行结果如下: 可知线程 A 和线程 B 被挂起后,线程 C 调用 notifyAll() 函数会唤醒在 resourceA 等待的所有线程,这里线程 A 和线程 B 都会被唤醒,只是线程 B 先获取到 resourceA 上面的锁然后从 wait() 方法返回,等线程 B 执行完毕后,线程 A 又获取了 resourceA 上面的锁,然后从 wait() 方返回,当线程 A 执行完毕,主线程就返回后,然后打印输出。 总结:在调用具体共享对象的 wait 或者 notify 系列函数前要先获取共享对象的锁;另外通知和等待是实现线程同步的原生方法,理解它们的协作功能很有必要;最后由于线程虚假唤醒的存在,一定要使用循环检查的方式。 6.等待线程执行终止的 join 方法:在项目实践时候经常会遇到一个场景,就是需要等待某几件事情完成后才能继续往下执行,比如多个线程去加载资源,当多个线程全部加载完毕后在汇总处理,Thread 类中有个静态的 join 方法就可以做这个事情,前面介绍的等待通知方法是属于 Object 类的,而 join 方法则是直接在 Thread 类里面提供的,join 是无参,返回值为 void 的方法。下面看一个简单的例子来介绍 join 的使用: /** * Created by cong on 2018/7/17. */ public class Test3 { public static void main(String[] args) throws InterruptedException { Thread threadOne = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("child threadOne over!"); } }); Thread threadTwo = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("child threadTwo over!"); } }); //启动子线程 threadOne.start(); threadTwo.start(); System.out.println("wait all child thread over!"); //等待子线程执行完毕,返回 threadOne.join(); threadTwo.join(); System.out.println("all child thread over!"); } } 运行结果如下: 如代码主线程里面启动了两个子线程,然后在分别调用了它们的 join() 方法,那么主线程首先会阻塞到 threadOne.join() 方法,等 threadOne 执行完毕后返回,threadOne 执行完毕后 threadOne.join() 就会返回,然后主线程调用 threadTwo.join() 后再次被阻塞,等 threadTwo 执行完毕后主线程也就返回了。这里只是为了演示 join 的作用,对应这类需求后面会讲的 CountDownLatch 是不错选择。 另外线程 A 调用线程 B 的 join 方法后会被阻塞,当其它线程调用了线程 B 的 interrupt() 方法中断了线程 B 时候,线程 B 会抛出 InterruptedException 异常而返回,下面通过一个例子来加深理解: /** * Created by cong on 2018/7/17. */ public class Test4 { public static void main(String[] args) throws InterruptedException { //线程one Thread threadOne = new Thread(new Runnable() { @Override public void run() { System.out.println("threadOne begin run!"); for (;;) { } } }); //获取主线程 final Thread mainThread = Thread.currentThread(); //线程two Thread threadTwo = new Thread(new Runnable() { @Override public void run() { //休眠1s try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } //中断主线程 mainThread.interrupt(); } }); // 启动子线程 threadOne.start(); //延迟1s启动线程 threadTwo.start(); try{//等待线程one执行结束 threadOne.join(); }catch(InterruptedException e){ System.out.println("main thread:" + e); } } } 运行结果如下: 如上代码 threadOne 线程里面执行死循环,主线程调用 threadOne 的 join 方法阻塞自己等待线程 threadOne 执行完毕,待 threadTwo 休眠 1s 后会调用主线程的 interrupt() 方法设置主线程的中断标志。 从结果看主线程中 threadOne.join() 处会抛出 InterruptedException 异常而返回。这里需要注意的是 threadTwo 里面调用的是主线程的 interrupt(),而不是线程 threadOne 的。 总结:由于 CountDownLatch 功能比 join 更丰富,所以项目实践中一般使用 CountDownLatch。 7.让线程睡眠的 sleep 方法:Thread 类中有一个静态的 sleep 方法,当一个执行中的线程调用了 Thread 的 sleep 方法后,调用线程会暂时让出指定时间的执行权,也就是这期间不参与 CPU 的调度,但是该线程所拥有的监视器资源,比如锁还是持有不让出的。当指定的睡眠时间到了该函数会正常返回,线程就处于就绪状态,然后参与 CPU 的调度,当获取到了 CPU 资源就可以继续运行了。如果在睡眠期间其它线程调用了该线程的 interrupt() 方法中断了该线程,该线程会在调用 sleep 的地方抛出 InterruptedException 异常返回。 用一个例子来说明线程在睡眠时候拥有的监视器资源不会被释放是什么意思,例子如下: /** * Created by cong on 2018/7/17. */ public class SleepTest2 { // 创建一个独占锁 private static final Lock lock = new ReentrantLock(); public static void main(String[] args) throws InterruptedException { // 创建线程A Thread threadA = new Thread(new Runnable() { public void run() { // 获取独占锁 lock.lock(); try { System.out.println("child threadA is in sleep"); Thread.sleep(10000); System.out.println("child threadA is in awaked"); } catch (InterruptedException e) { e.printStackTrace(); } finally { // 释放锁 lock.unlock(); } } }); // 创建线程B Thread threadB = new Thread(new Runnable() { public void run() { // 获取独占锁 lock.lock(); try { System.out.println("child threadB is in sleep"); Thread.sleep(10000); System.out.println("child threadB is in awaked"); } catch (InterruptedException e) { e.printStackTrace(); } finally { // 释放锁 lock.unlock(); } } }); // 启动线程 threadA.start(); threadB.start(); } } 运行结果如下: 如上代码首先创建了一个独占锁,然后创建了两个线程,每个线程内部先获取锁,然后睡眠,睡眠结束后会释放锁。 首先无论你执行多少遍上面的代码都是先输出线程 A 的打印或者先输出线程 B 的打印,不会存在线程 A 和线程 B 交叉打印的情况。 从执行结果看线程 B 先获取了锁,那么线程 B 会先打印一行,然后调用 sleep 让自己沉睡 10s,在线程 B 沉睡的这 10s 内那个独占锁 lock 还是线程 B 自己持有的,线程 A 会一直阻塞直到线程 B 醒过来后执行 unlock 释放锁。 下面在来看下当一个线程处于睡眠时候如果另外一个线程中断了它,会不会在调用 sleep 处抛出异常。代码如下: /** * Created by cong on 2018/7/17. */ public class SleepInterruptTest { public static void main(String[] args) throws InterruptedException { //创建线程 Thread thread = new Thread(new Runnable() { public void run() { try { System.out.println("child thread is in sleep"); Thread.sleep(10000); System.out.println("child thread is in awaked"); } catch (InterruptedException e) { e.printStackTrace(); } } }); //启动线程 thread.start(); //主线程休眠2s Thread.sleep(2000); //主线程中断子线程 thread.interrupt(); } } 如上代码在子线程睡眠期间主线程中断了它,所以子线程在调用 sleep 处抛出了 InterruptedException 异常。 总结:sleep 方法只是会让调用线程暂时让出指定时间的 CPU 执行权,但是该线程所拥有的监视器资源,比如锁还是持有不让出的。

优秀的个人博客,低调大师

Java并发编程笔记之FutureTask源码分析

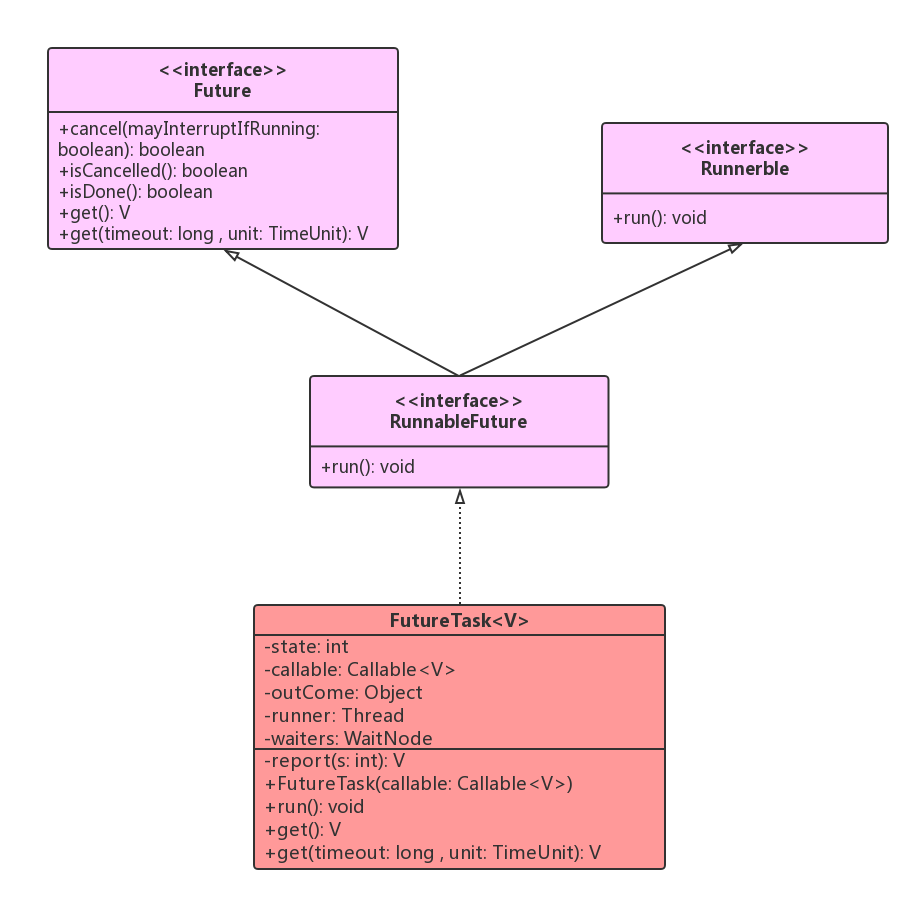
FutureTask可用于异步获取执行结果或取消执行任务的场景。通过传入Runnable或者Callable的任务给FutureTask,直接调用其run方法或者放入线程池执行,之后可以在外部通过FutureTask的get方法异步获取执行结果,因此,FutureTask非常适合用于耗时的计算,主线程可以在完成自己的任务后,再去获取结果。另外,FutureTask还可以确保即使调用了多次run方法,它都只会执行一次Runnable或者Callable任务,或者通过cancel取消FutureTask的执行等。 类图结构如下所示: 线程池使用 FutureTask 时候需要注意的一点事,FutureTask 使用不当可能会造成调用线程一直阻塞,如何避免? 线程池使用 FutureTask 的时候如果拒绝策略设置为了DiscardPolicy和DiscardOldestPolicy并且在被拒绝的任务的 Future 对象上调用无参 get 方法那么调用线程会一直被阻塞。 下面先通过一个简单的例子来复现问题,代码如下: public class FutureTest { //(1)线程池单个线程,线程池队列元素个数为1 private final static ThreadPoolExecutor executorService = new ThreadPoolExecutor(1, 1, 1L, TimeUnit.MINUTES, new ArrayBlockingQueue<Runnable>(1),new ThreadPoolExecutor.DiscardPolicy()); public static void main(String[] args) throws Exception { //(2)添加任务one Future futureOne = executorService.submit(new Runnable() { @Override public void run() { System.out.println("start runable one"); try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } } }); //(3)添加任务two Future futureTwo = executorService.submit(new Runnable() { @Override public void run() { System.out.println("start runable two"); } }); //(4)添加任务three Future futureThree=null; try { futureThree = executorService.submit(new Runnable() { @Override public void run() { System.out.println("start runable three"); } }); } catch (Exception e) { System.out.println(e.getLocalizedMessage()); } System.out.println("task one " + futureOne.get());//(5)等待任务one执行完毕 System.out.println("task two " + futureTwo.get());//(6)等待任务two执行完毕 System.out.println("task three " + (futureThree==null?null:futureThree.get()));// (7)等待任务three执行完毕 executorService.shutdown();//(8)关闭线程池,阻塞直到所有任务执行完毕 } 运行结果如下: 代码 (1) 创建了一个单线程并且队列元素个数为 1 的线程池,并且拒绝策略设置为了DiscardPolicy 代码(2)向线程池提交了一个任务 one,那么这个任务会使用唯一的一个线程进行执行,任务在打印start runable one后会阻塞该线程 5s. 代码(3)向线程池提交了一个任务 two,这时候会把任务 two 放入到阻塞队列 代码(4)向线程池提交任务 three,由于队列已经满了则会触发拒绝策略丢弃任务 three, 从执行结果看在任务 one 阻塞的 5s 内,主线程执行到了代码 (5) 等待任务 one 执行完毕,当任务 one 执行完毕后代码(5)返回,主线程打印出 task one null。任务 one 执行完成后线程池的唯一线程会去队列里面取出任务 two 并执行所以输出 start runable two 然后代码(6)会返回,这时候主线程输出 task two null,然后执行代码(7)等待任务 three 执行完毕,从执行结果看代码(7)会一直阻塞不会返回,至此问题产生,如果把拒绝策略修改为 DiscardOldestPolicy 也会存在有一个任务的 get 方法一直阻塞只是现在是任务 two 被阻塞。但是如果拒绝策略设置为默认的 AbortPolicy 则会正常返回,并且会输出如下结果: 要分析这个问题需要看下线程池的 submit 方法里面做了什么,submit 方法源码如下: public Future<?> submit(Runnable task) { ... //(1)装饰Runnable为Future对象 RunnableFuture<Void> ftask = newTaskFor(task, null); execute(ftask); //(6)返回future对象 return ftask; } protected <T> RunnableFuture<T> newTaskFor(Runnable runnable, T value) { return new FutureTask<T>(runnable, value); } public void execute(Runnable command) { ... //(2) 如果线程个数消息核心线程数则新增处理线程处理 int c = ctl.get(); if (workerCountOf(c) < corePoolSize) { if (addWorker(command, true)) return; c = ctl.get(); } //(3)如果当前线程个数已经达到核心线程数则任务放入队列 if (isRunning(c) && workQueue.offer(command)) { int recheck = ctl.get(); if (! isRunning(recheck) && remove(command)) reject(command); else if (workerCountOf(recheck) == 0) addWorker(null, false); } //(4)尝试新增处理线程进行处理 else if (!addWorker(command, false)) reject(command);//(5)新增失败则调用拒绝策略 } 代码(1)装饰 Runnable 为 FutureTask 对象,然后调用线程池的 execute 方法。 代码 (2) 如果线程个数消息核心线程数则新增处理线程处理 代码(3)如果当前线程个数已经达到核心线程数则任务放入队列 代码(4)尝试新增处理线程进行处理,失败则进行代码(5),否者直接使用新线程处理 代码(5)执行具体拒绝策略,从这里也可以看出拒绝策略执行是使用的业务线程。 所以要分析上面例子中问题所在只需要看步骤(5)对被拒绝任务的影响,这里先看下拒绝策略 DiscardPolicy 的源码,如下: public static class DiscardPolicy implements RejectedExecutionHandler { public DiscardPolicy() { } public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { } } 可知拒绝策略 rejectedExecution 方法里面什么都没做,所以代码(4)调用 submit 后会返回一个 future 对象,这里有必要在重新说 future 是有状态的,FutureTask 内部有一个state用来展示任务的状态,并且是volatile修饰的,future 的状态枚举值如下: /** Possible state transitions: * NEW -> COMPLETING -> NORMAL 正常的状态转移 * NEW -> COMPLETING -> EXCEPTIONAL 异常 * NEW -> CANCELLED 取消 * NEW -> INTERRUPTING -> INTERRUPTED 中断 */ private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; 在代码(1)的时候使用 newTaskFor 方法转换 Runnable 任务为 FutureTask,而 FutureTask 的构造函数里面设置的状态就是 New。FutureTask的构造函数源码如下: public FutureTask(Runnable runnable, V result) { this.callable = Executors.callable(runnable, result); this.state = NEW; // ensure visibility of callable } 把FutureTask提交到线程池或者线程执行start时候会调用run方法,源码如下: public void run() { //如果当前不是new状态,或者当前cas设置当前线程失败则返回,只有一个线程可以成功。 if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return; try { //当前状态为new 则调用任务的call方法执行任务 Callable<V> c = callable; if (c != null && state == NEW) { V result; boolean ran; try { result = c.call(); ran = true; } catch (Throwable ex) { result = null; ran = false; setException(ex);//完成NEW -> COMPLETING -> EXCEPTIONAL 状态转移 } //执行任务成功则保存结果更新状态,unpark所有等待线程。 if (ran) set(result); } } finally { // runner must be non-null until state is settled to // prevent concurrent calls to run() runner = null; // state must be re-read after nulling runner to prevent // leaked interrupts int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } protected void set(V v) { //状态从new->COMPLETING if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = v; //状态从COMPLETING-》NORMAL UNSAFE.putOrderedInt(this, stateOffset, NORMAL); // final state //unpark所有等待线程。 finishCompletion(); } } 所以使用 DiscardPolicy 策略提交任务后返回了一个状态值为NEW的future对象。那么我们下面就要看下当future的无参get()方法的时候,future变为什么状态才会返回,这时候就要看一下FutureTask的get方法的源码,源码如下: public V get() throws InterruptedException, ExecutionException { int s = state; //当状态值<=COMPLETING时候需要等待,否者调用report返回 if (s <= COMPLETING) s = awaitDone(false, 0L); return report(s); } private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false; for (;;) { //如果被中断,则抛异常 if (Thread.interrupted()) { removeWaiter(q); throw new InterruptedException(); } //组建单列表 int s = state; if (s > COMPLETING) { if (q != null) q.thread = null; return s; } else if (s == COMPLETING) // cannot time out yet Thread.yield(); else if (q == null) q = new WaitNode(); else if (!queued) queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q); else if (timed) { nanos = deadline - System.nanoTime(); //超时则返回 if (nanos <= 0L) { removeWaiter(q); return state; } //否者设置park超时时间 LockSupport.parkNanos(this, nanos); } else //直接挂起当前线程 LockSupport.park(this); } } private V report(int s) throws ExecutionException { Object x = outcome; //状态值为NORMAL正常返回 if (s == NORMAL) return (V)x; //状态值大于等于CANCELLED则抛异常 if (s >= CANCELLED) throw new CancellationException(); throw new ExecutionException((Throwable)x); } 也就是说当 future 的状态 > COMPLETING 时候调用 get 方法才会返回,而明显 DiscardPolicy 策略在拒绝元素的时候并没有设置该 future 的状态,后面也没有其他机会可以设置该 future 的状态,所以 future 的状态一直是 NEW,所以一直不会返回,同理 DiscardOldestPolicy 策略也是这样的问题,最老的任务被淘汰时候没有设置被淘汰任务对于 future 的状态。、 在submit任务后还可以调用futuretask的cancel来取消任务: public boolean cancel(boolean mayInterruptIfRunning) { //只有任务是new的才能取消 if (state != NEW) return false; //运行时允许中断 if (mayInterruptIfRunning) { //完成new->INTERRUPTING if (!UNSAFE.compareAndSwapInt(this, stateOffset, NEW, INTERRUPTING)) return false; Thread t = runner; if (t != null) t.interrupt(); //完成INTERRUPTING->INTERRUPTED UNSAFE.putOrderedInt(this, stateOffset, INTERRUPTED); // final state } //不允许中断则直接new->CANCELLED else if (!UNSAFE.compareAndSwapInt(this, stateOffset, NEW, CANCELLED)) return false; finishCompletion(); return true; } 那么默认的 AbortPolicy 策略为啥没问题呢? 也就是说当 future 的状态 > COMPLETING 时候调用 get 方法才会返回,而明显 DiscardPolicy 策略在拒绝元素的时候并没有设置该 future 的状态,后面也没有其他机会可以设置该 future 的状态,所以 future 的状态一直是 NEW,所以一直不会返回,同理 DiscardOldestPolicy 策略也是这样的问题,最老的任务被淘汰时候没有设置被淘汰任务对于 future 的状态。 所以当使用 Future 的时候,尽量使用带超时时间的 get 方法,这样即使使用了 DiscardPolicy 拒绝策略也不至于一直等待,等待超时时间到了会自动返回的,如果非要使用不带参数的 get 方法则可以重写 DiscardPolicy 的拒绝策略在执行策略时候设置该 Future 的状态大于 COMPLETING 即可,但是查看 FutureTask 提供的方法发现只有 cancel 方法是 public 的并且可以设置 FutureTask 的状态大于 COMPLETING,重写拒绝策略具体代码可以如下: /** * Created by cong on 2018/7/13. */ public class MyRejectedExecutionHandler implements RejectedExecutionHandler { public void rejectedExecution(Runnable runnable, ThreadPoolExecutor threadPoolExecutor) { if (!threadPoolExecutor.isShutdown()) { if(null != runnable && runnable instanceof FutureTask){ ((FutureTask) runnable).cancel(true); } } } } 使用这个策略时候由于从 report 方法知道在 cancel 的任务上调用 get() 方法会抛出异常所以代码(7)需要使用 try-catch 捕获异常代码(7)修改为如下: package com.hjc; import java.util.concurrent.*; /** * Created by cong on 2018/7/13. */ public class FutureTest { //(1)线程池单个线程,线程池队列元素个数为1 private final static ThreadPoolExecutor executorService = new ThreadPoolExecutor(1, 1, 1L, TimeUnit.MINUTES, new ArrayBlockingQueue<Runnable>(1), new MyRejectedExecutionHandler()); public static void main(String[] args) throws Exception { //(2)添加任务one Future futureOne = executorService.submit(new Runnable() { public void run() { System.out.println("start runable one"); try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } } }); //(3)添加任务two Future futureTwo = executorService.submit(new Runnable() { public void run() { System.out.println("start runable two"); } }); //(4)添加任务three Future futureThree = null; try { futureThree = executorService.submit(new Runnable() { public void run() { System.out.println("start runable three"); } }); } catch (Exception e) { System.out.println(e.getLocalizedMessage()); } System.out.println("task one " + futureOne.get());//(5)等待任务one执行完毕 System.out.println("task two " + futureTwo.get());//(6)等待任务two执行完毕 try{ System.out.println("task three " + (futureThree==null?null:futureThree.get()));// (7)等待任务three }catch(Exception e){ System.out.println(e.getLocalizedMessage()); } executorService.shutdown();//(8)关闭线程池,阻塞直到所有任务执行完毕 } } 运行结果如下: 当然这相比正常情况下多了一个异常捕获,其实最好的情况是重写拒绝策略时候设置 FutureTask 的状态为 NORMAL,但是这需要重写 FutureTask 方法了,因为 FutureTask 并没有提供接口进行设置。

优秀的个人博客,低调大师

Java并发编程笔记之Timer源码分析

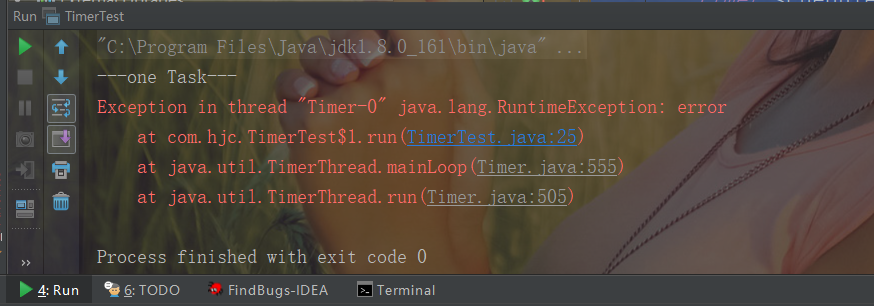
timer在JDK里面,是很早的一个API了。具有延时的,并具有周期性的任务,在newScheduledThreadPool出来之前我们一般会用Timer和TimerTask来做,但是Timer存在一些缺陷,为什么这么说呢? Timer只创建唯一的线程来执行所有Timer任务。如果一个timer任务的执行很耗时,会导致其他TimerTask的时效准确性出问题。例如一个TimerTask每10秒执行一次,而另外一个TimerTask每40ms执行一次,重复出现的任务会在后来的任务完成后快速连续的被调用4次,要么完全“丢失”4次调用。Timer的另外一个问题在于,如果TimerTask抛出未检查的异常会终止timer线程。这种情况下,Timer也不会重新回复线程的执行了;它错误的认为整个Timer都被取消了。此时已经被安排但尚未执行的TimerTask永远不会再执行了,新的任务也不能被调度了。 这里做了一个小的 demo 来复现问题,代码如下: package com.hjc; import java.util.Timer; import java.util.TimerTask; /** * Created by cong on 2018/7/12. */ public class TimerTest { //创建定时器对象 static Timer timer = new Timer(); public static void main(String[] args) { //添加任务1,延迟500ms执行 timer.schedule(new TimerTask() { @Override public void run() { System.out.println("---one Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } throw new RuntimeException("error "); } }, 500); //添加任务2,延迟1000ms执行 timer.schedule(new TimerTask() { @Override public void run() { for (;;) { System.out.println("---two Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } }, 1000); } } 如上代码先添加了一个任务在 500ms 后执行,然后添加了第二个任务在 1s 后执行,我们期望的是当第一个任务输出 ---one Task--- 后等待 1s 后第二个任务会输出 ---two Task---, 但是执行完毕代码后输出结果如下所示: 例子2, public class Shedule { private static long start; public static void main(String[] args) { TimerTask task = new TimerTask() { public void run() { System.out.println(System.currentTimeMillis()-start); try{ Thread.sleep(3000); }catch (InterruptedException e){ e.printStackTrace(); } } }; TimerTask task1 = new TimerTask() { @Override public void run() { System.out.println(System.currentTimeMillis()-start); } }; Timer timer = new Timer(); start = System.currentTimeMillis(); //启动一个调度任务,1S钟后执行 timer.schedule(task,1000); //启动一个调度任务,3S钟后执行 timer.schedule(task1,3000); } } 上面程序我们预想是第一个任务执行后,第二个任务3S后执行的,即输出一个1000,一个3000. 实际运行结果如下: 实际运行结果并不如我们所愿。世界结果,是过了4S后才输出第二个任务,即4001约等于4秒。那部分时间时间到哪里去了呢?那个时间是被我们第一个任务的sleep所占用了。 现在我们在第一个任务中去掉Thread.sleep();这一行代码,运行是否正确了呢?运行结果如下: 可以看到确实是第一个任务过了1S后执行,第二个任务在第一个任务执行完后过3S执行了。 这就说明了Timer只创建唯一的线程来执行所有Timer任务。如果一个timer任务的执行很耗时,会导致其他TimerTask的时效准确性出问题。 Timer 实现原理分析 下面简单介绍下 Timer 的原理,如下图是 Timer 的原理模型介绍: 1.其中 TaskQueue 是一个平衡二叉树堆实现的优先级队列,每个 Timer 对象内部有唯一一个 TaskQueue 队列。用户线程调用 timer 的 schedule 方法就是把 TimerTask 任务添加到 TaskQueue 队列,在调用 schedule 的方法时候 long delay 参数用来说明该任务延迟多少时间执行。 2.TimerThread 是具体执行任务的线程,它从 TaskQueue 队列里面获取优先级最小的任务进行执行,需要注意的是只有执行完了当前的任务才会从队列里面获取下一个任务而不管队列里面是否有已经到了设置的 delay 时间,一个 Timer 只有一个 TimerThread 线程,所以可知 Timer 的内部实现是一个多生产者单消费者模型。 从实现模型可以知道要探究上面的问题只需看 TimerThread 的实现就可以了,TimerThread 的 run 方法主要逻辑源码如下: public void run() { try { mainLoop(); } finally { // 有人杀死了这个线程,表现得好像Timer已取消 synchronized(queue) { newTasksMayBeScheduled = false; queue.clear(); // 消除过时的引用 } } } private void mainLoop() { while (true) { try { TimerTask task; boolean taskFired; //从队列里面获取任务时候要加锁 synchronized(queue) { ...... } if (taskFired) task.run();//执行任务 } catch(InterruptedException e) { } } } 可知当任务执行过程中抛出了除 InterruptedException 之外的异常后,唯一的消费线程就会因为抛出异常而终止,那么队列里面的其他待执行的任务就会被清除。所以 TimerTask 的 run 方法内最好使用 try-catch 结构 catch 主可能的异常,不要把异常抛出到 run 方法外。 其实要实现类似 Timer 的功能使用 ScheduledThreadPoolExecutor 的 schedule 是比较好的选择。ScheduledThreadPoolExecutor 中的一个任务抛出了异常,其他任务不受影响的。 ScheduledThreadPoolExecutor 例子如下: /** * Created by cong on 2018/7/12. */ public class ScheduledThreadPoolExecutorTest { static ScheduledThreadPoolExecutor scheduledThreadPoolExecutor = new ScheduledThreadPoolExecutor(1); public static void main(String[] args) { scheduledThreadPoolExecutor.schedule(new Runnable() { public void run() { System.out.println("---one Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } throw new RuntimeException("error "); } }, 500, TimeUnit.MICROSECONDS); scheduledThreadPoolExecutor.schedule(new Runnable() { public void run() { for (int i =0;i<5;++i) { System.out.println("---two Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } } } }, 1000, TimeUnit.MICROSECONDS); scheduledThreadPoolExecutor.shutdown(); } } 运行结果如下: 之所以 ScheduledThreadPoolExecutor 的其他任务不受抛出异常的任务的影响是因为 ScheduledThreadPoolExecutor 中的 ScheduledFutureTask 任务中 catch 掉了异常,但是在线程池任务的 run 方法内使用 catch 捕获异常并打印日志是最佳实践。

优秀的个人博客,低调大师

Java并发编程笔记之SimpleDateFormat源码分析

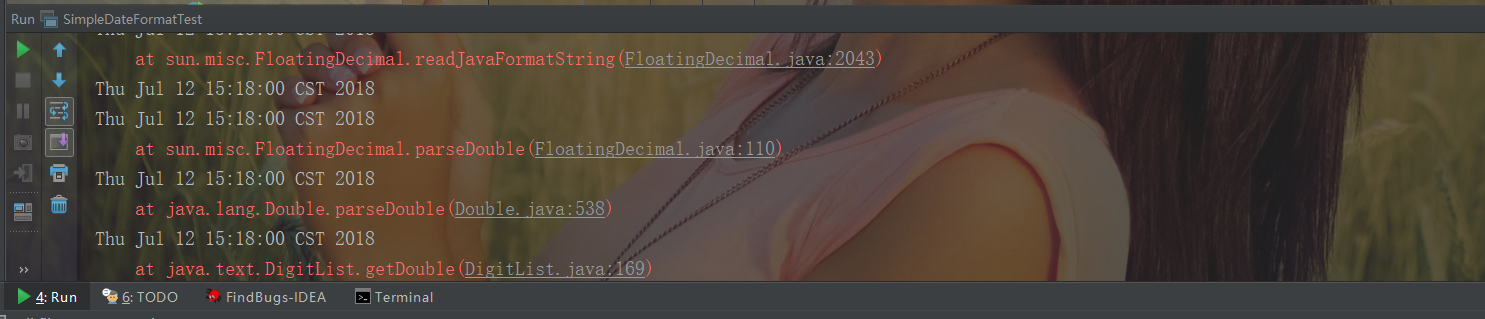
SimpleDateFormat 是 Java 提供的一个格式化和解析日期的工具类,日常开发中应该经常会用到,但是由于它是线程不安全的,多线程公用一个 SimpleDateFormat 实例对日期进行解析或者格式化会导致程序出错,本节就讨论下它为何是线程不安全的,以及如何避免。 为了复现上面所说的不安全,我们要用一个例子来突出这个不安全,例子如下: package com.hjc; import java.text.ParseException; import java.text.SimpleDateFormat; /** * Created by cong on 2018/7/12. */ public class SimpleDateFormatTest { //(1)创建单例实例 static SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static void main(String[] args) { //(2)创建多个线程,并启动 for (int i = 0; i <10 ; ++i) { Thread thread = new Thread(new Runnable() { public void run() { try {//(3)使用单例日期实例解析文本 System.out.println(sdf.parse("2018-07-12 15:18:00")); } catch (ParseException e) { e.printStackTrace(); } } }); thread.start();//(4)启动线程 } } } 运行结果如下: 代码(1)创建了 SimpleDateFormat 的一个实例,代码(2)创建 10 个线程,每个线程都公用同一个 sdf 对象对文本日期进行解析,多运行几次就会抛出 java.lang.NumberFormatException 异常,加大线程的个数有利于该问题复现。 为什么会出现这样的问题呢? 那么接下来我们就要进入到SimpleDateFormat 源码一探究竟,为了便于分析首先查看 SimpleDateFormat 的类图结构,类图如下所示: 可知每个 SimpleDateFormat 实例里面有一个 Calendar 对象,到后面就会知道SimpleDateFormat 之所以是线程不安全的,其实就是因为 Calendar 是线程不安全的,后者之所以是线程不安全的是因为其中存放日期数据的变量都是线程不安全的,比如里面的 fields,time 等。 接下来我们要看看parse方法到底干了些什么事,源码如下: public Date parse(String text, ParsePosition pos) { //(1)解析日期字符串放入CalendarBuilder的实例calb中,源码很长,省略一部分,自己去看 ..... Date parsedDate; try {//(2)使用calb中解析好的日期数据设置calendar parsedDate = calb.establish(calendar).getTime(); ... } catch (IllegalArgumentException e) { ... return null; } return parsedDate; } Calendar establish(Calendar cal) { ... //(3)重置日期对象cal的属性值 cal.clear(); //(4) 使用calb中中属性设置cal ... //(5)返回设置好的cal对象 return cal; } 代码(1)主要的作用是解析字符串日期并把解析好的数据放入了 CalendarBuilder 的实例 calb 中,CalendarBuilder 是一个建造者模式,用来存放后面需要的数据。 代码(3)重置 Calendar 对象里面的属性值,源码如下: public final void clear(){ for (int i = 0; i < fields.length; ) { stamp[i] = fields[i] = 0; // UNSET == 0 isSet[i++] = false; } areAllFieldsSet = areFieldsSet = false; isTimeSet = false; } 代码(4)使用 calb 中解析好的日期数据设置 cal 对象 代码(5) 返回设置好的 cal 对象 从上面步骤可知代码(3)(4)(5)操作不是原子性操作,当多个线程调用 parse 方法时候比如线程 A 执行了代码(3)(4)也就是设置好了 cal 对象,在执行代码(5)前线程 B 执行了代码(3)清空了 cal 对象,由于多个线程使用的是一个 cal 对象,所以线程 A 执行代码(5)返回的就可能是被线程 B 清空后的对象,当然也有可能线程 B 执行了代码(4)被线程 B 修改后的 cal 对象。从而导致程序错误。 那么,让我们思考一个问题,如何解决SimpleDateFormat 的线程安全性问题呢? 1.第一种方式:每次使用时候 new 一个 SimpleDateFormat 的实例,这样可以保证每个实例使用自己的 Calendar 实例, 但是每次使用都需要 new 一个对象,并且使用后由于没有其它引用,就会需要被回收,开销会很大。 2.第二种方式:究其原因是因为多线程下代码(3)(4)(5)三个步骤不是一个原子性操作,那么容易想到的是对其进行同步,让(3)(4)(5)成为原子操作,可以使用 synchronized 进行同步,例子改造如下所示: /** * Created by cong on 2018/7/12. */ public class SimpleDateFormatTest1 { //(1)创建单例实例 static SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static void main(String[] args) { //(2)创建多个线程,并启动 for (int i = 0; i <10 ; ++i) { Thread thread = new Thread(new Runnable() { public void run() { try {// (3)使用单例日期实例解析文本 synchronized (sdf) { System.out.println(sdf.parse("2018-07-12 15:18:00")); } } catch (ParseException e) { e.printStackTrace(); } } }); thread.start();//(4)启动线程 } } } 运行结果如下: 3.第三种方式:使用 ThreadLocal,这样每个线程只需要使用一个 SimpleDateFormat 实例相比第一种方式大大节省了对象的创建销毁开销,并且不需要对多个线程直接进行同步,使用 ThreadLocal 方式来保证线程安全,例子如下: /** * Created by cong on 2018/7/12. */ public class SimpleDateFormatTest2 { // (1)创建threadlocal实例 static ThreadLocal<DateFormat> safeSdf = new ThreadLocal<DateFormat>(){ @Override protected SimpleDateFormat initialValue(){ return new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); } }; public static void main(String[] args) { // (2)创建多个线程,并启动 for (int i = 0; i < 10; ++i) { Thread thread = new Thread(new Runnable() { public void run() { try {// (3)使用单例日期实例解析文本 System.out.println(safeSdf.get().parse("2018-07-12 15:18:00")); } catch (ParseException e) { e.printStackTrace(); }finally { //(4)使用完毕记得清除,避免内存泄露 safeSdf.remove(); } } }); thread.start();// (4)启动线程 } } } 运行结果如下: 代码(1)创建了一个线程安全的 SimpleDateFormat 实例,代码(3)在使用的时候首先使用 get() 方法获取当前线程下 SimpleDateFormat 的实例,在第一次调用 ThreadLocal 的 get()方法适合会触发其 initialValue 方法用来创建当前线程所需要的 SimpleDateFormat 对象。另外需要注意的是代码(4)使用完毕线程变量后要记得进行清理,以避免内存泄露。

优秀的个人博客,低调大师

Java高级编程——MySql采用的算法原理

摘要 本文以MySQL数据库为研究对象,讨论与数据库索引相关的一些话题。特别需要说明的是,MySQL支持诸多存储引擎,而各种存储引擎对索引的支持也各不相同,因此MySQL数据库支持多种索引类型,如BTree索引,哈希索引,全文索引等等。为了避免混乱,本文将只关注于BTree索引,因为这是平常使用MySQL时主要打交道的索引,至于哈希索引和全文索引本文暂不讨论。 文章主要内容分为两个部分。 第一部分主要从数据结构及算法理论层面讨论MySQL数据库索引的数理基础。 第二部分结合MySQL数据库中MyISAM和InnoDB数据存储引擎中索引的架构实现讨论聚集索引、非聚集索引及覆盖索引等话题。 数据结构及算法基础 索引的本质 MySQL官方对索引的定义为:索引(Index)是帮助MySQL高效获取数据的数据结构。提取句子主干,就可以得到索引的本质:索引是数据结构。 我们知道,数据库查询是数据库的最主要功能之一。我们都希望查询数据的速度能尽可能的快,因此数据库系统的设计者会从查询算法的角度进行优化。最基本的查询算法当然是顺序查找(linear search),这种复杂度为O(n)的算法在数据量很大时显然是糟糕的,好在计算机科学的发展提供了很多更优秀的查找算法,例如二分查找(binary search)、二叉树查找(binary tree search)等。如果稍微分析一下会发现,每种查找算法都只能应用于特定的数据结构之上,例如二分查找要求被检索数据有序,而二叉树查找只能应用于二叉查找树上,但是数据本身的组织结构不可能完全满足各种数据结构(例如,理论上不可能同时将两列都按顺序进行组织),所以,在数据之外,数据库系统还维护着满足特定查找算法的数据结构,这些数据结构以某种方式引用(指向)数据,这样就可以在这些数据结构上实现高级查找算法。这种数据结构,就是索引。 看一个例子: 图1 图1展示了一种可能的索引方式。左边是数据表,一共有两列七条记录,最左边的是数据记录的物理地址(注意逻辑上相邻的记录在磁盘上也并不是一定物理相邻的)。为了加快Col2的查找,可以维护一个右边所示的二叉查找树,每个节点分别包含索引键值和一个指向对应数据记录物理地址的指针,这样就可以运用二叉查找在O(log2n)的复杂度内获取到相应数据。 虽然这是一个货真价实的索引,但是实际的数据库系统几乎没有使用二叉查找树或其进化品种红黑树(red-black tree)实现的,原因会在下文介绍。 B-Tree和B+Tree 目前大部分数据库系统及文件系统都采用B-Tree或其变种B+Tree作为索引结构,在本文的下一节会结合存储器原理及计算机存取原理讨论为什么B-Tree和B+Tree在被如此广泛用于索引,这一节先单纯从数据结构角度描述它们。 B-Tree 为了描述B-Tree,首先定义一条数据记录为一个二元组[key, data],key为记录的键值,对于不同数据记录,key是互不相同的;data为数据记录除key外的数据。那么B-Tree是满足下列条件的数据结构: 1. d为大于1的一个正整数,称为B-Tree的度。 2. h为一个正整数,称为B-Tree的高度。 3. 每个非叶子节点由n-1个key和n个指针组成,其中d<=n<=2d。 4. 每个叶子节点最少包含一个key和两个指针,最多包含2d-1个key和2d个指针,叶节点的指针均为null 。 5. 所有叶节点具有相同的深度,等于树高h。 6. key和指针互相间隔,节点两端是指针。 7. 一个节点中的key从左到右非递减排列。 8. 所有节点组成树结构。 9. 每个指针要么为null,要么指向另外一个节点。 10. 如果某个指针在节点node最左边且不为null,则其指向节点的所有key小于v(key1),其中v(key1)为node的第一个key的值。 11. 如果某个指针在节点node最右边且不为null,则其指向节点的所有key大于v(keym),其中v(keym)为node的最后一个key的值。 12. 如果某个指针在节点node的左右相邻key分别是keyi和keyi+1且不为null,则其指向节点的所有key小于v(keyi+1)且大于v(keyi)。 图2是一个d=2的B-Tree示意图。 图2 由于B-Tree的特性,在B-Tree中按key检索数据的算法非常直观:首先从根节点进行二分查找,如果找到则返回对应节点的data,否则对相应区间的指针指向的节点递归进行查找,直到找到节点或找到null指针,前者查找成功,后者查找失败。B-Tree上查找算法的伪代码如下: 关于B-Tree有一系列有趣的性质,例如一个度为d的B-Tree,设其索引N个key,则其树高h的上限为logd((N+1)/2),检索一个key,其查找节点个数的渐进复杂度为O(logdN)。从这点可以看出,B-Tree是一个非常有效率的索引数据结构。 另外,由于插入删除新的数据记录会破坏B-Tree的性质,因此在插入删除时,需要对树进行一个分裂、合并、转移等操作以保持B-Tree性质,本文不打算完整讨论B-Tree这些内容,因为已经有许多资料详细说明了B-Tree的数学性质及插入删除算法,有兴趣的朋友可以在本文末的参考文献一栏找到相应的资料进行阅读。 B+Tree B-Tree有许多变种,其中最常见的是B+Tree,例如MySQL就普遍使用B+Tree实现其索引结构。 与B-Tree相比,B+Tree有以下不同点: 1. 每个节点的指针上限为2d而不是2d+1。 2. 内节点不存储data,只存储key;叶子节点不存储指针。 图3是一个简单的B+Tree示意。 图3 由于并不是所有节点都具有相同的域,因此B+Tree中叶节点和内节点一般大小不同。这点与B-Tree不同,虽然B-Tree中不同节点存放的key和指针可能数量不一致,但是每个节点的域和上限是一致的,所以在实现中B-Tree往往对每个节点申请同等大小的空间。 一般来说,B+Tree比B-Tree更适合实现外存储索引结构,具体原因与外存储器原理及计算机存取原理有关,将在下面讨论。 带有顺序访问指针的B+Tree 一般在数据库系统或文件系统中使用的B+Tree结构都在经典B+Tree的基础上进行了优化,增加了顺序访问指针。 如图4所示,在B+Tree的每个叶子节点增加一个指向相邻叶子节点的指针,就形成了带有顺序访问指针的B+Tree。做这个优化的目的是为了提高区间访问的性能,例如图4中如果要查询key为从18到49的所有数据记录,当找到18后,只需顺着节点和指针顺序遍历就可以一次性访问到所有数据节点,极大提到了区间查询效率。 这一节对B-Tree和B+Tree进行了一个简单的介绍,下一节结合存储器存取原理介绍为什么目前B+Tree是数据库系统实现索引的首选数据结构。 为什么使用B-Tree(B+Tree) 上文说过,红黑树等数据结构也可以用来实现索引,但是文件系统及数据库系统普遍采用B-/+Tree作为索引结构,这一节将结合计算机组成原理相关知识讨论B-/+Tree作为索引的理论基础。 一般来说,索引本身也很大,不可能全部存储在内存中,因此索引往往以索引文件的形式存储的磁盘上。这样的话,索引查找过程中就要产生磁盘I/O消耗,相对于内存存取,I/O存取的消耗要高几个数量级,所以评价一个数据结构作为索引的优劣最重要的指标就是在查找过程中磁盘I/O操作次数的渐进复杂度。换句话说,索引的结构组织要尽量减少查找过程中磁盘I/O的存取次数。下面先介绍内存和磁盘存取原理,然后再结合这些原理分析B-/+Tree作为索引的效率。 主存存取原理 目前计算机使用的主存基本都是随机读写存储器(RAM),现代RAM的结构和存取原理比较复杂,这里本文抛却具体差别,抽象出一个十分简单的存取模型来说明RAM的工作原理。 图5 从抽象角度看,主存是一系列的存储单元组成的矩阵,每个存储单元存储固定大小的数据。每个存储单元有唯一的地址,现代主存的编址规则比较复杂,这里将其简化成一个二维地址:通过一个行地址和一个列地址可以唯一定位到一个存储单元。图5展示了一个4 x 4的主存模型。 主存的存取过程如下: 当系统需要读取主存时,则将地址信号放到地址总线上传给主存,主存读到地址信号后,解析信号并定位到指定存储单元,然后将此存储单元数据放到数据总线上,供其它部件读取。 写主存的过程类似,系统将要写入单元地址和数据分别放在地址总线和数据总线上,主存读取两个总线的内容,做相应的写操作。 这里可以看出,主存存取的时间仅与存取次数呈线性关系,因为不存在机械操作,两次存取的数据的“距离”不会对时间有任何影响,例如,先取A0再取A1和先取A0再取D3的时间消耗是一样的。 磁盘存取原理 上文说过,索引一般以文件形式存储在磁盘上,索引检索需要磁盘I/O操作。与主存不同,磁盘I/O存在机械运动耗费,因此磁盘I/O的时间消耗是巨大的。 图6是磁盘的整体结构示意图。 图6 一个磁盘由大小相同且同轴的圆形盘片组成,磁盘可以转动(各个磁盘必须同步转动)。在磁盘的一侧有磁头支架,磁头支架固定了一组磁头,每个磁头负责存取一个磁盘的内容。磁头不能转动,但是可以沿磁盘半径方向运动(实际是斜切向运动),每个磁头同一时刻也必须是同轴的,即从正上方向下看,所有磁头任何时候都是重叠的(不过目前已经有多磁头独立技术,可不受此限制)。 图7是磁盘结构的示意图。 图 7 盘片被划分成一系列同心环,圆心是盘片中心,每个同心环叫做一个磁道,所有半径相同的磁道组成一个柱面。磁道被沿半径线划分成一个个小的段,每个段叫做一个扇区,每个扇区是磁盘的最小存储单元。为了简单起见,我们下面假设磁盘只有一个盘片和一个磁头。 当需要从磁盘读取数据时,系统会将数据逻辑地址传给磁盘,磁盘的控制电路按照寻址逻辑将逻辑地址翻译成物理地址,即确定要读的数据在哪个磁道,哪个扇区。为了读取这个扇区的数据,需要将磁头放到这个扇区上方,为了实现这一点,磁头需要移动对准相应磁道,这个过程叫做寻道,所耗费时间叫做寻道时间,然后磁盘旋转将目标扇区旋转到磁头下,这个过程耗费的时间叫做旋转时间。 局部性原理与磁盘预读 由于存储介质的特性,磁盘本身存取就比主存慢很多,再加上机械运动耗费,磁盘的存取速度往往是主存的几百分分之一,因此为了提高效率,要尽量减少磁盘I/O。为了达到这个目的,磁盘往往不是严格按需读取,而是每次都会预读,即使只需要一个字节,磁盘也会从这个位置开始,顺序向后读取一定长度的数据放入内存。这样做的理论依据是计算机科学中著名的局部性原理: 当一个数据被用到时,其附近的数据也通常会马上被使用。 程序运行期间所需要的数据通常比较集中。 由于磁盘顺序读取的效率很高(不需要寻道时间,只需很少的旋转时间),因此对于具有局部性的程序来说,预读可以提高I/O效率。 预读的长度一般为页(page)的整倍数。页是计算机管理存储器的逻辑块,硬件及操作系统往往将主存和磁盘存储区分割为连续的大小相等的块,每个存储块称为一页(在许多操作系统中,页得大小通常为4k),主存和磁盘以页为单位交换数据。当程序要读取的数据不在主存中时,会触发一个缺页异常,此时系统会向磁盘发出读盘信号,磁盘会找到数据的起始位置并向后连续读取一页或几页载入内存中,然后异常返回,程序继续运行。 B-/+Tree索引的性能分析 到这里终于可以分析B-/+Tree索引的性能了。 上文说过一般使用磁盘I/O次数评价索引结构的优劣。先从B-Tree分析,根据B-Tree的定义,可知检索一次最多需要访问h个节点。数据库系统的设计者巧妙利用了磁盘预读原理,将一个节点的大小设为等于一个页,这样每个节点只需要一次I/O就可以完全载入。为了达到这个目的,在实际实现B-Tree还需要使用如下技巧: 每次新建节点时,直接申请一个页的空间,这样就保证一个节点物理上也存储在一个页里,加之计算机存储分配都是按页对齐的,就实现了一个node只需一次I/O。 B-Tree中一次检索最多需要h-1次I/O(根节点常驻内存),渐进复杂度为O(h)=O(logdN)。一般实际应用中,出度d是非常大的数字,通常超过100,因此h非常小(通常不超过3)。 综上所述,用B-Tree作为索引结构效率是非常高的。 而红黑树这种结构,h明显要深的多。由于逻辑上很近的节点(父子)物理上可能很远,无法利用局部性,所以红黑树的I/O渐进复杂度也为O(h),效率明显比B-Tree差很多。 上文还说过,B+Tree更适合外存索引,原因和内节点出度d有关。从上面分析可以看到,d越大索引的性能越好,而出度的上限取决于节点内key和data的大小: dmax = floor(pagesize / (keysize + datasize + pointsize)) (pagesize – dmax >= pointsize) 或 dmax = floor(pagesize / (keysize + datasize + pointsize)) – 1 (pagesize – dmax < pointsize) floor表示向下取整。由于B+Tree内节点去掉了data域,因此可以拥有更大的出度,拥有更好的性能。 本文从理论角度讨论了与索引相关的数据结构与算法问题。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5zMN6JB 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

Java并发编程-volatile关键字介绍

前言 要学习好Java的多线程,就一定得对volatile关键字的作用机制了熟于胸。最近博主看了大量关于volatile的相关博客,对其有了一点初步的理解和认识,下面通过自己的话叙述整理一遍。 有什么用? volatile主要对所修饰的变量提供两个功能 可见性 防止指令重排序 本篇博客主要对volatile可见性进行探讨,以后发表关于指令重排序的博文。 什么是可见性? 一图胜千言上图已经把JAVA内存模型(JMM)展示得很详细了,简单概括一下 每个Thread有一个属于自己的工作内存(可以理解为每个厨师有一个属于自己的铁锅) 所有Thread共用一个主内存(餐厅所有的厨师共用同一个冰箱) 每个Thread操作数据之前都会去主内存中获取数据(厨师炒菜之前都要去冰箱里拿食材) Thread:厨师 工作内存:铁锅 store&load:放熟食,取食材 主内存:冰箱 读者可思考以下情景:餐厅来了一位顾客点了一份红烧肉,此时有两位大厨(假设大厨之间互不通信),由于互不通信,所以两位大厨都打开冰箱取出食材开始炒菜。最后炒出了两份红烧肉,顾客只要一份。为什么会造成这种结果? 由于大厨之间没有可见性。 将此情景放在JAVA中即是:线程A从主内存中取了一个变量到工作内存中,操作完毕后没有及时放回主内存中,于是线程B去取这个变量已经过期了,取的是线程A操作之前的变量。 如何拥有可见性? 先介绍一下Java内存模型中定义的8种工作内存与主内存之间的原子操作 lock( 锁定 ):作用于主内存的变量,把一个变量标识为一条线程独占的状态。 unlock(解锁):作用于主内存的变量,把一个处于锁定的变量释放出来,释放变量才可以被其他线程锁定。 read(读取):作用于主内存的变量,把一个变量的值从主内存传输到线程的工作内存中,以便随后的load动作使用。 load(载入):作用于工作内存的变量,它把read操作从主内存中得到的变量值放入工作内存的变量副本中。 use(使用):作用于工作内存种的变量,它把工作内存中一个变量的值传递给执行引擎,每当虚拟机遇到一个需要使用到变量的值的字节码指令时将会执行这个操作。 assign(赋值):作用于工作内存中的变量,它把一个从执行引擎接收到的值赋给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。 store(存储):作用于工作内存的变量,它把工作内存中一个变量的值传送到主内存中,以便随后的write操作使用 write(写入):作用于主内存的变量,它把store操作从工作内存中得到的值放入主内存的变量中。 读取赋值一个普通变量的情况 当线程1对主内存对象发起read操作到write操作套流程的时间里,线程2随时都有可能对这个主内存对象发起第二套操作 有什么危害呢? 假设主内存中有一个 int a=0; 线程1和线程2分别执行一次,理想状态下最终a的值为2. a++; 线程1在执行了assign操作之后变量a的真实值已经从0变成了1,但是这个过程发生在工作内存中对其他线程不可见,若线程2此时对变量a的操作,读取到的值仍然为0,因为没有可见性,线程2的操作也仅仅是重复了线程1的操作,再次让a从0变成了1。并没有达到期望的a=2。 读取赋值一个volatile变量的情况 volatile变量对对象的操作更严格: use之前不能被read&load assign之后必须紧跟store&write 也就是说 read-load-use 和 assign-store-write成为了两个不可分割的原子操作 尽管这时候在use和assign之间依然有一段真空期,有可能变量会被其他线程读取,但是无论在哪一个时间点主内存的变量和任一工作内存的变量的值都是相等的。这个特性就导致了volatile变量不适合参与到依赖当前值的运算,如自增。那么依靠可见性的特点volatile可以用在哪些地方呢?《Java虚拟机》提到: 运算结果并不依赖变量的当前值(即结果对产生中间结果不依赖),或者能够确保只有单一的线程修改变量的值 通常volatile用做保存某个状态的boolean值。 部分参考自 volatile变量与普通变量的区别 <<深入理解Java虚拟机 高级特性与最佳实践>>

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册