首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

深入解析Vue中的computed工作原理

我们通过实现一个简单版的和Vue中computed具有相同功能的函数来了解computed是如何工作的。 JS属性: JavaScript有一个特性是 Object.defineProperty ,它能做很多事,但我在这篇文章只专注于这个方法中的一个: var person = {}; Object.defineProperty (person, 'age', { get: function () { console.log ("Getting the age"); return 25; } }); console.log ("The age is ", person.age); // Prints: // // Getting the age // The age is 25 (Obeject.defineProperty是Object的一个方法,第一个参数是对象名称,第二个参数是要设置的属性名,第三个参数是一个对象,它可以设置这个属性是否可修改、可写等,而这篇文章主要使用的是Obeject.defineProperty的访问器属性,感兴趣的朋友可以自行google或者查看Js高及程序设计) 尽管 person.age 看起来像是访问了对象的一个属性,但其实在内部我们是运行了一个函数。 一个基本可响应的Vue.js Vue.js内部构建了一个可以将普通的对象转化为可以被观察的值( 响应属性 ),下面为大家展示一个简化版的如何添加响应属性的案例: function defineReactive (obj, key, val) { Object.defineProperty (obj, key, { get: function () { return val; }, set: function (newValue) { val = newValue; }//欢迎加入全栈开发交流圈一起学习交流:864305860 }) }; // 创建一个对象 var person = {}; // 添加可响应的属性"age"和"country" defineReactive (person, 'age', 25); defineReactive (person, 'country', 'Brazil'); // 现在你可以随意使用person.age了 if (person.age < 18) { return 'minor'; }//欢迎加入全栈开发交流圈一起学习交流:864305860 else { return 'adult'; } // 设置person.country的值 person.country = 'Russia'; 25 和 ‘Brazil' 还是一个闭包内部的变量,只有当赋给它们新值的时候 val 才会改变。 person.country 并不拥有 'Brazil' 这个值,而是getter这个函数拥有 'Brazil' 这个值。 声明一个计算属性 让我们创建一个定义计算属性的函数 defineComputed 。这个函数就跟大家平时使用computed时的一样。 defineComputed ( person, // 计算属性就声明在这个对象上 'status', // 计算属性的名称 function () { // 实际返回计算属性值的函数 console.log ("status getter called") if (person.age < 18) { return 'minor'; } else { return 'adult'; } }, function (newValue) { // 当计算属性值更新时调用的函数 console.log ("status has changed to", newValue) } }); // 我们可以像使用一般的属性一样使用计算属性 console.log ("The person's status is: ", person.status); 写一个简单的 defineComputed 函数,它支持调用计算方法,但目前不需要它支持 updateCallback function defineComputed (obj, key, computeFunc, updateCallback) { Object.defineProperty (obj, key, { get: function () { // 执行计算函数并且返回值 return computeFunc (); }, set: function () { // 什么也不做,不需要设定计算属性的值 }//欢迎加入全栈开发交流圈一起学习交流:864305860 }) }//帮助突破技术瓶颈,提升思维能力 这个函数有两个问题: 每次访问计算属性时都会执行一次计算函数 computeFunc () 它不知道什么时候更新 (即当我们更新某个data中的属性,计算属性中也会更新这个data属性) // 我希望最终函数执行后是这个效果:每当person.age更新值的时候,person.status也同步更新 person.age = 17; // console: status 的值为 minor person.age = 22; // console: status 的值为 adult 增加一个依赖项 让我们增加一个全局变量 Dep : var Dep = { target: null }; 这是一个依赖项,接着我们用一个骚操作来更新 defineComputed 函数: var onDependencyUpdated = function () { // TODO } Object.defineProperty (obj, key, { get: function () { // 将onDependencyUpdated 这个函数传给Dep.target Dep.target = onDependencyUpdated; var value = computeFunc (); Dep.target = null; },//帮助突破技术瓶颈,提升思维能力 set: function () { // 什么也不做,不需要设定计算属性的值 } }) } 回到之前设置的响应属性上: function defineReactive (obj, key, val) { // 所有的计算属性都依赖这个数组 var deps = []; Object.defineProperty (obj, key, { get: function () { // 检查是否调用了计算属性,如果调用了,Department.target将等于一个onDependencyUpdated函数 if (Dep.target) { // 把onDependencyUpdated函数push到deos中 deps.push (target); } return val; }, set: function (newValue) { val = newValue // 通知所有的计算属性,告诉它们有个响应属性更新了 deps.forEach ((changeFunction) => { changeFunction (); });//欢迎加入全栈开发交流圈一起学习交流:864305860 }//帮助突破技术瓶颈,提升思维能力 }) }; 可以在计算属性定义的函数触发更新回调后更新 onDependencyUpdated 函数。 var onDependencyUpdated = function () { // 再次计算 计算属性的值 var value = computeFunc (); updateCallback (value); } 把它们整合到一起,重新访问我们的计算属性 person.status : person.age = 22; defineComputed ( person, 'status', function () { if (person.age > 18) { return 'adult'; }//欢迎加入全栈开发交流圈一起学习交流:864305860 },//帮助突破技术瓶颈,提升思维能力 function (newValue) { console.log ("status has changed to", newValue) } }); console.log ("Status is ", person.status); 结语 感谢您的观看,如有不足之处,欢迎批评指正。

优秀的个人博客,低调大师

阿里云自助诊断系统技术解析

当您在阿里云上使用云资源遇到问题时,可以通过查看文档、博客或者提交工单的方式来解决问题,但问题的处理周期可能较长,成本可能较高。为了解决上面的问题,阿里云推出了自助诊断系统,帮助您一键提交问题诊断,快速获取诊断结果。本文将从技术角度来介绍阿里云自助诊断系统的优点及其实现方法,进一步阐述阿里云自助诊断系统的能够为您解决的问题。关于阿里云自助诊断系统的介绍信息,您可以通过查看 阿里云自助诊断系统 获取。 阿里云自助诊断系统优点 通过阿里云自助诊断系统提交问题诊断,不仅能够降低问题的反馈沟通成本,而且能够缩短问题的处理时间,提高了问题处理效率,同时,阿里云自助诊断系统诊断的时效性以及准确率还在不断的提升。 阿里云自助诊断系统依靠强大的技术支撑,相比其它问题反馈沟通渠道,具有以下几大优点: 一键反馈,反馈问题方便、快捷 反馈信息准确、全面,有助于问

优秀的个人博客,低调大师

探索解析微服务下的RabbitMQ

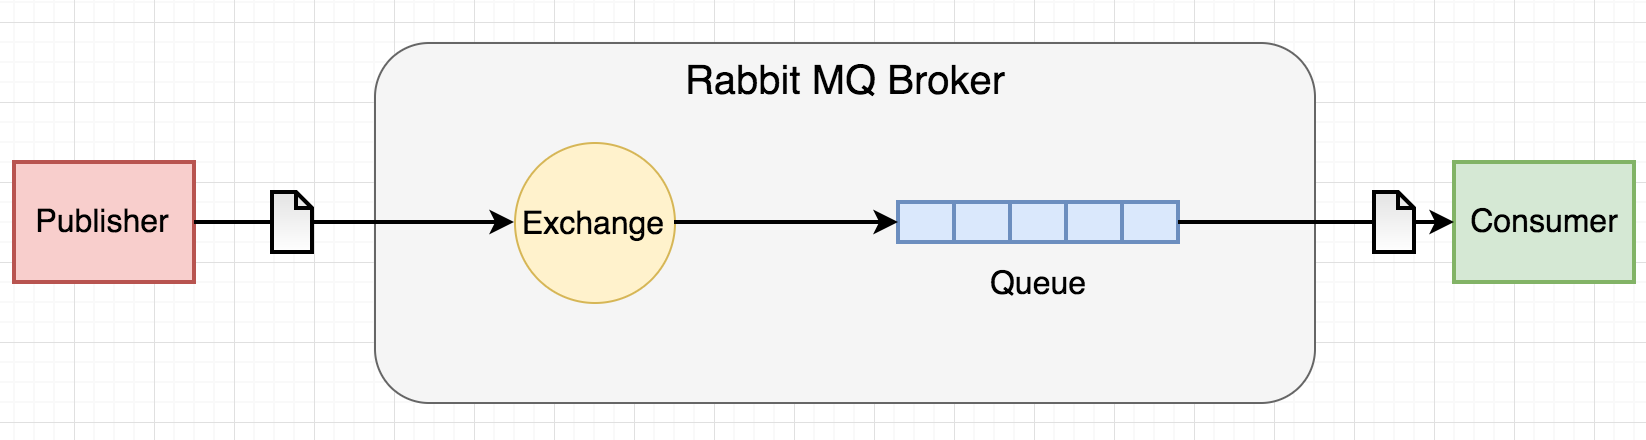
概览 本文主要介绍如何使用RabbitMQ消息代理来实现分布式系统之间的通信,从而促进微服务的松耦合。 RabbitMQ,也被称为开源消息代理,它支持多种消息协议,并且可以部署在分布式系统上。它轻量级,便于部署应用程序。它主要充当一个队列,其中输入的消息可以首先被操作。RabbitMQ可以在许多操作系统和云环境中运行,并为大多数流行语言提供了广泛的开发工具。它是生产者-消费者模式,生产者发出信息,消费者消费信息。RabbitMQ的主要特点如下: 异步消息 分布式部署 管理和监控 企业和云计算 安装 对于RabbitMQ,首先需要在系统中安装ErLang,因为RabbitMQ是用ErLang语言编写的。安装Erlang之后,你可以通过下面的介绍从它的官网下载最新版本的RabbitMQ。 在微服务中使用RabbitMQ 在您的微服务体系结构中,RabbitMQ是实现消息队列的最简单的免费的可用选项之一。这些队列模式有助于解耦各个微服务之间的通信来增加应用程序的弹性。我们可以将这些队列用于各种目的,比如核心微服务之间的交互、微服务的解耦、实现故障转移机制,以及通过消息代理发送电子邮件通知。 无论在哪里,只要有两个或两个以上的核心模块需要相互通信,我们就不应该进行直接的HTTP调用,因为它们会使核心层产生紧耦合,并且当每个核心模块有更多实例时将很难管理。而且每当服务宕机时,HTTP调用模式就会失败,因为在服务重启之后,我们将无法跟踪旧的HTTP请求调用。这就产生了对RabbitMQ的需求。 在微服务中设置RabbitMQ 在微服务架构中,为了演示,我们将使用一个可以通过任何核心微服务发送电子邮件通知的示例模式。在这种模式下,我们将有一个可以存在任何核心微服务的生产者,它将生成电子邮件内容并将其发送到队列。然后,这个电子邮件内容由总是在等待队列中新消息的消费者来处理。 请注意,由于正在使用Spring Boot构建微服务,因此我们将为Spring提供配置。 1)生产者:这一层负责生成电子邮件内容,并将此内容发送给RabbitMQ中的消息代理。 a)在properties文件中,我们需要配置队列名和交换类型,以及安装RabbitMQ服务器的主机和端口。 queue.name=messagequeue fanout.exchange=messagequeue-exchange spring.rabbitmq.host: localhost spring.rabbitmq.port: 5672 spring.rabbitmq.username: guest spring.rabbitmq.password: guest b)我们需要创建一个配置类,它将使用队列名和交换类型将队列绑定到微服务模块。 @Configuration public class RabbitConfiguration { @Value("${fanout.exchange}") private String fanoutExchange; @Value("${queue.name}") private String queueName; @Bean Queue queue() { return new Queue(queueName, true); } @Bean FanoutExchange exchange() { return new FanoutExchange(fanoutExchange); } @Bean Binding binding(Queue queue, FanoutExchange exchange) { return BindingBuilder.bind(queue).to(exchange); } } c)最后,我们需要一个工具类,它将使用Spring框架提供的RabbitTemplate将实际的电子邮件内容发送到队列中。 @Component public class QueueProducer { protected Logger logger = LoggerFactory.getLogger(getClass()); @Value("${fanout.exchange}") private String fanoutExchange; private final RabbitTemplate rabbitTemplate; @Autowired public QueueProducer(RabbitTemplate rabbitTemplate) { super(); this.rabbitTemplate = rabbitTemplate; } public void produce(NotificationRequestDTO notificationDTO) throws Exception { logger.info("Storing notification..."); rabbitTemplate.setExchange(fanoutExchange); rabbitTemplate.convertAndSend(new ObjectMapper().writeValueAsString(notificationDTO)); logger.info("Notification stored in queue sucessfully"); } } d)然后,您可以在模块的任何地方调用这个produce方法。 { queueProducer.produce(notificationDTO); } 2) 消费者:这一层负责使用FIFO方法从RabbitMQ消息代理中消费消息,然后执行与电子邮件相关的操作。 a)在这个properties文件中,我们需要配置队列名和交换类型,以及安装RabbitMQ服务器的主机和端口。 queue.name=messagequeue fanout.exchange=messagequeue-exchange spring.rabbitmq.host: localhost spring.rabbitmq.port: 5672 spring.rabbitmq.username: guest spring.rabbitmq.password: guest b)我们需要创建一个配置类,它将使用队列名和交换类型将队列绑定到微服务模块。此外,在消费者的RabbitMQ配置中,我们需要创建一个充当消费者的MessageListenerAdapterbean,它始终侦听从队列中传入的消息。这个MessageListenerAdapter将有一个带有消费者工具类和defaultListenerMethod的有参构造函数,在这里我们可以指定与电子邮件相关的操作。 @Configuration public class RabbitConfiguration { private static final String LISTENER_METHOD = "receiveMessage"; @Value("${queue.name}") private String queueName; @Value("${fanout.exchange}") private String fanoutExchange; @Bean Queue queue() { return new Queue(queueName, true); } @Bean FanoutExchange exchange() { return new FanoutExchange(fanoutExchange); } @Bean Binding binding(Queue queue, FanoutExchange exchange) { return BindingBuilder.bind(queue).to(exchange); } @Bean SimpleMessageListenerContainer container(ConnectionFactory connectionFactory, MessageListenerAdapter listenerAdapter) { SimpleMessageListenerContainer container = new SimpleMessageListenerContainer(); container.setConnectionFactory(connectionFactory); container.setQueueNames(queueName); container.setMessageListener(listenerAdapter); return container; } @Bean MessageListenerAdapter listenerAdapter(QueueConsumer consumer) { return new MessageListenerAdapter(consumer, LISTENER_METHOD); } } c)然后,需要创建具有特定消息侦听器方法的QueueConsumer类,在该类中我们可以进行实际发送电子邮件的操作。 @Component public class QueueConsumer { @Autowired MailServiceImpl mailServiceImpl; protected Logger logger = LoggerFactory.getLogger(getClass()); public void receiveMessage(String message) { logger.info("Received (String) " + message); processMessage(message); } public void receiveMessage(byte[] message) { String strMessage = new String(message); logger.info("Received (No String) " + strMessage); processMessage(strMessage); } private void processMessage(String message) { try { MailDTO mailDTO = new ObjectMapper().readValue(message, MailDTO.class); ValidationUtil.validateMailDTO(mailDTO); mailServiceImpl.sendMail(mailDTO, null); } catch (JsonParseException e) { logger.warn("Bad JSON in message: " + message); } catch (JsonMappingException e) { logger.warn("cannot map JSON to NotificationRequest: " + message); } catch (Exception e) { logger.error(e.getMessage()); } } } 总结 通过使用RabbitMQ,您可以避免服务之间直接的HTTP调用,并消除核心微服务的紧密耦合。这将帮助您在更高级别上实现微服务的可伸缩性,并在微服务之间添加故障转移机制。 程序员学习交流群:878249276,欢迎一到五年的工程师加入,合理利用自己每一分每一秒的时间来学习提升自己,不要再用"没有时间“来掩饰自己思想上的懒惰!趁年轻,使劲拼,给未来的自己一个交代!

优秀的个人博客,低调大师

全面对比,深度解析 Ignite 与 Spark

经常有人拿 Ignite 和 Spark 进行比较,然后搞不清两者的区别和联系。Ignite 和 Spark,如果笼统归类,都可以归于内存计算平台,然而两者功能上虽然有交集,并且 Ignite 也会对 Spark 进行支持,但是不管是从定位上,还是从功能上来说,它们差别巨大,适用领域有显著的区别。本文从各个方面对此进行对比分析,供各位技术选型参考。 一、综述 Ignite 和 Spark 都为 Apache 的顶级开源项目,遵循 Apache 2.0 开源协议,经过多年的发展,二者都已经脱离了单一的技术组件或者框架的范畴,向着多元化的生态圈发展,并且发展速度都很快。 Ignite Ignite 技术来源于 GridGain 公司的商业产品,于 2014 年将绝大部分功能捐赠给 Apache 社区,并于 2015 年 8 月毕业成为 Apache 的顶级项目。Ignite 目前一直保持着高强度的快速迭代式开发,基本一个季度发布一个大版本,从提交数量、版本发布数量等若干指标来评估,一直保持在 Apache 社区 300 多个开源项目的前五位。目前已经聚拢了来自多家组织或公司的众多开发者,处于非常活跃的状态,开发者社区和产品生态正在形成中。 Spark 作为 Hadoop 生态圈重要成员的 Spark 于2009 年由 Matei Zaharia 在加州大学伯克利分校 AMPLab 开发,于 2013 年 6 月捐赠给 Apache 基金会并切换协议至 Apache2.0,2014 年 2 月毕业成为 Apache 的顶级项目。鉴于 Spark 核心计算模型的先进性,它吸引了众多大企业和组织的积极参与,促成了 Spark 的高速发展和社区的空前繁荣,随着 Spark 技术不断地向纵深发展以及向外延伸,形成了庞大的 Spark 社区和生态圈,目前几乎成为了大数据领域影响力最大的开源项目。 二、定位 Ignite 和 Spark 都是分布式架构,都归类于目前的大数据技术类别,二者都是利用大量内存的高性能,为原有的技术方案进行提速,但是定位差别很大。 Ignite Ignite 的核心定位是一个分布式的内存缓存解决方案,通过将数据保存在内存中,提供比传统的基于磁盘的方案更快的性能。然后在分布式缓存的基础上,一方面进一步深入,通过标准 SQL 功能的引入,向分布式内存数据库的方向发展,一方面功能不断扩展,引入了内存计算、流数据处理、机器学习等功能。Ignite 部署灵活,可以轻易地集成进已有的系统,非常方便地与已有的数据库系统集成(NoSQL、HDFS 也支持),为已有的业务进行加速服务。不颠覆已有架构,是 Ignite 很重要的逻辑。 Spark Spark 的核心定位是一个分布式统一大数据分析引擎,通过先进的 RDD 模型和大量内存的使用,解决了使用 Hadoop 的 MapReduce 进行多轮迭代式计算的性能问题。然后在 RDD 的基础上不断完善,引入了 Dataset 和 DataFrame、SparkSQL、Spark Streaming、SparkML 等更高级的功能。Spark 对 Hadoop 技术栈有非常好的支持,很多可以直接集成,虽然也可以支持 RDBMS 的读写,但是这不是 Spark 主要的关注方向。 三、核心技术 Ignite 和 Spark 核心技术截然不同。 Ignite Ignite 的核心数据结构为分布式哈希,即键-值型存储,和 Redis 等可以归于同一类,对于分布式内存数据库,核心技术来源于 H2 数据库,也即 Ignite 对 SQL 的支持来源于 H2 的 SQL 引擎。Ignite 的核心计算模型为 MapReduce+支持 SQL 查询的缓存优化。 Ignite 的内存数据模型为固化内存架构,同时支持内存存储和磁盘存储(可选)。数据保存在堆外,因此只要内存够用,不用担心内存溢出,也不用担心大量占用内存导致垃圾回收暂停。 Spark Spark 的核心是建立在统一的抽象 RDD 之上,使得 Spark 的各个组件可以无缝进行集成,在同一个应用程序中完成大数据计算任务。RDD 的设计理念源自 AMP 实验室发表的论文《Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing》。RDD 可以认为是 MapReduce 的超集,也即 RDD 也可以实现传统的 MapReduce 计算机制。 四、部署模型 Ignite 和 Spark 的组网基本模式有很大的不同,但在更高层面的资源管理上,支持能力是差不多的。 Ignite Ignite 集群基于无共享架构,所有的集群节点都是平等的、独立的,整个集群不存在单点故障。 通过灵活的 Discovery SPI 组件,Ignite 节点可以自动地发现对方,因此只要需要,可以轻易地对集群进行缩放。 Ignite 可以独立运行,可以组成集群,可以运行于 Kubernetes 和 Docker 容器中,也可以运行在 Apache Mesos 以及 Hadoop Yarn 上,可以运行于虚拟机和云环境,也可以运行于物理机,从技术上来说,集群部署在哪里,是没有限制的。 Ignite 还支持嵌入式部署,也就是和应用集成在一起。 Spark Spark 支持四种分布式部署方式:分别是 Standalone、Spark on Mesos、Spark on YARN 和 Kubernetes。 Spark 的部署属于 Master/Slave 模式,可能存在单点故障问题,但是可以通过 ZooKeeper 解决。 五、功能 内存计算 Ignite 和 Spark 都有内存计算的能力,尤其内存计算是 Spark 的主打功能,从技术原理上来看它们的能力:SparkRDD > Ignite MapReduce+Cache > Hadoop MapReduce。 但具体来说,Ignite 的计算模型优于 Hadoop 毋庸置疑。但是 Ignite 和 Spark,虽然 Ignite 技术原理上不如 SparkRDD 先进,但是落实到具体的实践中,则要看具体的业务场景、技术人员对技术和设计的掌控力、代码优化程度等,无法直接下结论,这个要具体问题具体分析。 Spark 擅长的多轮迭代式计算、交互式计算、图计算等,Ignite 则没有对应的解决方案。 Ignite Ignite 的计算功能原理与 Hadoop 一致,都是 MapReduce 范式,即可以将一个批量任务拆分为多个部分,然后在不同的节点并行执行,这样就可以并行地利用所有节点的资源,来减少计算任务的整体执行时间。 但是 Ignite 的计算有两个重要的独特之处,一个是鉴于 Ignite 灵活的部署模型,Ignite 可以是离线计算,也可以是在线计算,对于在线的场景,比如 OLTP 业务,它可以通过将请求中的计算负载同步地放在多个可用节点上,然后将结果返回,这样可以提高整个系统的扩展性和容错能力。 另一个是计算可以和数据并置,即计算会被发送到要处理的数据所在的节点,这样会使开销最小化。 Spark Spark 的计算模型从原理上来说,作为 MapReduce 的超集是非常先进的,Spark 也具有 MapReduce 的机制和开发接口,所以用 Spark 实现 MapReduce 计算模型是可以的。 Spark 的核心概念 RDD,作为一个通用的数据抽象,着重解决了 MapReduce 模型在处理多轮迭代式算法(比如机器学习、图算法等)的性能瓶颈,避免了中间结果落盘导致的大量数据复制、磁盘 IO 和序列化开销。但是 Spark 的计算功能是按照离线系统设计的,无法实现 Ignite 的在线计算功能。 存储支持能力 Ignite 和 Spark 都可以将第三方存储作为数据来源用作后续的处理,两者对第三方存储的支持程度、侧重点完全不同。这里说的第三方存储,暂时划分为传统的 RDBMS 和 NoSQL(HDFS、Hive、Cassandra 等)。但是 Ignite 在支持第三方存储的同时,本身还具有原生持久化的能力。 Ignite RDBMS:Ignite 作为一个缓存系统,天然对 RDBMS 有良好的支持,基本上只要支持 JDBC/ODBC 协议的数据库都没有问题。对于数据的加载、数据的读写及其一致性(事务)保证、各种工具的支持、各种通信协议的支持都一应俱全,是一个完整的方案; NoSQL:Ignite 对于各种 NoSQL 数据库的支持是有限的,因为功能定位的原因,不是任何 NoSQL 产品都适合和 Ignite 整合进而提升能力,就目前来说,Ignite 在不同的功能场景对 NoSQL 提供了支持,包括对 HDFS 的支持,也包括与 Cassandra 的原生集成; 原生持久化:Ignite 基于固化内存架构,提供了原生持久化,可以同时处理存储于内存和磁盘上的数据和索引,它将内存计算的性能和扩展性与磁盘持久化和强一致性整合到一个系统中。 原生持久化以有限的性能损失,透明地提供了更强大的功能,即使整个集群重启,内存不需要预热,数据可以直接访问。 Spark RDBMS:SparkRDD 可以将 RDBMS 作为数据来源之一,支持 RDBMS 数据的批量读写,也支持各种类型的 RDBMS,但是 Spark 对 RDBMS 的读写,属于批量模式,Spark 更多地会将 RDBMS 作为分析型业务的数据来源之一,最后如有必要,则将业务分析的结果批量回写 RDBMS; NoSQL:Spark 原生支持 JDBC、JSON、Parquet、csv、libsvm 以及 orcFile 等,也可以通过扩展接口自定义数据源。Spark 可以直接或者通过各种连接器读取 Hive、Hbase、Cassandra 中的数据,然后创建对应的 RDD,写入也是同理,这个能力是 Ignite 所不具备的; 原生持久化:Spark 不具备原生的持久化能力。 SQL Ignite 和 Spark 都支持 SQL,但是两者的定位和能力,有所不同。 Ignite Ignite SQL 目前的语法兼容于 ANSI-99,支持查询、删除、更新与插入,但语法和功能与标准并不完全一致。Ignite 如果做好了数据并置,SQL 查询的性能是很好的,同时 Ignite 还支持索引,这都进一步提升了 Ignite SQL 的能力。另外,Ignite SQL 对缓存的功能进行了极大的增强,通常用于缓存的在线查询和计算,用于离线数据处理也是可以的。 Spark SparkSQL 最初来源于 Shark 项目,后来两者进行了合并,SparkSQL 构建于 Dataset/DataFrame 机制基础上,目前只支持查询,主要适用于分析型业务以及对来自不同数据源的结构化数据进行处理。它也可以进行交互式查询,因为不支持索引等等原因,所以性能较差,响应时间可能较长。 数据一致性(事务) Ignite Ignite 整体来说对事务的支持还不完善,具体来说,在键-值 API 层面,有完善的事务机制,主要原理来自于经过优化的二阶段提交协议,但是 SQL 层面的 DML 语句还不支持事务,未来版本会解决该问题。 在计算层面,因为支持丰富的编程接口,也可以非常容易地与各种开源的 ORM 框架集成,所以也可以方便地对事务进行细粒度的控制,比如 CRUD 都是没问题的。 Spark SparkSQL 本身并不提供事务机制。Spark 本身也不适用于 RDBMS 的细粒度数据维护,RDBMS 对于 Spark 来说,只是数据的一个来源和存储地之一,通常都是批量操作,如果批量操作失败,Spark 有容错机制可以重来,以保证整体的一致性。 流计算 Spark 有 Spark Streaming,Ignite 也支持流数据处理。 Ignite Ignite 可以与主流的流处理技术和框架进行集成,比如 Kafka、Camel、Storm 与 JMS,提供可扩展和容错的能力。流处理技术为 Ignite 提供了一种数据加载机制,针对流式数据,Ignite 也提供了各种处理和查询功能。Ignite 社区官方提供了 10 种流处理技术的集成实现,利用统一的 API,开发者也可以自行开发流处理技术实现。Ignite 为所有流入 Ignite 的数据以可扩展和容错的方式提供至少一次保证。 Spark Spark Streaming 是基于 Spark 的流式批处理引擎,其基本原理是把输入数据以某一时间间隔批量的处理,即以时间为单位切分数据流,每个切片内的数据对应一个 RDD,进而可以采用 Spark 引擎进行快速计算。其同样支持众多的数据源,内部的数据表示形式为 DStream。Spark Streaming 吞吐量高,可以做复杂的业务逻辑,但是秒级别的延迟是否符合业务需求需要确认。Spark Streaming 可以与 Spark 其他技术完美集成,包括 SparkML、SparkSQL 等。 机器学习 Ignite 和 Spark 都支持机器学习。 Ignite Ignite 从 2.5 版本开始,提供了完整的机器学习解决方案,Ignite 的机器学习有两个优点:一个是如果已经在 Ignite 中持有了大量的数据,那么继续在 Ignite 中进行机器学习的训练和推理,就不需要在不同系统间进行 ETL 的等待,提高效率。另一个是 Ignite 提供了一系列的机器学习和深度学习算法,对 Ignite 的分布式并置处理进行优化,这样在处理大规模的数据集或者不断增长的输入数据流时,提供了内存级的速度和近乎无限的扩展性,而不需要将数据移到另外的存储。目前支持的算法包括回归、分类、聚类以及对数据进行预处理等。另外 Ignite 还支持了一组遗传算法,该算法适合于以最优的方式检索大量复杂的数据集。 Spark Spark 很早就包含了机器学习库,RDD 模型面向的一个主要场景就是机器学习这样的多轮迭代式计算。目前的 Spark 机器学习库有 2 个实现,正在逐步向 SparkML 过渡,SparkML 基于 DataFrame API,更强大更灵活,而传统的 MLlib 会处于维护状态。SparkML 基于 DataFrames 对 API 进行了统一,使用体验更友好。可以使用 SparkSQL 等更高级的功能,支持流水线,特别是特征变换。Spark 的机器学习因为 RDD 的原因性能更好,支持的算法也更多。 图计算 Ignite 暂不支持 Spark Spark 中包含了 GraphX,这是一个图计算组件。它在 RDD 基础上引入了新的 Graph 抽象,为了支持图形计算,GraphX 公开了一组基本运算符(例如子图、连接顶点和聚合消息)以及 Pregel API 的优化变型。此外,GraphX 还包括了越来越多的图形算法和构造者,以简化图形分析任务。 开发语言和客户端协议 Ignite Ignite 是以 Java 语言为主进行开发的,因此可以在 JVM 支持的任何操作系统和架构上部署和运行。Java 的 API 支持 Ignite 的所有功能,使用 Java 或者 Scala 开发的应用,相关的逻辑可以直接嵌入 Ignite,然后借助于 SQL 以及键-值操作与集群进行交互,执行分布式计算和机器学习算法等等。 除了 Java,Ignite 还支持 .NET 平台与 C++,Ignite.NET 和 Ignite C++ 使用 JNI,会把大部分的调用转发给 Java。 Ignite 还支持使用标准的 JDBC 或者 ODBC 连接,可以像其它 SQL 存储一样与 Ignite 进行交互。Ignite 还为 Java、.NET 和 C++ 开发者提供原生的 SQL API,性能更好。 Ignite 还支持其它的语言访问,比如 Python、Ruby、PHP 与 NodeJS,另外还可以考虑使用 Ignite 的二进制客户端协议接入集群。 Spark Spark 使用 Scala 语言开发,目前支持使用 Scala、Java、Python、R 语言开发 Spark 程序。 监控运维工具支持 Ignite Ignite 开源版没有提供图形化的监控工具,但是提供了简易的命令行工具,同时为了简化开发,Ignite 提供了图形化的 Web 控制台。 Ignite 运行时可以通过 API 接口获取大量的指标,通过编程的方式了解集群的状况。 如果需要强大的监控运维工具,可以购买 GridGain 的商业版软件和服务。如果搭建的是一个小规模的集群,鉴于 Ignite 的无共享架构,部署运维都是比较简单的。 Spark Spark 启动后会有一个 Web 控制台,虽然不是很美观,但是可以从总体上看到 Spark 的当前运行状态。 Spark 属于 Master/Slave 模式,如果直接拿开源版本搭建大规模集群,部署运维还是非常麻烦的,但是国内有很多厂商开发包含 Spark 组件的大数据平台,为部署和运维提供了很大的便利。 六、总结 综上所述,Ignite 和 Spark 功能都很全面,已经脱离了简单开源技术组件的范围,都成为了自成体系的开源大数据平台。上面主要对 Ignite 和 Spark 的主要功能做了简单的梳理对比,不一定全面,也没有对其各自特有的功能进行梳理。但经过这么一些分析,还是可以得出这样一个结论:两者差别很大,定位不同,因此会有不同的适用领域。 Ignite Ignite 以缓存为中心构建大数据体系,底层存储模型更偏向传统关系型数据架构,上层为应用开发的便利做了大量的工作,包括为各种常见语言和协议提供支持。中间核心层在缓存的基础上不断向外扩展,功能日趋丰富强大。 Ignite 从定位上来说有两个突出点,一是可以独立组网,构建独立的大数据平台,然后企业在其上开发全新的大数据应用,包括缓存、计算、流数据处理、机器学习应用等等。二是还可以与传统应用紧密整合,在不颠覆已有架构的前提下,帮助用户进行传统应用的分布式架构转型。为运行多年的复杂、运行缓慢、技术架构落后的业务系统,提供加速能力的同时,引入众多的先进功能,大幅提升原有系统的能力从而延长已有架构的寿命,产生更大的价值,保护客户原有投资。 Ignite 的定位和架构,与 Hadoop 体系大数据组件有很大的不同,但是并不冲突,即使企业已经部署了基于 Hadoop 技术体系的大数据平台,那么也可以继续引入 Ignite 作为补充。 Spark Spark 以计算为中心构建大数据体系,底层存储对各种数据源进行了抽象,总体上更偏向非结构化的数据,上层应用支持多种语言,核心层基于 RDD 模型,然后进行了大量的扩展,支持了更多更高级的功能,比如 SparkSQL、Spark Streaming、SparkML 与 Spark GraphX 等。Spark 的核心优势是进行多轮迭代式计算、交互式计算以及图计算等。 Spark 是围绕 RDD 构建生态,用户可以以 Spark 为中心搭建大数据平台,满足大量数据的获取、清洗、处理、加载、计算、存储等需求,核心定位是解决大数据的分析问题。虽然 Spark 的计算能力也可以处理传统的关系型数据,但这并非 Spark 的强项,因此和传统业务系统并没有太多的交集。企业基于 Spark 搭建大数据平台之后,其上的应用基本需要全新开发。传统的数据处理业务,即使适合用 Spark 实现,原有的业务逻辑也无法直接、简单地移植进入 Spark 技术堆栈。Spark 技术堆栈更适合用于处理传统技术处理起来很麻烦、性能很差、数据量又很大的非结构化数据,Spark 适合对众多系统的相关数据进行整合,通过分析后能产生更大价值的业务场景。 本文来自云栖社区合作伙伴“开源中国” 本文作者:李玉珏 原文链接

优秀的个人博客,低调大师

全方面解析Web应用程序开发

Web应用程序是与服务器端编程相结合的动态Web站点,它提供诸如与用户交互,连接到后端数据库以及向浏览器生成结果等功能。 Web应用程序的示例包括网上银行,社交网络,在线预订,电子商务/购物车应用程序,互动游戏,在线培训,在线调查,博客,在线论坛,内容管理系统等。 技术 创建Web应用程序有两种主要的程序,客户端脚本和服务器端程序: I.客户端脚本 - 客户端脚本是浏览器执行或解释的代码类型。 客户端脚本通常可由站点的任何访问者查看(从视图菜单中单击“查看源”以查看源代码)。 以下是一些常见的客户端脚本技术: HTML(超文本标记语言) CSS(层叠样式表) JavaScript的 Ajax(异步JavaScript和XML) jQuery(JavaScript框架库 - 常用于Ajax开发) MooTools(JavaScript框架库 - 常用于Ajax开发) Dojo Toolkit(JavaScript框架库 - 常用于Ajax开发) II。服务器端脚本/编码- 服务器端脚本是Web服务器执行或解释的代码类型。 任何访问者或一般公众都无法查看或访问Server Side Scripting。 以下是常见的服务器端脚本技术: PHP(非常常见的Server Side Scripting语言 - 基于Linux / Unix的开源 - 自由分发,通常与MySQL数据库结合) Zend Framework(PHP的面向对象的Web应用程序框架) ASP(Microsoft Web服务器(IIS)脚本语言) ASP.NET(微软的Web应用程序框架 - ASP的后继者) ColdFusion(Adobe的Web应用程序框架) Ruby on Rails(Ruby编程的Web应用程序框架 - 自由分发) Perl(通用高级编程语言和服务器端脚本语言 - 自由分发 -但失去了PHP的流行度) Python(通用高级编程语言和Server Side Scripting语言 - 自由分发) 程序库 程序库是常用函数,类或子程序的集合,它们允许开发人员轻松地向框架化或模块化类型应用程序添加或编辑功能,从而提供易于开发和维护。 Web应用程序框架 Web应用程序框架是在体系结构系统中组织的程序库,组件和工具集,允许开发人员使用快速有效的方法构建和维护复杂的Web应用程序项目。 Web应用程序框架旨在通过设置文件夹组织和结构,文档,指南和库(常用功能和类的可重用代码)来简化编程并促进代码重用。 Web应用程序框架的优点 程序操作和逻辑与HTML,CSS和设计文件分开。这有助于设计人员能够在没有程序员帮助的情况下编辑界面并进行设计更改。 构建基于模块,库和工具,允许程序员以快速有效的方式轻松共享库并实现复杂的功能和特性。 该结构有助于使用一致的逻辑和编码标准生成最佳实践编码,并使其他开发人员能够在短时间内熟悉代码。 编码指南,标准和惯例 编码指南是用于编写Web应用程序项目的规则和标准集。 这些规则和标准适用于编码逻辑,文件夹结构和名称,文件名,文件组织,格式和缩进,语句,类和函数以及命名约定。这些规则还强制编写明确的注释并提供文档。 使用编码指南的重要好处 为多个程序员创建最佳环境,以便在同一个项目上工作 提供易维护性和版本管理 提供更好的可读性和对源代码的理解 确保其他开发人员能够在短时间内理解并熟悉代码 Web应用程序生命周期模型 Web应用程序生命周期是开发Web应用程序以及参与开发过程的多个团队的参与过程。每个团队都可以提出自己独特的方式。 一些公司遵循某种标准模型,如SDLC(系统开发生命周期)或敏捷软件开发模型。 SDLC是开发软件或Web应用程序的传统过程,包括研究以识别和定义应用程序需求,信息分析,架构设计和规范蓝图,团队参与,编程,测试和错误修复,系统测试,实施和维护。 敏捷软件/ Web应用程序开发是迭代开发过程和开发过程实践,侧重于相关人员的协作,并提供更好的过程以允许Web应用程序需求的修订和发展。敏捷方法包括研究,分析,项目管理,设计,编程,实施,频繁测试,适应和维护。 Web应用程序开发过程 Web应用程序开发过程在应用程序开发中组织实用的过程和方法。 有关详细信息:Web应用程序开发过程 以下过程列表和建议文档为Web应用程序生命周期和过程提供了一个很好的概述: 路径图文档:定义Web应用程序,目的,目标和方向 研究和定义受众范围和安全文件 创建功能规范或功能摘要文档 团队协作和项目管理文档 技术选择,技术规范,Web应用程序架构和结构的说明图,开发方法,版本控制,备份,升级,扩展和增长规划文档,服务器硬件/软件选择 第三方供应商分析和选择(商家帐户和支付网关,SSL证书,托管服务器/共同服务器提供商,履行中心,网站访客分析软件,第三方结账系统等) 应用程序可视指南,设计布局,界面设计,线框架 数据库结构设计和Web应用程序开发 测试:质量保证,多浏览器兼容性,安全性,性能 - 负载和压力测试,可用性 维护 Web应用程序测试 测试是Web应用程序开发过程的重要部分。有时,测试会比开发本身消耗更多的人力和时间。 以下是任何Web应用程序开发过程所需的一些最常见的测试: 质量保证和错误测试 多浏览器兼容性 应用安全 性能 - 负载和压力测试 可用性 趋势与受欢迎程度 企业构建Web应用程序的需求正在大幅增长。 如果计划和构建正确,Web应用程序可以: 为数百万消费者和企业提供服务 从消费者,企业和广告商处获得大量的多层/多类别收入 根据受众覆盖面,受欢迎程度,技术和潜在增长,轻松构建业务声誉和资产 以下是公司构建Web应用程序的充分理由: 公司希望简化其内部部门和职能,运营,销售和项目管理等。 企业希望利用基于Web的应用程序的灵活性和多功能性,从传统的桌面应用程序平台转向Web应用程序平台 公司希望通过在线提供便捷的服务和解决方案来获得更多客户或更好地服务现有客户 公司希望构建新的Web应用程序,为在线用户和企业提供创新服务或解决方案 web前端开发学习交流群:731771211

优秀的个人博客,低调大师

插件化框架DL源码的简单解析

目前行业内已经有较多的插件化实现方案。本文主要对DL(DynamicLoadApk)这一个开源的侵入式插件化方案进行简单分析。因为Service组件插件化的实现逻辑和Activity大体相似,所以在这里主要用Activity来分析。 基本介绍 基本概念 1、宿主:主App,可以加载插件.2、插件:插件App.被宿主App加载的App.3、组件:对于Android来说,指的就是Android中的四大组件(Activity、Service、BroadcastReceiver、ContentProvider) 基本使用 1、PluginActivity public class MainActivity extends DLBasePluginActivity { @Override public void onCreate(Bu

优秀的个人博客,低调大师

网易工业级WebRTC应用实践深度解析

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/vn9PLgZvnPs1522s82g/article/details/80994030 本文来自网易云信CTO赵加雨在LiveVideoStackCon2017上的分享,并由 LiveVideoStack整理而成。赵加雨阐述了网易在WebRTC上的探索和改进,以及如何与WebRTC进行互通。 文 / 赵加雨 整理 / LiveVideoStack 概览: 网易在音视频领域有10多年丰富经验的积累,在公司内部我们把自己的这一套工业级的功能完整的音视频技术方案称为NRTC,NRTC的意思就是NetEase RTC。近几年,WebRTC非常火热,尤其是2017年,苹果宣布在Safari 11里面支持WebRTC,所以说Web本身也变成了一个非常重要的入口,是音视频很重要的一个终端,对于我们来说,要在我们的NRTC里面实现对WebRTC的支持,也就是要能够支持Web这样一个终端和入口。 本次分享的主要内容: 1、简要介绍NRTC的技术方案 2、怎样理解WebRTC 3、如何实现NRTC支持WebRTC 1、NRTC技术解决方案 NRTC全称为NetEase RTC,是网易公司实现的一套工业级的功能完整的音视频技术解决方案。 1.1 NRTC技术架构图: 从架构图中,大家可以看到,我们有NRTC SDK,这是实时音视频通话的客户端SDK,有PC端、移动端的SDK,另外有我们的NRTC MCU,这是一个媒体服务器。在客户端上NRTC SDK会负责推拉流到NRTC MCU,NRTC MCU负责把媒体流中转给其它的客户端,同时它也会中转给 NRTC BMS,BMS其实就是互动直播服务器,在BMS上会做混音混屏,将音视频混成一路流后再推给NRTC LVS,LVS就是直播源站,最后再推给我们的NCDN网络,通过NCDN的海量分发,使用我们的NRTC Player就可以支持海量的用户拉流。在这里面大家可以看到左半边是UDP的方案,右半边是一个TCP的方案,同时我们在Server端有很多像录制、混屏、混音、转码,包括存储,后续还有基于存储的点播。 1.2 NRTC支持的功能: 实时音视频通话 直播 互动直播 点播 互动白板 短视频 1.3 音视频技术栈 信令: SDP、JSEP、SIP、Jingle、ROAP 传输: RTP、RTCP、DTLS、RTMP、FLV、HLS P2P: ICE、STUN、TURN、NAT 网络: UDP、TCP 音频: Opus、G711、AAC、Speex、3A 视频: H264、VP8 QoS: FEC、NACK、BWE Server: SFU、MCU 端: Capture、Render、各种适配 2、怎样理解WebRTC? WebRTC是由W3C和IETF定义的规范,简单来讲,就是一个在浏览器里面去实现音视频会话的框架(JavaScript API),它不需要安装,可以满足P2P传输。只要通过信令的协商,也可以和传统的音视频应用去做互联互通。另外,WebRTC也是一个开源项目,是由谷歌公司提供的基于C++的可以跨平台的开源的音视频框架,是功能完整的一个音视频SDK,一般用libwebrtc来表示这个开源项目。 2.1 WebRTC的体系结构 在这个简单的架构里面,主要包括了网络传输、音频引擎、视频引擎,,它主要的功能和内容其实是C++实现的,然后封装了一层JavaScript的API,让你用JavaScript能够调用到这些功能。 2.2 WebRTC的特点和局限 通过JavaScript的API在浏览器上调用 没有定义信令 基于客户端,没有SFU/MCU 完全基于标准 依赖浏览器来实现 2.3 如何使用WebRTC 1)方法一:基于JavaScript的API进行音视频的应用 完全基于JavaScrip去做,没有媒体相关的Server,可靠性或者功能会很受限,但可以控制很低的成本。 2)方法二:基于libwebrtc来实现 由于WebRTC本身这些C++的Code,没有很好的工程化,所以在异常保护,错误恢复等方面做得不太够。在真实的应用当中,可能要做很多的调整和改造。 3)方法三:兼容、支持WebRTC 对于一些有成熟的音视频框架体系的公司,可以在自己的体系上来兼容、支持WebRTC。 2.4 NRTC和WebRTC的比较 NRTC早于WebRTC NRTC是VoIP的完整解决方案,大概可以说NRTC SDK约等于WebRTC NRTC的实现更灵活,WebRTC是基于标准的,有很多受限的方面 NRTC是工业级的实现,技术框架更加成熟 3、如何实现NRTC支持WebRTC 3.1 在NRTC中连接WebRTC的原理 从图中的简要架构设计可以看出,如果想要NRTC的技术方案和Web端建立连接,可以通过WebRTC Gateway这种方式,WebRTC GateWay跟NRTC MCU之间是通过UDP协议传输NPDU的流媒体,另一端通过SRTP连接Web。 下面给大家讲解一下WebRTC GateWay: 在WebRTC GateWay里面主要包括两部分:信令和媒体,在信令方面,我们主要提供了WebSocket,信令是为了帮助两个端SDP和ICE去交互,由提供的WebSocket来进行连接;在媒体方面,要实现ICE框架和SRTP协议栈来建立网络通讯的连接,还要做一个包的转封装工作,把RTP的包和NPDU的包相互转换。有了这个WebRTC GateWay,经过我们的MCU就可以跟我们的其他的端实现互联互通。 3.2 实现NRTC兼容WebRTC所做的工作 实现浏览器的兼容 建立ICE框架 搭建RCTP协议栈,得到反馈值 确保Web端的可靠连接 拥塞控制 3.3 浏览器的“坑点” 1)利用adapter.js来实现浏览器的兼容 各种不同版本的浏览器实现这个规范的时候可能会接口会有些不一样,主要还是接口层的不一样,通过adapter.js可以兼容这些接口。 2)视频分辨率 有些浏览器支持视频分辨率的裁切,有些不支持。 3)媒体流的生命周期 浏览器上的媒体流的生命周期有限,有时得到的媒体是没有视频或音频。 4)请求得到用户媒体成功,却没有媒体流发过来。 3.4 Lite ICE框架 在ICE框架中包括NAT,STUN-RFC5389,TURN-RFC5766,ICE-RFC5245,TCP。在一个高可靠的网络连接中,还要能够支持TCP连接。当一方是Serve且有固定的公网IP,另外一方是客户端的这种情况下,可以使用Lite ICE框架。在Lite ICE这种情况下面,你只要给一个Host candidates,即当你的Server回来,给Server一个公网IP,不需要再去其他的探测,你只要给Server的Host candidates就可以了,在Lite ICE情况下面,是有Full peer这端会发起连通的检查,也就是由浏览器这一端发起连通检查,它只需要两步就可以完成连通检查。 3.5 网络监测 1)在信令中,WebSocket有断网事件通知 2)RTCPeerConnection有断网事件通知 3)在TCP连接上,有基于signaling channel的keepalive 3.6 断开重连 1)Start over Detach stream,销毁现有连接等 信令连接、鉴权、媒体连接 2)ICE restart 3.7 Multiplexing and bundle 减少UDP的连接数 减少UDP的连接有两个好处,第一,可以减少建立连接的时间,第二,在企业环境里面,很多UDP的一个端口连接需要找网管去配的,如果有多个连接,会加大配置和维护的难度。 3.8 丢包恢复和拥塞控制 1)GCC GCC是在WebRTC本身现有的一套拥塞控制框架,它是有两种模型,一种是基于丢包的模型,一种是基于时延的模型,从图中可以看出,发送端有一个叫丢包的模型,在接收端有一个基于时延的模型(在最新的WebRTC里已调整为都在发送端了);在发送端它会做带宽评估,评估管理以后流媒体送到接收端,那接收端之它有个基于延时的一个带宽评估,评估完以后,当它发现这个带宽受限,或者它需要调整码率,它通过REMB将消息送给发送端,让发送端重新调整码率,从而来实现一个带宽评估和自适应码率的过程。 2)如何在WebRTC GateWay中让GCC工作起来 REMB 先在接收端进行一个最大接收码率估测,在WebRTC Gateway上通过REMB消息,告诉发送端如何调整码率和带宽。 GCC feedbacks 通过反馈给Delay-based controller正确的Transport cc来让它计算正确的时延估计,以及带宽评估;通过反馈Loss-based controller两种RTCP的报文(SR/RR),来进行丢包的计算。 3)丢包重传(NACK) 实现一个双向的丢包重传,通过WebRTC GateWay和浏览器之间 发送NACK的RTCP feedback信息来进行丢包重传。 3.9 分享一个SDP的例子

优秀的个人博客,低调大师

jvm原理解析——不疯魔不成活

摘要: 作为一名java开发人员,如果有人问你java是什么?java是如何运行的?你该如何回答,事实上java是有Java语言、class文件、jvm、Java API共同组成。 java程序运行 *.java文件-->编译器-->*.class文件-->线程启动(main)-->jvm-->操作系统-->硬件 通过上面的流程我们可以看出java程序的执行顺序,那么jvm到底是什么,class文件到底是如何在jvm中运行就显得很重要了。 jvm原理 什么是jvm openjdk源码地址http://hg.openjdk.java.net/jdk9 JVM是一个计算机模型,JVM对Java可执行代码,即字节码(Bytecode)的格式给出了明确的规格。这一规格包括操作码和操作数的语法(也就是cpu指令集)和数值、标识符的数值表示方式、以及Java类文件中的Java对象、常量缓冲池在JVM的存储映象。 JVM的组成 JVM指令系统、JVM寄存器、JVM 栈结构、JVM 碎片回收堆、JVM 存储区 JVM指令 Java指令也是由操作码和操作数两部分组成,与RISC CPU采用的编码方式是一致的,也就是精简指令集,目前UNIX、Linux、MacOS系统使用RISC,我们目前知道的x86架构CPU使用的CISC编码,也就是复杂指令集。 JVM寄存器 1.pc程序计数器 2.optop操作数栈顶指针 3.frame当前执行环境指针 4.vars指向当前执行环境中第一个局部变量的指针 jvm的装载 windows操作系统装入JVM是通过jdk中Java.exe来完成,通过下面4步来完成JVM环境。 1.创建JVM装载环境和配置 2.装载JVM.dll(C:Program FilesJavajre1.8.0_151inserver linux在jre/lib/server下) 3.初始化JVM.dll并挂接到JNIENV(JNI调用接口)实例 4.调用JNIEnv实例装载并处理class类。 JVM虚拟机相当于x86计算机系统,Java解释器相当于x86CPU JVM运行数据 JVM定义了若干个程序执行期间使用的数据区域。这个区域里的一些数据在JVM启动的时候创建,在JVM退出的时候销毁。而其他的数据依赖于每一个线程,在线程创建时创建,在线程退出时销毁。分别有程序计数器,堆,栈,方法区,运行时常量池 程序计数器:每个线程一旦被创建就拥有了自己的程序计数器。当线程执行Java方法的时候,它包含该线程正在被执行的指令的地址。但是若线程执行的是一个本地的方法,那么程序计数器的值就不会被定义。 常量缓冲池和方法区:常量缓冲池用于存储类名称、方法和字段名称以及串常量。方法区则用于存储Java方法的字节码。对于这两种存储区域具体实现方式在JVM规格中没有明确规定。这使得Java应用程序的存储布局必须在运行过程中确定,依赖于具体平台的实现方式。 栈:Java栈是JVM存储信息的主要方法。当JVM得到一个Java字节码应用程序后,便为该代码中一个类的每一个方法创建一个栈框架,以保存该方法的状态信息。每个栈框架包括以下三类信息: 局部变量:对应vars寄存器指向该变量表中的第一个局部变量,用于存储一个类的方法中所用到的局部变量。 执行环境:对应frame寄存器的当前执行环境指针,用于保存解释器对Java字节码进行解释过程中所需的信息。它们是:上次调用的方法、局部变量指针和操作数栈的栈顶和栈底指针。执行环境是一个执行一个方法的控制中心。例如:如果解释器要执行iadd(整数加法),首先要从frame寄存器中找到当前执行环境,而后便从执行环境中找到操作数栈,从栈顶弹出两个整数进行加法运算,最后将结果压入栈顶。 操作数栈:对应optop寄存器的操作数栈顶指针,操作数栈用于存储运算所需操作数及运算的结果。 堆:JVM中最大的,应用的对象和数据都是存在这个区域,这块区域也是线程共享的,也是 gc 主要的回收区,一个 JVM 实例只存在一个堆类存,堆内存的大小是可以调节的。类加载器读取了类文件后,需要把类、方法、常变量放到堆内存中,以方便执行器执行。 垃圾回收机制(GC)只发生在线程共享区,也就是堆和方法区,栈不需要回收,线程销毁则栈也销毁, 也就是上图的heap space与method area会发生gc。 通过上图可以发现heap space被分为两部分: Young Generation:又分为Eden space所有的类都是在Eden space被new出来的。From区(Survivor 0 space)和To区(Survivor 1 space)。当Eden space空间用完时,程序又需要创建对象,JVM的垃圾回收器将对Eden space进行垃圾回收(Minor GC),将Eden space中的剩余对象移动到From区。若From区也满了,再对该区进行垃圾回收,然后移动到To区。那如果To区也满了呢,再移动到Old区。 Old Generation:若该区也满了,那么这个时候将产生Major GC(FullGCC),进行Tenured区的内存清理。若该区执行Full GC 之后发现依然无法进行对象的保存,产生异常java.lang.OutOfMemoryError: Java heap space。 Java虚拟机的堆内存设置不够,可以通过参数-Xms、-Xmx来调整。 代码中创建了大量大对象,并且长时间不能被垃圾收集器收集(存在被引用)。 Permanent Generation:是一个常驻内存区域,用于存放JDK自身所携带的 Class,Interface 的元数据,也就是说它存储的是运行环境必须的类信息,被装载进此区域的数据是不会被垃圾回收器回收掉的,关闭 JVM 才会释放此区域所占用的内存。产生异常java.lang.OutOfMemoryError: PermGen space jdk1.8之后已经不会再报报这个错误了。因为类信息的卸载几乎很少发生,这样会影响GC的效率。于是PermGen便被拆分出去了。 程序启动需要加载大量的第三方jar包。例如:在一个Tomcat下部署了太多的应用。 大量动态反射生成的类不断被加载,最终导致Perm区被占满。 jvm的算法 由于算法篇幅太长具体算法可自行查阅资料,主要介绍gc算法发生在什么区。 分代搜集算法:是由复制算法、标记/整理、标记/清除算法共同组成 复制算法发生在Young Generation 标记/整理和标记/清除算法发生在Old Generation和Permanent Generation java验证jvm 栈中一般存放的都是对象的指针和基本类型,存取速度比堆要快,仅次于直接位于CPU中的寄存器。但缺点是,存在栈中的数据大小与生存期必须是确定的,缺乏灵活性。 栈数据可以共享 /*** Created by liustc on 2018/4/20.*/public class JvmTest { public static void main(String[] args) { int a=0; int b=0; System.out.print(a==b); }} "C:Program FilesJavajdk1.8.0_151injava"trueProcess finished with exit code 0 编译器先处理int a = 0;首先它会在栈中创建一个变量为a的引用,然后查找有没有字面值为0的地址,没找到,就开辟一个存放0这个字面值的地址,然后将a指向0的地址。接着处理int b = 0;在创建完b的引用变量后,由于在栈中已经有0这个字面值,便将b直接指向0的地址。这样,就出现了a与b同时均指向0的情况 /*** Created by liustc on 2018/4/20.*/public class JvmTest { public static void main(String[] args) { int a=0; int b=0; a=1; System.out.print("a="+a); System.out.print("b="+b); System.out.print(a==b); }} "C:Program FilesJavajdk1.8.0_151injava" a=1b=0falseProcess finished with exit code 0 再令a=1;那么,b不会等于1,还是等于0。在编译器内部,遇到a=1;时,它就会重新搜索栈中是否有1的字面值,如果没有,重新开辟地址存放1的值;如果已经有了,则直接将a指向这个地址。因此a值的改变不会影响到b的值。 String str = "abc"的工作原理 /*** Created by liustc on 2018/4/20.*/public class JvmTest { public static void main(String[] args) { String str1 = "abc"; String str2 = "abc"; System.out.println(str1==str2); }} "C:Program FilesJavajdk1.8.0_151injava"trueProcess finished with exit code 0 /*** Created by liustc on 2018/4/20.*/public class JvmTest { public static void main(String[] args) { String str1 = "abc"; String str2 = "abc"; str1 = "bcd"; System.out.println(str1 + "," + str2); System.out.println(str1==str2); }} "C:Program FilesJavajdk1.8.0_151injava" bcd,abcfalseProcess finished with exit code 0 赋值的变化导致了类对象引用的变化,str1指向了另外一个新对象!而str2仍旧指向原来的对象。上例中,当我们将str1的值改为"bcd"时,JVM发现在栈中没有存放该值的地址,便开辟了这个地址,并创建了一个新的对象,其字符串的值指向这个地址。 /*** Created by liustc on 2018/4/20.*/public class JvmTest { public static void main(String[] args) { String str1 = "abc"; String str2 = "abc"; str1 = "bcd"; String str3 = str1; System.out.println(str3); String str4 = "bcd"; System.out.println(str1 == str4); }} "C:Program FilesJavajdk1.8.0_151injava"bcdtrueProcess finished with exit code 0 str3这个对象的引用直接指向str1所指向的对象(注意,str3并没有创建新对象)。当str1改完其值后,再创建一个String的引用 str4,并指向因str1修改值而创建的新的对象。可以发现,这回str4也没有创建新的对象,从而再次实现栈中数据的共享。 堆验证 String类 /*** Created by liustc on 2018/4/20.*/public class JvmTest { public static void main(String[] args) { String str1 = new String("abc"); String str2 = "abc";System.out.println(str1==str2);}} "C:Program FilesJavajdk1.8.0_151injava"falseProcess finished with exit code 0 以上代码说明,只要是用new()来新建对象的,都会在堆中创建,而且其字符串是单独存值的,即使与栈中的数据相同,也不会与栈中的数据共享。 使用String str = "abc";的方式,可以在一定程度上提高程序的运行速度,因为JVM会自动根据栈中数据的实际情况来决定是否有必要创建新对象。而对于String str = new String("abc");的代码,则一概在堆中创建新对象,而不管其字符串值是否相等,是否有必要创建新对象,从而加重了程序的负担。这个思想应该是 享元模式的思想。 由于String类的性质,当String变量需要经常变换其值时,应该考虑使用StringBuffer类,以提高程序效率。 执行时间上寄存器 < 堆栈 < 堆 /*** Created by liustc on 2018/4/20.*/public class JvmTest { public static void main(String[] args) { String s1 = "ja"; String s2 = "va"; String s3 = "java"; String s4 = s1 + s2; System.out.println(s3 == s4); System.out.println(s3.equals(s4)); }} "C:Program FilesJavajdk1.8.0_151injava"falsetrueProcess finished with exit code 0 是不是很矛盾啊!是不是又懵逼了? 打印false的原因是,java 重载了“+”,查看java字节码可以发现“+”其实是调用了StringBuilder 所以使用了“+”其实是生成了一个新的对象。所以(s3 == s4)打印false /*** Created by liustc on 2018/4/20.*/public class JvmTest { public static void main(String[] args){ long maxMemory = Runtime.getRuntime().maxMemory();//返回Java虚拟机试图使用的最大内存量。 Long totalMemory = Runtime. getRuntime().totalMemory();//返回jvm实例占用的内存。 System.out.println("MAX_MEMORY ="+maxMemory +"(字节)、"+(maxMemory/(double)1024/1024) + "MB"); System.out.println("TOTAL_ MEMORY = "+totalMemory +"(字节)"+(totalMemory/(double)1024/1024) + "MB"); }} "C:Program FilesJavajdk1.8.0_151injava" -XX:+PrintGCDetailsMAX_MEMORY =1868038144(字节)、1781.5MBTOTAL_ MEMORY = 126877696(字节)121.0MBHeapPSYoungGen total 37888K, used 3932K [0x00000000d6400000, 0x00000000d8e00000, 0x0000000100000000) eden space 32768K, 12% used [0x00000000d6400000,0x00000000d67d7320,0x00000000d8400000) from space 5120K, 0% used [0x00000000d8900000,0x00000000d8900000,0x00000000d8e00000) to space 5120K, 0% used [0x00000000d8400000,0x00000000d8400000,0x00000000d8900000)ParOldGen total 86016K, used 0K [0x0000000082c00000, 0x0000000088000000, 0x00000000d6400000) object space 86016K, 0% used [0x0000000082c00000,0x0000000082c00000,0x0000000088000000)Metaspace used 3325K, capacity 4494K, committed 4864K, reserved 1056768K class space used 363K, capacity 386K, committed 512K, reserved 1048576KProcess finished with exit code 0 将jvm堆初始值改小,触发gc回收 import java.util.Random;/*** Created by liustc on 2018/4/20.*/public class JvmTest { public static void main(String[] args){ long maxMemory = Runtime.getRuntime().maxMemory();//返回jvm试图使用的最大内存量。 Long totalMemory = Runtime. getRuntime().totalMemory();//返回jvm实例的内存大小。 System.out.println("MAX_MEMORY ="+maxMemory +"(字节)、"+(maxMemory/(double)1024/1024) + "MB"); System.out.println("TOTAL_ MEMORY = "+totalMemory +"(字节)"+(totalMemory/(double)1024/1024) + "MB"); String str = "www.baidu.com"; while(true){ str += str + new Random().nextInt(88888888) + new Random().nextInt(99999999); } }} "C:Program FilesJavajdk1.8.0_151injava" -XX:+PrintGCDetailsMAX_MEMORY =1868038144(字节)、1781.5MBTOTAL_ MEMORY = 126877696(字节)121.0MB[GC (Allocation Failure) [PSYoungGen: 32247K->2729K(37888K)] 32247K->10124K(123904K), 0.0045031 secs] [Times: user=0.01 sys=0.03, real=0.00 secs][GC (Allocation Failure) [PSYoungGen: 32912K->4469K(70656K)] 40307K->26638K(156672K), 0.0121112 secs] [Times: user=0.00 sys=0.00, real=0.01 secs][GC (Allocation Failure) [PSYoungGen: 66160K->776K(70656K)] 88329K->59879K(156672K), 0.0141096 secs] [Times: user=0.03 sys=0.02, real=0.01 secs][Full GC (Ergonomics) [PSYoungGen: 776K->0K(70656K)] [ParOldGen: 59103K->37630K(116224K)] 59879K->37630K(186880K), [Metaspace: 3408K->3408K(1056768K)], 0.0143902 secs] [Times: user=0.03 sys=0.00, real=0.01 secs][Full GC (Ergonomics) [PSYoungGen: 60370K->0K(70656K)] [ParOldGen: 96726K->74565K(172032K)] 157096K->74565K(242688K), [Metaspace: 3409K->3409K(1056768K)], 0.0598124 secs] [Times: user=0.08 sys=0.00, real=0.06 secs][GC (Allocation Failure) [PSYoungGen: 60382K->32K(95744K)] 1257771K->1226968K(1463808K), 0.0227293 secs] [Times: user=0.06 sys=0.01, real=0.02 secs][GC (Allocation Failure) [PSYoungGen: 32K->32K(131584K)] 1226968K->1226968K(1499648K), 0.0037586 secs] [Times: user=0.00 sys=0.00, real=0.00 secs][Full GC (Allocation Failure) [PSYoungGen: 32K->0K(131584K)] [ParOldGen: 1226936K->355271K(483840K)] 1226968K->355271K(615424K), [Metaspace: 3409K->3409K(1056768K)], 0.1616835 secs] [Times: user=0.19 sys=0.09, real=0.16 secs][GC (Allocation Failure) [PSYoungGen: 2499K->32K(158208K)] 1303306K->1300838K(1526272K), 0.0037952 secs] [Times: user=0.06 sys=0.00, real=0.00 secs][GC (Allocation Failure) [PSYoungGen: 32K->32K(158208K)] 1300838K->1300838K(1526272K), 0.0036491 secs] [Times: user=0.00 sys=0.00, real=0.00 secs][Full GC (Allocation Failure) [PSYoungGen: 32K->0K(158208K)] [ParOldGen: 1300806K->473463K(622080K)] 1300838K->473463K(780288K), [Metaspace: 3409K->3409K(1056768K)], 0.1641897 secs] [Times: user=0.30 sys=0.06, real=0.16 secs][GC (Allocation Failure) [PSYoungGen: 0K->0K(250880K)] 946230K->946230K(1618944K), 0.0027229 secs] [Times: user=0.00 sys=0.00, real=0.00 secs][GC (Allocation Failure) [PSYoungGen: 0K->0K(258560K)] 946230K->946230K(1626624K), 0.0027747 secs] [Times: user=0.00 sys=0.00, real=0.00 secs][Full GC (Allocation Failure) [PSYoungGen: 0K->0K(258560K)] [ParOldGen: 946230K->709846K(879104K)] 946230K->709846K(1137664K), [Metaspace: 3409K->3409K(1056768K)], 0.1013768 secs] [Times: user=0.28 sys=0.02, real=0.10 secs][GC (Allocation Failure) [PSYoungGen: 0K->0K(353280K)] 709846K->709846K(1721344K), 0.0049384 secs] [Times: user=0.00 sys=0.00, real=0.01 secs][Full GC (Allocation Failure) Exception in thread "main" java.lang.OutOfMemoryError: Java heap space[PSYoungGen: 0K->0K(353280K)] [ParOldGen: 709846K->709816K(900608K)] 709846K->709816K(1253888K), [Metaspace: 3409K->3409K(1056768K)], 0.1792920 secs] [Times: user=0.39 sys=0.00, real=0.18 secs]Heapat java.util.Arrays.copyOf(Arrays.java:3332) PSYoungGen total 353280K, used 14028K [0x00000000d6400000, 0x00000000ec700000, 0x0000000100000000)at java.lang.AbstractStringBuilder.ensureCapacityInternal(AbstractStringBuilder.java:124) eden space 352768K, 3% used [0x00000000d6400000,0x00000000d71b3070,0x00000000ebc80000)at java.lang.AbstractStringBuilder.append(AbstractStringBuilder.java:674) from space 512K, 0% used [0x00000000ec680000,0x00000000ec680000,0x00000000ec700000)at java.lang.StringBuilder.append(StringBuilder.java:208) to space 4608K, 0% used [0x00000000ebe00000,0x00000000ebe00000,0x00000000ec280000)at JvmTest.main(JvmTest.java:15) ParOldGen total 1368064K, used 709816K [0x0000000082c00000, 0x00000000d6400000, 0x00000000d6400000)at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) object space 1368064K, 51% used [0x0000000082c00000,0x00000000ae12e1e8,0x00000000d6400000) Metaspace used 3440K, capacity 4494K, committed 4864K, reserved 1056768Kat sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62) class space used 377K, capacity 386K, committed 512K, reserved 1048576Kat sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)at java.lang.reflect.Method.invoke(Method.java:498)at com.intellij.rt.execution.application.AppMain.main(AppMain.java:140)Process finished with exit code 1 欢迎工作一到五年的Java程序员朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

聊聊Dubbo - Dubbo可扩展机制源码解析

在Dubbo可扩展机制实战中,我们了解了Dubbo扩展机制的一些概念,初探了Dubbo中LoadBalance的实现,并自己实现了一个LoadBalance。是不是觉得Dubbo的扩展机制很不错呀,接下来,我们就深入Dubbo的源码,一睹庐山真面目。 ExtensionLoader ExtentionLoader是最核心的类,负责扩展点的加载和生命周期管理。我们就以这个类开始吧。Extension的方法比较多,比较常用的方法有: public static <T> ExtensionLoader<T> getExtensionLoader(Class<T> type) public T getExtension(String name) public T getAdaptiveExtension() 比较常

优秀的个人博客,低调大师

HashSet集合的add()方法的源码解析

一般来说,不同的字符串的哈希值是不同的。 1 package cn.itcast_02; 2 3 /* 4 * 一般来说,不同的字符串的哈希值是不同的。 5 * 哈希值仅仅是逻辑值,可能一样。 6 * 地址值是实际的物理值,不一样。 7 */ 8 9 public class HashCodeDemo { 10 public static void main(String[] args) { 11 System.out.println("hello".hashCode()); // 99162322 12 System.out.println("hello".hashCode()); // 99162322 13 System.out.println("world".hashCode()); // 113318802 14 } 15 } HashSet存储字符串并遍历 1 package cn.itcast_02; 2 3 import java.util.HashSet; 4 5 /* 6 * HashSet:存储字符串并遍历 7 * 8 * 问题:为什么存储字符串的时候,字符串内容相同的只存储了一个呢? 9 * 通过查看add方法的底层源码,我们知道这个方法的底层依赖两个方法:hashCode()和equals()。 10 * 即: 11 * int hashCode() 12 * boolean equals(Object obj) 13 * 14 * 步骤: 15 * 首先比较哈希值 16 * 如果相同,继续走,比较地址值或者走equals() 17 * 如果不同,就直接添加到集合中 18 * 19 * 按照方法的步骤来说: 20 * 先看hashCode()值是否相同 21 * 相同:继续走equals()方法 22 * 返回true:说明元素重复,就不添加 23 * 返回false:说明元素不重复,就添加到集合 24 * 不同:就直接把元素添加到集合中 25 * 26 * 如果类没有重写这两个方法,默认使用的Object的方法。一般来说不相同。 27 * 而String类重写了hashCode()和equals()方法,所以,它就可以把内容相同的字符串去掉。只留下一个元素。 28 */ 29 public class HashSetDemo { 30 public static void main(String[] args) { 31 // 创建集合对象 32 HashSet<String> hs = new HashSet<String>(); 33 34 // 创建并添加元素 35 hs.add("hello"); 36 hs.add("world"); 37 hs.add("java"); 38 hs.add("world"); 39 40 // 遍历集合 41 for (String s : hs) { 42 System.out.println(s); 43 } 44 } 45 } HashSet集合的add()方法的源码 --------------------------------------- interface Collection { ... } interface Set extends Collection { ... } --------------------------------------- class HashSet implements Set { ... private static final Object PRESENT = new Object(); private transient HashMap<E,Object> map; public HashSet() { map = new HashMap<>(); } public boolean add(E e) { // e = hello,world return map.put(e, PRESENT)==null; } ... } --------------------------------------- class HashMap implements Map { ... public V put(K key, V value) { // key = e = hello,world // 看哈希表是否为空,如果是空,就开辟空间,开辟完空间,程序就往下走 if (table == EMPTY_TABLE) { inflateTable(threshold); } // 判断对象是否为null,不是null,程序就往下走 if (key == null) return putForNullKey(value); int hash = hash(key); // 和对象的hashCode()方法相关,即和对象的哈希值相关 int i = indexFor(hash, table.length); // 在哈希表中查找hash值 for (Entry<K,V> e = table[i]; e != null; e = e.next) { // 注意:这次的e其实是第一次/第二次的hello/world Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; // 走到这里说明没有添加元素 } } modCount++; addEntry(hash, key, value, i); // 把元素添加进集合 return null; } ... transient int hashSeed = 0; ... final int hash(Object k) { // k = key = e = hello, int h = hashSeed; // transient int hashSeed = 0; if (0 != h && k instanceof String) { return sun.misc.Hashing.stringHash32((String) k); } h ^= k.hashCode(); // 这里调用的是对象的hashCode()方法 // This function ensures that hashCodes that differ only by // constant multiples at each bit position have a bounded // number of collisions (approximately 8 at default load factor). h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } ... } --------------------------------------- hs.add("hello"); hs.add("world"); hs.add("java"); hs.add("world"); --------------------------------------- 我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

java面试-数据库索引全面解析

索引是什么? 数据库中查找操作非常普遍,索引就是提升查找速度的一种手段。 索引分类 B+树索引它就是传统意义上的索引,它是最常用、最有效的索引。 哈希索引哈希索引是一种自适应的索引,数据库会根据表的使用情况自动生成哈希索引,我们人为是没办法干预的。 全文索引用于实现关键词搜索。但它只能根据空格分词,因此不支持中文。若要实现搜索功能,可选择lucene。 RTree索引在mysql很少使用,仅支持geometry数据类型;相对于BTREE,RTREE的优势在于范围查找。 B+树索引 数据库以页为存储单元,一个页是8K(8192Byte),一页可以存放N条记录。页在B+树中分为:数据页和索引页。B+树的高一般为2-4层,因此查找某一键值的行记录只需2-4次IO,效率较高。 聚集索引 和 非聚集索引 不管是聚集索引还是非聚集索引,它们的逻辑结构都一棵是B+树,它们的唯一区别在于: 聚集索引的数据页存放的是完整的记录;也就是说,聚集索引决定了表的物理存储顺序; 非聚集索引的数据页只存指向记录的地址信息,它真正的数据已经在聚集索引中存储了。 联合索引 和 覆盖索引 联合索引当查询条件涉及多列时,可以使用联合索引。 覆盖索引只需通过辅助索引就能获取要查询的信息,而无需再次通过聚集索引查询具体的记录信息。由于覆盖索引并不包含整行的记录,因此它的大小远远小于聚集索引。它比较适合做一些统计操作。 MyISAM索引实现 主键索引在主键索引中,索引页中存放的是主键和指向数据页的偏移量;数据页中存放的是主键和该主键所属行记录的地址空间。 辅助索引在MyISAM中,主索引和辅助索引(Secondary key)在结构上没有任何区别,只是主索引要求key是唯一的,而辅助索引的key可以重复。 综上所述,在MyISAM中,索引文件和数据文件分开存放,不管是主键索引还是辅助索引,都属于非聚集索引。 InnoDB索引实现 主键索引索引页仍然存放主键和和指向数据页的偏移量,但数据页存放的是完整的记录。也就是在InnoDB中,数据和主键索引是存放在一起的。 辅助索引索引节点存放的内容一样,仍然是键值信息和指向数据页的偏移量;但数据页中存放的是键值信息和该键值对应的主键。然后通过主键查询主键索引就能找到该条记录。 综上所述: 聚集索引这种实现方式使得按主键的搜索十分高效,但是辅助索引搜索需要检索两遍索引:首先检索辅助索引获得主键,然后用主键到主索引中检索获得记录。 InnoDB的辅助索引也会包含主键列,所以,如果主键定义的比较大,其他索引也将很大。如果想在表上定义 、很多索引,则争取尽量把主键定义得小一些。InnoDB 不会压缩索引。 索引的优点 第一,通过创建唯一性索引,可以保证数据库表中每一行数据的唯一性。 第二,可以大大加快数据的检索速度,这也是创建索引的最主要的原因。 第三,可以加速表和表之间的连接,特别是在实现数据的参考完整性方面特别有意义。 第四,在使用分组和排序子句进行数据检索时,同样可以显著减少查询中分组和排序的时间。 第五,通过使用索引,可以在查询的过程中,使用优化隐藏器,提高系统的性能。 索引的缺点 第一,创建索引和维护索引要耗费时间,这种时间随着数据量的增加而增加。 第二,索引需要占物理空间,除了数据表占数据空间之外,每一个索引还要占一定的物理空间,如果要建立聚簇索引,那么需要的空间就会更大。 第三,当对表中的数据进行增加、删除和修改的时候,索引也要动态的维护,这样就降低了数据的维护速度。 哪些情况需要加索引? 在经常需要搜索的列上,可以加快搜索的速度; 在作为主键的列上,强制该列的唯一性和组织表中数据的排列结构; 在经常用在连接的列上,这些列主要是一些外键,可以加快连接的速度; 在经常需要根据范围进行搜索的列上创建索引,因为索引已经排序,其指定的范围是连续的; 在经常需要排序的列上创建索引,因为索引已经排序,这样查询可以利用索引的排序,加快排序查询时间; 在经常使用在WHERE子句中的列上面创建索引,加快条件的判断速度。 哪些情况不需要加索引? 第一,对于那些在查询中很少使用或者参考的列不应该创建索引。这是因为,既然这些列很少使用到,因此有索引或者无索引,并不能提高查询速度。相反,由于增加了索引,反而降低了系统的维护速度和增大了空间需求。 第二,对于那些只有很少数据值的列也不应该增加索引。这是因为,由于这些列的取值很少,例如人事表的性别列,在查询的结果中,结果集的数据行占了表中数据行的很大比例,即需要在表中搜索的数据行的比例很大。增加索引,并不能明显加快检索速度。 第三,对于那些定义为text, image和bit数据类型的列不应该增加索引。这是因为,这些列的数据量要么相当大,要么取值很少。第四,当修改性能远远大于检索性能时,不应该创建索引。这是因为,修改性能和检索性能是互相矛盾的。当增加索引时,会提高检索性能,但是会降低修改性能。当减少索引时,会提高修改性能,降低检索性能。因此,当修改性能远远大于检索性能时,不应该创建索引。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册