首页 文章 精选 留言 我的

精选列表

搜索[指标分析],共10000篇文章
优秀的个人博客,低调大师

WAL的概念与实践分析

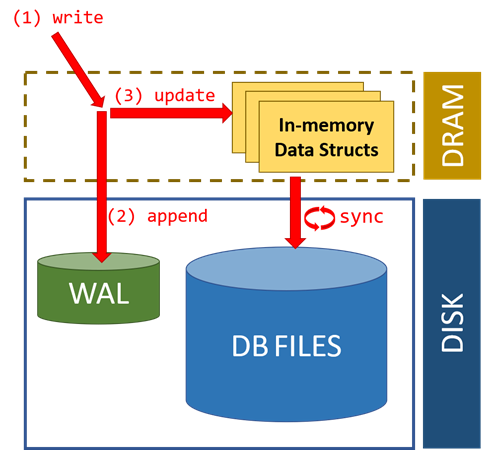
Part 1 - 预写式日志 在计算机科学中,预写式日志[1](Write-Ahead logging,缩写WAL)是关系数据库系统中用于提供原子性和持久性(事务ACID属性中的A与D)的一系列技术。在使用WAL的系统中,所有的修改在生效之前都要先写入log文件中。log文件中通常包括redo和undo信息。假设一个程序在执行某些操作的过程中机器掉电了。在重新启动时,程序可能需要知道当时执行的操作是成功了还是部分成功或者是失败了。如果使用了WAL,程序就可以检查log文件,并对突然掉电时计划执行的操作内容跟实际上执行的操作内容进行比较。在这个比较的基础上,程序就可以决定是撤销已做的操作还是继续完成已做的操作,或者是保持原样。 WAL允许用in-place方式更新数据库。另一种用来实现原子更新的方法是shadowpaging。用in-place方式做更新的主要优点是减少索引和块列表的修改。ARIES[2]是WAL系列技术常用的算法,其核心策略为:1)Write ahead logging,对于对象的任何变更都要首先记入日志,同时日志必须要先于对象被写入磁盘;2)Repeating history during Redo,在crash之后重启时,ARIES通过重新执行数据库在crash之前的行为,使数据库恢复到它crash之前那一刻的状态,然后undo掉crash时还在执行的事务;3)Logging changes during Undo,将在undo事务时对数据库所做的变更记录日志,保证在重复重启时不会重做。在文件系统中,WAL通常称为journaling[3]。 RocksDB[4]中的每个更新操作都会写到两个地方:1)写到磁盘上的WAL日志;2)一个名为memtable的内存数据结构,后续会被刷盘到SST文件。WAL会把memtable的操作序列化之后以日志文件形式存储在持久化介质中。在数据库出现崩溃的时候,WAL文件可以用于重新构建memtable,帮助数据库恢复数据库到一个一致的状态。当一个memtable被安全地落盘到持久化介质之后,相关的WAL日志会变成过期的,然后被归档,最终归档的日志会在一定时间后被从硬盘上删除。 1.1WAL管理器 WAL文件使用一个递增的序列号生成到WAL文件夹。为了重新构建数据库的状态,这些文件会被按序列号顺序读取。WAL管理器提供把WAL文件作为一个可独立进行读取的抽象接口。内部使用Writer或者Reader抽象接口打开,并读取文件。 Writer提供一个抽象接口,用于在日志文件末尾增加数据。存储介质相关的内部细节信息通过WriteableFile接口处理。类似的,Reader提供一个抽象接口,用于从一个日志文件中顺序读取日志记录。内部的存储介质相关细节信息有SequentialFile接口处理。 1.2WAL文件格式 WAL文件由一系列的变长记录构成。记录通过kBlockSize(默认为32KB)聚集在一起。如果某个特定记录不能放入剩余的空间,那么剩余空间将会被空数据填充。writer写而reader读数据的时候,是按照一个kBlockSize大小的块来读的。 记录的排列格式如下所示: WAL文件包含一系列的大小为32KB的块,唯一的例外是文件的末尾可能会包含一个分片的块。每个块都由一系列记录构成,一个记录不会在一个块的最后6个Byte开始(毕竟放不下)。任何剩下的数据都构成tailer,tailer由全0构成,读取的时候应该被跳过。如果当前块正好剩下7个Byte,并且一个新的非0长度记录被加入进来,那么write必须加一个FIRST记录(里面不含任何用户数据)来填充剩下的7个byte,然后在下一个块再提交用户数据。 FULL类型的记录保存完整的用户数据。FIRST,MIDDLE,LAST在不得不把用户数据切分成多个分片的时候使用(大多数是因为块边界问题)。FIRST是用户数据的第一个分片用的类型,LAST是最后一个用户数据分片用的记录类型,MIDDLE则是中间那些所有的其他数据的记录类型。 例子:考虑一个用户记录的序列: A会在第一个block里被存储为一个FULL记录。B会被分成三个分片:第一个分片占据第一个块剩下的空间,第二个分片占据第二个块的完整空间,第三个分片占据第三个块的开头部分。第三个块还剩下6个Byte,作为一个tailer,留空。C会在第四个块以FULL记录存储。 1.3 WAL的生命周期 用一个例子来说明一个WAL的生命周期。一个RocksDB的db实例创建了两个列族:"new_cf"和"default"。一旦db被打开,一个新的WAL会在磁盘上被创建,以保证写持久性。 往列族中加入一些数据: 这时WAL需要记录所有的写操作。WAL会保持打开,并不断跟踪后续的写操作,直到大小到达DBOptions::max_total_wal_size设定阈值。 如果用户决定把列族"new_cf"的数据落盘,以下的事情会发生: new_cf的数据(key1和key3)会被落盘到一个新的SST文件; 一个新的WAL会被创建,现在后续的写操作都会写到新的WAL了; 旧的WAL不再接受新的写入,但是删除操作会被延后。 这时,会有两个WAL文件,旧的保存有从key1到key4的内容,新的保存key5和key6。因为旧的还有线上数据,就是"defalut"列族的,还不能被删除。只有当用户最后决定把"default"列族的数据落盘,旧的WAL才能被归档,然后自动从磁盘上删除。 总的来说一个WAL文件会在以下时机被创建: DB打开的时候; 一个列族落盘数据的时候。 一个WAL会在他持有的所有列族的数据的最大请求序列号落盘后被删除(或者归档,如果允许归档),换句话说所有的WAL里的数据都被固定到SST文件。归档WAL会被移到一个独立的位置,然后再从存储设备上清除。实际的删除动作可能会因为拷贝的原因被延后。 1.4 WAL配置 这些配置可以在options.h中找到。 DBOptions::wal_dir:用于设置RocksDB存储WAL文件的目录,这允许用户把WAL和实际数据分开存储(云溪数据库默认两者保存在同一个目录); DBOptions::WAL_ttl_seconds,DBOptions::WAL_size_limit_MB:这两个选项影响WAL文件删除的时间。非0参数表示时间和硬盘空间的阈值,超过这个阀值,会触发删除归档的WAL文件(云溪数据库中默认0); DBOptions::max_total_wal_size:如果希望限制WAL的大小,RocksDB使用其作为列族落盘的触发器。一旦WAL超过这个大小,RocksDB会开始强制列族落盘,以保证删除最老的WAL文件。这个配置在列族以不固定频率更新的时候非常有用。如果没有大小限制,如果这个WAL中有一些非常低频更新的列族的数据没有落盘,用户可能会需要保存非常老的WAL文件(云溪数据库中默认0)。 DBOptions::avoid_flush_during_recovery:选项名已经说明了他的用途(恢复过程中避免落盘)(云溪数据库中默认false); DBOptions::manual_wal_flush:决定WAL是每次写操作之后自动flush还是纯人工flush(用户必须调用FlushWAL来触发一个WALflush)(云溪数据库中默认false); DBOptions::wal_filter:通过改参数用户可以提供一个在恢复过程中处理WAL文件时被调用的filter对象(云溪数据库中默认Disabled); WriteOptions::disableWAL:如果用户依赖于其他写日志方式,或者不担心数据丢失,该参数就非常有用了(云溪数据库中默认false)。 1.5 WAL过滤器12 事务日志迭代器提供一种方法,用来在RocksDB实例间复制数据。一旦一个WAL因为列族被落盘而被归档,WAL不会马上被删掉。这是为了允许事务日志迭代器可以继续读取WAL文件,再发送给从节点。事务日志迭代器提供一种方法,用来在RocksDB实例间复制数据。一旦一个WAL因为列族被落盘而被归档,WAL不会马上被删掉。这是为了允许事务日志迭代器可以继续读取WAL文件,再发送给从节点。 Part 2 - WAL的实现 2.1etcd[5] etcd整体架构如下图所示: etcd的写请求流程大致可以总结为如下过程:1)首先 client 端通过负载均衡算法选择一个 etcd 节点,发起 gRPC 调用;2)然后 etcd 节点收到请求后经过gRPC 拦截器、Quota模块后,进入 KVServer 模块;3)KVServer 模块向 Raft 模块提交一个提案;4)随后此提案通过 RaftHTTP 网络模块转发集群中各个节点;5)经过集群多数节点持久化后,状态会变成已提交;6)etcdserver 从 Raft 模块获取已提交的日志条目,7)传递给 Apply 模块;8)Apply 模块通过MVCC 模块执行提案内容;9)更新状态机。 在流程5中,Raft 模块收到提案后,如果当前节点是Follower,它会转发给Leader,只有Leader 才能处理写请求。Leader收到提案后,通过Raft 模块输出待转发给Follower 节点的消息和待持久化的日志条目,日志条目则封装了提案内容。etcdserver从 Raft 模块获取到以上消息和日志条目后,作为 Leader,它会将 put 提案消息广播给集群各个节点,同时需要把集群 Leader 任期号、投票信息、已提交索引、提案内容持久化到一个 WAL(Write Ahead Log)日志文件中,用于保证集群的一致性、可恢复性。 上图是 WAL 结构,它由多种类型的 WAL 记录顺序追加写入组成,每个记录由类型、数据、循环冗余校验码组成。不同类型的记录通过Type 字段区分,Data为对应记录内容,CRC为循环校验码信息。WAL记录类型目前支持5 种,分别是文件元数据记录、日志条目记录、状态信息记录、CRC 记录、快照记录。文件元数据记录包含节点 ID、集群 ID 信息,它在 WAL 文件创建的时候写入;日志条目记录包含 Raft 日志信息,如 put 提案内容;状态信息记录,包含集群的任期号、节点投票信息等,一个日志文件中会有多条,以最后的记录为准;CRC记录包含上一个 WAL 文件的最后的 CRC(循环冗余校验码)信息,在创建、切割 WAL 文件时,作为第一条记录写入到新的WAL 文件,用于校验数据文件的完整性、准确性等;快照记录包含快照的任期号、日志索引信息,用于检查快照文件的准确性。 WAL模块又是如何持久化一个put 提案的日志条目类型记录呢?首先看看put 写请求如何封装在Raft 日志条目里面。下面是Raft 日志条目的数据结构信息,它由以下字段组成:Term是 Leader 任期号,随着 Leader 选举增加;Index 是日志条目的索引,单调递增增加;Type 是日志类型,比如是普通的命令日志(EntryNormal)还是集群配置变更日志(EntryConfChange);Data 保存述的 put 提案内容。 了解完 Raft 日志条目数据结构后,再看 WAL 模块如何持久化 Raft 日志条目。它首先将 Raft 日志条目内容(含任期号、索引、提案内容)序列化后保存到 WAL 记录的 Data 字段,然后计算 Data 的CRC 值,设置Type 为Entry Type,以上信息就组成了一个完整的 WAL 记录。最后计算 WAL 记录的长度,顺序先写入 WAL 长度(Len Field),然后写入记录内容,调用 fsync 持久化到磁盘,完成将日志条目保存到持久化存储中。当一半以上节点持久化此日志条目后,Raft 模块就会通过channel 告知etcdserver 模块,put提案已经被集群多数节点确认,提案状态为已提交,可以执行此提案内容了。于是进入流程6,etcdserver 模块从 channel 取出提案内容,添加到先进先出(FIFO)调度队列,随后通过 Apply 模块按入队顺序,异步、依次执行提案内容。 [1] https://zh.wikipedia.org/wiki/%E9%A2%84%E5%86%99%E5%BC%8F%E6%97%A5%E5%BF%97 [2] https://en.wikipedia.org/wiki/Algorithms_for_Recovery_and_Isolation_Exploiting_Semantics [3] https://en.wikipedia.org/wiki/Journaling_file_system [4]https://rocksdb.org.cn/doc/Write-Ahead-Log-File-Format.html [5]https://github.com/etcd-io/etcd/blob/release-3.4/wal/doc.go

优秀的个人博客,低调大师

Shiro源码分析---FilterChain创建过程

在Shiro中,无论是认证还是权限控制都是通过过滤器来实现的,在应用中可能会配置很多个过滤器,但对于不同的访问请求所需要经过的过滤器肯定是不一样的,那么当发起一个请求时,到底会应用上哪些过滤器,对于我们使用Shiro就显示得格外重要;下面就来讲讲一个请求到底会经过哪些过滤器。 在Shiro中,确证一个请求会经过哪些过滤器是通过org.apache.shiro.web.filter.mgt.FilterChainResolver接口来定义的,下面是接口定义: public interface FilterChainResolver { FilterChain getChain(ServletRequest request, ServletResponse response, FilterChain originalChain); } 接口中只有一个方法getChain,就是用于确定请求到底要经过哪些过滤器,然后将这些过滤器封装成一个FilterChain对象,FilterCahin我们很熟悉,在使用Servlet的时候经常见面。FilterChainResolver只是一个接口,Shiro提供了一个默认的实现类org.apache.shiro.web.filter.mgt.PathMatchingFilterChainResolver,该实现类会根据请求路径进行匹配过滤器。在看PathMatchingFilterChainResolver源码之前先说一下FilterChainManager中的FilterChain是怎么来的,以ini配置为例: [urls] /static/**=anon /formfilterlogin=authc /role=authc,roles[admin] 其中/static/**、/formfilterlogin,/role 就是受FilterChainManager管理的FilterChain的名称。下面看看FilterChainManager是如何管理FilterChain的。Shiro提供了FilterChainManager一个的默认实现:org.apache.shiro.web.filter.mgt.DefaultFilterChainManager,其createChain方法会在系统启动的时候被org.apache.shiro.web.config.IniFilterChainResolverFactory调用,用于创建各个FilterChain。下面以/role=authc,roles[admin]配置为例,chainName就是/role,chainDefinition就是authc,roles[admin] public void createChain(String chainName, String chainDefinition) { if (!StringUtils.hasText(chainName)) { throw new NullPointerException("chainName cannot be null or empty."); } if (!StringUtils.hasText(chainDefinition)) { throw new NullPointerException("chainDefinition cannot be null or empty."); } if (log.isDebugEnabled()) { log.debug("Creating chain [" + chainName + "] from String definition [" + chainDefinition + "]"); } // filterTokens数组有两个元素,第一个为authc,第二个为roles[admin],因为配置时可以配置多个Filter, // 多个Filter间以逗号分隔 String[] filterTokens = splitChainDefinition(chainDefinition); for (String token : filterTokens) { // 对roles[admin]进行分隔,数组中第一个元素为roles,第二个为admin String[] nameConfigPair = toNameConfigPair(token); // 添加FilterChain addToChain(chainName, nameConfigPair[0], nameConfigPair[1]); } } public void addToChain(String chainName, String filterName, String chainSpecificFilterConfig) { if (!StringUtils.hasText(chainName)) { throw new IllegalArgumentException("chainName cannot be null or empty."); } // 根据filterName(role)查找出Filter Filter filter = getFilter(filterName); if (filter == null) { throw new IllegalArgumentException("There is no filter with name '" + filterName + "' to apply to chain [" + chainName + "] in the pool of available Filters. Ensure a " + "filter with that name/path has first been registered with the addFilter method(s)."); } // 应用FilterChain配置,以roles[amdin]为例,调用该方法后roles过滤器就知道其进行拦截器需要admin角色 applyChainConfig(chainName, filter, chainSpecificFilterConfig); // 如果chainName以前没处理过则创建一个新的NamedFilterList对象,如果处理过则返回以前的NamedFilterList对象 // 所以在FilterChainManager中,存储Filter的是NamedFilterList对象 NamedFilterList chain = ensureChain(chainName); // 将过滤器添加至链中 chain.add(filter); } 在了解了FilterChainManager是如何创建与存储FilterChain以后,再来看看FilterChainResolver是如何确定一个请求需要经过哪些过滤器的。 public FilterChain getChain(ServletRequest request, ServletResponse response, FilterChain originalChain) { FilterChainManager filterChainManager = getFilterChainManager(); // 判断FilterChainManager中是否有FilterChain,如果没有则返回null if (!filterChainManager.hasChains()) { return null; } // 获取请求URI String requestURI = getPathWithinApplication(request); // FilterChain的名称就是路径匹配符,如果请求URI匹配上了某个FilterChain // 则调用FilterChainManager.proxy方法返回一个FilterChain对象,注意是返回第一个匹配FilterChain // 也就是说如果在ini配置文件中配置了多个同名的FilterChain,则只有第一个FilterChain有效 for (String pathPattern : filterChainManager.getChainNames()) { if (pathMatches(pathPattern, requestURI)) { if (log.isTraceEnabled()) { log.trace("Matched path pattern [" + pathPattern + "] for requestURI [" + requestURI + "]. " + "Utilizing corresponding filter chain..."); } return filterChainManager.proxy(originalChain, pathPattern); } } return null; } 下面是DefualtFilterChainManager.proxy方法源码: public FilterChain proxy(FilterChain original, String chainName) { // 路径模式匹配(如/static/**)就是FilterChain名称 // 根据FilterChain名称查找NamedFilterList对象(存储了配置的Filter) NamedFilterList configured = getChain(chainName); if (configured == null) { String msg = "There is no configured chain under the name/key [" + chainName + "]."; throw new IllegalArgumentException(msg); } // 调用NamedFilterList.proxy方法 return configured.proxy(original); } NamedFilterList的实现类为org.apache.shiro.web.filter.mgt.SimpleNamedFilterList public FilterChain proxy(FilterChain orig) { // 返回ProxiedFilterChain对象,该对象就是当一个请求到来后需要被执行的FilterChain对象 // 该对象只是一个代理对象,代理了两个FilterChain,一个是NamedFilterList,另一个是原始的FilterChain对象 // 原始的FilterChain对象包含了在web.xml中配置并应用上的Filter return new ProxiedFilterChain(orig, this); } public class ProxiedFilterChain implements FilterChain { private static final Logger log = LoggerFactory.getLogger(ProxiedFilterChain.class); private FilterChain orig; private List<Filter> filters; private int index = 0; public ProxiedFilterChain(FilterChain orig, List<Filter> filters) { if (orig == null) { throw new NullPointerException("original FilterChain cannot be null."); } this.orig = orig; this.filters = filters; this.index = 0; } public void doFilter(ServletRequest request, ServletResponse response) throws IOException, ServletException { // 可以看出,先执行原始Filter,再执行NamedFilterList中的Filter if (this.filters == null || this.filters.size() == this.index) { //we've reached the end of the wrapped chain, so invoke the original one: if (log.isTraceEnabled()) { log.trace("Invoking original filter chain."); } this.orig.doFilter(request, response); } else { if (log.isTraceEnabled()) { log.trace("Invoking wrapped filter at index [" + this.index + "]"); } this.filters.get(this.index++).doFilter(request, response, this); } } } 至此,Shiro创建FilterChain过程讲解完毕,如有错误之处,尽请指正。 -------------------------------- END ------------------------------- 及时获取更多精彩文章,请关注公众号《Java精讲》。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册