首页 文章 精选 留言 我的

精选列表

搜索[思考模型],共10000篇文章
优秀的个人博客,低调大师

Spark(六) -- Spark计算模型

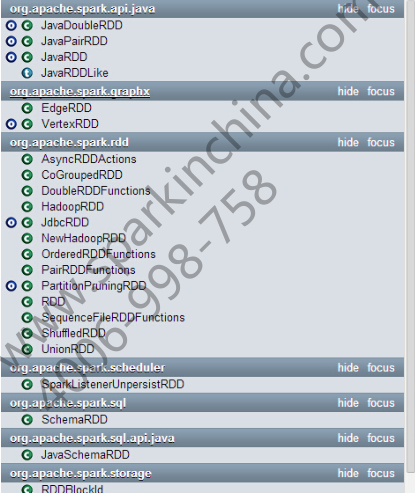
版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq1010885678/article/details/45788083 整个Spark框架都是基于RDD算子来进行计算的。 What is RDD? Resilient Distributed Dataset(RDD),分布式弹性数据集,是Spark上的一个核心抽象 表示用于并行计算的,不可修改的,对数据集合进行分片的数据结构 简单地,可以将RDD看成是Spark平台上的通用货币 在Spark上,针对各种各样的计算场景存在着各种各种的RDD,这些RDD拥有一些共同的操作,例如map,filter,persist等,就好像RDDs都是一个总RDD的子类一样,拥有所有RDD的共同特性 同时RDDs也拥有能表达自己特性的操作,例如PairRDDR有groupByKey,join等操作,而DoubleRDD有Doubles操作 所有的RDD都有以下特性: 可以表示数据分片的列表集合。将原始数据经过某些分片处理生成RDDs,这些RDD将用于并行计算 通用的算子来计算每个数据分片 包括transformation和action两大算子类别。 RDD之间拥有依赖关系 transformation只对数据进行处理而不计算,处理过程会被画成一个DAG有向无循环图,只有当action操作要获取结果时,才根据DAG图来进行并行计算。 DAG图会根据RDD之间的依赖关系被分解成一个个stage之后提交 形成DAG图的过程中也会根据RDD之间的依赖关系形成Lineage 这是Spark上一个重要的容错机制 当某个节点计算错误时,只需要根据Lineage重新计算相关的操作而不必回滚整个程序 以下两张图是来源自网络的 Spark中部分RDD类的截图 transformation和action操作的Function截图 除了transformation和action两大类算子之外,RDD还有一个比较特殊的算子 如persist和checkpoint,它们既不属于transformation也不属于action 但是都会触发Job的运行 persist将RDD结果持久化,修改了RDD中meta info的存储级别 checkpoint在持久化RDD的同时还切断了RDD之间的依赖血缘关系。除了修改了存储级别,还修改了meta info中RDD的lineage依赖关系 两者返回的均是修改后的RDD而不是产生的RDD(transformation是产生新的RDD,action是对RDD取结果) RDD之间的依赖关系可以分为Narrow,Wide:窄依赖和宽依赖两种 窄依赖:子RDD中的每个数据块只依赖于父RDD中对应的有限个固定的数据块,可以理解成父子RDD是一对一或者多对一的关系,例如:map变换,前后的数据都是一行对一行的。一个子RDD可以根据其父RDD直接计算得出,因而子RDD出现计算错误的时候,只需要重新计算对应的父RDD即可 宽依赖:子RDD中的一个数据块可以依赖于父RDD中的所有数据块。即一对多的情况,例如:groupByKey变换,子RDD中的数据块会依赖于多个父RDD中的数据块,因为一个key可能存在于父RDD的任何一个数据块中 。宽依赖中的子RDD要等到所有的父RDD计算完成之后才能进行计算,当数据丢失时需要对所有祖先RDD进行重新计算 依赖关系图: 其中,宽依赖是会触发shuffle行为的 而shuffle操作可以减小集群之间网络传输的压力,对数据进行一定的提前处理工作,对于提高整个集群的处理性能是十分重要的 在Spark中shuffle操作会是将DAG图划分成一个个stage的起点 如图所示: map和union是属于transformation操作的。这里会涉及到一个pipeline的概念,对数据切片之后并行协同计算,从图中我们可以看到,map和union的时候Task之间的处理是并行的,而协同体现在当某个Task计算缓慢的时候,集群会启动一个新的节点来计算该Task,哪个节点先处理完毕就采用哪个节点的结果 groupBy和join操作是产生RDD之间的宽依赖的,这是一个shuffle过程,也是触发划分stages的起点,如上图中的三个stage 从物理的角度看RDD其实是一个元数据结构,存储着Block和Node之间的映射关系 关于Spark的transformation,action和划分stage等过程都是怎么处理的,整个作业的处理流程是什么,请看: Spark(四) – Spark内核作业调度机制

优秀的个人博客,低调大师

我不想让搜索引擎替我思考:AI 摘要浪潮下的信息消费反思

当我打开一个搜索引擎,输进一个问题,然后直接看到一个由AI整理好的段落式答案——这个体验正在变得越来越普遍。Google的AI Overview、Perplexity的答案卡片、SearchGPT的摘要视图……AI搜索正在重塑我们获取信息的方式。但这种"喂到嘴边"的信息消费模式,是真正的进步吗? SearchZee博客近日发表了一篇观点鲜明的文章,作者的立场相当明确:AI搜索摘要正在让互联网变得更糟。 AI摘要的三个隐蔽代价 文章指出了AI搜索摘要的三个核心问题。第一是信息收窄。当搜索引擎把多个来源的不同观点压缩成一段自信满满的总结时,读者实际上失去了接触多元视角的机会。那些原本需要用户自己消化、比较、判断的过程,被一个"权威"答案替代了。而这个答案的倾向性,往往取决于搜索引擎算法,而不是真实的信息生态。 第二是验证行为的消失。传统的搜索模式会引导用户点击多个链接、对比不同说法、甚至主动阅读原始资料。而AI摘要让用户停留在一个页面,不再需要自己动手求证。长期来看,这种习惯会削弱人们的信息甄别能力——当你习惯了一个答案,为什么还要多看一眼? 第三是网络经济的结构性破坏。当用户不再访问原始网页,广告收人就向平台集中而非内容创作者。这会直接导致优质内容的商业价值下降,进而压制高质量内容的生产动力。内容变少、变浅,最终损害的仍然是用户。 "简单查询"不是借口 文章也承认,AI摘要并非一无是处。单位换算、天气预报、简单的名词解释等场景下,AI摘要确实提升了效率。但问题在于,搜索引擎无法预先判断一个查询是"简单"还是"高风险"。用户搜"血压正常值"希望得到快速答案,这没问题;但同一用户搜"某种药物的副作用"时,如果AI给出了一个过度简化的答案,后果可能很严重。搜索引擎不知道哪次查询会救人,哪次只是好奇。 回归"只给结果"的搜索哲学 作者倡导的解决思路很直接:搜索引擎应该回归"只给结果,不给答案"的定位。平台提供链接,用户自己判断。这不是反技术,而是对信息传播责任边界的重新划定。AI可以辅助检索,但最终的认知结论应该由人来做。 从更宏观的视角看,这篇文章折射出一个正在困扰整个互联网的问题:效率与深度之间的永恒张力。AI在提升信息获取效率的同时,也在系统性地削减深度加工信息的动机。当"快"成为唯一的评价维度,"慢"的内容就逐渐消失了。 参考来源:https://searchzee.com/blog/search-without-ai-summaries

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册