首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

如何理解Compass和Hibernate的结合使用

我们在使用Hibernate构建的项目中可以快速的添加搜索功能。在这里我只想更详解的介绍一下,它们结合时使用的工作原理。了解了工作原理,至于程序怎么实现就可以。 首先,我们知道Hibernate是比较有名的ORM框架,它的主要作用,就是让我们的开发更接近现实生活。现在虽然有很多数据库已经是“对象型的数据库”,但在我们还是比较喜欢用一些关系型数据库。好像我们已经习惯了用这些数据库。只要有关系数据库,要想让我们的程序真正的OOP(面向对象编程)。就少不了这样一个中间组件,对象关系映射(ORM)。这个框架很方便的帮助我们实现了,把以前对关系数据库的操作,变成了我们大家都比较熟悉的面向一些简单的java类操作,也就是对一些又简单又古老的对象(pojo)的操作。 简单的了解一下Hibernate。 <1>hibernate技术本质上是一个提供数据服务的中间件。是一个面向Java环境的对象/关系数据库映射工具。把Java 类对应到数据库的table中,并且采用了xml技术。JavaReflection技术等。同时也提供了数据查询和恢复等机制。可以大幅度减少开发时人工使用SQL和JDBC处理数据的时间。 <2>是一个开发源代码的对象关系映射框架。它对JDBC进行了非常轻量级的对象封装。可以应用到任何可以使用JDBC的场合。 上面的简单的介绍了一下hiberante。而compass又是对lucene的简单的封装。好比hibernate对JDBC的封装。它们很相似的。Compass的设计原则就是按照Hibernate的使用习惯而设计的,所以对Hibernate了解的,对学习Compass也是很简单的。 Compass和Hibernate的结合使用,Hibernate就是充当了中间桥梁。Hibernate主要负责对象到数据库的映射。而Compass又可以充分利用已有的对象,间接的与数据库联系,来实现搜索。在利用Compass时,我们首先要对每个表对应的pojo为基础建立索引。同时保持数据的同步。我们可以简单的用图表示如下: 希望看来这个图示,可以让你对了解Compass和Hibernate的结合使用。 不明的地方,可以提出,我会尽力解答的。 本文转自 weijie@java 51CTO博客,原文链接:http://blog.51cto.com/weijie/74656,如需转载请自行联系原作者

优秀的个人博客,低调大师

理解Docker(8):Docker 存储之卷(Volume)

(1)Docker 安装及基本用法 (2)Docker 镜像 (3)Docker 容器的隔离性 - 使用 Linux namespace 隔离容器的运行环境 (4)Docker 容器的隔离性 - 使用 cgroups 限制容器使用的资源 (5)Docker 网络 (6)若干企业生产环境中的容器网络方案 (7)Docker 存储- AUFS (8)Docker 存储 - Volume 1. Docker volume 的几种形态 有状态容器都有数据持久化需求。前一篇文章中提到过,Docker 采用 AFUS 分层文件系统时,文件系统的改动都是发生在最上面的容器层。在容器的生命周期内,它是持续的,包括容器在被停止后。但是,当容器被删除后,该数据层也随之被删除了。因此,Docker 采用 volume (卷)的形式来向容器提供持久化存储。Docker volume 有如下几种形态。 1.1 无 - 不使用 Docker volume 默认情况下,容器不使用任何 volume,此时,容器的数据被保存在容器之内,它只在容器的生命周期内存在,会随着容器的被删除而被删除。当然,也可以使用 docker commit 命令将它持久化为一个新的镜像。 1.2 Data volume (数据卷) 一个 data volume 是容器中绕过 Union 文件系统的一个特定的目录。它被设计用来保存数据,而不管容器的生命周期。因此,当你删除一个容器时,Docker 肯定不会自动地删除一个volume。有如下几种方式来使用 data volume: (1)使用 “-v 容器内目录” 形式 docker run -d -P --name web -v /webapp training/webapp python app.py 使用 docker inspect 命令可以看出,Docker 将本地一个 _data 目录 mount 为容器内的 webapp 目录了: "Mounts": [ { "Name": "f143b7f379fb6d012a08656fc950bf6df4bf5a5b90c72f310644aa997620122b", "Source": "/var/lib/docker/volumes/f143b7f379fb6d012a08656fc950bf6df4bf5a5b90c72f310644aa997620122b/_data", "Destination": "/webapp", "Driver": "local", "Mode": "", "RW": true, "Propagation": "" } ], 其实,在 web 容器被删除后,/var/lib/docker/volumes/f143b7f379fb6d012a08656fc950bf6df4bf5a5b90c72f310644aa997620122b/_data 目录及其中的内容都还会保留下来,但是,新启动的容器无法再使用这个目录,也就是说,已有的数据不能自动地被重复使用了。 (2)使用 -v 来挂载一个主机上的目录到容器的目录 docker run -d -P --name web2 -v /src/webapp:/webapp training/webapp python app.py 主机上的目录可以是一个本地目录,也可以在一个 NFS share 内,或者在一个已经格式化好了的块设备上。 其实这种形式和第一种没有本质的区别,容器内对 /webapp 的操作都会反映到主机上的 /src/webapp 目录内。只是,重新启动容器时,可以再次使用同样的方式来将 /src/webapp 目录挂载到新的容器内,这样就可以实现数据持久化的目标。 (3)使用 -v 来挂载主机上的一个文件到容器内的一个文件 docker run --rm -it -v ~/.bash_history:/root/.bash_history ubuntu /bin/bash 1.3 使用 data container 如果要在容器之间共享数据,最好是使用 data container。这种 container 中不会跑应用,而只是挂载一个卷。比如: 创建一个 data container: docker create -v /dbdata --name dbstore training/webapp /bin/true 启动一个 app container: docker run -d -P --name web3 --volumes-from dbstore training/webapp python app.py 其实,对 web3 这个容器来说,volume 的本质没变,它只是将 dbstore 容器的 /dbdata 目录映射的主机上的目录映射到自身的 /dbdata 目录。 "Mounts": [ { "Name": "5341c03f3b94f13f4c86d88ccb0f3b63487adf30dea7ae6b2d06e947235e7330", "Source": "/var/lib/docker/volumes/5341c03f3b94f13f4c86d88ccb0f3b63487adf30dea7ae6b2d06e947235e7330/_data", "Destination": "/dbdata", "Driver": "local", "Mode": "", "RW": true, "Propagation": "" } ], 但是,其好处是,可以不管其目录的临时性而不断地重复使用它。 1.4 使用 docker volume 命令 Docker 新版本中引入了 docker volume 命令来管理 Docker volume。 (1)使用默认的 ‘local’ driver 创建一个 volume root@docker1:/home/sammy# docker volume create --name vol1 vol1 root@docker1:/home/sammy# docker volume inspect vol1 [ { "Name": "vol1", "Driver": "local", "Mountpoint": "/var/lib/docker/volumes/vol1/_data", "Labels": {}, "Scope": "local" } ] (2)使用这个 volume docker run -d -P --name web4 -v vol1:/volume training/webapp python app.p 结果还是一样的,即将 vol1 对应的主机上的目录挂载给容器内的 /volume 目录。 "Mounts": [ { "Name": "vol1", "Source": "/var/lib/docker/volumes/vol1/_data", "Destination": "/volume", "Driver": "local", "Mode": "z", "RW": true, "Propagation": "rprivate" } ], 1.5 Volume 删除和孤单 volume 清理 1.5.1 在删除容器时删除 volume 可以使用 docker rm -v 命令在删除容器时删除该容器的卷。 root@docker1:/home/sammy# docker run -d -P --name web5 -v /webapp training/webapp python app.py 69199905a74cb360935e32f4e99f7f11319f6aa36033a920aa0bae25874f5c69 root@docker1:/home/sammy# docker volume ls DRIVER VOLUME NAME local 5341c03f3b94f13f4c86d88ccb0f3b63487adf30dea7ae6b2d06e947235e7330 local 838f4dd99721a9445be22a6b42d35e04cb43ad145ecf26107a9025f428587f76 local vol1 root@docker1:/home/sammy# docker rm -vf web5 web5 root@docker1:/home/sammy# docker volume ls DRIVER VOLUME NAME local 5341c03f3b94f13f4c86d88ccb0f3b63487adf30dea7ae6b2d06e947235e7330 local vol1 1.5.2 批量删除孤单 volumes 从上面的介绍可以看出,使用 docker run -v 启动的容器被删除以后,在主机上会遗留下来孤单的卷。可以使用下面的简单方法来做清理: root@docker1:/home/sammy# docker volume ls -qf dangling=true 244a23f3ab11f17345a68e77f96bb46a8dbaf445760dd86ab0faa07dfbd84236 c864cfac232e8728b1805abc8c363d324124b38e6297544a8cbbf61d883c7e46 f143b7f379fb6d012a08656fc950bf6df4bf5a5b90c72f310644aa997620122b root@docker1:/home/sammy# docker volume rm $(docker volume ls -qf dangling=true) 244a23f3ab11f17345a68e77f96bb46a8dbaf445760dd86ab0faa07dfbd84236 c864cfac232e8728b1805abc8c363d324124b38e6297544a8cbbf61d883c7e46 f143b7f379fb6d012a08656fc950bf6df4bf5a5b90c72f310644aa997620122b root@docker1:/home/sammy# docker volume ls DRIVER VOLUME NAME local 5341c03f3b94f13f4c86d88ccb0f3b63487adf30dea7ae6b2d06e947235e7330 local vol1 github 上有很多脚本可以自动化地清理孤单卷,比如: https://github.com/chadoe/docker-cleanup-volumes/blob/master/docker-cleanup-volumes.sh https://github.com/meltwater/docker-cleanup 1.6 小结 对以上内容的两点小结: 容器内的数据是临时性的,它会随着容器生命周期的结束而消失 默认的 Docker volume (driver = ‘loclal’)不管是哪种形式,本质上都是将容器所在的主机上的一个目录 mount 到容器内的一个目录,因此,它不具备可移植性。 2. Flocker:容器的分布式存储平台 第一部分提到过,原生的 Docker volume 不具备可移植性。于是,出现了Docker 的分布式卷解决方案Flocker。先来看看 Flocker volume 和 Docker 原生 volume 的对比: 启动一个使用 Flocker 卷的容器: docker run --volume-driver flocker -v flocker-volume:/container/dir --name=container-xyz 它带来的好处包括: 容器的数据会被写入 Flocker 后端存储而不是主机上,因此,在主机出现故障时可以保证数据不丢失 在容器迁移时,Flocker 会自动地将卷从一个 host 移植到另一个 host Flocker 的结构: 本文转自SammyLiu博客园博客,原文链接:http://www.cnblogs.com/sammyliu/p/5932996.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

理解 OpenStack 高可用(HA) (6): MySQL HA

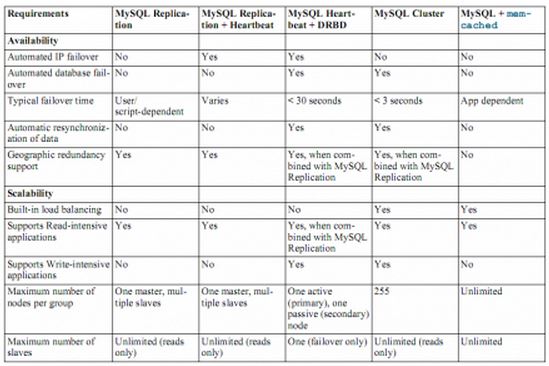
本系列会分析OpenStack 的高可用性(HA)概念和解决方案: (1)OpenStack 高可用方案概述 (2)Neutron L3 Agent HA - VRRP (虚拟路由冗余协议) (3)Neutron L3 Agent HA - DVR (分布式虚机路由器) (4)Pacemaker 和 OpenStack Resource Agent (RA) (5)RabbitMQ HA (6)MySQL HA 1. MySQL HA 方案 1.1 各种方案概述 Mysql HA 方案有很多种,包括: mmm:http://mysql-mmm.org/ mha:https://code.google.com/p/mysql-master-ha/ heartbeat+brdb:http://lin128.blog.51cto.com/407924/279411http://www.centos.bz/2012/03/achieve-drbd-high-availability-with-heartbeat/ cluster(使用ndb引擎):http://database.51cto.com/art/201008/218326.htm 双master+keeplived:http://database.51cto.com/art/201012/237204.htm,http://kb.cnblogs.com/page/83944/ 双master:http://yunnick.iteye.com/blog/1845301 Oracel Fabric 方案:http://www.csdn.net/article/2014-08-20/2821300 这些高可用方案,大多是基于以下几种基础来部署的: 基于主从复制; 基于Galera协议; 基于NDB引擎; 基于中间件/proxy; 基于共享存储; 基于主机高可用; 从 SLA 的角度看: 要达到99.9%:使用MYSQL复制技术 要达到99.99%:使用MYSQL NDB 集群和虚拟化技术 要达到99.999%:使用shared-nothing架构的GEO-REPLICATION和NDB集群技术 这里有个各种方案的比较: 在这些可选项中,最常见的就是基于主从复制的方案,其次是基于Galera的方案。这篇文章分享MYSQL中的各种高可用技术全面具体地分析了 Mysql 的各种容灾方案。也可见 Mysql 容灾的水很深。 1.2MySQL Cluster(NDB Storage Engine) MySQL Cluster 是 MySQL 官方也就是 Oracle 主推的一种提供去中心化集群(shared-nothing clustering)和 自动共享(auto-sharding)的MySQL 数据库管理系统。它被设计来提供高可用(99.999%)、高吐吞吐量、低延迟和几乎线性扩展的解决方案。它是基于 MySQL 的 NDB 或者NDBCLUSTER 存储引擎实现的。(引用自https://en.wikipedia.org/wiki/MySQL_Cluster) 官网:https://www.mysql.com/products/cluster/ 版本:MySQL Cluster 有独立于 MySQL 的版本(7.4版本使用 MySQL 5.6;7.3版本使用 MySQL 5.5) 价格:https://www.mysql.com/products/ 这是Choosing the right MySQL High Availability Solution – webinar replayMySQL Cluster 和其它几个主要HA方案的 SLA 比较: (1)特征 (2)架构 1)Sql结点(SQL node--上图对应为MySQLd):分布式数据库。包括自身数据和查询中心结点数据. 2)数据结点(Data node -- ndbd):集群共享数据(内存中). 3)管理服务器(Management Server – ndb_mgmd):集群管理SQL node,Data node. 支持最多 48 个 data nodes;集群最多 255 个节点 2. MariaDB 和 Galera Cluster MySQL 被 Oracle 收购后,基于需求以及对 Oracle 的担心,出现了两个主要的分支。它们都是免费开源的软件。 2.1 MySQL 的两个主要分支之一之 MariaDB MariaDB由MySQL的创始人麦克尔·维德纽斯主导开发,他早前曾以10亿美元的价格,将自己创建的公司MySQL AB卖给了SUN,此后,随着SUN被甲骨文收购,MySQL的所有权也落入Oracle的手中。MariaDB名称来自麦克尔·维德纽斯的女儿玛丽亚(英语:Maria)的名字。 MariaDB的目的是完全兼容MySQL,包括API和命令行,使之能轻松成为MySQL的代替品。在存储引擎方面,10.0.9版起使用XtraDB(名称代号为Aria)来代替MySQL的InnoDB。 版本方面,MariaDB直到5.5版本,均依照MySQL的版本。因此,使用MariaDB5.5的人会从MySQL 5.5中了解到MariaDB的所有功能。从2012年11月12日起发布的10.0.0版开始,不再依照MySQL的版号。10.0.x版以5.5版为基础,加上移植自MySQL 5.6版的功能和自行开发的新功能。 相对于最新的MySQL5.6,MariaDB在性能、功能、管理、NoSQL扩展方面包含了更丰富的特性。比如微秒的支持、线程池、子查询优化、组提交、进度报告等。 官网地址:https://mariadb.org/ 2.2 MySQL 的两个主要分支之二之 Percona Percona Server就是这样一款产品,由领先的MySQL咨询公司Percona发布。Percona Server是一款独立的数据库产品,为用户提供了换出其MySQL安装并换入Percona Server产品的能力。通过这样做,就可以利用XtraDB存储引擎。Percona Server声称可以完全与MySQL兼容,因此从理论上讲,您无需更改软件中的任何代码。这确实是一个很大的优势,适合在您寻找快速性能改进时控制质量。因此,采用Percona Server的一个很好的理由是,利用XtraDB引擎来尽可能地减少代码更改。 更多的比较,可以参考网上的大量文章,比如 超越MySQL:三个流行MySQL分支的对比 MySQL分支的选择:Percona还是MariaDB MariaDB or PerconaDB 你选哪种来替代 MySQL? 2.3 Galera Cluster Galera Cluster 是一套在innodb存储引擎上面实现multi-master及数据实时同步的系统架构,业务层面无需做读写分离工作,数据库读写压力都能按照既定的规则分发到各个节点上去。在数据方面完全兼容 MariaDB 和 MySQL。 官网:http://galeracluster.com/products/ 使用案例:HP, OpenStack,KPN 特征: 2.4 MySQL Galera Cluster 2.4.1 MySQL Galera Cluster 的特点和局限 Galera Cluster 可以同时支持 MySQL 和 MariaDB: 安装 MySQL Galera Cluster:需要安装带 wsrep patch 的MySQL版本(比如MySQL 5.5.29)和 Galera复制插件,详细步骤请参考MySQL多主复制-MySQL Galera安装部署 安装 MiraDB Galera Cluster:参考OpenStack 在 RedHat 平台上的 MariaDB HA 方案,以及MariaDB Galera Cluster 部署。 为了支持MySQL,Galera Cluster 中使用了由 Coreship 提供的补丁 (https://launchpad.net/codership-mysql)。MySQL Galera 集群: 使用通用的Wsrep replication 来替代 MySQL Cluster 中的 Replication 基本 Quorum的集群,最少三个节点,只能奇数个节点 使用偶数个节点时,可以使用一个 Galera Arbiter (garbd) 较高的死锁可能性:在多主集群中,不支持对表加锁和解锁(LOCK/UNLOCK TABLES cannot be supported in multi-master setups)。因此,在两个transaction 从不同的节点更新同一个 row 的时候,只有一个 transaction 会成功,对另外一个transaction,MySQL 会返回死锁错误(Error: 1213 SQLSTATE: 40001 (ER_LOCK_DEADLOCK))。 部署: (本节信息来自http://www.slideshare.net/Severalnines/galera-cluster-for-mysql-vs-mysql-ndb-cluster-a-high-level-comparison-42724783) MySQL Galera 集群有非常多的使用限制(来源): In MySQL-5.5.x/wsrep-23.x, Galera Replication has some limitations, these are documented in readme-wsrep. Galera replication originally only worked with InnoDB storage engine, but it now also supports MyISAM storage engine. Any writes to other table types, including system (mysql.*) tables are not replicated. However, DDL statements are replicated in statement level, and changes to mysql.* tables will get replicated that way. So, you can safely issue: CREATE USER..., but issuing: INSERT INTO mysql.user..., will not be replicated. MyISAM replication is recent and should be considered experimental. Non-deterministic functions like NOW() are not supported. The Configurator for Galera enables wsrep_replicate_myisam by default. DELETE operation is unsupported on tables without primary key. Also rows in tables without primary key may appear in different order on different nodes. As a result SELECT...LIMIT... may return slightly different sets. Unsupported queries: * LOCK/UNLOCK TABLES cannot be supported in multi-master setups. 不支持跨节点的表锁 * lock functions (GET_LOCK(), RELEASE_LOCK()... ) Query log cannot be directed to table. If you enable query logging, you must forward the log to a file: log_output = FILE Use general_log and general_log_file to choose query logging and the log file name. Maximum allowed transaction size is defined by wsrep_max_ws_rows and wsrep_max_ws_size. Anything bigger (e.g. huge LOAD DATA) will be rejected. Due to cluster level optimistic concurrency control, transaction issuing COMMIT may still be aborted at that stage. There can be two transactions writing to same rows and committing in separate cluster nodes, and only one of the them can successfully commit. The failing one will be aborted. For cluster level aborts, MySQL/galera cluster gives back deadlock error. code (Error: 1213 SQLSTATE: 40001 (ER_LOCK_DEADLOCK)). XA transactions can not be supported due to possible rollback on commit. MySQL 5.6 的同样描述在percona/debian-percona-xtradb-cluster-5.6 原因和概率: MySQL Galera 在本地节点上使用悲观锁(pessimistic locking) MySQL Galera 在其它节点上使用乐观锁(optimistic locking) 在大的负载压力下的发生概率大概为 1/500 在正常的负载压力下的发生概率大概为 1/10000 2.4.2 NDB (MySQL Cluster 使用的引擎)和 MySQL Galera Cluster 的性能对比 2.4.3 一些 best practice 常规的推荐做法: 减少死锁的一些推荐做法: 3. 使用Pacemaker + DRBD + CoroSync 的A/P 方案 与 RabbitMQ HA 方案类似,OpenStack 官方推荐的 Mysql Active/Passive HA 方案也是Pacemaker + DRBD + CoroSync。具体方案为: 配置 DRBD 用于 Mysql 配置 Mysql 的 var/lib/mysql 目录位于 DRBD 设备上 选择和配置一个 VIP,配置 Mysql 在该 IP 上监听 使用 Pacemaker 管理 Mysql 所有的资源,包括其 deamon 配置 OpenStack 服务使用基于 VIP 的 Mysql 连接 OpenStack 官方推荐的 Mysql HA A/P 方案配置完成后的效果: 这个文档详细阐述了具体的配置步骤。这个方案的问题是,drbd 容易出现脑裂;而且,两个 mysql 节点只有一个能提供服务,存在资源浪费。 4. 使用 MySQL Galera 的多主方案 4.1 三节点方案 架构如下: Galera 主要功能: 同步复制 真正的multi-master,即所有节点可以同时读写数据库 自动的节点成员控制,失效节点自动被清除 新节点加入数据自动复制 真正的并行复制,行级 用户可以直接连接集群,使用感受上与MySQL完全一致 优势: 因为是多主,所以不存在延迟 不存在丢失交易的情况 同时具有读和写的扩展能力 更小的客户端延迟 节点间数据是同步的,而Master/Slave模式是异步的,不同slave上的binlog可能是不同的 局限:见 4.3.1 章节的详细描述 另外,MySQL Galera Cluster 并不是适合所有需要复制的情形,你必须根据自己的需求来决定,比如, 如果你是数据一致性考虑的多,而且写操作和更新的东西多,但写入量不是很大,MySQL Galera Cluster就适合你。但是,这种方案中整个集群的写入吞吐量是由最弱的节点限制,如果有一个节点变得缓慢,那么整个集群将是缓慢的。为了稳定的高性能要求,所有的节点应使用统一的硬件,而且集群节点建议最少3个。 如果你是查询的多,且读写分离也容易实现,那就用 replication 好,简单易用,用一个 master 保证数据的一致性,可以有多个slave用来读去数据,分担负载,只要能解决好数据一致性和唯一性,replication就更适合你,毕竟 MySQLGalera Cluster集群遵循“木桶”原理,如果写的量很大,数据同步速度是由集群节点中IO最低的节点决定的,整体上,写入的速度会比replication慢许多。 详细配置过程可以参考 OpenStack HA Guide,这个文章和MySQL Multi-master Replication With Galera。 4.2 两节点 +Galera ArbitratorA/A HA 方案 3.1 中的A/A 方案需要三个节点,因此成本比较高。本方案提供使用两个节点情况下的 A/A 方案。相信信息可以参考这篇文章。 该方案使用 Arbitrator 作为第三个节点来使用,它其实是一个守护进程。它有两个作用: 当你使用偶数个节点时,它能当作一个奇数节点使用,来防止脑裂发生。 它能被用作持续的系统状态的快照,用于备份目的。 4.3 OpenStack 使用 HAProxy + MySQL Galera Cluster 的问题 这篇文章中,作者对200个OpenStack用户/运维人员做过一个关于数据库使用的调查,结果是 1 人使用PostgreSQL 10几个人使用标准的 MYSQL master/slave replication 方案 其他人都是用 MySQL Gelera 集群 4.3.1 问题原理 OpenStack 官方推荐的A/A HA 方案是使用Galera 来做三节点HA(http://docs.openstack.org/ha-guide/controller-ha-galera.html)。这种模式下,Galera 提供多个 Mysql 节点之间的同步复制,使得多个 Mysql 节点同时对外提供服务,这时候往往需要使用负载均衡软件比如 HAProxy 来提供一个 VIP 给各应用使用。但是,OpenStack 文档回避了这种MySql集群的问题。 对于 2.4.1 部分描述的 MySQL Galera 的一些局限,如果在 OpenStack 环境中使用 HAProxy 做整个MySQL Galera 的 LB 的话,因为该集群不支持跨节点对表加锁,也就是说如果OpenStack 某组件有两个会话分布在两个节点上同时写入某一条数据,那么其中一个会话将会遇到死锁的情况。网上这种情况的报告非常多,比如: https://bugzilla.redhat.com/show_bug.cgi?id=1141972Cause: Unhandled database deadlock conditions triggered with some database configuration edge cases,Consequence: Lost database transactions,Fix: Retry actions on deadlock conditions,Result: Robust database communication in all cases http://www.gossamer-threads.com/lists/openstack/operators/41337Openstack and mysql galera with haproxy 文章Avoiding Deadlocks in Galera - Set up HAProxy for single-node writes and multi-node reads对这个问题和解决方法有非常详细的描述。基本原理示意图: 有一个长长的 OpenStack邮件列表,IMPORTANT: MySQL Galera does *not* support SELECT ... FOR UPDATE(写于 2014年五月)中,作者列出了Nova 和 Neutron 中使用的 SELECT ... FOR UPDATE 代码,其中 Nova 中只有若干地方使用该结构,但是,使用的地方是 quota 代码中 Neutron 中大量使用该结构,据统计,在11个不同的文件中出现了44次。 可见,在写并发非常高的情况下,死锁的情况的出现概率是不低的,特别是在 Neutron 中。 作者还提出了几个选项: 在包含with_lockmode('update') 代码的 OpenStack 模块中不使用 MYSQL Galera 作为数据库(问题是目前没更好的选择。。) 在 OpenStack 文档中加入有关问题的注释(这么目前都还没有。。) 修改 Nova 和 Neutron 的代码,替换掉with_lockmode('update') 代码 (据说,目前,Nova 代码的修改已经完成,Neutron 还没有。。) 对于 Nova db quota 驱动,做代码优化 4.3.2 一些 workaround (1)上面的邮件回复中提到的一个 workaround,就是使得更新请求只发往一个节点。在使用 HAProxy 的情况下,具体做法是,只设定一个节点为 master,其余的为 backup。HAProxy 会在 master 失效时自动切换到某一个 backup 上。 server 192.168.0.101 192.168.0.101:3306 check server 192.168.0.102 192.168.0.102:3306 check backup server 192.168.0.103 192.168.0.103:3306 check backup 如果还需要进一步优化的话,可以只将写操作放到一个节点,而将读操作在所有节点之间做负载均衡从而提高性能。Percona XtraDB Cluster reference architecture with HaProxy描述了一个改进的方案,就是提供两个 MYSQL 服务端点,一个(端口 3306)只是使用(包括读写)一个节点,另一个(端口3306)使用三个节点。因此,对 OpenStack 来说,Neutron 使用 3306 端口(如果Nova解决了问题的话),其它组件使用 3307 端口。 global log 127.0.0.1 local0 log 127.0.0.1 local1 notice maxconn 4096 chroot /usr/share/haproxy user haproxy group haproxy daemon defaults log global mode http option tcplog option dontlognull retries 3 option redispatch maxconn 2000 contimeout 5000 clitimeout 50000 srvtimeout 50000 frontend pxc-front bind *:3307 mode tcp default_backend pxc-back frontend stats-front bind *:80 mode http default_backend stats-back frontend pxc-onenode-front bind *:3306 mode tcp default_backend pxc-onenode-back backend pxc-back #master-master,适用于没有使用 SELECT...UPDATE 语句的应用 mode tcp balance leastconn option httpchk server c1 10.116.39.76:3306 check port 9200 inter 12000 rise 3 fall 3 server c2 10.195.206.117:3306 check port 9200 inter 12000 rise 3 fall 3 server c3 10.202.23.92:3306 check port 9200 inter 12000 rise 3 fall 3 backend stats-back mode http balance roundrobin stats uri /haproxy/stats stats auth pxcstats:secret backend pxc-onenode-back #一个master,其它是backup,用来避免deadlock mode tcp balance leastconn option httpchk server c1 10.116.39.76:3306 check port 9200 inter 12000 rise 3 fall 3 server c2 10.195.206.117:3306 check port 9200 inter 12000 rise 3 fall 3 backup server c3 10.202.23.92:3306 check port 9200 inter 12000 rise 3 fall 3 backup (2)另外一个方案是,将 OpenStack 所有的MySQL 操作按照读和写做分离(read write splitting),写只在那个主节点上,读在所有节点上做负载均衡。但是,目前 OpenStack 应该还没有原生的支持。一个可选的方案是使用开源软件 maxscale:https://www.percona.com/blog/2015/06/08/maxscale-a-new-tool-to-solve-your-mysql-scalability-problems/ (3)关于 openstack 里面的读写分离,其 db 库 oslo 倒是有了接口支持: def get_session(self, use_slave=False, **kwargs): """Get a Session instance. :param use_slave: if possible, use 'slave' database connection forthis session. If the connection string for theslave database wasn't provided, a session boundto the 'master' engine will be returned.(defaults to False) :type use_slave: bool 但是从代码(Kilo版本)来看,只有 Nova 支持这种 slave_connection 参数(\nova\nova\db\sqlalchemy\api.py): def model_query(context, model, args=None, session=None, use_slave=False, read_deleted=None, project_only=False): if session is None: if CONF.database.slave_connection == '': use_slave = False session = get_session(use_slave=use_slave) 而 Neutron 模块至少在 Kilo 版本中还没有实现。下面的代码中,调用 oslo 创建 db session 的时候,根本就没有传入CONF.database.slave_connection 的值: def get_session(autocommit=True, expire_on_commit=False): """Helper method to grab session.""" facade = _create_facade_lazily() return facade.get_session(autocommit=autocommit, expire_on_commit=expire_on_commit) 在这个 openstack 邮件列表中也能确认这个状态: Nova is the only project that uses slave_connection option and it was kind of broken: nova bare metal driver uses a separate database and there was no way to use a slave db connection for it. 但是,在 Juno 版本中,唯一没有解决 dead lock 问题的就是 Neutorn,因此,该配置项对解决 Neutron MySQL Galera 死锁没有实质性意义。它只对Nova提高DB性能有帮助。关于该配置项,可以参考官方文档https://wiki.openstack.org/wiki/Slave_usage。 4.3.3 对该问题的终极处理 OpenStack 的 Nova 和 Neutorn 模块都在不少地方使用了SELECT... FOR UPDAT 语句,可以参考A lock-free quota implementation文章中的描述。因此,如果不想使用上面的 Workaround(它降低了对扩展性的支持)而要做终极处理的话,就需要修改Nova 和 Neutron 的代码将这些语句替换掉了。 关于代码修改,有如下文档: [documented]: https://github.com/openstack/nova/blob/da59d3228125d7e7427c0ba70180db17c597e8fb/nova/openstack/common/db/sqlalchemy/session.py#L180-196 [Nova]: http://specs.openstack.org/openstack/nova-specs/specs/kilo/approved/lock-free-quota-management.html https://bugs.launchpad.net/oslo.db/+bug/1394298Galera deadlock on SELECT FOR UPDATE is not handled。这个针对 Nova 的 fix 已经进了 Kilo 版本。 [Neutron]: https://bugs.launchpad.net/neutron/+bug/1364358https://bugs.launchpad.net/neutron/+bug/1331564 https://bugs.launchpad.net/neutron/+bug/1364358Remove SELECT FOR UPDATE usage。该 ticket 目前还是 incomplete 状态,而最新的注释 “the current design disallows to remove all SELECT FOR UPDATE so the right bug would to ensure all SELECT FOR UPDATE are Galera multi-writers compliant” 更是说明Neutron 这部分的修改还没有完成。因此,对于 Neutron 来说,还得继续使用 workaround。 根据 Mirantis 和 Percona 的这个报告,Juno 版本中,“All components except neutron are good with using multiple writers”。 4.3.4 数据最终一致性问题 这个OpenStack 邮件列表描述了该问题: A: start transaction; A: insert into foo values(1) A: commit; B: select * from foo; <-- May not contain the value we inserted above[3] 这说明,虽然 Galera 是生成同步的,但是作为分布式数据库,本质上还是需要一些时间,即使非常短,完成写入的数据同步到整个集群的。因此,在某些情况下,特别是MySQL 负载很大导致同步压力很大的情况下,这种读写不一致性的问题可能会更加突出。 注意最下面右侧的Node1 和 node2 上的箭头和红线直接的差距(蓝色圆圈内),这也是为什么是 “virtually”同步,而不是直接同步。如果正好在gap时间段内读的话,是无法读到写入的数据的。 好在 MySQL Galera 提供了一个配置项wsrep_sync_wait,它的含义是 “Defines whether the node enforces strict cluster-wide causality checks.” ,可以有如下值: Bitmask Checks 0 Disabled. 1 Checks onREADstatements, includingSELECT,SHOW, andBEGIN/STARTTRANSACTION. 2 Checks made onUPDATEandDELETEstatements. 3 Checks made onREAD,UPDATEandDELETEstatements. 4 Checks made onINSERTandREPLACEstatements. 它的默认值是0,如果需要保证读写一致性可以设置为1。但是需要注意的是,该设置会带来相应的延迟性,因此,它是一把双刃剑,到底对性能有多大的影响,需要经过测试才能使用。关于该配置项和其它 wresp 配置项的具体说明,可以参考http://galeracluster.com/documentation-webpages/mysqlwsrepoptions.html。注意到Mirantis 和 Percona 的这个报告所使用的测试环境中该值被设为1了。 4.3.5 小结 看起来,目前至少Neutron 还没有完成代码修改,Nova 中的代码修改看似已经完成,但是需要通过测试来验证。因此,目前情况下,我们还是需要使用 4.3.1 中描述的 workaround。 参考链接: http://leejia.blog.51cto.com/4356849/841084 http://drbd.linbit.com/ http://kafecho.github.io/presentations/introduction-to-pacemaker/#/8 http://chuansong.me/n/412792 http://www.gpfeng.com/?p=603 http://fengchj.com/?p=2273 http://imysql.com/2015/09/14/solutions-of-mysql-ha.shtml http://www.joinfu.com/2015/01/understanding-reservations-concurrency-locking-in-nova/ http://www.clusterdb.com/mysql/choosing-the-right-mysql-high-availability-solution-webinar-replay http://galeracluster.com/documentation-webpages/mysqlwsrepoptions.html 本文转自SammyLiu博客园博客,原文链接:http://www.cnblogs.com/sammyliu/p/4995868.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

理解 OpenStack 高可用(HA)(5):RabbitMQ HA

本系列会分析OpenStack 的高可用性(HA)概念和解决方案: (1)OpenStack 高可用方案概述 (2)Neutron L3 Agent HA - VRRP (虚拟路由冗余协议) (3)Neutron L3 Agent HA - DVR (分布式虚机路由器) (4)Pacemaker 和 OpenStack Resource Agent (RA) (5)RabbitMQ HA (6)MySQL HA 1.RabbitMQ 集群 你可以使用若干个RabbitMQ 节点组成一个 RabbitMQ 集群。集群解决的是扩展性问题。所有的数据和状态都会在集群内所有的节点上被复制,只有queue是例外。默认的情况下,消息只会存在于它被创建的节点上,但是它们在所有节点上可见和可访问。 对于Queue 来说,消息实体只存在于其中一个节点,A、B两个节点仅有相同的元数据,即队列结构。当消息进入A节点的Queue中后,consumer从B节点拉取时,RabbitMQ会临时在A、B间进行消息传输,把A中的消息实体取出并经过B发送给consumer。所以consumer应尽量连接每一个节点,从中取消息。即对于同一个逻辑队列,要在多个节点建立物理Queue。否则无论consumer连A或B,出口总在A,会产生瓶颈。该模式存在一个问题就是当A节点故障后,B节点无法取到A节点中还未消费的消息实体。如果做了消息持久化,那么得等A节点恢复,然后才可被消费;如果没有持久化的话,然后就没有然后了。 因此,在集群环境中,队列只有元数据会在集群的所有节点同步,但队列中的数据只会存在于一个节点,数据没有冗余且容易丢,甚至在durable的情况下,如果所在的服务器节点宕机,就要等待节点恢复才能继续提供消息服务。那既然有这种问题,为什么依然有这个选项呢?官方的说法是: (1)存储空间:如果集群的每个节点都有每个queue的一个拷贝,那么增加节点将无法增加存储容量。比如,如果一个节点可以存放 1GB 的消息,增加另外两个节点只会增加另外两个拷贝而已。 (2)性能:发布消息,将会将它拷贝其它节点上。如果是持久性消息,那么每个节点上都会触发磁盘操作。你的网络和磁盘负载在每次增加节点时都会增加。 可见,RabbitMQ Clustering 技术不能完全解决HA 问题。单纯的集群只适合于在不需要HA的场景中使用。 2. Active/Passive HA 方案 RabbitMQ A/P HA官方方案是采用 Pacemaker + (DRBD 或者其它可靠的共享 NAS/SNA 存储) +(CoroSync 或者Heartbeat 或者 OpenAIS)组合来实现的。需要注意的是CoroSync 需要使用多播,而多播在某些云环境中是被禁用的,这时候可以改为使用 Heartbeat,它采用单播。其架构为: 实现 HA 的原理: RabbitMQ 将数据库文件和持久性消息保存在 DRBD 挂载点上。注意,在 failover 时,非持久性消息会丢失。 DRBD 要求在某一时刻,只能有一个 node (primary)能够访问其共享存储,因此,不会有多个node 同时写一块数据的风险。这要求必须依赖 Pacemaker 来控制使用 DRBD 共享存储的 node。Pacemaker 使得在某一时刻,只有 active node 来访问 DRBD 共享存储。在 failover 时,Pacemaker 会卸载当前 active node 上的 DRBD 共享存储,并在新的 active node (原 secondary node)上挂载 DRBD 共享存储。 在 node 启动时,不会自动启动 RabbitMQ。Pacemaker 会在 active node 启动 RabbitMQ。 RabbitMQ HA 只会提供一个访问 RabbitMQ 的 虚拟IP 地址。该方案依赖 Pacemaker 来保证 VIP 的切换。 2.1 基于Pacemaker+ DRBD + CoroSync 的 RabbitMQ HA 方案配置 RabbitMQ 官方的这篇文章介绍了基于 Pacemaker 的 RabbitMQ HA 方案。它同时指出,这是传统的 RabbitMQ HA 方案,并且建议使用 RabbitMQ 集群 + 镜像 Message Queue 的方式来实现 A/A HA。使用 Pacemaker 实现 HA 的方案主要步骤包括: 为 RabbitMQ 配置一个 DRBD 设备 配置 RabbitMQ 使用建立在 DRBD 设备之上的数据目录 选择并绑定一个可以在各集群节点之间迁移的虚拟 IP 地址 (即 VIP ) 配置 RabbitMQ 监听该 IP 地址 使用 Pacemaker 管理上述所有资源,包括 RabbitMQ 守护进程本身 2.1.1 安装 Corosync 和 Pacemaker 本配置使用两个节点。 首先,在两个节点上安装软件包:apt-get install pacemaker crmsh corosync cluster-glue resource-agents,并配置Corosync,设它为 boot 自启动:vi/etc/default/corosync,START=yes。 两个节点上, (1)修改配置文件:vim /etc/corosync/corosync.conf totem { #... interface { ringnumber: 0 bindnetaddr: #节点1上,192.168.1.15;节点2上,192.168.1.32 broadcast: yes mcastport: 5405 } transport: udpu } nodelist { node { ring0_addr: 192.168.1.15 nodeid: 1 } node { ring0_addr: 192.168.1.32 nodeid: 2 } } (2)启动服务service corosync start (3)查看状态 root@compute2:/home/s1# corosync-cfgtool -s Printing ring status. Local node ID 2 RING ID 0 id = 192.168.1.32 status = ring 0 active with no faults root@compute2:/home/s1# corosync-cmapctl runtime.totem.pg.mrp.srp.members#需要确保两个节点都加入了组 runtime.totem.pg.mrp.srp.members.1.config_version (u64) = 0 runtime.totem.pg.mrp.srp.members.1.ip (str) = r(0) ip(192.168.1.15) runtime.totem.pg.mrp.srp.members.1.join_count (u32) = 1 runtime.totem.pg.mrp.srp.members.1.status (str) = joined runtime.totem.pg.mrp.srp.members.2.config_version (u64) = 0 runtime.totem.pg.mrp.srp.members.2.ip (str) = r(0) ip(192.168.1.32) runtime.totem.pg.mrp.srp.members.2.join_count (u32) = 1 runtime.totem.pg.mrp.srp.members.2.status (str) = joined (4)启动 pacemaker:service pacemaker start (5)查看 pacemaker 状态:crm_mon Last updated: Sun Aug 16 15:59:10 2015 Last change: Sun Aug 16 15:58:59 2015 via crmd on compute1 Stack: corosync Current DC: compute1 (1) - partition with quorum Version: 1.1.10-42f2063 3 Nodes configured 0 Resources configured Node compute1 (1084752143): UNCLEAN (offline) Online: [ compute1 compute2 ] (6)配置 pacemaker root@compute2:/home/s1# crm crm(live)# configure crm(live)configure# property no-quorum-policy="ignore" \ #因为这里只有两个节点,因此需要设置为 ‘ignore’。两个节点以上,不可以设置为 ‘ignore’ > pe-warn-series-max="1000" \ > pe-input-series-max="1000" \ > pe-error-series-max="1000" \ > cluster-recheck-interval="2min" crm(live)configure# quit There are changes pending. Do you want to commit them? yes bye 2.1.2 为 RabbitMQ 配置一个 DRBD 设备 在 node1 和 node2 上,依次进行: (0)安装 DRBD,并设置机器启动时 DRBD 服务不自动启动。该服务的启停升降级等都需要由 Pacemaker 控制。 (1)添加一个 1G 的 hard disk,fdiskl -l 可见 /dev/sdb (2)创建 LVM:pvcreate /dev/sdb,vgcreate vg_rabbit /dev/sdb,lvcreate -L1000 -n rabbit vg_rabbit。创建好的 LVM 为/dev/mapper/vg_rabbit-rabbit。 (3)定义 rabbitmq 资源:vi /etc/drbd.d/rabbitmq.res 根据/etc/drbd.conf,资源的配置文件需要放置在/etc/drbd.d/ 目录中,并以 res 为文件类型。DRBD 会自动读取这些配置文件并创建相应的资源。 rource rabbitmq { device minor 1; # DRBD device 是 /dev/drbd1,相当于 device /dev/drbd1 disk "/dev/mapper/vg_rabbit-rabbit"; # Raw device, 本例中是 LVM path。也可以使用不同名字的 Raw device,这样的话需要放到 host 定义部分。 meta-disk internal; # 这是默认值,更多信息可以参考这个 on compute1 { # 节点1,名称需要与 uname -n 的输出相同。 address ipv4 192.168.1.15:7701; #7701 是 DRBD 通信的 TCP 端口,需要确保该端口可以被访问 } on compute2 { # 节点2 address ipv4 192.168.1.32:7701; } } (4)drbdadm create-md rabbitmq root@compute2:/home/s1# drbdadm create-md rabbitmq Writing meta data... initializing activity log NOT initializing bitmap New drbd meta data block successfully created. (5)drbdadm up rabbitmq 在 compute 2 上, (1)drbdadm -- --force primary rabbitmq (2)mkfs -t xfs /dev/drbd1 (如果提示 mkfs.xsf 找不到,则 sudo apt-get install xfsprogs) meta-data=/dev/drbd1 isize=256 agcount=4, agsize=63996 blks = sectsz=512 attr=2, projid32bit=0 data = bsize=4096 blocks=255983, imaxpct=25 = sunit=0 swidth=0 blks naming =version 2 bsize=4096 ascii-ci=0 log =internal log bsize=4096 blocks=1200, version=2 = sectsz=512 sunit=0 blks, lazy-count=1 realtime =none extsz=4096 blocks=0, rtextents=0 (3)mount /dev/drbd1 /var/lib/rabbitmq (4)umount /var/lib/rabbitmq (3)drbdadm secondary rabbitmq 在 compute 1 上: drbdadm -- --force primary rabbitmq mkfs -t xfs /dev/drbd1 mount /dev/drbd1 /var/lib/rabbitmq 至此,DRBD 设置完成,目前 compute 1 上的 DRBD 是主,compute 2 上的是备。查看其状态: root@compute1:/home/s1# /etc/init.d/drbd status drbd driver loaded OK; device status: version: 8.4.3 (api:1/proto:86-101) srcversion: 6551AD2C98F533733BE558C m:res cs ro ds p mounted fstype 1:rabbitmq Connected Primary/Secondary UpToDate/UpToDate C /var/lib/rabbitmq xfs root@compute2:/home/s1# /etc/init.d/drbd status drbd driver loaded OK; device status: version: 8.4.3 (api:1/proto:86-101) srcversion: 6551AD2C98F533733BE558C m:res cs ro ds p mounted fstype 1:rabbitmq Connected Secondary/Primary UpToDate/UpToDate C 调试时遇到一个脑裂问题,就是两个node上 drbd 的状态都是 StandAlone,然后 DRBD 服务在 compute 2 上能起来,在 compute 1 上起不来。 root@compute1:/home/s1# /etc/init.d/drbd status drbd driver loaded OK; device status: version: 8.4.3 (api:1/proto:86-101) srcversion: 6551AD2C98F533733BE558C m:res cs ro ds p mounted fstype 1:rabbitmq StandAlone Secondary/Unknown UpToDate/DUnknown r----- DRBD's startup script waits for the peer node(s) to appear. - In case this node was already a degraded cluster before the reboot the timeout is 0 seconds. [degr-wfc-timeout] - If the peer was available before the reboot the timeout will expire after 0 seconds. [wfc-timeout] (These values are for resource 'rabbitmq'; 0 sec -> wait forever) To abort waiting enter 'yes' [ 148]: 这篇文章和这篇文章给出了这个问题的解决办法: 在起不来 DRBD 服务的节点(compute1)上,运行drbdadm disconnect rabbitmq,drbdadm secondary rabbitmq,和drbdadm --discard-my-data connect rabbitmq 在能起来 DRBD 服务的节点(compute2)上,运行drbdadm connect rabbitmq 然后 DRBD 状态恢复成 Connected 了。 SUSE 有关于 DRBD 安装、配置和测试的不错的文档。 2.1.3 安装和配置 RabbitMQ (1)在两个节点上安装 RabbitMQ。rabbitmq-server 进程会在 rabbitmq 组内的 rabbitmq 用户下运行。 (2)确保 rabbitmq 组和用户在两个节点上具有相同的 ID。运行cat /etc/passwd | grep rabbitmq 和cat /etc/group | grep rabbitmq 查看 ID,必要时进行修改。 (3)确保 rabbitmq 用户对 /var/lib/rabbitmq/有读写权限。 运行 chmod a+w/var/lib/rabbitmq/。 (4)确保各节点都使用相同的 Erlang cookie。需要将 compute 1 上的 RabbitMQ cookie 拷贝到 compute 2 上: (1)compute 1:scp /var/lib/rabbitmq/.erlang.cookie s1@compute2:/home/s1 (2)compute 2:mv .erlang.cookie /var/lib/rabbitmq/ (3)compute 2:chown rabbitmq: /var/lib/rabbitmq/.erlang.cookie (4)compute 2:chmod 400 /var/lib/rabbitmq/.erlang.cookie (5)再执行相同的步骤,将该文件拷贝到 DRBD 共享存储文件系统中 (5)确保计算机启动时不自动启动 rabbitmq。修改/etc/init.d/rabbitmq-server 文件,在文件头注释后面添加 exit 0. 2.1.4 在 Pacemaker 中添加 RabbitMQ 资源 在添加前,在 compute 1 节点上,运行 crm configure,输入: primitive p_ip_rabbitmq ocf:heartbeat:IPaddr2 \ #定义访问 RabbitMQ 的 VIP。使用 RA ocf:heartbeat:IPaddr2。对该 VIP 的监控间隔为 10s。 params ip="192.168.1.222" cidr_netmask="24" \ op monitor interval="10s" primitive p_drbd_rabbitmq ocf:linbit:drbd \ #定义RabbitMQ 的 DRBD 资源,pacemaker 会对它 start,stop,promote,demote 和 monitor。 params drbd_resource="rabbitmq" \ op start timeout="90s" \ #启动的超时时间 op stop timeout="180s" \ op promote timeout="180s" \ op demote timeout="180s" \ op monitor interval="30s" role="Slave" \ #对 Slave drbd 的监控间隔定义为 30s op monitor interval="29s" role="Master" #对 master drbd 的监控间隔定义为 29s primitive p_fs_rabbitmq ocf:heartbeat:Filesystem \ # 在 /dev/drbd1 上创建 xfs 文件系统,并 mount 到 /var/lib/rabbitmq params device="/dev/drbd1" directory="/var/lib/rabbitmq" fstype="xfs" options="relatime" \ op start timeout="60s" op stop timeout="180s" op monitor interval="60s" timeout="60s" primitive p_rabbitmq ocf:rabbitmq:rabbitmq-server \ #定义 RabbitMQ 资源 params nodename="rabbit@localhost" \ mnesia_base="/var/lib/rabbitmq" \ op monitor interval="20s" timeout="10s" group g_rabbitmq p_ip_rabbitmq p_fs_rabbitmq p_rabbitmq #group 指定一组资源需要在同一个node上 ip -> fs -> rabbitmq,顺序启动,逆序停止 ms ms_drbd_rabbitmq p_drbd_rabbitmq meta notify="true" master-max="1" clone-max="2" # 定义一个资源集合,往往用于 master-slave 资源集群。其中,clone-max 定义集合内的 drbd 节点数目,master-max 指定 master 最多只能有一个;notify = “true” 表示启用notification。 colocation c_rabbitmq_on_drbd inf: g_rabbitmq ms_drbd_rabbitmq:Master #colocation 定义在同一个节点上启动的资源。这里定义了一个约束,rabbitmq 只能在 DRBD Master 节点上启动 order o_drbd_before_rabbitmq inf: ms_drbd_rabbitmq:promote g_rabbitmq:start #oder 指定服务启动顺序。这个定义要求先 DRBD 升级为 Master 然后依次执行 ip,fs 和 rabbitmq 启动。 更多的 Pacemaker 配置细节,请参考这个文档。 Pacemaker 一些有用的命令: crm status:显示集群状态 crm configure show:显示集群配置 crm configure edit:修改集群配置 crm node standby:将当前节点设为备节点 crm node online:将当前节点设为主节点 crm ra meta ocf:heartbeat:IPaddr2:查看 RA 的 metadata 配置完成后,RabbitMQ 起不来。一堆问题,挨个来说: (1)Corosync 调试:设置日志文件 logging { fileline: off to_stderr: yes to_logfile: yes to_syslog: yes logfile: /var/log/cluster/corosync.log syslog_facility: daemon debug: off timestamp: on } (2)pacemaker 调试:pacemaker 的日志在 corosync 的 log file 中。 (3)运行 crm status,如果出现 Could not establish cib_ro connection: Connection refused (111) ,原因是 pacemaker 服务没有启动。运行 service pacemaker start 即可。 (4)rabbitmq 启动的错误日志可以在/var/log/rabbitmq 目录下找到。可能的错误之一是,rabbit 用户没有目录 /var/lib/rabbitmq 的写权限。 成功后,是这样的效果: root@compute2:/var/lib/rabbitmq/rabbit@localhost# crm status Last updated: Mon Aug 17 00:16:11 2015 Last change: Sun Aug 16 22:54:27 2015 via cibadmin on compute1 Stack: corosync Current DC: compute1 (1) - partition with quorum Version: 1.1.10-42f2063 3 Nodes configured 5 Resources configured Online: [ compute1 compute2 ] # pacemaker 集群中有两个节点 OFFLINE: [ compute1 ] # compute 1 是备节点 Resource Group: g_rabbitmq p_ip_rabbitmq (ocf::heartbeat:IPaddr2): Started compute2 #在 compute 2 上启动 VIP,成功 p_rabbitmq (ocf::rabbitmq:rabbitmq-server): Started compute2 #在 compute 2 上启动 rabbitmq,成功 Master/Slave Set: ms_drbd_rabbitmq [p_drbd_rabbitmq] Masters: [ compute2 ] Slaves: [ compute1 ] p_fs_rabbitmq (ocf::heartbeat:Filesystem): Started compute2 # 在 compute 2 上设置 drbd 文件系统,成功 可见,根据配置,pacemaker 会(1)根据 corosync 确定集群中的节点和状态 (2)启动 VIP (3)启动指定的服务 (4)设置 DRBD 文件系统。每一步都可能失败,失败则需要调试。 (5)将主节点停机,rabbitmq 服务顺利地被切换到备节点上。 2. 基于集群+镜像队列的A/A 方案 从 3.6.0 版本开始,RabbitMQ支持镜像队列功能,官方文档在这里。。与普通集群相比,其实质和普通模式不同之处在于,消息实体会主动在镜像节点间同步,而不是在 consumer 取数据时临时拉取。该模式带来的副作用也很明显,除了降低系统性能外,如果镜像队列数量过多,加之大量的消息进入,集群内部的网络带宽将会被这种同步通讯大大消耗掉。所以在对可靠性要求较高的场合中适用。 Mirrorred queue 是 RabbitMQ 高可用的一种方案,相对于普通的集群方案来讲,queue中的消息每个节点都会存在一份 copy,这个在单个节点失效的情况下,整个集群仍旧可以提供服务。但是由于数据需要在多个节点复制,在增加可用性的同时,系统的吞吐量会有所下降。 选举机制:mirror queue 内部实现了一套选举算法,有一个 master 和多个slave,queue 中的消息以 master 为主。镜像队列有主从之分,一个主节点(master),0个或多个从节点(slave)。当master宕掉后,会在 slave 中选举新的master,其选举算法为最早启动的节点。若master节点失效,则 mirror queue 会自动选举出一个节点(slave中消息队列最长者)作为master,作为消息消费的基准参考;在这种情况下可能存在ack消息未同步到所有节点的情况(默认异步),若 slave 节点失效,mirror queue 集群中其他节点的状态无需改变。所以,看起来可以使用两节点的镜像队列集群。 使用:对于publish,可以选择任意一个节点进行连接,rabbitmq内部若该节点不是master,则转发给master,master向其他slave节点发送该消息,后进行消息本地化处理,并组播复制消息到其他节点存储;对于consumer,可以选择任意一个节点进行连接,消费的请求会转发给master,为保证消息的可靠性,consumer需要进行ack确认,master收到ack后,才会删除消息,ack消息会同步(默认异步)到其他各个节点,进行slave节点删除消息。 考虑到性能问题,复制可以在可控范围内进行,包括集群内全节点复制的镜像队列和集群内局部节点复制的镜像队列两种模式。 2.1 配置 多个单独的 RabbitMQ 服务,可以加入到一个集群中,也可以从集群中退出。集群中的 RabbitMQ 服务,使用同样的 Erlang cookie(unix 系统上默认为/var/lib/rabbitmq/.erlang.cookie)。所有在一个 RabbitMQ 服务中被操作的数据和状态(date/state)都会被同步到集群中的其它节点。 镜像队列的配置通过添加 policy 完成,policy 添加的命令为: rabbitmqctl set_policy [-p Vhost] Name Pattern Definition [Priority] -p Vhost: 可选参数,针对指定vhost下的queue进行设置 Name: policy的名称 Pattern: queue的匹配模式(正则表达式) Definition: 镜像定义,包括三个部分 ha-mode,ha-params,ha-sync-mode ha-mode: 指明镜像队列的模式,有效值为 all/exactly/nodes all表示在集群所有的节点上进行镜像 exactly 表示在指定个数的节点上进行镜像,节点的个数由ha-params指定 nodes 表示在指定的节点上进行镜像,节点名称通过ha-params指定 ha-params: ha-mode模式需要用到的参数 ha-sync-mode: 镜像队列中消息的同步方式,有效值为automatic,manually Priority: 可选参数, policy的优先级 例如,对队列名称以 ’hello‘ 开头的所有队列进行镜像,并在集群的两个节点上完成镜像,policy的设置命令为: rabbitmqctl set_policy hello-ha "^hello" '{"ha-mode":"exactly","ha-params":2,"ha-sync-mode":"automatic"}' 2.2 HAProxy 和 RabbitMQ A/A 集群 RabbitMQ 实现镜像队列的方式比较特别。这篇文章进行了深入的阐述。假设有如下的配置: 创建 queue 的过程: LB 将 client request 分发到 node 2,client 创建队列 “NewQueue”,然后开始向其中放入 message。 最终,后端服务会对 node 2 上的 “NewQueue” 创建一个快照,并在一段时间内将其拷贝到node 1 和 3 上。这时候,node2 上的队列是master Queue,node 1 和 3 上的队列是 slave queue。 假如现在 node2 宕机了: node 2 不再响应心跳,它会被认为已经被从集群中移出了 node 2 上的 master queue 不再可用 RabbitMQ 将 node 1 或者 3 上的 salve instance 升级为 master instance 假设 master queue 还在 node 2 上,客户端通过 LB 访问该队列: 客户端连接到集群,要访问“NewQueue” 队列 LB 根据配置的轮询算法将请求分发到一个节点上 假设客户端请求被转到 node 3 上 RabbitMQ 发现“NewQueue” master node 是 node 2 RabbitMQ 将消息转到 node 2 上 最终客户端成功连接到 node 2 上的 master 队列 可见,这种配置下,2/3 的客户端请求需要重定向,这会造成大概率的访问延迟,但是终究访问还是会成功的。要优化的话,总共有两种方式: 直接连到 master queue 所在的节点,这样就不需要重定向了。但是对这种方式,需要提前计算,然后告诉客户端哪个节点上有 master queue。 尽可能地在所有节点间平均分布队列,减少重定向概率 2.3 镜像队列的负载均衡 使用镜像队列的 RabbitMQ 不支持负载均衡,这是由其镜像队列的实现机制决定的。如前面所述,假设一个集群里有两个实例,记作 rabbitA 和 rabbitB。如果某个队列在rabbitA 上创建,随后在 rabbitB 上镜像备份,那么 rabbitA 上的队列称为该队列的主队列(master queue),其它备份均为从队列。接下来,无论client 访问rabbitA 或 rabbitB,最终消费的队列都是主队列。换句话说,即使在连接时主动连接rabbitB,RabbitMQ的 cluster 会自动把连接转向 rabbitA。当且仅当rabbitA服务down掉以后,在剩余的从队列中再选举一个作为继任的主队列。 如果这种机制是真的(需要看代码最最终确认),那么负载均衡就不能简单地随机化连接就能做到了。要实现轮询,需要满足下面的条件: 队列本身的建立需要随机化,即将队列分布于各个服务器 client 访问需要知道每个队列的主队列保存在哪个服务器 如果某个服务器down了,需要知道哪个从队列被选择成为继任的主队列。 要实现这种方案,这篇文章给出了一个方案: 首先,在建立一个新队列的时候,Randomiser 会随机选择一个服务器,这样能够保证队列均匀分散在各个服务器(这里暂且不考虑负载)。建立队列后需要在Meta data 里记录这个队列对应的服务器;另外,Monitor Service是关键,它用于处理某个服务器down掉的情况。一旦发生down机,它需要为之前主队列在该服务器的队列重新建立起与服务器的映射关系。 这里会遇到一个问题,即怎么判断某个队列的主队列呢?一个方法是通过rabbitmqctl,如下面的例子: 1 2 3 ./rabbitmqctl-pproductionlist_queuespidslave_pids registration-email-queue<rabbit@mq01.2.1076.0>[<rabbit@mq00.1.285.0>] registration-sms-queue<rabbit@mq01.2.1067.0>[<rabbit@mq00.1.281.0>] 可以看到pid和slave_pids分别对应主队列所在的服务器和从服务器(可能有多个)。利用这个命令就可以了解每个队列所在的主服务器了。 3. OpenStack 中RabbitMQ集群的用法和配置 3.1 配置 OpenStack 官方建议至少使用三节点 RabbitMQ 集群,而且推荐配置是使用镜像队列。对于测试和演示环境,使用两节点也是可以。以下OpenStack服务都支持这种 A/A 形式的 RabbitMQ: 计算服务 块设备存储服务 网络服务 Telemetry OpenStack 支持如下的 RabbitMQ 配置: rabbit_hosts=rabbit1:5672,rabbit2:5672,rabbit3:5672:所有RabbitMQ 服务列表 rabbit_retry_interval=1: 连接失败时候的重试间隔 rabbit_retry_backoff=2:How long to back-off for between retries when connecting to RabbitMQ。不太明白其含义。 rabbit_max_retries=0:最大重试次数。0 表示一直重试 rabbit_durable_queues=true:true 的话表示使用持久性队列,Kilo 中默认为 false。 rabbit_ha_queues=true: 设置为 true 的话则使用镜像队列,并设置x-ha-policy 为 all;但是 Kilo 中其默认值为 false。 具体的配置可以参考这篇文章以及 OpenStack 官网,以及RabbitMQ 官网。 3.2 RabbitMQ 节点选择 OpenStack 的 oslo_messaging 的 RabbitMQ driver 的实现代码在这里。它采用的逻辑正是上面所提到的第二种优化方法“尽可能地在所有节点间平均分布队列,减少重定向概率”。这表现在: (1)将 rabbit_hosts 打乱,然后构造新的包含多host的 url: if len(self.rabbit_hosts) > 1: random.shuffle(self.rabbit_hosts) #将多个 hosts 打乱 for adr in self.rabbit_hosts: hostname, port = netutils.parse_host_port( adr, default_port=self.rabbit_port) self._url += '%samqp://%s:%s@%s:%s/%s' % ( #将多个url合并,以分号分割,kombu 会按照指定策略在连接失败时重新选择别的host重连 ";" if self._url else '', parse.quote(self.rabbit_userid, ''), parse.quote(self.rabbit_password, ''), self._parse_url_hostname(hostname), port, virtual_host) (2)在建立 Connection 的时候,设置 failover_strategy 为 “shuffle”,这样,在连接不成功需要重连的时候,kombu 会 “随机”地选择一个新的 host:port 重新连接(kombu 库支持 轮询和随机两种策略,代码在这里) self.connection = kombu.connection.Connection( self._url, ssl=self._fetch_ssl_params(), login_method=self.login_method, failover_strategy="shuffle", heartbeat=self.heartbeat_timeout_threshold, transport_options={ 'confirm_publish': True, 'on_blocked': self._on_connection_blocked, 'on_unblocked': self._on_connection_unblocked, }, ) 3.3 性能配置 OpenStack 支持如下几种 RPC 性能配置: rpc_conn_pool_size = 30 (IntOpt) (RPC 连接池的大小) rpc_response_timeout = 60 (IntOpt) (等待返回的超时时间,单位是秒) rpc_thread_pool_size = 64 (IntOpt) (RPC 线程池的大小) 这些参数在做RPC 性能调试的时候往往需要考虑到。 参考链接: http://leejia.blog.51cto.com/4356849/841084 http://drbd.linbit.com/ http://kafecho.github.io/presentations/introduction-to-pacemaker/#/8 http://chuansong.me/n/412792 http://www.gpfeng.com/?p=603 http://fengchj.com/?p=2273 http://onlychoice.github.io/blog/2013/11/12/rabbitmq-ha/ http://insidethecpu.com/2014/11/17/load-balancing-a-rabbitmq-cluster/ http://my.oschina.net/hncscwc/blog/186350 http://www.rabbitmq.com/ha.html 本文转自SammyLiu博客园博客,原文链接:http://www.cnblogs.com/sammyliu/p/4730517.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

理解Docker(1):Docker 安装和基础用法

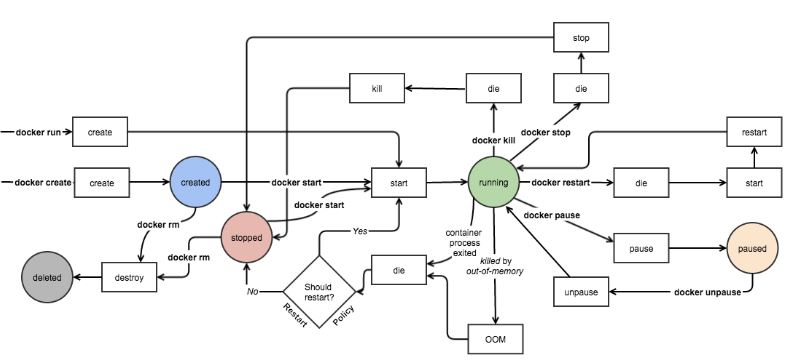
本系列文章将介绍Docker的有关知识: (1)Docker 安装及基本用法 (2)Docker 镜像 (3)Docker 容器的隔离性 - 使用 Linux namespace 隔离容器的运行环境 (4)Docker 容器的隔离性 - 使用 cgroups 限制容器使用的资源 (5)Docker 网络 1. 安装 1.1 在 Ubuntu 14.04 上安装 Docker 前提要求: 内核版本必须是3.10或者以上 依次执行下面的步骤: sudo apt-get update sudo apt-get install apt-transport-https ca-certificates sudo apt-key adv --keyserver hkp://p80.pool.sks-keyservers.net:80 --recv-keys 58118E89F3A912897C070ADBF76221572C52609D 编辑/etc/apt/sources.list.d/docker.list 文件,添加deb https://apt.dockerproject.org/repo ubuntu-trusty main sudo apt-getupdate sudo apt-getpurge lxc-docker apt-cachepolicy docker-engine apt-get upgrade sudo apt-get install linux-image-extra-$(uname -r) linux-image-extra-virtual sudo apt-get install docker-engine 至此,安装过程完成。 运行sudo service dockerstart 启动 Docker 守护进程。 运行 docker version 查看 Docker 版本 root@devstack:/home/sammy# docker --version Docker version 1.12.1, build 23cf638 启动第一个容器: 启动第一个Docker 容器 docker run hello-world root@devstack:/home/sammy# docker run hello-world Hello from Docker! This message shows that your installation appears to be working correctly. 它的运行成功也表明前面的安装步骤都运行正确了。 以上内容参考自 Docker 官网:https://docs.docker.com/engine/installation/linux/ubuntulinux/ 1.2 Docker 到目前(2016/09/16)为止的版本历史 版本号 发布日期 发布经理 Docker 1.12.1 08/18/2016 Docker 1.12.0 07/28/2016 Docker 1.11.0 04/12/2016 @mlaventure Docker 1.10.0 02/04/2016 @thaJeztah Docker 1.9.0 10/29/2015 @tiborvass Docker 1.8.0 08/11/2015 @calavera 2. Docker 的基本操作 2.1 Docker 容器的状态机 (图片来源) 一个容器在某个时刻可能处于以下几种状态之一: created:已经被创建 (使用 docker ps -a 命令可以列出)但是还没有被启动 (使用 docker ps 命令还无法列出) running:运行中 paused:容器的进程被暂停了 restarting:容器的进程正在重启过程中 exited:上图中的 stopped 状态,表示容器之前运行过但是现在处于停止状态(要区别于 created 状态,它是指一个新创出的尚未运行过的容器)。可以通过 start 命令使其重新进入 running 状态 destroyed:容器被删除了,再也不存在了 你可以在 docker inspect 命令的输出中查看其详细状态: "State": { "Status": "running", "Running": true, "Paused": false, "Restarting": false, "OOMKilled": false, "Dead": false, "Pid": 4597, "ExitCode": 0, "Error": "", "StartedAt": "2016-09-16T08:09:34.53403504Z", "FinishedAt": "2016-09-16T08:06:44.365106765Z" } 2.2 Docker 命令概述 我们可以把Docker 的命令大概地分类如下: 镜像操作: build Build an image from a Dockerfile commit Create a new image from a container's changes images List images load Load an image from a tar archive or STDIN pull Pull an image or a repository from a registry push Push an image or a repository to a registry rmi Remove one or more images search Search the Docker Hub for images tag Tag an image into a repository save Save one or more images to a tar archive (streamed to STDOUT by default) history 显示某镜像的历史 inspect 获取镜像的详细信息 容器及其中应用的生命周期操作: create Create a new container (创建一个容器) kill Kill one or more running containers inspect Return low-level information on a container, image or task pause Pause all processes within one or more containers ps List containers rm Remove one or more containers (删除一个或者多个容器) rename Rename a container restart Restart a container run Run a command in a new container (创建并启动一个容器) start Start one or more stopped containers (启动一个处于停止状态的容器) stats Display a live stream of container(s) resource usage statistics (显示容器实时的资源消耗信息) stop Stop one or more running containers (停止一个处于运行状态的容器) top Display the running processes of a container unpause Unpause all processes within one or more containers update Update configuration of one or more containers wait Block until a container stops, then print its exit code attach Attach to a running container exec Run a command in a running container port List port mappings or a specific mapping for the container logs 获取容器的日志 容器文件系统操作: cp Copy files/folders between a container and the local filesystem diff Inspect changes on a container's filesystem export Export a container's filesystem as a tar archive import Import the contents from a tarball to create a filesystem image Docker registry 操作: login Log in to a Docker registry. logout Log out from a Docker registry. Volume 操作 volume Manage Docker volumes 网络操作 network Manage Docker networks Swarm 相关操作 swarm Manage Docker Swarm service Manage Docker services node Manage Docker Swarm nodes 系统操作: version Show the Docker version information events Get real time events from the server (持续返回docker 事件) info Display system-wide information (显示Docker 主机系统范围内的信息) 比较有意思的几个命令: (1)容器从生到死整个生命周期 root@devstack:/home/sammy# docker create --name web31 training/webapp python app.py #创建名字为 web31 的容器 7465f4cb7c49555af32929bd1bc4213f5e72643c0116450e495b71c7ec128502 root@devstack:/home/sammy# docker inspect --format='{{.State.Status}}' web31 #其状态为 created created root@devstack:/home/sammy# docker start web31 #启动容器 web31 root@devstack:/home/sammy# docker exec -it web31 /bin/bash #在容器中运行 bash 命令 root@devstack:/home/sammy# docker inspect --format='{{.State.Status}}' web31 #其状态为 running running root@devstack:/home/sammy# docker pause web31 #暂停容器 web31 root@devstack:/home/sammy# docker inspect --format='{{.State.Status}}' web31 paused root@devstack:/home/sammy# docker unpause web31 #继续容器 web31 root@devstack:/home/sammy# docker inspect --format='{{.State.Status}}' web31 running root@devstack:/home/sammy# docker rename web31 newweb31 #重命名 root@devstack:/home/sammy# docker inspect --format='{{.State.Status}}' newweb31 running root@devstack:/home/sammy# docker top newweb31 #在容器中运行 top 命令 UID PID PPID C STIME TTY TIME CMD root 5009 4979 0 16:28 ? 00:00:00 python app.py root@devstack:/home/sammy# docker logs newweb31 #获取容器的日志 * Running on http://0.0.0.0:5000/ (Press CTRL+C to quit) root@devstack:/home/sammy# docker stop newweb31 #停止容器 newweb31 root@devstack:/home/sammy# docker inspect --format='{{.State.Status}}' newweb31 exited root@devstack:/home/sammy# docker rm newweb31 #删除容器 newweb31 root@devstack:/home/sammy# docker inspect --format='{{.State.Status}}' newweb31 Error: No such image, container or task: newweb31 (2) docker stop 和 docker kill 在docker stop 命令执行的时候,会先向容器中PID为1的进程发送系统信号 SIGTERM,然后等待容器中的应用程序终止执行,如果等待时间达到设定的超时时间(默认为 10秒,用户可以指定特定超时时长),会继续发送SIGKILL的系统信号强行kill掉进程。在容器中的应用程序,可以选择忽略和不处理SIGTERM信号,不过一旦达到超时时间,程序就会被系统强行kill掉,因为SIGKILL信号是直接发往系统内核的,应用程序没有机会去处理它。 比如运行docker stop web5 -t 20 命令后: 2016-09-16T16:01:18.206540853+08:00 container kill b3256ef1400a7f6a6f242e377a77af5e25d3b12237c4ee7c2e9b31a5f6437868 (image=training/webapp, name=web5, signal=15) 2016-09-16T16:01:38.212352224+08:00 container kill b3256ef1400a7f6a6f242e377a77af5e25d3b12237c4ee7c2e9b31a5f6437868 (image=training/webapp, name=web5, signal=9) 2016-09-16T16:01:38.235021315+08:00 container die b3256ef1400a7f6a6f242e377a77af5e25d3b12237c4ee7c2e9b31a5f6437868 (exitCode=137, image=training/webapp, name=web5) 能看到: 首先 docker 向容器发出SIGTERM 信号(signal=15) 等待20秒 (01:18 到01:38) 再发送SIGKILL 系统信号 (signal = 9) 然后容器被杀掉了 (die) 而 docker kill 命令会直接发出SIGKILL的系统信号,以强行终止容器中程序的运行。运行 docker kill web5 命令后: 2016-09-16T16:06:44.351086471+08:00 container kill b3256ef1400a7f6a6f242e377a77af5e25d3b12237c4ee7c2e9b31a5f6437868 (image=training/webapp, name=web5, signal=9) 2016-09-16T16:06:44.365116100+08:00 container die b3256ef1400a7f6a6f242e377a77af5e25d3b12237c4ee7c2e9b31a5f6437868 (exitCode=137, image=training/webapp, name=web5) 可见直接发出的是 SIGKILL 信号,容器立马就被杀掉了。 (3)使用 docker cp 在 host 和 container 之间拷贝文件或者目录 root@devstack:/home/sammy# docker cp /home/sammy/mydockerbuild/Dockerfile web5:/webapp #从 host 拷贝文件到 container 里面 root@devstack:/home/sammy# root@devstack:/home/sammy# docker cp web5:/webapp/Dockerfile /home/sammy/Dockerfile #从 container 里面拷贝文件到 host 上 root@devstack:/home/sammy# ls /home/sammy chroot devstack Dockerfile mongodbdocker mydockerbuild webapp (4)docker export 和 import docker export:将一个容器的文件系统打包为一个压缩文件 root@devstack:/home/sammy# docker export web5 -o ./web5 root@devstack:/home/sammy# ls chroot devstack Dockerfile mongodbdocker mydockerbuild web5 webapp docker import:从一个压缩文件创建一个镜像 root@devstack:/home/sammy# docker import web5 web5img -m "imported on 0916" sha256:745bb258be0a69a517367667646148bb2f662565bb3d222b50c0c22e5274a926 root@devstack:/home/sammy# docker history web5img IMAGE CREATED CREATED BY SIZE COMMENT 745bb258be0a 6 seconds ago 324 MB imported on 0916 (5) 当在 docker 中执行某 bash 命令时,可能会返回 command not found。其原因是你所使用的镜像往往是最小镜像,未安装你所需要的命令。比如基于 ubuntu 镜像启动一个容器,运行 ping 命令会提示该错误。此时,需要手工安装该工具。 apt-get update apt-get install iputils-ping #会安装 ping 命令apt-get install net-tools #会安装 ifconfig 命令 2.3 docker run 命令 docker run 命令会创建一个容器并启动它,它也是包含很多的参数,按照用途将它们分类如下: cgroups 和 namespace 相关: --blkio-weight value Block IO (relative weight), between 10 and 1000 --blkio-weight-device value Block IO weight (relative device weight) (default []) --cgroup-parent string Optional parent cgroup for the container --cpu-percent int CPU percent (Windows only) --cpu-period int Limit CPU CFS (Completely Fair Scheduler) period --cpu-quota int Limit CPU CFS (Completely Fair Scheduler) quota -c, --cpu-shares int CPU shares (relative weight) --cpuset-cpus string CPUs in which to allow execution (0-3, 0,1) --cpuset-mems string MEMs in which to allow execution (0-3, 0,1) --device-read-bps value Limit read rate (bytes per second) from a device (default []) --device-read-iops value Limit read rate (IO per second) from a device (default []) --device-write-bps value Limit write rate (bytes per second) to a device (default []) --device-write-iops value Limit write rate (IO per second) to a device (default []) --ipc string IPC namespace to use -m, --memory string Memory limit --memory-reservation string Memory soft limit --memory-swap string Swap limit equal to memory plus swap: '-1' to enable unlimited swap --memory-swappiness int Tune container memory swappiness (0 to 100) (default -1) --kernel-memory string Kernel memory limit -u, --user string Username or UID (format: <name|uid>[:<group|gid>]) --userns string User namespace to use --uts string UTS namespace to use -h, --hostname string Container host name --pid string PID namespace to use --pids-limit int Tune container pids limit (set -1 for unlimited) --isolation string Container isolation technology --io-maxbandwidth string Maximum IO bandwidth limit for the system drive (Windows only) --io-maxiops uint Maximum IOps limit for the system drive (Windows only) linux process capabilities 相关参数: --cap-add value Add Linux capabilities (default []) --cap-drop value Drop Linux capabilities (default []) 容器运行模式和环境相关: -d, --detach Run container in background and print container ID -e, --env value Set environment variables (default []) --env-file value Read in a file of environment variables (default []) DNS 相关: --dns value Set custom DNS servers (default []) --dns-opt value Set DNS options (default []) --dns-search value Set custom DNS search domains (default []) 健康检查相关: --health-cmd string Command to run to check health --health-interval duration Time between running the check --health-retries int Consecutive failures needed to report unhealthy --health-timeout duration Maximum time to allow one check to run --no-healthcheck Disable any container-specified HEALTHCHECK IP 和端口: --ip string Container IPv4 address (e.g. 172.30.100.104) --ip6 string Container IPv6 address (e.g. 2001:db8::33) -p, --publish value Publish a container's port(s) to the host (default []) -P, --publish-all Publish all exposed ports to random ports --expose value Expose a port or a range of ports (default []) --mac-address string Container MAC address (e.g. 92:d0:c6:0a:29:33) --add-host value Add a custom host-to-IP mapping (host:ip) (default []) Volume 相关: -v, --volume value Bind mount a volume (default []) --volume-driver string Optional volume driver for the container --volumes-from value Mount volumes from the specified container(s) (default []) --storage-opt value Storage driver options for the container (default []) Network 有关: --network string Connect a container to a network (default "default") --network-alias value Add network-scoped alias for the container (default []) --link value Add link to another container (default []) --link-local-ip value Container IPv4/IPv6 link-local addresses (default []) 日志有关: --log-driver string Logging driver for the container --log-opt value Log driver options (default []) 交互性有关: -a, --attach value Attach to STDIN, STDOUT or STDERR (default []) -i, --interactive Keep STDIN open even if not attached OOM 有关: --oom-kill-disable Disable OOM Killer --oom-score-adj int Tune host's OOM preferences (-1000 to 1000) 其它(待更进一步分类): --cidfile string Write the container ID to the file --detach-keys string Override the key sequence for detaching a container --device value Add a host device to the container (default []) --disable-content-trust Skip image verification (default true) --entrypoint string Overwrite the default ENTRYPOINT of the image --group-add value Add additional groups to join (default []) --help Print usage -l, --label value Set meta data on a container (default []) --label-file value Read in a line delimited file of labels (default []) --name string Assign a name to the container --privileged Give extended privileges to this container --read-only Mount the container's root filesystem as read only --restart string Restart policy to apply when a container exits (default "no") --rm Automatically remove the container when it exits --runtime string Runtime to use for this container --security-opt value Security Options (default []) --shm-size string Size of /dev/shm, default value is 64MB --sig-proxy Proxy received signals to the process (default true) --stop-signal string Signal to stop a container, SIGTERM by default (default "SIGTERM") --sysctl value Sysctl options (default map[]) --tmpfs value Mount a tmpfs directory (default []) -t, --tty Allocate a pseudo-TTY --ulimit value Ulimit options (default []) -w, --workdir string Working directory inside the container 具体的内容以后会有专门文件分析。 3. Doker 平台的基本构成 Docker 平台基本上由三部分组成: 客户端:用户使用 Docker 提供的工具(CLI 以及 API 等)来构建,上传镜像并发布命令来创建和启动容器 Docker 主机:从 Docker registry 上下载镜像并启动容器 Docker registry:Docker 镜像仓库,用于保存镜像,并提供镜像上传和下载 后面的文章会具体分析。 本文转自SammyLiu博客园博客,原文链接:http://www.cnblogs.com/sammyliu/p/5875470.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

谈谈对区块链服务(BaaS)的理解

我认为在下半年会一个有关区块链的新词火热起来:BaaS(区块链即服务Blockchain as a Service) 理由有两: 第一、目前区块链的私有链(联盟链)竞争已经进入白热化阶段,HyperLedger/EEA等私有链产品已经摩拳擦掌,国内也有很多类似产品在相互竞争。目前还未进入真正的市场宣传阶段,如果进入对技术型产品的宣传阶段,势必会将BaaS的概念炒热。 第二、BaaS的概念可以很好地与云服务平台相结合,形成将区块链技术框架嵌入云计算平台的结合趋势。 我认为上述趋势和做法,完全偏离了的区块链发展方向。我会详细说明以下几点以证明我的观点: 什么是区块链服务? 什么是区块链技术服务? 两者区别。 为什么说区块链服务比区块链技术服务重要? 如何构建区块链服务? 1. 什么是区块链服务? 区块链服务是指利用区块链产生的数据,提供基于区块链的搜索查

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册