首页 文章 精选 留言 我的

精选列表

搜索[AI生成],共10000篇文章
优秀的个人博客,低调大师

开源代码生成模型 StarCoder 2 全新上线!

BigCode 正式推出 StarCoder2 —— 一系列新一代的开放源代码大语言模型 (LLMs)。这些模型全部基于一个全新、大规模且高品质的代码数据集 The Stack v2 进行训练。我们不仅公开了所有的模型和数据集,还包括了数据处理和训练代码的详细信息,详情请参阅 相关论文。 StarCoder2 是什么? StarCoder2 是一套面向代码的开放式大语言模型系列,提供 3 种规模的模型,分别包括 30 亿 (3B)、70 亿 (7B) 和 150 亿 (15B) 参数。特别地,StarCoder2-15B 模型经过了超过 4 万亿 token 和 600 多种编程语言的训练,基于 The Stack v2 数据集。所有模型均采用分组查询注意力机制 (Grouped Query Attention),具备 16,384 个 token 的上下文窗口和 4,096 个令牌的滑动窗口注意力,并通过“填充中间” (Fill-in-the-Middle) 技术进行训练。 StarCoder2 包含三种规模的模型:ServiceNow 训练的 30 亿参数模型、Hugging Face 训练的 70 亿参数模型以及 NVIDIA 利用 NVIDIA NeMo 在 NVIDIA 加速基础架构上训练的 150 亿参数模型: StarCoder2-3B 基于 The Stack v2 的 17 种编程语言训练,处理了超过 3 万亿 token。 StarCoder2-7B 基于 The Stack v2 的 17 种编程语言训练,处理了超过 3.5 万亿 token。 StarCoder2-15B 基于 The Stack v2 的 600 多种编程语言训练,处理了超过 4 万亿 token。 StarCoder2-15B 模型在其级别中表现出色,与 33 亿以上参数的模型在多项评估中不相上下。StarCoder2-3B 的性能达到了 StarCoder1-15B 的水平: The Stack v2 是什么? The Stack v2 是迄今为止最大的开放代码数据集,非常适合进行大语言模型的预训练。与 The Stack v1 相比,The Stack v2 拥有更大的数据规模,采用了更先进的语言和许可证检测流程以及更优的过滤机制。此外,训练数据集按照仓库进行了分组,使得模型训练能够获得仓库上下文的支持。 数据集对比 The Stack v1 The Stack v2 全部数据量 6.4TB 67.5TB 去重后数据量 2.9TB 32.1TB 训练数据集大小 约 2000 亿 token 约 9000 亿 token 该数据集源自软件遗产档案 (Software Heritage archive),这是一个包含了丰富软件源代码及其开发历史的公共档案库。作为一个开放和非盈利的项目,软件遗产由 Inria 与 UNESCO 合作发起,旨在收集、保存并共享所有公开可用的软件源代码。我们对软件遗产提供这一无价资源表示感谢。欲了解更多信息,请访问 软件遗产网站。 您可以通过 Hugging Face Hub 访问 The Stack v2 数据集。 关于 BigCode BigCode 是由 Hugging Face 和 ServiceNow 联合领导的一个开放科研合作项目,致力于负责任地开发代码用大语言模型。 相关链接 模型资源 研究论文: 详细介绍 StarCoder2 和 The Stack v2 的技术报告。 GitHub 仓库: 提供使用或微调 StarCoder2 的完整指南。 StarCoder2-3B: 规模较小的 StarCoder2 模型。 StarCoder2-7B: 规模中等的 StarCoder2 模型。 StarCoder2-15B: 规模较大的 StarCoder2 模型。 数据及治理 StarCoder2 许可协议: 模型基于 BigCode OpenRAIL-M v1 许可协议授权。 StarCoder2 代码搜索: 对预训练数据集中的代码进行全文搜索。 StarCoder2 成员资格测试: 快速验证代码是否包含在预训练数据集中。 其他资源 VSCode 扩展: 使用 StarCoder 进行编码的插件! 大型代码模型排行榜: 比较不同模型的性能。所有资源和链接均可在 huggingface.co/bigcode 查阅! 🤗 宝子们可以戳 阅读原文 查看文中所有的外部链接哟! 英文原文:https://hf.co/blog/starcoder2 原文作者: Leandro von Werra, Loubna Ben Allal, Anton Lozhkov, Nouamane Tazi 译者: AdinaY 本文分享自微信公众号 - Hugging Face(gh_504339124f0f)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Kafka生成消息时的3种分区策略

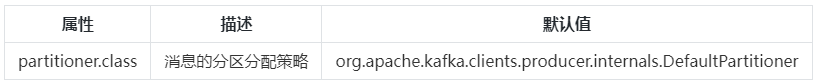
摘要:KafkaProducer在发送消息的时候,需要指定发送到哪个分区, 那么这个分区策略都有哪些呢? 本文分享自华为云社区《Kafka生产者3中分区分配策略》,作者:石臻臻的杂货铺。 KafkaProducer在发送消息的时候,需要指定发送到哪个分区, 那么这个分区策略都有哪些呢?我们今天来看一下 使用分区策略的配置: 1. DefaultPartitioner 默认分区策略 全路径类名:org.apache.kafka.clients.producer.internals.DefaultPartitioner 如果消息中指定了分区,则使用它 如果未指定分区但存在key,则根据序列化key使用murmur2哈希算法对分区数取模。 如果不存在分区或key,则会使用粘性分区策略,关于粘性分区请参阅 KIP-480。 粘性分区Sticky Partitioner 为什么会有粘性分区的概念? 首先,我们指定,Producer在发送消息的时候,会将消息放到一个ProducerBatch中, 这个Batch可能包含多条消息,然后再将Batch打包发送。关于这一块可以看看我之前的文章 图解Kafka Producer 消息缓存模型。 这样做的好处就是能够提高吞吐量,减少发起请求的次数。 但是有一个问题就是, 因为消息的发送它必须要你的一个Batch满了或者linger.ms时间到了,才会发送。如果生产的消息比较少的话,迟迟难以让Batch塞满,那么就意味着更高的延迟。 在之前的消息发送中,就将消息轮询到各个分区的, 本来消息就少,你还给所有分区遍历的分配,那么每个ProducerBatch都很难满足条件。 那么假如我先让一个ProducerBatch塞满了之后,再给其他的分区分配是不是可以降低这个延迟呢? 详细的可以看看下面这张图 这张图的前提是: Topic1 有3分区, 此时给Topic1 发9条无key的消息, 这9条消息加起来都不超过batch.size . 那么以前的分配方式和粘性分区的分配方式如下 可以看到,使用粘性分区之后,至少是先把一个Batch填满了发送然后再去填充另一个Batch。不至于向之前那样,虽然平均分配了,但是导致一个Batch都没有放满,不能立即发送。这不就增大了延迟了吗(只能通过linger.ms时间到了才发送) 划重点: 当一个Batch发送之后,需要选择一个新的粘性分区的时候 ①. 可用分区<1 ;那么选择分区的逻辑是在所有分区中随机选择。 ②. 可用分区=1; 那么直接选择这个分区。 ③. 可用分区>1 ; 那么在所有可用分区中随机选择。 当选择下一个粘性分区的时候,不是按照分区平均的原则来分配。而是随机原则(当然不能跟上一次的分区相同) 例如刚刚发送到的Batch是 1号分区,等Batch满了,发送之后,新的消息可能会发到2或者3, 如果选择的是2,等2的Batch满了之后,下一次选择的Batch仍旧可能是1,而不是说为了平均,选择3分区。 2.UniformStickyPartitioner 纯粹的粘性分区策略 全路径类名:org.apache.kafka.clients.producer.internals.UniformStickyPartitioner 他跟DefaultPartitioner分区策略的唯一区别就是。 DefaultPartitionerd 如果有key的话,那么它是按照key来决定分区的,这个时候并不会使用粘性分区 UniformStickyPartitioner 是不管你有没有key, 统一都用粘性分区来分配。 3. RoundRobinPartitioner 分区策略 全路径类名:org.apache.kafka.clients.producer.internals.RoundRobinPartitioner 如果消息中指定了分区,则使用它 将消息平均的分配到每个分区中。 与key无关 @Override public int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) { List<PartitionInfo> partitions = cluster.partitionsForTopic(topic); int numPartitions = partitions.size(); int nextValue = nextValue(topic); List<PartitionInfo> availablePartitions = cluster.availablePartitionsForTopic(topic); if (!availablePartitions.isEmpty()) { int part = Utils.toPositive(nextValue) % availablePartitions.size(); return availablePartitions.get(part).partition(); } else { // no partitions are available, give a non-available partition return Utils.toPositive(nextValue) % numPartitions; } } 上面是具体代码。有个地方需要注意; 当可用分区是0的话,那么就是遍历的是所有分区中的。 当有可用分区的话,那么遍历的是所有可用分区的。 点击关注,第一时间了解华为云新鲜技术~
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册