首页 文章 精选 留言 我的

精选列表

搜索[AI可见性],共10000篇文章
优秀的个人博客,低调大师

loveqq 框架新增 ApplicationScope,IOC 全量容器刷新也可保持单例

是什么? ApplicationScope 作用域是什么? ApplicationScope 是 loveqq-framework 新增的一种 bean 的作用域,它的作用是保证 IOC 容器全量刷新时,仍然能够保持单例。 loveqq-framework 已支持的作用域有: 单例:IOC 容器全量刷新时会重建,IOC 全量刷新即应用启动后,多次调用 ApplicationContext#refresh() 方法 原型:每次获取都是新的实例 线程:同一个线程内,是同一个实例,线程终结后自动销毁 bean 应用:即使IOC 容器全量刷新,也保持同一个单例 为什么? 为什么需要 ApplicationScope? 因为 loveqq-framework 支持 IOC 容器的全量刷新,全量刷新时,所有 bean 都会销毁并重建。 基于这个机制,可以实现插件化开发,即通过 http 上传插件 jar 包,即可实时的加载新功能,可以点击参考这里 所有 bean,自然也包括一些重量级的 bean,比如 WebServer,虽然重新启动一个 WebServer 很快,但也会造成毫秒级别不可用的问题。因此设计了 ApplicationScope,标记 WebServer bean,从而保证真正的不停机热部署实时刷新。 不重建又想刷新怎么办? 还是以 WebServer 为例,当 IOC 全量刷新时,有可能新增控制器方法,此时如果不更新 WebServer 的话,直接访问会报 404,这怎么搞? 答案是:实现ScopeRefreshed 接口,实现了该接口的 bean,当对应的作用域刷新时,将不会销毁重建,而是回调该接口,由开发者自己决定如何刷新!实际案例可以点击参考这里 感兴趣的同学可以看一下

优秀的个人博客,低调大师

腾讯公布大语言模型训练专利:可提高模型的准确性

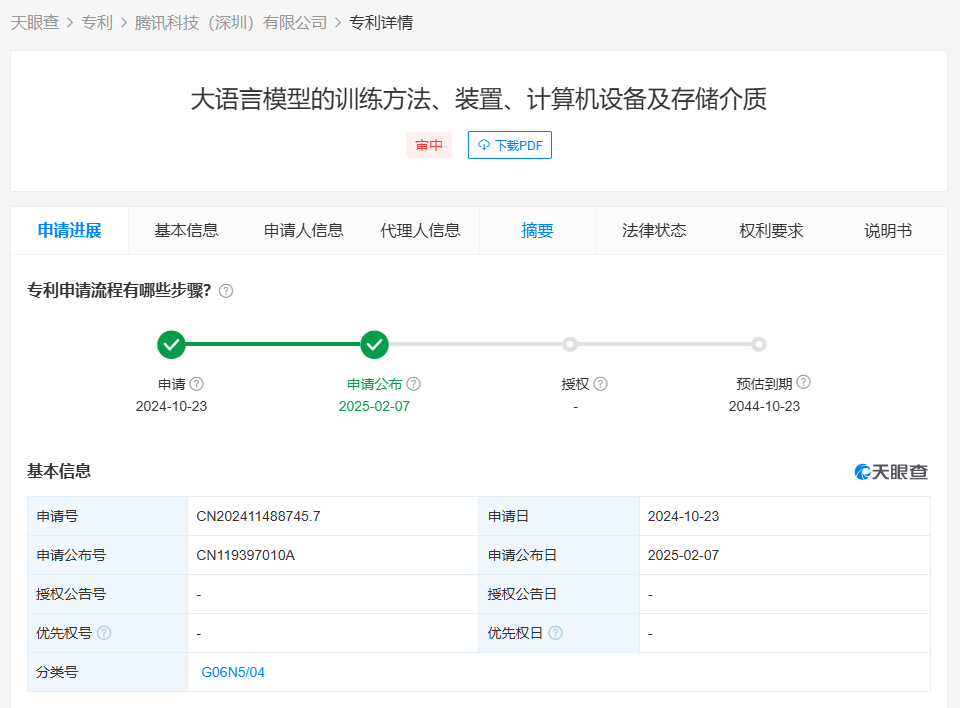
天眼查App显示,腾讯科技(深圳)有限公司申请的“大语言模型的训练方法、装置、计算机设备及存储介质”专利正式公布。 摘要显示,在该方法中,通过在大语言模型的训练过程中引入第一摘要文本和第二摘要文本,为模型训练提供了更多可学习信息,同时由于第一摘要文本和第二摘要文本包含的信息量不同,且第一摘要文本中包含正确语句和错误语句,通过对同一样本文本的两个不同摘要文本进行对比学习,并区分学习第一摘要文本中的正确语句和错误语句,避免了由于摘要文本单一而导致的模型过拟合和生成不准确等问题,不仅提高了模型的泛化性能,还提高了模型的准确性。 有媒体分析称,腾讯的专利通过多样化摘要文本及对比机制,为模型提供了更贴近真实应用的学习环境,尤其对智能客服、内容生成等需高精度输出的领域具有直接意义。此外,该技术或能加速大模型落地进程。例如,在短文本对话场景中,腾讯曾推出基于混合注意力机制的对话模型专利,若结合新训练方法,有望进一步提升回复的相关性与丰富性。

优秀的个人博客,低调大师

StarCoder2-Instruct: 完全透明和可自我对齐的代码生成

指令微调 是一种技术,它能让大语言模型 (LLMs) 更好地理解和遵循人类的指令。但是,在编程任务中,大多数模型的微调都是基于人类编写的指令 (这需要很高的成本) 或者是由大型专有 LLMs 生成的指令 (可能不允许使用)。我们推出了一个叫做 StarCoder2-15B-Instruct-v0.1 的模型,这是第一个完全自我对齐的大型代码模型,它是通过一个完全开放和透明的流程进行训练的。我们的开源流程使用 StarCoder2-15B 生成了成千上万的指令-响应对,然后用这些对来微调 StarCoder-15B 本身,而不需要任何人类的注释或者从大型专有 LLMs 中提取的数据。 StarCoder2-15B-Instruct-v0.1 https://hf.co/bigcode/starcoder2-15b-instruct-v0.1 StarCoder2-15B-Instruct 在 HumanEval 上的得分是 72.6,甚至超过了 CodeLlama-70B-Instruct 的 72.0 分! 在 LiveCodeBench 上的进一步评估表明,自我对齐的模型甚至比在从 GPT-4 提炼的数据上训练的同一模型表现得更好,这意味着 LLM 可能能从自己分布内的数据中更有效地学习,而不是从教师 LLM 的偏移分布中学习。 理论 我们的数据生成流程主要包括三个步骤: 从 The Stack v1 中提取高质量和多样化的种子函数。The Stack v1 是一个拥有大量允许使用许可的源代码的大型语料库。 创建包含种子函数中不同代码概念的多样化且现实的代码指令 (例如,数据反序列化、列表连接和递归)。 对每个指令,通过执行引导的自我验证生成高质量的响应。 The Stack v1 https://hf.co/datasets/bigcode/the-stack 在接下来的部分中,我们将详细探讨这些方面的内容。 收集种子代码片段 为了充分解锁代码模型的遵循指令能力,它应该接触到涵盖广泛编程原则和实践的多样化指令集。受到 OSS-Instruct 的启发,我们通过从开源代码片段中挖掘代码概念来进一步推动这种多样性,特别是来自 The Stack V1 的格式良好的 Python 种子函数。 OSS-Instruct https://github.com/ise-uiuc/magicoder 对于我们的种子数据集,我们仔细提取了 The Stack V1 中所有带有文档字符串的 Python 函数,使用 autoimport 推断所需的依赖关系,并在所有函数上应用以下过滤规则: autoimport https://lyz-code.github.io/autoimport/ 类型检查: 我们应用 Pyright 启发式类型检查器来移除所有产生静态错误的函数,这可能是错误的信号。 去污处理: 我们检测并移除我们评估的所有基准项。我们同时在解决方案和提示上使用精确字符串匹配。 文档字符串质量过滤: 我们使用 StarCoder2-15B 作为评判来移除文档质量差的函数。我们给基础模型提供 7 个少样本示例,要求它用“是”或“否”来回应是否保留该条目。 近似去重: 我们使用 MinHash 和局部敏感哈希,设置 Jaccard 相似性阈值为 0.5,以过滤数据集中的重复种子函数。这是应用于 StarCoder 训练数据的 相同过程。 Pyright https://github.com/microsoft/pyright 相同过程 https://hf.co/blog/dedup 这个过滤流程从带有文档字符串的 500 万个函数中筛选出了 25 万个 Python 函数的数据集。这个过程在很大程度上受到了 MultiPL-T 中使用的数据收集流程的启发。 MultiPL-T https://hf.co/datasets/nuprl/MultiPL-T Self-OSS-Instruct 在收集了种子函数之后,我们使用 Self-OSS-Instruct 生成多样化的指令。具体来说,我们采用上下文学习的方式,让基础 StarCoder2-15B 模型从给定的种子代码片段中自我生成指令。这个过程使用了 16 个精心设计的少样本示例,每个示例的格式为*(代码片段,概念,指令)*。指令生成过程分为两个步骤: 概念提取: 对于每个种子函数,StarCoder2-15B 被提示生成一个存在于函数中的代码概念列表。代码概念指的是编程中使用的基础原则和技术,例如 模式匹配 和 数据类型转换 ,这些对开发者掌握至关重要。 指令生成: 然后提示 StarCoder2-15B 自我生成一个包含已识别代码概念的编程任务。 最终,这个过程生成了 23.8 万条指令。 响应自我验证 我们已经有了 Self-OSS-Instruct 生成的指令,我们的下一步是将每条指令与高质量的响应相匹配。先前的实践通常依赖于从更强大的教师模型 (如 GPT-4) 中提炼响应,这些模型有望展现出更高的质量。然而,提炼专有模型会导致非许可的许可问题,而且更强大的教师模型可能并不总是可用的。更重要的是,教师模型也可能出错,而且教师和学生之间的分布差距可能是有害的。 我们提议通过显式指示 StarCoder2-15B 在生成交织自然语言的响应后生成测试来进行自我验证,这个过程类似于开发者测试他们的代码实现。具体来说,对于每条指令,StarCoder2-15B 生成 10 个*(自然语言响应,测试)*格式的样本,我们在沙箱环境中执行测试以过滤掉那些被测试证伪的样本。然后我们为每个指令随机选择一个通过的响应作为最终的 SFT 数据集。总共,我们为 23.8 万条指令生成了 240 万 (10 x 23.8 万) 个响应,其中 50 万个通过了执行测试。去重后,我们剩下 5 万条指令,每条指令配有一个随机通过的响应,最终我们将其用作我们的 SFT 数据集。 评估 在流行且严格的 EvalPlus 基准测试中,StarCoder2-15B-Instruct 在其规模上作为表现最佳的拥有许可的 LLM 脱颖而出,超过了更大的 Grok-1 Command-R+ 和 DBRX,与 Snowflake Arctic 480B 和 Mixtral-8x22B-Instruct 相近。据我们所知,StarCoder2-15B-Instruct 是第一个具有完全透明和许可流程,达到 70+ HumanEval 分数的代码 LLM。它大大超过了之前的最佳透明许可代码 LLM OctoCoder。 EvalPlus https://github.com/evalplus/evalplus 即使与具有限制性许可的强大 LLM 相比,StarCoder2-15B-Instruct 仍然具有竞争力,超过了 Gemini Pro 和 Mistral Large,与 CodeLlama-70B-Instruct 相当。此外,仅在自我生成数据上训练的 StarCoder2-15B-Instruct 与在 GPT-3.5/4 提炼数据上微调 StarCoder2-15B 的 OpenCodeInterpreter-SC2-15B 非常接近。 除了 EvalPlus,我们还对具有相似或更小规模的最新开源模型在 LiveCodeBench 上进行了评估,LiveCodeBench 包括 2023 年 9 月 1 日之后创建的新编程问题,以及针对数据科学程序的 DS-1000。在 LiveCodeBench 上,StarCoder2-15B-Instruct 在评估的模型中取得了最佳结果,并且一致优于从 GPT-4 数据中提炼的 OpenCodeInterpreter-SC2-15B。在 DS-1000 上,尽管 StarCoder2-15B-Instruct 只在非常有限的数据科学问题上进行了训练,但它仍然具有竞争力。 LiveCodeBench https://livecodebench.github.io DS-1000 https://ds1000-code-gen.github.io 结论 StarCoder2-15B-Instruct-v0.1 首次展示了我们可以在不依赖像 GPT-4 这样的更强大的教师模型的情况下,创建出强大的指令微调代码模型。这个模型证明了自我对齐——即模型使用自己生成的内容来学习——对于代码也是有效的。它是完全透明的,并允许进行提炼,这使得它与其它更大规模但非透明的许可模型如 Snowflake-Arctic、Grok-1、Mixtral-8x22B、DBRX 和 CommandR+ 区别开来。我们已经将我们的数据集和整个流程,包括数据整理和训练,完全开源。我们希望这项开创性的工作能够激发该领域更多的未来研究和开发。 资源 StarCoder2-15B-Instruct-v0.1: 指令微调模型 https://hf.co/bigcode/starcoder2-15b-instruct-v0.1 starcoder2-self-align: 自我对齐流程 https://github.com/bigcode-project/starcoder2-self-align StarCoder2-Self-OSS-Instruct: 自我生成的、用于指令微调的数据集 https://hf.co/datasets/bigcode/self-oss-instruct-sc2-exec-filter-50k/ 英文原文: https://hf.co/blog/sc2-instruct 原文作者: Yuxiang Wei, Federico Cassano, Jiawei Liu, Yifeng Ding, Naman Jain, Harm de Vries, Leandro von Werra, Arjun Guha, Lingming Zhang 译者: innovation64 本文分享自微信公众号 - Hugging Face(gh_504339124f0f)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

VersionFox 0.2.3 发布:强大且可拓展的 SDK 版本管理工具!

项目地址:https://github.com/version-fox/vfox 该版本是一次重大更新,相较于之前版本插件只能分发预先编译好的二进制文件, 此次更新真正做到插件完全自定义,如支持Python这类需要自定义编译和安装的SDK。 另外允许自定义存储路径, 避免$HOME占用过大! 更新内容: 功能: 支持自定义存储路径 by@aooohanand@XuZheCheung627330f 功能: 允许插件安装本地文件 by@aooohanin8888f41 功能: 添加验证插件支持的最低运行时版本的新机制 by@aooohanin0bc5b1d 功能:http插件模块 支持 HEAD 请求 by@aooohanin2a4fc77 修复: mac arm64 安装问题 by@ankit-pnin#34 修复: 别名导致不生效问题 by@aooohanin1987a2a 修复: Windows环境下默认作用域不生效问题 by@aooohanin32421d1 新增插件: Python 插件 by@aooohanversion-fox/version-fox-plugins#10 Python Npmmirror镜像插件 by@aooohanversion-fox/version-fox-plugins#12 Nodejs Npmmirror镜像插件 by@yimiaoxiehouversion-fox/version-fox-plugins#9 Zulu JDK 插件 by@yimiaoxiehouversion-fox/version-fox-plugins#11 新贡献者: @ankit-pnmade their first contribution in#34 @yimiaoxiehoumade their first contribution inversion-fox/version-fox-plugins#8 Full Changelog:v0.2.2...v0.2.3 已支持插件: Name Version Author Description dart/dart 0.0.1 Aooohan dart plugin, support for getting stable, dev, beta version deno/deno 0.0.1 Aooohan Deno plugin,https://deno.com/ dotnet/dotnet 0.0.1 Korbinian Habereder dotnet plugin, support for dotnet sdks 6.0, 7.0, 8.0 flutter/flutter-cn 0.0.1 Aooohan flutter plugin for China, support for getting stable, dev, beta version flutter/flutter 0.0.2 Aooohan flutter plugin, support for getting stable, dev, beta version golang/golang 0.0.2 Aooohan java/adoptium-jdk 0.0.1 aooohan Adoptium JDK java/azul-jdk 0.0.1 yimiaoxiehou Azul JDK, also known as Zulu maven/maven 0.0.1 Aooohan nodejs/nodejs 0.0.3 Aooohan Node.js nodejs/npmmirror 0.0.1 yimiaoxiehou install Node.js usehttps://cdn.npmmirror.com python/npmmirror 0.0.1 aooohan vfox >= 0.2.3 !!! From npmmirror.org. For Windows, only support >=3.5.0, but no restrictions for unix-like python/python 0.0.1 aooohan vfox >= 0.2.3 !! For Windows, only support >=3.5.0, but no restrictions for unix-like zig/zig 0.0.3 aooohan Zig 快速开始 每种编程语言都有对应的版本管理工具,如 nvm、fvm、gvm、sdkman 等,它们的核心功能大同小异。但对于使用多种语言的开发者来说,这意味着需要学习和记忆各种不同的命令,增加了学习成本。如果你是全栈工程师,或者使用不止一种语言,使用VersionFox,你无需再学习这些繁杂的工具,从而降低学习成本,节省时间。 亮点: 跨平台 (Windows、Linux、macOS), 不同的平台拥有相同的用户体验 使用一致的命令管理所有语言 简单的插件系统添加对您所需 SDK 的支持 支持 Global、Project、Session 三种作用域 切换项目时,自动切换到对应版本 快速入门 安装 vfox (详细安装) $ brew tap version-fox/tap $ brew install vfox 选择一条适合你 shell 的命令 echo 'eval "$(vfox activate bash)"' >> ~/.bashrc echo 'eval "$(vfox activate zsh)"' >> ~/.zshrc echo 'vfox activate fish | source' >> ~/.config/fish/config.fish # For PowerShell, add the following line to your $PROFILE: Invoke-Expression "$(vfox activate pwsh)" 3. 添加插件 $ vfox add nodejs/nodejs 4. 安装版本 vfox install nodejs@latest 5. 切换版本 $ vfox use nodejs@21.5.0 $ node -v 21.5.0 目前已支持多种开发语言,欢迎使用~~ 作用域演示 Project 作用域 Session 作用域 Node 完整演示 项目地址:https://github.com/version-fox/vfox

优秀的个人博客,低调大师

VersionFox 0.2.2 发布:跨平台、可拓展的 SDK 版本管理工具

项目地址:https://github.com/version-fox/vfox 当前版本最重要的变化是使用插件里指定的名称作为 sdk 名称,而不是使用插件的文件名作为 sdk 名称。此外,我们还引入了代理支持,使用户能够配置代理来路由 vfox 的请求。 更新内容: 功能: 支持配置代理#4by@XuZheCheungin#27 修复: 使用插件里指定名称作为SDK名称 by@aooohaninb221f57 修复: 清理今天之前的所有临时文件 by@aooohaninc738772 插件: 支持Flutter CN镜像 by@aooohaninversion-fox/version-fox-plugins#5 插件: 支持.Net by@liquidiertinversion-fox/version-fox-plugins#6 每种编程语言都有对应的版本管理工具,如 nvm、fvm、gvm、sdkman 等,它们的核心功能大同小异。但对于使用多种语言的开发者来说,这意味着需要学习和记忆各种不同的命令,增加了学习成本。如果你是全栈工程师,或者使用不止一种语言,使用VersionFox,你无需再学习这些繁杂的工具,从而降低学习成本,节省时间。 亮点: 跨平台 (Windows、Linux、macOS), 不同的平台拥有相同的用户体验 使用一致的命令管理所有语言 简单的插件系统添加对您所需 SDK 的支持 支持 Global、Project、Session 三种作用域 切换项目时,自动切换到对应版本 快速入门 安装 vfox (详细安装) $ brew tap version-fox/tap $ brew install vfox 选择一条适合你 shell 的命令 echo 'eval "$(vfox activate bash)"' >> ~/.bashrc echo 'eval "$(vfox activate zsh)"' >> ~/.zshrc echo 'vfox activate fish | source' >> ~/.config/fish/config.fish # For PowerShell, add the following line to your $PROFILE: Invoke-Expression "$(vfox activate pwsh)" 3. 添加插件 $ vfox add nodejs/nodejs 4. 安装版本 vfox install nodejs@latest 5. 切换版本 $ vfox use nodejs@21.5.0 $ node -v 21.5.0 目前已支持多种开发语言,欢迎使用~~ 作用域演示 Project作用域 Session作用域 Node 完整演示 项目地址:https://github.com/version-fox/vfox

优秀的个人博客,低调大师

WinRAR 修复高危漏洞,可导致打开压缩文件时执行任意代码

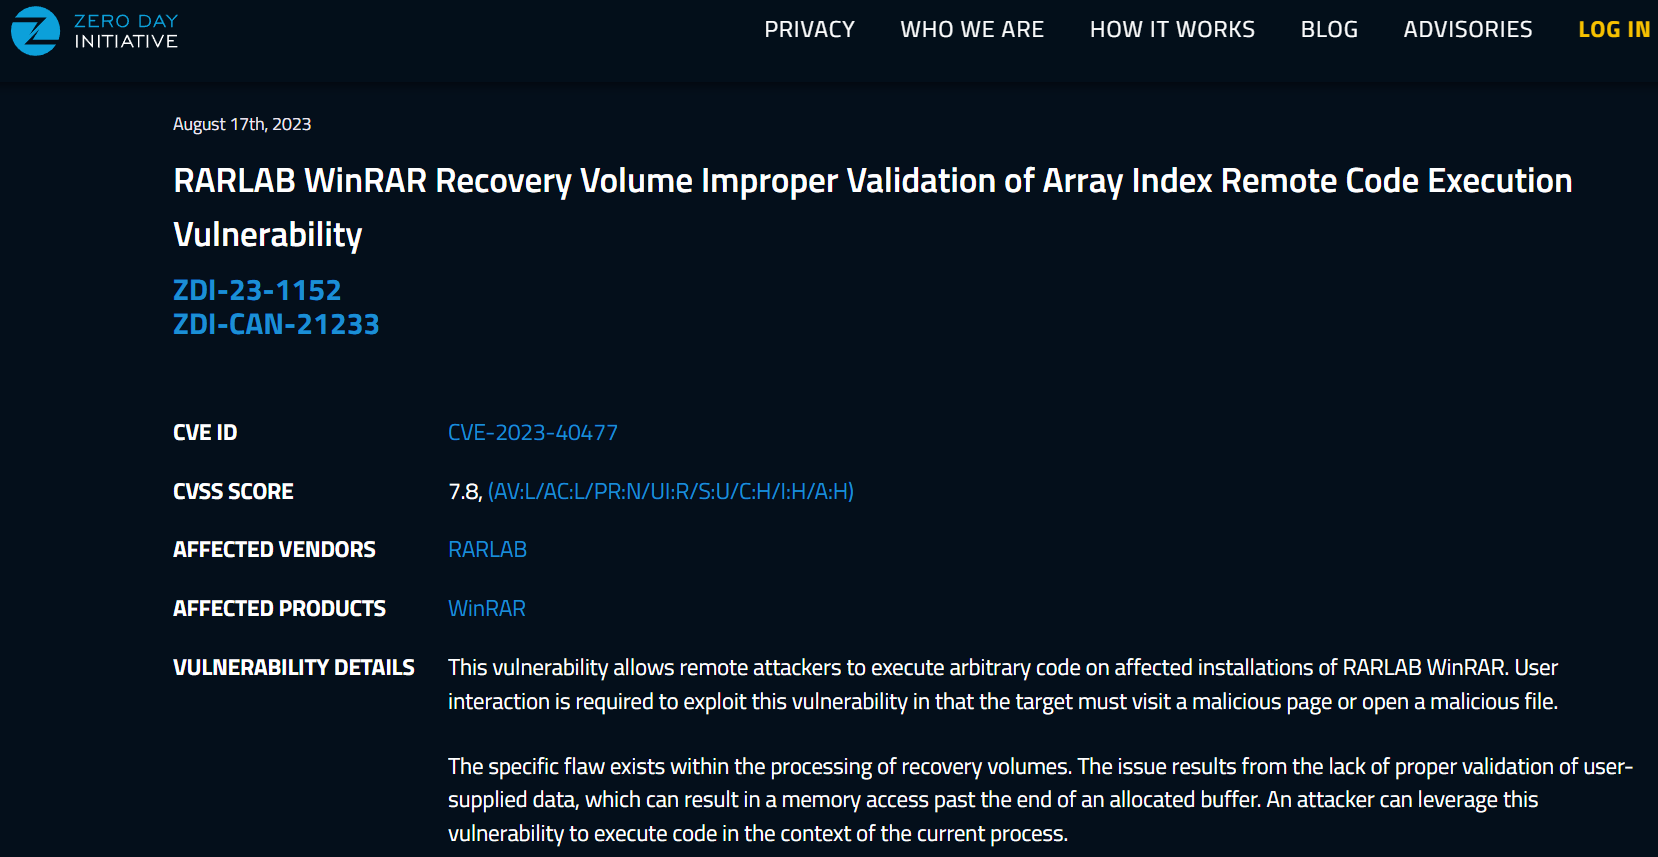
8 月 17 日,Zero Day Initiative 网站上披露了一项针对 WinRAR 的 0day 漏洞 (CVE-2023-40477)。该漏洞允许远程攻击者通过诱导受害者打开特制的恶意 RAR 压缩文件去执行任意代码。 由于此漏洞需要欺骗用户以进行交互,因此危险等级评分略低为 7.8/10。 该漏洞由 Zero Day Initiative 研究员 goodbyeselene 发现,2023 年 6 月 8 日报告给开发商 RARLAB,漏洞存在于恢复卷处理过程中,可能允许额外的内存访问,因未能正确验证用户提供的数据而导致。 RARLAB 在 8 月 2 日发布 WinRAR v6.23修复了该漏洞,建议 WinRAR 用户尽快升级。WinRAR v6.23 还修复了另一个会导致错误文件初始化的漏洞。

优秀的个人博客,低调大师

英特尔开源新等宽字体,称可保护开发者视力

英特尔开源了一款面向开发者的新等宽字体“Intel One Mono ”,这是一种富有表现力的等宽字体系列,集清晰度、易读性和开发者视力保护于一体。 Intel One Mono 字体涵盖了 200 多种使用拉丁文字的语言,提供四种粗细 —— Light、Regular、Medium 和 Bold,并带有默认的斜体。 该系列字体由Frere-Jones Type 、英特尔品牌团队和 VMLY&R 合作开发,在构建时充分考虑到了清晰度、易读性和开发者的视觉疲劳和眼睛疲劳问题。 除了字体本身,还有另一个重要的群体参与了这个字形的设计:低视力和法定盲人开发者,他们在在设计的每个阶段都会提供反馈。英特尔表示,在低视力者的帮助测试下, Intel One Mono 在阅读和输入代码的时候视觉更放松,有助于减轻眼睛疲劳,并可能减轻疲劳。 Intel One Mono 于 4 月底发布了最初的“v1.0”版本,而最新版本是 Intel One Mono v1.2 ,解决了在 Visual Studio Code 上使用时发现的兼容问题。 目前Intel One Mono 可在Intel GitHub 仓库下载,除了源代码之外,下载还包括易于使用的 OTF / WOFF / TTF 字体文件。

优秀的个人博客,低调大师

用这个方法计算开源开发者的贡献,你觉得可吗?

编者按: 长久以来,个人开发者在开源社区中的贡献都是在被一把无形的尺粗略衡量,比如模糊的个人知名度、信服力等等,又或是开源社区赋予的 Maintainer、Committer 等称谓。与此相对应的是,个人开发者如何从开源贡献中获得收益、如何准确评估这份收益等问题,迟迟没有一个可以量化的衡量指标。 为了能更准确地评价开源项目内的个人贡献度和影响力,X-lab 开放实验室赵生宇尝试建立一套具体的度量体系,通过构建一个开源项目内的协作网路,去衡量开发者的贡献。赵生宇认为,贡献评价也是对开源精神很好的补充与支持,同时,付出与回报的匹配,对开源协作的持久性、开源社区的规模化发展,也都是有益处的。 在文末,赵生宇也邀请大家参与一个简单的投票调查,希望大家可以留下自己的选择和看法。 嘉宾:赵生宇X-lab 开放实验室核心成员 OSCHINA:为什么想到要建立一套度量体系,去评价开源项目内的个人贡献度? 赵生宇:在过去数十年中,开源对于软件行业,尤其是对于基础软件带来了巨大改变,极大程度上促进了软件行业的发展。而与其形成强烈对比的则是开源软件的作者无法从自己创造的价值中获利,甚至难以维持生计。 我虽然之前提到开源作为一种大规模的协作方式,需要有完整的价值闭环才能持续健康的发展,并且也喊出了「在开放协作的世界里,每一份贡献都值得回报!」的价值口号,但即使解决了开源项目本身的商业化和盈利问题,如何将这部分利益再有效的分配到具体的开发者手中依然是个难题。 事实上,开源世界中生产力高度自由流动,与依赖传统公司雇佣形式的生产关系之间的矛盾,已经日益凸显,对于社区中流动开发者的贡献如何量化,是解决开源价值分配中最为重要的一环。 虽然企业内的贡献中,大部分的分析方法会使用代码变更或类似工单计件的方式来统计贡献量,但我还是希望可以挖掘开源中社交开发的特点,利用协作关系来构建一个更加科学有效的度量方法,从而可以更好的解决开源中价值分配的问题。 OSCHINA:我们目前看到的项目中开发者的贡献评价基本上是通过开发者的Issue、PR 数量或提交代码行数来统计得到的,如何理解“利用协作关系来构建一个更加有效的度量方法”呢? 赵生宇: 那我们就以搜索引擎为例,讲一下网页排序的计算方法。其实最早的搜索引擎中,大家会使用网页的内容作为网页排名的依据,这样虽然搜索的相关性很好,但网页的质量排序依然是个难题。谷歌的 PageRank 算法利用网页之间的外链关系来评价网页的质量,基本的假设是高质量的页面更容易被其他高质量的页面所引用,这个算法在不需要关注网页内容本身的情况下,为网页质量排序带来一个高效而优质的解决方案。 而协作网络也是类似,其实我的基本假设是高影响力的开发者更容易吸引其他高影响力的开发者与其进行协作,例如在同一个 Issue 上深度交流或在 PR 上就代码细节进行讨论等。 在全域协作网络中,我们以项目与开发者为节点,以活跃度为边构建了一个庞大的协作网络,事实上其含义就是以项目作为开发者的协作单元,即在同一个项目上活跃就看做是一种协作。 在项目内部,最直观的就是使用 Issue 和 PR 作为基本的协作单元,在同一个 Issue 或 PR 进行的讨论就被看成是一种协作。因此我们就得到了如下一个项目内的协作网络图: 由此就构建出了一个开源项目内的精细化协作网络,之后使用 OpenRank 算法就可以计算出每个开发者、每个 Issue 和 PR 的价值了。与 PageRank 类似,我们不需要关注具体的 Issue 和 PR 中每次讨论和代码提交的内容,而通过开发者之间的协作关系就可以计算出一个开发者的影响力。 但与 PageRank 不同的是,我们不仅仅考虑关系信息,而且 Issue 和 PR 也是具有初始价值的,这个价值对于修正和精细化评判开发者的贡献具有重要的作用。 OSCHINA:Issue 与 PR 的初始价值是如何确定的呢? 赵生宇:Issue 与 PR 的初始价值计算需要重点说明,因为某个具体的项目中,与全域项目不同,我们可以通过制定社区的规则,使社区中的成员可以常态化的表达更多的价值倾向,从而帮助我们更好的评判每个节点的价值。 在 Issue 与 PR 的初始价值计算中,我们使用了低成本的 GitHub reactions 来进行,即所有开发者都可以对 Issue 和 PR 进行 reactions 评价,如👍 2 倍、❤️ 3 倍、🚀 4 倍,所以如果一个开发者使用了三个 reactions 进行评价,则最多可以把一个 Issue 或 PR 的基础倍率提高到默认的 9 倍。 但这里我们对不同开发者做出的评价权重是不同的,一个开发者的评价倍率对最终倍率的影响与其在项目中的上个月的影响力有关。如一个开发者在上个月的影响力占比是 20%,那么如果他对一个 Issue 给出了 9 倍倍率的评价,但仅有他给出了评价,则最终这个 Issue 的基础倍率将是0.2∗9+(1−0.2)=2.6。因此 9 倍看上去是一个非常高的倍率,但其实个别账号的高评价并不会带来非常大的影响。 也就是说这是一种去中心化的评价体系,每个开发者如果想要自己的评价更有意义,就需要自己在项目中的影响力更大才行,如果一个对项目完全没有贡献的开发者,他的 reactions 评价则完全不影响结果。 所以可以认为这是一种专家经验,只是这里的专家必须是对项目有深度贡献的人。 OSCHINA:开发者可以如何参考这套评价体系来提升自己的影响力?会不会出现为了提升个人影响力而刷Issue, PR数量的情况呢? 赵生宇:正如管理学中的一句话:“你考核什么,就会得到什么”,那么在上述的数学模型和计算方法下,如果一个开发者想要在社区中获得更高的影响力,他应该做什么呢,以及这些行为会对社区后续带来什么变化呢? 提升与社区中影响力较高开发者的协作频次 由于协作网络是构建在 Issue 和 PR 等协作单元之上的,因此最简单的一种策略就是要提升与社区中影响力较高的开发者的协作频次。 刚刚进入社区的开发者,最简单的方式就是在社区高影响力开发者的 Issue 或 PR 中进行交互,无论是进行讨论或者去 Review 他们的代码提出一些问题都是可以的。 对项目已经有一些了解的开发者,则更好的策略是通过自己高质量的 Issue 和 PR 来吸引核心的开发者与自己进行协作,例如参与自己提出的问题的讨论,或来 Review 自己提的 PR 等。所以这里就已经对开发者有一些价值引导了,即需要想办法与社区中的核心开发者交流协作,而不是自己一味的提低质量的 Issue 或 PR,若没有人愿意与你讨论,则你的影响力依然是很难提升的。 对于项目中的核心开发者,其策略其实是要与更多的开发者产生协作关系,即尽可能去与其他的开发者进行交流与协作来巩固自己的核心位置。 提升自己在社区中的贡献质量 上一项是鼓励协作的频次,但这一项则更加强调贡献的质量。由于 Issue 和 PR 具有初始价值,而这个初始价值其实对于提升开发者的影响力非常重要。 那么如果一个开发者希望社区中的核心开发者来给自己的 Issue 和 PR 点赞,从而获取更高的初始价值,那么他们就要想办法去提高自己贡献的质量,来赢得其他开发者的认可。 事实上,在真正落地运作时,我们会发现这个价值引导会带来额外的好处,那就是常态化的相互点赞,可以很好的活跃社区的氛围。毕竟很多时候并没有那么多严肃的讨论可以进行,这种点赞在评价的同时,也变成了一种社交手段,使得在较严肃的开发环境中,社区中开发者之间有了更融洽的氛围,这种潜移默化的变化对我来说是一个惊喜。 尽可能长期参与贡献 在该算法中,任何刚刚进入社区的开发者的初始影响力均为 1,这意味着开发者如果仅有短期的贡献,一定很难上升到一定的高度,而由于每个月都会继承上个月的影响力作为初始值,那么长期贡献基本意味着影响力的长期增长。 而一旦贡献中断,则影响力会以 85% 的速度逐渐衰减,其实这里之所以选择 85% 这样一个并不高的比例,而不是直接清零,就是防止贡献者因为偶然中断的贡献而流失。85% 的速度意味着 4 个月停止贡献依然保留超过原始 50% 的影响力,而一年不贡献还保有 15% 的影响力。则开发者随时回到社区时,就可以快速续接之前的影响力,不会需要从头再来。 其他风险 其实对于任何的算法,都无法完全避免刷榜,事实上如果一个开发者通过大量提交无意义的 Issue 或 PR,也可以短期小幅提升自己在项目内的影响力数值,但显然这是对项目无益的。 所以这套算法本身不是要完全替代维护者来评判开发者的贡献度,而是一个参考与引导,如果出现破坏性的行为,我们可以通过社区规范来屏蔽甚至驱逐那些投机型的开发者。 其实信任是低成本高效协作的基础,而在数据越来越完善和开放的未来,个人信用也必将越来越重要,投机型的开发者不仅无法在一个项目中短期受益,甚至可能会严重危害他个人的长期发展,这是制度设计需要考量的事情,在这里其实我们可以大量借鉴已有的一些社会制度的设计原则。 OSCHINA:目前这套算法机制有没有在哪些开源社区落地呢?对社区和开发者带来了什么变化? 赵生宇:自己的狗粮肯定要自己先吃,事实上我们这套方案已经在 X-lab 开放实验室落地有半年左右的时间了,我们尽量将实验室的工作都线上化,沉淀在 GitHub 平台上,然后通过这套算法来评判同学们在实验室项目中的贡献情况并提供每月的额外补助。 从实验室所有项目的全域影响力来看,整体提升还是比较明显的,每月都有稳定的增长。而从我自己主要负责的项目上来看,同学们的参与热情还是有了较大的提升,而且由于算法本身的特性,没有来刷 Issue 的同学,而是多了几个长期深度参与到项目中的同学。 X-lab 开放实验室创始人王伟老师也总结道:“这段时间的运转甚至使得 X-lab 开放实验室的的社区文化也发生了一些潜移默化的变化:大家更愿意将自己的工作用 GitHub 的开放协作模式来运营了,例如论文阅读与分享;更愿意参与项目的讨论以及表情点赞了,甚至很多时候都是秒赞;更愿意拉一些其它同学一起来讨论与协作了,包括主动告诉大家发布了一个新功能或修了一个新 Bug;更主动为自己参与的项目打广告与宣传了,发展新的参与者。大家的成长是看得见的!” 另外,我们也和一些外部社区有深度合作,Sealos 社区也基于我们这套算法来做社区中的外部开发者回馈,据反馈效果也是相当不错的,外部贡献比例一直在稳步上升,而且也培养出了多个外部的长期贡献者。 所以从目前来看,我对这个算法未来的应用前景还是非常有信心的,但可能需要在更多的场景中落地来观察效果。 OSCHINA:用一套具体的数据和框架去评价开发者贡献,这是否和我们所提倡的 Geek、共享的开源精神所悖? 赵生宇:我认为贡献评价是对开源精神很好的补充与支持,不会和Geek、共享的开源精神所悖。 开源精神强调共享与奉献,但经济系统的有效性则来自于付出与回报的匹配。可能早期的 Geek 可以不计回报的开源出优秀的项目,或者将名誉上的收益看做是一种回报,但当开源作为一种开放协作的模式被大规模的推广,且开源软件伴随云等模式开始释放出巨大价值时,我们必须考虑到其长期发展中需要解决的问题。 OpenRank 的核心思想与传统的软件数据分析不同,并不强调数学模型和统计特性,而是更多的考虑协作中的社交属性,这与开源的开放协作模式也是高度匹配的。 我相信在付出与回报可以更好的统一和协调的未来,开源必将以更大的协作规模对世界带来不可估量的改变。 互动问答:如果你参与的开源社区使用该算法公开贡献者的排名,你会支持吗? 欢迎在评论区说出答案,我们会随机揪出 3 位小伙伴赠送精美福袋一份!

优秀的个人博客,低调大师

Neovim 0.7 即将发布,基于 Vim 的可扩展文本编辑器

Neovim 0.7 目前正处于稳定化阶段,预计在 4 月 15 日发布。 主要变化 新增 lua 自动命令 新增 lua keymap API 新增 lua 命令 API 支持全局命名空间 lua 高亮(纯 lua 配色方案) 全局statusline 支持通过nvim_buf_set_extmark设置 signs 提供在映射中从<Tab>区分<C-I>的能力 filetype.lua(用于匹配filetype规则的单个自动命令的更快替代方案) :lua =expr, 尝试:lua ={test = true} 其他更新内容是常见的错误修复、移植 Vim 补丁和改进性能。 Neovim 是 Vim 的一个分支,旨在改进代码库,允许更轻松地实现 API,改善用户体验和插件实现。Neovim 的源代码比 Vim 少 30%。 其目标是: 重构代码以改善维护 实施新的高级功能 展示一个更好、更强大的插件系统 开放的开发模式,随时接受贡献,接受的标准也很明确。 特性: 现代图形用户界面 从任何语言访问API,包括C/C++, C#, Clojure, D, Elixir, Go, Haskell, Java, JavaScript/Node.js, Julia, Lisp, Lua, Perl, Python, Racket, Ruby, Rust 嵌入式、可编写脚本的终端仿真器 异步作业控制 多个编辑器实例之间的共享数据(shada)。 支持XDG基础目录 与大多数Vim插件兼容,包括Ruby和Python插件

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册