首页 文章 精选 留言 我的

精选列表

搜索[TDSQL PostgreSQL 版],共10000篇文章
优秀的个人博客,低调大师

nginx 1.17.7 主线版发布

nginx 1.17.7(mainline version)发布了,此版本主要是修复 bug,变更内容如下: Bugfix:如果在配置中使用了带有空替换字符串的"rewrite"指令,则可能在启动或重新配置期间发生分段错误 Bugfix:如果将"break"指令与"alias"指令或带有 URI 的"proxy_pass"指令一起使用,则可能在 worker 进程中发生分段错误 Bugfix:如果请求 URI 被重写为包含空字符的 URI,则"Location"的响应 header 行可能包含垃圾 Bugfix:使用"error_page"指令返回重定向时,带有正文的请求会被错误处理;该错误在 0.7.12 中出现过 Bugfix:使用 HTTP/2 时出现 socket 泄漏的情况 Bugfix:在 SSL 连接中处理流水线请求时可能会发生超时; 该错误在 1.17.5 中出现过 Bugfix: in the ngx_http_dav_module. 下载地址|更新说明 有关 nginx 版本分支的解释请点此查看。

优秀的个人博客,低调大师

Kafka 消息队列 Java版

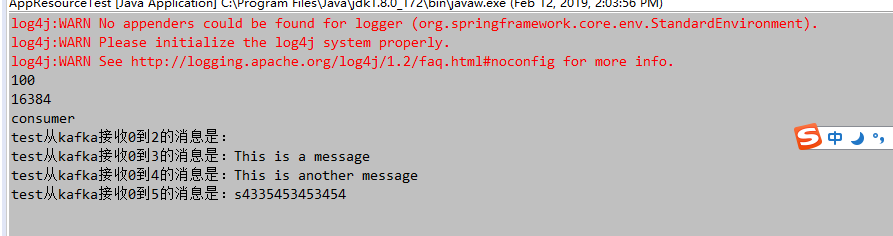
消费者 apache kafka工具类,消费者Consumer类 public class Consumer { private ConsumerHandler handler; private ConsumerConfig config; private KafkaConsumer<String, String> consumer; private boolean startFlag = false; /** * 创建消费者 * * @param handler * 消费者处理类 * @param config * 消费者处理配置 */ public Consumer(ConsumerHandler handler, ConsumerConfig config) { this.handler = handler; this.config = config; init(); } /** * 初始化接收器 */ private void init() { Properties props = new Properties(); props.put("bootstrap.servers", config.getBootstrapServers());// 服务器ip:端口号,集群用逗号分隔 props.put("group.id", config.getGroupID()); /* 是否自动确认offset */ props.put("enable.auto.commit", "true"); /* 自动确认offset的时间间隔 */ props.put("auto.commit.interval.ms", config.getAutoCommitInterVal()); props.put("session.timeout.ms", config.getSessionTimeOut()); /* key的序列化类 */ props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer"); /* value的序列化类 */ props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer"); consumer = new KafkaConsumer<>(props); if (config.isProcessBeforeData()) { /* 消费者订阅的topic, 可同时订阅多个 */ consumer.subscribe(config.getTopicList(), new ConsumerRebalanceListener() { @Override public void onPartitionsRevoked(Collection<TopicPartition> partitions) { } @Override public void onPartitionsAssigned(Collection<TopicPartition> partitions) { for (TopicPartition partition : partitions) { long offset = handler.getSeek(partition.topic(), partition.partition()); if (offset >= 0) { if (consumer != null) { consumer.seek(partition, offset + 1); } } else { consumer.seekToBeginning(partitions); } } } }); start(); } else { consumer.subscribe(config.getTopicList()); } } public void start() { startFlag = true; while (startFlag) { /* 读取数据,读取超时时间为XXms */ ConsumerRecords<String, String> records = consumer.poll(config.getPollTime()); if (records.count() > 0) { long offset = 0; int partition = 0; for (ConsumerRecord<String, String> record : records) { if (record != null) { offset = record.offset(); partition = record.partition(); try { handler.processObject(record.topic(), record.partition(), record.offset(), record.value()); } catch (Exception e) { e.printStackTrace(); } } } } try { Thread.currentThread(); Thread.sleep(1000); } catch (Exception e) { e.printStackTrace(); } } consumer.close(); } public void stop() { startFlag = false; } } 消费者配置ConsumerConfig类 public class ConsumerConfig { private String bootstrapServers; private String groupID; private int autoCommitInterVal =1000; private int sessionTimeOut = 30000; private List<String> topicList; private boolean processBeforeData; private long pollTime = 100; public ConsumerConfig() { super(); } /** * 创建消费者配置 * @param bootstrapServers 服务器配合 格式为服务器ip:端口号,集群用逗号分隔 例如 192.168.1.1:9092,192.168.1.2:9092 * @param groupID groupID * @param autoCommitInterVal 自动提交时间单位毫秒, 默认1000 * @param sessionTimeOut 超时时间单位毫秒 , 默认30000 * @param topicList topicList列表 * @param processBeforeData 是否处理启动之前的数据,该开关需要配置consumerHandler的跨步存储使用 * @param pollTime 每次获取数据等待时间单位毫秒,默认100毫秒 */ public ConsumerConfig(String bootstrapServers, String groupID, int autoCommitInterVal, int sessionTimeOut ,List<String> topicList,boolean processBeforeData,long pollTime) { this.bootstrapServers = bootstrapServers; this.groupID = groupID; this.autoCommitInterVal = autoCommitInterVal; this.sessionTimeOut = sessionTimeOut; this.topicList = topicList; this.processBeforeData = processBeforeData; this.pollTime = pollTime; } public String getBootstrapServers() { return bootstrapServers; } public void setBootstrapServers(String bootstrapServers) { this.bootstrapServers = bootstrapServers; } public String getGroupID() { return groupID; } public void setGroupID(String groupID) { this.groupID = groupID; } public int getAutoCommitInterVal() { return autoCommitInterVal; } public void setAutoCommitInterVal(int autoCommitInterVal) { this.autoCommitInterVal = autoCommitInterVal; } public int getSessionTimeOut() { return sessionTimeOut; } public void setSessionTimeOut(int sessionTimeOut) { this.sessionTimeOut = sessionTimeOut; } public List<String> getTopicList() { return topicList; } public void setTopicList(List<String> topicList) { this.topicList = topicList; } public boolean isProcessBeforeData() { return processBeforeData; } public void setProcessBeforeData(boolean processBeforeData) { this.processBeforeData = processBeforeData; } public long getPollTime() { return pollTime; } public void setPollTime(long pollTime) { this.pollTime = pollTime; } } 消费者处理ConsumerHandler类 public interface ConsumerHandler { /** * 处理收到的消息 * @param topic 收到消息的topic名称 * @param partition 收到消息的partition内容 * @param offset 收到消息在队列中的编号 * @param value 收到的消息 */ void processObject(String topic,int partition,long offset,String value); /** * 获取跨步 * @param topic 接受消息的topic * @param partition 接受消息的partition * @return 当前topic,partition下的seek */ long getSeek(String topic , int partition); } 生产者 kafka生产者,工具Producer类 public class Producer { private ProducerConfig config ; private org.apache.kafka.clients.producer.Producer<String,String> producer; public Producer(ProducerConfig config){ this.config = config; init(); } private void init(){ Properties props = new Properties(); props.put("bootstrap.servers",config.getBootstrapServers()); props.put("acks", "all"); props.put("retries", config.getRetries()); props.put("batch.size", config.getBatchSize()); props.put("linger.ms", config.getLingerMs()); props.put("buffer.memory", config.getBufferMemory()); props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); producer = new KafkaProducer<>(props); } /** * 发送消息 * @param topic 要发送的topic * @param msg */ public void sendMessage(String topic,String msg){ try { producer.send(new ProducerRecord<String, String>(config.getTopic(), String.valueOf(new Date().getTime()), msg)).get(); } catch (InterruptedException e) { // TODO 自动生成的 catch 块 e.printStackTrace(); } catch (ExecutionException e) { // TODO 自动生成的 catch 块 e.printStackTrace(); } producer.flush(); } public void close(){ producer.close(); } } kafka生产者配置ProducerConfig类 public class ProducerConfig { private String bootstrapServers; private String topic; private int retries = 0; private int batchSize = 16384; private int lingerMs=1; private int bufferMemory=33554432; public ProducerConfig() { super(); } /** * 创建生产者配置文件 * @param bootstrapServers 服务器配合 格式为服务器ip:端口号,集群用逗号分隔 例如 192.168.1.1:9092,192.168.1.2:9092 * @param retries * @param batchSize * @param lingerMs * @param bufferMemory */ public ProducerConfig(String bootstrapServers,int retries, int batchSize, int lingerMs, int bufferMemory) { this.bootstrapServers = bootstrapServers; this.retries = retries; this.batchSize = batchSize; this.lingerMs = lingerMs; this.bufferMemory = bufferMemory; } public String getBootstrapServers() { return bootstrapServers; } public void setBootstrapServers(String bootstrapServers) { this.bootstrapServers = bootstrapServers; } public String getTopic() { return topic; } public void setTopic(String topic) { this.topic = topic; } public int getRetries() { return retries; } public void setRetries(int retries) { this.retries = retries; } public int getBatchSize() { return batchSize; } public void setBatchSize(int batchSize) { this.batchSize = batchSize; } public int getLingerMs() { return lingerMs; } public void setLingerMs(int lingerMs) { this.lingerMs = lingerMs; } public int getBufferMemory() { return bufferMemory; } public void setBufferMemory(int bufferMemory) { this.bufferMemory = bufferMemory; } } 测试 消费者处理实现ConsumerHandlerImpl类 public class ConsumerHandlerImpl implements ConsumerHandler{ /** * 处理收到的消息 * @param topic 收到消息的topic名称 * @param partition 收到消息的partition内容 * @param offset 收到消息在队列中的编号 * @param value 收到的消息 */ public void processObject(String topic,int partition,long offset,String value) { System.out.println(topic+"从kafka接收"+partition+"到"+offset+"的消息是:"+value); } /** * 获取跨步 * @param topic 接受消息的topic * @param partition 接受消息的partition * @return 当前topic,partition下的seek */ public long getSeek(String topic , int partition) { return 1; } } main方法类 public class AppResourceTest{ public static void main(String[] args){ BeanDefinitionRegistry reg=new DefaultListableBeanFactory(); PropertiesBeanDefinitionReader reader=new PropertiesBeanDefinitionReader(reg); reader.loadBeanDefinitions(new ClassPathResource("resources/kafka-consumer.properties")); reader.loadBeanDefinitions(new ClassPathResource("resources/kafka-producer.properties")); BeanFactory factory=(BeanFactory)reg; ConsumerConfig consumerConfig=(ConsumerConfig)factory.getBean("consumerConfig"); System.out.println(consumerConfig.getPollTime()); ProducerConfig producerConfig=(ProducerConfig)factory.getBean("producerConfig"); System.out.println(producerConfig.getBatchSize()); Producer producer = new Producer(producerConfig); producer.sendMessage(producerConfig.getTopic(),"s4335453453454"); producer.close(); System.out.println("consumer"); Consumer consumer = new Consumer(new ConsumerHandlerImpl(),consumerConfig); try{ Thread.currentThread(); Thread.sleep(10000); }catch(Exception e){ e.printStackTrace(); } } } 运行结果

优秀的个人博客,低调大师

springboot + redis(单机版)

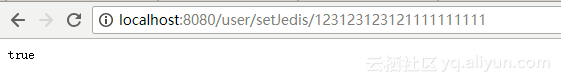
本次和大家分享的是在springboot集成使用redis,这里使用的是redis的jedis客户端,如下添加依赖 <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> </dependency> 然后需要redis的相关配置(这里我的redis密码是空) spring: redis: single: 192.168.146.28:6378 jedis: pool: max-idle: 8 max-active: 8 max-wait: 3000 timeout: 3000 password: 这是redis的一般配置,具体调优可以设置这些参数,下面在JedisConfig类中读取这些设置 @Value("${spring.redis.single}") private String strSingleNode; @Value("${spring.redis.jedis.pool.max-idle}") private Integer maxIdle; @Value("${spring.redis.jedis.pool.max-active}") private Integer maxActive; @Value("${spring.redis.jedis.pool.max-wait}") private Integer maxAWait; @Value("${spring.redis.timeout}") private Integer timeout; @Value("${spring.redis.password}") private String password; 有上面的配置,就需要有代码里面设置下,这里创建一个返回JedisPoolConfig的方法 /** * jedis配置 * * @return */ public JedisPoolConfig getJedisPoolConfig() { JedisPoolConfig config = new JedisPoolConfig(); config.setMaxIdle(maxIdle); #最大空闲数 config.setMaxWaitMillis(maxAWait); #最大等待时间 config.setMaxTotal(maxActive); #最大连接数 return config; } 有了配置,接下来就创建JedisPool,这里把JedisPool托管到spring中 /** * 获取jedispool * * @return */ @Bean public JedisPool getJedisPool() { JedisPoolConfig config = getJedisPoolConfig(); System.out.println("strSingleNode:" + this.strSingleNode); String[] nodeArr = this.strSingleNode.split(":"); JedisPool jedisPool = null; if (this.password.isEmpty()) { jedisPool = new JedisPool( config, nodeArr[0], Integer.valueOf(nodeArr[1]), this.timeout); } else { jedisPool = new JedisPool( config, nodeArr[0], Integer.valueOf(nodeArr[1]), this.timeout, this.password); } return jedisPool; } 上面简单区分了无密码的情况,到此jedis的配置和连接池就基本搭建完了,下面就是封装使用的方法,这里以set和get为例;首先创建个JedisComponent组件,代码如下 /** * Created by Administrator on 2018/8/18. */ @Component public class JedisComponent { @Autowired JedisPool jedisPool; public boolean set(String key, String val) { Jedis jedis = null; try { jedis = jedisPool.getResource(); return jedis.set(key, val).equalsIgnoreCase("OK"); } finally { if (jedis != null) { jedis.close(); } } } public <T> boolean set(String key, T t) { String strJson = JacksonConvert.serilize(t); if (strJson.isEmpty()) { return false; } return this.set(key, strJson); } public String get(String key) { Jedis jedis = null; try { jedis = jedisPool.getResource(); return jedis.get(key); } finally { if (jedis != null) { jedis.close(); } } } public <T> T get(String key, Class<T> tClass) { String strJson = this.get(key); return JacksonConvert.deserilize(strJson, tClass); } } 有了对jedis的调用封装,我们在Controller层的测试用例如下 @Autowired JedisComponent jedis; @GetMapping("/setJedis/{val}") public boolean setJedis(@PathVariable String val) { return jedis.set("token", val); } @GetMapping("/getJedis") public String getJedis() { return jedis.get("token"); } 运行set和get的接口效果如

优秀的个人博客,低调大师

Mybatis迷你版--QueryObjectFactory

今天在看JDBC4.2新规范,然后无意之间就碰到了这个东西QueryObjectFactory, 市面上orm框架有很多,在这里我就不一一列举了。那么今天我来记录一下QueryObjectFactory。官网地址:点这里 一、快速入门 1、将下载好的jar包加入项目 2、我们利用一下jdbc4.0的规范在项目中建立如下文件 在这里我们指定要加载的驱动:com.mysql.jdbc.Driver 3、编写接口: package com.bdqn.lyrk.java.study; import sf.qof.BaseQuery; import sf.qof.Insert; import sf.qof.Query; import java.util.List; public interface StudentDao extends BaseQuery { @Query(sql = "select stuName {%%.stuName},id {%%.id} from student_0") List<StudentEntity> listStudents(); @Insert(sql = "INSERT INTO student_0 (id,stuName,password) values({%1.id},{%1.stuName},{%1.password})") void save(List<StudentEntity> studentEntities); } View Code 这里面我们使用注解的方式配置SQL语句。在这里{}表示占位符,{%%.属性} 通常用于设置查询结果对应的对象属性上,{%1} 通常代表方法内的参数 4、Main方法 package com.bdqn.lyrk.java.study; import sf.qof.QueryObjectFactory; import sf.qof.dialect.HSQLDbDialect; import java.sql.Connection; import java.sql.DriverManager; import java.sql.SQLException; import java.util.ArrayList; import java.util.List; public class Main { public static void main(String[] args) throws SQLException { Connection connection = DriverManager.getConnection("jdbc:mysql://localhost:3306/MySchool?characterEncoding=utf-8&useSSL=false", "root", "xxx"); StudentDao studentDao = QueryObjectFactory.createQueryObject(StudentDao.class); QueryObjectFactory.setSQLDialect(new HSQLDbDialect()); studentDao.setConnection(connection); studentDao.setBatchSize(3); studentDao.listStudents().forEach(s -> System.out.println(s.getStuName())); List<StudentEntity> studentEntities = new ArrayList<>(); for (int i = 0; i < 5; i++) { StudentEntity studentEntity = new StudentEntity(); studentEntity.setId(i + 10); studentEntity.setStuName("test3"); studentEntity.setPassword("abcd"); studentEntities.add(studentEntity); } studentDao.save(studentEntities); } } View Code 执行成功后,拿到如下结果: 5、 设置参数的方式与坑 在这里面QueryFactory给我们设置了如下几种数据类型 registerResultMapper("string", AbstractCharacterMapping.StringMapping.class, AbstractCharacterMapping.StringMapping.getTypes()); registerResultMapper("char", AbstractCharacterMapping.CharacterMapping.class, AbstractCharacterMapping.CharacterMapping.getTypes()); registerResultMapper("boolean", AbstractNumberMapping.BooleanMapping.class, AbstractNumberMapping.BooleanMapping.getTypes()); registerResultMapper("byte", AbstractNumberMapping.ByteMapping.class, AbstractNumberMapping.ByteMapping.getTypes()); registerResultMapper("short", AbstractNumberMapping.ShortMapping.class, AbstractNumberMapping.ShortMapping.getTypes()); registerResultMapper("int", AbstractNumberMapping.IntegerMapping.class, AbstractNumberMapping.IntegerMapping.getTypes()); registerResultMapper("integer", AbstractNumberMapping.IntegerMapping.class, AbstractNumberMapping.IntegerMapping.getTypes()); registerResultMapper("long", AbstractNumberMapping.LongMapping.class, AbstractNumberMapping.LongMapping.getTypes()); registerResultMapper("float", AbstractNumberMapping.FloatMapping.class, AbstractNumberMapping.FloatMapping.getTypes()); registerResultMapper("double", AbstractNumberMapping.DoubleMapping.class, AbstractNumberMapping.DoubleMapping.getTypes()); registerResultMapper("date", AbstractDateTimeMapping.DateMapping.class, AbstractDateTimeMapping.DateMapping.getTypes()); registerResultMapper("time", AbstractDateTimeMapping.TimeMapping.class, AbstractDateTimeMapping.TimeMapping.getTypes()); registerResultMapper("timestamp", AbstractDateTimeMapping.TimestampMapping.class, AbstractDateTimeMapping.TimestampMapping.getTypes()); registerParameterMapper("string", AbstractCharacterMapping.StringMapping.class, AbstractCharacterMapping.StringMapping.getTypes()); registerParameterMapper("char", AbstractCharacterMapping.CharacterMapping.class, AbstractCharacterMapping.CharacterMapping.getTypes()); registerParameterMapper("boolean", AbstractNumberMapping.BooleanMapping.class, AbstractNumberMapping.BooleanMapping.getTypes()); registerParameterMapper("byte", AbstractNumberMapping.ByteMapping.class, AbstractNumberMapping.ByteMapping.getTypes()); registerParameterMapper("short", AbstractNumberMapping.ShortMapping.class, AbstractNumberMapping.ShortMapping.getTypes()); registerParameterMapper("int", AbstractNumberMapping.IntegerMapping.class, AbstractNumberMapping.IntegerMapping.getTypes()); registerParameterMapper("integer", AbstractNumberMapping.IntegerMapping.class, AbstractNumberMapping.IntegerMapping.getTypes()); registerParameterMapper("long", AbstractNumberMapping.LongMapping.class, AbstractNumberMapping.LongMapping.getTypes()); registerParameterMapper("float", AbstractNumberMapping.FloatMapping.class, AbstractNumberMapping.FloatMapping.getTypes()); registerParameterMapper("double", AbstractNumberMapping.DoubleMapping.class, AbstractNumberMapping.DoubleMapping.getTypes()); registerParameterMapper("date", AbstractDateTimeMapping.DateMapping.class, AbstractDateTimeMapping.DateMapping.getTypes()); registerParameterMapper("time", AbstractDateTimeMapping.TimeMapping.class, AbstractDateTimeMapping.TimeMapping.getTypes()); registerParameterMapper("timestamp", AbstractDateTimeMapping.TimestampMapping.class, AbstractDateTimeMapping.TimestampMapping.getTypes()); View Code 注意我们通过以下几种方式设置数据类型: {数据类型%1} 或者 {数据类型%%.属性的方式} 坑:注意以下关于日期数据类型代码: /* * Copyright 2007 brunella ltd * * Licensed under the LGPL Version 3 (the "License"); * you may not use this file except in compliance with the License. * * THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS" * AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE * IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE * ARE DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT OWNER OR CONTRIBUTORS BE * LIABLE FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR * CONSEQUENTIAL DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF * SUBSTITUTE GOODS OR SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS * INTERRUPTION) HOWEVER CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN * CONTRACT, STRICT LIABILITY, OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) * ARISING IN ANY WAY OUT OF THE USE OF THIS SOFTWARE, EVEN IF ADVISED OF * THE POSSIBILITY OF SUCH DAMAGE. */ package sf.qof.mapping; import java.util.Date; import java.util.HashSet; import java.util.Set; public abstract class AbstractDateTimeMapping extends AbstractBaseMapping implements Mapping, ParameterMapping, ResultMapping { private static final Set<Class<?>> types = new HashSet<Class<?>>(); static { types.add(Date.class); } public static Set<Class<?>> getTypes() { return types; } public void accept(Mapper mapper, MappingVisitor visitor) { visitor.visit(mapper, this); } public abstract void accept(Mapper mapper, DateTimeMappingVisitor visitor); public static class DateMapping extends AbstractDateTimeMapping { public void accept(Mapper mapper, DateTimeMappingVisitor visitor) { visitor.visit(mapper, this); } } public static class TimeMapping extends AbstractDateTimeMapping { public void accept(Mapper mapper, DateTimeMappingVisitor visitor) { visitor.visit(mapper, this); } } public static class TimestampMapping extends AbstractDateTimeMapping { public void accept(Mapper mapper, DateTimeMappingVisitor visitor) { visitor.visit(mapper, this); } } } View Code 在静态代码块中所有的日期类型都对应的是java.util.Date ,因此我们不能用Timestamp或者java.sql.Date作为JavaBean的数据类型 二、总结与展望 1. 使用注解通常情况下适配一些比较简单的查询,复杂的查询不建议使用 2.这个适合于小型项目的迅速开发与上线,大型项目建议选择成熟的orm框架 3.虽然说select * 不建议使用的,但是如何解决select * 下映射关系?

优秀的个人博客,低调大师

Tengine-Ngnix高级版

​ image Tengine介绍 Tengine是由淘宝网发起的Web服务器项目。它在Nginx的基础上,针对大访问量网站的需求,添加了很多高级功能和特性。Tengine的性能和稳定性已经在大型的网站如淘宝网,天猫商城等得到了很好的检验。它的最终目标是打造一个高效、稳定、安全、易用的Web平台。 从2011年12月开始,Tengine成为一个开源项目,Tengine团队在积极地开发和维护着它。Tengine团队的核心成员来自于淘宝、搜狗等互联网企业。Tengine是社区合作的成果,我们欢迎大家参与其中,贡献自己的力量。 特性 继承Nginx-1.8.1的所有特性,兼容Nginx的配置; 动态模块加载(DSO)支持。加入一个模块不再需要重新编译整个Tengine; 支持HTTP/2协议,HTTP/2模块替代SPDY模块; 流式上传到HTTP后端服务器或FastCGI服务器,大量减少机器的I/O压力; 更加强大的负载均衡能力,包括一致性hash模块、会话保持模块,还可以对后端的服务器进行主动健康检查,根据服务器状态自动上线下线,以及动态解析upstream中出现的域名; 输入过滤器机制支持。通过使用这种机制Web应用防火墙的编写更为方便; 支持设置proxy、memcached、fastcgi、scgi、uwsgi在后端失败时的重试次数; 动态脚本语言Lua支持。扩展功能非常高效简单; 支持按指定关键字(域名,url等)收集Tengine运行状态; 组合多个CSS、JavaScript文件的访问请求变成一个请求; 自动去除空白字符和注释从而减小页面的体积; 自动根据CPU数目设置进程个数和绑定CPU亲缘性; 监控系统的负载和资源占用从而对系统进行保护; 显示对运维人员更友好的出错信息,便于定位出错机器; 更强大的防攻击(访问速度限制)模块; 更方便的命令行参数,如列出编译的模块列表、支持的指令等; 可以根据访问文件类型设置过期时间; …… 更多可以访问: 项目官网:http://tengine.taobao.org/ 开源地址:https://github.com/alibaba/tengine 推荐阅读 去BAT面试完的Mysql面试题总结(55道,带完整答案) 阿里高级Java面试题(首发,70道,带详细答案) 2017派卧底去阿里、京东、美团、滴滴带回来的面试题及答案 Spring面试题(70道,史上最全) 通往大神之路,百度Java面试题前200页。 分享Java干货,高并发编程,热门技术教程,微服务及分布式技术,架构设计,区块链技术,人工智能,大数据,Java面试题,以及前沿热门资讯等。

优秀的个人博客,低调大师

spark基本操作 java 版

1.map算子 private static void map() { //创建SparkConf SparkConf conf = new SparkConf() .setAppName("map") .setMaster("local"); //创建JavasparkContext JavaSparkContext sc = new JavaSparkContext(conf); //构造集合 List<Integer> numbers = Arrays.asList(1,2,3,4,5); //并行化集合,创建初始RDD JavaRDD<Integer> numberRDD = sc.parallelize(numbers); //使用map算子,将集合中的每个元素都乘以2 JavaRDD<Integer> multipleNumberRDD = numberRDD.map(new Function<Integer, Integer>() { @Override public Integer call(Integer v1) throws Exception { return v1 * 2; } }); //打印新的RDD multipleNumberRDD.foreach(new VoidFunction<Integer>() { @Override public void call(Integer t) throws Exception { System.out.println(t); } }); //关闭JavasparkContext sc.close(); } 2.filter算子 private static void filter() { //创建SparkConf SparkConf conf = new SparkConf() .setAppName("filter") .setMaster("local"); //创建JavaSparkContext JavaSparkContext sc = new JavaSparkContext(conf); //模拟集合 List<Integer> numbers = Arrays.asList(1,2,3,4,5,6,7,8,9,10); //并行化集合,创建初始RDD JavaRDD<Integer> numberRDD = sc.parallelize(numbers); //对集合使用filter算子,过滤出集合中的偶数 JavaRDD<Integer> evenNumberRDD = numberRDD.filter(new Function<Integer, Boolean>() { @Override public Boolean call(Integer v1) throws Exception { return v1%2==0; } }); evenNumberRDD.foreach(new VoidFunction<Integer>() { @Override public void call(Integer t) throws Exception { System.out.println(t); } }); sc.close(); } 3.flatMap算子 Spark 中 map函数会对每一条输入进行指定的操作,然后为每一条输入返回一个对象; 而flatMap函数则是两个操作的集合——正是“先映射后扁平化”: 操作1:同map函数一样:对每一条输入进行指定的操作,然后为每一条输入返回一个对象 操作2:最后将所有对象合并为一个对象 private static void flatMap() { SparkConf conf = new SparkConf() .setAppName("flatMap") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<String> lineList = Arrays.asList("hello you","hello me","hello world"); JavaRDD<String> lines = sc.parallelize(lineList); //对RDD执行flatMap算子,将每一行文本,拆分为多个单词 JavaRDD<String> words = lines.flatMap(new FlatMapFunction<String, String>() { //在这里,传入第一行,hello,you //返回的是一个Iterable<String>(hello,you) @Override public Iterable<String> call(String t) throws Exception { return Arrays.asList(t.split(" ")); } }); words.foreach(new VoidFunction<String>() { @Override public void call(String t) throws Exception { System.out.println(t); } }); sc.close(); } 4.groupByKey算子 private static void groupByKey() { SparkConf conf = new SparkConf() .setAppName("groupByKey") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<Tuple2<String, Integer>> scoreList = Arrays.asList( new Tuple2<String, Integer>("class1", 80), new Tuple2<String, Integer>("class2", 90), new Tuple2<String, Integer>("class1", 97), new Tuple2<String, Integer>("class2", 89)); JavaPairRDD<String, Integer> scores = sc.parallelizePairs(scoreList); //针对scoresRDD,执行groupByKey算子,对每个班级的成绩进行分组 //相当于是,一个key join上的所有value,都放到一个Iterable里面去了 JavaPairRDD<String, Iterable<Integer>> groupedScores = scores.groupByKey(); groupedScores.foreach(new VoidFunction<Tuple2<String,Iterable<Integer>>>() { @Override public void call(Tuple2<String, Iterable<Integer>> t) throws Exception { System.out.println("class:" + t._1); Iterator<Integer> ite = t._2.iterator(); while(ite.hasNext()) { System.out.println(ite.next()); } } }); } 5.reduceByKey算子 private static void reduceByKey() { SparkConf conf = new SparkConf() .setAppName("reduceByKey") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<Tuple2<String, Integer>> scoreList = Arrays.asList( new Tuple2<String, Integer>("class1", 80), new Tuple2<String, Integer>("class2", 90), new Tuple2<String, Integer>("class1", 97), new Tuple2<String, Integer>("class2", 89)); JavaPairRDD<String, Integer> scores = sc.parallelizePairs(scoreList); //reduceByKey算法返回的RDD,还是JavaPairRDD<key,value> JavaPairRDD<String, Integer> totalScores = scores.reduceByKey(new Function2<Integer, Integer, Integer>() { @Override public Integer call(Integer v1, Integer v2) throws Exception { return v1 + v2; } }); totalScores.foreach(new VoidFunction<Tuple2<String,Integer>>() { @Override public void call(Tuple2<String, Integer> t) throws Exception { System.out.println(t._1 + ":" + t._2); } }); sc.close(); } 6.sortByKey算子 private static void sortByKey() { SparkConf conf = new SparkConf() .setAppName("sortByKey") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<Tuple2<Integer, String>> scoreList = Arrays.asList( new Tuple2<Integer, String>(78, "marry"), new Tuple2<Integer, String>(89, "tom"), new Tuple2<Integer, String>(72, "jack"), new Tuple2<Integer, String>(86, "leo")); JavaPairRDD<Integer, String> scores = sc.parallelizePairs(scoreList); JavaPairRDD<Integer, String> sortedScores = scores.sortByKey(); sortedScores.foreach(new VoidFunction<Tuple2<Integer,String>>() { @Override public void call(Tuple2<Integer, String> t) throws Exception { System.out.println(t._1 + ":" + t._2); } }); sc.close(); } 7.join算子 join算子用于关联两个RDD,join以后,会根据key进行join,并返回JavaPairRDD。JavaPairRDD的第一个泛型类型是之前两个JavaPairRDD的key类型,因为通过key进行join的。第二个泛型类型,是Tuple2<v1, v2>的类型,Tuple2的两个泛型分别为原始RDD的value的类型 private static void join() { SparkConf conf = new SparkConf() .setAppName("join") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<Tuple2<Integer, String>> studentList = Arrays.asList( new Tuple2<Integer, String>(1, "tom"), new Tuple2<Integer, String>(2, "jack"), new Tuple2<Integer, String>(3, "marry"), new Tuple2<Integer, String>(4, "leo")); List<Tuple2<Integer, Integer>> scoreList = Arrays.asList( new Tuple2<Integer, Integer>(1, 78), new Tuple2<Integer, Integer>(2, 87), new Tuple2<Integer, Integer>(3, 89), new Tuple2<Integer, Integer>(4, 98)); //并行化两个RDD JavaPairRDD<Integer, String> students = sc.parallelizePairs(studentList);; JavaPairRDD<Integer, Integer> scores = sc.parallelizePairs(scoreList); //使用join算子关联两个RDD //join以后,会根据key进行join,并返回JavaPairRDD //JavaPairRDD的第一个泛型类型,之前两个JavaPairRDD的key类型,因为通过key进行join的 //第二个泛型类型,是Tuple2<v1, v2>的类型,Tuple2的两个泛型分别为原始RDD的value的类型 JavaPairRDD<Integer, Tuple2<String, Integer>> studentScores = students.join(scores); //打印 studentScores.foreach(new VoidFunction<Tuple2<Integer,Tuple2<String,Integer>>>() { @Override public void call(Tuple2<Integer, Tuple2<String, Integer>> t) throws Exception { System.out.println("student id:" + t._1); System.out.println("student name:" + t._2._1); System.out.println("student score:" + t._2._2); System.out.println("=========================="); } }); sc.close(); } 更深的方法参见:http://blog.csdn.net/liulingyuan6/article/details/53397780http://blog.csdn.net/liulingyuan6/article/details/53410832https://www.2cto.com/net/201608/543044.html 转自:http://blog.csdn.net/sunhaoning/article/details/70505718 本文转自whk66668888 51CTO博客,原文链接:http://blog.51cto.com/12597095/2063767

优秀的个人博客,低调大师

hbase单机版安装

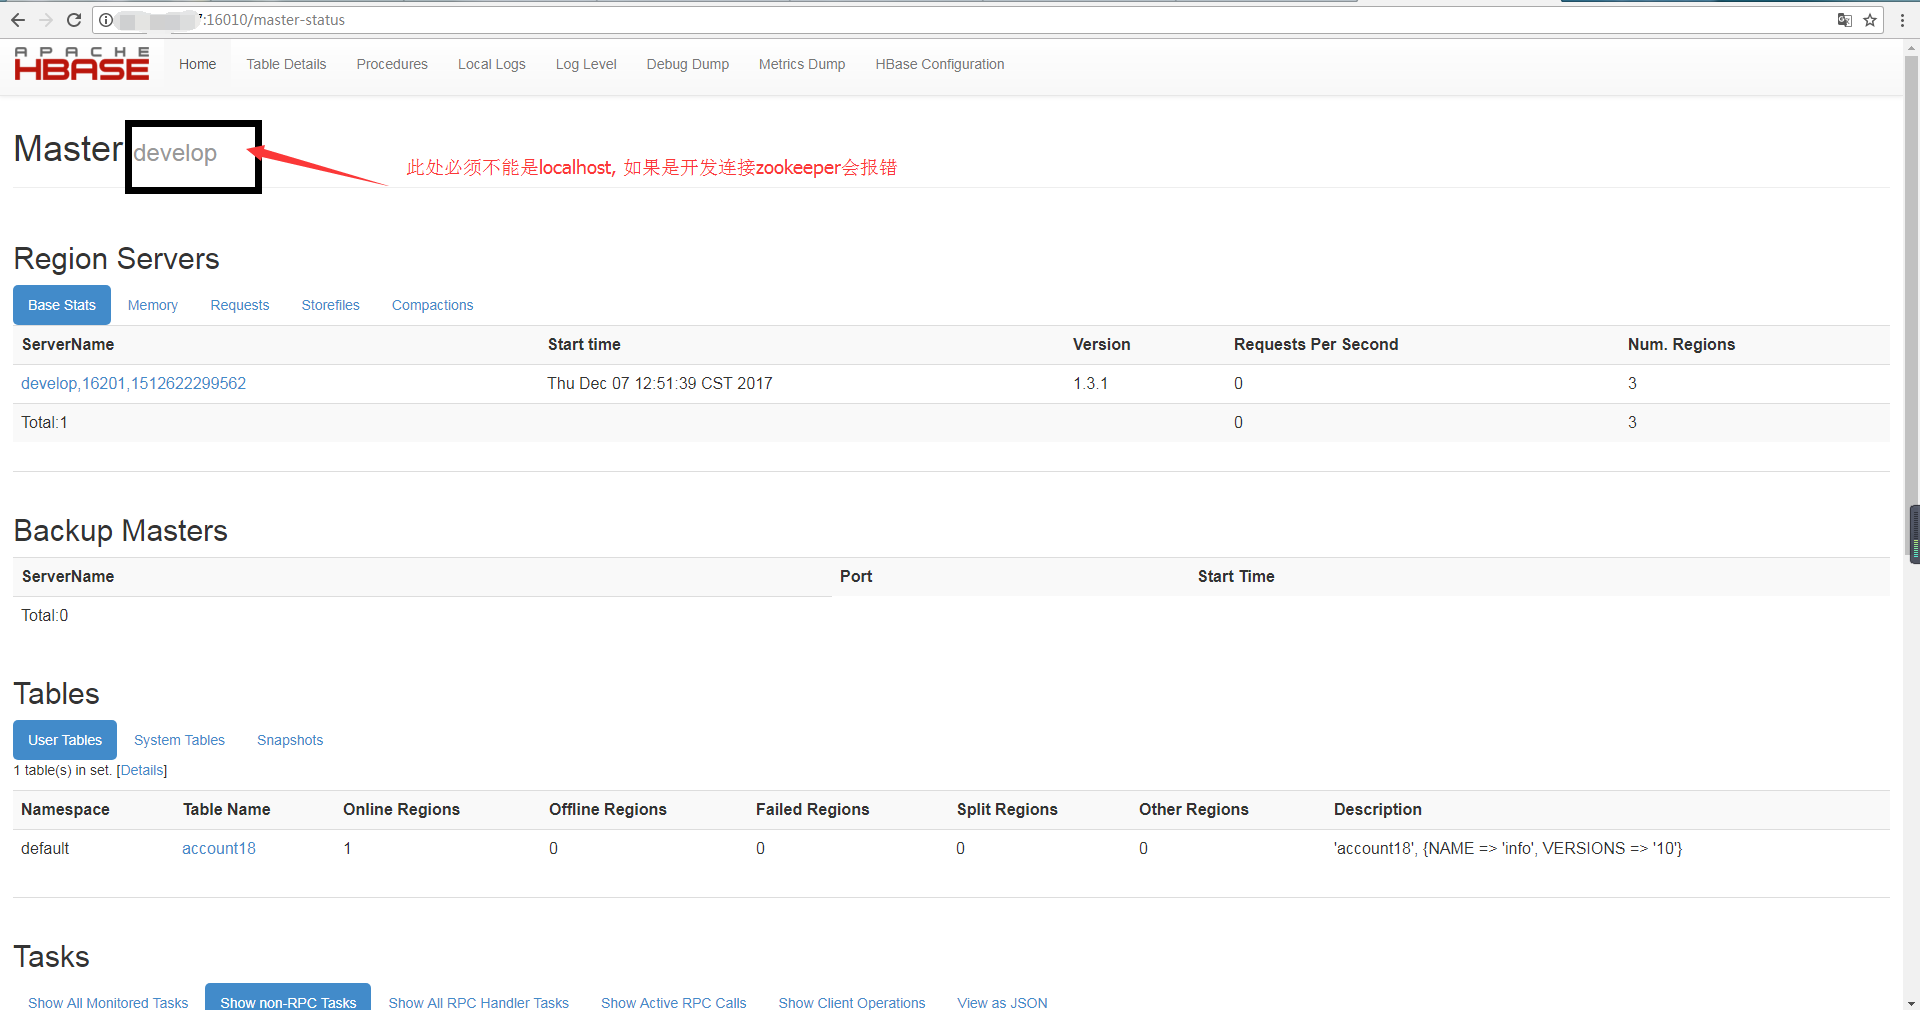
、系统版本 2、安装 3、测试一下 4、注意事项 1、系统版本 版本: linux centos6.8 hbase版本: hbase-1.3.1 jdk版本 [root@test hbase]# java -version java version "1.8.0_121" Java(TM) SE Runtime Environment (build 1.8.0_121-b13) Java HotSpot(TM) 64-Bit Server VM (build 25.121-b13, mixed mode) 2、安装 # 将hbase解压到/opt/hadoop/目录下,并弄一个软链接 # 配置/etc/hosts文件 #注意这里127.0.0.1 这行一定要注释,否则hbase单机启动的时候会报错 # 加一行 你的主机IP地址 主机hostname 如192.168.1.1 test # 配置 conf/hbase-env.sh# 这里配置你安装的jdk的目录 export JAVA_HOME=/usr/java/default/ # 配置 conf/hbase-site.xml <configuration> <property> <name>hbase.rootdir</name> <value>file:///opt/hadoop/hbase/data/</value>#这里是安装目录自行定义的目录 </property> <property> <name>hbase.master</name> <value>192.168.1.1</value># 主机IP,也可以是主机名 </property> <property> <name>hbase.cluster.distributed</name> <value>true</value> </property> <property> <name>hbase.zookeeper.property.clientPort</name> <value>2181</value># zookeeper端口 </property> <property> <name>hbase.zookeeper.quorum</name> <value>192.168.1.1</value># zookeeper地址,也可以是主机名 </property> </configuration> 3、测试一下 # 使用 bin/hbase shell 1 2 3 4 5 6 7 8 9 10 11 2017-12-0713:21:03,242WARN[main]util.NativeCodeLoader:Unabletoloadnative-hadooplibrary for yourplatform...using builtin -javaclasseswhereapplicable HBaseShell;enter 'help<RETURN>' for listofsupportedcommands. Type "exit<RETURN>" toleavetheHBaseShell Version1.3.1,r930b9a55528fe45d8edce7af42fef2d35e77677a,ThuApr619:36:54PDT2017 hbase(main):001:0>list TABLE account18 1row(s) in 0.1570seconds =>[ "account18" ] 4、注意事项 # 也可以使用ip地址:16010登陆,查看master一定不能是localhost如果是那么一定要检查/etc/hosts文件 本文转自812374156 51CTO博客,原文链接:http://blog.51cto.com/xiong51/2048302,如需转载请自行联系原作者

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码