首页 文章 精选 留言 我的

精选列表

搜索[SpringBoot],共4561篇文章
优秀的个人博客,低调大师

SpringBoot 2.0整合jackson配置日期格式化和反序列化

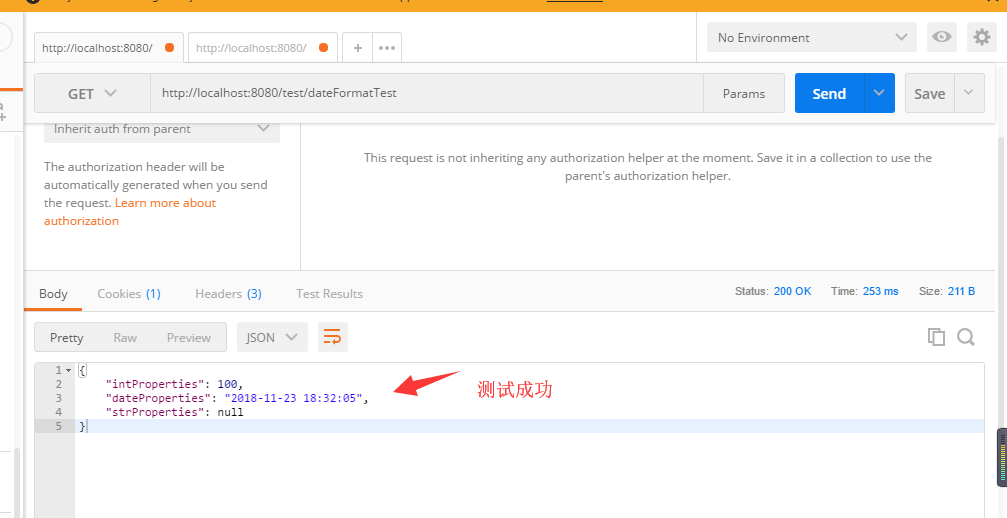
网上杂七杂八的说法不一,大多数都是抄来抄去,没有实践,近期在项目频繁遇到boot+jackson处理日期的问题,故开此贴。 首先是POM <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>io.cj.learning</groupId> <artifactId>boot2exam</artifactId> <version>0.0.1-SNAPSHOT</version> <packaging>jar</packaging> <name>boot2exam</name> <description>Demo project for Spring Boot</description> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>2.0.0.RELEASE</version> <relativePath/> <!-- lookup parent from repository --> </parent> <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding> <java.version>1.8</java.version> </properties> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> <version>RELEASE</version> <scope>compile</scope> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> <version>RELEASE</version> <scope>compile</scope> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> </plugins> </build> </project> 然后是yml文件 (当然yml这东西很多人不喜欢,我也写了个properties版本的) spring: jackson: #参数意义: #JsonInclude.Include.ALWAYS 默认 #JsonInclude.Include.NON_DEFAULT 属性为默认值不序列化 #JsonInclude.Include.NON_EMPTY 属性为 空(””) 或者为 NULL 都不序列化 #JsonInclude.Include.NON_NULL 属性为NULL 不序列化 default-property-inclusion: ALWAYS time-zone: GMT+8 date-format: yyyy-MM-dd HH:mm:ss 上面配置对应的properties文件版本: #jackson相关配置 spring.jackson.date-format = yyyy-MM-dd HH:mm:ss #时区必须要设置 spring.jackson.time-zone= GMT+8 #ALWAYS的意思是即时属性为null,仍然也会输出这个key spring.jackson.default-property-inclusion=ALWAYS 然后来定义一个Controller和JAVA Bean Controller: package io.cj.learning.boot2exam.controller; import io.cj.learning.boot2exam.model.DateFormatTest; import org.springframework.web.bind.annotation.*; import java.text.SimpleDateFormat; import java.util.Date; @RestController @RequestMapping(value="/test") public class TestController { /** * 测试时间序列化, java.util.date 类型 -> String * @return */ @RequestMapping(value="/dateFormatTest", method = RequestMethod.GET) @ResponseBody public DateFormatTest dateFormatTest(){ DateFormatTest dateFormatTest = new DateFormatTest(); dateFormatTest.setIntProperties(100); dateFormatTest.setDateProperties(new Date()); return dateFormatTest; } /** * 测试时间反序列化 String -> java.util.date 类型 */ @RequestMapping(value="/dateFormatTest2" ,method = RequestMethod.POST) public void dateFormatTest2(@RequestBody DateFormatTest model){ SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); System.out.println(model.getIntProperties()); System.out.println(sdf.format(model.getDateProperties())); System.out.println(model.getStrProperties()); } } Java Bean: package io.cj.learning.boot2exam.model; import java.util.Date; /** * 一个model,里面带一个日期类型 */ public class DateFormatTest { private Integer intProperties; private Date dateProperties; private String strProperties; public Integer getIntProperties() { return intProperties; } public void setIntProperties(Integer intProperties) { this.intProperties = intProperties; } public Date getDateProperties() { return dateProperties; } public void setDateProperties(Date dateProperties) { this.dateProperties = dateProperties; } public String getStrProperties() { return strProperties; } public void setStrProperties(String strProperties) { this.strProperties = strProperties; } } 启动主类: package io.cj.learning.boot2exam; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; @SpringBootApplication public class Boot2examApplication { public static void main(String[] args) { SpringApplication.run(Boot2examApplication.class, args); } } 测试: 试一下,首先是日期序列化, 请求一下试试 然后是反序列化,也请求一个试试:

优秀的个人博客,低调大师

SpringCloud+SpringBoot+mybatis分布式微服务云架构开发Web应用

在完成配置之后,举一个简单的例子,在快速入门工程的基础上,举一个简单的示例来通过Thymeleaf渲染一个页面。 @Controller public class HelloController { @RequestMapping("/") public String index(ModelMap map) { // 加入一个属性,用来在模板中读取 map.addAttribute("host", "http://blog.didispace.com"); // return模板文件的名称,对应src/main/resources/templates/index.html return "index"; } } <!DOCTYPE html> <html> <head lang="en"> <meta charset="UTF-8" /> <title></title> </head> <body> <h1 th:text="${host}">Hello World</h1> </body> </html> 如上页面,直接打开html页面展现Hello World,但是启动程序后,访问http://localhost:8080/,则是展示Controller中host的值:http://blog.didispace.com,做到了不破坏HTML自身内容的数据逻辑分离。 更多Thymeleaf的页面语法,还请访问Thymeleaf的官方文档查询使用。 Thymeleaf的默认参数配置 如有需要修改默认配置的时候,只需复制下面要修改的属性到application.properties中,并修改成需要的值,如修改模板文件的扩展名,修改默认的模板路径等。 # Enable template caching. spring.thymeleaf.cache=true # Check that the templates location exists. spring.thymeleaf.check-template-location=true # Content-Type value. spring.thymeleaf.content-type=text/html # Enable MVC Thymeleaf view resolution. spring.thymeleaf.enabled=true # Template encoding. spring.thymeleaf.encoding=UTF-8 # Comma-separated list of view names that should be excluded from resolution. spring.thymeleaf.excluded-view-names= # Template mode to be applied to templates. See also StandardTemplateModeHandlers. spring.thymeleaf.mode=HTML5 # Prefix that gets prepended to view names when building a URL. spring.thymeleaf.prefix=classpath:/templates/ # Suffix that gets appended to view names when building a URL. spring.thymeleaf.suffix=.html spring.thymeleaf.template-resolver-order= # Order of the template resolver in the chain. spring.thymeleaf.view-names= # Comma-separated list of view names that can be resolved. 支持JSP的配置Spring Boot并不建议使用,但如果一定要使用,可以参考此工程作为脚手架:JSP支持 完整项目的源码来源 技术支持1791743380

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第10招 数据库自动配置怎么来

# Petclinic 换 MySQL:从 H2 到生产数据库的自动配置追踪 ```text 旧方案:H2 内存库一切正常 → 换 MySQL 后偶发 SQL 报错、类型不匹配、事务超时、连接池耗尽 → 上线即故障 ``` 很多团队在 Petclinic 这类教学项目上会先跑通 H2,再切 MySQL。 切换时只改一个 JDBC URL,以为数据库只是“换个地址”。 结果测试环境一压就出问题:SQL 方言不同、类型映射不同、事务隔离不同、连接池参数不同。 我是老李,这次带团队把 Petclinic 真正接到第 1 招准备的 MySQL,沿着 `spring.datasource` 到 `DataSourceAutoConfiguration`、Hika riCP、JPA/Hibernate、Repository、MySQL 的链路逐层追踪。 为什么 H2 完全正常,换成 MySQL 后仍然可能暴露 SQL、类型、事务和连接池问题? 是继续沿用 H2 的开发习惯,还是按生产数据库重新校验每一层自动配置? 如果选错,会不会在压测或上线当天才发现连接池被打满、事务回滚失效、SQL 全表扫描? # 01、故事 ```text 周四 23:40 → 研发区 → 任务是把 Petclinic 切到 MySQL 并跑通冒烟 → 测试催着要环境,日志里全是连接超时 ``` 周四晚上十一点四十,研发区只剩我们这一排还亮着灯。 任务是第二天早上把 Petclinic 切到 MySQL,给测试一个能压的环境。 我把 `jdbc:mysql://localhost:3306/petclinic` 填进去,启动应用。 控制台刷了几十行后停住,最后一行是 `HikariPool-1 - Connection is not available, request timed out after 30000ms`。 测试同学在群里催:“环境好了没? 我们八点要跑第一轮。 ”我盯着屏幕,脑子里全是 H2 时代从没见过的报错。 > 夜深屏幕冷光白,连接池里等不来 > 测试催声如鼓点,H2 旧梦已不在 > 一行 URL 换天地,自动配置藏暗礁 > 若问故障何处起,层层追到数据桥 # 02、问题 ```text 需求变化:从演示用 H2 内存库 → 生产级 MySQL → 自动配置默认值不再适配 → SQL、类型、事务、连接池四类风险 ``` H2 是嵌入式内存库,应用启动时创建,关闭即销毁。 MySQL 是独立服务,有网络延迟、连接数上限、严格 SQL 模式、事务隔离级别和持久化约束。 Spring Boot 对两者的自动配置虽然入口相同,但底层方言、驱动、连接池行为完全不同。 失效原因不是配置写错,而是把 H2 的“零配置体验”误当成 MySQL 的“零配置安全”。 H2 默认宽松,MySQL 默认严格。 可验证的验收标准是:应用启动后能通过 HTTP 接口完成一次 Owner 新增、查询、修改,且日志中能看到真实 SQL 和连接池获取/归还记录。 > 内存库中无风浪,一朝出海见波涛 > 方言不同语句错,类型映射藏暗刀 > 事务隔离分高下,连接池里争分秒 > 不是配置写不对,是把演示当生产 # 03、原理 ```text spring.datasource → DataSourceAutoConfiguration → HikariDataSource → EntityManagerFactory → JpaTransactionManager → Repository → MySQL ``` Spring Boot 的 Data 自动配置由 `DataSourceAutoConfiguration` 触发。 它读取 `spring.datasource.*` 属性,创建 HikariCP 数据源。 随后 `HibernateJpaAutoConfiguration` 用这个数据源构建 `EntityManagerFactory`,扫描 `@Entity` 和 Repository。 HikariCP 默认最大连接数是 10,连接超时 30 秒。 Hibernate 默认 `ddl-auto` 在 H2 上常配合 `create-drop`,在 MySQL 上如果沿用会直接删表重建。 MySQL 驱动通过 `com.mysql.cj.jdbc.Driver` 注册,方言由 Hibernate 根据连接元数据自动识别。 一个反直觉判断:连接池参数不是越大越好。MySQL 每个连接都占用服务端线程和内存,连接数过大反而会让数据库上下文切换加剧,吞吐下降。 > 自动配置一条链,层层默认藏玄机 > 数据源起 Hikari,实体扫描靠 JPA > 方言驱动自动认,池中连接有上限 > 反直觉处须牢记,连接不是越多越强 # 04、架构 ```text HTTP 请求 → Controller → Service → Repository → EntityManager → Hibernate → HikariCP → MySQL ``` 本模块的边界是持久层:从 Repository 接口到 MySQL 连接。 Controller 和 Service 不感知数据库类型,这是 JPA 抽象的价值。 但抽象不能消除差异,只能把差异压缩到方言、类型映射和连接管理三层。 收益是业务代码不用改,代价是排障时必须穿透抽象看真实 SQL 和连接行为。适用条件是单一数据库、标准 JPA 映射。一旦用了 MySQL 特有函数或 JSON 类型,抽象就开始泄漏。 > 上层不晓底层事,抽象压差入方言 > 业务代码稳如山,排障却要穿三层 > 收益代价两相抵,适用边界在标准 > 若用特性超映射,抽象泄漏见真身 # 05、第一版实战 ```text 环境:JDK 17 + Spring Boot 3.2 + Petclinic 官方代码 + MySQL 8.0 → 配置 → 启动 → 验证 → V1 ``` 第一步,在 `pom.xml` 确认依赖。Petclinic 官方已含 `spring-boot-starter-data-jpa`,需要把 H2 换成 MySQL 驱动。 ```xml com.mysql mysql-connector-j runtime ``` 第二步,在 `application.properties` 写数据源配置。 ```properties spring.datasource.url=jdbc:mysql://localhost:3306/petclinic?useSSL=false&serverTimezone=Asia/Shanghai&characterEncoding=utf8 spring.datasource.username=petclinic spring.datasource.password=petclinic spring.datasource.driver-class-name=com.mysql.cj.jdbc.Driver spring.jpa.hibernate.ddl-auto=update spring.jpa.show-sql=true spring.jpa.properties.hibernate.format_sql=true ``` 第三步,启动应用。 ```bash ./mvnw spring-boot:run ``` 第四步,验证新增 Owner。 ```bash curl -X POST http://localhost:8080/owners/new \ -H "Content-Type: application/x-www-form-urlencoded" \ -d "firstName=李&lastName=雷&address=深圳&city=深圳&telephone=13800138000" ``` 示例输出: ```text Hibernate: insert into owners (first_name,last_name,address,city,telephone) values (?,?,?,?,?) ``` V1 成功标准:应用启动不报错,Owner 新增后能在 MySQL 中查到记录。 > 依赖换罢配置填,启动命令敲回车 > 一条插入落日志,MySQL 中见新行 > 看似成功已到手,隐患还在暗处藏 > 第一版只验通路,未验压力与边界 # 06、排查 ```text 诊断树:连接池超时 → 怀疑连接泄漏 → 查 Hikari 日志 → 发现连接未归还 → 根因是事务未提交 ``` 第一个问题:压测时连接池超时。现象是并发 20 个请求后,日志出现 `Connection is not available`。怀疑连接泄漏,检查 Hikari 指标。 ```bash curl http://localhost:8080/actuator/metrics/hikaricp.connections.active ``` 示例输出: ```text {"name":"hikaricp.connections.active","measurements":[{"statistic":"VALUE","value":10.0}]} ``` 证据是活跃连接数一直等于 10,说明连接只借不还。 根因是 Service 方法缺少 `@Transactional`,Repository 调用后 EntityManager 未关闭,连接一直挂在事务上。 第二个问题:MySQL 报 `Data too long for column`。 现象是 Owner 的 address 字段写入长字符串时报错。 怀疑 H2 的 VARCHAR 长度在 MySQL 上被严格校验。 检查表结构。 ```sql SHOW CREATE TABLE owners; ``` 示例输出: ```text `address` varchar(255) DEFAULT NULL ``` 证据是 MySQL 严格模式拒绝超长数据,而 H2 默认截断。根因是实体字段未加 `@Column(length=...)`,Hibernate 按默认 255 建表。 **错误尝试:** 第一次遇到连接池超时,我直接把 `maximum-pool-size` 调到 100。结果 MySQL 端线程数暴涨,CPU 飙到 90%,问题更严重。 > 连接池满查指标,活跃数定格十 > 借而不还因无事务,连接泄漏是根因 > 类型报错查表结构,默认长度二五五 > 错误尝试加池数,反让数据库更苦 # 07、优化 ```text V1:无事务、默认池参数、无 SQL 日志规范 → 证据:连接泄漏、类型报错 → V2:显式事务、池参数调优、日志分级 ``` 第一处修改:给 Service 层加 `@Transactional`。Petclinic 的 `ClinicServiceImpl` 需要显式声明事务边界。 ```java @Service public class ClinicServiceImpl implements ClinicService { @Transactional @Override public Owner saveOwner(Owner owner) { return ownerRepository.save(owner); } } ``` 第二处修改:调整连接池参数。连接数按 CPU 核数和 MySQL 最大连接数综合设定,不盲目调大。 ```properties spring.datasource.hikari.maximum-pool-size=20 spring.datasource.hikari.minimum-idle=5 spring.datasource.hikari.connection-timeout=5000 spring.datasource.hikari.idle-timeout=600000 spring.datasource.hikari.max-lifetime=1800000 ``` 第三处修改:SQL 日志按环境分级,开发环境打印,生产环境关闭。 ```properties spring.jpa.show-sql=false spring.jpa.properties.hibernate.format_sql=false logging.level.org.hibernate.SQL=debug logging.level.org.hibernate.type.descriptor.sql.BasicBinder=trace ``` > 事务注解补上去,连接借还归正途 > 池参数按核来定,不追大数追匹配 > 日志分级分环境,开发可见生产隐 > 三处修改皆对症,V2 方敢称可用 # 08、演进 ```text V2:显式事务 + 池参数调优 + 日志分级 → 能力:连接不泄漏、类型可约束、SQL 可追踪 → 遗留:迁移脚本未管 ``` 用 V1 同一组请求前后验证。V1 时并发 20 个请求,10 个超时;V2 后同样并发,全部 200 返回。连接活跃数峰值 20,请求结束后回落到 5。 ```bash curl http://localhost:8080/actuator/metrics/hikaricp.connections.active ``` 示例输出: ```text {"name":"hikaricp.connections.active","measurements":[{"statistic":"VALUE","value":5.0}]} ``` 收益是连接生命周期可控,类型约束明确,SQL 排障有据。 代价是每个 Service 方法都要显式考虑事务边界,开发心智增加。 遗留问题是数据库表结构变更还没有纳入版本管理,`ddl-auto=update` 在生产环境有风险。 > 同组请求再验证,超时清零全通过 > 活跃连接有起落,峰值二十回落五 > 收益代价两分明,事务边界要常想 > 遗留迁移未管住,下篇要把脚本收 # 09、洞见 ```text 从现象到判断:H2 正常不代表 MySQL 正常,抽象不消除差异,连接池是数据库的客户端限流器 ``` ## 反直觉判断:H2 越正常,MySQL 越危险 ```text H2 宽松 → 掩盖问题 → MySQL 严格 → 集中爆发 ``` H2 的宽松默认值会掩盖类型、事务、SQL 方言问题。开发期越顺利,说明代码越依赖 H2 的宽容,切换 MySQL 时问题越集中。 ## 反直觉判断:连接池是保护数据库,不是压榨数据库 ```text 池小 → 数据库稳 → 请求排队 → 池大 → 数据库崩 → 全部超时 ``` 连接池的本质是客户端限流器。池参数调大看似提高并发,实际是把压力转嫁给数据库。数据库一旦过载,所有请求一起超时。 ## 事务边界是连接归还的开关 ```text 无事务 → 连接不归还 → 池耗尽 → 有事务 → 连接按时还 → 池健康 ``` Spring 的事务管理器和连接池是联动的。事务提交或回滚时,连接才会归还池中。漏写 `@Transactional` 等于让连接只借不还。 ## SQL 日志是生产排障的底线 ```text 无日志 → 黑盒 → 有日志 → 可追踪 → 分级 → 可控制 ``` 生产环境不能靠 `show-sql` 全开,但也不能完全没有 SQL 日志。按包名和级别精细控制,才能在排障时看到真实 SQL,又不拖垮性能。 > 洞见不在多,在穿透表象 > H2 是温床,MySQL 是考场 > 连接池是盾,不是攻城锤 > 事务与日志,一收一放间 # 10、系统落地 ```text 入口:HTTP 请求 → Controller → Service → Repository → HikariCP → MySQL → 未实现:Flyway 迁移 ``` 原来 Petclinic 只有 H2 内存库,重启即丢数据。 本篇增加了 MySQL 持久化、HikariCP 连接池调优、显式事务边界、SQL 日志分级。 现在应用可以连接真实 MySQL,支持并发读写,连接生命周期可控。 下一篇缺的是数据库迁移管理。 `ddl-auto=update` 在开发期方便,在生产环境不可控。 需要引入 Flyway 或 Liquibase,把表结构变更纳入版本管理。 官方文档见 Spring Boot 文档首页和 Petclinic GitHub 仓库。 > 入口请求层层下,直到池中取连接 > 原来内存随启灭,如今 MySQL 持久存 > 本篇补上池与务,日志分级可追踪 > 下篇要管迁移事,表结构变更有版本 # 11、小结 ```text 三问三答:为什么 H2 正常 MySQL 出问题?选 H2 习惯还是生产校验?选错会怎样? ``` 为什么 H2 正常 MySQL 出问题?因为 H2 的宽松默认值掩盖了 SQL 方言、类型长度、事务边界和连接池配置四类差异。MySQL 严格模式让这些问题集中暴露。 选 H2 习惯还是生产校验?必须按生产数据库重新校验每一层自动配置。H2 的零配置体验不能迁移到 MySQL,连接池参数、事务注解、类型约束都要重新审视。 选错会怎样?连接池耗尽导致服务不可用,类型报错导致写库失败,事务缺失导致数据不一致,SQL 方言差异导致全表扫描。当前状态是 V2 已通过并发验证,连接生命周期可控,SQL 可追踪。 > 三问三答皆落地,不靠猜想来答题 > H2 宽松藏隐患,MySQL 严格见真章 > 生产校验不可省,层层配置要过堂 > 当前状态已可用,迁移管理待下章 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:为什么 HikariCP 的 maximum-pool-size 不是越大越好? 连接池过大意味着每个应用实例都持有大量数据库连接。 MySQL 每个连接消耗服务端线程和内存,连接数超过数据库承载能力后,上下文切换加剧,整体吞吐反而下降。 连接池的本质是客户端限流器,保护数据库不被压垮。 ## 实战题:把 Petclinic 的 Owner 实体 address 字段加上 @Column(length=500),并验证 MySQL 表结构变化。 在 `Owner` 实体的 `address` 字段上添加 `@Column(length=500)`,重启应用后执行 `SHOW CREATE TABLE owners`,确认 `address` 列变为 `varchar(500)`。 注意 `ddl-auto=update` 只加长不缩短,缩短长度需要手动迁移。 ## 排障题:压测时日志出现 HikariPool-1 - Connection is not available,如何定位是连接泄漏还是池太小? 先查 Hikari 指标,看活跃连接数是否长时间等于最大值。 如果活跃数一直满且请求结束后不回落,是连接泄漏,检查 Service 层是否漏写 `@Transactional`。 如果活跃数随请求波动但峰值触顶,是池太小,按 CPU 核数和数据库承载能力调大。 ## 架构判断题:生产环境能否继续使用 spring.jpa.hibernate.ddl-auto=update? 不能。`ddl-auto=update` 由 Hibernate 在启动时自动修改表结构,生产环境不可控。 它可能执行危险的 DDL,且无法回滚。 生产环境应使用 Flyway 或 Liquibase 管理数据库迁移,`ddl-auto` 设为 `validate` 或 `none`。 > 四题四层递进,从懂到做再到断 > 理解池中真意,实战改列验证 > 排障看指标分,架构判断守底线 > 作业不是终点,是下篇的起点 # 13、升华 ```text 工程结论:数据库切换不是改 URL,而是重新校验整条持久化链路的默认值 ``` 从 H2 到 MySQL,表面是 JDBC URL 的变化,实质是持久化链路从演示模式切换到生产模式。 连接池、事务、类型、方言、日志,每一层都要重新审视。 Spring Boot 的自动配置给了我们一条清晰的追踪路径,但默认值只保证“能启动”,不保证“能生产”。 下一篇将引入 Flyway,把数据库表结构变更纳入版本管理,让 Petclinic 的持久化层具备可迁移、可回滚、可审计的生产能力。 > 一条链路穿到底,层层默认要过堂 > 切换不是改地址,是换模式换心脏 > 自动配置给路径,生产校验给安全 > 下篇引入 Flyway,表结构变更有回响 **系列项目:** Spring 官方 Petclinic,服务宠物诊所的预约、宠物与兽医管理。 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系、Web 层、安全层、数据源切换 MySQL、连接池调优、事务边界、SQL 日志。 **本篇:** 沿 spring.datasource 到 MySQL 追踪 Data 自动配置,解决连接池、类型、事务、日志四类问题。 **下一篇:** 引入 Flyway 管理数据库迁移,替代 ddl-auto=update。

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第7招 Profile别变成配置垃圾场

# Profile 不是配置的垃圾桶:Petclinic 多环境配置治理实战 ```text 旧方案:一个 application.yml 塞满 local/test/prod 分支 冲突:环境越多,@Profile 和 if(prod) 越多 后果:配置像垃圾桶,改一处炸一片,新人不敢动 ``` Petclinic 从教学项目走向生产时,配置最先失控。 数据库、Redis、外部保险服务、可观测、安全策略在不同环境都不一样。 团队一开始把差异都写进同一个 application.yml,再用 spring.profiles.active 切换。 环境从 2 个涨到 5 个以后,文件超过 800 行,没人能说清一个开关会影响哪些服务。 我是老李,这次要带团队把 Petclinic 的配置从“能跑”治理到“能维护”。问题不是 Spring Boot 不支持多环境,而是我们把 Profile 当成了万能开关。 为什么 Profile 越建越多以后,配置系统反而越来越难理解? 是继续增加 Profile 和条件注解,还是把部署环境组合与模块化配置拆开? 如果选错,会不会出现生产配置被测试默认值悄悄覆盖,或者改一个业务开关要同时改五个文件? # 01、故事 ```text 周四 23:47 → 生产发布值班群 → 任务:切 production profile 上线保险服务 → 冲突:Redis 地址仍是 localhost ``` 周四晚上十一点四十七分,发布群突然弹消息。 任务是让 Petclinic 的生产环境启用外部保险服务,同时把数据库切到生产只读副本。 运维同学在 application.yml 里把 spring.profiles.active 改成 production,然后重启。 应用起来了,但日志里 Redis 连接一直报 Connection refused。我打开配置一看,Redis 的 host 还写着 localhost。生产环境根本没有本地 Redis。 群里开始催:为什么改个 profile 还会连本地?为什么测试环境好的配置到生产就失效?为什么没人知道 production 到底激活了哪些配置? > 夜深发布灯犹亮, > 一行配置改错行。 > 本地 Redis 连不上, > 才知环境已混装。 # 02、问题 ```text 需求变化:local/test/prod 都要独立配置 冲突:Profile 文件互相覆盖,默认值混进生产 后果:配置来源不唯一,排查靠猜,发布靠运气 ``` Petclinic 现在有三个部署环境:本地开发、测试集群、生产集群。 数据库、Redis、外部保险服务、可观测和安全策略都不同。 团队为每个环境建了 application-local.yml、application-test.yml、application-prod.yml。 但问题在于,很多公共配置还留在 application.yml 里。 比如 Redis host 默认写 localhost,生产文件里漏了覆盖,就出现故事里的故障。 更糟的是,有人开始在业务代码里写 if(prod) 来切换逻辑,配置和代码耦合越来越深。 失效原因是配置来源不唯一:默认文件、Profile 文件、环境变量、启动参数都能改同一个键,但优先级和覆盖关系没人梳理。 影响是生产事故风险高,每次发布都要靠人肉核对。 可验证的验收标准是:任意环境启动后,数据库、Redis、保险服务、安全策略的最终生效值都能从配置文件中唯一确定,不依赖启动顺序和默认值巧合。 > 环境三套各自忙, > 默认值里藏祸殃。 > 生产漏写一行字, > 本地配置上厅堂。 # 03、原理 ```text Profile 表达部署环境组合 → 不是模块开关 spring.profiles.active 激活环境 → profile-specific files 覆盖默认值 Profile Groups 组合多个环境 → spring.config.activate.on-profile 限定文件生效条件 ``` Spring Boot 的 Profile 机制本质是“条件化配置”。 spring.profiles.active 指定当前激活的环境名,application-{profile}.yml 会在主配置之后加载,同名键覆盖主配置。 这个顺序是固定的,但容易让人误以为“生产文件一定会覆盖所有默认值”。 实际上,如果生产文件里没有写某个键,主配置里的默认值仍然生效。 这就是 Redis 连 localhost 的根因。 反直觉的是:Profile 文件不是“完整替代”主配置,而是“增量覆盖”。 你越依赖默认值,生产配置就越不可预测。 Profile Groups 是 Spring Boot 2.4 之后的能力,允许用一个组名同时激活多个 Profile。 比如 production 组可以包含 prod、prod-db、prod-observability、prod-security。 这样部署时只写一个名字,但配置仍然分文件维护。 spring.config.activate.on-profile 则让一个文件只在特定 Profile 激活时生效,适合做条件化片段。 > 覆盖不是全替换, > 默认值里藏隐患。 > 组合环境成一键, > 文件边界要划断。 # 04、架构 ```text 输入:部署环境名 → 配置加载链 → 输出:唯一生效配置集 边界:application.yml 只放公共默认值,profile-specific 文件只放环境差异 ``` 治理后的配置架构分三层。 第一层是 application.yml,只放所有环境都相同的公共配置,比如应用名、通用日志格式。 第二层是 profile-specific 文件,每个文件只描述一个部署环境的差异,比如 application-prod-db.yml 只写生产数据库连接。 第三层是 Profile Group,把多个差异文件组合成一个部署环境。 这样做的收益是配置来源唯一:一个键要么在公共文件,要么在某个环境差异文件,不会同时出现在多个地方互相覆盖。代价是文件数量变多,需要约定命名规范。适用条件是部署环境之间有明确差异,且差异可以按模块拆分。 边界要划清楚:业务逻辑里禁止出现 if(prod)。如果某个行为需要按环境切换,应该用配置项驱动,而不是硬编码环境名。Profile 只表达“当前在哪运行”,不表达“代码该怎么走”。 > 公共默认归一处, > 环境差异各成书。 > 组合一键启生产, > 业务不写环境符。 # 05、第一版实战 ```text 环境:Spring Boot 3.2 + Java 17 → 配置:application.yml + 三个 profile 文件 → 代码:@Profile 注解 → 启动:local/test/prod → 验证:配置生效 → V1 ``` 先看当前 Petclinic 的依赖。pom.xml 里 Spring Boot 版本是 3.2.x,Java 17。配置文件结构如下: ```yaml # application.yml spring: application: name: petclinic datasource: url: jdbc:mysql://localhost:3306/petclinic username: root password: root data: redis: host: localhost port: 6379 insurance: base-url: http://localhost:8081 ``` ```yaml # application-local.yml spring: datasource: url: jdbc:mysql://localhost:3306/petclinic_local ``` ```yaml # application-test.yml spring: datasource: url: jdbc:mysql://test-db:3306/petclinic data: redis: host: test-redis ``` ```yaml # application-prod.yml spring: datasource: url: jdbc:mysql://prod-db:3306/petclinic username: prod_user password: ${DB_PASSWORD} insurance: base-url: https://insurance.prod.example.com ``` 启动命令: ```bash java -jar petclinic.jar --spring.profiles.active=prod ``` 验证请求: ```bash curl http://localhost:8080/actuator/env/spring.data.redis.host ``` 示例输出: ```json {"property":{"source":"application.yml","value":"localhost"}} ``` V1 成功标准是应用能启动,但 Redis 配置明显错误。生产环境没有 localhost Redis,这个值来自主配置的默认值,prod 文件里漏写了。 > 三套文件已分列, > 默认值里仍藏劣。 > 生产启动连本地, > 配置治理未了结。 # 06、排查 ```text 现象:prod 启动后 Redis 连 localhost 怀疑:prod 文件没覆盖 → 检查:actuator/env 看配置来源 → 证据:source 是 application.yml → 根因:默认值未被覆盖 ``` 第一个问题是 Redis host 错误。怀疑是 application-prod.yml 漏写。检查命令: ```bash curl http://localhost:8080/actuator/env/spring.data.redis.host ``` 示例输出: ```json {"property":{"source":"application.yml","value":"localhost"}} ``` 证据显示值来自 application.yml,说明 prod 文件没有覆盖这个键。 根因是团队把“公共默认值”和“环境差异”混在一起,导致生产文件不完整。 修复方式是在 prod 文件里补上 Redis 配置。 第二个问题是保险服务地址在 test 环境也指向了 localhost。检查命令: ```bash curl http://localhost:8080/actuator/env/insurance.base-url ``` 示例输出: ```json {"property":{"source":"application.yml","value":"http://localhost:8081"}} ``` 测试环境没有本地保险服务,这个默认值同样是错的。根因和第一个问题一样:默认值被当成“所有环境都能用”。 **错误尝试:** 一开始想在代码里判断 profile,如果 prod 就用生产地址,否则用本地地址。这样虽然能跑,但把环境判断写进了业务代码,后面每加一个环境都要改代码。 > 配置来源查得清, > 默认值里藏祸心。 > 莫把环境写进码, > 边界划好才安心。 # 07、优化 ```text V1:默认值混在 application.yml → 证据:actuator/env 显示 source 错误 → V2:公共默认值最小化 + 环境文件补全 ``` 优化第一步是把 application.yml 里的环境相关默认值全部移除,只保留真正公共的配置。数据库、Redis、保险服务这些有环境差异的键,必须在每个环境文件里显式写全。 ```yaml # application.yml spring: application: name: petclinic ``` ```yaml # application-local.yml spring: datasource: url: jdbc:mysql://localhost:3306/petclinic_local username: root password: root data: redis: host: localhost port: 6379 insurance: base-url: http://localhost:8081 ``` ```yaml # application-test.yml spring: datasource: url: jdbc:mysql://test-db:3306/petclinic username: test_user password: ${TEST_DB_PASSWORD} data: redis: host: test-redis port: 6379 insurance: base-url: http://insurance.test.example.com ``` ```yaml # application-prod.yml spring: datasource: url: jdbc:mysql://prod-db:3306/petclinic username: prod_user password: ${DB_PASSWORD} data: redis: host: prod-redis port: 6379 insurance: base-url: https://insurance.prod.example.com ``` 这样每个环境的完整配置都在自己的文件里,不再依赖主配置的默认值。验证命令: ```bash java -jar petclinic.jar --spring.profiles.active=prod curl http://localhost:8080/actuator/env/spring.data.redis.host ``` 示例输出: ```json {"property":{"source":"application-prod.yml","value":"prod-redis"}} ``` > 默认值里清干净, > 环境文件各写全。 > 配置来源唯一化, > 排查不再靠猜拳。 # 08、演进 ```text V2:环境文件完整 → 能力:配置来源唯一 → 遗留:文件变大,生产配置混杂多个模块 ``` V2 解决了默认值覆盖问题,但带来新问题:application-prod.yml 里同时包含数据库、Redis、保险服务、可观测、安全策略,文件超过 200 行。 每次改安全配置都要在数据库配置旁边翻找,模块边界模糊。 用 V1 同一组请求验证: ```bash curl http://localhost:8080/actuator/env/spring.data.redis.host curl http://localhost:8080/actuator/env/insurance.base-url ``` 示例输出: ```json {"property":{"source":"application-prod.yml","value":"prod-redis"}} {"property":{"source":"application-prod.yml","value":"https://insurance.prod.example.com"}} ``` 配置来源唯一了,但文件内部结构混乱。收益是排查快,代价是维护难。适用场景是环境少、差异小的情况。遗留问题是生产配置需要按模块拆分,同时保持一键激活。 > 来源唯一已达成, > 文件膨胀又生疼。 > 模块边界要划清, > 组合激活待启程。 # 09、洞见 ```text 从现象到判断:Profile 不是配置的垃圾桶 ``` ## Profile 应表达部署环境组合,而不是代替模块化配置 ```text Profile 数量增长 → 配置理解成本指数上升 ``` 当 Profile 既表示环境又表示模块时,组合数量爆炸。 比如 prod、prod-db、prod-redis、prod-security 同时存在,没人知道 prod 到底包含哪些。 正确做法是 Profile 只表示部署环境,模块差异用文件拆分,再用 Profile Group 组合。 ## 反直觉判断:默认值越少,配置系统越安全 ```text 默认值多 → 覆盖链长 → 生产事故概率高 ``` 很多人觉得默认值方便,少写几行。但默认值会让配置来源不唯一,生产环境可能悄悄继承开发环境的地址。把默认值最小化,强制每个环境显式声明,反而更安全。 ## 反直觉判断:if(prod) 是配置治理失败的信号 ```text 业务代码出现环境判断 → 配置边界已经失守 ``` 如果代码里需要判断当前是不是生产环境,说明有行为差异没有通过配置表达。应该把差异抽成配置项,让代码只读配置,不关心环境名。这样测试环境可以模拟生产行为,生产环境也可以安全切换。 ## Profile Group 的价值在于“一键组合”,不是“多建几个 Profile” ```text production 组 → prod-db + prod-observability + prod-security ``` Group 让部署命令保持简单,同时配置文件可以按模块维护。一个 production 名字背后是多个文件的组合,但每个文件只关心自己的模块。这样加一个可观测配置,不需要动数据库配置。 > 环境组合是正道, > 模块配置各成书。 > 默认值少才安全, > 业务不写环境符。 # 10、系统落地 ```text 入口:部署命令 --spring.profiles.active=production → 服务:Petclinic 应用 → 本模块:Profile Group 组合配置 → 存储:数据库/Redis/保险服务 → 未实现:配置加密与动态刷新 ``` 原来 Petclinic 只有 application.yml 和几个零散的 profile 文件,配置来源混乱。 本篇增加了 Profile Group 机制,把生产环境拆成 prod-db、prod-observability、prod-security 三个模块文件,再用 production 组一键激活。 现在能做的事情:部署时只写一个环境名,配置文件按模块维护,每个键的来源唯一可查。下一篇缺的是配置加密和动态刷新能力,生产密码目前还是明文环境变量。 官方文档可参考 Spring Boot 官方文档首页:https://docs.spring.io/spring-boot/index.html > 一键组合生产境, > 模块文件各分明。 > 配置来源可追溯, > 加密刷新待前行。 # 11、小结 ```text 三问三答:Profile 为何难懂?如何选择?选错后果? ``` 第一问:为什么 Profile 越建越多以后,配置系统反而越来越难理解?因为 Profile 被同时用来表示环境和模块,组合爆炸,覆盖链变长,来源不唯一。 第二问:是继续增加 Profile 和条件注解,还是把部署环境组合与模块化配置拆开?应该拆开。Profile 只表示部署环境,模块差异用独立文件,再用 Profile Group 组合。 第三问:选错会怎样? 会出现生产配置被默认值覆盖、业务代码里到处 if(prod)、改一个开关要动五个文件。 当前状态是配置来源已唯一,生产环境通过 production 组一键激活,但配置加密和动态刷新还没做。 > 三问已答心自明, > 环境模块要分清。 > 组合一键启生产, > 配置治理路渐平。 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:spring.profiles.active 和 spring.config.activate.on-profile 有什么区别? spring.profiles.active 是启动时指定激活哪些 Profile,属于入口配置。 spring.config.activate.on-profile 是写在配置文件内部,声明这个文件只在特定 Profile 激活时生效。 前者决定“激活谁”,后者决定“谁被激活时加载”。 ## 实战题:把 Petclinic 的生产配置拆成 prod-db、prod-observability、prod-security 三个文件,并用 production 组组合。 创建 application-prod-db.yml、application-prod-observability.yml、application-prod-security.yml,分别写数据库、可 观测、安全配置。 然后在 application.yml 里定义: ```yaml spring: profiles: group: production: - prod-db - prod-observability - prod-security ``` 启动时用 --spring.profiles.active=production 验证三个文件的配置都生效。 ## 排障题:生产环境启动后,数据库连接池一直报连接超时,但配置里写的是 prod-db,怎么排查? 先查配置来源: ```bash curl http://localhost:8080/actuator/env/spring.datasource.url ``` 看 source 是哪个文件。 如果 source 是 application.yml,说明 prod-db 文件没被激活,检查 Profile Group 定义和启动参数。 如果 source 正确但还超时,检查网络策略和数据库白名单。 ## 架构判断题:团队想在代码里用 @Profile("prod") 来切换保险服务的调用逻辑,应该支持吗? 不应该。@Profile 用在 Bean 定义上可以,但用来切换业务逻辑会把环境判断写进代码。 正确做法是把差异抽成配置项,比如 insurance.mode=real 或 mock,代码只读配置。 这样测试环境可以模拟生产行为,生产环境也能安全切换。 > 理解实战排障题, > 架构判断要清晰。 > 环境不写业务里, > 配置治理见真章。 # 13、升华 ```text 工程结论:Profile 是部署环境的组合开关,不是配置的垃圾桶 ``` Petclinic 的配置治理证明了一件事:配置系统的复杂度不取决于 Profile 的数量,而取决于边界是否清晰。 把部署环境组合和模块化配置拆开,用 Profile Group 做一键激活,才能让配置可维护、可追溯、可发布。 下一篇要把生产密码从明文环境变量升级为配置加密,并引入动态刷新能力,让配置变更不再需要重启应用。 > 环境组合是正道, > 模块配置各成书。 > 一键激活生产境, > 配置治理路已铺。 **系列项目:** Spring 官方 Petclinic 演进为生产级 Spring Boot 4 Java 应用 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系基础 **本篇:** 多环境 Profile 治理与 Profile Group 组合 **下一篇:** 配置加密与动态刷新

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第8招 Web请求完整走一遍

# Owner 查询 JSON API:从 HTTP 到 Response 的完整调用链 ```text 旧方案:仅返回 Thymeleaf 视图,无标准 JSON API 冲突:前端/第三方需要结构化数据,但现有 Controller 只返回视图名 后果:无法复用业务逻辑,接口契约不清晰,错误响应格式不统一 ``` Petclinic 官方项目默认面向服务端渲染,OwnerController 的查询方法返回 ModelAndView 或视图名。 当团队需要给移动端、管理后台或开放平台提供 Owner 查询能力时,直接复用现有 Controller 会暴露 HTML 片段,而不是结构化 JSON。 我是老李,今天要带你把 Owner 查询改造成标准 JSON API,并且把 HTTP 请求从进入 Tomcat 到最终返回 Response 的每一层都追清楚。 为什么 Controller 里只写了一句 return owner,最终客户端却能收到一个完整的 HTTP JSON Response? 是继续在现有 Controller 上增加 @ResponseBody,还是单独建立 ApiController 并引入 DTO、校验和统一异常处理? 如果选错,会不会出现实体直接序列化导致循环引用、校验错误返回 500、或者 404 与业务异常格式不一致的问题? # 01、故事 ```text 周二 14:30 → 研发区 → 给运营后台提供 Owner 查询接口 → 前端催接口、现有代码只返回 HTML ``` 周二下午两点半,我坐在研发区,任务是给运营后台提供一个按 ID 查询 Owner 的 JSON 接口。 前端同事在群里催:“接口什么时候好?我现在拿到的全是 HTML 片段,根本没法解析。” 我打开 Petclinic 的 OwnerController,发现查询方法返回的是视图名,数据通过 Model 传给 Thymeleaf 渲染。 如果直接加 @ResponseBody 返回 Owner 实体,又担心宠物集合被序列化出一大堆嵌套对象,甚至可能出现循环引用。 > 午后工位催声急, > 旧日视图难解意。 > 欲把主人成数据, > 却愁嵌套无穷已。 # 02、问题 ```text 需求变化:服务端渲染 → 标准 JSON API 冲突:Controller 返回视图,实体直接序列化风险高 后果:接口不可用、错误格式混乱、前后端联调成本高 ``` 现有 OwnerController 的查询逻辑绑定视图渲染,无法直接满足 JSON 接口需求。 如果直接返回 Owner 实体,JPA 关联的 pets、visits 可能被 Jackson 深度序列化,导致响应体膨胀、性能下降,甚至双向关联引发循环引用。 同时,参数缺失、ID 不存在、业务校验失败等场景没有统一的错误结构,前端需要针对不同状态码和响应体写多套解析逻辑。 可验证的验收标准是:GET /api/owners/{id} 返回标准 JSON; 参数错误返回 400; 不存在返回 404; 业务异常返回 409; 未预期异常返回 500,且错误体符合 Problem Detail 规范。 > 视图转身成接口, > 实体裸奔隐患久。 > 错误若还无定式, > 联调终夜空白首。 # 03、原理 ```text HTTP → Tomcat → Filter → DispatcherServlet → HandlerMapping → HandlerAdapter → ArgumentResolver → Validation → Controller → Service → MessageConverter → Response ``` Spring MVC 的核心是 DispatcherServlet,它把请求分发给 HandlerMapping 找到的处理器,再由 HandlerAdapter 完成参数解析、校验、调用和返回值处理 。 Controller 方法返回的 Owner 对象并不是 HTTP 响应本身,它只是返回值。 真正把它变成 JSON 的是 HttpMessageConverter,Spring Boot 默认配置了 MappingJackson2HttpMessageConverter。 一个反直觉判断是:Controller 里那句 return owner 并没有“发送响应”,它只是把对象交给框架,框架在方法返回后才开始序列化和写响应。 另一个反直觉判断是:@Valid 校验失败抛出的 MethodArgumentNotValidException 如果不在统一异常处理中捕获,默认会变成 500,而不是 400。 > 一句返回非终点, > 框架接力方成全。 > 校验若无人接住, > 五百错把四百演。 # 04、架构 ```text 输入:GET /api/owners/{id} 本模块:ApiController → OwnerRequest/Response DTO → Validation → OwnerService → ExceptionHandler → ProblemDetail 输出:标准 JSON + 正确 HTTP Status 边界:不直接暴露 JPA 实体,不把业务异常泄漏到客户端 ``` 本模块分为四层:Controller 负责接收 HTTP 请求并调用 Service; DTO 负责请求和响应契约; Service 复用现有业务逻辑; ExceptionHandler 负责把异常映射为 Problem Detail。 Controller 不直接返回 Owner 实体,而是返回 OwnerResponse DTO,这样可以把 JPA 关联关系隔离在服务层内部。 统一异常处理放在 @RestControllerAdvice 中,分别处理参数校验失败、资源不存在、业务冲突和未预期异常。 收益是接口契约清晰、错误格式统一、实体演化不影响外部 API。 代价是增加 DTO 映射代码,且需要明确哪些异常映射到哪些 HTTP 状态码。 适用条件是系统需要对外提供 JSON API,或前后端分离后需要稳定契约。 > 实体深藏服务内, > 契约只露薄薄层。 > 异常各有归处去, > 状态分明不误人。 # 05、第一版实战 ```text 环境:Spring Boot 4 + Java 21 + Maven 配置:pom.xml 引入 spring-boot-starter-web、spring-boot-starter-validation、spring-boot-starter-data-jpa 代码:OwnerResponse、OwnerRequest、ApiOwnerController、GlobalExceptionHandler 启动:mvn spring-boot:run 验证:curl GET /api/owners/1 V1:返回 OwnerResponse JSON,但错误处理不完整 ``` 先确认 pom.xml 包含 Web、Validation 和 JPA 依赖。 ```xml org.springframework.boot spring-boot-starter-web org.springframework.boot spring-boot-starter-validation org.springframework.boot spring-boot-starter-data-jpa ``` 创建 OwnerResponse DTO,只暴露必要字段。 ```java public record OwnerResponse( Long id, String firstName, String lastName, String address, String city, String telephone ) { } ``` 创建 ApiOwnerController,返回 DTO 而不是实体。 ```java @RestController @RequestMapping("/api/owners") public class ApiOwnerController { private final OwnerService ownerService; public ApiOwnerController(OwnerService ownerService) { this.ownerService = ownerService; } @GetMapping("/{id}") public OwnerResponse getOwner(@PathVariable Long id) { Owner owner = ownerService.findOwnerById(id); return new OwnerResponse( owner.getId(), owner.getFirstName(), owner.getLastName(), owner.getAddress(), owner.getCity(), owner.getTelephone() ); } } ``` 启动应用。 ```bash mvn spring-boot:run ``` 验证正常查询。 ```bash curl -i http://localhost:8080/api/owners/1 ``` 示例输出: ```text HTTP/1.1 200 Content-Type: application/json {"id":1,"firstName":"George","lastName":"Franklin","address":"110 W. Liberty St.","city":"Madison","telephone":"6085551023"} ``` V1 成功返回 JSON,但此时如果传入非数字 ID,会触发 500;如果 ID 不存在,也会因为 Service 抛异常而返回 500。 > 初版接口已成形, > 正常路径走得通。 > 只是错误无人管, > 五百乱象隐其中。 # 06、排查 ```text 诊断树 ├── 参数类型错误 → 怀疑 MethodArgumentTypeMismatchException → 检查默认异常处理 → 证据:返回 500 → 根因:未捕获该异常 ├── ID 不存在 → 怀疑 Service 抛 NoSuchElementException → 检查响应 → 证据:返回 500 → 根因:未映射为 404 └── 业务校验失败 → 怀疑 Service 抛 IllegalStateException → 检查响应 → 证据:返回 500 → 根因:未映射为 409 ``` 第一个问题是传入非数字 ID。 ```bash curl -i http://localhost:8080/api/owners/abc ``` 示例输出: ```text HTTP/1.1 500 {"timestamp":"...","status":500,"error":"Internal Server Error","path":"/api/owners/abc"} ``` 怀疑是 MethodArgumentTypeMismatchException 没有被处理。 检查日志,看到异常堆栈: ```text Failed to convert value of type 'java.lang.String' to required type 'java.lang.Long' ``` 根因是 Spring 默认把类型转换失败当作未预期异常,返回 500。 第二个问题是 ID 不存在。 ```bash curl -i http://localhost:8080/api/owners/9999 ``` 示例输出: ```text HTTP/1.1 500 {"timestamp":"...","status":500,"error":"Internal Server Error","path":"/api/owners/9999"} ``` 怀疑是 Service 抛出的 NoSuchElementException 没有被映射。 检查 Service 实现,发现 findOwnerById 内部使用 Optional.orElseThrow()。 根因是异常直接冒泡到容器,被默认 500 处理。 **错误尝试:** 我一开始在 Controller 里用 try-catch 捕获所有异常并手动构造 ResponseEntity,结果每个方法都重复大量样板代码,而且状态码散落各处,难以统一维护。 > 参数错时五百现, > 资源不在也同面。 > 若在方法里捕尽, > 样板成灾更难辨。 # 07、优化 ```text V1:正常路径可用,错误路径全部 500 证据:curl 参数错误、不存在 ID 均返回 500 V2:引入 @RestControllerAdvice + ProblemDetail,统一映射 400/404/409/500 ``` 创建 GlobalExceptionHandler,集中处理四类异常。 ```java @RestControllerAdvice public class GlobalExceptionHandler { @ExceptionHandler(MethodArgumentTypeMismatchException.class) public ProblemDetail handleTypeMismatch(MethodArgumentTypeMismatchException ex) { ProblemDetail pd = ProblemDetail.forStatusAndDetail( HttpStatus.BAD_REQUEST, "参数类型错误: " + ex.getName() ); pd.setTitle("Bad Request"); return pd; } @ExceptionHandler(NoSuchElementException.class) public ProblemDetail handleNotFound(NoSuchElementException ex) { ProblemDetail pd = ProblemDetail.forStatusAndDetail( HttpStatus.NOT_FOUND, "Owner 不存在" ); pd.setTitle("Not Found"); return pd; } @ExceptionHandler(IllegalStateException.class) public ProblemDetail handleConflict(IllegalStateException ex) { ProblemDetail pd = ProblemDetail.forStatusAndDetail( HttpStatus.CONFLICT, ex.getMessage() ); pd.setTitle("Conflict"); return pd; } @ExceptionHandler(Exception.class) public ProblemDetail handleGeneric(Exception ex) { ProblemDetail pd = ProblemDetail.forStatusAndDetail( HttpStatus.INTERNAL_SERVER_ERROR, "服务器内部错误" ); pd.setTitle("Internal Server Error"); return pd; } } ``` 同时让 Service 在业务校验失败时抛出 IllegalStateException,而不是返回 null 或布尔值。 这样 Controller 保持简洁,所有错误路径都汇聚到 GlobalExceptionHandler。 > 异常汇聚一处管, > 状态分明各有安。 > 四百四百零九, > 五百不再乱纠缠。 # 08、演进 ```text V2:统一异常处理 + Problem Detail 能力:标准 JSON 契约、稳定错误格式、可扩展异常映射 遗留:校验异常尚未覆盖,请求体校验需后续补充 ``` 用 V1 同一组请求验证 V2。 正常查询: ```bash curl -i http://localhost:8080/api/owners/1 ``` 示例输出: ```text HTTP/1.1 200 Content-Type: application/json {"id":1,"firstName":"George","lastName":"Franklin","address":"110 W. Liberty St.","city":"Madison","telephone":"6085551023"} ``` 参数类型错误: ```bash curl -i http://localhost:8080/api/owners/abc ``` 示例输出: ```text HTTP/1.1 400 Content-Type: application/problem+json {"type":"about:blank","title":"Bad Request","status":400,"detail":"参数类型错误: id","instance":"/api/owners/abc"} ``` ID 不存在: ```bash curl -i http://localhost:8080/api/owners/9999 ``` 示例输出: ```text HTTP/1.1 404 Content-Type: application/problem+json {"type":"about:blank","title":"Not Found","status":404,"detail":"Owner 不存在","instance":"/api/owners/9999"} ``` 收益是前端只需识别 Content-Type 和 status,就能统一解析错误。 代价是 GlobalExceptionHandler 需要持续维护异常映射,避免把所有异常都归为 500。 遗留问题是当前只有路径参数,还没有覆盖请求体校验,例如创建 Owner 时的 @Valid 校验失败。 > 同组请求再验证, > 状态分明各归位。 > 契约稳定前端喜, > 遗留校验待下回。 # 09、洞见 ```text 从现象到判断:Controller 返回对象 ≠ HTTP 响应;异常映射决定 API 成熟度 ``` ## Controller 的 return 只是返回值,不是响应 ```text Controller → return Owner → HandlerAdapter → MessageConverter → HTTP Response ``` 很多人以为 return 语句执行完响应就发出了,实际上 return 只是把对象交给框架。 真正的序列化和响应写入发生在方法返回之后,由 HttpMessageConverter 完成。 这解释了为什么 Controller 里只有一句 return owner,客户端却能收到完整 JSON。 ## 反直觉判断:默认异常处理会把很多客户端错误变成 500 ```text 参数类型错误 → 默认 500 → 实际应为 400 ``` Spring Boot 的默认错误处理对未捕获异常统一返回 500,即使根因是客户端传错参数。 如果不显式映射 MethodArgumentTypeMismatchException,前端会误以为服务器故障。 统一异常处理不是可选优化,而是 JSON API 的基本能力。 ## 反直觉判断:DTO 不是多余代码,而是契约边界 ```text 实体直接序列化 → 关联爆炸/循环引用 → DTO 隔离 → 契约稳定 ``` 直接返回 JPA 实体看似省事,但会把持久化细节泄漏到 API。 DTO 的映射代码虽然增加,但换来的是外部契约与内部模型解耦。 当实体增加字段或调整关联时,API 可以保持稳定。 ## Problem Detail 让错误从“状态码”升级为“可读文档” ```text 错误响应 → title + status + detail + instance → 前端可统一处理 ``` Problem Detail 规范让错误响应包含人类可读的 title、机器可读的 status、具体 detail 和发生路径 instance。 前端可以只写一个错误解析器,而不需要为每个接口单独适配。 > 返回非响应须明辨, > 异常映射定成熟。 > 契约边界靠 DTO, > 错误文档解百忧。 # 10、系统落地 ```text 入口:GET /api/owners/{id} 服务:ApiOwnerController → OwnerService → OwnerRepository 本模块:DTO 映射、统一异常处理、Problem Detail 存储:H2/MySQL 中的 owners 表 未实现:请求体校验、创建/更新 API、分页查询 ``` 原来 Petclinic 只有服务端渲染的 Owner 查询,没有标准 JSON API。 本篇增加了 ApiOwnerController、OwnerResponse DTO 和 GlobalExceptionHandler,使系统具备对外提供 Owner 查询 JSON 接口的能力。 现在前端可以通过 GET /api/owners/{id} 获取结构化数据,并且错误响应统一为 Problem Detail 格式。 下一篇需要补充创建和更新 Owner 的 JSON API,并引入请求体 DTO 与 Bean Validation。 官方文档可参考 Spring 官网 https://spring.io 和 Petclinic 仓库 https://github.com/spring-projects/spring-petclin ic 。 > 旧日视图今成 API, > 查询一路到存储。 > 错误统一契约稳, > 创建更新待下章。 # 11、小结 ```text 三问三答:return 如何变响应;是否新建 ApiController;选错后果 ``` 第一问:Controller 里只写了一句 return owner,为什么最终能变成完整 HTTP JSON Response? 因为 return 只是把对象交给 HandlerAdapter,后续由 MappingJackson2HttpMessageConverter 序列化为 JSON,并写入 HTTP 响应体。 第二问:是继续在现有 Controller 上增加 @ResponseBody,还是单独建立 ApiController? 单独建立 ApiController 更合适,因为服务端渲染和 JSON API 的返回类型、异常策略、契约要求不同,分离后各自演化更清晰。 第三问:如果选错会怎样? 如果直接返回实体会导致关联爆炸或循环引用;如果不做统一异常处理,参数错误和 404 都会变成 500,前端无法区分客户端错误和服务端故障。 当前状态是 Owner 查询 JSON API 已可用,错误响应符合 Problem Detail,但创建、更新和请求体校验尚未实现。 > 一句返回非终点, > 框架接力方成全。 > 分离接口避旧债, > 统一异常保平安。 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:为什么 @RestController 的方法返回对象后,客户端能收到 JSON? 因为 @RestController 组合了 @ResponseBody,HandlerAdapter 在方法返回后调用 HttpMessageConverter 将返回值序列化为 JSON,再写入 HTTP 响应体。 ## 实战题:为 Petclinic 增加 GET /api/owners?lastName=xxx 的查询接口,返回 List,并处理空结果。 创建 ApiOwnerController 中的查询方法,调用 OwnerService 按 lastName 查询,空结果返回空列表和 200,而不是 404。 ## 排障题:调用 GET /api/owners/abc 返回 500,但日志显示 MethodArgumentTypeMismatchException,如何修复? 在 GlobalExceptionHandler 中增加 @ExceptionHandler(MethodArgumentTypeMismatchException.class),返回 400 和 P roblemDetail,而不是让它冒泡到默认 500 处理。 ## 架构判断题:如果前端要求返回 Owner 的所有 pets 和 visits,是否应该直接返回 Owner 实体? 不应该。应该为这个需求单独设计包含 pets 和 visits 的 DTO,避免实体直接序列化带来的关联爆炸和循环引用,同时保持 API 契约稳定。 > 理解框架接力链, > 实战查询列表添。 > 排障须看异常类, > 架构判断守边界。 # 13、升华 ```text 工程结论:JSON API 的成熟度取决于契约、校验和错误处理,而不是能否返回 JSON ``` 能返回 JSON 只是起点,真正的工程能力在于稳定契约、明确校验和统一错误处理。 Controller 的 return 只是调用链中的一个环节,理解从 HTTP 到 Response 的完整路径,才能在排障时快速定位问题。 下一篇将引入请求体 DTO 和 Bean Validation,把创建 Owner 的 JSON API 落地,并覆盖校验失败的错误映射。 > 能返 JSON 非终点, > 契约校验方为全。 > 调用链中明因果, > 排障定位不茫然。 **系列项目:** Spring 官方 Petclinic 演进为生产级 Spring Boot 4 Java 应用 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系、Web 基础、安全、数据、事务、远程调用、数据库迁移、缓存、并发、日志、测试、Testcontainers、Docker Compose、Actuator、可观测、自定义自动配置、容器构建、生产上线 **本篇:** Owner 查询标准 JSON API、DTO、统一异常处理、Problem Detail、HTTP 状态码映射 **下一篇:** Owner 创建与更新 JSON API、请求体 DTO、Bean Validation、校验错误映射
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册