首页 文章 精选 留言 我的

精选列表

搜索[字节级],共10000篇文章
优秀的个人博客,低调大师

Jmix 1.5.1 发布 - 企业级Web快速开发框架

Jmix Web 快速开发框架 1.5.1 发布,该补丁版本中主要包含了 Bug 修复,推荐升级: 💥 主要新功能: - 支持 Spring Boot 2.7.10 - 组件工具箱支持 PivotTable(透视表) - 在 Studio 中添加表格类型组件默认 100% 宽度 - Quartz 任务管理界面按钮支持本地化 🛠️ 主要 Bug 修复: - PresentationProvider 在某些情况下应用两次的问题 - 组件 enable 属性不支持的问题 - 通知组件为替代用户展示错误通知的问题 - 扩展组件中运行测试由于 Liquibase 脚本导致失败的问题 - URL 参数值中带有 “&” 符号导致解析失败的问题 - 一些 Flow UI 相关的修复 详细修复的问题列表,请参考 Jmix GitHub: https://github.com/jmix-framework/jmix/issues?q=is%3Aclosed+milestone%3A1.5.1 🔑 Jmix 是一个覆盖应用程序全生命周期的 Java 少代码快速开发平台。以 Spring Boot 作为开源基础框架,提供过程中的 Studio 开发工具以及开箱即用的扩展组件。通过 Jmix 实现您的数字化愿景,无低代码平台限制,无供应商依赖,无需按用户付费。 资源:👉🏻 Jmix 适合我吗? 👉🏻 中文官网

优秀的个人博客,低调大师

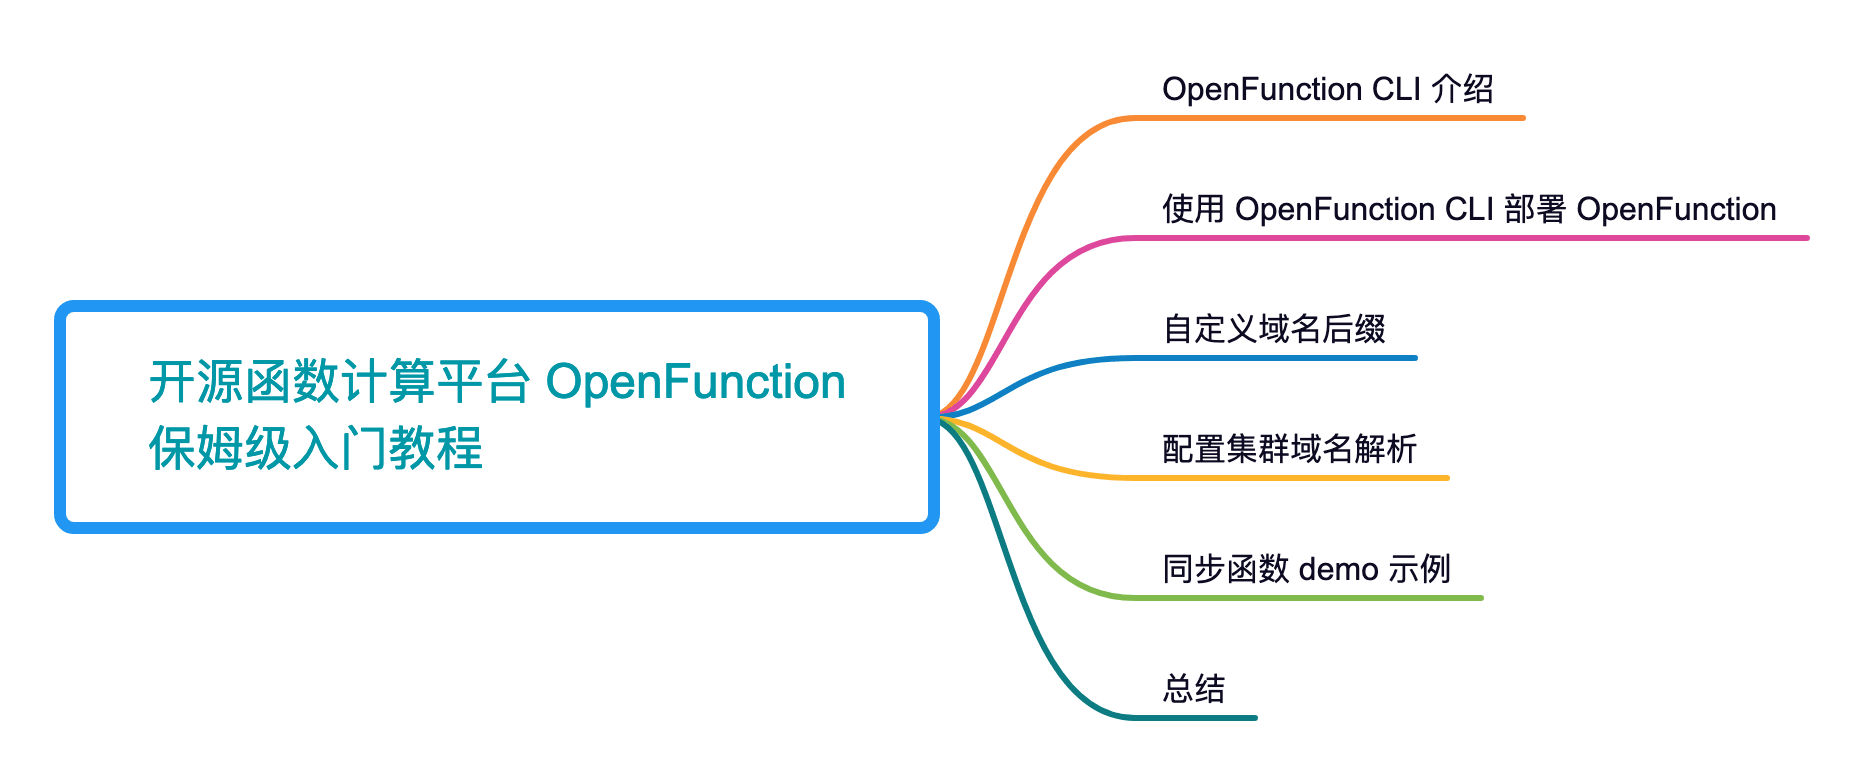
开源函数计算平台 OpenFunction 保姆级入门教程

OpenFunction 0.6.0 上周已经正式发布了,带来了许多值得注意的功能,包括函数插件、函数的分布式跟踪、控制自动缩放、HTTP 函数触发异步函数等。同时,异步运行时定义也被重构了。核心 API 也已经从 v1alpha1 升级到 v1beta1。<br> 官宣链接🔗:https://openfunction.dev/blog/2022/03/25/announcing-openfunction-0.6.0-faas-observability-http-trigger-and-more/ 近年来,随着无服务器计算的兴起,出现了很多非常优秀的 Serverless 开源项目,其中比较杰出的有 Knative 和 OpenFaaS。但 Knative Serving 仅仅能运行应用,还不能运行函数,而 Serverless 的核心是函数计算,也就是 FaaS,因此比较遗憾;OpenFaaS 虽然很早就出圈了,但技术栈过于老旧,不能满足现代化函数计算平台的需求。 OpenFunction 便是这样一个现代化的云原生 FaaS(函数即服务)框架,它引入了很多非常优秀的开源技术栈,包括 Knative、Tekton、Shipwright、Dapr、KEDA 等,这些技术栈为打造新一代开源函数计算平台提供了无限可能: Shipwright 可以在函数构建的过程中让用户自由选择和切换镜像构建的工具,并对其进行抽象,提供了统一的 API; Knative 提供了优秀的同步函数运行时,具有强大的自动伸缩能力; KEDA 可以基于更多类型的指标来自动伸缩,更加灵活; Dapr 可以将不同应用的通用能力进行抽象,减轻开发分布式应用的工作量。 本文不打算讲一些非常高深的理论,作为刚跨进 Serverless 门槛的用户,更需要的是如何快速上手,以便对函数计算有一个感性的认知,在后续使用的过程中,咱们再慢慢理解其中的架构和设计。 本文将会带领大家快速部署和上手 OpenFunction,并通过一个 demo 来体验同步函数是如何运作的。 OpenFunction CLI 介绍 OpenFunction 从 0.5 版本开始使用全新的命令行工具 ofn 来安装各个依赖组件,它的功能更加全面,支持一键部署、一键卸载以及 Demo 演示的功能。用户可以通过设置相应的参数自定义地选择安装各个组件,同时可以选择特定的版本,使安装更为灵活,安装进程也提供了实时展示,使得界面更为美观。它支持的组件和其依赖的 Kubernetes 版本如下: Components Kubernetes 1.17 Kubernetes 1.18 Kubernetes 1.19 Kubernetes 1.20+ Knative Serving 0.21.1 0.23.3 0.25.2 1.0.1 Kourier 0.21.0 0.23.0 0.25.0 1.0.1 Serving Default Domain 0.21.0 0.23.0 0.25.0 1.0.1 Dapr 1.5.1 1.5.1 1.5.1 1.5.1 Keda 2.4.0 2.4.0 2.4.0 2.4.0 Shipwright 0.6.1 0.6.1 0.6.1 0.6.1 Tekton Pipelines 0.23.0 0.26.0 0.29.0 0.30.0 Cert Manager 1.5.4 1.5.4 1.5.4 1.5.4 Ingress Nginx na na 1.1.0 1.1.0 <center>表一 OpenFunction 使用的第三方组件依赖的 Kubernetes 版本</center> <br> ofn 的安装参数 `ofn install` 解决了 OpenFunction 和 Kubernetes 的兼容问题,会自动根据 Kubernetes 版本选择兼容组件进行安装,同时提供多种参数以供用户选择。 参数 功能 --all 用于安装 OpenFunction 及其所有依赖。 --async 用于安装 OpenFunction 的异步运行时(Dapr & Keda)。 --cert-manager * 用于安装 Cert Manager。 --dapr * 用于安装 Dapr。 --dry-run 用于提示当前命令所要安装的组件及其版本。 --ingress * 用于安装 Ingress Nginx。 --keda * 用于安装 Keda。 --knative 用于安装 Knative Serving(以Kourier为默认网关) --region-cn 针对访问 gcr.io 或 github.com 受限的用户。 --shipwright * 用于安装 ShipWright。 --sync 用于安装 OpenFunction Sync Runtime(待支持)。 --upgrade 在安装时将组件升级到目标版本。 --verbose 显示粗略信息。 --version 用于指定要安装的 OpenFunction 的版本。(默认为 "v0.6.0") --timeout 设置超时时间。默认为5分钟。 <center>表二 install 命令参数列表</center> 使用 OpenFunction CLI 部署 OpenFunction 有了命令行工具 ofn 之后,OpenFunction 部署起来非常简单。首先需要安装 ofn,以 amd64 版本的 Linux 为例,仅需两步即可: 1、下载 ofn $ wget -c https://github.com/OpenFunction/cli/releases/download/v0.5.1/ofn_linux_amd64.tar.gz -O - | tar -xz 2、为 ofn 赋予权限并移动到 /usr/local/bin/ 文件夹下。 $ chmod +x ofn && mv ofn /usr/local/bin/ 安装好 ofn 之后,仅需一步即可完成 OpenFunction 的安装。虽然使用 --all 选项可以安装所有组件,但我知道大部分小伙伴的真实需求是不想再额外装一下 Ingress Controller 的,这个也好办,我们可以直接指定需要安装的组件,排除 ingress,命令如下: $ ofn install --knative --async --shipwright --cert-manager --region-cn Start installing OpenFunction and its dependencies. The following components will be installed: +------------------+---------+ | COMPONENT | VERSION | +------------------+---------+ | OpenFunction | 0.6.0 | | Keda | 2.4.0 | | Dapr | 1.5.1 | | Shipwright | 0.6.1 | | CertManager | 1.5.4 | | Kourier | 1.0.1 | | DefaultDomain | 1.0.1 | | Knative Serving | 1.0.1 | | Tekton Pipelines | 0.30.0 | +------------------+---------+ ✓ Dapr - Completed! ✓ Keda - Completed! ✓ Knative Serving - Completed! ✓ Shipwright - Completed! ✓ Cert Manager - Completed! ✓ OpenFunction - Completed! 🚀 Completed in 2m47.901328069s. ██████╗ ██████╗ ███████╗███╗ ██╗ ██╔═══██╗██╔══██╗██╔════╝████╗ ██║ ██║ ██║██████╔╝█████╗ ██╔██╗ ██║ ██║ ██║██╔═══╝ ██╔══╝ ██║╚██╗██║ ╚██████╔╝██║ ███████╗██║ ╚████║ ╚═════╝ ╚═╝ ╚══════╝╚═╝ ╚═══╝ ███████╗██╗ ██╗███╗ ██╗ ██████╗████████╗██╗ ██████╗ ███╗ ██╗ ██╔════╝██║ ██║████╗ ██║██╔════╝╚══██╔══╝██║██╔═══██╗████╗ ██║ █████╗ ██║ ██║██╔██╗ ██║██║ ██║ ██║██║ ██║██╔██╗ ██║ ██╔══╝ ██║ ██║██║╚██╗██║██║ ██║ ██║██║ ██║██║╚██╗██║ ██║ ╚██████╔╝██║ ╚████║╚██████╗ ██║ ██║╚██████╔╝██║ ╚████║ ╚═╝ ╚═════╝ ╚═╝ ╚═══╝ ╚═════╝ ╚═╝ ╚═╝ ╚═════╝ ╚═╝ ╚═══╝ 虽然本文演示的是同步函数,但这里把异步运行时也装上了,如果你不需要,可以把 --async 这个参数去掉,不影响本文的实验。 安装完成后,会创建这几个 namespace: $ kubectl get ns NAME STATUS AGE cert-manager Active 17m dapr-system Active 4m34s io Active 3m31s keda Active 4m49s knative-serving Active 4m41s kourier-system Active 3m57s openfunction Active 3m37s shipwright-build Active 4m26s tekton-pipelines Active 4m50s 每个 namespace 对应上面安装的各个组件。目前 OpenFunction 的 Webhook 需要使用 CertManager 来验证 API 访问,后续我们会去掉这个依赖,不再需要安装 CertManager。 自定义域名后缀 Knative Serving 目前使用 Kourier 作为入口网关,由于我们没有部署 Ingress Controller,所以我们访问函数只有 Kourier 这一个入口。 Kourier 是一个基于 Envoy Proxy 的轻量级网关,是专门对于 Knative Serving 服务访问提供的一个网关实现。关于 Envoy 控制平面的细节本文不作赘述,感兴趣的可以去阅读 Kourier 官方文档和源码。这里我们只需要知道 Kourier 会为函数访问提供一个入口,这个访问入口是通过域名来提供的,我们要做的工作就是将相关域名解析到 Kourier 的 ClusterIP。 Kourier 默认创建了两个 Service: $ kubectl -n kourier-system get svc NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kourier LoadBalancer 10.233.7.202 <pending> 80:31655/TCP,443:30980/TCP 36m kourier-internal ClusterIP 10.233.47.71 <none> 80/TCP 36m 只需要将与函数访问相关域名解析到 10.233.47.71 即可。 虽然每个函数的域名都是不同的,但域名后缀是一样的,可以通过泛域名解析来实现解析与函数相关的所有域名。Kourier 默认的域名后缀是 example.com,通过 Knative 的 ConfigMap config-domain 来配置: $ kubectl -n knative-serving get cm config-domain -o yaml apiVersion: v1 data: _example: | ################################ # # # EXAMPLE CONFIGURATION # # # ################################ # This block is not actually functional configuration, # but serves to illustrate the available configuration # options and document them in a way that is accessible # to users that `kubectl edit` this config map. # # These sample configuration options may be copied out of # this example block and unindented to be in the data block # to actually change the configuration. # Default value for domain. # Although it will match all routes, it is the least-specific rule so it # will only be used if no other domain matches. example.com: | # These are example settings of domain. # example.org will be used for routes having app=nonprofit. example.org: | selector: app: nonprofit # Routes having the cluster domain suffix (by default 'svc.cluster.local') # will not be exposed through Ingress. You can define your own label # selector to assign that domain suffix to your Route here, or you can set # the label # "networking.knative.dev/visibility=cluster-local" # to achieve the same effect. This shows how to make routes having # the label app=secret only exposed to the local cluster. svc.cluster.local: | selector: app: secret kind: ConfigMap metadata: annotations: knative.dev/example-checksum: 81552d0b labels: app.kubernetes.io/part-of: knative-serving app.kubernetes.io/version: 1.0.1 serving.knative.dev/release: v1.0.1 name: config-domain namespace: knative-serving 将其中的 _example 对象删除,添加一个默认域名(例如 openfunction.dev),最终修改结果如下: $ kubectl -n knative-serving get cm config-domain -o yaml apiVersion: v1 data: openfunction.dev: "" kind: ConfigMap metadata: annotations: knative.dev/example-checksum: 81552d0b labels: app.kubernetes.io/part-of: knative-serving app.kubernetes.io/version: 1.0.1 serving.knative.dev/release: v1.0.1 name: config-domain namespace: knative-serving 配置集群域名解析 为了便于在 Kubernetes 的 Pod 中访问函数,可以对 Kubernetes 集群的 CoreDNS 进行改造,使其能够对域名后缀 openfunction.dev 进行泛解析,需要在 CoreDNS 的配置中添加一段内容: template IN A openfunction.dev { match .*\.openfunction\.dev answer "{{ .Name }} 60 IN A 10.233.47.71" fallthrough } 修改完成后的 CoreDNS 配置如下: $ kubectl -n kube-system get cm coredns -o yaml apiVersion: v1 data: Corefile: | .:53 { errors health ready template IN A openfunction.dev { match .*\.openfunction\.dev answer "{{ .Name }} 60 IN A 10.233.47.71" fallthrough } kubernetes cluster.local in-addr.arpa ip6.arpa { pods insecure fallthrough in-addr.arpa ip6.arpa } hosts /etc/coredns/NodeHosts { ttl 60 reload 15s fallthrough } prometheus :9153 forward . /etc/resolv.conf cache 30 loop reload loadbalance } ... 同步函数 demo 示例 配置完域名解析后,接下来可以运行一个同步函数的示例来验证一下。OpenFunction 官方仓库提供了多种语言的同步函数示例: 这里我们选择 Go 语言的函数示例,先来看一下最核心的部署清单: # function-sample.yaml apiVersion: core.openfunction.io/v1beta1 kind: Function metadata: name: function-sample spec: version: "v2.0.0" image: "openfunctiondev/sample-go-func:latest" imageCredentials: name: push-secret port: 8080 # default to 8080 build: builder: openfunction/builder-go:latest env: FUNC_NAME: "HelloWorld" FUNC_CLEAR_SOURCE: "true" srcRepo: url: "https://github.com/OpenFunction/samples.git" sourceSubPath: "functions/knative/hello-world-go" revision: "main" serving: template: containers: - name: function imagePullPolicy: Always runtime: "knative" Function 是由 CRD 定义的一个 CR,用来将函数转换为最终运行的应用。这个例子里面包含了两个组件: build : 通过 Shipwright 选择不同的镜像构建工具,最终将应用构建为容器镜像; Serving : 通过 Serving CRD 将应用部署到不同的运行时中,可以选择同步运行时或异步运行时。这里选择的是同步运行时 knative。 国内环境由于不可抗因素,可以通过 GOPROXY 从公共代理镜像中快速拉取所需的依赖代码,只需在部署清单中的 build 阶段添加一个环境变量 FUNC_GOPROXY 即可: # function-sample.yaml apiVersion: core.openfunction.io/v1beta1 kind: Function metadata: name: function-sample spec: version: "v2.0.0" image: "openfunctiondev/sample-go-func:latest" imageCredentials: name: push-secret port: 8080 # default to 8080 build: builder: openfunction/builder-go:latest env: FUNC_NAME: "HelloWorld" FUNC_CLEAR_SOURCE: "true" FUNC_GOPROXY: "https://proxy.golang.com.cn,direct" srcRepo: url: "https://github.com/OpenFunction/samples.git" sourceSubPath: "functions/knative/hello-world-go" revision: "main" serving: template: containers: - name: function imagePullPolicy: Always runtime: "knative" 在创建函数之前,需要先创建一个 secret 来存储 Docker Hub 的用户名和密码: $ REGISTRY_SERVER=https://index.docker.io/v1/ REGISTRY_USER=<your_registry_user> REGISTRY_PASSWORD=<your_registry_password> $ kubectl create secret docker-registry push-secret \ --docker-server=$REGISTRY_SERVER \ --docker-username=$REGISTRY_USER \ --docker-password=$REGISTRY_PASSWORD 下面通过 kubectl 创建这个 Function: $ kubectl apply -f function-sample.yaml 查看 Function 运行状况: $ kubectl get function NAME BUILDSTATE SERVINGSTATE BUILDER SERVING URL AGE function-sample Building builder-6ht76 5s 目前正处于 Build 阶段,builder 的名称是 builder-6ht76。查看 builder 的运行状态: $ kubectl get builder NAME PHASE STATE REASON AGE builder-6ht76 Build Building 50s 这个 builder 会启动一个 Pod 来构建镜像: $ kubectl get pod NAME READY STATUS RESTARTS AGE builder-6ht76-buildrun-jvtwk-vjlgt-pod 2/4 NotReady 0 2m11s 这个 Pod 中包含了 4 个容器: step-source-default : 拉取源代码; step-prepare : 设置环境变量; step-create : 构建镜像; step-results : 输出镜像的 digest。 再次查看函数状态: $ kubectl get function NAME BUILDSTATE SERVINGSTATE BUILDER SERVING URL AGE function-sample Succeeded Running builder-6ht76 serving-6w4rn http://openfunction.io/default/function-sample 6m 已经由之前的 Building 状态变成了 Runing 状态。 这里的 URL 我们无法直接访问,因为没有部署 Ingress Controller。不过我们可以通过其他方式来访问,Kourier 把每个访问入口抽象为一个 CR 叫 ksvc,每一个 ksvc 对应一个函数的访问入口,可以看下目前有没有创建 ksvc: $ kubectl get ksvc NAME URL LATESTCREATED LATESTREADY READY REASON serving-6w4rn-ksvc-k4x29 http://serving-6w4rn-ksvc-k4x29.default.openfunction.dev serving-6w4rn-ksvc-k4x29-v200 serving-6w4rn-ksvc-k4x29-v200 True 函数的访问入口就是 http://serving-6w4rn-ksvc-k4x29.default.openfunction.dev。由于在前面的章节中已经配置好了域名解析,这里可以启动一个 Pod 来直接访问该域名: $ kubectl run curl --image=radial/busyboxplus:curl -i --tty If you don't see a command prompt, try pressing enter. [ root@curl:/ ]$ [ root@curl:/ ]$ curl http://serving-6w4rn-ksvc-k4x29.default.openfunction.dev/default/function-sample/World Hello, default/function-sample/World! [ root@curl:/ ]$ curl http://serving-6w4rn-ksvc-k4x29.default.openfunction.dev/default/function-sample/OpenFunction Hello, default/function-sample/OpenFunction! 访问这个函数时会自动触发运行一个 Pod: $ kubectl get pod NAME READY STATUS RESTARTS AGE serving-6w4rn-ksvc-k4x29-v200-deployment-688d58bfb-6fvcg 2/2 Running 0 7s 这个 Pod 使用的镜像就是之前 build 阶段构建的镜像。事实上这个 Pod 是由 Deployment 控制的,在没有流量时,这个 Deployment 的副本数是 0。当有新的流量进入时,会先进入 Knative 的 Activator,Activator 接收到流量后会通知 Autoscaler(自动伸缩控制器),然后 Autoscaler 将 Deployment 的副本数扩展到 1,最后 Activator 会将流量转发到实际的 Pod 中,从而实现服务调用。这个过程也叫冷启动。 如果你不再访问这个入口,过一段时间之后,Deployment 的副本数就会被收缩为 0: $ kubectl get deploy NAME READY UP-TO-DATE AVAILABLE AGE serving-6w4rn-ksvc-k4x29-v200-deployment 0/0 0 0 22m 总结 通过本文的示例,相信大家应该能够体会到一些函数计算的优势,它为我们带来了我们所期望的对业务场景快速拆解重构的能力。作为用户,只需要专注于他们的开发意图,编写函数代码,并上传到代码仓库,其他的东西不需要关心,不需要了解基础设施,甚至不需要知道容器和 Kubernetes 的存在。函数计算平台会自动为您分配好计算资源,并弹性地运行任务,只有当您需要访问的时候,才会通过扩容来运行任务,其他时间并不会消耗计算资源。 本文由博客一文多发平台 OpenWrite 发布!

优秀的个人博客,低调大师

亿级流量架构服务限流,写得太好了!

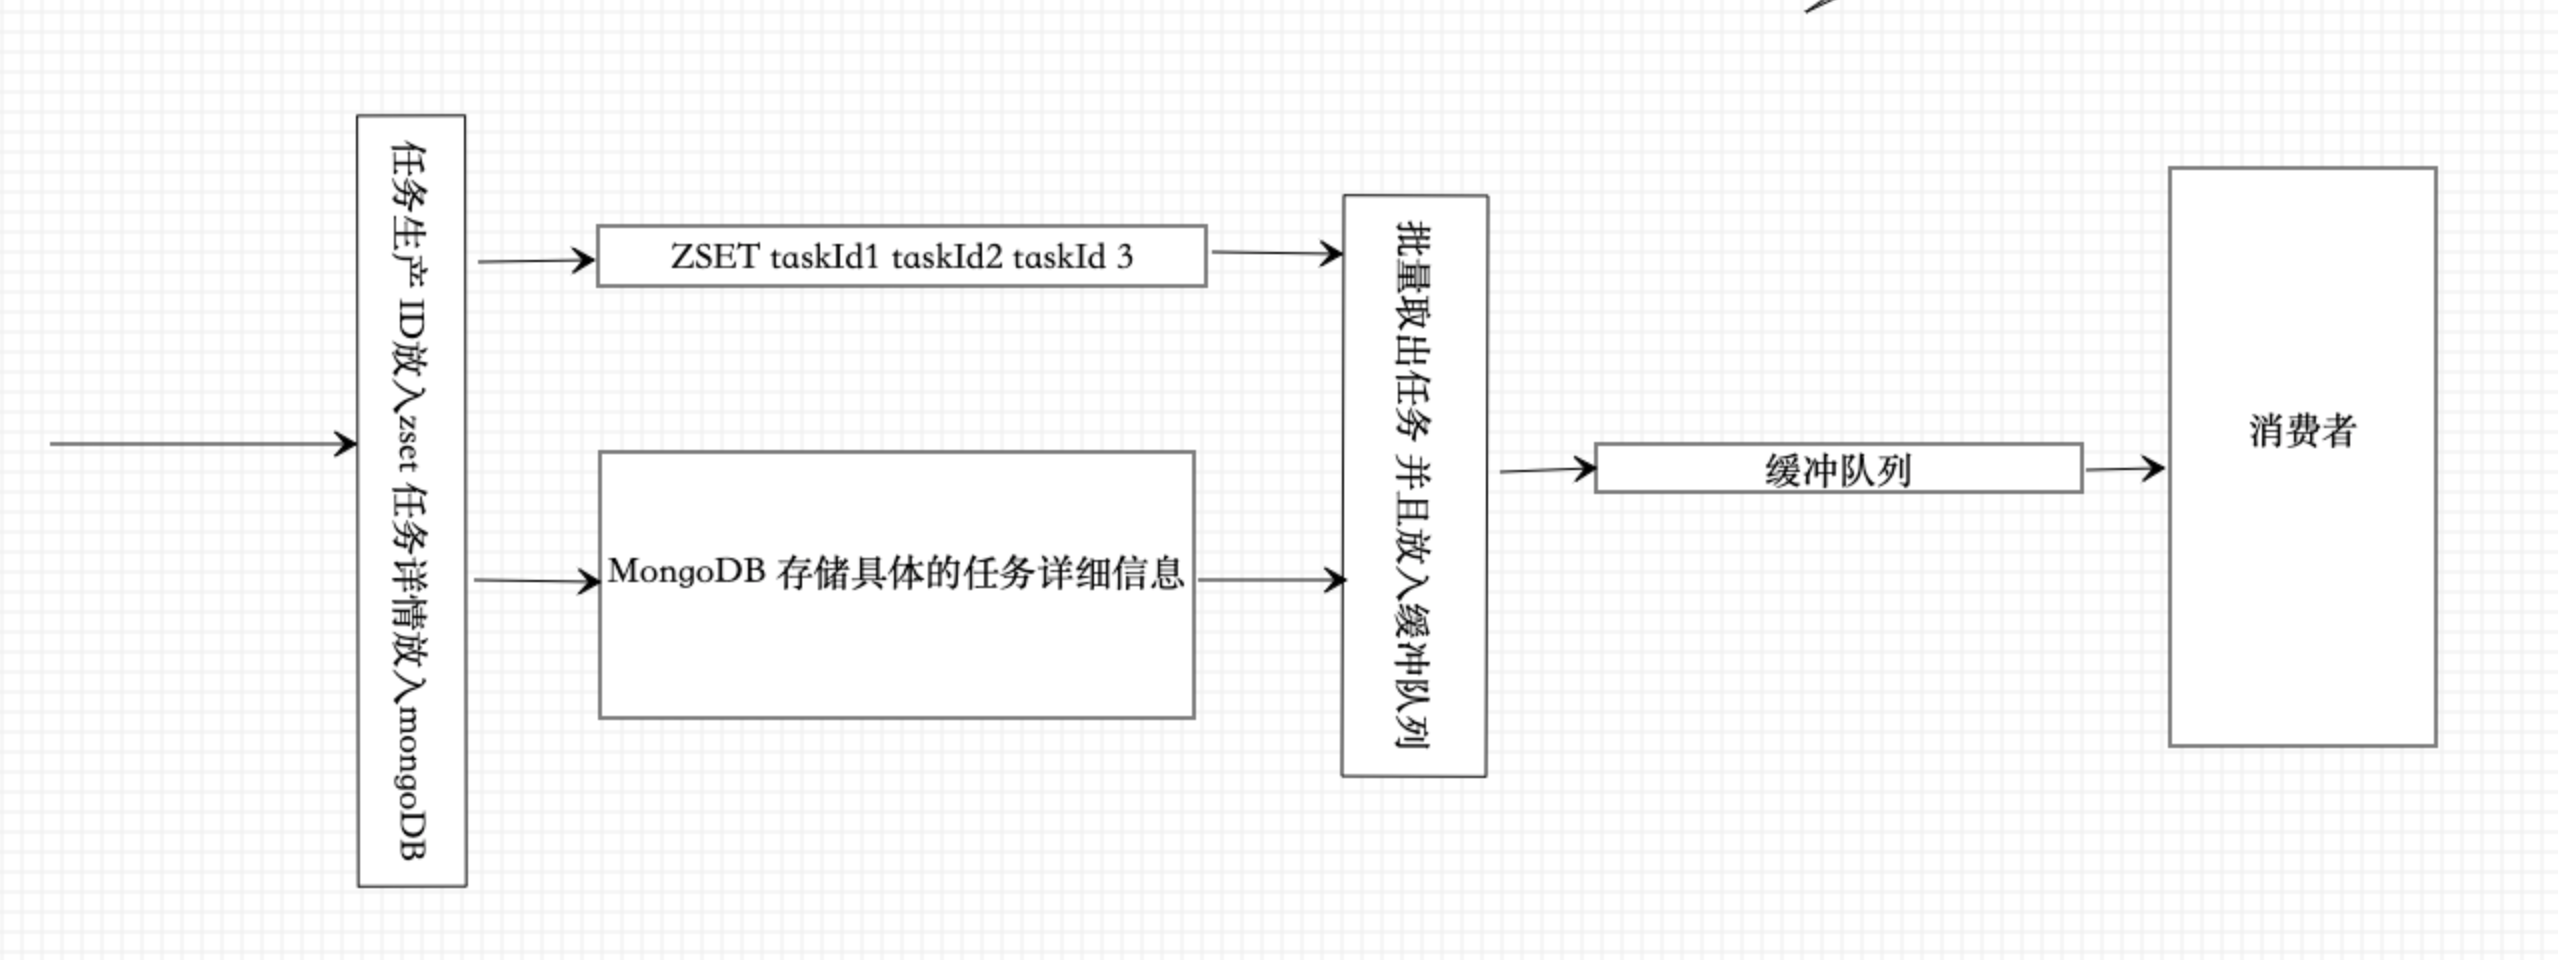
本文作者:等不到的口琴<br> 本文链接:https://www.cnblogs.com/Courage129/p/14423707.html 为什么要限流 日常生活中,有哪些需要限流的地方? 像我旁边有一个国家景区,平时可能根本没什么人前往,但是一到五一或者春节就人满为患,这时候景区管理人员就会实行一系列的政策来限制进入人流量, 为什么要限流呢?假如景区能容纳一万人,现在进去了三万人,势必摩肩接踵,整不好还会有事故发生,这样的结果就是所有人的体验都不好,如果发生了事故景区可能还要关闭,导致对外不可用,这样的后果就是所有人都觉得体验糟糕透了。 限流的思想就是,在保证可用的情况下尽可能多增加进入的人数,其余的人在外面排队等待,保证里面的一万人可以正常游玩。 回到网络上,同样也是这个道理,例如某某明星公布了恋情,访问从平时的50万增加到了500万,系统最多可以支撑200万访问,那么就要执行限流规则,保证是一个可用的状态,不至于服务器崩溃导致所有请求不可用。 限流思路 对系统服务进行限流,一般有如下几个模式: 熔断 系统在设计之初就把熔断措施考虑进去。当系统出现问题时,如果短时间内无法修复,系统要自动做出判断,开启熔断开关,拒绝流量访问,避免大流量对后端的过载请求。 系统也应该能够动态监测后端程序的修复情况,当程序已恢复稳定时,可以关闭熔断开关,恢复正常服务。常见的熔断组件有Hystrix以及阿里的Sentinel,两种互有优缺点,可以根据业务的实际情况进行选择。 服务降级 将系统的所有功能服务进行一个分级,当系统出现问题需要紧急限流时,可将不是那么重要的功能进行降级处理,停止服务,这样可以释放出更多的资源供给核心功能的去用。 例如在电商平台中,如果突发流量激增,可临时将商品评论、积分等非核心功能进行降级,停止这些服务,释放出机器和CPU等资源来保障用户正常下单,而这些降级的功能服务可以等整个系统恢复正常后,再来启动,进行补单/补偿处理。除了功能降级以外,还可以采用不直接操作数据库,而全部读缓存、写缓存的方式作为临时降级方案。 延迟处理 这个模式需要在系统的前端设置一个流量缓冲池,将所有的请求全部缓冲进这个池子,不立即处理。然后后端真正的业务处理程序从这个池子中取出请求依次处理,常见的可以用队列模式来实现。这就相当于用异步的方式去减少了后端的处理压力,但是当流量较大时,后端的处理能力有限,缓冲池里的请求可能处理不及时,会有一定程度延迟。后面具体的漏桶算法以及令牌桶算法就是这个思路。 特权处理 这个模式需要将用户进行分类,通过预设的分类,让系统优先处理需要高保障的用户群体,其它用户群的请求就会延迟处理或者直接不处理。 缓存、降级、限流区别 缓存,是用来增加系统吞吐量,提升访问速度提供高并发。 降级,是在系统某些服务组件不可用的时候、流量暴增、资源耗尽等情况下,暂时屏蔽掉出问题的服务,继续提供降级服务,给用户尽可能的友好提示,返回兜底数据,不会影响整体业务流程,待问题解决再重新上线服务 限流,是指在使用缓存和降级无效的场景。比如当达到阈值后限制接口调用频率,访问次数,库存个数等,在出现服务不可用之前,提前把服务降级。只服务好一部分用户。 限流的算法 限流算法很多,常见的有三类,分别是计数器算法、漏桶算法、令牌桶算法,下面逐一讲解。 计数器算法 简单粗暴,比如指定线程池大小,指定数据库连接池大小、nginx连接数等,这都属于计数器算法。 计数器算法是限流算法里最简单也是最容易实现的一种算法。举个例子,比如我们规定对于A接口,我们1分钟的访问次数不能超过100个。那么我们可以这么做:在一开 始的时候,我们可以设置一个计数器counter,每当一个请求过来的时候,counter就加1,如果counter的值大于100并且该请求与第一个请求的间隔时间还在1分钟之内,那么说明请求数过多,拒绝访问;如果该请求与第一个请求的间隔时间大于1分钟,且counter的值还在限流范围内,那么就重置 counter,就是这么简单粗暴。 漏桶算法 漏桶算法思路很简单,水(请求)先进入到漏桶里,漏桶以一定的速度出水,当水流入速度过大会超过桶可接纳的容量时直接溢出,可以看出漏桶算法能强行限制数据的传输速率。 这样做的好处是: 削峰:有大量流量进入时,会发生溢出,从而限流保护服务可用 缓冲:不至于直接请求到服务器,缓冲压力 消费速度固定 因为计算性能固定 令牌桶算法 令牌桶与漏桶相似,不同的是令牌桶桶中放了一些令牌,服务请求到达后,要获取令牌之后才会得到服务,举个例子,我们平时去食堂吃饭,都是在食堂内窗口前排队的,这就好比是漏桶算法,大量的人员聚集在食堂内窗口外,以一定的速度享受服务,如果涌进来的人太多,食堂装不下了,可能就有一部分人站到食堂外了,这就没有享受到食堂的服务,称之为溢出,溢出可以继续请求,也就是继续排队,那么这样有什么问题呢? 如果这时候有特殊情况,比如有些赶时间的志愿者啦、或者高三要高考啦,这种情况就是突发情况,如果也用漏桶算法那也得慢慢排队,这也就没有解决我们的需求,对于很多应用场景来说,除了要求能够限制数据的平均传输速率外,还要求允许某种程度的突发传输。这时候漏桶算法可能就不合适了,令牌桶算法更为适合。如图所示,令牌桶算法的原理是系统会以一个恒定的速度往桶里放入令牌,而如果请求需要被处理,则需要先从桶里获取一个令牌,当桶里没有令牌可取时,则拒绝服务。 令牌桶好处就是,如果某一瞬间访问量剧增或者有突发情况,可以通过改变桶中令牌数量来改变连接数,就好比那个食堂排队吃饭的问题,如果现在不是直接去窗口排队,而是先来楼外拿饭票然后再去排队,那么有高三的学生时可以将增加饭票数量或者优先将令牌给高三的学生,这样比漏桶算法更加灵活。 并发限流 简单来说就是设置系统阈值总的QPS个数,这些也挺常见的,就拿Tomcat来说,很多参数就是出于这个考虑,例如 配置的acceptCount 设置响应连接数, maxConnections设置瞬时最大连接数, maxThreads 设置最大线程数,在各个框架或者组件中,并发限流体现在下面几个方面: 限制总并发数(如数据库连接池、线程池) 限制瞬时并发数(nginx的limit_conn模块,用来限制瞬时并发连接数) 限制时间窗口内的平均速率(如Guava的RateLimiter、nginx的limit_req模块,限制每秒的平均速率) 其他的还有限制远程接口调用速率、限制MQ的消费速率。 另外还可以根据网络连接数、网络流量、CPU或内存负载等来限流。 有了并发限流,就意味着在处理高并发的时候多了一种保护机制,不用担心瞬间流量导致系统挂掉或雪崩,最终做到有损服务而不是不服务;但是限流需要评估好,不能乱用,否则一些正常流量出现一些奇怪的问题而导致用户体验很差造成用户流失。 接口限流 接口限流分为两个部分,一是限制一段时间内接口调用次数,参照前面限流算法的计数器算法, 二是设置滑动时间窗口算法。 接口总数 控制一段时间内接口被调用的总数量,可以参考前面的计数器算法,不再赘述。 接口时间窗口 固定时间窗口算法(也就是前面提到的计数器算法)的问题是统计区间太大,限流不够精确,而且在第二个统计区间 时没有考虑与前一个统计区间的关系与影响(第一个区间后半段 + 第二个区间前半段也是一分钟)。为了解决上面我们提到的临界问题,我们试图把每个统计区间分为更小的统计区间,更精确的统计计数。 在上面的例子中,假设QPS可以接受100次查询/秒, 前一分钟前40秒访问很低,后20秒突增,并且这个持续了一段时间,直到第二分钟的第40秒才开始降下来,根据前面的计数方法,前一秒的QPS为94,后一秒的QPS为92,那么没有超过设定参数,但是!但是在中间区域,QPS达到了142,这明显超过了我们的允许的服务请求数目,所以固定窗口计数器不太可靠,需要滑动窗口计数器。 计数器算法其实就是固定窗口算法, 只是它没有对时间窗口做进一步地划分,所以只有1格;由此可见,当滑动窗口的格子划分的越多,也就是将秒精确到毫秒或者纳秒, 那么滑动窗口的滚动就越平滑,限流的统计就会越精确。 需要注意的是,消耗的空间就越多。 限流实现 这一部分是限流的具体实现,简单说说,毕竟长篇代码没人愿意看。 guava实现 引入包 <!-- https://mvnrepository.com/artifact/com.google.guava/guava --> <dependency> <groupId>com.google.guava</groupId> <artifactId>guava</artifactId> <version>28.1-jre</version> </dependency> 核心代码 LoadingCache<Long, AtomicLong> counter = CacheBuilder.newBuilder(). expireAfterWrite(2, TimeUnit.SECONDS) .build(new CacheLoader<Long, AtomicLong>() { @Override public AtomicLong load(Long secend) throws Exception { // TODO Auto-generated method stub return new AtomicLong(0); } }); counter.get(1l).incrementAndGet(); 令牌桶实现 稳定模式(SmoothBursty:令牌生成速度恒定) public static void main(String[] args) { // RateLimiter.create(2)每秒产生的令牌数 RateLimiter limiter = RateLimiter.create(2); // limiter.acquire() 阻塞的方式获取令牌 System.out.println(limiter.acquire());; try { Thread.sleep(2000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; } `RateLimiter.create(2) 容量和突发量,令牌桶算法允许将一段时间内没有消费的令牌暂存到令牌桶中,用来突发消费。 渐进模式(SmoothWarmingUp:令牌生成速度缓慢提升直到维持在一个稳定值) // 平滑限流,从冷启动速率(满的)到平均消费速率的时间间隔 RateLimiter limiter = RateLimiter.create(2,1000l,TimeUnit.MILLISECONDS); System.out.println(limiter.acquire());; try { Thread.sleep(2000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; System.out.println(limiter.acquire());; 超时 boolean tryAcquire = limiter.tryAcquire(Duration.ofMillis(11)); 在timeout时间内是否能够获得令牌,异步执行 分布式系统限流 Nginx + Lua实现 另外,分布式系列面试题和答案全部整理好了,微信搜索Java技术栈,在后台发送:面试,可以在线阅读。 可以使用resty.lock保持原子特性,请求之间不会产生锁的重入 https://github.com/openresty/lua-resty-lock 使用lua_shared_dict存储数据 local locks = require "resty.lock" local function acquire() local lock =locks:new("locks") local elapsed, err =lock:lock("limit_key") --互斥锁 保证原子特性 local limit_counter =ngx.shared.limit_counter --计数器 local key = "ip:" ..os.time() local limit = 5 --限流大小 local current =limit_counter:get(key) if current ~= nil and current + 1> limit then --如果超出限流大小 lock:unlock() return 0 end if current == nil then limit_counter:set(key, 1, 1) --第一次需要设置过期时间,设置key的值为1, --过期时间为1秒 else limit_counter:incr(key, 1) --第二次开始加1即可 end lock:unlock() return 1 end ngx.print(acquire()) 近期热文推荐: 1.1,000+ 道 Java面试题及答案整理(2021最新版) 2.别在再满屏的 if/ else 了,试试策略模式,真香!! 3.卧槽!Java 中的 xx ≠ null 是什么新语法? 4.Spring Boot 2.5 重磅发布,黑暗模式太炸了! 5.《Java开发手册(嵩山版)》最新发布,速速下载! 觉得不错,别忘了随手点赞+转发哦!

优秀的个人博客,低调大师

iDempiere 企业级 ERP/CRM/SCM 8.2 Phong 发布

iDempiere r8.2 Phong于2020年12月20日(中国时间)发布。 官方的通知:https://groups.google.com/g/idempiere/c/ZRzwv_9rmBw/m/ioQEnWXHAQAJ 本次发布和以往有些不同,首先经历了1个多月的8.1 RC的测试后正式发布的8.2稳定版。 安装介质下载地址:https://www.idempiere.org/download/ 开发环境搭建方法等还没有更新至WIKI,后续请个别跟踪相关信息。 Hengsin更新了他的安装工具,可以尝试使用。 https://github.com/hengsin/idempiere-dev-setup 平台更新内容 Jetty = 9.4.33.v20201020 Eclipse 2020-12 Tycho 2.0 JUnit5(Support for JUnit5 Unit Testing) zk 9.5 功能更新内容 https://wiki.idempiere.org/en/Category:New_Features_v8.1 软件发布履历 2020年11月04日发布了8.1 RC 2019年11月22日发布了7.1 2019年01月05日发布了6.2 2018年11月04日发布了6.1 2017年10月31日发布了5.1 2016年10月31日发布了4.1 2015年10月31日发布了3.1 2014年10月31日发布了2.1 2013年10月31日发布了2.0 2013年06月27日发布了1.0c 2013年04月24日发布了1.0b 2012年10月31日发布了1.0a

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册