首页 文章 精选 留言 我的

精选列表

搜索[一键部署],共10000篇文章
优秀的个人博客,低调大师

《零基础入门:用 WorkBuddy 一键生成高质量 PPT 大纲流程》

在实际需求驱动下,精准确定 PPT 主题是生成高质量大纲的首要步骤。无论是工作汇报、学术分享还是教学演示,不同的场景对主题的聚焦点提出了多样化要求。例如,在工作汇报中,主题应紧密围绕具体任务或项目的进展、成果及改进方向展开;而在学术分享中,则需突出研究问题的核心内容、方法论及创新性发现。通过明确主题,不仅能够为大纲提供清晰的方向性指引,还能确保后续内容组织具备逻辑性和针对性。此外,主题的确立还需考虑信息传递的目标与受众期望,避免因主题过于宽泛或模糊而导致内容失焦。因此,用户在使用 WorkBuddy 工具时,应首先结合实际场景需求,对主题进行细化与具体化定义,以确保生成的大纲具有较高的实用价值。

优秀的个人博客,低调大师

一键生成各种风格PPT,教师、办公、设计必备神级Skill

还在为做PPT熬夜挠头?一份看起来像样的演示文稿往往要在排版、配色、找图这些琐事上耗费大半精力。有一类AI工具正在悄悄改写这个局面——只需要丢进一段文字、一份文档,甚至一句话描述,就能在几分钟内自动生成一份结构清晰、排版专业的PPT。今天就从实战角度聊聊这类神器的安装、使用和核心能力。

优秀的个人博客,低调大师

Kimi Code 0.4.0 发布,一键安装、毫秒级启动的终端 AI 编程 Agent

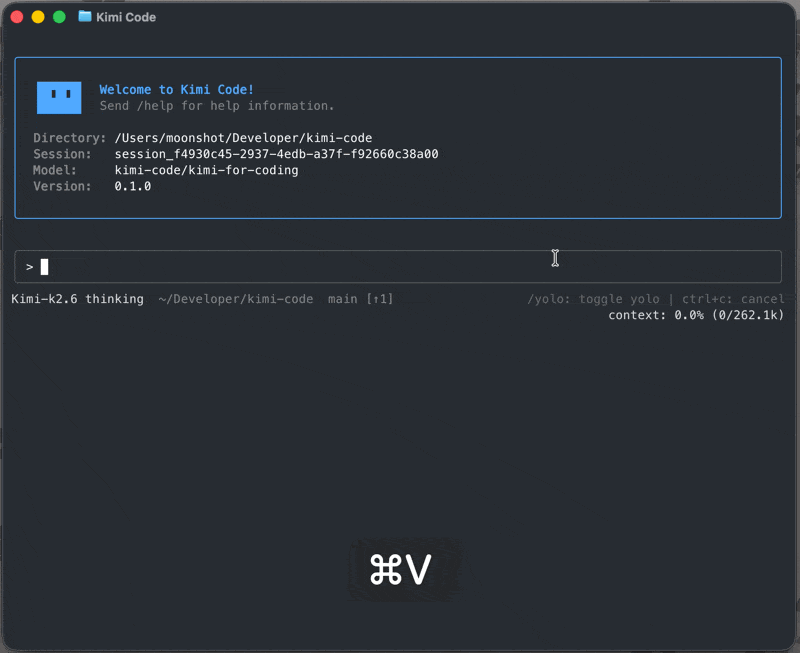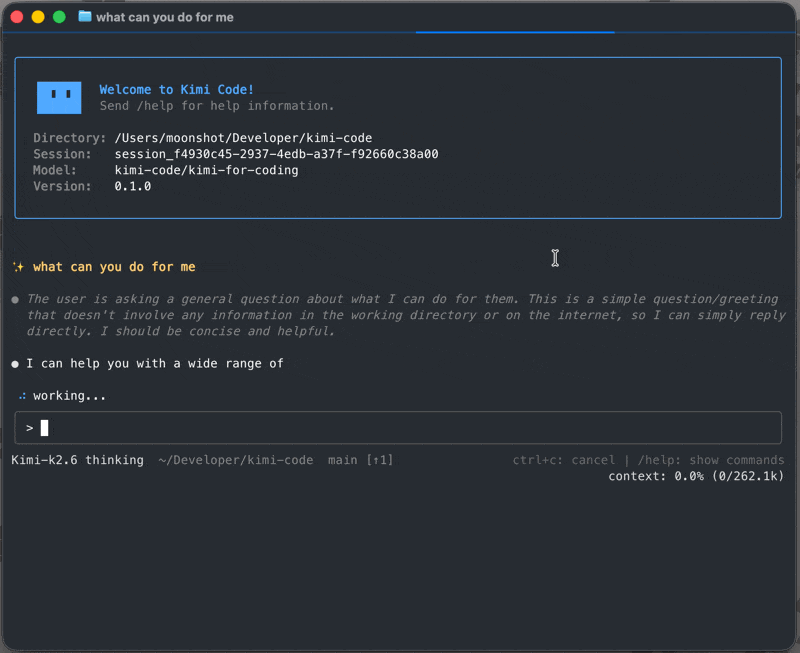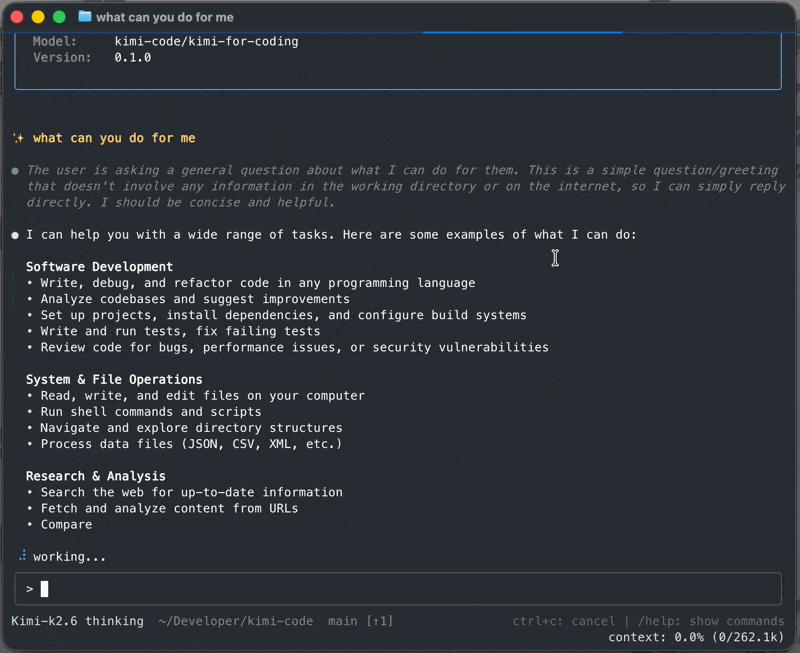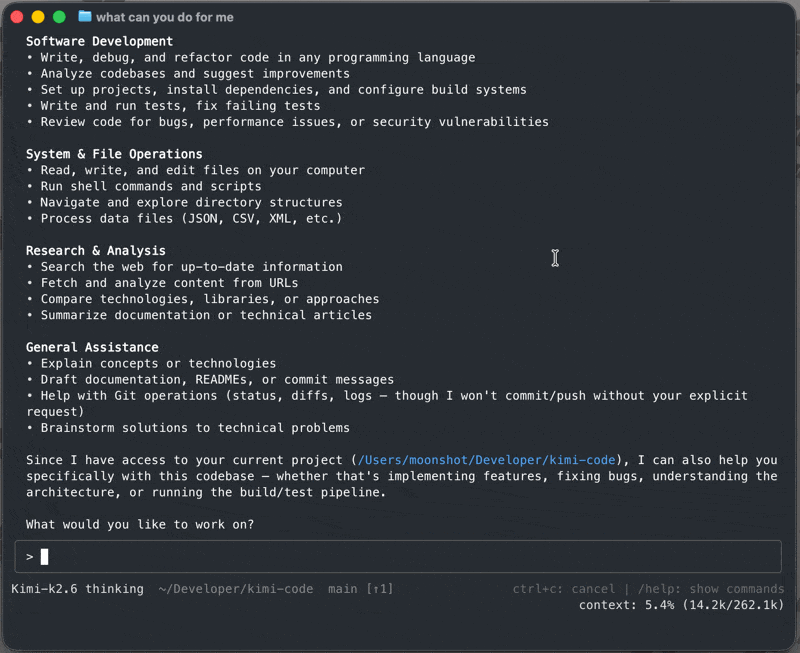
月之暗面(Moonshot AI)发布了 Kimi Code 0.4.0 版本,这是其终端 AI 编程 Agent 产品线的最新稳定版本。作为 kimi-cli 的继承产品,kimi-code 以 TypeScript 为核心语言,在功能设计和技术实现上呈现出明显的工程化思路。 Kimi Code 的差异化定位首先体现在分发方式上:它是一款单一二进制分发工具,用户无需预先搭建 Node.js 环境即可运行。macOS 和 Linux 用户通过一行 curl 命令完成安装,Windows 用户通过 PowerShell 安装脚本完成配置。这种"下载即用"的设计降低了入门门槛,对于不熟悉前端工具链的开发者尤其友好。 启动速度是另一个被重点优化的指标。官方标称"毫秒级启动",这在基于 Node.js Runtime 的终端工具中并不常见。实现路径很可能是将核心 TUI 渲染逻辑预编译进二进制,而非每次启动时动态加载依赖。对于需要频繁唤醒 AI 辅助的开发者来说,每次交互节省数百毫秒的等待时间,累积效果可观。 功能层面,Kimi Code 的核心能力覆盖了常见的 AI 辅助编程场景:读取和编辑代码、执行 Shell 命令、搜索文件、获取网页内容。内置coder、explore、plan 三个子 Agent,分别对应代码生成与修改、文件探索、任务规划三个高频使用情境。子 Agent 并行工作模式下,多个任务可以同时进行而不互相阻塞。 视频输入支持是 0.4.0 版本的一个新特性——用户可以上传屏幕录制文件,让 AI 基于视频内容理解上下文后给出建议。这个功能在代码演示、bug 复现和架构讲解场景中有实际价值,填补了"看图说话"式 AI 助手中的一个空白。 MCP(Model Context Protocol)配置的引入,使得外部工具的接入以对话驱动的方式完成,而非传统的 JSON 配置或命令行参数。这对不熟悉基础设施配置的开发者而言降低了一个隐性门槛。 从技术选型来看,kimi-code 基于 pi-tui 构建,后者是一个专门面向 AI Agent 场景的 TUI 框架。Node.js ≥ 24.15.0 的版本要求筛选掉了较旧的运行时环境,同时也意味着它默认支持 ES Module 和完整的 TypeScript 编译链路。 下载地址:https://github.com/MoonshotAI/kimi-code/releases

优秀的个人博客,低调大师

PAI-Diffusion中文模型全面升级,海量高清艺术大图一键生成

作者:段忠杰(终劫)、刘冰雁(伍拾)、汪诚愚(熊兮)、黄俊(临在) 背景 以Stable Diffusion模型为代表,AI生成内容(AI Generated Content,AIGC)的模型和应用呈现出井喷式的增长趋势。在先前的工作中,阿里云机器学习PAI团队开源了PAI-Diffusion系列模型(看这里),包括一系列通用场景和特定场景的文图生成模型,例如古诗配图、二次元动漫、魔幻现实等。这些模型的Pipeline除了包括标准的Diffusion Model,还集成了PAI团队先前提出的中文CLIP跨模态对齐模型(看这里)使得模型可以生成符合中文文本描述的、各种场景下的高清大图。此外,由于Diffusion模型推理速度比较慢,而且需要耗费较多的硬件资源,我们结合由PAI自主研发的编译优化工具 PAI-Blade,支持对PAI-Diffusion模型的端到端的导出和推理加速,在A10机器下做到了1s内的中文大图生成(看这里)。在本次的工作中,我们对之前的PAI-Diffusion中文模型进行大幅升级,主要的功能扩展包括: 图像生成质量的大幅提升、风格多样化:通过大量对模型预训练数据的处理和过滤,以及训练过程的优化,PAI-Diffusion中文模型生成的图像无论在质量上,还是在风格上都大幅超越先前版本; 丰富的精细化模型微调功能:除了对模型的标准微调,PAI-Diffusion中文模型支持开源社区的各种微调功能,包括LoRA、Textual Inversion、DreamBooth、ControlNet等,支持各类图像生成和编辑的功能; 简单易用的场景化定制方案:除了训练各种通用场景下的中文模型,我们也在垂类场景下做了很多尝试和探索,通过场景化的定制,可以在各种产品中使用这些模型,包括Diffuser API、WebUI等。 在下文中,我们详细介绍PAI-Diffusion中文模型的新功能和新特性。 艺术画廊 在详细介绍PAI-Diffusion中文模型及其功能前,我们首先带大家参观我们的艺术画廊,下面的所有图片都采用PAI-Diffusion中文模型真实生成。 positive prompt: 人工智能,未来派,4k,科幻 negative prompt: 模糊 positive prompt: 魔法药瓶 negative prompt: positive prompt: 雄鹰展翅,风暴,动漫风格 negative prompt: positive prompt: 中国风景图 远山、清水、古楼、古船、飞鸟、云雾,光线灿烂,远距离透视,超广角,气势磅礴,色彩逼真 negative prompt: 丑陋,畸形,模糊,画面不连贯,污染,噪声 positive prompt: 带墨镜的猫,黑客,特工,西装 negative prompt: positive prompt: 海底世界,各种鱼类,海草 negative prompt: positive prompt: 白瓷的咖啡杯,质地细腻、透光性好,中国传统的瓷器。深蓝色主色调。 高贵、优雅、沉稳 negative prompt: 斑点 positive prompt: 柴犬小狗,机甲,机器人,未来科技 negative prompt: positive prompt: 白色小狐狸,扁平画风 negative prompt: 斑点,噪点 positive prompt: 参天大树,浮雕,画框 negative prompt: positive prompt: 东方美女,学妹,少女,精致面容,可爱,长发,古装,汉服,画面精致,完美造型,柔和的色彩,电影感 negative prompt: positive prompt: 奇妙几何形别墅,悬崖上 negative prompt: positive prompt: 粉红色羽毛的猫头鹰 negative prompt: positive prompt: 浮岛,天空,白云,城堡,幻想世界 negative prompt: 油画,模糊,雾蒙蒙 positive prompt: 一个抽烟的美丽女人的画像,梦幻般的色彩,精美细节 negative prompt: 丑陋,畸形,污染,噪声 positive prompt: 一个穿着连帽衫的酷女孩,日蚀背景,精美细节,赛博朋克 negative prompt: 噪声,污染 positive prompt: 火车,雪地,隧道,昏暗灯光,恐怖片 negative prompt: 多个铁轨 positive prompt: 金属盒子,宝箱,神秘,反光,骷髅,草地上 negative prompt: positive prompt: 镜中花,水中月,水彩画,大量笔墨 negative prompt: positive prompt: 阳光,彩虹,小白马 negative prompt: positive prompt: 中国剪纸画,雪山,白云,落日 negative prompt: positive prompt: 日落时分城市的鸟瞰图,日蚀行星建构主义风格 negative prompt: 噪点,扭曲 positive prompt: 山水画,流畅的线条,优美的山水图案 negative prompt: 斑点 positive prompt: 亭台楼阁,曲径通幽,水墨绘画,中国风 negative prompt: 油画,彩色 positive prompt: 洋葱头小精灵,可爱,童话 negative prompt: positive prompt: 一只小猪在夕阳下奔跑,童话绘本 negative prompt: positive prompt: 一个戴着眼镜的女孩 ,精致的五官,白皮肤,赛博朋克场景,全身照片 negative prompt: positive prompt: 一个在上学路上的女孩,宫崎骏的绘画风格,清晰 negative prompt: 摄影,写实,模糊 positive prompt: 向日葵花海,最高的质量,8K,超精细刻画 negative prompt: positive prompt: 落日风景油画,朦胧美 negative prompt: 画框,画笔 positive prompt: 生肖兔,武侠风,仙气,紫砂盔甲配剑,细节,特写 negative prompt: positive prompt: 盛世莲花,传说,荷塘,发光,柔和光线,CG感 negative prompt: 斑点 positive prompt: 陶瓷大花瓶,牡丹花 negative prompt: positive prompt: 童话绘本,蘑菇,树林,低饱和度氛围,可爱,萌萌哒 negative prompt: positive prompt: 未来战士,机械装甲,光剑,红眼,科幻 negative prompt: 景深,模糊 positive prompt: 蝴蝶,对称美感,数字艺术 negative prompt: PAI-Diffusion ModelZoo 我们利用海量中文图文对数据,训练了多个Diffusion中文模型,参数量均在10亿左右。本次我们开源了如下两个模型。概述如下所示: 模型名 使用场景 pai-diffusion-artist-large-zh 中文文图生成艺术模型,默认支持生成图像分辨率为512*512 pai-diffusion-artist-xlarge-zh 中文文图生成艺术模型(更大分辨率),默认支持生成图像分辨率为768*768 为了提升模型输出图像的质量,在最大限度内避免出现不合规或低质量内容,我们搜集海量开源的图文对数据集,包括大规模中文跨模态预训练数据集WuKong、大规模多语言多模态数据集LAION-5B等。我们针对图像和文本进行了多种清洗方式,筛选掉违规和低质量数据。具体的数据处理方式包括NSFW(Not Safe From Work)数据过滤、水印数据去除,以及使用CLIP分数和美观值分数评分,选出最合适的预训练数据子集进行训练。与英文开源社区的Diffusion模型不同,我们的CLIP Text Encoder采用EasyNLP自研的中文CLIP模型(https://github.com/alibaba/EasyNLP),并且在Diffusion训练过程中冻结其参数,使得模型对中文语义的建模更加精确。值得注意的是,上表的图像分辨率指训练过程中的图像分辨率,在模型推理阶段可以设置不同的分辨率。 PAI-Diffusion模型特性 为了更加便于广大用户使用PAI-Diffusion模型,我们从如下几个方面详细介绍PAI-Diffusion模型的特性。 丰富多样的模型微调方法 PAI-Diffusion模型和社区Stable Diffusion等模型的参数量一般在十亿左右。这些模型的全量参数微调往往需要消耗大量计算资源。除了标准的模型微调,PAI-Diffusion模型支持多种轻量化微调算法,支持用户在计算量尽可能少的情况下,实现模型的特定领域、特定场景的微调。以下,我们也给出两个轻量化微调的示例。 使用LoRA进行模型轻量化微调 PAI-Diffusion模型可以使用LoRA(Low-Rank Adaptation)算法进行轻量化微调,大幅降低计算量。调用开源脚本train_text_to_image_lora.py,我们同样可以实现PAI-Diffusion中文模型的轻量化微调。训练命令示例如下: export MODEL_NAME="model_name" export TRAIN_DIR="path_to_your_dataset" export OUTPUT_DIR="path_to_save_model" accelerate launch train_text_to_image_lora.py \ --pretrained_model_name_or_path=$MODEL_NAME \ --train_data_dir=$TRAIN_DIR \ --resolution=512 --center_crop --random_flip \ --train_batch_size=1 \ --gradient_accumulation_steps=4 \ --max_train_steps=15000 \ --learning_rate=1e-04 \ --max_grad_norm=1 \ --lr_scheduler="cosine" --lr_warmup_steps=0 \ --output_dir=$OUTPUT_DIR 其中,MODEL_NAME是用于微调的PAI-Diffusion模型名称或路径,TRAIN_DIR是训练集的本地路径,OUTPUT_DIR为模型保存的本地路径(只包含LoRA微调参数部分)。当模型LoRA轻量化微调完毕之后可以使用如下示例代码进行文图生成: from diffusers import StableDiffusionPipeline model_id = "model_name" lora_path = "model_path/checkpoint-xxx/pytorch_model.bin" pipe = StableDiffusionPipeline.from_pretrained(model_id) pipe.unet.load_attn_procs(torch.load(lora_path)) pipe.to("cuda") image = pipe("input text").images[0] image.save("result.png") 其中,model_path即为微调后的模型保存的本地路径(只包含LoRA微调参数部分),即前一步骤的OUTPUT_DIR;model_id为原始的没有经过LoRA微调的模型。 使用Textual Inversion进行模型定制化轻量微调 由于PAI-Diffusion模型一般用于生成各种通用场景下的图像,Textual Inversion是一种定制化轻量微调技术,使模型生成原来模型没有学会的、新的概念相关图像。PAI-Diffusion模型可以使用Textual Inversion算法进行轻量化微调。同样地,我们可以运行脚本textual_inversion.py,训练命令示例如下: export MODEL_NAME="model_name" export TRAIN_DIR="path_to_your_dataset" export OUTPUT_DIR="path_to_save_model" accelerate launch textual_inversion.py \ --pretrained_model_name_or_path=$MODEL_NAME \ --train_data_dir=$TRAIN_DIR \ --learnable_property="object" \ --placeholder_token="<小奶猫>" --initializer_token="猫" \ --resolution=512 \ --train_batch_size=1 \ --gradient_accumulation_steps=4 \ --max_train_steps=100 \ --learning_rate=5.0e-04 --scale_lr \ --lr_scheduler="constant" \ --lr_warmup_steps=0 \ --output_dir=$OUTPUT_DIR 其中,MODEL_NAME是用于微调的PAI-Diffusion模型名称,TRAIN_DIR是前述训练集的本地路径,OUTPUT_DIR为模型保存的本地路径。其中placeholder_token是与新的概念相关的文本,initializer_token是与新的概念密切相关的字(用于初始化新的概念对应的参数),这里我们以小奶猫为例。当模型轻量化微调完毕之后可以使用如下示例代码进行文图生成: from diffusers import StableDiffusionPipeline model_path = "path_to_save_model" pipe = StableDiffusionPipeline.from_pretrained(model_path).to("cuda") image = pipe("input text").images[0] image.save("result.png") 其中,model_path即为微调后的模型保存的本地路径,即前一步骤的OUTPUT_DIR。注意在使用微调后的模型生成包含新的概念的图像时,文本中新的概念用步骤二中的placeholder_token表示,例如: 输入文本:一只<小奶猫>在草地上 输入文本:一只<小奶猫>在沙发上 输出图像 输出图像 AIGC系列模型的潜在风险在于容易生成不可控的、带有违法信息的内容,影响了这些模型在下游业务场景中的应用。PAI-Diffusion中文模型支持多种可控的图像编辑功能,允许用户对生成的图像内容作出限制,从而使得结果更加可用。PAI-Diffusion中文模型对StableDiffusionImg2ImgPipeline做到完全兼容,这一文本引导的图像编辑Pipeline允许模型在给定输入文本和图像的基础上,生成相关的图像,示例脚本如下: from diffusers import StableDiffusionImg2ImgPipeline pipe = StableDiffusionImg2ImgPipeline.from_pretrained("model_name").to("cuda") image = pipe(prompt="input text", image=init_image, strength=0.75, guidance_scale=7.5).images[0] image.save("result.png") 以下给出一个输入输出的示例: 输入文本:雪地里的两只企鹅 输入图像 输出图像 场景定制化的功能支持 除了用于生成艺术大图,通过对PAI-Diffusion中文模型进行继续预训练,我们也可以得到高度场景化的中文模型。以下是PAI-Diffusion中文模型在美食数据上继续预训练后生成的结果,可以看出只要拥有高质量的业务数据,可以产出针对不同业务场景的Diffusion模型。这些模型可以进一步与LoRA、ControlNet等技术进行无缝结合,做到与业务更契合、更可控的图像编辑与生成。 菠萝炒饭 韭菜鸡蛋水饺 番茄炒蛋 韩式炸鸡 红烧狮子头 清汤娃娃菜 模型的使用和下载 在开源社区使用PAI-Diffusion中文模型 为了方便开源社区使用这些模型,我们将这两个模型接入了两个知名的开源模型分享社区HuggingFace和ModelScope。以HuggingFace为例,我们可以使用如下代码进行模型推理: from diffusers import StableDiffusionPipeline model_id = "alibaba-pai/pai-diffusion-artist-large-zh" pipe = StableDiffusionPipeline.from_pretrained(model_id) pipe = pipe.to("cuda") prompt = "雾蒙蒙的日出在湖面上" image = pipe(prompt).images[0] image.save("result.png") 在ModelScope的使用接口示例如下: from modelscope.pipelines import pipeline import cv2 p = pipeline('text-to-image-synthesis', 'PAI/pai-diffusion-artist-large-zh', model_revision='v1.0.0') result = p({'text': '雾蒙蒙的日出在湖面上'}) image = result["output_imgs"][0] cv2.imwrite("image.png", image) 此外,我们也在EasyNLP算法框架中开设了Diffusion算法专区(链接),提供各种PAI-Diffusio模型的使用脚本和教程。 在PAI-DSW使用PAI-Diffusion中文模型 PAI-DSW(Data Science Workshop)是阿里云机器学习平台PAI开发的云上IDE,面向不同水平的开发者,提供了交互式的编程环境(文档)。在DSW Gallery中,提供了各种Notebook示例,方便用户轻松上手DSW,搭建各种机器学习应用。我们也在DSW Gallery中上架了使用PAI-Diffusion中文模型的Sample Notebook,欢迎大家体验! 免费领取:阿里云机器学习平台PAI为开发者提供免费试用额度,包含DSW、DLC、EAS多款产品。https://free.aliyun.com/?pipCode=learn 未来展望 在这一期的工作中,我们对PAI-Diffusion中文模型的效果和功能进行了大幅扩展,使得图像生成质量的大幅提升、风格多样化。同时,我们支持包括LoRA、Textual Inversion等多种精细化模型微调和编辑功能。此外,我们也展示了多种场景化定制方案,方便用户在特定场景下训练和使用自己的Diffusion中文模型。在未来,我们计划进一步扩展各种场景的模型功能。 阿里灵杰回顾 阿里灵杰:阿里云机器学习PAI开源中文NLP算法框架EasyNLP,助力NLP大模型落地 阿里灵杰:预训练知识度量比赛夺冠!阿里云PAI发布知识预训练工具 阿里灵杰:EasyNLP带你玩转CLIP图文检索 阿里灵杰:EasyNLP中文文图生成模型带你秒变艺术家 阿里灵杰:EasyNLP集成K-BERT算法,借助知识图谱实现更优Finetune 阿里灵杰:中文稀疏GPT大模型落地 — 通往低成本&高性能多任务通用自然语言理解的关键里程碑 阿里灵杰:EasyNLP玩转文本摘要(新闻标题)生成 阿里灵杰:跨模态学习能力再升级,EasyNLP电商文图检索效果刷新SOTA 阿里灵杰:EasyNLP带你实现中英文机器阅读理解 阿里灵杰:EasyNLP发布融合语言学和事实知识的中文预训练模型CKBERT 阿里灵杰:当大火的文图生成模型遇见知识图谱,AI画像趋近于真实世界 阿里灵杰:PAI-Diffusion模型来了!阿里云机器学习团队带您徜徉中文艺术海洋 阿里灵杰:阿里云PAI-Diffusion功能再升级,全链路支持模型调优,平均推理速度提升75%以上

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册