首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

每日一博 | React Hooks 源码深度解析

作者:京东零售 郑炳懿 前言 React Hooks是React16.8 引入的一个新特性,它允许函数组件中使用state和其他 React 特性,而不必使用类组件。Hooks是一个非常重要的概念,因为它们提供了更简单、更易于理解的React开发体验。 React Hooks的核心源码主要包括两个部分:React内部的Hook管理器和一系列预置的Hook函数。 首先,让我们看一下React内部的Hook管理器。这个管理器是React内部的一个重要机制,它负责管理组件中的所有Hook,并确保它们在组件渲染期间以正确的顺序调用。 内部Hook管理器 示例: const Hook = { queue: [], current: null, }; function useState(initialState) { const state = Hook.current[Hook.queue.length]; if (!state) { Hook.queue.push({ state: typeof initialState === 'function' ? initialState() : initialState, setState(value) { this.state = value; render(); }, }); } return [state.state, state.setState.bind(state)]; } function useHook(callback) { Hook.current = { __proto__: Hook.current, }; try { callback(); } finally { Hook.current = Hook.current.__proto__; } } function render() { useHook(() => { const [count, setCount] = useState(0); console.log('count:', count); setTimeout(() => { setCount(count + 1); }, 1000); }); } render(); 在这个示例中,Hook对象有两个重要属性:queue和current。queue存储组件中所有Hook的状态和更新函数,current存储当前正在渲染的组件的Hook链表。useState和useHook函数则分别负责创建新的Hook状态和在组件中使用Hook。 预置 Hook 函数 useState Hook 以下是useState Hook的实现示例: function useState(initialState) { const hook = updateWorkInProgressHook(); if (!hook.memoizedState) { hook.memoizedState = [ typeof initialState === 'function' ? initialState() : initialState, action => { hook.queue.pending = true; hook.queue.dispatch = action; scheduleWork(); }, ]; } return hook.memoizedState; } 上述代码实现了useState Hook,其主要作用是返回一个state和更新函数的数组,state 初始值为initialState。 在这个实现中,updateWorkInProgressHook()函数用来获取当前正在执行的函数组件的 fiber 对象并判断是否存在对应的hook。它的实现如下: function updateWorkInProgressHook() { const fiber = getWorkInProgressFiber(); let hook = fiber.memoizedState; if (hook) { fiber.memoizedState = hook.next; hook.next = null; } else { hook = { memoizedState: null, queue: { pending: null, dispatch: null, last: null, }, next: null, }; } workInProgressHook = hook; return hook; } getWorkInProgressFiber()函数用来获取当前正在执行的函数组件的fiber对象,workInProgressHook则用来存储当前正在执行的hook对象。在函数组件中,每一个useState调用都会创建一个新的 hook 对象,并将其添加到fiber对象的hooks链表中。这个hooks链表是通过fiber对象的memoizedState属性来维护的。 我们还需要注意到在useState Hook的实现中,每一个hook对象都包含了一个queue对象,用来存储待更新的状态以及更新函数。scheduleWork()函数则用来通知React调度器有任务需要执行。 在React的源码中,useState函数实际上是一个叫做useStateImpl的内部函数。 下面是useStateImpl的源码: function useStateImpl<S>(initialState: (() => S) | S): [S, Dispatch<SetStateAction<S>>] { const dispatcher = resolveDispatcher(); return dispatcher.useState(initialState); } 可以看到,useStateImpl函数的作用就是获取当前的dispatcher并调用它的useState方法,返回一个数组,第一个元素是状态的值,第二个元素是一个dispatch函数,用来更新状态。这里的resolveDispatcher函数用来获取当前的dispatcher,其实现如下: function resolveDispatcher(): Dispatcher { const dispatcher = currentlyRenderingFiber?.dispatcher; if (dispatcher === undefined) { throw new Error('Hooks can only be called inside the body of a function component. (https://fb.me/react-invalid-hook-call)'); } return dispatcher; } resolveDispatcher函数首先尝试获取当前正在渲染的fiber对象的dispatcher属性,如果获取不到则说 明当前不在组件的渲染过程中,就会抛出一个错误。 最后,我们来看一下useState方法在具体的dispatcher实现中是如何实现的。我们以useReducer的 dispatcher为例,它的实现如下: export function useReducer<S, A>( reducer: (prevState: S, action: A) => S, initialState: S, initialAction?: A, ): [S, Dispatch<A>] { const [dispatch, currentState] = updateReducer<S, A>( reducer, // $FlowFixMe: Flow doesn't like mixed types [initialState, initialAction], // $FlowFixMe: Flow doesn't like mixed types reducer === basicStateReducer ? basicStateReducer : updateStateReducer, ); return [currentState, dispatch]; } 可以看到,useReducer方法实际上是调用了一个叫做updateReducer的函数,返回了一个包含当前状态和dispatch函数的数组。updateReducer的实现比较复杂,涉及到了很多细节,这里不再展开介绍。 useEffect Hook useEffect是React中常用的一个Hook函数,用于在组件中执行副作用操作,例如访问远程数据、添加/移除事件监听器、手动操作DOM等等。useEffect的核心功能是在组件的渲染过程结束之后异步执行回调函数,它的实现方式涉及到 React 中的异步渲染机制。 以下是useEffect Hook的实现示例: function useEffect(callback, dependencies) { // 通过调用 useLayoutEffect 或者 useEffect 方法来获取当前的渲染批次 const batch = useContext(BatchContext); // 根据当前的渲染批次判断是否需要执行回调函数 if (shouldFireEffect(batch, dependencies)) { callback(); } // 在组件被卸载时清除当前 effect 的状态信息 return () => clearEffect(batch); } 在这个示例中,useEffect接收两个参数:回调函数和依赖项数组。当依赖项数组中的任何一个值发生变化时, React会在下一次渲染时重新执行useEffect中传入的回调函数。 useEffect函数的实现方式主要依赖于React中的异步渲染机制。当一个组件需要重新渲染时,React会将所有的state更新操作加入到一个队列中,在当前渲染批次结束之后再异步执行这些更新操作,从而避免在同一个渲染批次中连续执行多次更新操作。 在useEffect函数中,我们通过调用useContext(BatchContext)方法来获取当前的渲染批次,并根据shouldFireEffect方法判断是否需要执行回调函数。在回调函数执行完毕后,我们需要通过clearEffect方法来清除当前effect的状态信息,避免对后续的渲染批次产生影响。 总结 总的来说,React Hooks的实现原理并不复杂,它主要依赖于React内部的fiber数据结构和调度系统,通过这些机制来实现对组件状态的管理和更新。Hooks能够让我们在函数组件中使用状态和其他React特性,使得函数组件的功能可以和类组件媲美。 除了useState、useEffect等hook,React还有useContext等常用的Hook。它们的实现原理也基本相似,都是利用fiber架构来实现状态管理和生命周期钩子等功能。 以上是hook简单实现示例,它们并不是React中实际使用的代码,但是可以帮助我们更好地理解hook的核心实现方式。
优秀的个人博客,低调大师

jsoup 1.15.4 发布,Java HTML 解析器

jsoup 1.15.4 现已发布,其中包括了一些改进,尤其是在 pretty-printing HTML 时;以及一些错误的修正。jsoup 是一个用于处理 real-worldHTML 的 Java 库。它使用最好的 HTML5 DOM 方法和 CSS 选择器提供了一个非常方便的 API 用于提取和操作数据。 下载地址:https://jsoup.org/download 具体更新内容包括: Improvements 添加了转义 CSS 选择器(tag、ID、classes)以匹配不遵循常规 CSS 语法的元素的功能。例如,要按类名<p class="one.two">进行匹配,可以使用document.select("p.one\\.two");#838 pretty-printing 时,将<br>标签后面的文本换行。#1858 pretty-printing 时,规范化自定义标签中 self-closing 标签后面的换行符。#1852 pretty-printing 时,折叠 block和inline 标签之间的非重要空白。#1802 在[Element.forEach()]和[Node.forEachNode()]中,使用java.util.function.Consumer而不是以前的 Android ompatibility shim​​[org.jsoup.helper.Consumer]。后者已被弃用。#1870 添加了一个新方法[Document.forms()],可以方便地检索包含文档中<form>元素的List<FormElement>。 增加了一个新方法[Document.expectForm()],找到第一个匹配的[FormElement],或者blow up trying。 Bug 修复 包含[and <code>]等字符的 URL 未正确转义,并且在获取时会抛出一个MalformedURLException错误。#1873 [Element.cssSelector()]将为标签名称、ID 或类名称需要转义的元素创建无效的选择器(例如,如果类名称包含.或:)。#1742 [Element.text()]在 block 和 inline 元素之间应该有一个空格。#1877 如果一个[Node]或[Element]被自身替换,则该节点将被错误地孤立。#1843 在[newRequest()]中,之前请求的表单数据被复制到新的请求中,导致执行多步表单提交时表单数据堆积,或者数据错误发送到后面的请求。现在,[newRequest()]只复制与会话相关的设置(cookie、代理设置、用户代理等),而不是请求数据或正文。#1778 修复了[Safelist.removeAttributes()]中的问题,当使用:allpseudo-attribute时可能抛出一个ConcurrentModificationException。 给定极深嵌套的 HTML,[Element]其中的许多方法可能会由于过多的递归而抛出StackOverflowError。即:#data()、#hasText()、#parents()和#wrap(html)。#1864 Changes 弃用了未使用的[Document.normalise()]方法。规范化发生在 HTML tree构建过程中,不再作为一个独立的阶段。 更新说明:https://github.com/jhy/jsoup/releases/tag/jsoup-1.15.4

优秀的个人博客,低调大师

OSPO 五阶段成熟度模型解析

OSPO成熟度模型和操作指南目录清单,用于帮助在企业环境中实施 OSPO 或开源计划。人们可以在这里阅读和下载完整的白皮书。 通过将与 OPSO 领导者和专家的对话映射到 OSPO 的调查结果,我们开发了 OSPO 成熟度模型来描述 OSPO 的典型演变。模型是通用的:组织的大小和类型影响 OSPO 的成熟方式。在较大的组织中,多个事业部可能会开发不同的开源方法,每种方法都有不同的技术文化;纯数字技术公司更有可能在早期消费和贡献 OSS ,并有更多的机会接触开源技术和概念。 以企业基础设施软件提供商 VMware 为例。他们的工程师与许多网络、云计算和其他关键领域的开源社区合作并做出贡献,原因很简单,他们知道使用开源构建会带来更好的结果和更强的互操作性——对于社区和 VMware 的客户来说。 与之形成对比的是首家上市的开源公司红帽。它将整个业务实践建立在开源软件的基础上,压缩了它的成熟度生命周期,实际上,这使它的整个公司有点像一个开源软件开发组织。今天,红帽将更多的资源投入到早期的生命周期活动中,例如教育内部利益相关者(例如,销售团队、营销人员、新聘的工程人员),促进上游社区的合作。 对于我们研究中的大多数其他公司,成熟度模型的一般阶段在消费、贡献、协作和参与以及领导力方面严密布局了 OSS 组织的轨迹。我们采访过的一些组织现已把开放源码参与和使用列入具体指标。 这些指标包括 OSS 项目中的项目参与率(pull requests、comment、commit)、出席和参与开源活动、撰写的博客文章、发表演讲以及参与开源项目等等。更高级的开源组织可能有关于项目成功增长的度量标准,这些项目是由他们自己的工程团队发起的或部分由他们自己的工程团队创建的。一些领先的组织,如 Comcast、VMware 和 Red Hat ,或已正在构建先进的度量标准和度量工具。 也就是说,即使是一些跟踪指标的复杂组织也不会明确地使用指标来跟踪或设置 OSS 目标。 以微软为例,这个组织曾经几乎只专注于私有软件,但现在已经成为开源项目的主要支持者和其自有产品开源的广泛用户。“我们专注于让我们的开发人员更容易与 OSS 合作,鼓励他们为他们所依赖的项目做出贡献。我们跟踪所有人的参与,但开源项目办公室确实在个人或团队层面设定了目标,”微软开源项目办公室前负责人斯托米·彼得斯( Stormy Peters )说。“我们的开发者可以自愿将他们的公司 ID 与他们的 GitHub 登录联系起来,这让我们可以在公司层面衡量参与程度。大多情况下,系统收集和分析指标发生在采用的后期阶段,此时 OSS 成为企业和更大组织的技术路线图和战略的关键元素,与此同时,OSPO 计划、预算和人员也在增长。 第0阶段 采用开源 Ad Hoc 今天,几乎所有的组织都在使用开源软件。他们最初使用它的方式各不相同。他们使用开源软件作为产品或工具的构建块或库,或供应商产品栈的关键部分,或支持供应商的配套服务提供。开发人员可以将开源软件用于快速成型技术或微服务和小型应用程序。开发人员也经常采用开源软件开发工具,如集成开发环境( IDEs ),或基于 GitHub 和 GitLab 等开放源码构建的工具。现代云原生应用程序几乎默认使用开源系统进行容器编排、可观察性、数据存储、消息传递等。在应用程序的前端,开发人员严重依赖开源库和框架。 Red Hat 报告称,“ 90% 的 IT 领导者都在使用企业版开源软件。”像 Synopsys 这样的软件组合分析供应商确定 75% 以上的代码库包含开源组件。换句话说,几乎每个组织都在使用开源。然而,最早期的采用形式是 Ad Hoc ,由开发人员使用现成的工具和技术来解决问题。这种“ad hoc adoption”通常意味着默认值之外的许可证合规性会较少考虑,或消费开源、分发开源组件构建的产品的长期影响。在大多数情况下,只有少数开发者在积极寻求开源,而其他的开发组织可能碰巧使用开源,但并不认为其活动依赖于开源。因此,这些组织既没有集中关注开源的团队,也没有相应的顶级开源战略。这些是非常重要的,因为一旦采用,这些开源组件默认情况下将成为组织软件供应链的一部分,这使得战略方法变得更加重要。 第1阶段 为OSS合规、目录清单和开发人员培训做充分准备 一般来说,当一个组织意识到项目部和开发部几乎所有人都在使用开源产品和代码时,就会形成一个 OSPO 。这种用法通常是内部的,而不是给客户或用户的一部分产品或服务。实际上,任何一个有较为可观的IT功能和先进的线上的或以应用程序为中心的组织都使用开源,从 Linux 服务器、像 NodeJS 和 Python 的 MySQL 数据库编程语言和如 React 和 Vue.js 的前端框架的开源技术堆栈无处不在。 早期阶段,组织对 OSPO 使用过许多不同的名称。例如IBM最初将其程序化的开源工作称为“开源指导委员会”。然而,在所有情况下,阶段1中的组织都认识到开源软件是他们业务和技术战略的关键部分。他们明白开源软件项目的安全实践与私有软件公司的安全实践不同。例如,开源软件项目的披露规则往往比专有项目更严格。因此,他们必须确定他们的合规性和安全风险。降低风险的策略包括重视许可证风险、开发人员培训和识别准确的 OSS 清单。 管理法律风险和许可 组织的法律团队或技术领导倾向于启动第一阶段开发之前, OSPO 需要确保其员工(以及承包商、供应商等)都根据其 license 条款使用开源软件,并且组织使用 OSS 后不会被置于法律风险之中。他们有数十个开源 license 在使用。在 2020 年的调查中,受访者将合规列为大型企业 OSPO 的最大好处,中型企业的第二大好处。“企业在刚开始时通常会有很多困惑。目前还没有相应的许可策略,开发者只能做他们认为正确的事情。”弗里德里希亚历山大大学的开源软件教授 Dirk Riehle 说。他补充道: 我曾经走进一家公司,有个开发人员说:“我们没有开源策略”。另一个人打趣道:“我们有,而且是:没有开源”。对此,第三个人皱着眉头说:“你在说什么?我们为开源项目做贡献已经有一段时间了。”这并不罕见。他们最终将成立一个开源项目办公室,负责处理开源的使用和贡献。 尽管开源软件用户一直在考虑法律的合规性,但一些开源软件贡献者已经设计了新的许可证,以阻止基于开源项目创建专有服务的大型云供应商。其中最突出的是 Affero 通用公共许可证( AGPL )。企业可能会使用开源软件提供专有软件即服务( SaaS )给他们的客户,遵从 license 协议授权的条款,这进一步模糊了商业服务和内部服务之间的界限。 开发者培训 为了保持合规,处于 OSPO 成熟度阶段1的组织创建了教育项目,以帮助他们的开发人员判定在创建新产品或服务的何时使用开源软件。“许多没有接受过开源教育的开发人员认为,因为他们没有购买软件,没有签署合同,所以不涉及许可证。”VMware 的开源营销和战略总监 Suzanne Ambiel 说。“开源软件可能是免费的,不用花钱;但如果以不合规的方式使用,它也可能是昂贵的。开源软件总是伴随着许可证。任何开源软件最重要的角色之一就是确保开发者理解不同选择的许可含义。”通过对开发人员的培训,高级管理人员很认可开源软件的价值和重要性。在这些项目中,开发人员可以学习到: 不同类型许可证的细微差别 推出新的开源软件产品的正式批准流程消费不兼容开源软件的真正风险,包括使用项目中未经正式许可的代码或 OSS 产品 使用贡献者许可协议( CLAs )保护组织里为开源做出贡献的开发人员 有时候,组织在这个阶段引入正式的 CLA 策略,为判断开源软件项目的健康状况提供指导,作为其决定在组织的技术堆栈或基础结构中使用哪些开源软件标准的一部分。 清点软件清单 开发人员可能会临时调用开源软件,而不会系统地对他们的工作进行编目。法律团队和技术领导倾向于要求一个组织中使用的所有 OSS 的清单。清单逐条列记了组织代码库(例如,GitHub, GitLab )和系统中的 OSS 。阶段1组织建立特定的软件库存过程,以创建一个全组织范围的软件物料清单( SBOM )。 有了这个清单,法律团队(通常与 OSPO 团队一起工作)就可以持续地监视 OSS 的使用情况,并标记出法律、安全或其他项目风险。通过详细的 SBOM ,技术领导(如首席技术官 CTO 或首席信息官 CIO )可以识别并密切监视最关键的业务使用,保护组织的安全性。 第2阶段 宣传OSS使用和参与生态系统 在组织认识到 OSS 的价值以及合规、教育和 SBOM 的必要之后,他们开始意识到使用 OSS 的经济效益,并寻求扩大它。阶段2中的 OSPO 创建了这样的内部机制,例如作为大使推广已批准的 OSS 产品的使用方法、好的 OSS 知识管理教育计划、OSS 技能建设和认证的技术培训或学费报销。 有了这些计划,组织就可以增加对 OSS 的使用并扩大。OSS 不仅重要,而且比专有软件产品更可取的信息。员工教育包括与 OSS 项目交互的最佳实践,例如如何请求特性、文件错误报告和贡献基本代码的特点。 在这个阶段,组织加强了它的协作力量,并体验了 OSS 项目和社区的社交生活。在这一点上,OSPO 向员工和管理者传达了贡献而不仅仅是使用 OSS 的重要性。这种推广包括倡导和推动活动赞助,在公共编码论坛上预定项目负责人和维护人作为演讲嘉宾或小组成员,并设法获得关键任务 OSS 项目的组织资源(例如:人才,资金)。 对于组织而言,积极和可见的参与会产生多种好处:更高的知名度、更好的声誉、更具吸引力的雇主。鉴于此,许多非技术组织在重要的 OSS 活动上购买展位,以与这些社区进行更多互动,并招聘喜欢在 OSS 生态系统中工作的开发人员。活跃于开源领域的技术公司可能会将教育计划扩展到希望与 OSS 社区和供应商互动的客户。Red Hat 开源高级总监 Deborah Bryant 说:“我们收到了很多客户的请求,希望我们在如何参与开源、贡献开源,以及如何与我们在项目上进行合作给予帮助和指导。” 随着阶段2的推进,组织开始鼓励开发人员从事对组织运营起至关重要的 OSS 项目,以使开发人员成为高度活跃的贡献者或主要维护者。对于技术组织来说,为重要的 OSS 项目聘请贡献者是一项有价值的投资:他们的大多数贡献者,比如说,Linux 内核(操作系统的核心组件和计算机硬件和软件之间的关键接口)都是全职员工,他们的工作是为 Linux 编写代码。 在技术领域之外,很少有组织能够分配全职员工从事开源工作,但他们正在这样做。例如,康卡斯特和彭博都有员工全职从事 OSS 项目。在生命周期阶段,OSPO 开始探索如何简化开发人员使用 OSS 的过程。这种开发者效能包括简化 CLA ,将具有可接受许可类型的 OSS 添加到工单系统中以便快速审批,促进 OSS 架构和现有软件的重用(内部采购的一种变体)以及标准化库选择和开源开发工具,从而融合 OSPO 和平台运营职责。 在这个阶段,组织会向 OSPO 寻求有关如何积极参与开放生态系统的指导。“你需要确保你得到的和你所回馈的一样多。你不希望人们认为你只是在通过开源赚钱,而没有为社区做出贡献。”Futurewei 技术有限公司 OSPO 负责人 Chris Xie 说,“我们强烈考虑到这一点——比以往任何时候都更加强烈。” 电信等受监管行业的公司还必须了解其国家出口法律并驾驭政治紧张局势,以保护 OSS 社区并避免国际纠葛。“我们一直希望确保我们的贡献是真正开放的,能造福社区、造福整个行业的。” Xie 解释道。 通常在 OSPO 成熟度周期的第2阶段(如果是软件公司或以技术为核心的公司,也可能是在第1阶段),OSPO 开始为其开发人员简化和优化开源贡献。早期,请求和获得外部参与的批准的过程通常是临时的和痛苦的。“我们建立 OSPO 时,首先关注的事情之一就是贡献的流程。” SAP OSPO 首席架构师 Michael Picht 说, “使用 Word、Excel 和电子邮件,这个过程根本没有自动化。当我们打开 OSPO 时,我们做的第一件事就是简化流程并实现端到端工具支持。我们将 GitHub 用于解决不同的流程步骤。” 第3阶段 成长中的OSS项目托管社区 在第 3 阶段,组织发起并托管或充当 OSS 项目的主要发起人。他们将为一个项目指定一名或多名 FTE,并承担培育项目社区和确保其健康的责任。他们不会将这种级别的组织承诺与决定开源项目的员工混淆。在第 3 阶段,组织领导者支持在公共领域孵化和启动开源项目,因为他们了解这些项目如何使他们的组织受益。此类项目往往在关键功能上提供更好的性能和经济性,这些功能可能对组织的价值主张不核心,但对其技术基础设施至关重要。 此外,创建和启动开源项目的组织在开源社区中建立了广泛的信誉,开发开源技术的可能性吸引了许多开发人员。我们采访过的大多数 OSPO 都将招聘新人才和留住现有人才作为开源工作的关键动力。 在 Linux 基金会最近对金融服务行业的一项研究中,53% 的贡献者表示他们为 OSS 做出贡献是因为“它很有趣”。用 FTE 和资金支持项目是开源比赛的真实面目。跨越这一门槛并成功启动多个开源项目的组织开发的内部资源和流程,可以孵化并确保这些项目在启动后的成功。OSPO 不仅仅是项目形成和启动的守门人和导师;他们教育项目创建者培养健康的开源生态系统的要求,并指导项目负责人让他们为 OSS 项目所需的更公开的领导角色做好准备。 随着 OSS 组织的成熟,其 OSPO 开发内部流程、战术手册、检查表、工具和其他机制,以审查、组织和运营开源项目,并为其领导者做好准备和指导。一些 OSPO 更愿意在主要开源基金会或合作组织(如 TODO Group)的协助下启动项目,以增强性能或提供基础设施、战术援助和其他资源。这种偏好的资源密集度较低,但会将项目的控制权交给更广泛的社区。 第4阶段 成为战略决策合作伙伴 在这个成熟阶段,OSPO 成为技术决策的战略合作伙伴,帮助指导选择并形成长期投入的项目。在第 4 阶段,CTO 和其他技术领导咨询 OSPO 及其领导层,依赖哪些开源技术,使用哪些决策标准来判断开源项目。由于主要的开源技术选择往往会产生大量的二级和三级成本,并影响上游和下游技术以及招聘计划,因此开源技术选择成为一项重大的商业决策。 从广义上讲,OSPO 在第 4 阶段提供了三种类型的战略指导。首先,OSPO 建议 CTO 和技术领导采用或从组织的技术堆栈中删除哪些开源技术。鉴于当今有许多 OSS 选项——大多数主要的软件类别都有数十种选项。如下图所示,OSPO可以洞察OSS的趋势,例如不同语言的流行程度、API 设计或不同 NoSQL 数据库的功能。在这个角色中,OSPO 成为 CTO 的内部技术顾问和内部OSS专家。 在第二种类型的战略指导中,OSPO 带头对构成可接受的 OSS 项目的内容进行基准测试。OSPO 经常评估项目的行为和绩效,特别是限制使用的许可类型的变化,或项目路线图的突然变化,以确定项目经理是否考虑到社区的最佳利益。大多数 OSPO 依赖粗略的指标来评估项目行为,例如: 它拥有哪种类型的许可证? 它的行为准则是什么,违反它的后果是什么? 它的治理结构是什么,这种结构是否确保独立性? 响应pull请求或漏洞归档需要多长时间? 项目发布新版本的频率? 是由一方(公司或组织)还是整个社区控制项目? 该项目有多少贡献者?这个数字是如何随时间变化的? 第三种指导是帮助组织理解和驾驭项目政治,例如当多个有影响力的参与者试图引导一个项目保持中立立场,或者阐明社区成员潜在的政治考虑。在更高的层面上,OSPO 可以通过培养超越国界和政治领域的个人和工作关系,帮助公司在技术民族主义上保持中立姿态并弥合政治分歧。 随着这些领域成为开源中重要的中立空间,这种价值逐渐延伸到基金会和非营利组织的工作中。Red Hat 的黛博拉•布莱恩特( Deborah Bryant )表示,她的 OSPO 不得不管理参与开源基金会工作的成本,包括赞助和派遣员工担任领导角色。“我们发现,我们需要花更多时间在参与软件基金会的一些集中管理和行政管理上,以确保我们的投资获得回报,并定期重新评估我们的参与。”在这个职位上,OSPO 拥有数百万美元的基金会预算,参与 OSS 生态系统的形成和增长的战略重要性与对基金会和非营利组织的货币投资相是相同的。在这个阶段,我们倾向于看到 OSPO 的快速增长。VMware 的 Ambiel 说: 今天,OSPO 的主要目标之一是帮助提供最佳指导实践以及如何成为一名优秀的开源公民。当你在开源社区时,你就是在参与开放——每个人都可以看到你在做什么。重要的是,一个组织要尽其所能。无论是在会议上发言,还是为参加Kubernetes这样的大型项目社区贡献一个小型库,OSPO都能帮助人们始终如一地、充满信心地做到这一点。 INFOBOX 1.利用开源项目办公室:新研究揭示了OSPO的演变:https://linuxfoundation.org/blog/leveraging-the-open-source-program-office-new-research-unpacks-the-evolution-of-the-ospo-and-a-whole-lot-more/ 2.开源项目办公室(OSPO)的发展:https://linuxfoundation.org/tools/the-evolution-of-the-open-source-program-office-ospo/

优秀的个人博客,低调大师

解析Java-throw抛出异常详细过程

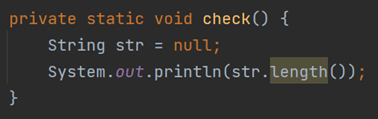
摘要:Java有3种抛出异常的形式:throw、throws、系统自动抛异常。 本文分享自华为云社区《Java-throw异常详解以及过程》,作者: gentle_zhou 。 首先,我们知道Java有3种抛出异常的形式:throw(执行的时候一定抛出某种异常对象), throws(出现异常的可能性,不一定会发生), 系统自动抛异常。 throw用在一个语句抛出异常的时候,throw (an instance of exception class)比如一个方法/函数里,try{…}catch(Exception e){throw new ArithmeticException(“XXX”);}finally{…}; throws则是用在声明方法可能抛出异常的时候,throw (exception class)比如public int division(int x, int y) throws ArithmeticException {…}; 系统自动抛异常则是当程序语句出现逻辑错误,主义错误或类型转换错误的时候,系统自动抛出异常,比如int a = 5; int b = 0; c = a/b; 这个时候移动会自动抛出ArithmeticException。 什么是异常 异常,顾名思义,就是有异于正常状态,有错误发生。而这错误会阻止Java当前函数方法的运行。 那么Java里面异常的体系是怎么样的呢? 1.Java里面所有不正常类都继承于Throwable类;而Throwable类包括2类:Error类和Exception类。 2.Error类包括虚拟机错误(VirtualMachineError)和线程死锁(ThreadDeath)。 3.Exception类则是我们在说的异常;包括运行时异常(RuntimeException)和检查异常;这里的异常通常是编码,环境,用户操作输入出现了问题。 4.运行时异常(RuntimeException)包括以下4种异常:空指针异常(NullPointerException),数组下标越界异常(ArrayIndexOutOfBoundsException),类型转换异常(ClassCastException),算术异常(ArithmeticException)。 空指针异常: 数组下标越界异常: 类型转换异常: 算术异常: 5.最后剩下的检查异常则是剩下各种异常的集合;这里发生异常的原因有很多,文件异常(IOException),连接异常(SQLException)等等;和运行时异常不同的是,这里的异常我们必须手动在代码里添加try…catch…(finally…)语句来捕获处理。 今天又了解学习到了一些具体的额外的异常: Throw抛出异常详细过程 和throws声明方法可能会发生异常不同,throw语句则是直接抛出一个异常。 前面有提到,throw (an instance of exception class),这里的一个exception类的实例其实也可以说是一个ExceptionObject(Throwable类或则其子类 的对象;也可以是自定义的继承自Throwable的直接或间接的异常类)。如果,我们用了throw new String(“异常XXX”); 则会在编译的时候报错,因为String 类并不是Throwable类的子类。 接着让我们回到怎么用throw语句的阶段。 一般我们有两种方式来用throw:直接在某处会发生异常的地方用throw语句 或则 用try…catch…finally…语句来捕获处理异常和关闭释放资源。 首先是第一种,直接在某处会发生异常的地方用throw语句;这是一种主动的方法,主动抛出异常去处理。而第二种,用try…catch…finally…语句来捕获处理异常和关闭释放资源 则是被动的方法。try里面放入可能会发生异常的语句块,如果在运行期间遇到了异常,则会交给catch来处理异常(catch可以是多个,处理不同的异常),finally则是无论有没有异常发生,只要加上了就会运行。 首先我们来看第一种方法的函数: 我们的int c = 4/2,其实是正确的;但是我们的throw 语句主动抛出了异常,那么程序就会到catch里面找有没有这个异常,有的话进行处理。所以我们要主动抛异常的话,要很确信这个代码一定会发生异常且后期不太会去变动了(最好放在if条件语句里)。所以我们得到的结果如下: 接着我们来看第二种方法。我们一开始先测正确的,只是把主动抛出异常语句给注释掉: 因为try里面的语句块没有异常,所以只执行了try和finally里面的语句块。运行的结果如下: 我们接着来测当try里面的语句块有异常,且没有主动抛出异常的时候,try会不会捕捉到异常吧: 得到的结果如下,会去处理异常和执行finally里面的语句块: 最后深入理解一点try里面的异常触发会逐层向上的这个概念。在我们try语句里主动/被动抛出异常的时候,程序会调向调用者程序(上面的例子里就是我们自己这个函数;但有的时候我们会在try语句里执行别的函数比如B,这个函数B里我们假如触发了异常,它会调向try语句所在的函数A),寻找和它相匹配的catch语句,执行catch语句里面相应的异常处理程序;但假如没有找到相匹配的catch语句,那么它会再转向上一层的调用程序…这样逐层向上,直到最外层的异常程序终止程序并打印出stack trace。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

“消息驱动、事件驱动、流 ”基础概念解析

作者:肯梦 阿里云消息队列 RocketMQ 5.0 实现了全新升级,实现了从“消息”到“消息、事件、流”的大融合,基于此,Message-Driven、Event-Driven、Streaming 这三个词是近期消息领域高频词,但由于概念过于新,很多同学其实是不太理解这里的异同。本文把三个概念重新整理下,梳理出比较明确的概念讲给大家。 背景 首先这三个概念具体翻译如下: Message-Driven: 消息驱动的通信; Event- Driven: 事件驱动的通信; Streaming: 流模式。 这三个模式都是类似异步通信的模式,发送消息的服务不会等待消费消息服务响应任何数据,做服务解耦是三个模式共同的特性; 只要是在服务通讯领域内,在选型时还要考虑如下特性: 排序: 是否可以保证特定的顺序交付; 事务: 生产者或消费者是否可以参与分布式事务; 持久化: 数据如何被持久化,以及是否可以重放数据; 订阅过滤: 是否拥有根据Tag或其他字段做订阅过滤的能力; At – least -once(最少交付一次),At-most-once(最多交付一次),Exactly-once (精确交付)。 通用背景介绍完,依次来看看各个模型代表的是什么意思。 消息驱动 Message-Driven 在消息驱动通信中,一般链路就是消息生产者(Producer)向消息消费者(Consumer)发送消息。模型如下: 消息驱动模式下通常会用到中间件,比较常见的中间组件有 RocketMQ,Kafka,RabbitMQ 等。这些中间件的目的是缓存生产者投递的消息直到消费者准备接收这些消息,以此将两端系统解耦。 在消息驱动架构中,消息的格式是基于消费者的需求制定的;消息传递可以是一对一,多对多,一对多或多对一。 消息驱动通讯比较常见的一个例子是商品订单推送,上游组件负责生成订单,下游组件负责接收订单并处理。通过这样的通讯方式上游生成组件其实无需关心整个订单的生命周期,更专注于如何快速生成订单,使单个组件的性能得以提升。! 消息驱动模式在服务之间提供了轻的耦合(这部分耦合指代 Producer/Consumer SDK),并可以对生产和消费服务根据诉求进行扩展。 事件驱动Event-Driven 首先要申明一个观点:事件驱动其实是对消息驱动方法的改进,它对消息体大小,消息格式做了较为严格的限制,这层基于消息的限制封装其实就称为事件(Event)。 在事件驱动模式中,生产者发布事件来表示系统变更,任何感兴趣且有权限接入的服务都可以订阅这些事件,并将这些事件作为触发器来启动某些逻辑/存储/任务。​ 事件驱动的模式可以是一对一,多对一,一对多或多对多。通常情况下一般是多个目标根据过滤条件执行不同的事件。 在事件驱动架构中,事件的格式是由生产者根据事件标准协议制定的;由于更规范限制和封装,事件的生产者完全不需要关心有哪些系统正在消费它生成的事件。 事件不是命令,事件不会告诉消费者如何处理信息,他们的作用只是告诉消费者此时此刻有个事件发生了;事件是一份不可变的数据,重要的数据,它与消息的数据价值相同;通常情况下当某个事件发生并执行时,往往伴随着另一个事件的产生。 事件驱动提供了服务间的最小耦合,并允许生产服务和消费服务根据需求进行扩展;事件驱动可以在不影响现有服务的情况下添加各类新增组件。 事件驱动也可以举一个非常贴切的例子,我们以“客户购买完一款商品”为一个事件,举证在事件场景的应用: CRM(客户关系系统)系统接收到客户购买信息,可自行更新客户的购买记录; EMR(库存管理系统) 系统接收到客户购买信息,动态调整库存并及时补货; 快递服务接收到客户购买信息,自行打单并通知快递公司派送。 这么看,事件驱动模式是不是可以应用并出现在任何地方! 在EventBridge产品化方向,也正是由于针对消息做了一些标准化封装,才有可能实现譬如针对事件本身的 filter(过滤) ,transform(转换),schema(事件结构),search(查询) 等能力。这些能力也拓展出更多针对事件驱动特有的场景功能及相关特性。 流Streaming 流是一组有序的无界事件或数据,执行操作通常是固定的某个事件段(e.g. 00:00 – 12:00)或一个相对事件(E.g. 过去 12 小时)。 通常情况下单个事件往往就是使用事件本身,但是对于流可能的操作大概率是过滤,组合,拆分,映射等等。 流的操作可以是无状态也可以是有状态的: 对于单个事件操作是无状态的,包括过滤和映射; 依赖消息在流的时间或位置(e.g. offset,time)是有状态的。有状态操作中,流处理逻辑必须保留一些已被消费消息的内存。有状态包括对数据做 Batch Size,Batch Window 等。 流这里也可以举一个比较简单的例子,比如我们的物流系统在物品通过一个物流节点时会生成一个事件,但是要查到这个物品完整的流转状态事件,则必须是各个物流节点单个事件的聚合,那这个聚合事件就是流事件。 Kafka 是最典型的流式中间件,在流式场景中,事件的位置信息至关重要。通常情况下位置信息(E.g. offset)是由消费者托管的。 事件规范标准 聊完 Event 和 Streaming 是什么,再来补充一点有关于它们的规范。 事件规范存在的目的是为了清晰事件生产者和消费者的关系,目前主要有两部分:AsyncAPI 和 CloudEvents; AsyncAPI: 基于事件 API 提供了与之对应的 Open API 和 Swagger 等;CloudEvents: 侧重于处理事件的元数据。 下面也重点介绍一些关于 CloudEvents 的相关概念参考:CloudEvents 的核心其实是定义了一组关于不同组件间传输事件的元数据,以及这些元数据应该如何出现在消息体中。 其主旨大抵如下: 事件规范化; 降低平台集成难度; 提高 FaaS 的可移植性; 源事件可追踪; 提升事件关联性 准确的事件体,事件信息才可以做出更稳定的系统架构,永远保持对事件的敬畏。 附 一些术语及定义: Occurrence: 发生,指事件逻辑上的发生,基于某种情况,事件出现了; Event: 事件,表示事件以及上下文的数据记录。可以根据事件中的信息决定路由,但事件本身并不包含路由信息; Producer: 生产者,真正创造事件的实例或组件; Source: 源,事件发生的上下文,可以由多个 producer 组成; Consumer: 消费者,接收事件并对事件进行消费; Intermediary:中介,接收包含事件的消息(message),并转发给下一个接收方,类似路由器; Context: 上下文,上下文元数据被封装到 context attributes 中,用来判断事件与其它系统的关系; Data: 数据,也可以叫做 payload; EventFormat:事件格式,例如 json; Message: 消息,封装事件并将其从 source 传递到 destination; Protocol: 协议,可以是行业标准如 http,开源协议如 Kafka 或者供应商协议如 AWS Kinesis; Protocol Binding: 协议绑定,描述如何通过给定的协议收发事件,如何将事件放到消息里。 重磅推荐 本文旨在帮助大家对近期消息领域的高频词“消息驱动(Message-Driven),事件驱动(Event-Driven)和流(Streaming)”有更清晰的了解和认知,其中事件驱动 EDA 作为 Gartner 预测的十大技术趋势之一, EventBridge 作为下一代消息中间件,也是目前的重点方向之一。如果大家感兴趣,想要有更多了解,可关注**「阿里云 EventBridge 系列公开课」**,完整课程正火热开讲中! 点击​​此处​​,可以直接观看课程视频~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册