首页 文章 精选 留言 我的

精选列表

搜索[移动解析],共10000篇文章
优秀的个人博客,低调大师

Java 源码解析实战 - ThreadLocal 原理

说起CS游戏,应该是每个中二少年的年少回忆了.游戏开始时,每个人能够领到一把枪,枪把上有三个数字:子弹数、杀敌数、自己的命数,为其设置的初始值分别为1500、0、10. 设战场上的每个人都是一个线程,那么这三个初始值写在哪里呢?如果每个线程都写死这三个值,万一将初始子弹数统一改成 1000发呢?如果共享,那么线程之间的并发修改会导致数据不准确.能不能构造这样一个对象,将这个对象设置为共享变量,统一设置初始值,但是每个线程对这个值的修改都是互相独立的.这个对象就是ThreadLocal 注意不能将其翻译为线程本地化或本地线程英语恰当的名称应该叫作:CopyValueIntoEveryThread 示例代码该示例中,无 set 操作,那么初始值又是如何进入每个线程成为独立拷贝的呢?首先,虽然ThreadLocal在定义时重写了initial

优秀的个人博客,低调大师

非常详尽的 Shiro 架构解析!

Shiro是什么? Apache Shiro是一个强大而灵活的开源安全框架,它干净利落地处理身份认证,授权,企业会话管理和加密。 Apache Shiro的首要目标是易于使用和理解。安全有时候是很复杂的,甚至是痛苦的,但它没有必要这样。框架应该尽可能掩盖复杂的地方,露出一个干净而直观的API,来简化开发人员在使他们的应用程序安全上的努力。 官网:http://shiro.apache.org Shiro有什么用? 以下是你可以用Apache Shiro所做的事情: ● 验证用户来核实他们的身份 ● 对用户执行访问控制,如: 1. 判断用户是否被分配了一个确定的安全角色; 2. 判断用户是否被允许做某事; ● 在任何环境下使用Session API,即使没有Web或EJB容器。 ● 在身份验证,访问控制期间或在会话的生命周期,对事件作出反应。 ● 聚集一个或多个用户安全数据的数据源,并作为一个单一的复合用户“视图”。 ● 启用单点登录(SSO)功能。 ● 为没有关联到登录的用户启用"Remember Me"服务 ● 以及更多——全部集成到紧密结合的易于使用的API中。 Shiro 视图在所有应用程序环境下实现这些目标——从最简单的命令行应用程序到最大的企业应用,不强制依赖其他第三方框架,容器,或应用服务器。当然,该项目的目标是尽可能地融入到这些环境,但它能够在任何环境下立即可用。 Shiro特性 Apache Shiro是一个拥有许多功能的综合性的程序安全框架。 Shiro把Shiro开发团队称为“应用程序的四大基石”——身份验证,授权,会话管理和加密作为其目标。 ● Authentication:有时也简称为“登录”,这是一个证明用户是他们所说的他们是谁的行为。 ● Authorization:访问控制的过程,也就是绝对“谁”去访问“什么”。 ● Session Management:管理用户特定的会话,即使在非 Web 或 EJB 应用程序。 ● Cryptography:通过使用加密算法保持数据安全同时易于使用。 也提供了额外的功能来支持和加强在不同环境下所关注的方面,尤其是以下这些: ● Web Support:Shiro的web支持的API能够轻松地帮助保护 Web 应用程序。 ● Caching:缓存是Apache Shiro中的第一层公民,来确保安全操作快速而又高效。 ● Concurrency:Apache Shiro利用它的并发特性来支持多线程应用程序。 ● Testing:测试支持的存在来帮助你编写单元测试和集成测试,并确保你的能够如预期的一样安全。 ● "Run As":一个允许用户假设为另一个用户身份(如果允许)的功能,有时候在管理脚本很有用。 ● "Remember Me":在会话中记住用户的身份,所以他们只需要在强制时候登录。 Shiro 架构 Apache Shiro的设计目标是通过直观和易于使用来简化应用程序安全。Shiro 的核心设计体现了大多数人们是如何考虑应用程序安全的——在某些人(或某些事)与应用程序交互的背景下。 应用软件通常是基于用户背景情况设计的。也就是说,你将经常设计用户接口或服务API,基于一个用户将要(或应该)如何与该软件交互。例如,你可能会说,“如果用户与我的应用程序交互的用户已经登录,我将显示一个他们能够点击的按钮来查看他们的帐户信息。如果他们没有登录,我将显示一个登录按钮。” 这个简单的陈述表明应用程序很大程度上的编写是为了满足用户的要求和需要。即使该“用户”是另一个软件系统而不是一个人类,你仍然得编写代码来响应行为,基于当前与你的软件进行交互的人或物。 Shiro在它自己的设计中体现了这些概念。通过匹配那些对于软件开发人员来说已经很直观的东西,Apache Shiro几乎在任何应用程序保持了直观和易用性。 在最高的概念层次,Shiro的架构有3个主要的概念:Subject,SecurityManager 和 Realms。 下面的关系图是关于这些组件是如何交互的高级概述,而且我们将会在下面讨论每一个概念: Subject 在我们的教程中已经提到,Subject实质上是一个当前执行用户的特定的安全“视图”。鉴于"User"一词通常意味着一个人,而一个Subject可以是一个人,但它还可以代表第三方服务,daemon account,cron job,或其他类似的任何东西——基本上是当前正与软件进行交互的任何东西。 所有Subject实例都被绑定到(且这是必须的)一个SecurityManager上。当你与一个Subject交互时,那些交互作用转化为与SecurityManager交互的特定subject的交互作用。 SecurityManager SecurityManager是Shiro架构的心脏,并作为一种“保护伞”对象来协调内部的安全组件共同构成一个对象图。然而,一旦SecurityManager和它的内置对象图已经配置给一个应用程序,那么它单独留下来,且应用程序开发人员几乎使用他们所有的时间来处理Subject API。 稍后会更详细地讨论SecurityManager,但重要的是要认识到,当你正与一个Subject进行交互时,实质上是幕后的 SecurityManager处理所有繁重的Subject安全操作。这反映在上面的基本流程图。 Realms Realms担当Shiro和你的应用程序的安全数据之间的“桥梁”或“连接器”。当它实际上与安全相关的数据如用来执行身份验证(登录)及授权(访问控制)的用户帐户交互时,Shiro 从一个或多个为应用程序配置的Realm中寻找许多这样的东西。 在这个意义上说,Realm本质上是一个特定安全的DAO:它封装了数据源的连接详细信息,使Shiro所需的相关的数据可用。当配置Shiro时,你必须指定至少一个Realm用来进行身份验证和/或授权。SecurityManager可能配置多个Realms,但至少有一个是必须的。 Shiro提供了立即可用的Realms来连接一些安全数据源(即目录),如LDAP,关系数据库(JDBC),文本配置源,像 INI 及属性文件,以及更多。你可以插入你自己的Realm 实现来代表自定义的数据源,如果默认地Realm不符合你的需求。 像其他内置组件一样,Shiro SecurityManager控制 Realms是如何被用来获取安全和身份数据来代表 Subject 实例的。 下图展示了Shiro的核心架构概念,紧跟其后的是每个的简短总结: Subject(org.apache.shiro.subject.Subject) 当前与软件进行交互的实体(用户,第三方服务,cron job,等等)的安全特定“视图”。 SecurityManager(org.apache.shiro.mgt.SecurityManager) 如上所述,SecurityManager是Shiro架构的心脏。它基本上是一个“保护伞”对象,协调其管理的组件以确保它们能够一起顺利的工作。它还管理每个应用程序用户的Shiro 的视图,因此它知道如何执行每个用户的安全操作。 Authenticator(org.apache.shiro.authc.Authenticator) Authenticator是一个对执行及对用户的身份验证(登录)尝试负责的组件。当一个用户尝试登录时,该逻辑被 Authenticator执行。Authenticator知道如何与一个或多个Realm协调来存储相关的用户/帐户信息。从这些Realm中获得的数据被用来验证用户的身份来保证用户确实是他们所说的他们是谁。 Authentication Strategy(org.apache.shiro.authc.pam.AuthenticationStrategy) 如果不止一个Realm被配置,则AuthenticationStrategy将会协调这些Realm来决定身份认证尝试成功或失败下的条件(例如,如果一个Realm成功,而其他的均失败,是否该尝试成功?是否所有的Realm必须成功?或只有第一个成功即可?)。 Authorizer(org.apache.shiro.authz.Authorizer) Authorizer是负责在应用程序中决定用户的访问控制的组件。它是一种最终判定用户是否被允许做某事的机制。与 Authenticator相似,Authorizer也知道如何协调多个后台数据源来访问角色恶化权限信息。Authorizer使用该信息来准确地决定用户是否被允许执行给定的动作。 SessionManager(org.apache.shiro.session.SessionManager) SessionManager知道如何去创建及管理用户Session生命周期来为所有环境下的用户提供一个强健的Session体验。这在安全框架界是一个独有的特色——Shiro拥有能够在任何环境下本地化管理用户Session的能力,即使没有可用的Web/Servlet或EJB容器,它将会使用它内置的企业级会话管理来提供同样的编程体验。SessionDAO的存在允许任何数据源能够在持久会话中使用。 SessionDAO(org.apache.shiro.session.mgt.eis.SessionDAO) SesssionDAO代表SessionManager执行Session持久化(CRUD)操作。这允许任何数据存储被插入到会话管理的基础之中。 CacheManager(org.apahce.shiro.cache.CacheManager) CacheManager创建并管理其他Shiro组件使用的Cache实例生命周期。因为Shiro能够访问许多后台数据源,由于身份验证,授权和会话管理,缓存在框架中一直是一流的架构功能,用来在同时使用这些数据源时提高性能。任何现代开源和/或企业的缓存产品能够被插入到Shiro来提供一个快速及高效的用户体验。 Cryptography(org.apache.shiro.crypto.*) Cryptography是对企业安全框架的一个很自然的补充。Shiro的crypto包包含量易于使用和理解的cryptographic Ciphers,Hasher(又名digests)以及不同的编码器实现的代表。所有在这个包中的类都被精心地设计以易于使用和易于理解。任何使用Java的本地密码支持的人都知道它可以是一个难以驯服的具有挑战性的动物。Shiro的cryptoAPI 简化了复杂的Java机制,并使加密对于普通人也易于使用。 Realms(org.apache.shiro.realm.Realm) 如上所述,Realms在Shiro和你的应用程序的安全数据之间担当“桥梁”或“连接器”。当它实际上与安全相关的数据如用来执行身份验证(登录)及授权(访问控制)的用户帐户交互时,Shiro从一个或多个为应用程序配置的Realm中寻找许多这样的东西。你可以按你的需要配置多个Realm(通常一个数据源一个Realm),且Shiro将为身份验证和授权对它们进行必要的协调。 The SecurityManager 因为Shiro的API鼓励一个以Subject为中心的编程方式,大多数应用程序开发人员很少,如果真有,与SecurityManager直接进行交互(框架开发人员有时候会觉得它很有用)。即便如此,了解如何SecurityManager是如何工作的仍然是很重要的,尤其是在为应用程序配置一个SecurityManager的时候。 Design 如前所述,应用程序的SecurityManager执行安全操作并管理所有应用程序用户的状态。在Shiro的默认SecurityManager实现中,这包括: ● Authentication ● Authorization ● Session Management ● Cache Management ● Realm coordination ● Event propagation ● "Remember Me" Services ● Subject creation ● Logout 以及更多。 但这是许多功能来尝试管理一个单一的组件。而且,使这些东西灵活而又可定制将会是非常困难的,如果一切都集中到一个单一的实现类。 为了简化配置并启用灵活配置/可插性,Shiro的实现都是高度模块化设计——由于如此的模块化,SecurityManager实现(以及它的类层次结构)并没有做很多事情。相反,SecurityManager 实现主要是作为一个轻量级的“容器”组件,委托计划所有的行为到嵌套/包裹的组件。这种“包装”的设计体现在上面的详细构架图。 虽然组件实际上执行逻辑,但SecurityManager实现知道何时以及如何协调组件来完成正确的行为。SecurityManager 实现和组件都是兼容JavaBean的,它允许你(或某个配置机制)通过标准的JavaBean的accessor/mutator 方法(get/set)轻松地自定义可拔插组件。这意味着 Shiro 的架构的组件性能够把自定义行为转化为非常容易的配置文件。 Easy Configuration 由于JavaBeans的兼容性,通过任何支持JavaBean风格的配置的机制可以很容易的用自定义组件配置SecurityManager,如 Spring,Guice,JBoss,等等。 原文发布时间为:2018-11-13 本文来自云栖社区合作伙伴“Java技术栈”,了解相关信息可以关注“Java技术栈”。

优秀的个人博客,低调大师

RocketMQ原理解析-producer(转)

1,启动流程 Producer如何感知要发送消息的broker(brokerAddrTable中的值是怎么获得的)? producer本地集合中没有,会根据指定topic到namesrv获取TopicPublishInfo,并放入本地集合。 定时从namesrv更新topic路由信息。 Producer与broker间的心跳 Producer定时发送心跳,将producer信息(其实就是procduer的group)定时发送到broker(brokerAddrTable集合中列出的)。 master接收消息,slave拷贝master Producer发送消息,只发送到broker_master机器,通过broker的主从复制机制拷贝到broker_slave。 2,如何发送消息 producer轮询某topic下的所有queue的方式 实现发送方的负载均衡。 Topic下的所有队列如何理解? Broker Topic queue 注册namesrv队列(Topic_A) broker1 Topic_A queue0 , queue1 broker1_queue0 ,broker1_queue1 broker2 Topic_A queue0, queue2, queue3 broker2_queue0,broker2_queue1,broker2_queue2 broker3 Topic_A queue0 broker3_queue0 Producer如何实现轮询队列? Producer从namesrv获得topic_A路由信息TopicPublishInfo。 //Topic_A的所有的队列 private List<MessageQueue> messageQueueList //自增整型 private volatile ThreadLocalIndex sendWhichQueue /** *选择一个发送队列 *lastBrokerName不为空,代表上次选择的queue失败,本次避开同一个queue */ public MessageQueue selectOneMessageQueue(final String lastBrokerName){ //计算队列下标 //sendWhichQueue.getAndIncrement()每次调用+1 Math.abs(sendWhichQueue.getAndIncrement()) % this.messageQueueList.size() } Producer发消息系统重试? //消息发送失败重试次数默认为2 private int retryTimesWhenSendFailed = 2; //发送消息超时时间 private int sendMsgTimeout = 3000; 发送失败,换个队列继续发送所需条件: 1. 重试次数不到retryTimesWhenSendFailed (默认2次) 2. 发送此条消息花费时间还没有到sendMsgTimeout (默认3000毫秒) 3,如何发送顺序消息 4,发送分布式事物消息 5,消息在broker落地之普通消息 6,消息在broker落地之事物消息

优秀的个人博客,低调大师

Linux overlay文件系统解析

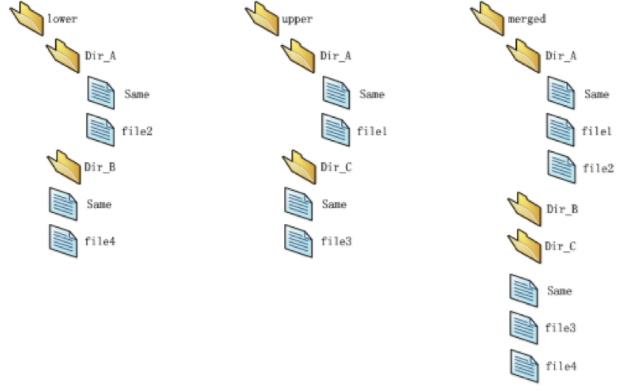
一个 overlay 文件系统包含两个文件系统,一个 upper 文件系统和一个 lower 文件系统,是一种新型的联合文件系统。overlay是“覆盖…上面”的意思,overlay文件系统则表示一个文件系统覆盖在另一个文件系统上面。 为了更好的展示 overlay 文件系统的原理,现新构建一个overlay文件系统。文件树结构如下: image 1、在一个支持 overlay文件系统的 Linux (内核3.18以上)的操作系统上一个同级目录内(如/root下)创建四个文件目录 lower 、upper 、merged 、work其中 lower 和 upper 文件夹的内容如上图所示,merged 和work 为空,same文件名相同,内容不同。 2、在/root目录下执行如下挂载命令,可以看到空的merged文件夹里已经包含了 lower 及 upper 文件夹中的所有文件及目录。 $mount -t overlay overlay -olowerdir=./lower,upperdir=./upper,workdir=./work ./merged 3、使用df –h 命令可以看到新构建的 overlay 文件系统已挂载。 Filesystem Size Used Avail Use% Mounted on overlay 20G 13G 7.8G 62% /root /merged 那么 lower 和 upper 目录里有相同的文件夹及相同的文件,合并到 merged 目录里时显示的是哪个呢?规则如下: 1. 文件名及目录不相同,则 lower 及 upper 目录中的文件及目录按原结构都融入到 merged 目录中; 2. 文件名相同,只显示 upper 层的文件。如上图在 lower 和 upper 目录下及下层目录 dir_A 下都有 same.txt 文件,但在合并到 merged 目录时,则只显示 upper 的,而 lower 的隐藏 ; 3. 目录名相同, 对目录进行合并成一个目录。如上图在 lower 及 upper 目录下都有 dir_A 目录,将目录及目录下的所有文件合并到 merged 的 dir_A 目录,目录内如有文件名相同,则同样只显示 upper 的,如上图中 dir_A 目录下的same.txt文件。 overlay只支持两层,upper文件系统通常是可写的;lower文件系统则是只读,这就表示着,当我们对 overlay 文件系统做任何的变更,都只会修改 upper 文件系统中的文件。那下面看一下overlay文件系统的读,写,删除操作。 读 ¬ 读 upper 没有而 lower 有的文件时,需从 lower 读; ¬ 读只在 upper 有的文件时,则直接从 upper 读 ¬ 读 lower 和 upper 都有的文件时,则直接从 upper 读。 写 ¬ 对只在 upper 有的文件时,则直接在 upper 写 ¬ 对在lower 和 upper 都有的文件时,则直接在 upper 写。 ¬ 对只在 lower 有的文件写时,则会做一个copy_up 的操作,先从 lower将文件拷贝一份到upper,同时为文件创建一个硬链接。此时可以看到 upper 目录下生成了两个新文件,写的操作只对从lower 复制到 upper 的文件生效,而 lower 还是原文件。 删 ¬ 删除 lower 和 upper 都有的文件时,upper 的会被删除,在 upper 目录下创建一个 ‘without’ 文件,而 lower 的不会被删除。 ¬ 删除 lower 有而 upper 没有的文件时,会为被删除的文件在 upper 目录下创建一个 ‘without’ 文件,而 lower 的不会被删除。 ¬ 删除 lower 和 upper 都有的目录时,upper 的会被删除,在 upper 目录下创建一个类似‘without’ 文件的 ‘opaque’ 目录,而 lower 的不会被删除。 可以看到,因为 lower 是只读,所以无论对 lower 上的文件和目录做任何的操作都不会对 lower 做变更。所有的操作都是对在 upper 做, 。 copy_up只在第一次写时对文件做copy_up操作,后面的操作都不再需要做copy_up,都只操作这个文件,特别适合大文件的场景。overlay的 copy_up操作要比AUFS相同的操作要快,因为AUFS有很多层,在穿过很多层时可能会有延迟,而overlay 只有两层。而且overlay在2014年并入linux kernel mailline ,但是aufs并没有被并入linux kernel mailline ,所以overlay 可能会比AUFS快。 lower文件系统可以为任何linux支持的文件系统,甚至可以为另一个overlayfs。因为虽然overlay文件系统的底层是由两个文件系统构成,但它本身只是一个文件系统,就如前面用df命令看到的,所以也可以和其他文件系统组成新的overlay文件系统。而upper是可写的,不支持NFS。多层 lower 可执行如下命令: $mount -t overlay overlay -olowerdir=/lower1:/lower2:/lower3 ,upperdir=./upper,workdir=./work ./merged 上例中,lower 是由三个文件系统合并成一个文件系统,其中lower1在最上面,lower3在最底下。 Docker一直在用AUFS(高级多层次统一文件系统)作为容器的文件系统。AUFS是一个能透明覆盖一或多个现有文件系统的层状文件系统。当一个进程需要修改一个文件时,AUFS创建该文件的一个副本。AUFS可以把多层合并成文件系统的单层表示。Docker 的image构采用的是AUFS,每个新版本都是一个与之前版本的简单差异改动,有效地保持镜像文件最小化。那docker 使用 overlay 之后有什么区别呢? 首先镜像在下载时每一层的镜像都有一个自己的镜像ID,每个镜像都会有自己的目录,保存在/var/lib/docker/overlay目录下,但是这些层目录的名字并不是下载镜像时的ID名称。我们都知道AUFS是多层,那如何体现为两层呢?启动一个容器后,也在这个目录下产生一个层目录,进入到目录可以看到有三个文件夹,分别是merged,upper,work,和一个文件lower-id,而在lower-id中保存的就是镜像最上层的ID,所以对容器来说,还是一个两层的文件系统。 image 这里说明一下,docker pull image时显示的镜像ID名称与/var/lib/docker/overlay目录下的镜像目录名称不一样。镜像目录中保存的是这层独有的文件和硬链接下层共享的文件。这样可以更有效的利用磁盘资源。 从上面这个图可以看到,overlay的两层对应的就是docker的镜像层(只读)和容器层(可写),只是把原来AUFS中的多层镜像合并成了lower层,而upper层代表的是容器层。 我们看到虽然overlay和AUFS都是联合文件系统,但结构比AUFS简单,且并入了linux kernel mainline,可能会比AUFS快,但还是太年轻,要谨慎在生产使用。而AUFS做为docker的第一个存储驱动,已经有很长的历史,比较的稳定,且在大量的生产中实践过,有较强的社区支持。 转载自:http://dockone.io/article/1511

优秀的个人博客,低调大师

Java多线程——FutureTask源码解析

一个很常见的多线程案例是,我们安排主线程作为分配任务和汇总的一方,然后将计算工作切分为多个子任务,安排多个线程去计算,最后所有的计算结果由主线程进行汇总。比如,归并排序,字符频率的统计等等。 我们知道Runnable是不返回计算结果的,如果想利用多线程的话,只能存储到一个实例的内部变量里面进行交互,但存在一个问题,如何判断是否已经计算完成了。用Thread.join是一个方案,但是我们只能依次等待一个线程结束后处理一个线程,如果线程1恰好特别慢,则后续已经完成的线程不能被及时处理。我们希望能够获知线程的执行状态,发现哪个线程处理完就先统计它的计算结果。可以考虑使用Callable和FutureTask来完成。 先说Callable它是一个功能接口,它只有一个方法V call(),计算一个结果,失败的话抛出一个异常。和Runnable不同的是,它不能直接交给Thread来执行,所以需要一个别的类来封装它与Runnable,这个类就是FutureTask。FutureTask是一个类,继承了RunnableFuture,而RunnableFuture是一个多继承接口,它继承了Runnable和 Future,所以FutureTask是可以作为实现了Runnable的实例交给Thread执行。 从内部变量来看,含有一个下层Callable实例,一个状态表示,一个返回结果,以及对运行线程的记录 /** * 任务的运行状态,最初是NEW。运行状态只在set, setException和cancel方法中过度到最终状态。 * 在完成过程中,状态可能发生转移到COMPLETING(在设置结果时)或者INTERRUPTING(仅当中断运行来满足cancel(true)时)。 * 从这些中间状态转移到最终状态使用成本更低有序/懒惰写入,因为值是唯一的且之后不能再修改。 * * Possible state transitions: * NEW -> COMPLETING -> NORMAL * NEW -> COMPLETING -> EXCEPTIONAL * NEW -> CANCELLED * NEW -> INTERRUPTING -> INTERRUPTED */ private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; /** 下层的callable,运行后为null */ private Callable<V> callable; /** get()操作返回的结果或者抛出的异常*/ private Object outcome; // 不是volatile,由reads/writes状态来保护 /** 运行callable的线程,在run()通过CAS修改*/ private volatile Thread runner; /** 等待线程的Treiber堆栈 */ private volatile WaitNode waiters; 构造函数 构造函数总共有两种重载,第一种直接给出Callable实例 public FutureTask(Callable<V> callable) { if (callable == null) throw new NullPointerException(); this.callable = callable; this.state = NEW; // 确保callable的可见性 } 第二种,给出Runnable实例和期望的返回结果,如果Runnable实例运行成功则返回的是result public FutureTask(Runnable runnable, V result) { this.callable = Executors.callable(runnable, result);//创建一个callable this.state = NEW; // 确保callable的可见性 } run run方法是Thread运行FutureTask内任务的接口。首先,根据最上方的进入条件可以看出,只有成功竞争到修改runnerOffset成功的线程才能执行后续方法,而搜索整个类文件,可以发现只有在run结束后才会重置为null,所以同一时间只能有一个线程执行run方法成功。然后要检查state和callable的状态,因为run会将它们修改。调用callable.call方法获取返回结果,成功的话设置结果,失败的话设置返回结果为异常。无论是否执行成功,runner会被重置为null。 public void run() { if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return;//状态必须是NEW且修改执行线程成功,否则直接返回,避免被多个线程同时执行 try { Callable<V> c = callable; if (c != null && state == NEW) { V result; boolean ran; try { result = c.call();//调用callable.call方法获取返回结果 ran = true;//执行成功 } catch (Throwable ex) { result = null; ran = false;//执行失败 setException(ex);//设置返回异常并唤醒等待线程解除阻塞 } if (ran) set(result);//设置结果 } } finally { //runner直到状态设置完成不能为null来避免并发调用run() runner = null; //在将runner设置为null后需要重新读取state避免漏掉中断 int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } set方法先修改state为COMPLETING,然后将outcome设置为刚才计算出来的结果,最后设置state为NORMAL,并调用finishCompletion。这个方法移除并通知所有等待的线程解除阻塞,调用done(),并将callable设为null。done方法默认是什么也不做。 protected void set(V v) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = v; UNSAFE.putOrderedInt(this, stateOffset, NORMAL); // 最终状态 finishCompletion();//唤醒等待线程,将callable设为null } } private void finishCompletion() { // assert state > COMPLETING; for (WaitNode q; (q = waiters) != null;) { if (UNSAFE.compareAndSwapObject(this, waitersOffset, q, null)) { for (;;) { Thread t = q.thread; if (t != null) { q.thread = null; LockSupport.unpark(t);//如果线程被park阻塞,解除阻塞 } WaitNode next = q.next; if (next == null) break; q.next = null; // 取消连接帮助gc q = next; } break; } } done();//未重写时什么也不做 callable = null; // to reduce footprint减少覆盖区 } setException跟set逻辑上基本一样,除了设置返回结果是Throwable对象 protected void setException(Throwable t) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) {//修改状态 outcome = t;//结果为Throwable UNSAFE.putOrderedInt(this, stateOffset, EXCEPTIONAL); // 最终状态 finishCompletion(); } } get get方法如果FutureTask已经执行完成则返回结果,否则会等待并阻止线程调度。等待时长可以输入,单位为纳秒,不输入为不限时等待,限时等待超时仍然没有完成会抛出异常。 public V get() throws InterruptedException, ExecutionException { int s = state; if (s <= COMPLETING) s = awaitDone(false, 0L);//等待完成 return report(s);//检查时返回结果还是抛出异常 } public V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException { if (unit == null) throw new NullPointerException(); int s = state; if (s <= COMPLETING && (s = awaitDone(true, unit.toNanos(timeout))) <= COMPLETING)//限时等待完成 throw new TimeoutException(); return report(s); } awaitDone这个方法会阻塞当前线程(get方法的调用线程)的调度并增加等待结点,阻塞时长根据输入的时间长度决定。如果执行Callable任务的线程完成了运行或者被中断,则会解除栈中等待结点对应线程的阻塞。然后会根据执行结果决定是否要抛出异常还是返回执行完成的结果。 private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false;//是否完成入栈 for (;;) { if (Thread.interrupted()) {//检查线程是否已经被中断 removeWaiter(q);//移除被中断的等待结点 throw new InterruptedException(); } int s = state; if (s > COMPLETING) {//已经完成 if (q != null) q.thread = null;//移除等待 return s; } else if (s == COMPLETING) // cannot time out yet还没有超时 Thread.yield();//已经在赋值,所以只需让出时间片等待赋值完成 //下方都是还在没有完成call方法的情况 else if (q == null) q = new WaitNode(); else if (!queued) queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q);//q加入到栈的最前方 else if (timed) { nanos = deadline - System.nanoTime(); if (nanos <= 0L) {//超时了 removeWaiter(q);//移除超时的等待结点 return state; } LockSupport.parkNanos(this, nanos);//阻塞当前线程nanos纳秒 } else LockSupport.park(this);//阻塞当前线程 } } cancel cancel输入的参数表示如果当前还在运行中是否要中断执行线程,如果输入参数是false则只有线程已经执行完成或者抛出异常或者已经被中断时可以把状态修改为CANCELLED,如果是true则会中断线程并将状态改为INTERRUPTED。所以,cancel在该任务已经结束或者已被取消,或者竞争修改状态失败时都会失败。如果中断成功,会释放所有被阻塞的等待线程。 public boolean cancel(boolean mayInterruptIfRunning) { if (!(state == NEW && UNSAFE.compareAndSwapInt(this, stateOffset, NEW, mayInterruptIfRunning ? INTERRUPTING : CANCELLED))) return false;//已经完成或者被取消或者竞争取消失败返回false try { // in case call to interrupt throws exception if (mayInterruptIfRunning) { try { Thread t = runner; if (t != null) t.interrupt(); } finally { // final state UNSAFE.putOrderedInt(this, stateOffset, INTERRUPTED); } } } finally { finishCompletion(); } return true; } 状态检查 非常简单的两个方法。因为CANCELLED是state中最大的,所以只有cancel方法成功才会是这种状态。而isDone只要不是还在运行或者还没有被执行就是返回true。 public boolean isCancelled() { return state >= CANCELLED; } public boolean isDone() { return state != NEW; } 简单的使用示例 public class CallableTest implements Callable<Integer>{ private int start; public CallableTest(int start) { this.start = start; } @Override public Integer call() throws Exception { Thread.sleep(500); return start + 1; } public static void main(String args[]) throws InterruptedException, ExecutionException{ long start = System.currentTimeMillis(); FutureTask<Integer> task1 = new FutureTask<>(new CallableTest(2)); new Thread(task1).start(); FutureTask<Integer> task2 = new FutureTask<>(new CallableTest(4)); new Thread(task2).start(); System.out.println(task1.get() + task2.get());//8 long end = System.currentTimeMillis(); System.out.println(end - start);//506 } }


资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册