首页 文章 精选 留言 我的

精选列表

搜索[时间序列],共10000篇文章
优秀的个人博客,低调大师

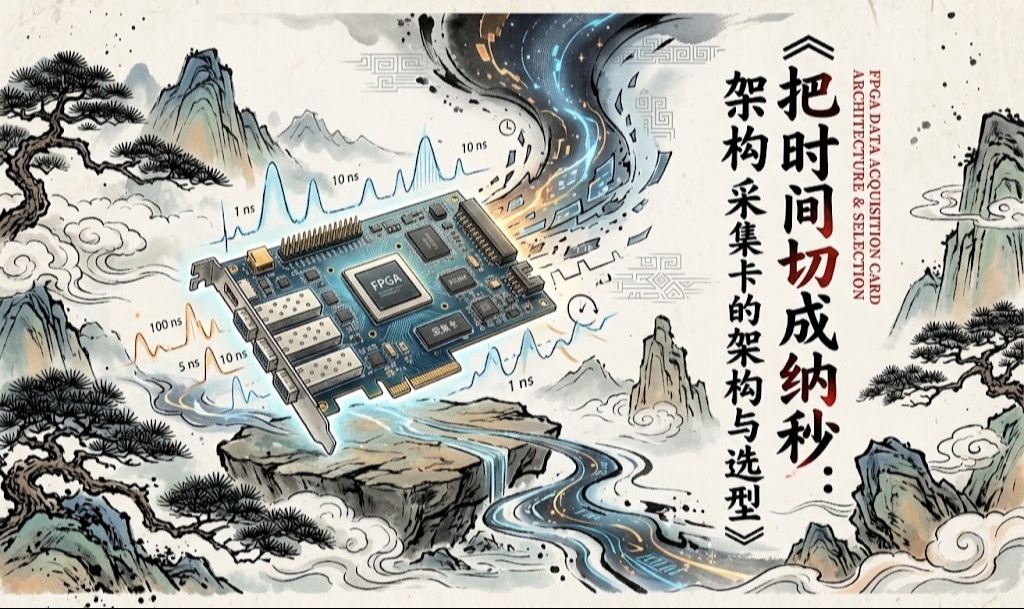
把时间切成纳秒:FPGA采集卡的架构与选型

在数据采集领域存在一个朴素的误解:觉得只要ADC分辨率够高、采样率够快,一张采集卡就足够优秀。但实际工程中你会发现,当采样率跨入每秒数吉样本(GSPS)的门槛,CPU那种串行取指、逐条执行的思路立刻就力不从心——数据在PCIe总线上排队、在驱动里拷贝、在内存里搬运,每一微秒都被浪费在"处理"之外的地方。高速采集的尽头,从来不是ADC的位数,而是它身后那片可重构的硅:FPGA。

优秀的个人博客,低调大师

Apache Kyuubi 在爱奇艺的时间:加速 Hive SQL 迁移 Spark

Hive 作为爱奇艺数仓的基础,Hive SQL 是爱奇艺大数据平台目前主要的数处理工具,各个业务积累大量的 Hive ETL 任务。Spark 相对于 MapReduce 有着更为灵活的的计算模型,这使得 Spark 相对于 Hive (on MapReduce) 有更好的性能。 经过测试对比,我们发现迁移 Hive SQL 到 Spark 将会带来很大的性能提升和资源节省。 Apache Kyuubi (Incubating) 项目提供一个分布式多租户的 Spark Thrift Server,相对于 Spark 原生的 Spark Thrift Server 有更好的架构优势和更多优秀的特性,具体对比可参考:Kyuubi v.s. Spark Thrift JDBC/ODBC Server (STS)。 HiveSQL 迁移Spark 1.1双跑对比 大数据平台中已有大量稳定运行的 Hive SQL 任务,为了在迁移的过程中提高用户迁移意愿,降低与用户的沟通成本,我们需要保证迁移后 Spark SQL 的稳定性以及数据准确性,并尽量减少用户操作。 我们在大数据平台中新增了 Hive SQL 迁移服务,提供一键批量双跑测试和一键迁移功能。在迁移前, 我们会对业务的 Hive SQL 任务进行批量双跑测试。改写业务 SQL 将输出替换成临时库表,并分别通过 Hive SQL 和 Spark SQL 执行。 执行完成后,对 Hive SQL 和 Spark SQL 的执行结果进行校验,确保迁移后数据一致。对每行数据进行concat后计算crc32并求和得到 checksum 值,通过对比两个结果表的 checksum 值和 count 数,来确定数据是否一致。 select sum(cast(CRC32(concat(*)) as decimal(19,0))) as checksum, count(*) as count from mock_db.mock_table 通过双跑测试,我们能够提前发现 Hive SQL 与 Spark SQL 的一些兼容性问题,以及配置不合理导致任 务失败的问题。及时优化平台配置,指导用户优化 SQL 并为任务提供合适的配置。 1.2 兼容性适配 Hive SQL 迁移到 Spark 的过程中,我们遇到了一些语法兼容性的问题,例如: Spark 删除不存在分区报错,而 Hive 中允许删除不存在分区 Spark 执行set mapreduce.job.reduces=-1报错 数字类型与字符串比较,结果与 Hive 不一致 ..... 为了加快迁移的进度,减少用户参与,我们需要兼容部分 Hive 语法。 在 Kyuubi 中提供 kyuubi-extension-spark 模块,维护 Spark SQL的 Extensions,用于优化Spark SQL的执行计划,社区已经提供了很多优化,详细文档:Auxiliary SQL extension for Spark SQL 。我们基于此模块,为不兼容的语法修改其执行计划,使得与 Hive 保持一致的语义。 例如,在 Hive 中由于默认的hive.exec.drop.ignorenonexistent=true配置,在删除不存在的表或分区时不会报错,但是迁移到 Spark 运行后,出现大量删除不存在分区的错误。我们在Kyuubi中实现了 DropIgnoreNonexistent 优化,改写AlterTableDropPartitionCommand/DropTableCommand等命令的执行计划,将ifExists属性设置为true,从而在删除不存在分区时不报错。 Kyuubi提供了只解释SQL执行计划的运行模式,通过 kyuubi.operation.plan.only.mode 配置,可以以 PARSE/ANALYZE/OPTIMIZE/PHYSICAL/EXECUTION的一些模式解释 SQL 的执行计划而不执行它,这样我们可以快速扫描出有语法兼容问题的一些 SQL。 1.3 小文件优化 Hive SQL 迁移 Spark 运行不可避免地会出现小文件的问题。我们使用 Kyuubi 的 Spark Extensions 结合 Spark AQE 可以有效地控制小文件问题。 Kyuubi Spark Extensions 中提供了RepartitionBeforeWrite的优化,在写入前插入repartition操作,再结合 AQE 合并小分区,从而实现控制小文件。 对于写入动态分区的情况,Kyuubi 中 Repartition 操作指定了动态分区字段,这样可以减小动态分区导致的小文件。如果动态分区数据分布不均匀,可能导致部分分区数据倾斜,所以对于动态分区写入 Kyuubi 在 Repartition 时,同时加入了一个随机数字段来避免数据倾斜。不过这样由于扩展了分区字段 的基数,也可能会导致小文件问题。 在spark-defaults.conf中添加相关的配置: spark.sql.extensions org.apache.kyuubi.sql.xyuubiSparksQ1Extension # Kyuubi # spark.sql.optimizer.insertmepartitionneforewrite.enabled true # AQE spark.sql.adaptive.enabled true spark.sql.adaptive.advisoryPartitionSizexnaytes 1024m spark. sql .adaptive. coal esceParti ti on s .mi nmarti ti onmum 1 对于 Spark3.2,Kyuubi 通过在写入前插入 Rebalance 算子,更好地解决小文件的问题。 Kyuubi 服务增强 2.1 标签化配置 对于不同用户和业务的 SQL,由于数据量和业务处理逻辑存在差异,可能需要对不同的任务进行单独的 配置优化。我们在数据开发平台上提供了用户配置参数的能力,允许用户对 SQL 任务添加配置。 对于同一用户或者业务会存在一些具有相同的特效的一些 SQL,我们提供标签化配置,定义一些标签绑定特有的配置,并在任务提交时带上相关的标签。 例如,我们定义的部分标签如下: Adhoc:用于即席查询平台任务,数据量小,要求快速响应。配置 USER 共享级别的引擎,较大 Driver 内存,以及 Spark 任务抢占策略等。 Batch:用于数据开发平台任务,定时调度运行,稳定要求较高。配置 CONNECTION 级别独立引 擎,使得任务完全资源隔离,并添加小文件、AQE 等优化配置。 User/Business/Custom:允许定义用户、业务或其他自定义标签,绑定特有的一些配置,如:队列、资源、兼容性适配相关配置等,降低用户使用门槛。 Kyuubi 中已经支持了对用户添加默认配置,例如在配置文件中添加 \_\_\_bob\_\_\_.spark.executor.memory=8g 配置,为 bob 用户的任务默认指定 8G 的 executor 内存,具体使用参考:User Default 。 同时,在Kyuubi 的kyuubi-server-plugin中,提供了SessionConfAdvisor接口,用于为 Session 注入配置。可以将标签配置保存在数据库中,并实现SessionConfAdvisor接口,根据 Session 配置 的标签从数据库中获取对应的配置。 2.2 SQL 审计 Kyuubi 服务中定义了一些事件,可用于 SQL 审计操作。 Kyuubi Server 中定义了如下事件: KyuubiServerInfoEvent:Kyuubi Server 启动、停止事件信息 KyuubiSessionEvent:Session 开启、关闭事件,以及连接相关信息 KyuubiOperationEvent:Kyuubi Operation 执行事件,包括了 SQL 执行相关信息 目前 Kyuubi 仅实现了 JSON 写入本地文件的方式采集事件,相关配置: 将事件写入 JSON 文件后,可以借助日志收集插件采集到 Kakfa 中并落地到 ElasticSearch 中,方便后续 对 SQL 执行事件进行审计分析。 我们在 Kyuubi Server 中通过实现自定义的EventHandler,处理 Kyuubi Server 的事件,直接将事件写入到 ElasticSearch 中。分析失败 SQL 执行事件的错误信息,完善 Spark SQL 运维知识库,并添加正则匹配分析规则,匹配执行事件的错误信息给出对应的解决方案,方便用户自行排障。 文中文档可参考: Kyuubi v.s. Spark Thrift JDBC/ODBC Server (STS)——https://kyuubi.apache.org/docs/latest/overview/kyuubi_vs_thriftserver.html Auxiliary SQL extension for Spark SQL—— https://kyuubi.apache.org/docs/latest/sql/rules.html# DropIgnoreNonexistent——https://github.com/apache/incubator-kyuubi/blob/master/extensions/spark/kyuubi-extension-spark-3-1/src/main/scala/org/apache/kyuubi/sql/DropIgnoreNonexistent.scala User Defaults—— https://kyuubi.apache.org/docs/latest/deployment/settings.html#user-defaults

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册