首页 文章 精选 留言 我的

精选列表

搜索[思考模型],共10000篇文章
优秀的个人博客,低调大师

这问题巧了,SpringMVC 不同参数处理机制引发的思考 | 京东云技术团队

这个问题非常有趣,不是SpringMVC 的问题,是实际开发中混合使用了两种请求方式暴露出来的。 问题场景 功能模块中,提供两个 Http 服务。一个是列表查询(application/json 请求),一个是列表导出(表单请求)。运行环境发现个问题:MVC model 新添加的属性,类似的 Http 请求,一个有值,一个没有 代码如下: /** * application/json 请求。 这种情况 param.field2 有值 ✔ * @param param RequestResponseBodyMethodProcessr 处理 HttpServletRequest 参数 */ @PostMapping(value = "query") public ResponseResult<Page<SomeData>> queryByCondition(@RequestBody SomeParam param){ // 业务逻辑... } /** * application/x-www-form-urlencoded 请求 这种情况 param.field2 没有有赋值 ❌ * @param param ServletModelAttributeMethodProcessor 处理 HttpServletRequest 参数 */ @PostMapping(value = "export") public void exportExcel(SomeParam param) { // 业务逻辑... } public class SomeParam { // 这个是原有的,有 get set 方法 private String field1; // 这个是新增的,没有get set 方法 (这是一个巧合、意外)。 问题就出在这里。 private String field2; } ❓ 根据代码分析,那应该是 SpringMVC 针对这两种参数处理的机制不同。 针对上述的参数处理,可以参考: RequestResponseBodyMethodProcessor、ServletModelAttributeMethodProcessor Insight RequestResponseBodyMethodProcessor 处理 Http Body 的数据。解析注解 RequestBody 的参数。 针对 MimeType 为 application/json 的请求,按照json 格式进行反序列化。 默认参数处理器 MappingJackson2HttpMessageConverter string 反序列化为对象,使用的是 com.fasterxml.jackson.databind.ObjectMapper。 上述工程中,对 ObjectMapper 开启 private 属性检测。新增的属性可以正常反序列化。 ObjectMapper mapper = new ObjectMapper(); // 这又是一个巧合、意外 咋还有这个用法 mapper.setVisibility(PropertyAccessor.FIELD, Visibility.ANY); Visibility 具体的用法示例参考: Jackson - Decide What Fields Get (De)Serialized | Baeldung 原理: 如果没有 setter 方法,jackson 会操作 field 来完成赋值。 /** * This concrete sub-class implements property that is set directly assigning to a Field. */ public final static class FieldProperty extends SettableBeanProperty { @Override public final void set(Object instance, Object value) throws IOException { try { _field.set(instance, value); } catch (Exception e) { _throwAsIOE(e, value); } } } Insight ServletModelAttributeMethodProcessor 自定义 Class 参数解析 通过解析 request parameters, 用来构造和初始化对应的方法入参。 主要通过 ServletRequestDataBinder.bind(request) 来完成。 /** * Apply given property values to the target object. * By default, unknown fields will be ignored. * * @see org.springframework.validation.DataBinder#applyPropertyValues */ protected void applyPropertyValues(MutablePropertyValues mpvs) { try { // Bind request parameters onto target object. // 默认使用 BeanWrapperImpl.setPropertyValue() getPropertyAccessor().setPropertyValues(mpvs, isIgnoreUnknownFields(), isIgnoreInvalidFields()); } catch (PropertyBatchUpdateException ex) { // Use bind error processor to create FieldErrors. } } public void setPropertyValues(PropertyValues pvs, boolean ignoreUnknown, boolean ignoreInvalid) throws BeansException { // 通过遍历 request parameters 来尝试对 target 进行赋值 List<PropertyValue> propertyValues = (pvs instanceof MutablePropertyValues ? ((MutablePropertyValues) pvs).getPropertyValueList() : Arrays.asList(pvs.getPropertyValues())); for (PropertyValue pv : propertyValues) { try { // etPropertyValue 使用 JDK 的 Introspector 来进行序列化操作。 // 没有setter 方法,自然没法赋值。 setPropertyValue(pv); } } } 总结 一件事情出错,不是一处问题造成的。 工程开发要规范,用最常规、最稳定的办法来实现。遇到稀奇古怪的问题就是冷门用法带来的。 对于常用的框架和工具库熟悉其底层原理,遇到问题可以很快定位。 作者:京东物流 杨攀 来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | 常见限流算法以及限流在单机分布式场景下的思考

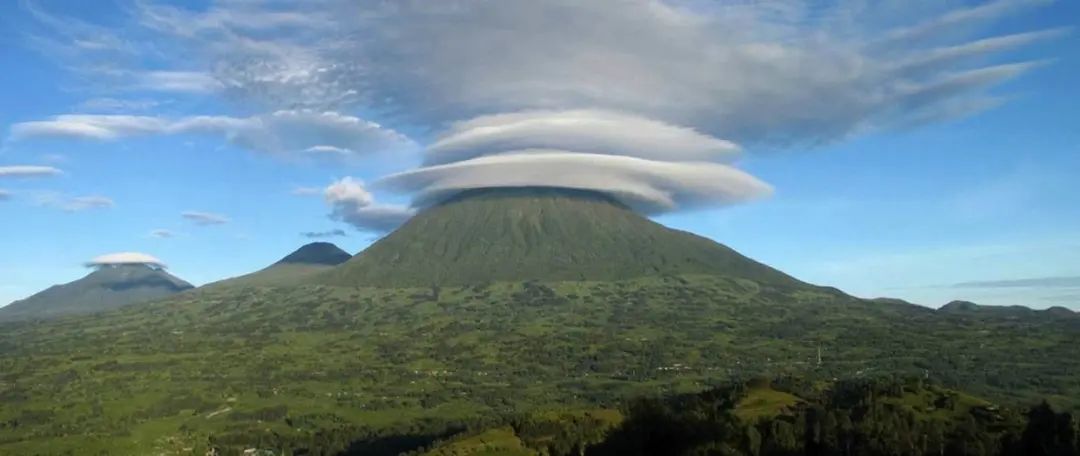
大家好,我是 yes。 今天来说说限流的相关内容,包括常见的限流算法、单机限流场景、分布式限流场景以及一些常见限流组件。 当然在介绍限流算法和具体场景之前我们先得明确什么是限流,为什么要限流?。 任何技术都要搞清它的来源,技术的产生来自痛点,明确痛点我们才能抓住关键对症下药。 限流是什么? 首先来解释下什么是限流? 在日常生活中限流很常见,例如去有些景区玩,每天售卖的门票数是有限的,例如 2000 张,即每天最多只有 2000 个人能进去游玩。 题外话:我之前看到个新闻,最不想卖门票的景区“卢旺达火山公园”,每天就卖 32 张,并且每张门票需要 1 万元! 卢旺达火山公园 再回到主题,那在我们工程上限流是什么呢?限制的是 「流」,在不同场景下「流」的定义不同,可以是每秒请求数、每秒事务处理数、网络流量等等。 而通常我们说的限流指代的是 限制到达系统的并发请求数,使得系统能够正常的处理 部分 用户的请求,来保证系统的稳定性。 限流不可避免的会造成用户的请求变慢或者被拒的情况,从而会影响用户体验。因此限流是需要在用户体验和系统稳定性之间做平衡的,即我们常说的 trade off。 对了,限流也称流控(流量控制)。 为什么要限流? 前面我们有提到限流是为了保证系统的稳定性。 日常的业务上有类似秒杀活动、双十一大促或者突发新闻等场景,用户的流量突增,后端服务的处理能力是有限的,如果不能处理好突发流量,后端服务很容易就被打垮。 亦或是爬虫等不正常流量,我们对外暴露的服务都要以最大恶意去防备我们的调用者。我们不清楚调用者会如何调用我们的服务。假设某个调用者开几十个线程一天二十四小时疯狂调用你的服务,不做啥处理咱服务也算完了。更胜的还有 DDos 攻击。 还有对于很多第三方开发平台来说,不仅仅是为了防备不正常流量,也是为了资源的公平利用,有些接口都免费给你用了,资源都不可能一直都被你占着吧,别人也得调的。 高德开放平台流量限制说明 当然加钱的话好商量。 在之前公司还做过一个系统,当时SaaS版本还没出来。因此系统需要部署到客户方。 当时老板的要求是,我们需要给他个限流降级版本,不但系统出的方案是降级后的方案,核心接口每天最多只能调用20次,还需要限制系统所在服务器的配置和数量,即限制部署的服务器的CPU核数等,还限制所有部署的服务器数量,防止客户集群部署,提高系统的性能。 当然这一切需要能动态配置,因为加钱的话好商量。客户一直都不知道。 估计老板在等客户说感觉系统有点慢吧。然后就搞个2.0版本?我让我们研发部加班加点给你搞出来。 小结一下,限流的本质是因为后端处理能力有限,需要截掉超过处理能力之外的请求,亦或是为了均衡客户端对服务端资源的公平调用,防止一些客户端饿死。 常见的限流算法 有关限流算法我给出了对应的图解和相关伪代码,有些人喜欢看图,有些人更喜欢看代码。 计数限流 最简单的限流算法就是计数限流了,例如系统能同时处理100个请求,保存一个计数器,处理了一个请求,计数器加一,一个请求处理完毕之后计数器减一。 每次请求来的时候看看计数器的值,如果超过阈值要么拒绝。 非常的简单粗暴,计数器的值要是存内存中就算单机限流算法。存中心存储里,例如 Redis 中,集群机器访问就算分布式限流算法。 优点就是:简单粗暴,单机在 Java 中可用 Atomic 等原子类、分布式就 Redis incr。 缺点就是:假设我们允许的阈值是1万,此时计数器的值为0, 当1万个请求在前1秒内一股脑儿的都涌进来,这突发的流量可是顶不住的。缓缓的增加处理和一下子涌入对于程序来说是不一样的。 而且一般的限流都是为了限制在指定时间间隔内的访问量,因此还有个算法叫固定窗口。 计数器限流伪代码实现 固定窗口限流 它相比于计数限流主要是多了个时间窗口的概念。计数器每过一个时间窗口就重置。规则如下: 请求次数小于阈值,允许访问并且计数器 +1; 请求次数大于阈值,拒绝访问; 这个时间窗口过了之后,计数器清零; 固定窗口限流伪代码实现 看起来好像很完美,实际上还是有缺陷的。 固定窗口临界问题 假设系统每秒允许 100 个请求,假设第一个时间窗口是 0-1s,在第 0.55s 处一下次涌入 100 个请求,过了 1 秒的时间窗口后计数清零,此时在 1.05 s 的时候又一下次涌入100个请求。 虽然窗口内的计数没超过阈值,但是全局来看在 0.55s-1.05s 这 0.1 秒内涌入了 200 个请求,这其实对于阈值是 100/s 的系统来说是无法接受的。 固定窗口 为了解决这个问题引入了滑动窗口限流。 滑动窗口限流 滑动窗口限流解决固定窗口临界值的问题,可以保证在任意时间窗口内都不会超过阈值。 相对于固定窗口,滑动窗口除了需要引入计数器之外还需要记录时间窗口内每个请求到达的时间点,因此对内存的占用会比较多。 规则如下,假设时间窗口为 1 秒: 记录每次请求的时间 统计每次请求的时间 至 往前推1秒这个时间窗口内请求数,并且 1 秒前的数据可以删除。 统计的请求数小于阈值就记录这个请求的时间,并允许通过,反之拒绝。 滑动窗口 滑动窗口伪代码实现 但是滑动窗口和固定窗口都无法解决短时间之内集中流量的突击。 我们所想的限流场景,例如每秒限制 100 个请求。希望请求每 10ms 来一个,这样我们的流量处理就很平滑,但是真实场景很难控制请求的频率。因此可能存在 5ms 内就打满了阈值的情况。 当然对于这种情况还是有变型处理的,例如设置多条限流规则。不仅限制每秒 100 个请求,再设置每 10ms 不超过 2 个。 再多说一句,这个滑动窗口可与TCP的滑动窗口不一样。TCP的滑动窗口是接收方告知发送方自己能接多少“货”,然后发送方控制发送的速率。 接下来再说说漏桶,它可以解决时间窗口类算法的痛点,使得流量更加的平滑。 漏桶算法 如下图所示,水滴持续滴入漏桶中,底部定速流出。如果水滴滴入的速率大于流出的速率,当存水超过桶的大小的时候就会溢出。 规则如下: 请求来了放入桶中 桶内请求量满了拒绝请求 服务定速从桶内拿请求处理 漏桶 漏桶伪代码实现 可以看到水滴对应的就是请求。它的特点就是宽进严出,无论请求多少,请求的速率有多大,都按照固定的速率流出,对应的就是服务按照固定的速率处理请求。“他强任他强,老子尼克杨”。 看到这想到啥,是不是和消息队列思想有点像,削峰填谷。一般而言漏桶也是由队列来实现的,处理不过来的请求就排队,队列满了就开始拒绝请求。看到这又想到啥,线程池不就是这样实现的嘛? 经过漏洞这么一过滤,请求就能平滑的流出,看起来很像很挺完美的?实际上它的优点也即缺点。 面对突发请求,服务的处理速度和平时是一样的,这其实不是我们想要的,面对突发流量我们希望在系统平稳的同时,提升用户体验即能更快的处理请求,而不是和正常流量一样,循规蹈矩的处理(看看,之前滑动窗口说流量不够平滑,现在太平滑了又不行,难搞啊)。 而令牌桶在应对突击流量的时候,可以更加的“激进”。 令牌桶算法 令牌桶其实和漏桶的原理类似,只不过漏桶是定速地流出,而令牌桶是定速地往桶里塞入令牌,然后请求只有拿到了令牌才能通过,之后再被服务器处理。 当然令牌桶的大小也是有限制的,假设桶里的令牌满了之后,定速生成的令牌会丢弃。 规则: 定速的往桶内放入令牌 令牌数量超过桶的限制,丢弃 请求来了先向桶内索要令牌,索要成功则通过被处理,反之拒绝 令牌桶 看到这又想到啥?Semaphore 信号量啊,信号量可控制某个资源被同时访问的个数,其实和咱们拿令牌思想一样,一个是拿信号量,一个是拿令牌。只不过信号量用完了返还,而咱们令牌用了不归还,因为令牌会定时再填充。 再来看看令牌桶的伪代码实现,可以看出和漏桶的区别就在于一个是加法,一个是减法。 令牌桶伪代码实现 可以看出令牌桶在应对突发流量的时候,桶内假如有 100 个令牌,那么这 100 个令牌可以马上被取走,而不像漏桶那样匀速的消费。所以在应对突发流量的时候令牌桶表现的更佳。 限流算法小结 上面所述的算法其实只是这些算法最粗略的实现和最本质的思想,在工程上其实还是有很多变型的。 从上面看来好像漏桶和令牌桶比时间窗口算法好多了,那时间窗口算法有啥子用,扔了扔了? 并不是的,虽然漏桶和令牌桶对比时间窗口对流量的整形效果更佳,流量更加得平滑,但是也有各自的缺点(上面已经提到了一部分)。 拿令牌桶来说,假设你没预热,那是不是上线时候桶里没令牌?没令牌请求过来不就直接拒了么?这就误杀了,明明系统没啥负载现在。 再比如说请求的访问其实是随机的,假设令牌桶每 20ms 放入一个令牌,桶内初始没令牌,这请求就刚好在第一个 20ms 内有两个请求,再过 20ms 里面没请求,其实从 40ms 来看只有 2 个请求,应该都放行的,而有一个请求就直接被拒了。这就有可能造成很多请求的误杀,但是如果看监控曲线的话,好像流量很平滑,峰值也控制的很好。 再拿漏桶来说,漏桶中请求是暂时存在桶内的。这其实不符合互联网业务低延迟的要求。 所以漏桶和令牌桶其实比较适合阻塞式限流场景,即没令牌我就等着,这就不会误杀了,而漏桶本就是等着。比较适合后台任务类的限流。而基于时间窗口的限流比较适合对时间敏感的场景,请求过不了您就快点儿告诉我,等的花儿都谢了(给阿姨倒一杯卡布奇诺。为什么我会突然打这句话??)。 单机限流和分布式限流 本质上单机限流和分布式限流的区别其实就在于 “阈值” 存放的位置。 单机限流就上面所说的算法直接在单台服务器上实现就好了,而往往我们的服务是集群部署的。因此需要多台机器协同提供限流功能。 像上述的计数器或者时间窗口的算法,可以将计数器存放至 Tair 或 Redis 等分布式 K-V 存储中。 例如滑动窗口的每个请求的时间记录可以利用 Redis 的 zset 存储,利用ZREMRANGEBYSCORE 删除时间窗口之外的数据,再用 ZCARD计数。 像令牌桶也可以将令牌数量放到 Redis 中。 不过这样的方式等于每一个请求我们都需要去Redis判断一下能不能通过,在性能上有一定的损耗,所以有个优化点就是 「批量」。例如每次取令牌不是一个一取,而是取一批,不够了再去取一批。这样可以减少对 Redis 的请求。 不过要注意一点,批量获取会导致一定范围内的限流误差。比如你取了 10 个此时不用,等下一秒再用,那同一时刻集群机器总处理量可能会超过阈值。 其实「批量」这个优化点太常见了,不论是 MySQL 的批量刷盘,还是 Kafka 消息的批量发送还是分布式 ID 的高性能发号,都包含了「批量」的思想。 当然分布式限流还有一种思想是平分,假设之前单机限流 500,现在集群部署了 5 台,那就让每台继续限流 500 呗,即在总的入口做总的限流限制,然后每台机子再自己实现限流。 限流的难点 可以看到每个限流都有个阈值,这个阈值如何定是个难点。 定大了服务器可能顶不住,定小了就“误杀”了,没有资源利用最大化,对用户体验不好。 我能想到的就是限流上线之后先预估个大概的阈值,然后不执行真正的限流操作,而是采取日志记录方式,对日志进行分析查看限流的效果,然后调整阈值,推算出集群总的处理能力,和每台机子的处理能力(方便扩缩容)。 然后将线上的流量进行重放,测试真正的限流效果,最终阈值确定,然后上线。 我之前还看过一篇耗子叔的文章,讲述了在自动化伸缩的情况下,我们要动态地调整限流的阈值很难,于是基于TCP拥塞控制的思想,根据请求响应在一个时间段的响应时间P90或者P99值来确定此时服务器的健康状况,来进行动态限流。在他的 Ease Gateway 产品中实现了这套算法,有兴趣的同学可以自行搜索。 其实真实的业务场景很复杂,需要限流的条件和资源很多,每个资源限流要求还不一样。所以我上面就是嘴强王者。 罗老师V5 限流组件 一般而言我们不需要自己实现限流算法来达到限流的目的,不管是接入层限流还是细粒度的接口限流其实都有现成的轮子使用,其实现也是用了上述我们所说的限流算法。 比如Google Guava 提供的限流工具类 RateLimiter,是基于令牌桶实现的,并且扩展了算法,支持预热功能。 阿里开源的限流框架Sentinel 中的匀速排队限流策略,就采用了漏桶算法。 Nginx 中的限流模块 limit_req_zone,采用了漏桶算法,还有 OpenResty 中的 resty.limit.req库等等。 具体的使用还是很简单的,有兴趣的同学可以自行搜索,对内部实现感兴趣的同学可以下个源码看看,学习下生产级别的限流是如何实现的。 最后 今天只是粗略讲解了限流相关的内容,具体应用到工程上还是有很多点需要考虑的,并且限流只是保证系统稳定性中的一个环节,还需要配合降级、熔断等相关内容。以后有机会再讲讲。 往期推荐: Kafka请求处理全流程分析 Kafka索引设计的亮点:https://juejin.im/post/5efdeae7f265da22d017e58d Kafka日志段读写分析:https://juejin.im/post/5ef6b94ae51d4534a1236cb0 我是yes,一个在互联网摸爬滚打且莫得感情的工具人。 本文分享自微信公众号 - yes的练级攻略(yes_java)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

一次List对象去重失败,引发对Java8中distinct()的思考

作者:puppylpg blog.csdn.net/puppylpg/article/details/78556730 list的转map的另一种猜想 Java8使用lambda表达式进行函数式编程可以对集合进行非常方便的操作。一个比较常见的操作是将list转换成map,一般使用Collectors的toMap()方法进行转换。一个比较常见的问题是当list中含有相同元素的时候,如果不指定取哪一个,则会抛出异常。因此,这个指定是必须的。 当然,使用toMap()的另一个重载方法,可以直接指定。这里,我们想讨论的是另一种方法:在进行转map的操作之前,能不能使用distinct()先把list的重复元素过滤掉,然后转map的时候就不用考虑重复元素的问题了。 使用distinct()给list去重 直接使用distinct(),失败 packageexample.mystream;importlombok.AllArgsConstructor;importlombok.Getter;importlombok.NoArgsConstructor;importlombok.ToString;importjava.util.Arrays;importjava.util.List;importjava.util.Map;importjava.util.stream.Collectors;publicclassListToMap{@AllArgsConstructor@NoArgsConstructor@ToStringprivatestaticclassVideoInfo{@GetterStringid;intwidth;intheight;}publicstaticvoidmain(String[]args){List<VideoInfo>list=Arrays.asList(newVideoInfo("123",1,2),newVideoInfo("456",4,5),newVideoInfo("123",1,2));//preferred:handleduplicateddatawhentoMap()Map<String,VideoInfo>id2VideoInfo=list.stream().collect(Collectors.toMap(VideoInfo::getId,x->x,(oldValue,newValue)->newValue));System.out.println("NoDuplicated1:");id2VideoInfo.forEach((x,y)->System.out.println("<"+x+","+y+">"));//handleduplicateddatausingdistinct(),beforetoMap()Map<String,VideoInfo>id2VideoInfo2=list.stream().distinct().collect(Collectors.toMap(VideoInfo::getId,x->x));System.out.println("NoDuplicated2:");id2VideoInfo2.forEach((x,y)->System.out.println("<"+x+","+y+">"));}} list里总共有三个元素,其中有两个我们认为是重复的。第一种转换是使用toMap()直接指定了对重复key的处理情况,因此可以正常转换成map。而第二种转换是想先对list进行去重,然后再转换成map,结果还是失败了,抛出了IllegalStateException,所以distinct()应该是失败了。 NoDuplicated1:<123,ListToMap.VideoInfo(id=123,width=1,height=2)><456,ListToMap.VideoInfo(id=456,width=4,height=5)>Exceptioninthread"main"java.lang.IllegalStateException:DuplicatekeyListToMap.VideoInfo(id=123,width=1,height=2)atjava.util.stream.Collectors.lambda$throwingMerger$0(Collectors.java:133)atjava.util.HashMap.merge(HashMap.java:1253)atjava.util.stream.Collectors.lambda$toMap$58(Collectors.java:1320)atjava.util.stream.ReduceOps$3ReducingSink.accept(ReduceOps.java:169)atjava.util.stream.DistinctOps$1$2.accept(DistinctOps.java:175)atjava.util.Spliterators$ArraySpliterator.forEachRemaining(Spliterators.java:948)atjava.util.stream.AbstractPipeline.copyInto(AbstractPipeline.java:481)atjava.util.stream.AbstractPipeline.wrapAndCopyInto(AbstractPipeline.java:471)atjava.util.stream.ReduceOps$ReduceOp.evaluateSequential(ReduceOps.java:708)atjava.util.stream.AbstractPipeline.evaluate(AbstractPipeline.java:234)atjava.util.stream.ReferencePipeline.collect(ReferencePipeline.java:499)atexample.mystream.ListToMap.main(ListToMap.java:79) 原因:distinct()依赖于equals() 查看distinct()的API,可以看到如下介绍: Returns a stream consisting of the distinct elements (according to {@link Object#equals(Object)}) of this stream. 显然,distinct()对对象进行去重时,是根据对象的equals()方法去处理的。如果我们的VideoInfo类不overrride超类Object的equals()方法,就会使用Object的。 但是Object的equals()方法只有在两个对象完全相同时才返回true。而我们想要的效果是只要VideoInfo的id/width/height均相同,就认为两个videoInfo对象是同一个。所以我们比如重写属于videoInfo的equals()方法。相关文章:一次性搞清楚equals和hashCode 重写equals()的注意事项 我们设计VideoInfo的equals()如下: @Overridepublicbooleanequals(Objectobj){if(!(objinstanceofVideoInfo)){returnfalse;}VideoInfovi=(VideoInfo)obj;returnthis.id.equals(vi.id)&&this.width==vi.width&&this.height==vi.height;} 这样一来,只要两个videoInfo对象的三个属性都相同,这两个对象就相同了。欢天喜地去运行程序,依旧失败!why? 《Effective Java》是本好书,连Java之父James Gosling都说,这是一本连他都需要的Java教程。在这本书中,作者指出,如果重写了一个类的equals()方法,那么就必须一起重写它的hashCode()方法!必须!没有商量的余地! 必须使得重写后的equals()满足如下条件: 根据equals()进行比较,相等的两个对象,hashCode()的值也必须相同; 根据equals()进行比较,不相等的两个对象,hashCode()的值可以相同,也可以不同; 因为这是Java的规定,违背这些规定将导致Java程序运行不再正常。 具体更多的细节,建议大家读读原书,必定获益匪浅。强烈推荐! 最终,我按照神书的指导设计VideoInfo的hashCode()方法如下: @OverridepublicinthashCode(){intn=31;n=n*31+this.id.hashCode();n=n*31+this.height;n=n*31+this.width;returnn;} 终于,distinct()成功过滤了list中的重复元素,此时使用两种toMap()将list转换成map都是没问题的: NoDuplicated1:<123,ListToMap.VideoInfo(id=123,width=1,height=2)><456,ListToMap.VideoInfo(id=456,width=4,height=5)>NoDuplicated2:<123,ListToMap.VideoInfo(id=123,width=1,height=2)><456,ListToMap.VideoInfo(id=456,width=4,height=5)> 引申 既然说distinct()是调用equals()进行比较的,那按照我的理解,list的3个元素至少需要比较3次吧。那是不是就调用了3次equals()呢? 在equals()中加入一句打印,这样就可以知道了。加后的equals()如下: @Overridepublicbooleanequals(Objectobj){if(!(objinstanceofVideoInfo)){returnfalse;}VideoInfovi=(VideoInfo)obj;System.out.println("<===>Invokeequals()==>"+this.toString()+"vs."+vi.toString());returnthis.id.equals(vi.id)&&this.width==vi.width&&this.height==vi.height;} 结果: NoDuplicated1:<123,ListToMap.VideoInfo(id=123,width=1,height=2)><456,ListToMap.VideoInfo(id=456,width=4,height=5)><===>Invokeequals()==>ListToMap.VideoInfo(id=123,width=1,height=2)vs.ListToMap.VideoInfo(id=123,width=1,height=2)NoDuplicated2:<123,ListToMap.VideoInfo(id=123,width=1,height=2)><456,ListToMap.VideoInfo(id=456,width=4,height=5)> 结果发现才调用了一次equals()。为什么不是3次呢?仔细想想,根据hashCode()进行比较,hashCode()相同的情况就一次,就是list的第一个元素和第三个元素(都是VideoInfo(id=123, width=1, height=2))会出现hashCode()相同的情况。 所以我们是不是可以这么猜想:只有当hashCode()返回的hashCode相同的时候,才会调用equals()进行更进一步的判断。如果连hashCode()返回的hashCode都不同,那么可以认为这两个对象一定就是不同的了! 验证猜想: 更改hashCode()如下: @OverridepublicinthashCode(){return1;} 这样一来,所有的对象的hashCode()返回值都是相同的。当然,这样搞是符合Java规范的,因为Java只规定equals()相同的对象的hashCode必须相同,但是不同的对象的hashCode未必会不同。 结果: NoDuplicated1:<123,ListToMap.VideoInfo(id=123,width=1,height=2)><456,ListToMap.VideoInfo(id=456,width=4,height=5)><===>Invokeequals()==>ListToMap.VideoInfo(id=456,width=4,height=5)vs.ListToMap.VideoInfo(id=123,width=1,height=2)<===>Invokeequals()==>ListToMap.VideoInfo(id=456,width=4,height=5)vs.ListToMap.VideoInfo(id=123,width=1,height=2)<===>Invokeequals()==>ListToMap.VideoInfo(id=123,width=1,height=2)vs.ListToMap.VideoInfo(id=123,width=1,height=2)NoDuplicated2:<123,ListToMap.VideoInfo(id=123,width=1,height=2)><456,ListToMap.VideoInfo(id=456,width=4,height=5)> 果然,equals()调用了三次!看来的确只有hashCode相同的时候才会调用equal()进一步判断两个对象究竟是否相同;如果hashCode不相同,两个对象显然不相同。猜想是正确的。 搜索Java知音公众号,回复“后端面试”,送你一份Java面试题宝典.pdf 结论 list转map推荐使用toMap(),并且无论是否会出现重复的问题,都要指定重复后的取舍规则,不费功夫但受益无穷; 对一个自定义的class使用distinct(),切记覆写equals()方法; 覆写equals(),一定要覆写hashCode(); 虽然设计出一个hashCode()可以简单地让其return 1,这样并不会违反Java规定,但是这样做会导致很多恶果。比如将这样的对象存入hashMap的时候,所有的对象的hashCode都相同,最终所有对象都存储在hashMap的同一个桶中,直接将hashMap恶化成了一个链表。从而O(1)的复杂度被整成了O(n)的,性能自然大大下降。 好书是程序猿进步的阶梯。——高尔基。比如《Effecctive Java》。 最终参考程序: packageexample.mystream;importlombok.AllArgsConstructor;importlombok.Getter;importlombok.NoArgsConstructor;importlombok.ToString;importjava.util.Arrays;importjava.util.List;importjava.util.Map;importjava.util.stream.Collectors;publicclassListToMap{@AllArgsConstructor@NoArgsConstructor@ToStringprivatestaticclassVideoInfo{@GetterStringid;intwidth;intheight;publicstaticvoidmain(String[]args){System.out.println(newVideoInfo("123",1,2).equals(newVideoInfo("123",1,2)));}@Overridepublicbooleanequals(Objectobj){if(!(objinstanceofVideoInfo)){returnfalse;}VideoInfovi=(VideoInfo)obj;returnthis.id.equals(vi.id)&&this.width==vi.width&&this.height==vi.height;}/***Ifequals()isoverride,hashCode()mustbeoverride,too.*1.ifaequalsb,theymusthavethesamehashCode;*2.ifadoesn'tequalsb,theymayhavethesamehashCode;*3.hashCodewritteninthiswaycanbeaffectedbysequenceofthefields;*3.2^5-1=31.So31willbefasterwhendothemultiplication,*becauseitcanbereplacedbybit-shifting:31*i=(i<<5)-i.*@return*/@OverridepublicinthashCode(){intn=31;n=n*31+this.id.hashCode();n=n*31+this.height;n=n*31+this.width;returnn;}}publicstaticvoidmain(String[]args){List<VideoInfo>list=Arrays.asList(newVideoInfo("123",1,2),newVideoInfo("456",4,5),newVideoInfo("123",1,2));//preferred:handleduplicateddatawhentoMap()Map<String,VideoInfo>id2VideoInfo=list.stream().collect(Collectors.toMap(VideoInfo::getId,x->x,(oldValue,newValue)->newValue));System.out.println("NoDuplicated1:");id2VideoInfo.forEach((x,y)->System.out.println("<"+x+","+y+">"));//handleduplicateddatausingdistinct(),beforetoMap()//Notethatdistinct()reliesonequals()intheobject//ifyouoverrideequals(),hashCode()mustbeoverridetogetherMap<String,VideoInfo>id2VideoInfo2=list.stream().distinct().collect(Collectors.toMap(VideoInfo::getId,x->x));System.out.println("NoDuplicated2:");id2VideoInfo2.forEach((x,y)->System.out.println("<"+x+","+y+">"));}} 再拓展 假设类是别人的,不能修改 以上,VideoInfo使我们自己写的类,我们可以往里添加equals()和hashCode()方法。如果VideoInfo是我们引用的依赖中的一个类,我们无权对其进行修改,那么是不是就没办法使用distinct()按照某些元素是否相同,对对象进行自定义的过滤了呢? 使用wrapper 在stackoverflow的一个回答上,我们可以找到一个可行的方法:使用wrapper。 假设在一个依赖中(我们无权修改该类),VideoInfo定义如下: @AllArgsConstructor@NoArgsConstructor@ToStringpublicclassVideoInfo{@GetterStringid;intwidth;intheight;} 使用刚刚的wrapper思路,写程序如下(当然,为了程序的可运行性,还是把VideoInfo放进来了,假设它就是不能修改的,不能为其添加任何方法): packageexample.mystream;importlombok.AllArgsConstructor;importlombok.Getter;importlombok.NoArgsConstructor;importlombok.ToString;importjava.util.Arrays;importjava.util.List;importjava.util.Map;importjava.util.stream.Collectors;publicclassDistinctByWrapper{privatestaticclassVideoInfoWrapper{privatefinalVideoInfovideoInfo;publicVideoInfoWrapper(VideoInfovideoInfo){this.videoInfo=videoInfo;}publicVideoInfounwrap(){returnvideoInfo;}@Overridepublicbooleanequals(Objectobj){if(!(objinstanceofVideoInfo)){returnfalse;}VideoInfovi=(VideoInfo)obj;returnvideoInfo.id.equals(vi.id)&&videoInfo.width==vi.width&&videoInfo.height==vi.height;}@OverridepublicinthashCode(){intn=31;n=n*31+videoInfo.id.hashCode();n=n*31+videoInfo.height;n=n*31+videoInfo.width;returnn;}}publicstaticvoidmain(String[]args){List<VideoInfo>list=Arrays.asList(newVideoInfo("123",1,2),newVideoInfo("456",4,5),newVideoInfo("123",1,2));//VideoInfo--map()-->VideoInfoWrapper---->distinct():VideoInfoWrapper--map()-->VideoInfoMap<String,VideoInfo>id2VideoInfo=list.stream().map(VideoInfoWrapper::new).distinct().map(VideoInfoWrapper::unwrap).collect(Collectors.toMap(VideoInfo::getId,x->x,(oldValue,newValue)->newValue));id2VideoInfo.forEach((x,y)->System.out.println("<"+x+","+y+">"));}}/***AssumethatVideoInfoisaclassthatwecan'tmodify*/@AllArgsConstructor@NoArgsConstructor@ToStringclassVideoInfo{@GetterStringid;intwidth;intheight;} 整个wrapper的思路无非就是构造另一个类VideoInfoWrapper,把hashCode()和equals()添加到wrapper中,这样便可以按照自定义规则对wrapper对象进行自定义的过滤。 搜索Java知音公众号,回复“后端面试”,送你一份Java面试题宝典.pdf 我们没法自定义过滤VideoInfo,但是我们可以自定义过滤VideoInfoWrapper啊! 之后要做的,就是将VideoInfo全部转化为VideoInfoWrapper,然后过滤掉某些VideoInfoWrapper,再将剩下的VideoInfoWrapper转回VideoInfo,以此达到过滤VideoInfo的目的。很巧妙! 使用“filter() + 自定义函数”取代distinct() 另一种更精妙的实现方式是自定义一个函数: privatestatic<T>Predicate<T>distinctByKey(Function<?superT,Object>keyExtractor){Map<Object,Boolean>map=newConcurrentHashMap<>();returnt->map.putIfAbsent(keyExtractor.apply(t),Boolean.TRUE)==null;} (输入元素的类型是T及其父类,keyExtracctor是映射函数,返回Object,整个传入的函数的功能应该是提取key的。distinctByKey函数返回的是Predicate函数,类型为T。) 这个函数传入一个函数(lambda),对传入的对象提取key,然后尝试将key放入concurrentHashMap,如果能放进去,说明此key之前没出现过,函数返回false;如果不能放进去,说明这个key和之前的某个key重复了,函数返回true。 这个函数最终作为filter()函数的入参。根据Java API可知filter(func)过滤的规则为:如果func为true,则过滤,否则不过滤。因此,通过“filter() + 自定义的函数”,凡是重复的key都返回true,并被filter()过滤掉,最终留下的都是不重复的。 最终实现的程序如下 packageexample.mystream;importlombok.AllArgsConstructor;importlombok.Getter;importlombok.NoArgsConstructor;importlombok.ToString;importjava.util.Arrays;importjava.util.List;importjava.util.Map;importjava.util.concurrent.ConcurrentHashMap;importjava.util.function.Function;importjava.util.function.Predicate;importjava.util.stream.Collectors;publicclassDistinctByFilterAndLambda{publicstaticvoidmain(String[]args){List<VideoInfo>list=Arrays.asList(newVideoInfo("123",1,2),newVideoInfo("456",4,5),newVideoInfo("123",1,2));//GetdistinctonlyMap<String,VideoInfo>id2VideoInfo=list.stream().filter(distinctByKey(vi->vi.getId())).collect(Collectors.toMap(VideoInfo::getId,x->x,(oldValue,newValue)->newValue));id2VideoInfo.forEach((x,y)->System.out.println("<"+x+","+y+">"));}/***IfakeycouldnotbeputintoConcurrentHashMap,thatmeansthekeyisduplicated*@paramkeyExtractoramappingfunctiontoproducekeys*@param<T>thetypeoftheinputelements*@returntrueifkeyisduplicated;elsereturnfalse*/privatestatic<T>Predicate<T>distinctByKey(Function<?superT,Object>keyExtractor){Map<Object,Boolean>map=newConcurrentHashMap<>();returnt->map.putIfAbsent(keyExtractor.apply(t),Boolean.TRUE)==null;}}/***AssumethatVideoInfoisaclassthatwecan'tmodify*/@AllArgsConstructor@NoArgsConstructor@ToStringclassVideoInfo{@GetterStringid;intwidth;intheight;} END 推荐好文 强大,10k+点赞的 SpringBoot 后台管理系统竟然出了详细教程! 为什么MySQL不推荐使用uuid或者雪花id作为主键? 为什么建议大家使用 Linux 开发?爽(外加七个感叹号) IntelliJ IDEA 15款 神级超级牛逼插件推荐(自用,真的超级牛逼) 炫酷,SpringBoot+Echarts实现用户访问地图可视化(附源码) 记一次由Redis分布式锁造成的重大事故,避免以后踩坑! 十分钟学会使用 Elasticsearch 优雅搭建自己的搜索系统(附源码) 本文分享自微信公众号 - Java知音(Java_friends)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

今日头条在消息服务平台和容灾体系建设方面的实践与思考

本篇文章整理自今日头条的沈辉在 RocketMQ 开发者沙龙中的演讲,主要和大家分享一下,RocketMQ 在微服务架构下的实践和容灾体系建设。沈辉是今日头条的架构师,主要负责 RocketMQ 在头条的落地以及架构设计,参与消息系统的时间大概一年左右。 以下是本次分享的议题: 头条的业务背景 为什么选择 RocketMQ RocketMQ 在头条的落地实践 头条的容灾系统建设 业务背景 今日头条的服务大量使用微服务,容器数目巨大,业务线繁多, Topic 的数量也非常多。另外,使用的语言比较繁杂,包括 Python,Go, C++, Java, JS 等,对于基础组件的接入,维护 SDK 的成本很高。 引入 RocketMQ 之前采用的消息队列是 NSQ 和 kafka , NSQ 是纯内存的消息队列,缺少消息的持久性,不落盘直接写到 Go

优秀的个人博客,低调大师

.Net架构篇:思考如何设计一款实用的分布式监控系统?

前言 无论从最早期的unix操作系统,还是曾经大行其道的单体式应用,还是现在日益流行的微服务架构,始终都离不开监控的身影。如windows的任务管理器,linux的top命令,都可以看作是监控的面板。 再联系起现实生活,无处不在的路网摄像头,为交通机关监控交通人流提供了方便。 系统规模越大,越离不开监控。缺少了监控,就像盲人摸象,窥不到全貌。 理想中的分布式监控 进入互联网时代,系统调用规模日益庞大,对监控的需求更是迫切。比如一个页面打开很慢,怎么分析哪里慢?是网站接受请求慢还是连接数据库慢,或者消息队列挂了,或者redis请求慢?我们需要监控系统能提供这些信息供我们追踪分析。 所以理想中的分布式监控应该记录从请求发起那一刻,所调用的公开方法,接触过的数据库,缓存,队列等步骤,以及每一步所消耗的时间。这些都需要大量的日志去记录。 第二点,理想中的分布式监控必须是对代码无侵入,应用程序员无需对每个方法去调用监控代码。这样完全解藕的监控系统,才更容易使用,加入每个方法,都要调一下监控接口,那不要累死人,代码也及其不友好。 第三点,理想中分布式监控应该对性能不造成损耗或者极小的损耗。如果流量一大,监控系统CPU飙生的话,那这个监控无疑是失败的。 第四点,许多方法有层级,方法内调用其他方法,应该能通过报表聚合查看,进入每个方法的时间以及调用耗时,调用方法的层级树。 第五点,分布式时代,一个调用请求会横跨很多站点,理想的分布式监控应该提供调用链上所有站点的聚合报表查看,要极力避免死循环,两个站点长官相互调用的情况下,应该用双箭头表明调用关系。 第六点,能提供接入监控的服务器cpu,内存,硬盘空间等指标,并根据警戒线发送通知。这个优先级可以降低,可以借助云服务器自身提供的监控,阿里云和Ucloud都有自己的服务器监控面板。 如何设计一款实用的监控 统一的调用链id 根据软件的调用链特性,从一个请求开始到最终的结束,应该具有一个统一的调用链id。 时间戳 调用各种方法的时间也应该是顺序的,需要一个精确的时间戳,来描述调用方法的进入与离开的时间。 异步传输 为了不影响性能,应该以异步传输,定时落库的方式。 延时聚合 如果能做到实时聚合更好,如果实现困难可以采用延时聚合报表,延时的时间应该小于一分钟。这个时间使用人群应该能接受,当然如果能缩短到几秒钟,那使用人群会更加高兴。聚合报表应首先提供最近时间内的耗时排序,可以查看调用的方法树,可以查看调用链的所有站点,其他需求可以后期开发,解决核心需求。 最后的难点 如果不追求无侵入,提供一个空接口。所有需要记录日志的实现接口,就已经达到了目标的一半。 为了完成对应用无侵入的目标,我们首先需要一款真正的aop,即静态编织Aop,这个只听说过postsharp,为什么只有它能实现?或者是类似fiddler之类的抓包工具。 本篇暂时写到这里结束。 可参考的如google dapper论文,zipkin,听云。 作者:从此启程/范存威 出处:http://www.cnblogs.com/fancunwei/ 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文链接。如文章对您有用,烦请点个推荐再走,感谢! 本博客新开通打赏,鼠标移到右侧打赏浮动处,即可赏博主点零花钱,感谢您的支持!

优秀的个人博客,低调大师

【Python初级】由生成杨辉三角代码所思考的一些问题

杨辉三角定义如下: 1 / \ 1 1 / \ / \ 1 2 1 / \ / \ / \ 1 3 3 1 / \ / \ / \ / \ 1 4 6 4 1 / \ / \ / \ / \ / \ 1 5 10 10 5 1 把每一行看做一个list,试写一个generator,不断输出下一行的list。 该题目考查生成器的应用。一般的思路是,首先在每一行输出一个1,随后通过循环,位置i(从2开始)的数是上一行i与i-1位置的数之和,当i与上一行数字个数相同时,循环终止,最后再添加进一个1,形成新的一行。 基于这个基本思路,将python的生成器运用到里面,有两种常见的写法: 一种写法如下: 1 def triangles():#杨辉三角的一种生成方法 2 l = [1] 3 while True : 4 yield l 5 for i in range ( 1,len (l) ) : 6 l [i] = h [i] + h [i-1] 7 l.append (1) 8 h = l[:] 另外一种写法如下,运用了list的生成式: 1 def triangles(): 2 l = [1] 3 while True : 4 yield l 5 l = [1] + [ l[i] + l[i+1] for i in range ( len (l) - 1)] + [1] 可以看到,以上两种写法都是相当简洁的。一开始这两个代码看不太懂,比如说为啥第一种写法里一开始h里面没有数,却也能够正常执行?主要是对于生成器的yield机制不明白,以及对于range的用法不是特别清楚。以下就这两点分别解释。 首先,当函数中出现了yield之后,该函数就不再被视为函数,而视为一个生成器。此时,整个函数被使用的语句流程会发生改变,一般的函数都是调用的时候从函数入口进,发现return或函数执行完毕后返回,而生成器函数则是每次调用函数执行,执行到yield返回,下次再调用函数的时候从上次yield返回处继续执行。 其次,range的用法中是,如果是【range(x,x) 其中x是常量】的形式,range依然返回空。故在上述代码的for循环中,由于在第一次试图循环的时候,后面的range要么是range(1,1)要么是range(0),故都会成功避开i或者h没有实际值的循环,执行接下来的部分。当第二次试图循环开始时,i和h内的内容都已经满足条件了,所以就能正常运行了。 还有一种我看到的最简单的写法: 1 def triangles(): 2 L = [1] 3 while True: 4 yield L 5 L= [(L + [0])[i] + ([0] + L)[i] for i in range(len(L)+1)] 这一种写法直接去掉了第二种写法里每次L两边额外插入的[1],使其变为了一个完整的一个list生成式,可以说是相当精妙。 那么,这种写法为什么也可以呢?我们再来分析一下杨辉三角的性质,这样,为了直观理解,我们先利用上面的代码,举一个运行中的过程例子。 比如,L此时为[1,1](杨辉三角第二行),现在需要求第三行。根据第五行的生成式,将按照以下步骤进行计算: 1.L尾部加0,得到[1,1,0],我们称之为tempL1 2.L首部加0,得到[0,1,1],我们称之为tempL2 3.现在,根据之后的for循环,L最终要被赋值成由tempL1与tempL2对应的每个相同位置数字之和所组成的列表,经过计算,这个新的L应该为[1,2,1]。居然确实是杨辉三角的第三行! 相信聪明的观众已经明白了,这个最简单的写法是利用了杨辉三角本身的对称性质,让同一行错开一位竖式相加,得到的就是下一行的结果。同时,利用python里面本身就极为方便的列表扩展写法和列表生成式,才有了第三种如此简洁的写法~

优秀的个人博客,低调大师

股权众筹鼻祖 Naval Ravikant 发表 36 条对于区块链乃至整个世界的思考

当走过史前纪事、中本魔咒、以太野望、沧海横流,发展了几近半个世纪的区块链已然成为了一种社会思潮,它预示着人类社会转型、换代的新时代的到来,以分布式网络架构为技术基础的区块链让互联网时代的组织及经济发展规律悄然发生改变。 区块链用技术设计取代权威控制和情感信任,以此建立一种网络结构,所有人都可以参与成为无数节点之一,进行认证、确权、交易、追溯和调整等一系列动作,它公开透明,成本低、速度快、分布广,没有权威可以篡改伪造和取缔记录。我们可以充分地想象今天的商业、艺术、司法、科技、政治乃至社会等各个领域中,这样一个建立在运算能力和技术架构上的网络文明社会基础设施将是多么不同。 尽管它毫无情怀和冷冰冰地运作,但从根本上,摈弃了狂热理想的驱使、自命权威的霸道、垄断财团的曲扭、民粹阴谋的盲动,商业诈骗和情感敲诈也会随之水落石出。 无论我们是否喜欢,区

优秀的个人博客,低调大师

阿里巴巴中台架构的业务价值思考——走进《企业IT架构转型之道》系列1

架构无法决定市场的成功还是失败,但是作为土壤可以不断孵化新的物种。阿里巴巴从2008年开始的架构优化过程其实并没有解决该做什么的问题,但是解决了创新效率的问题。 ——阿里巴巴集团中间件技术部研究院蒋江伟(小邪) 源自芬兰游戏公司 Supercell 的启发 2015年年中,马云带领阿里巴巴集团高管拜访了芬兰移动游戏公司Supercell——《部落战争》《海岛奇兵》《卡通农场》等多款知名游戏的创作者。Supercell的模式给了集团高管们很大的感想:在Supercell内部以小团队(cell)形式作战,小团队最多不超过7人,小团队对整个项目周期负责,从项目策划到研发再到向市场推广,如果产品没有受到市场欢迎则迅速放弃产品,从中吸取经验后再进行新的尝试。这样的快速试错、不断创新的模式使得Supercell成为了一家年税前15亿美元的游戏公

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册