首页 文章 精选 留言 我的

精选列表

搜索[全栈智算],共10000篇文章
优秀的个人博客,低调大师

VDA标准全解

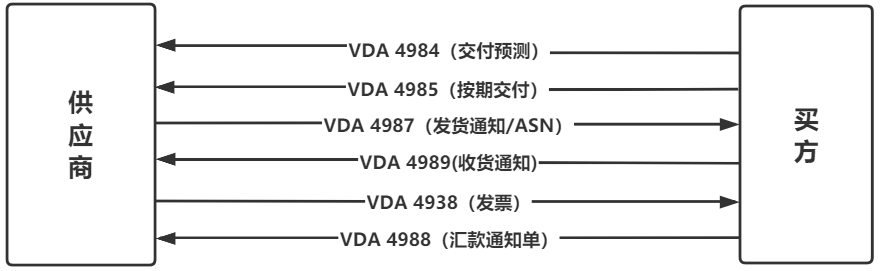
什么是VDA标准? 德国汽车工业联合会(VDA) 是德国汽车工业的倡导团体,协会成员包括汽车制造商和汽车零部件供应商。同时,它也是欧洲汽车制造商协会(ACEA)的成员。VDA制定标准和最佳实践,以满足德国汽车行业公司的需求,如宝马、大众和梅赛德斯-奔驰母公司戴姆勒等汽车制造商,也包括外国供应商和欧宝等外资汽车制造商。 常见的VDA标准报文有哪些? VDA 4984 :交付预测 VDA 4985 :按期交付 VDA 4987 :发货通知/ASN VDA 4989 :收货通知 VDA 4938 :发票 VDA 4988 :汇款通知单 更多VDA报文目录:VDA报文标准 以下是几种常用报文的应用: 除了以上报文的应用之外,不得不提到的是VDA Label,VDA Label是适用于汽车领域的规范标签,听到Label这个名字大家或许会觉得有些陌生,实际上这里的Label就是在产品运输前需要贴在装有产品的纸箱或托盘上的标签,往往需要包含产品必要的信息,如接收方地址信息、产品重量、供应商编号、供应商产品编号等。Label制作对于企业而言是一项令人头疼的事情,需要填充很多数据,对于数据格式也有着很高的要求。如果可以通过知行之桥EDI系统自动生成Label,将为企业节省大量的人力。 应该如何生成VDA Lael呢?知行之桥的PDF Port即可实现这个功能,通过PDF Port生成符合VDA标准PDF标签,然后让打印厂商按标签要求打印即可。在生成Label的过程中,需要设计PDF模板,这是因为不同的交易伙伴需要的Label格式是不一样的,必须进行个性化的设计才能保证能够完全符合交易伙伴的要求。制作Label的详细流程可以参考文章:VDA Label VDA标准都用于哪些行业? VDA报文是在汽车领域使用的EDI报文,可满足汽车行业内各个企业的特定需求。VDA标准与汽车行业的联系十分密切,它从头到尾的定义了汽车供应链中的各个细节。 VDA标准适用供应链用户所要求的不同功能,例如在订单中(预测),以检查供应商运送的货物是否与分销商下达的采购订单相匹配(DESADV或ASN);有关交货顺序和及时要求(DELJIT),电子发票(INVOIC)等的准确信息。这些数据的传输可确保制造商(OEM)、供应商(TIER 1、TIER 2、TIER 3……)和顾客之间信息准确高效的流动。 VDA标准应用实例 上汽大众汽车有限公司(简称“上汽大众”)是一家中德合资企业,由上汽集团和大众汽车集团合资经营,是国内历史最悠久的汽车合资企业之一。上汽大众与其供应商之间通过EDI传输业务文件。 大众EDI项目使用的是符合VDA标准的报文——VDA 4984和VDA 4987。VDA 4984 是VDA标准下表示交货计划/提货计划的报文,VDA 4987表示发货通知/收货反馈的报文。业务流程如下图所示: 整体业务逻辑是大众向其供应商发送VDA 4984(提货计划),供应商收到报文后按照要求备货,发货后向大众发送VDA 4987(发货通知),最后再由大众向供应商发送VDA 4987(收货反馈)表示已经顺利收到货物。 与交易伙伴传输VDA文件需要做哪些准备呢? 与交易伙伴传输VDA文件首先需要和交易伙伴进行沟通,明确实际需求。明确使用VDA报文标准之后,还需要确定传输协议,如上图所示,上汽大众的EDI项目中使用了OFTP2.0,此外还有AS2、SFTP等协议可选。比如特斯拉就选择使用AS2作为其传输协议。 此外还需要和您的交易伙伴确认传输的具体文件类型,不同的业务场景需要的报文类型各有不同,除了上文提到的常见报文类型之外,如果您的交易伙伴向您提供了新的报文类型,联系我们,轻松搞定任意报文类型!EDI系统可以集成您的业务系统,从而保证您的EDI项目可以实现高度自动化传输。 有了明确的需求之后,您可以寻找合适的EDI供应商实施EDI项目,知行之桥支持多种集成方式,您可以使用中间数据库表、API、自定义文件格式等多种方案与供应商业务系统集成,实现数据传输,节约企业成本,显著提高效率。 如何读懂VDA报文? VDA标准对于每个字段的长度,以及在报文中所占的位数有着严格的规定,每一行必须是128个字符。每个字段的位数如果存在缺失或增多的情况,将会导致整个报文长度的改变,报文内容也会随之错位。所以,在生成VDA报文的时候,需要严格的遵守VDA报文规范中的要求,才可以保证在每一个特定的位置上存放的是正确的数据信息。 VDA报文规范中的对于字段位数和长度的要求主要有以下几点:第一如果类型为N,例如N8,业务数据的最大长度不能超过8位,如果小于8位,则用数字0进行右补齐,如12300000;第二如果类型为A,例如A8,业务数据的最大长度不能超过8位,如果小于8位,则用空格进行左补齐,如____123(这里记得凑够8位);第三如果规范中的描述是Empty,则根据字段类型用数字0或空格进行相应的补齐。 详细报文解读可以参考文章:如何读懂艾可迅ACOM EDI项目中的4984报文? 注:文案部分图片及内容来源于网络,版权归原创作者所有,如有侵犯到您的权益,请您联系我们进行删除,给您带来困扰,我们深感抱歉。

优秀的个人博客,低调大师

AOP编程全解析

AOP是一种编程思想,一套规范。 软件开发经历了面向过程编程时代,以C语言为代表,之后是面向对象编程时代,以Java语言为代表。 在21世纪大牛们又提出了一种新的编程思想面向方面编程,即AOP理念,全称Aspect-Oriented Programming。 AOP是第三代编程思想,到哪免不了都要问下。 发展历史 1997年在面向对象编程大会上Gregor Kiczales等人首次提出了AOP的概念,之后各大公司等分别加入研究。2001年Palo Alto研究中心发布了首个支持AOP的语言AspectJ,同时也是一个规范。 目标定位 在对真实世界抽象的面向对象编程过程中,始终伴随着某写操作的代码无法实现模块化封装,会散落在各个对象中存在,特别是非功能性代码。对于一般的功能开发采取面向对象方式进行抽象是能够很好应付的,但是面向方面(切面)给了一种新的思维方式来考虑编程,能更好的进行全局结构化思考。 所以AOP主要解决两个问题: 代码分散问题,特别是那些非功能性代码。 作为面向对象编程思维的一种补充和完善。 核心知识点 连接点 连接点:join point,程序的一个执行点,如类中的一个方法,方法里面一个代码块。 切入点 切入点:point cut,是一个捕获连接点的代码结构,就是定义一个代码逻辑用来捕获某个连接点的代码。 方面 方面;aspect,是具体被执行的切面逻辑代码,类似于一个类。 通知 通知:advice,是point cut执行的代码,定义在连接点什么时机来执行aspect。 主要运用场景 场景分为2类: 一类是非功能性需求,如日志、异常、安全、事务都可以使用AOP思想编程。 另一类是功能性需求,在原来对象抽象的思维中添加AOP思维,这里是一种结构化思维,在定义类时考虑多个类的切面共性。 主流AOP语言实现 对AOP实现除了AspectJ外,已知的还有JBoss AOP、Spring AOP等。 这里只介绍AspectJ和SpringAOP,重点是他们不同点。 AspcetJ AspectJ采用静态织入方式进行切面织入原代码,提供独立的编译器把切面和原代码的java文件编织成一个新的class文件。提供了详细的编译日志和调试工具,编译时间长但是运行效率高。 连接点的支持范围: 方法和构造器调用 方法和构造器执行 属性访问 异常处理 类初始化,是static代码块 语法结构 控制流 对象及参数类型 条件测试 关联连接点通知方式: before,连接点执行前运行 after,连接点执行后运行 around,连接点的整个外侧,整个包住,能够绝的连接点执行和修改上下文环境 Spring AOP Spring AOP没有完全实现AspectJ语言,它更多的是对Spring framwork进行Aop能力的扩展实现,补全Spring framework的不足并让Aop与Spring framwork融合。 连接点只支持方法拦截调用。 连接点通知方式在aspect的before、after、around的基础上增加throw对异常的触发的拦截。 Spring AOP与Spring IoC体系融合,对于aspect类统一交由Spring beans管理,并且提供ProxyFactoryBean的AOP代理工厂类,还有自动代理的BeanNameAutoProxyCreator和DefaultAdvisorAutoProxyCreator的强大工具。 Spring AOP是动态织入,在运行时完成AOP的aspect代码织入原代码逻辑中。其底层默认采用JDK的动态代理实现AOP代理,当对象没有实现接口时,CGLIB会默认使用。 优缺点 优点:解决代码散乱问题、代码逻辑解偶、易于维护、提供扩展性和可重用性。 缺点:切面越多系统越复杂难懂、工程师学习成本增加(业务不再是线型,变成了跳跃式) AOP编程要慎重使用,作为面向对象编程的一种补充。 作者:Owen Jia 关注他的博客:https://blog.shareworld.vip

优秀的个人博客,低调大师

Kubernetes Node全解

今晚20:30,Kubernetes Master Class在线培训第四期《企业如何构建CI/CD流水线》即将开播,点击链接:http://live.vhall.com/729465809 即可免费预约注册! 介 绍 Kubernetes在GitHub上拥有超过48,000颗星,超过75,000个commit,拥有以Google为代表的科技巨头公司为主要贡献者。可以说,Kubernetes已迅速掌管了容器生态系统,成为容器编排平台的真正领导者。 Kubernetes提供了诸如部署的滚动和回滚、容器健康检查、自动容器恢复、基于指标的容器自动扩展、服务负载均衡、服务发现(适用于微服务架构)等强大功能。在本文中,我们将讨论Kubernetes重要的基本概念、master节点架构,并重点关注节点组件。 理解Kubernetes及其抽象 Kubernetes是一个开源的编排引擎,用于自动部署、扩展、管理和提供托管容器化应用程序的基础架构。在基础架构级别,Kubernetes集群由一组物理或虚拟机组成,每个机器都以特定角色运行。 Master机器就像是所有业务的大脑,负责编排所有运行在节点机器上的容器。每个节点都配有一个容器运行时。节点接收来自master的指令,然后执行操作来创建pod、删除pod或调整网络规则。 Master组件负责管理Kubernetes集群。它们管理pod的生命周期,pod是Kubernetes集群内部署的基本单元。Master Server运行以下组件: kube-apiserver - 主要组件,为其他master组件公开API。 etcd - 分布式密钥/值存储库,Kubernetes使用它来持久化存储所有集群信息。 kube-scheduler – 依照pod规范中的信息,来决定运行pod的节点。 kube-controller-manager - 负责节点管理(检测节点是否出现故障)、pod复制和端点创建。 cloud-controller-manager - 守护进程,充当API和不同云提供商工具(存储卷、负载均衡器等)之间的抽象层。 节点组件是Kubernetes中的worker机器,受到master的管理。节点可以是虚拟机(VM)或物理机器——Kubernetes在这两种类型的系统上都能良好运行。每个节点都包含运行pod的必要组件: kubelet – 为位于那个节点上的pod监视API服务器,确保它们正常运行 cAdvisor - 收集在特定节点上运行着的pod的相关指标 kube-proxy - 监视API服务器,实时获取pod或服务的变化,以使网络保持最新 容器运行时 - 负责管理容器镜像,并在该节点上运行容器 Kubernetes节点组件详解 总而言之就是,节点上运行着两个最重要的组件——kubelet和kube-proxy,除此之外还有一个负责运行应用容器化应用程序的容器引擎。 kubelet kubelet处理着master和在其上运行的节点之间的所有通信。它以manifest的形式接收来自主设备的命令,manifest定义着工作负载和操作参数。它与负责创建、启动和监视pod的容器运行时进行接合。 kubelet还会周期性地对配置的活跃度探针和准备情况进行检查。它会不断监视pod的状态,并在出现问题时启动新实例。kubelet还有一个内部HTTP服务器,在端口10255上显示一个只读视图。除此之外,在/healthz上还有一个健康检查端点,以及一些其他状态端点。例如,我们可以在/pods获取正在运行的pod的列表。我们还可以在/spec获取kubelet正在运行的机器的详情。 kube-proxy kube-proxy组件在每个节点上运行,负责代理UDP、TCP和SCTP数据包(它不了解HTTP)。它负责维护主机上的网络规则,并处理pod、主机和外部世界之间的数据包传输。它就像是节点上运行着的pod的网络代理和负载均衡器一样,通过在iptables使用NAT实现东/西负载均衡。 kube-proxy过程位于连接到Kubernetes的网络和在该特定节点上运行的pod之间。它本质上是Kubernetes的核心网络组件,负责确保跨集群的所有元素有效地进行通信。当用户创建Kubernetes服务对象时,kube-proxy实例会负责将该对象转换为位于worker节点的、本地iptables规则集上的有意义的规则。iptables用于将分配给服务对象的虚拟IP转换为服务映射的所有pod IP。 容器运行时 容器运行时负责从公有或私有镜像仓库中拉取镜像,并根据这些镜像运行容器。当下最流行的容器引擎无疑是Docker,不过Kubernetes还支持诸如rkt、runc等的其他容器运行时。正如我们在上文中提到过的,kubelet会直接与容器运行时交互,以启动、停止或删除容器。 cAdvisor cAdvisor是一个开源代理,它能够监视资源使用情况并分析容器的性能。cAdvisor最初由谷歌创建,现在已与kubelet集成。 位于每个节点上的cAdvisor实例,会收集、聚合、处理和导出所有正在运行的容器的指标,如CPU、内存、文件和网络使用情况等。所有数据都将发送到调度程序,以确保调度程序了解节点内部的性能和资源使用情况。这些信息会被用于执行各种编排任务,如调度、水平pod扩展、管理容器资源限制等。 从动手实操了解节点组件端点 接下来,我们将安装一个Kubernetes集群(在Rancher的帮助下),以此来开始探索节点组件公开的一些API。要完成下面的操作,我们需要: Google Cloud Platform帐户(任何公有云也都是一样的) 一台主机,后续Rancher会运行在它上面(可以是个人PC / Mac或公有云中的VM) 在同一主机上,安装kubectl和 Google Cloud SDK。验证好您的相关credential(gcloud init和gcloud auth login),确保gcloud能正常访问您的Google Cloud账户 在GKE上运行的Kubernetes集群(运行EKS或AKS也是相同的) 启动Rancher实例 首先,启动Rancher实例。这一过程非常简单,参考快速上手指南即可: https://rancher.com/quick-start/ 使用Rancher部署GKE集群 使用Rancher设置和配置Kubernetes集群,同样是按指南进行操作即可: https://rancher.com/docs/rancher/v2.x/en/cluster-provisioning/hosted-kubernetes-clusters/gke/ 部署好集群后,我们可以快速部署Nginx以进行测试: 为了与Kubernetes API进行交互,我们需要在本地计算机上启动代理服务器: 让我们检查一下进度,看它是否正在正常运行,以及是否在监听默认端口: 现在,在浏览器中,检查kubelet公开的各种端点: 接下来,显示集群可用节点的列表: 我们可以通过spec来检查所有列出的、使用API的节点。在本文的示例中,我们使用n1-standard-1机器类型(1个vCPU,3.75GB RAM,10GB的根大小磁盘)创建了一个3节点集群。我们可以通过访问专用端点来确认这些规范: 在不同端点使用相同的kubelet API,我们可以检查我们创建的Nginx pod,以查看它们正运行在什么节点上。 首先,列出正在运行的pod: 现在,curl每个节点的/proxy/pods端点,查看其运行的pod列表: 我们还可以检查cAdvisor端点,它会以Prometheus格式输出大量数据。默认情况下,这在/metrics HTTP端点可用: SSH到节点并直接调用kubelet端口,也可以获得相同的cAdvisor或pod信息: 清理 要清理我们在本文中使用的资源,只需从Rancher UI中删除Kubernetes集群即可(选择集群并点击Delete按钮就可以了)。这将删除我们的集群正在使用的所有节点以及关联的IP地址。如果您是在公有云中使用VM来运行Rancher,那么您也需要处理它。找出您的实例名称,然后将其删除即可: 结 语 在本文中,我们讨论了Kubernetes节点机器的关键组件。之后,我们使用Rancher部署了一个Kubernetes集群,并完成了一个小型部署以帮助我们学习使用kubelet API。 若想了解有关Kubernetes及其架构的更多信息,Kubernetes官方文档是一个不错的起点:https://kubernetes.io/docs/concepts/overview/components/

优秀的个人博客,低调大师

Python 核心编程 (全)

浅拷贝和深拷贝 1.浅拷贝:是对于一个对象的顶层拷贝,通俗的理解是:拷贝了引用,并没有拷贝内容。相当于把变量里面指向的一个地址给了另一个变量就是浅拷贝,而没有创建一个新的对象,如a=b 2.深拷贝:首先要import copy,然后c = copy.deepcopy(a),就表示把a的内容深拷贝到c中,如果发现了a中也存在引用的内容,则递归拷贝,也就是把当前的这个引用的对象继续深拷贝 3. copy和deepcopy的区别 ①copy:浅拷贝,里面如果有可变类型,修改这个可变类型(如list),被拷贝的对象也会相应改变,仅仅拷第一层,如果是不可变类型,就一层都不拷,如果是可变类型就拷一层 ②deepcopy:深拷贝,里面不管是可变类型和不可变类型,被拷贝的对象都不会受到影响,递归拷贝 4.copy和deepcopy拷贝元组的特点 使用copy模块的copy功能的时候,它会根据当前拷贝的数据类型是可变类型还是不可变类型有不同的处理方式,如元组是不可变类型,拷贝多份没有用,对copy来说,如果是可变类型就拷一层,如果是不可变类型,就一层都不拷 属性property 1.属性property-1 ①私有属性添加getter和setter方法 ②使用property升级getter和setter方法 num=property(getNum,setNum) 注意: Num到底是调用getNum()还是setNum(),要根据实际的场景来判断,值得注意的是一定要先填getNum后setNum 如果是给t.num赋值,那么一定调用setNum() 如果是获取t.num的值,那么就一定调用getNum() property的作用:相当于把方法进行了封装,开发者在对属性设置数据的时候更方便 2.属性property-2 classMoney(object): @property#修饰器 defnum(self): print("------getter-----") returnself.__num @num.setter#修饰器 defnum(self,new_num): print("------setter------") self.__num=new_num t.num=20 print(t.num) 迭代器 1.迭代器 迭代是访问集合元素的一种方式。迭代器是一个可以记住遍历的位置的对象。迭代器对象从集合的第一个元素开始访问,直到所有的元素被访问完结束,迭代器只能往前不会后退 2.可迭代对象(for 循环遍历的数据类型) ①一类是集合数据类型,如 list 、 tuple 、 dict 、 set 、 str 等 ②一类是 generator(列表生成式,生成器) ,包括生成器和带 yield 的generator function ③这些可以直接作用于for循环的对象统称为可迭代对象:Iterable fromcollectionsimportIterable #如果可以迭代就返回True isinstance([],Iterable) 3.判断是否可以迭代 可以使用isinstance()判断一个对象是否是Iterable对象 fromcollectionsimportIterable #如果可以迭代就返回True isinstance([],Iterable) 而生成器不但可以作用于for循环,还可以被next()函数不断调用并返回下一个值,直到最后抛出StopIteration错误表示无法继续返回下一个值了 4.迭代器 ①可以被next()函数调用并不断返回下一个值的对象称为迭代器:Iterator ②可以使用isinstance()判断一个对象是否是Iterator对象 ③生成器(i for i in range(10))一定是迭代器,但迭代器不一定是生成器 ④迭代器一定是可迭代对象,但可迭代对象不一定是迭代器 fromcollectionsimportIterator isinstance((xforxinrange(10)),Iterator)#如果是的话就返回True 5.iter( )函数 ①生成器都是Iterator(迭代器)对象,但 list、dict、str虽然是Iterable(可迭代),却不是Iterator(迭代器) ②把list、dict、str 等 Iterable(可迭代)变成 Iterator(迭代器)可以使用iter()函数,就好比人可以游泳,但不是天生就会,可迭代对象就好比人,迭代器就好比会游泳的人,需要经过iter()训练一样 isinstance(iter([ ]),Iterator) True 闭包 1.函数的引用 test1()#调用函数 ret=test1#引用函数 ret()#通过引用调用函数 2.什么是闭包 在函数内部再定义一个函数,并且这个函数用到了外边函数的变量,那么将这个函数以及用到的一些变量称之为闭包 deftest(number): print("-----1-----") deftest_in(number2): print("----2-----") print(number+number2) print("------3------") #把函数的引用返回了 returntest_in #用来接收test(100),指向了一个函数体,这个100传给了number ret=test(100) #这个1传给了number2 ret(1) #这个返回101 ret(100) #这个返回200 ret(200) #这个返回300 3.闭包再理解 内部函数对外部函数作用域里变量的引用(非全局变量),则称内部函数为闭包 闭包的实际例子: defline_conf(a,b): defline(x): returna*x+b returnline line1=line_conf(1,1) line2=line_conf(4,5) print(line1(5)) print(line2(5)) 这个例子中,函数line与变量a,b构成闭包。在创建闭包的时候,我们通过line_conf的参数a,b说明了这两个变量的取值,这样,我们就确定了函数的最终形式(y = x + 1和y = 4x + 5)。我们只需要变换参数a,b,就可以获得不同的直线表达函数。由此,我们可以看到,闭包也具有提高代码可复用性的作用 装饰器 1.装饰器 在有两个重名的函数中,Python解释器会调用最后定义的那重名函数,因为在Python里,第一个函数指向的是一片内存,然后又让这个函数指向另一片内存,就会利用第二片内存来执行,所有函数名应尽量避免相同 写代码要遵循开放封闭原则,虽然在这个原则是用的面向对象开发,但是也适用于函数式编程,简单来说,它规定已经实现的功能代码不允许被修改,但可以被扩展,即: ①封闭:已实现的功能代码块 ②开放:对扩展开发 ③实例: defw1(func): definner(): #验证1 #验证2 #验证3 func() returninner @w1 #装饰器 deff1(): print('f1') @w1#装饰器 deff2(): print('f2') ........ 对于上述代码,也是仅仅对基础平台的代码进行修改,就可以实现在其他人调用函数 f1、 f2 、f3 、f4 之前都进行【验证】操作,并且其他业务部门无需做任何操作 2.装饰器的功能 ①引入日志 ②函数执行时间统计 ③执行函数前预备处理 ④执行函数后清理功能 ⑤权限校验等场景 ⑤缓存 ⑥如果是有多个装饰器的情况,一般是先装饰最下面的一个,然后依次往上,@w1类比于f1 = w1(f1) 3.装饰有参数的函数:在传递参数的时候,需要在闭包里面定义一个形参,闭包里面的调用的函数也要定义一个形参,否则会导致两部分函数调用失败 4.装饰不定长的参数的函数:在传递参数的时候,需要在闭包里面定义一个*args和**kwargs,闭包里面的调用的函数也要定义一个*args和**kwargs,这样就可以在调用的时候传递任意长度的参数,增加代码的可复用性 5.装饰带返回值的函数:需要在闭包里面进行一个接收,也就是ret = test(),然后再把接收到的ret return出去,这样在装饰的test才能返回出当前需要返回的东西,否则只会返回None 6.通用的装饰 defw1(func): print("-----正在装饰-----") definner(*args,**kwargs): print("---正在验证权限---") print("----记录日志----") ret=func(*args,**kwargs) returnret returninner 带有参数的装饰器:也就是在原来包含一个闭包的函数外面再给他套一个函数,用来传递装饰器的参数 deffunc_arg(arg): defw1(func): print("---记录日志---") definner(*args,**kwargs): func(*args,**kwargs) returninner returnw1 @func_arg("heihei") deff1(): print("----f1----") #1.先执行func_arg("heihei")函数,这个函数return的结果是 #2.@w1 #3.使用@w1对f1进行装饰 #作用:带有参数的装饰器,能够起到在运行时,有不同的功能 python是动态语言 1.Python是动态语言 动态编程语言是高级程序设计语言的一个类别,在计算机科学领域已被广泛应用。它是一类在运行时可以改变其结构的语言:例如新的函数、对象、甚至代码可以被引进,已有的函数可以被删除或是其他结构上的变化。这种动态语言的应用就好比是在没有更新app的情况下,它的界面在后台也可以被开发者更改,因为它是动态的,可以把新增的动态程序放置在文本,只要加载一遍即可 2.运行的过程中给对象绑定(添加)属性:也就是说给对象绑定一个实例属性(这个属性是初始化之外的额外属性),只有这个创建对象的属性如laozhao.addr = "北京" 3.运行的过程中给类绑定(添加)属性:如果需要所有的一个类的实例加上一个属性怎么办呢? 答案就是直接给这个类绑定属性,如Person.sex = "male" 4.运行的过程中给类绑定(添加)方法: 如果是对这个类绑定一个实例方法,那么就要先import types,然后如对象.方法名 = types.MethodType(函数名, 对象),把run这个方法绑定到P对象上。如果是静态方法和类方法,就直接用类名.方法名=函数名 5.运行的过程中删除属性、方法: ①del 对象.属性名 ②delattr(对象, "属性名") __slots__的作用 1.动态语言:可以在运行的过程中,修改代码 2.静态语言:编译时已经确定好代码,运行过程中不能修改 3.为了达到限制的目的,Python允许在定义class的时候,定义一个特殊的__slots__变量,来限制该class实例能添加的属性,如__slots__ = ("name","age"),就可以达到限制name和age的属性,如果发现有添加其他属性的程序就会发生异常 4.使用__slots__要注意,__slots__定义的属性仅对当前类实例起作用,对继承的子类是不起作用的 生成器 1.什么是生成器 通过列表生成式,我们可以直接创建一个列表。但是,受到内存限制,列表容量肯定是有限的。而且,创建一个包含100万个元素的列表,不仅占用很大的存储空间,如果我们仅仅需要访问前面几个元素,那后面绝大多数元素占用的空间都白白浪费了 ①while的列表推导 list.append(i) ②for的列表推导,range与切片很类似 foriinrange(10,78): ③第一个i是元素的值,后面的for是循环的次数,如果第一个i=11,那么所有的元素都是11 a=[iforiinrange(1,18)] ④for控制循环的次数,for和if的嵌套 c=[iforiinrange(10)ifi%2==0] ⑤每执行第一个for循环都要执行第二个for循环的所有次数 d=[iforiinrange(3)forjinrange(2)] ⑥每执行第一个for循环都要执行第二个for循环的所有次数 d=[(i,j)foriinrange(3)forjinrange(2)] 例题:找出100以内能被3整除的正整数 aiquot=[] forninrange(1,100) ifn%3==0: aiquot.append(n) range(3,100,3)#很简洁 2.创建生成器方法1 要创建一个生成器,有很多种方法。第一种方法很简单,只要把一个列表生成式的[ ]改成( ) 如L = [ x*2 for x in range(5)]和G = ( x*2 for x in range(5)),L是一个列表,而G是一个生成器,可以通过next(G)函数获得生成器的下一个返回值,不断调用 next()实在是太变态了,正确的方法是使用for循环,因为生成器也是可迭代对象 3.创建生成器方法2 fib函数变成generator,只需要把print(b)改为yield b就可以了,循环过程中不断调用yield ,就会不断中断。当然要给循环设置一个条件来退出循环,不然就会产生一个无限数列出来,当循环到没有元素的时候,将会生成异常,这时候就要用try和exception来检测异常,#print自动检测异常并停止,但是next()就要用try ,在创建生成器的时候需要接收函数的返回值 #1.next(返回函数名) #2.返回函数名.__next__()是一样的方法来获取下一个返回值 总结:生成器是这样一个函数,它记住上一次返回时在函数体中的位置。对生成器函数的第二次或第 n 次调用跳转至该函数中间,而上次调用的所有局部变量都保持不变,生成器不仅“记住”了它数据状态;生成器还“记住”了它在流控制构造(在命令式编程中,这种构造不只是数据值)中的位置 4.生成器的特点 ①节约内存 ②迭代到下一次的调用时,所使用的参数都是第一次所保留下的,即是说,在整个所有函数调用的参数都是第一次所调用时保留的,而不是新创建的 5.send用法 ①如果在在程序中有个变量等于yield,不是说把yield的值给了这个变量,而是接下来在下一次调用执行一次的时候可以传一个值,t.send("haha")和t.__next__()都可以让生成器继续执行,不同的是send可以传递一个值,但是不能在程序刚开始执行就用send传值,有两种方法,要么先用__next__调用一次,再send一个值,或者t.send(None) ②生成器:完成多任务,控制多个任务执行的情况 元类 1.元类 ①类也是对象 ②在大多数编程语言中,类就是一组用来描述如何生成一个对象的代码段,类同样也是一种对象 2.动态的创建类 因为类也是对象,你可以在运行时动态的创建它们,就像其他任何对象一样 defchoose_class(name): ifname=='foo': classFoo(object): pass returnFoo#返回的是类,不是类的实例 else: classBar(object): pass returnBar MyClass=choose_class('foo')#当你使用class关键字时,Python解释器自动创建这个对象 2.使用type创建类 ①type还有一种完全不同的功能,动态的创建类,type可以像这样工作: ②type(类名, 由父类名称组成的元组(针对继承的情况,可以为空),包含属性的字典(名称和值)) Test2=type("Test2",(),{})#定了一个Test2类 3.使用type创建带有属性的类 Foo=type('Foo',(),{'bar':True}) 4.使用type创建带有方法的类 FooChild=type('FooChild',(Foo,),{'echo_bar':echo_bar})#这是添加实例方法echo_bar Foochild=type('Foochild',(Foo,),{"echo_bar":echo_bar,"testStatic":testStatic})#添加静态方法 Foochild=type('Foochild',(Foo,),{"echo_bar":echo_bar,"testStatic":testStatic,"testClass":testClass})#添加类方法 5.到底什么是元类 元类就是用来创建类的东西,元类就是用来创建这些类 (对象) 的,元类就是类的类,元类又由元类创建,Python中所有的东西,注意,我是指所有的东西——都是对象。这包括整数、字符串、函数以及类 6.__metaclass__属性 classFoo(object): __metaclass__=something… 如果这么做了,Python就会用元类来创建类Foo,这里面有些技巧。首先写下class Foo(object),但是类Foo还没有在内存中创建。Python会在类的定义中寻找__metaclass__属性,如果找到了,Python就会用它来创建类Foo,如果没有找到,就会用内建的type来创建这个类 GC垃圾回收 1.GC垃圾回收 ①小整数对象池:Python为了优化速度,使用了小整数对象池, 避免为整数频繁申请和销毁内存空间。Python 对小整数的定义是[-5, 257) 这些整数对象是提前建立好的,不会被垃圾回收 ②大整数对象池:每一个大整数,均创建一个新的对象 ③intern机制:假如要创建n个对象的是一样的字符串,那么python只会创建一个内存空间来存储,其他对象都是引用,但如果字符串中出现空格或其他符号就表示为不同的对象 2.GC(Garbage collection)垃圾回收 Python里也同Java一样采用了垃圾收集机制,不过不一样的是: Python采用的是引用计数机制为主,标记-清除和分代收集两种机制为辅的策略 3.引用计数机制的优点 ①简单 ②实时性:一旦没有引用,内存就直接释放了。不用像其他机制等到特定时机。实时性还带来一个好处:处理回收内存的时间分摊到了平时 4. 引用计数机制的缺点 ①维护引用计数消耗资源 ②循环引用 5.GC系统所承担的工作远比"垃圾回收"多得多。实际上,它们负责三个重要任务: ①为新生成的对象分配内存 ②识别那些垃圾对象 ③从垃圾对象那回收内存 6.垃圾回收机制:Python中的垃圾回收是以引用计数为主,分代收集为辅 ①导致引用计数+1的情况: 对象被创建,例如a=23 对象被引用,例如b=a 对象被作为参数,传入到一个函数中,例如func(a) 对象作为一个元素,存储在容器中,例如list1=[a,a] ②导致引用计数-1的情况: 对象的别名被显式销毁,例如del a 对象的别名被赋予新的对象,例如a=24 一个对象离开它的作用域,例如f函数执行完毕时,func函数中的局部变量(全局变量不会) 对象所在的容器被销毁,或从容器中删除对象 7.查看一个对象的引用计数 importsys a="helloworld" sys.getrefcount(a) ①可以查看a对象的引用计数,但是比正常计数大1,因为调用函数的时候传入a,这会让a的引用计数+1 ②有三种情况会触发垃圾回收: 调用gc.collect() 当gc模块的计数器达到阀值的时候 程序退出的时候 8.gc模块的自动垃圾回收机制: ①必须要import gc模块,并且is_enable()=True才会启动自动垃圾回收。 ②这个机制的主要作用就是发现并处理不可达的垃圾对象。 ③垃圾回收 = 垃圾检查 + 垃圾回收 ④在Python中,采用分代收集的方法。把对象分为三代,一开始,对象在创建的时候,放在一代中,如果在一次一代的垃圾检查中,该对象存活下来,就会被放到二代中,同理在一次二代的垃圾检查中,该对象存活下来,就会被放到三代中 ⑤gc模块里面会有一个长度为3的列表计数器,可以通过gc.get_count()获取,gc.set_threshold(threshold0[, threshold1[, threshold2]) 设置自动执行垃圾回收的频率,例如(700,10,10)每一次计数器的增加,gc模块就会检查增加后的计数是否达到阀值的数目,700表示阈值,10表示没清理10次零代就清理一次二代,第二个10表示每清理10次一代链表就清理二代一次 注意点: gc模块唯一处理不了的是循环引用的类都有__del__方法,所以项目中要避免定义__del__方法 内建属性 常用专有属性 说明 触发方式 __init__ 构造初始化函数 创建实例后,赋值时使用,在__new__后 __new__ 生成实例所需属性 创建实例时 __class__ 实例所在的类 实例.__class__ __str__ 实例字符串表示,可读性 print(类实例),如没实现,使用repr结果 __repr__ 实例字符串表示,准确性 类实例 回车 或者 print(repr(类实例)) __del__ 析构 del删除实例 __dict__ 实例自定义属性 vars(实例.__dict__) __doc__ 类文档,子类不继承 help(类或实例) __getattribute__ 属性访问拦截器 访问实例属性时 __bases__ 类的所有父类构成元素 类名.__bases__ def__getattribute__(self,obj): ifobj=='subject1': print('logsubject1') return'redirectpython' else:#测试时注释掉这2行,将找不到subject2 returnobject.__getattribute__(self,obj) __getattribute__的作用可以用来打印Log日志 __getattribute__的坑: classPerson(object): def__getattribute__(self,obj): print("---test---") ifobj.startswith("a"): return"hahha" else: returnself.test deftest(self): print("heihei") t.Person() t.a#返回hahha t.b#会让程序死掉 #原因是:当t.b执行时,会调用Person类中定义的__getattribute__方法,但是在这个方法的执行过程中if条件不满足,所以程序执行else里面的代码,即returnself.test问题就在这,因为return需要把self.test的值返回,那么首先要获self.test的值,因为self此时就是t这个对象,所以self.test就是t.test此时要获取t这个对象的test属性,那么就会跳转到__getattribute__方法去执行,即此时产生了递归调用,由于这个递归过程中没有判断什么时候推出,所以这个程序会永无休止的运行下去,又因为每次调用函数,就需要保存一些数据,那么随着调用的次数越来越多,最终内存吃光,所以程序崩溃 #注意:以后不要在__getattribute__方法中调用self.xxxx 调试 1.调试:pdb是基于命令行的调试工具,非常类似gnu的gdb(调试c/c++) 执行时调试 程序启动,停止在第一行等待单步调试 python-mpdbxxx.py 2.调试方法 ①n(next)执行下一步 ②l(list)显示当前执行进度 ③c(continue)继续执行代码 ④b(break)添加断点 ⑤q(quit)中止并退出 ⑥clear num删除指定断点 ⑦p(print)打印变量的值 ⑧a(args)打印所有的形参数据 ⑨s(step)进入到一个函数 r执行代码直到从当前函数返回

优秀的个人博客,低调大师

Python 基础入门 (全)

MongoDB简介 1.MongoDB ①MongoDB 是一个基于分布式 文件存储的NoSQL数据库 ②由C++语言编写,运行稳定,性能高 ③旨在为 WEB 应用提供可扩展的高性能数据存储解决方案 ④官方网址:https://www.mongodb.com/ 2.MongoDB特点 ①MongoDB可以轻松地布置两个活跃集群,但关系型不容易在两台服务器上同时运行单个数据库 ②MongoDB天然缺少对事物的支持 ③MongoDB并不提供主/主复制,但它支持分片 3.Bson和Json ①Bosn版本是Json的二进制格式,但并不意味着Bson占用的空间就比Json小的多 ②继续使用Bson的原因是因为MongoDB在设计上就是要求快速,而不是节省空间,如果处理数据的速度更快,存储文档时的一点开销是完全可以接受的 ③Bson更易于浏览(即遍历),遍历索引页非常快,第二点是很容易将Bson数据快速转化为编程语言的原生数据格式 4.名词 SQL术语/概念 MongoDB术语/概念 解释/说明 database database 数据库 table collection 数据库表/集合 row document 数据记录行/文档 column field 数据字段/域 index index 索引 tablejoins 表连接,MongoDB不支持 primarykey primarykey 主键,MongoDB自动将_id字段设置为主键 5.MongoDB三要素:数据库,集合,文档 ①数据库:是一个集合的物理容器,一个数据库中可以包含多个文档,一个服务器通常有多个数据库 ②集合:类似于关系数据库中的表,储存多个文档,结构不固定,如可以存储如下文档在一个集合中 {'name':'guojing','gender':'男'} {'name':'huangrong','age':18} {'book':'shuihuzhuan','heros':'108'} ③文档:就是一个对象,由键值对组成,是Json的扩展Bson格式 {'name':'guojing','gender':'男'} MongoDB安装与管理 1.安装 ①下载MongoDB的版本注意,两点注意 根据规则:偶数为稳定版,如1.6X,奇数为开发版,如1.7X 32bit的MongoDB最大只能存放2G的数据,64bit就没有限制 ②到官网,选择合适的版本下载 ③解压 tar-zxvfmongodb-linux-x86_64-ubuntu1604-3.4.0.tgz ④移动到/usr/local/目录下 sudomv-rmongodb-linux-x86_64-ubuntu1604-3.4.0//usr/local/mongodb ⑤将可执行文件添加到PATH路径中 exportPATH=/usr/local/mongodb/bin:$PATH 2.管理 ①配置文件在/etc/mongod.conf,默认端口27017 ②启动 sudoservicemongodstart ③停止 sudoservicemongodstop ④使用终端连接:mongo,这个shell就是mongodb的客户端,同时也是一个js的编译器 ⑤ GUI:robomongo,解压后在bin目录下找到运行程序 数据库操作 1.数据库切换 ①查看当前数据库名称:db ②查看所有数据库名称:show dbs,(列出所有在物理上存在的数据库) ③切换数据库:use 数据库名称,(如果数据库不存在,则指向数据库,但不创建,直到插入数据或创建集合时数据库才被创建) ④默认的数据库为test,如果没有创建新的数据库,集合将存放在test数据库中 2.数据库删除 删除当前指向的数据库,如果数据库不存在,则什么也不做 db.dropDatabase() 集合操作 1.集合创建 语法: db.createCollection(name,option) ①name是要创建集合的名称 ②options是一个文档,用于指定集合的配置 ③选项参数是可选的,所以只需要到指定的集合名称 例1:不限制集合的大小 db.createCollection(‘stu’) 例2:限制集合大小 db.createCollection(‘sub’,{capped:true,size:10}) 参数capped:默认值为false表示不设置上限,值为true表示设置上限 参数size:当capped值为true时,需要指定此参数,表示上限大小,当文档设置上限时,会将之前的数据覆盖,单位为字节 2.查看当前数据库的集合 showcollections 3.删除集合 db.集合名称.drop() 数据类型 1. MongoDB中常用的几种数据类型: ①Object ID:文档ID ②String:字符串,最常用,必须是有效的UTF-8 ③Boolean:存储一个布尔值,true或false ④Integer:整数可以是32位或64位,这取决于服务器 ⑤Double:存储浮点值 ⑥Arrays:数组或列表,多个值存储到一个键 ⑦Object:用于嵌入式的文档,即一个值为一个文档 ⑧Null:存储Null值 ⑨Timestamp:时间戳 ⑩Date:存储当前日期或时间的UNIX时间格式 2. object id ①每个文档都有一个属性,为_id,保证每个文档的唯一性 ②可以自己去设置_id插入文档 ③如果没有提供,那么MongoDB为每个文档提供了一个独特的_id,类型为objectID ④objectID是一个12字节的十六进制数 前4个字节为当前时间戳 接下来3个字节的机器ID 接下来的2个字节中MongoDB的服务进程id 最后3个字节是简单的增量值 数据操作 1.插入 插入文档时,如果不指定_id参数,MongoDB会为文档分配一个唯一的ObjectId db.集合名称.insert(document) 2.简单查询 db.集合名称.find() 3.更新 db.集合名称.update(<query>,<update>,multi:<boolean>}) ①参数query:查询条件,类似sql语句update中where部分 ②参数update:更新操作符,类似sql语句update中set部分 ③参数multi:可选,默认是false,表示只更新找到的第一条记录,值为true表示把满足条件的文档全部更新 例3:全文档更新 db.stu.update( {name:'hr'},{name:'mnc'} ) 例4:指定属性更新,通过操作符$set db.stu.insert({name:'hr',gender:0}) db.stu.update({name:'hr'},{$set:{name:'hys'}}) 例5:修改多条匹配到的数据 db.stu.update({},{$set:{gender:0}},{multi:true}) 4.保存 如果文档的_id已经存在则修改,不存在则添加 db.集合名称.save(document) 5.删除 db.集合名称.remove(<query>,{justOne:<boolean>}) ①参数query:可选,删除的文档的条件 ②参数justOne:可选,如果设为true或1,则只删除一条,默认false,表示删除多条 例6:只删除匹配到的第一条 db.stu.remove({gender:0},{justOne:true}) 例7:全部删除 db.stu.remove({}) 数据查询 1.基本查询 ①方法find():查询 db.集合名称.find({条件文档}) ②方法findOne():查询,只返回第一个 db.集合名称.findOne({条件文档}) ③方法pretty():将结果格式化 db.集合名称.find({条件文档}).pretty() 2.比较运算符 ①等于,默认是等于判断,没有运算符 ②小于$lt ③小于或等于$lte ④大于$gt ⑤大于或等于$gte ⑥不等于$ne 例8:查询年龄大于或等于18的学生 db.stu.find({age:{$gte:18}}) 3.逻辑运算符 ①查询时可以有多个条件,多个条件之间需要通过逻辑运算符连接 ②逻辑与:默认是逻辑与的关系 例9:查询年龄大于或等于18,并且性别为1的学生 db.stu.find({age:{$gte:18},gender:1}) 逻辑或:使用$or 例10:查询年龄大于18,或性别为0的学生 db.stu.find({$or:[{age:{$gt:18}},{gender:1}]}) and和or一起使用 例11:查询年龄大于18或性别为0的学生,并且学生的姓名为gj db.stu.find({$or:[{age:{$gte:18}},{gender:1}],name:'gj'}) 4.范围运算符 使用"$in","$nin" 判断是否在某个范围内 例12:查询年龄为18、28的学生 db.stu.find({age:{$in:[18,28]}}) 5.支持正则表达式 使用//或$regex编写正则表达式 例13:查询姓黄的学生 db.stu.find({name:/^黄/})db.stu.find({name:{$regex:'^黄'}}) 6.自定义查询 使用$where后面写一个函数,返回满足条件的数据 例14:查询年龄大于30的学生 db.stu.find({$where:function(){returnthis.age>20}}) 7. Limit(方法limit():用于读取指定数量的文档) db.集合名称.find().limit(NUMBER) ①参数NUMBER表示要获取文档的条数 ②如果没有指定参数则显示集合中的所有文档 例15:查询2条学生信息 db.stu.find().limit(2) 8. skip(方法skip():用于跳过指定数量的文档) db.集合名称.find().skip(NUMBER) 参数NUMBER表示跳过的记录条数,默认值为0 例16:查询从第3条开始的学生信息 db.stu.find().skip(2) 9.Limit与Skip一起使用 方法limit()和skip()可以一起使用,不分先后顺序 查询第5至8条数据(跳取) db.stu.find().limit(4).skip(5)db.stu.find().skip(5).limit(4) 10. 投影 在查询到的返回结果中,只选择必要的字段,而不是选择一个文档的整个字段 语法:参数为字段与值,值为1表示显示,值为0不显示 db.集合名称.find({},{字段名称:1,...}) 对于需要显示的字段,设置为1即可,不设置即为不显示 特殊:对于_id列默认是显示的,如果不显示需要明确设置为0 db.stu.find({},{_id:0,name:1,gender:1}) 11.排序 方法sort(),用于对结果集进行排序 语法:db.集合名称.find().sort({字段:1,...}) ①参数1为升序排列 ②参数-1为降序排列 例18:根据性别降序,再根据年龄升序 db.stu.find().sort({gender:-1,age:1}) 12.统计个数 方法count()用于统计结果集中文档条数 语法: db.集合名称.find({条件}).count() 也可以与为 db.集合名称.count({条件}) 例19:统计男生人数 db.stu.find({gender:1}).count() 例20:统计年龄大于20的男生人数 db.stu.count({age:{$gt:20},gender:1}) 13.消除重复 方法distinct()对数据进行去重 语法: db.集合名称.distinct('去重字段',{条件}) 例21:查找年龄大于18的性别(去重) db.stu.distinct('gender',{age:{$gt:18}}) 聚合 aggregate 1.聚合(aggregate) 主要用于计算数据,类似sql中的sum()、avg() 语法: db.集合名称.aggregate([{管道:{表达式}}]) 2.管道 管道在Unix和Linux中一般用于将当前命令的输出结果作为下一个命令的输入 psajx|grepmongo 在mongodb中,管道具有同样的作用,文档处理完毕后,通过管道进行下一次处理 常用管道: $group:将集合中的文档分组,可用于统计结果 $match:过滤数据,只输出符合条件的文档 $project:修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 $sort:将输入文档排序后输出 $limit:限制聚合管道返回的文档数 $skip:跳过指定数量的文档,并返回余下的文档 $unwind:将数组类型的字段进行拆分 表达式 处理输入文档并输出 语法:表达式:'$列名' $sum:计算总和,$sum:1同count表示计数 $avg:计算平均值 $min:获取最小值 $max:获取最大值 $push:在结果文档中插入值到一个数组中 $first:根据资源文档的排序获取第一个文档数据 $last:根据资源文档的排序获取最后一个文档数据 3.$group 将集合中的文档分组,可用于统计结果 _id表示分组的依据,使用某个字段的格式为'$字段' 例22:统计男生、女生的总人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}}]) Group by null 将集合中所有文档分为一组 例23:求学生总人数、平均年龄 db.stu.aggregate([{$group:{_id:null,counter:{$sum:1},avgAge:{$avg:'$age'}}}]) 透视数据 例24:统计学生性别及学生姓名 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$name'}}}]) 使用$$ROOT可以将文档内容加入到结果集的数组中,代码如下 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$$ROOT'}}}]) 4.$match 用于过滤数据,只输出符合条件的文档 使用MongoDB的标准查询操作 例25:查询年龄大于20的学生 db.stu.aggregate([{$match:{age:{$gt:20}}}]) 例26:查询年龄大于20的男生、女生人数 db.stu.aggregate([{$match:{age:{$gt:20}}},{$group:{_id:'$gender',counter:{$sum:1}}}]) 5.$project 修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 例27:查询学生的姓名、年龄 db.stu.aggregate([{$project:{_id:0,name:1,age:1}}]) 例28:查询男生、女生人数,输出人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$project:{_id:0,counter:1}}]) 6. $sort 将输入文档排序后输出 例29:查询学生信息,按年龄升序 b.stu.aggregate([{$sort:{age:1}}]) 例30:查询男生、女生人数,按人数降序 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$sort:{counter:-1}}]) 7. $limit,$skip 限制聚合管道返回的文档数 例31:查询2条学生信息 db.stu.aggregate([{$limit:2}]) $skip 跳过指定数量的文档,并返回余下的文档 例32:查询从第3条开始的学生信息 db.stu.aggregate([{$skip:2}]) 例33:统计男生、女生人数,按人数升序,取第二条数据 db.stu.aggregate( [{$group:{_id:'$gender',counter:{$sum:1}}}, {$sort:{counter:1}}, {$skip:1}, {$limit:1}]) 注意顺序:先写skip,再写limit 8. $unwind 将文档中的某一个数组类型字段拆分成多条,每条包含数组中的一个值 语法1:对某字段值进行拆分 db.集合名称.aggregate([{$unwind:'$字段名称'}]) 构造数据 db.t2.insert({_id:1,item:'t-shirt',size:['S','M','L']}) 查询 db.t2.aggregate([{$unwind:'$size'}]) 语法2:对某字段值进行拆分 处理空数组、非数组、无字段、null情况 db.inventory.aggregate([{$unwind:{path:'$字段名称',preserveNullAndEmptyArrays:<boolean>#防止数据丢失}}]) 构造数据 db.t3.insert( [{"_id":1,"item":"a","size":["S","M","L"]}, {"_id":2,"item":"b","size":[]}, {"_id":3,"item":"c","size":"M"}, {"_id":4,"item":"d"}, {"_id":5,"item":"e","size":null}] ) 使用语法1查询 db.t3.aggregate([{$unwind:'$size'}]) 查看查询结果,发现对于空数组、无字段、null的文档,都被丢弃了 问:如何能不丢弃呢? 答:使用语法2查询 db.t3.aggregate([{$unwind:{path:'$sizes',preserveNullAndEmptyArrays:true}}]) 安全 1.超级管理员 为了更安全的访问mongodb,需要访问者提供用户名和密码,于是需要在mongodb中创建用户 采用了角色-用户-数据库的安全管理方式 常用系统角色如下: root:只在admin数据库中可用,超级账号,超级权限 Read:允许用户读取指定数据库 readWrite:允许用户读写指定数据库 创建超级管理用户 useadmindb.createUser({ user:'admin', pwd:'123', roles:[{role:'root',db:'admin'}] }) 2.启用安全认证 修改配置文件 sudovi/etc/mongod.conf 启用身份验证 注意:keys and values之间一定要加空格, 否则解析会报错 security:authorization:enabled 重启服务 sudoservicemongodstop sudoservicemongodstart 终端连接 mongo-u'admin'-p'123'--authenticationDatabase'admin' 3.普通用户管理 使用超级管理员登录,然后进入用户管理操作 查看当前数据库的用户 usetest1showusers 创建普通用户 db.createUser({ user:'t1',pwd:'123',roles:[{role:'readWrite',db:'test1'}] }) 终端连接 mongo-ut1-p123--authenticationDatabasetest1 切换数据库,执行命令查看效果 修改用户:可以修改pwd、roles属性 db.updateUser('t1',{pwd:'456'}) 复制(副本集) 1.什么是复制 ①复制提供了数据的冗余备份,并在多个服务器上存储数据副本,提高了数据的可用性,并可以保证数据的安全性 ②复制还允许从硬件故障和服务中断中恢复数据 2.为什么要复制 ①数据备份 ②数据灾难恢复 ③读写分离 ④高(24* 7)数据可用性 ⑤无宕机维护 ⑥副本集对应用程序是透明 3.复制的工作原理 ①复制至少需要两个节点A、B... ②A是主节点,负责处理客户端请求 ③其余的都是从节点,负责复制主节点上的数据 ④节点常见的搭配方式为:一主一从、一主多从 ⑤主节点记录在其上的所有操作,从节点定期轮询主节点获取这些操作,然后对自己的数据副本执行这些操作,从而保证从节点的数据与主节点一致 ⑥主节点与从节点进行数据交互保障数据的一致性 4.复制的特点 ①N 个节点的集群 ②任何节点可作为主节点 ③所有写入操作都在主节点上 ④自动故障转移 ⑤自动恢复 5.设置复制节点 接下来的操作需要打开多个终端窗口,而且可能会连接多台ubuntu主机,会显得有些乱,建议在xshell中实现 step1:创建数据库目录t1、t2 在Desktop目录下演示,其它目录也可以,注意权限即可 mkdirt1mkdirt2 step2:使用如下格式启动mongod,注意replSet的名称是一致的 mongod--bind_ip192.168.196.128--port27017 --dbpath~/Desktop/t1--replSet rs0mongod--bind_ip192.168.196.128--port27018 --dbpath~/Desktop/t2--replSetrs0 step3:连接主服务器,此处设置192.168.196.128:27017为主服务器 mongo--host192.168.196.128--port27017 step4:初始化 rs.initiate() step5:查看当前状态 rs.status() step6:添加复本集 rs.add('192.168.196.128:27018') step7:连接第二个mongo服务 mongo--host192.168.196.128--port27018 step8:向主服务器中插入数据 usetest1for(i=0;i<10;i++){ db.t1.insert({_id:i}) } db.t1.find() step9:在从服务器中插查询 说明:如果在从服务器上进行读操作,需要设置rs.slaveOk() rs.slaveOk()db.t1.find() 其它说明 删除从节点 rs.remove('192.168.196.128:27018') 关闭主服务器后,再重新启动,会发现原来的从服务器变为了主服务器,新启动的服务器(原来的从服务器)变为了从服务器 备份和恢复 1.备份 语法: mongodump-hdbhost-ddbname-odbdirectory -h:服务器地址,也可以指定端口号 -d:需要备份的数据库名称 -o:备份的数据存放位置,此目录中存放着备份出来的数据 例1: sudomkdirtest1bak sudomongodump-h192.168.196.128:27017-dtest1-o~/Desktop/test1bak 2.恢复 语法: mongorestore-hdbhost-ddbname--dirdbdirectory -h:服务器地址 -d:需要恢复的数据库实例 --dir:备份数据所在位置 例2: mongorestore-h192.168.196.128:27017-dtest2--dir~/Desktop/test1bak/test1 与python交互 1.点击查看官方文档:http://api.mongodb.org/python/current/tutorial.html 2.安装python包 进入虚拟环境 sudopipinstallpymongo 或源码安装 pythonsetup.py 引入包pymongo importpymongo 连接,创建客户端 client=pymongo.MongoClient("localhost",27017) 获得数据库test1 db=client.test1 获得集合stu stu=db.stu 添加文档 s1={name:'gj',age:18} s1_id=stu.insert_one(s1).inserted_id 查找一个文档 s2=stu.find_one() 查找多个文档1 forcurinstu.find(): printcur 查找多个文档2 cur=stu.find()cur.next()cur.next()cur.next() 获取文档个数 printstu.count()

优秀的个人博客,低调大师

MongoDB 使用入门 (全)

MongoDB简介 1.MongoDB ①MongoDB 是一个基于分布式 文件存储的NoSQL数据库 ②由C++语言编写,运行稳定,性能高 ③旨在为 WEB 应用提供可扩展的高性能数据存储解决方案 ④官方网址:https://www.mongodb.com/ 2.MongoDB特点 ①MongoDB可以轻松地布置两个活跃集群,但关系型不容易在两台服务器上同时运行单个数据库 ②MongoDB天然缺少对事物的支持 ③MongoDB并不提供主/主复制,但它支持分片 3.Bson和Json ①Bosn版本是Json的二进制格式,但并不意味着Bson占用的空间就比Json小的多 ②继续使用Bson的原因是因为MongoDB在设计上就是要求快速,而不是节省空间,如果处理数据的速度更快,存储文档时的一点开销是完全可以接受的 ③Bson更易于浏览(即遍历),遍历索引页非常快,第二点是很容易将Bson数据快速转化为编程语言的原生数据格式 4.名词 SQL术语/概念 MongoDB术语/概念 解释/说明 database database 数据库 table collection 数据库表/集合 row document 数据记录行/文档 column field 数据字段/域 index index 索引 tablejoins 表连接,MongoDB不支持 primarykey primarykey 主键,MongoDB自动将_id字段设置为主键 5.MongoDB三要素:数据库,集合,文档 ①数据库:是一个集合的物理容器,一个数据库中可以包含多个文档,一个服务器通常有多个数据库 ②集合:类似于关系数据库中的表,储存多个文档,结构不固定,如可以存储如下文档在一个集合中 {'name':'guojing','gender':'男'} {'name':'huangrong','age':18} {'book':'shuihuzhuan','heros':'108'} ③文档:就是一个对象,由键值对组成,是Json的扩展Bson格式 {'name':'guojing','gender':'男'} MongoDB安装与管理 1.安装 ①下载MongoDB的版本注意,两点注意 根据规则:偶数为稳定版,如1.6X,奇数为开发版,如1.7X 32bit的MongoDB最大只能存放2G的数据,64bit就没有限制 ②到官网,选择合适的版本下载 ③解压 tar-zxvfmongodb-linux-x86_64-ubuntu1604-3.4.0.tgz ④移动到/usr/local/目录下 sudomv-rmongodb-linux-x86_64-ubuntu1604-3.4.0//usr/local/mongodb ⑤将可执行文件添加到PATH路径中 exportPATH=/usr/local/mongodb/bin:$PATH 2.管理 ①配置文件在/etc/mongod.conf,默认端口27017 ②启动 sudoservicemongodstart ③停止 sudoservicemongodstop ④使用终端连接:mongo,这个shell就是mongodb的客户端,同时也是一个js的编译器 ⑤ GUI:robomongo,解压后在bin目录下找到运行程序 数据库操作 1.数据库切换 ①查看当前数据库名称:db ②查看所有数据库名称:show dbs,(列出所有在物理上存在的数据库) ③切换数据库:use 数据库名称,(如果数据库不存在,则指向数据库,但不创建,直到插入数据或创建集合时数据库才被创建) ④默认的数据库为test,如果没有创建新的数据库,集合将存放在test数据库中 2.数据库删除 删除当前指向的数据库,如果数据库不存在,则什么也不做 db.dropDatabase() 集合操作 1.集合创建 语法: db.createCollection(name,option) ①name是要创建集合的名称 ②options是一个文档,用于指定集合的配置 ③选项参数是可选的,所以只需要到指定的集合名称 例1:不限制集合的大小 db.createCollection(‘stu’) 例2:限制集合大小 db.createCollection(‘sub’,{capped:true,size:10}) 参数capped:默认值为false表示不设置上限,值为true表示设置上限 参数size:当capped值为true时,需要指定此参数,表示上限大小,当文档设置上限时,会将之前的数据覆盖,单位为字节 2.查看当前数据库的集合 showcollections 3.删除集合 db.集合名称.drop() 数据类型 1. MongoDB中常用的几种数据类型: ①Object ID:文档ID ②String:字符串,最常用,必须是有效的UTF-8 ③Boolean:存储一个布尔值,true或false ④Integer:整数可以是32位或64位,这取决于服务器 ⑤Double:存储浮点值 ⑥Arrays:数组或列表,多个值存储到一个键 ⑦Object:用于嵌入式的文档,即一个值为一个文档 ⑧Null:存储Null值 ⑨Timestamp:时间戳 ⑩Date:存储当前日期或时间的UNIX时间格式 2. object id ①每个文档都有一个属性,为_id,保证每个文档的唯一性 ②可以自己去设置_id插入文档 ③如果没有提供,那么MongoDB为每个文档提供了一个独特的_id,类型为objectID ④objectID是一个12字节的十六进制数 前4个字节为当前时间戳 接下来3个字节的机器ID 接下来的2个字节中MongoDB的服务进程id 最后3个字节是简单的增量值 数据操作 1.插入 插入文档时,如果不指定_id参数,MongoDB会为文档分配一个唯一的ObjectId db.集合名称.insert(document) 2.简单查询 db.集合名称.find() 3.更新 db.集合名称.update(<query>,<update>,multi:<boolean>}) ①参数query:查询条件,类似sql语句update中where部分 ②参数update:更新操作符,类似sql语句update中set部分 ③参数multi:可选,默认是false,表示只更新找到的第一条记录,值为true表示把满足条件的文档全部更新 例3:全文档更新 db.stu.update( {name:'hr'},{name:'mnc'} ) 例4:指定属性更新,通过操作符$set db.stu.insert({name:'hr',gender:0}) db.stu.update({name:'hr'},{$set:{name:'hys'}}) 例5:修改多条匹配到的数据 db.stu.update({},{$set:{gender:0}},{multi:true}) 4.保存 如果文档的_id已经存在则修改,不存在则添加 db.集合名称.save(document) 5.删除 db.集合名称.remove(<query>,{justOne:<boolean>}) ①参数query:可选,删除的文档的条件 ②参数justOne:可选,如果设为true或1,则只删除一条,默认false,表示删除多条 例6:只删除匹配到的第一条 db.stu.remove({gender:0},{justOne:true}) 例7:全部删除 db.stu.remove({}) 数据查询 1.基本查询 ①方法find():查询 db.集合名称.find({条件文档}) ②方法findOne():查询,只返回第一个 db.集合名称.findOne({条件文档}) ③方法pretty():将结果格式化 db.集合名称.find({条件文档}).pretty() 2.比较运算符 ①等于,默认是等于判断,没有运算符 ②小于$lt ③小于或等于$lte ④大于$gt ⑤大于或等于$gte ⑥不等于$ne 例8:查询年龄大于或等于18的学生 db.stu.find({age:{$gte:18}}) 3.逻辑运算符 ①查询时可以有多个条件,多个条件之间需要通过逻辑运算符连接 ②逻辑与:默认是逻辑与的关系 例9:查询年龄大于或等于18,并且性别为1的学生 db.stu.find({age:{$gte:18},gender:1}) 逻辑或:使用$or 例10:查询年龄大于18,或性别为0的学生 db.stu.find({$or:[{age:{$gt:18}},{gender:1}]}) and和or一起使用 例11:查询年龄大于18或性别为0的学生,并且学生的姓名为gj db.stu.find({$or:[{age:{$gte:18}},{gender:1}],name:'gj'}) 4.范围运算符 使用"$in","$nin" 判断是否在某个范围内 例12:查询年龄为18、28的学生 db.stu.find({age:{$in:[18,28]}}) 5.支持正则表达式 使用//或$regex编写正则表达式 例13:查询姓黄的学生 db.stu.find({name:/^黄/})db.stu.find({name:{$regex:'^黄'}}) 6.自定义查询 使用$where后面写一个函数,返回满足条件的数据 例14:查询年龄大于30的学生 db.stu.find({$where:function(){returnthis.age>20}}) 7. Limit(方法limit():用于读取指定数量的文档) db.集合名称.find().limit(NUMBER) ①参数NUMBER表示要获取文档的条数 ②如果没有指定参数则显示集合中的所有文档 例15:查询2条学生信息 db.stu.find().limit(2) 8. skip(方法skip():用于跳过指定数量的文档) db.集合名称.find().skip(NUMBER) 参数NUMBER表示跳过的记录条数,默认值为0 例16:查询从第3条开始的学生信息 db.stu.find().skip(2) 9.Limit与Skip一起使用 方法limit()和skip()可以一起使用,不分先后顺序 查询第5至8条数据(跳取) db.stu.find().limit(4).skip(5)db.stu.find().skip(5).limit(4) 10. 投影 在查询到的返回结果中,只选择必要的字段,而不是选择一个文档的整个字段 语法:参数为字段与值,值为1表示显示,值为0不显示 db.集合名称.find({},{字段名称:1,...}) 对于需要显示的字段,设置为1即可,不设置即为不显示 特殊:对于_id列默认是显示的,如果不显示需要明确设置为0 db.stu.find({},{_id:0,name:1,gender:1}) 11.排序 方法sort(),用于对结果集进行排序 语法:db.集合名称.find().sort({字段:1,...}) ①参数1为升序排列 ②参数-1为降序排列 例18:根据性别降序,再根据年龄升序 db.stu.find().sort({gender:-1,age:1}) 12.统计个数 方法count()用于统计结果集中文档条数 语法: db.集合名称.find({条件}).count() 也可以与为 db.集合名称.count({条件}) 例19:统计男生人数 db.stu.find({gender:1}).count() 例20:统计年龄大于20的男生人数 db.stu.count({age:{$gt:20},gender:1}) 13.消除重复 方法distinct()对数据进行去重 语法: db.集合名称.distinct('去重字段',{条件}) 例21:查找年龄大于18的性别(去重) db.stu.distinct('gender',{age:{$gt:18}}) 聚合 aggregate 1.聚合(aggregate) 主要用于计算数据,类似sql中的sum()、avg() 语法: db.集合名称.aggregate([{管道:{表达式}}]) 2.管道 管道在Unix和Linux中一般用于将当前命令的输出结果作为下一个命令的输入 psajx|grepmongo 在mongodb中,管道具有同样的作用,文档处理完毕后,通过管道进行下一次处理 常用管道: $group:将集合中的文档分组,可用于统计结果 $match:过滤数据,只输出符合条件的文档 $project:修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 $sort:将输入文档排序后输出 $limit:限制聚合管道返回的文档数 $skip:跳过指定数量的文档,并返回余下的文档 $unwind:将数组类型的字段进行拆分 表达式 处理输入文档并输出 语法:表达式:'$列名' $sum:计算总和,$sum:1同count表示计数 $avg:计算平均值 $min:获取最小值 $max:获取最大值 $push:在结果文档中插入值到一个数组中 $first:根据资源文档的排序获取第一个文档数据 $last:根据资源文档的排序获取最后一个文档数据 3.$group 将集合中的文档分组,可用于统计结果 _id表示分组的依据,使用某个字段的格式为'$字段' 例22:统计男生、女生的总人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}}]) Group by null 将集合中所有文档分为一组 例23:求学生总人数、平均年龄 db.stu.aggregate([{$group:{_id:null,counter:{$sum:1},avgAge:{$avg:'$age'}}}]) 透视数据 例24:统计学生性别及学生姓名 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$name'}}}]) 使用$$ROOT可以将文档内容加入到结果集的数组中,代码如下 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$$ROOT'}}}]) 4.$match 用于过滤数据,只输出符合条件的文档 使用MongoDB的标准查询操作 例25:查询年龄大于20的学生 db.stu.aggregate([{$match:{age:{$gt:20}}}]) 例26:查询年龄大于20的男生、女生人数 db.stu.aggregate([{$match:{age:{$gt:20}}},{$group:{_id:'$gender',counter:{$sum:1}}}]) 5.$project 修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 例27:查询学生的姓名、年龄 db.stu.aggregate([{$project:{_id:0,name:1,age:1}}]) 例28:查询男生、女生人数,输出人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$project:{_id:0,counter:1}}]) 6. $sort 将输入文档排序后输出 例29:查询学生信息,按年龄升序 b.stu.aggregate([{$sort:{age:1}}]) 例30:查询男生、女生人数,按人数降序 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$sort:{counter:-1}}]) 7. $limit,$skip 限制聚合管道返回的文档数 例31:查询2条学生信息 db.stu.aggregate([{$limit:2}]) $skip 跳过指定数量的文档,并返回余下的文档 例32:查询从第3条开始的学生信息 db.stu.aggregate([{$skip:2}]) 例33:统计男生、女生人数,按人数升序,取第二条数据 db.stu.aggregate( [{$group:{_id:'$gender',counter:{$sum:1}}}, {$sort:{counter:1}}, {$skip:1}, {$limit:1}]) 注意顺序:先写skip,再写limit 8. $unwind 将文档中的某一个数组类型字段拆分成多条,每条包含数组中的一个值 语法1:对某字段值进行拆分 db.集合名称.aggregate([{$unwind:'$字段名称'}]) 构造数据 db.t2.insert({_id:1,item:'t-shirt',size:['S','M','L']}) 查询 db.t2.aggregate([{$unwind:'$size'}]) 语法2:对某字段值进行拆分 处理空数组、非数组、无字段、null情况 db.inventory.aggregate([{$unwind:{path:'$字段名称',preserveNullAndEmptyArrays:<boolean>#防止数据丢失}}]) 构造数据 db.t3.insert( [{"_id":1,"item":"a","size":["S","M","L"]}, {"_id":2,"item":"b","size":[]}, {"_id":3,"item":"c","size":"M"}, {"_id":4,"item":"d"}, {"_id":5,"item":"e","size":null}] ) 使用语法1查询 db.t3.aggregate([{$unwind:'$size'}]) 查看查询结果,发现对于空数组、无字段、null的文档,都被丢弃了 问:如何能不丢弃呢? 答:使用语法2查询 db.t3.aggregate([{$unwind:{path:'$sizes',preserveNullAndEmptyArrays:true}}]) 安全 1.超级管理员 为了更安全的访问mongodb,需要访问者提供用户名和密码,于是需要在mongodb中创建用户 采用了角色-用户-数据库的安全管理方式 常用系统角色如下: root:只在admin数据库中可用,超级账号,超级权限 Read:允许用户读取指定数据库 readWrite:允许用户读写指定数据库 创建超级管理用户 useadmindb.createUser({ user:'admin', pwd:'123', roles:[{role:'root',db:'admin'}] }) 2.启用安全认证 修改配置文件 sudovi/etc/mongod.conf 启用身份验证 注意:keys and values之间一定要加空格, 否则解析会报错 security:authorization:enabled 重启服务 sudoservicemongodstop sudoservicemongodstart 终端连接 mongo-u'admin'-p'123'--authenticationDatabase'admin' 3.普通用户管理 使用超级管理员登录,然后进入用户管理操作 查看当前数据库的用户 usetest1showusers 创建普通用户 db.createUser({ user:'t1',pwd:'123',roles:[{role:'readWrite',db:'test1'}] }) 终端连接 mongo-ut1-p123--authenticationDatabasetest1 切换数据库,执行命令查看效果 修改用户:可以修改pwd、roles属性 db.updateUser('t1',{pwd:'456'}) 复制(副本集) 1.什么是复制 ①复制提供了数据的冗余备份,并在多个服务器上存储数据副本,提高了数据的可用性,并可以保证数据的安全性 ②复制还允许从硬件故障和服务中断中恢复数据 2.为什么要复制 ①数据备份 ②数据灾难恢复 ③读写分离 ④高(24* 7)数据可用性 ⑤无宕机维护 ⑥副本集对应用程序是透明 3.复制的工作原理 ①复制至少需要两个节点A、B... ②A是主节点,负责处理客户端请求 ③其余的都是从节点,负责复制主节点上的数据 ④节点常见的搭配方式为:一主一从、一主多从 ⑤主节点记录在其上的所有操作,从节点定期轮询主节点获取这些操作,然后对自己的数据副本执行这些操作,从而保证从节点的数据与主节点一致 ⑥主节点与从节点进行数据交互保障数据的一致性 4.复制的特点 ①N 个节点的集群 ②任何节点可作为主节点 ③所有写入操作都在主节点上 ④自动故障转移 ⑤自动恢复 5.设置复制节点 接下来的操作需要打开多个终端窗口,而且可能会连接多台ubuntu主机,会显得有些乱,建议在xshell中实现 step1:创建数据库目录t1、t2 在Desktop目录下演示,其它目录也可以,注意权限即可 mkdirt1mkdirt2 step2:使用如下格式启动mongod,注意replSet的名称是一致的 mongod--bind_ip192.168.196.128--port27017 --dbpath~/Desktop/t1--replSet rs0mongod--bind_ip192.168.196.128--port27018 --dbpath~/Desktop/t2--replSetrs0 step3:连接主服务器,此处设置192.168.196.128:27017为主服务器 mongo--host192.168.196.128--port27017 step4:初始化 rs.initiate() step5:查看当前状态 rs.status() step6:添加复本集 rs.add('192.168.196.128:27018') step7:连接第二个mongo服务 mongo--host192.168.196.128--port27018 step8:向主服务器中插入数据 usetest1for(i=0;i<10;i++){ db.t1.insert({_id:i}) } db.t1.find() step9:在从服务器中插查询 说明:如果在从服务器上进行读操作,需要设置rs.slaveOk() rs.slaveOk()db.t1.find() 其它说明 删除从节点 rs.remove('192.168.196.128:27018') 关闭主服务器后,再重新启动,会发现原来的从服务器变为了主服务器,新启动的服务器(原来的从服务器)变为了从服务器 备份和恢复 1.备份 语法: mongodump-hdbhost-ddbname-odbdirectory -h:服务器地址,也可以指定端口号 -d:需要备份的数据库名称 -o:备份的数据存放位置,此目录中存放着备份出来的数据 例1: sudomkdirtest1bak sudomongodump-h192.168.196.128:27017-dtest1-o~/Desktop/test1bak 2.恢复 语法: mongorestore-hdbhost-ddbname--dirdbdirectory -h:服务器地址 -d:需要恢复的数据库实例 --dir:备份数据所在位置 例2: mongorestore-h192.168.196.128:27017-dtest2--dir~/Desktop/test1bak/test1 与python交互 1.点击查看官方文档:http://api.mongodb.org/python/current/tutorial.html 2.安装python包 进入虚拟环境 sudopipinstallpymongo 或源码安装 pythonsetup.py 引入包pymongo importpymongo 连接,创建客户端 client=pymongo.MongoClient("localhost",27017) 获得数据库test1 db=client.test1 获得集合stu stu=db.stu 添加文档 s1={name:'gj',age:18} s1_id=stu.insert_one(s1).inserted_id 查找一个文档 s2=stu.find_one() 查找多个文档1 forcurinstu.find(): printcur 查找多个文档2 cur=stu.find()cur.next()cur.next()cur.next() 获取文档个数 printstu.count()

优秀的个人博客,低调大师

Spring 项目全介绍

Spring Framework Spring Security Spring Web Flow Spring Web Services Spring Dynamic Modules Spring Integration Spring Batch Spring Batch Admin Spring.NET Spring AMQP Spring AMQP.NET Spring GemFire Spring GemFire for .NET Spring LDAP Spring Social Spring Android Spring IDE Spring BlazeDS Integration SpringSource Bundlor Spring Roo Spring Python SpringSource OSGi Test Stubs Spring Security Kerberos Extension SpringSource dm Server SpringSource dm Kernel SpringSource dm Server Samples Spring Data Spring Data Commons Spring Data JDBC Spring Data JPA Spring Data Redis Spring Mobile Spring Data Mongo Spring Data Neo4j Spring Social Facebook Spring Social LinkedIn Spring Social Twitter Spring.NET CodeConfig Spring.NET REST Client Spring.NET Visual Studio 2010 Extension 本文转自 leizhimin 51CTO博客,原文链接:http://blog.51cto.com/lavasoft/753163,如需转载请自行联系原作者

优秀的个人博客,低调大师

Xamarin 技术全解析

Xamarin 是一套基于C#语言的跨平台移动应用开发工具,今年2月份微软宣布收购Xamarin,而后在4月份进行的Build大会上微软宣布将会在各个版本的Visual Studio中免费提供Xamarin,并且宣布Xamarin SDK开源。 本文主要阐述Xamarin是什么,它能做什么以及它是如何跨平台的。 1. 什么是Xamarin Xamarin 是一个跨平台的移动开发工具,由 Mono 发展而来。开发人员可以使用 C# 为iOS,Android, Mac以及Windows Phone开发原生应用。 Xamarin 的跨平台开发思路是:使用 C# 来完成所有平台共用的,和平台无关的 app 逻辑部分;由于各个平台的 UI 和交互不同,再使用由 Xamarin 封装好的 C# API 来访问和操控 native 的控件,分别进行不同平台的 UI 开发。 如下图: 另外Xamarin还提供了Xamarin.Forms UI工具包,Xamarin.Forms可以帮助开发人员快速的构建跨平台的UI,通过一次编码,生成多个平台的原生UI界面,稍后本文会讲述Xamarin.Forms的使用方法以及实现原理。 2. Xamarin能做什么 Xamarin主要由Xamarin.iOS,Xamarin.Android以及Xamarin.Forms组成,主要功能也有着三部分组成: 2.1 使用Xamarin.iOS来构建iOS原生应用 下面会使用Mac OS X上的Xamarin Studio来演示如何构建iOS应用: - 打开Xamarin Studio - 新建一个项目,选择iOS - App - Single View App - 点击下一步,输入App 名称, 例如:FirstXamariniOS,一路点击下一步,工程创建完成。 下面是生成的iOS工程结构截图: 如果有Xcode使用经验的话会发现,这个Xamarin iOS工程的项目结构与Xcode的结构很类似,都包含了AppDelegate类,默认的ViewController以及Main StoryBoard文件,基本的类名称都是一致的。 打开Main.storyboard 文件,可以从Toolbox上拖拽一些原生控件到View Controller上,与Xcode中使用方式一致,但是有一些功能没有Xcode 强大,比如设置View的Auto layout等等,如下图: 运行上面的工程,就可以在模拟器中查看效果了。 从上面来看来说使用Xamarin进行iOS编程需要有一定的iOS App开发知识,需要熟悉iOS UI框架(Cocoa Touch)等等,即便使用Xamarin开发应用,也绕不过原生底层的这些东西。 2.2 使用Xamarin.Android来构建Android原生应用 下面会使用Mac OS X上的Xamarin Studio来演示如何构建iOS应用: - 打开Xamarin Studio - 新建一个项目,选择Android - App - Android App - 点击下一步,输入App 名称, 例如:FirstXamarinAndroid,一路点击下一步,工程创建完成。 下面是生成的Android工程结构截图: 如果有Eclipse进行Android编程经验的话会发现,这个Xamarin Android工程的项目结构与Eclipse的结构很类似,都包含了默认的MainActivity以及布局文件,基本的类名称都是一致的。 打开Main.axml文件,可以从Toolbox上拖拽一些原生控件到View Controller上,与Eclipse的体验类似,也可以通过编辑XML的方式更改界面。 同样从上面来看来说使用Xamarin进行Android编程需要有一定的Android App开发知识,需要熟悉Android UI框架等等,原生底层的东西还是需要熟悉的。 2.3 使用Xamarin.Forms来构建跨平台的应用 Xamarin.Forms 是一个创建跨平台用户界面的库,通过Xamarin.Forms 可以一次编码生成基于各个移动平台(iOS, Android, Windows Phone)的应用界面。 Xamarin.Forms提供了更高层次的一层UI组件抽象,这些组件在进行最终呈现的时候,会以原生控件的方式表现出来,也就是说每一个Xmarin.Forms的控件最终会有多个平台的原生呈现逻辑,如下图中,Xamarin.Forms的Entry控件,对应的原生呈现为: 使用Xamarin.Forms构建跨平台应用的一个缺陷就是只能使用Xamarin.Forms包中的控件,会有一些限制。 如果先了解更多关于如何使用Xamarin.Forms构建跨平台应用,请参见文章:Xamarin.Forms入门-使用 Xamarin.Forms 来创建跨平台的用户界面。 3. Xamarin实现原理 3.1 Xamarin.Android 实现原理 在讲述Xamarin.Android架构之前,需要先了解一些Android应用程序的背景知识: - Android应用程序试运行在Dalvik虚拟机中的,每一个应用程序对应一个单独的虚拟机实例,其代码在虚拟机的解释下得以执行。 -Dalvik主要是完成对象生命周期管理,堆栈管理,线程管理,安全和异常管理,以及垃圾回收等等重要功能。 -不同于Java虚拟机运行java字节码,Dalvik虚拟机运行的是其专有的文件格式 Xamarin.Android架构图(ART 是Android 虚拟机Dalvik): Android Callable Wrappers(ACW) 使用C#开发的Android应用程序在运行的时候,C#代码是在Mono虚拟机中执行的,而Mono虚拟机是寄宿在Dalvik虚拟机中运行的,所有的C#代码都通过ACW的方式被调用。 由于需要打包Mono环境,使用C#开发的Android应用的APK文件会比原生开发的大,执行效率也会差一些。 Managed Callable Wrapper(MCW) 如果需要在C#中调用一些系统的功能或者Java实现的类库,该如何调用那? 答案就是MCW,MCW就是一个JNI桥梁,可以使用托管代码调用Android的代码。MCW将整个Android.* 以及相关的命名空间通过jar绑定的方式暴露出来,是的C#可以调用。 3.2 Xamarin.iOS 实现原理 对于开发者来说,Xamarin.IOS相对于Xamarin.Android就要简单很多了,我们用C#开发的iOS应用程序在被编译成IL代码之后,然后转交给Apple complier直接编译成iOS的本地机器码,也就是说C#写的iOS应用程序和Objective-C 写的是一样的。 透过 Ahead-of-Time (AOT) 编译程序,直接将Xamarin.iOS程序编译为ARM的执行档。编译封装完成的应用程序被直接编译为原生的二进制执行文件。 3.3 Xamarin.Forms实现原理 在Xamarin Studio中构建Xamarin.Forms跨平台的应用的时候,会生成Android以及iOS单独的项目工程,两者共享业务逻辑以及一些UI界面,在打包生成App的时候,是分开进行的,两者互不影响。每个平台的实现原理与上面讲的是一样的。 本文转自 powertoolsteam 51CTO博客,原文链接:http://blog.51cto.com/powertoolsteam/1782877,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册