首页 文章 精选 留言 我的

精选列表

搜索[个人知识库],共10000篇文章
优秀的个人博客,低调大师

【个人学习JAVA---学后的梳理】 一、从外,观识JAVA

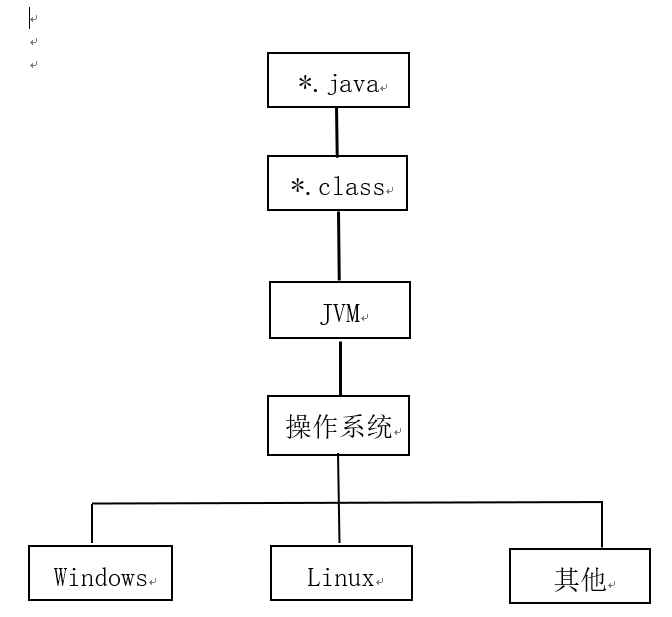
认识Java语言 横看成岭侧成峰,远近高低各不同... 1. Java的历史 Java来自于Sun公司的一个Green项目,它期望能与家用电器进行信息交流,一开始是准备采用C++,不过C++太复杂,安全性差,于是最后基于C++开发了一种新语言Oak(Java的前身),该语言是一种用于网络的精巧而安全的语言。 2. Java的现状 Java是Sun公司推出的新一代面向对象程序设计语言,特别适用于Internet应用程序开发。它具有平台无关的特性(Java开发环境有JDK与JRE)。 2.1:Java的技术分支 Java主要有3类技术分支:(它们前身的前缀名为J2 ,05年后均改为JAVA ) JAVA SE:Java2Platform,StandardEdition;(标准版) JAVA EE: Java2Platform,EnterpriseEdition;(企业版) JAVA ME: Java2Platform,MicroEdition; 以上三个分支,不管如何划分,都是以JAVA SE为核心,那么掌握JAVA SE最为重要。 3. Java的特点 JAVA是一种简单的、面向对象的、分布式的、解释性的、可移植的、多线程的、动态的程序设计语言。 3.1:Java语言的关键特性说明: 简洁有效 Java语言是一种相当简洁的程序设计语言。它省略了C++语言中所有难以理解、容易混淆的特性,例如头文件、指针、结构、单元、运算符重载、虚拟基础类等。所以它更加严谨、简洁。 可移植同操作系统平台无关的特性,使得Java应用程序可以在配备了Java解释器和运行环境的任何计算机操作系统上运行,这就是Java应用软件便于移植的良好基础。而且,Java的基本数据类型设计不依赖具体实现,它通过定义独立于平台的基本数据类型及其运算,使得Java数据得以在任何的硬件平台上保持一致。 面向对象 Java语言的设计完全是面向对象的,不支持类似C语言那样的面向过程的程序设计技术。Java支持静态和动态风格的代码继承和重用。 解释型Java语言是一种解释性语言,相对于C/C++语言来说,Java程序的效率低,执行速度慢。 适合分布式计算Java语言具有强大的、易于使用的联网能力,非常适合开发分布式计算的程序。Java应用程序能像访问本地文件系统那样,通过URL访问远程对象。它十分使用于公共网关接口(GGI)脚本的开发,另外还能使用Java小应用程序(Applet)、Java服务器页面(Java Server Page,JSP)和Servlet等手段来构建更丰富的网页。 4. Java虚拟机(JVM) 虚拟机,即在机器和编译程序间加入了一层抽象的虚拟的机器。它能够在任何平台上都提供给编译程序一个共同的接口。编译程序只需要面向虚拟机,编译生成虚拟机可以理解的代码,然后由解释器将虚拟机代码转换为特定系统的机器码执行。 那么在Java中,虚拟机能理解的代码叫做字节码(Byte Code)。 每一种平台的解释器是不同,但实现的虚拟机相同。 Java源程序(代码存在.java文件)经过编译器编译后变成了字节码(代码存在.claa文件),字节码由虚拟机解释执行,虚拟机将每一条要执行的字节码送给解释器,解释器将其翻译成特定机器上的机器码,然后在特定的机器上执行。 Java虚拟机也具有一个指令集,并使用不同的存储区域。它负责执行指令,还要治理数据、内存和寄存器。 图1-Java源文件编译运行过程图 结束

优秀的个人博客,低调大师

【个人学习JAVA---学后的梳理】五、JAVA的核心所在

Java的核心 问渠哪得清如许,为有源头活水来... 语言的特性就是突出提示了它的核心关键所在。 众所周知,Java语言是面向对象的程序设计语言。那么,对象是什么。。。 1. 面向对象程序设计 对象,即某一类事物的一个具体的实体。有着完全相同特征的一群对象即一类事物。所以面向对象的程序设计是:程序 = 对象 + 消息。 对象的特征分为静态特征与动态特征。静态特征:指对象的外观、性质、属性等。动态特征:指其具有的功能、行为动作等。所以面向对象程序设计语言将两者分别抽象为了:属性与方法。所以在面向对象程序语言中,一个对象是由一组属性和一组方法(其对属性进行操作)所构成。-------------------------------------------------------------------------------------------------------------------------------------------类:是具有相同属性和方法的一组对象。类就是一种抽象的数据类型,对象是具体的,所以由抽象的类实例化而来,就是调用类的构造方法后,获得了一个对象。 1.1: 面向对象的语言特性 封装性:尽可能对外界公布一个有限的界面,将细节隐藏,与其他对象的相互作用只通过该界面进行。 继承性:类之间的继承、接口间的继承。继承的特征有: 继承关系是传递的。 它简化了事物的描述,能清晰体现相关类间的层次结构关系。 提供软件复用功能。 通过增强一致性来减少模块间的接口和界面,大大增加程序的易维护性。 只能多重继承(传递)。一个类只能一次继承一个父类。 多态性:Java语言存在多态的形式有,方法重载与成员方法覆写,以及对象间的向上向下转型。 方法的重载:针对于一个类中,相同名字的方法,返回类型可不同,只要重载的方法的参数列表不同,就是实现了该方法的重载。 成员方法的覆写:是针对父类与其子类。子类要想覆写父类的方法,其只能修改方法内部的具体实现,其余(如方法名、返回类型、参数列表)均不能更改。 结束 2019年8月6日 18:35:55

优秀的个人博客,低调大师

【个人学习JAVA---学后的梳理】二、关于JAVA程序的语法

认识Java程序 1. Java的一些基本规则和用法 程序的框架自然需要遵守该语言的特定规则,规则包括对于一条语句的,代码块的,变量的命名等。 符号的使用以西式字符为准,尽量少使用中式输入法输入符号。 1.1:大括号、段和主体 类的主体,以左大括号'{'为开始标记、'}'右大括号为结束标记;其中每个命令语句的结束,必须以分号';'做结尾;而某个命令的语句需要数行才能完成时,则被'{}'所包括起来,此表示一个代码块(代码块分种类,括起来的意义各不相同)。 1.2:标识符 标识符就是包、类、方法、参数、和变量的名字。它可以由任意顺序的大小写字母、数字、下划线和美元符号($,不建议开发者使用此来命名)等组成。注意:标识符是不能以数字作开头,不能是Java中的保留关键字。如: 0name、class。 1.3:Java的注释 注释,是程序中添加的非编译运行信息,开发者可以此解释程序某一处的作用、意义,提高程序的可读性。 注释分为3种: 注释类型 格式 例子 说明 单行注释 //注释内容 int x;//声明一个整数 适用简短信息的一行提示 多行注释 /* 注释内容 */ /* 第一行;第二行 */ 需要描述较多语句 文档注释 /** 注释内容 */ 此注释的内容将会被解释城程序的正式文档 1.4:变量 变量命名就是标识符的命名,对于各种类型数据、对象、类、方法的命名通俗规则,这些类型的变量命名会有不同。 1.5:Java的数据类型 Java提供多种数据类型,Java的数据类型除了可以是基本数据类型之外,还有引用类型。数据类型的总结在以后有专门归纳... 结束

优秀的个人博客,低调大师

首个人工智能专业委员会成立,产业发展再添动力

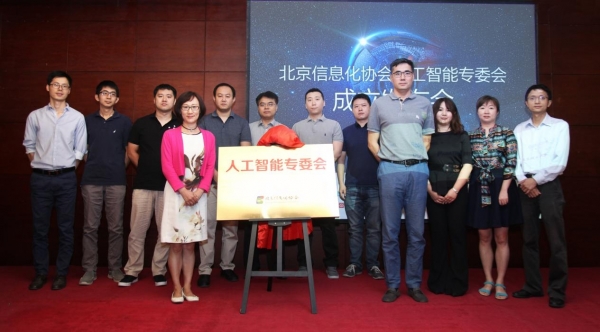
6月7日,北京信息化协会人工智能专业委员会(以下简称“专委会”)在北京举办成立大会。来自工业和信息化部、北京信息化协会、专委会理事会、专委会发起单位,以及人工智能企业的领导和嘉宾出席了本次大会。 作为首个聚合人工智能行业各方优势资源、由协会发起领导的专业组织,专委会将搭建人工智能全产业链上企业间交流合作的重要平台,并起到上传下达的重要作用,协助政府相关产业政策落地,推动人工智能产业标准的制定,力争在人工智能重塑全球化格局的过程中,为世界贡献中国智慧。 专委会快速协调推进人工智能的应用 人工智能如今已不仅仅是科技热词,不但获得了来自政府决策层的重视,国内的科技企业在人工智能技术上也屡获突破,成绩显著。这意味着,相关产业将进入创新发展的黄金阶段。在此基础上,业界亟需创建一个能够加快政府决策落地,搭建各方沟通合作的桥梁,同时建立产业标准,打造行业生态,推进技术和产业创新的平台。因此,专委会的成立恰逢其时。 工信部信息化和软件服务业司软件产业处调研员傅永宝在致辞中表示,人工智能产业化应用是一项长期、复杂的系统工程,需要各有关方面加强沟通、积极对接、增进合作、共同发展。鉴于此,我们认为成立北京信息化协会人工智能专委会十分必要,专委会的成立,将有利于系统谋划、快速协调推进北京市以及全国范围内人工智能的应用和发展。 北京信息化协会秘书长段红表示,专委会的成立,将为产学研用各界搭建一个良好的沟通交流平台,意义重大。希望专委会能为北京市人工智能产业的发展带来强劲的驱动力,在各位同仁的努力下,发挥群体效应,全方位地开展各项工作。 据介绍,专委会由北京信息化协会牵头,联合北京小米移动软件有限公司、北京猎豹移动科技有限公司、北京旷视科技有限公司、北京并行科技有限公司、北京云知声科技有限公司、北京猎户星空科技有限公司、北京数美时代科技有限公司、北京爱接力科技发展有限公司、北京金山云网络技术有限公司、北京首钢自动化信息技术有限公司、四川新网银行股份有限公司、北京邮电大学、北京理工大学等企业与高校共同发起成立。 搭建一座人工智能产业界的桥梁 专委会发起单位均是人工智能行业的知名企业和科研机构,业务涵盖产业的各个领域,将在人工智能产业上下游形成强烈的带动效应。专委会成员将致力于推动形成技术、应用多方协商管理的运作机制,还将结合云计算、大数据、物联网等领域的前沿技术,面向工业、交通、金融、教育、电信、医疗等关系到国计民生的重点领域,共同打造完善的行业解决方案,营造开放共享的产业生态环境,为各行各业提供优质的技术与产品服务,将人工智能技术更好地融入到社会和经济发展当中。 作为专委会发起单位,一直以来,金山云非常重视技术服务和平台价值,希望打造开放的人工智能生态。金山云将在以云计算为底层服务的智能时代,构建起在人工智能领域的核心竞争力,力争成为“AI+”时代的“水电煤供应商”。 与会嘉宾纷纷表示,随着我国人工智能产业继续迎风而上,产业规模不断壮大,在各方的大力支持和共同努力下,专委会将搭建起一座人工智能产业界的桥梁,相信专委会将为“网络强国”和“制造强国”目标的早日实现,贡献更多智慧和力量。 本文出处:畅享网 本文来自云栖社区合作伙伴畅享网,了解相关信息可以关注vsharing.com网站。

优秀的个人博客,低调大师

android 的多任务之道(个人渣水平,无责任翻译)(目前到Design considerations)

Android is fairly unique in the ways it allows multiple applications to run at the same time. android 使用十分独特的方式 允许多任务在同一时间运行. Developers coming from a different platform may find the way it operates surprising. 开发者在不同的平台中发现这种方式会出现意想不到的事情. Understanding its behavior is important for designing applications that will work well and integrate seamlessly with the rest of the Android platform. 了解这种行为在设计应用程序中十分重要,这样可以使程序运行的完美和无缝结合的保持在android平台中 This article covers the reasons for Android's multitasking design, its impact on how applications work, and how you can best take advantage of Android's unique features. 这篇文章展示的就是如何设计android程序的多任务,这紧紧的关系着应用程序是如何工作,和如何让你android程序拥有独特的高级特性. Design considerations:设计的约束 Mobile devices have technical limitations and user experience requirements not present in desktop or web systems. 移动设备在技术上有着限制和用户体验需求不同于当前的桌面电脑和网络系统. We did not want to require that users close applications when "done" with them. Such a usage pattern does not work well in a mobile environment, where usage tends to involve repeated brief contact with a wide variety of applications throughout the day. 我们不想要求用户自行关掉程序.这样的习惯模式在手机的环境中不是很好,贯穿于一天当中的应用程序习惯趋向于反复简短的调用 Mobile devices don't have the luxury of swap space, so have fairly hard limits on memory use. Robert Love hasa very good articlecovering the topic. 移动设备没有丰富的交换空间,所以十分有限制的使用内存.Robert有一篇非常好的文章介绍这个主题. Application switching on a mobile device is extremely critical; we target significantly less than 1 second to launch a new application. This is especially important when the user is switching between a few applications, such as switching to look at a new SMS message while watching a video, and then returning to that video. A noticeable wait in such situations will quickly make users hate you. 在移动设备中应用程序的切换是十分苛刻的,我们的目标是尽量少于1s运行一个新的程序.当用户在少量程序之间切换是尤其的重要,例如,当用户在看视频的时候切换到短信管理器查看新的短信,然后,再回到看视频当中.一个显著的等待情形,将会使用户很快就讨厌你 The available APIs must be sufficient for writing the built-in Google applications, as part of our "all applications are created equal" philosophy. This means background music playback, data syncing, GPS navigation, and application downloading must be implemented with the same APIs that are available to third party developers. 在构建的一个Google 应用程序现有的APIs必须充分的利用,作为我们”所有程序都是公平”哲学的一部分.这就意味着现有的一伙开发者在开发,后台播放音乐,数据同步,GPS导航,和应用程序的下载必须实现一样的APIs The first two requirements highlight an interesting conflict. 有一个有趣的冲突在第一个条件和第二个条件. We don't want users to worry about closing their apps, but rather make it appear that all of the applications are always running. 我们不想用户担忧如何关闭他们的程序,但是这样会出现所有程序都总是在运行当中. At the same time, mobile devices have hard limits on memory use, so that a system will degrade or even start failing very quickly as it needs more RAM than is available; a desktop computer, with swap, in contrast will simply start slowing down as it needs to page RAM to its swap space. 在同一时间,移动设备只有十分有限的内存在使用,导致系统将会减慢或者甚至使一个需要很多空闲RAM的程序无法启动, 与之相比较,在桌面电脑中,同样使用交换空间,程序仅仅减慢启动速度,需要用到的交换空间由页面缓存代替. These competing constraints were a key motivation for Android's design. 在android的程序设计中这些约束都是提升你程序性能的关键.PS:翻译果然不是一件容易的事情…水平太渣了…有错误欢迎指正…估计就翻这段了…能力不足呀… When does an application "stop"?:什么时候停止你的程序? Explicitly running in the background:明确的运行在后台 The value of generic components:基础组件的价值 本文转自 liam2199 博客,原文链接: http://blog.51cto.com/youxilua/773091如需转载请自行联系原作者


优秀的个人博客,低调大师

阿里云服务器怎么安装个人博客?安装wordpress程序,创建LAMP环境?

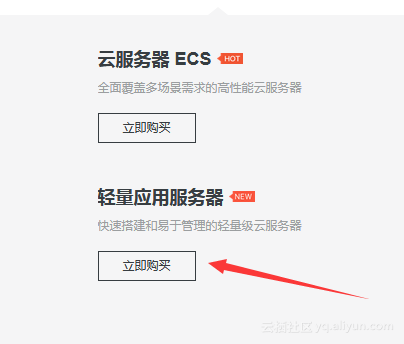
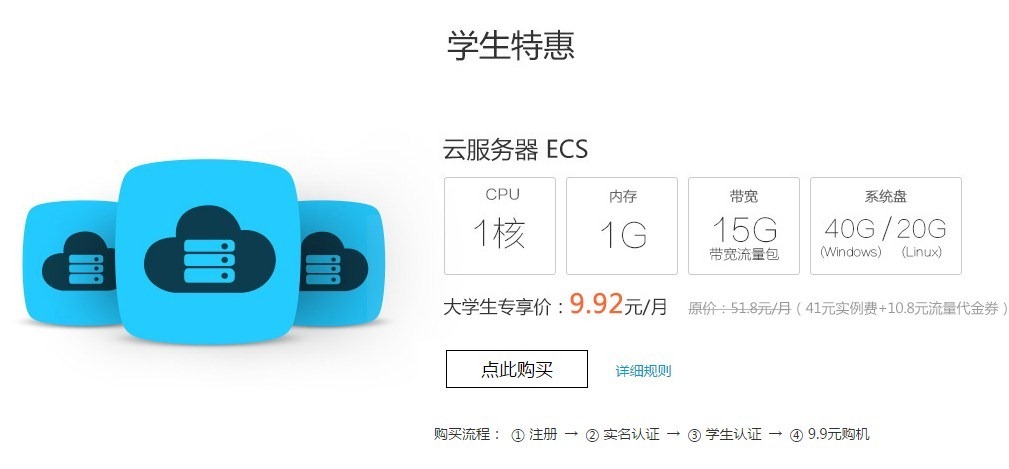
注册域名比较简单,这里就不讲了,直接到阿里云官网注册就行了。 最近阿里云推出了轻量应用型服务器,有一键配置功能,使用方便,1分钟就可以配置了。 注意,请先到阿里云官网 领取幸运券,除了价格上有很多优惠外,还可以参与抽奖。详见:https://promotion.aliyun.com/ntms/act/ambassador/sharetouser.html?userCode=2a7uv47d&utm_source=2a7uv47d 1、登录 阿里云官网,点击:轻量应用服务器,如下图: 2、根据需要选择配置,如下图:(再次提醒一下,购买前请先:领取阿里云幸运券,有很多优惠。)

优秀的个人博客,低调大师

首个人工智能专业委员会成立产业发展再添动力

6月7日,北京信息化协会人工智能专业委员会(以下简称“专委会”)在北京举办成立大会。来自工业和信息化部、北京信息化协会、专委会理事会、专委会发起单位,以及人工智能企业的领导和嘉宾出席了本次大会。 作为首个聚合人工智能行业各方优势资源、由协会发起领导的专业组织,专委会将搭建人工智能全产业链上企业间交流合作的重要平台,并起到上传下达的重要作用,协助政府相关产业政策落地,推动人工智能产业标准的制定,力争在人工智能重塑全球化格局的过程中,为世界贡献中国智慧。 专委会快速协调推进人工智能的应用 人工智能如今已不仅仅是科技热词,不但获得了来自政府决策层的重视,国内的科技企业在人工智能技术上也屡获突破,成绩显著。这意味着,相关产业将进入创新发展的黄金阶段。在此基础上,业界亟需创建一个能够加快政府决策落地,搭建各方沟通合作的桥梁,同时建立产业标准,打造行业生态,推进技术和产业创新的平台。因此,专委会的成立恰逢其时。 工信部信息化和软件服务业司软件产业处调研员傅永宝在致辞中表示,人工智能产业化应用是一项长期、复杂的系统工程,需要各有关方面加强沟通、积极对接、增进合作、共同发展。鉴于此,我们认为成立北京信息化协会人工智能专委会十分必要,专委会的成立,将有利于系统谋划、快速协调推进北京市以及全国范围内人工智能的应用和发展。 北京信息化协会秘书长段红表示,专委会的成立,将为产学研用各界搭建一个良好的沟通交流平台,意义重大。希望专委会能为北京市人工智能产业的发展带来强劲的驱动力,在各位同仁的努力下,发挥群体效应,全方位地开展各项工作。 据介绍,专委会由北京信息化协会牵头,联合北京小米移动软件有限公司、北京猎豹移动科技有限公司、北京旷视科技有限公司、北京并行科技有限公司、北京云知声科技有限公司、北京猎户星空科技有限公司、北京数美时代科技有限公司、北京爱接力科技发展有限公司、北京金山云网络技术有限公司、北京首钢自动化信息技术有限公司、四川新网银行股份有限公司、北京邮电大学、北京理工大学等企业与高校共同发起成立。 搭建一座人工智能产业界的桥梁 专委会发起单位均是人工智能行业的知名企业和科研机构,业务涵盖产业的各个领域,将在人工智能产业上下游形成强烈的带动效应。专委会成员将致力于推动形成技术、应用多方协商管理的运作机制,还将结合云计算、大数据、物联网等领域的前沿技术,面向工业、交通、金融、教育、电信、医疗等关系到国计民生的重点领域,共同打造完善的行业解决方案,营造开放共享的产业生态环境,为各行各业提供优质的技术与产品服务,将人工智能技术更好地融入到社会和经济发展当中。 作为专委会发起单位,一直以来,金山云非常重视技术服务和平台价值,希望打造开放的人工智能生态。金山云将在以云计算为底层服务的智能时代,构建起在人工智能领域的核心竞争力,力争成为“AI+”时代的“水电煤供应商”。 与会嘉宾纷纷表示,随着我国人工智能产业继续迎风而上,产业规模不断壮大,在各方的大力支持和共同努力下,专委会将搭建起一座人工智能产业界的桥梁,相信专委会将为“网络强国”和“制造强国”目标的早日实现,贡献更多智慧和力量。 原文发布时间为:2017年6月8日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

Hadoop 1.0.3 在CentOS 6.2上安装过程 [个人安装通过的全程记录]

//安装SSH [root@localhost /]# sudo yum install ssh //生成密钥 [root@localhost /]# ssh-keygen (可以一路回车) 生成下面两个文件: /root/.ssh/id_rsa /root/.ssh/id_rsa.pub [root@localhost .ssh]# cd /root/.ssh/ //实际情况是把公钥复制到另外一台机器上,并且写入到另外一台机器上的authorized_keys文件中 [root@localhost .ssh]# cat ./id_rsa.pub>>./authorized_keys [root@localhost .ssh]# cd /home (另外一个更简单的复制方法是使用 ssh-copy-id -i ~/.ssh/id_rsa.pub root@192.168.1.201) //配置JDK环境变量 [root@localhost opt]# vi /etc/profile export JAVA_HOME=/opt/jdk1.6.0_31 export PATH=$JAVA_HOME/bin:$PATH:. //使配置生效 [root@localhost opt]# source /etc/profile //安装Hadoop 1.0.3 [root@localhost opt]# rpm -i hadoop-1.0.3-1.x86_64.rpm //查看安装后的Hadoop版本号信息 [root@localhost opt]# hadoop version (如果报错,请检查hadoop-env.sh中的java路径配置是否正确) 修改hadoop配置文件(/etc/hadoop) [root@localhost hadoop]# cd /etc/hadoop [root@localhost hadoop]# vi hadoop-env.sh export JAVA_HOME=/opt/jdk1.6.0_31 [root@localhost hadoop]# vi core-site.xml <configuration> <property> <name>fs.default.name</name> <value>hdfs://192.168.1.101:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/hadoop</value> </property> </configuration> [root@localhost hadoop]# vi hdfs-site.xml <configuration> <property> <name>dfs.replication</name> <value>1</value> </property> </configuration> [root@localhost hadoop]# vi mapred-site.xml <configuration> <property> <name>mapred.job.tracker</name> <value>192.168.1.101:9001</value> </property> </configuration> //格式化文件系统 [root@localhost opt]# hadoop namenode -format //启动Hadoop相关的所有服务 (/usr/sbin) [root@localhost sbin]# start-all.sh 或 [root@localhost opt]# /usr/sbin/start-all.sh (如果没有执行权限,需要将/usr/sbin目录下的相关sh文件设置执行权限) 说明: start-all.sh stop-all.sh start-dfs.sh stop-dfs.sh start-mapred.sh stop-mapred.sh slaves.sh //jps查看已经启动的服务进程信息 [root@localhost hadoop]# jps 5131 NameNode 5242 DataNode 5361 SecondaryNameNode 5583 TaskTracker 5463 JobTracker 6714 Jps 防火墙需要开放的端口: 9000 9001 50010 (访问 http://192.168.1.101:50070 http://192.168.1.101:50030) [root@localhost hadoop]# hadoop dfsadmin -report 为运行例子 wordcount 作准备 [root@localhost opt]# hadoop fs -mkdir input [root@localhost opt]# echo "Hello World Bye World" > file01 [root@localhost opt]# echo "Hello Hadoop Goodbye Hadoop" > file02 [root@localhost opt]# hadoop fs -copyFromLocal ./file0* input 运行例子 wordcount [root@localhost opt]# hadoop jar /usr/share/hadoop/hadoop-examples-1.0.3.jar wordcount input output 12/08/11 12:00:30 INFO input.FileInputFormat: Total input paths to process : 2 12/08/11 12:00:30 INFO util.NativeCodeLoader: Loaded the native-hadoop library 12/08/11 12:00:30 WARN snappy.LoadSnappy: Snappy native library not loaded 12/08/11 12:00:31 INFO mapred.JobClient: Running job: job_201208111137_0001 12/08/11 12:00:32 INFO mapred.JobClient: map 0% reduce 0% 12/08/11 12:01:05 INFO mapred.JobClient: map 100% reduce 0% 12/08/11 12:01:20 INFO mapred.JobClient: map 100% reduce 100% 12/08/11 12:01:25 INFO mapred.JobClient: Job complete: job_201208111137_0001 12/08/11 12:01:25 INFO mapred.JobClient: Counters: 29 12/08/11 12:01:25 INFO mapred.JobClient: Job Counters 12/08/11 12:01:25 INFO mapred.JobClient: Launched reduce tasks=1 12/08/11 12:01:25 INFO mapred.JobClient: SLOTS_MILLIS_MAPS=49499 12/08/11 12:01:25 INFO mapred.JobClient: Total time spent by all reduces waiting after reserving slots (ms)=0 12/08/11 12:01:25 INFO mapred.JobClient: Total time spent by all maps waiting after reserving slots (ms)=0 12/08/11 12:01:25 INFO mapred.JobClient: Launched map tasks=2 12/08/11 12:01:25 INFO mapred.JobClient: Data-local map tasks=2 12/08/11 12:01:25 INFO mapred.JobClient: SLOTS_MILLIS_REDUCES=12839 12/08/11 12:01:25 INFO mapred.JobClient: File Output Format Counters 12/08/11 12:01:25 INFO mapred.JobClient: Bytes Written=41 12/08/11 12:01:25 INFO mapred.JobClient: FileSystemCounters 12/08/11 12:01:25 INFO mapred.JobClient: FILE_BYTES_READ=79 12/08/11 12:01:25 INFO mapred.JobClient: HDFS_BYTES_READ=276 12/08/11 12:01:25 INFO mapred.JobClient: FILE_BYTES_WRITTEN=64705 12/08/11 12:01:25 INFO mapred.JobClient: HDFS_BYTES_WRITTEN=41 12/08/11 12:01:25 INFO mapred.JobClient: File Input Format Counters 12/08/11 12:01:25 INFO mapred.JobClient: Bytes Read=50 12/08/11 12:01:25 INFO mapred.JobClient: Map-Reduce Framework 12/08/11 12:01:25 INFO mapred.JobClient: Map output materialized bytes=85 12/08/11 12:01:25 INFO mapred.JobClient: Map input records=2 12/08/11 12:01:25 INFO mapred.JobClient: Reduce shuffle bytes=85 12/08/11 12:01:25 INFO mapred.JobClient: Spilled Records=12 12/08/11 12:01:25 INFO mapred.JobClient: Map output bytes=82 12/08/11 12:01:25 INFO mapred.JobClient: CPU time spent (ms)=4770 12/08/11 12:01:25 INFO mapred.JobClient: Total committed heap usage (bytes)=246751232 12/08/11 12:01:25 INFO mapred.JobClient: Combine input records=8 12/08/11 12:01:25 INFO mapred.JobClient: SPLIT_RAW_BYTES=226 12/08/11 12:01:25 INFO mapred.JobClient: Reduce input records=6 12/08/11 12:01:25 INFO mapred.JobClient: Reduce input groups=5 12/08/11 12:01:25 INFO mapred.JobClient: Combine output records=6 12/08/11 12:01:25 INFO mapred.JobClient: Physical memory (bytes) snapshot=391634944 12/08/11 12:01:25 INFO mapred.JobClient: Reduce output records=5 12/08/11 12:01:25 INFO mapred.JobClient: Virtual memory (bytes) snapshot=3159781376 12/08/11 12:01:25 INFO mapred.JobClient: Map output records=8 //查看统计结果 [root@localhost opt]# hadoop fs -cat output/part-r-00000 Bye1 Goodbye1 Hadoop2 Hello2 World2 //--------------------------------------- 作业日志存放目录: /var/log/hadoop/root/userlogs/ //--------------------------------------- 安装 hadoop-1.0.3-1 后,存放的目录有: /etc/hadoop /var/run/hadoop /var/log/hadoop /usr/share/hadoop /usr/share/doc/hadoop /usr/etc/hadoop /usr/bin/hadoop(文件) /usr/include/hadoop

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册