首页 文章 精选 留言 我的

精选列表

搜索[万物智联],共10000篇文章
优秀的个人博客,低调大师

汇智焕彩,聚势创新 - openKylin 2.0 SP2 正式发布!

OpenAtom openKylin(简称 “openKylin”) 2.0 SP2版本正式发布!本次版本更新在底层核心能力上,持续维护 6.6 稳定版内核,深度适配海光、飞腾、兆芯、龙芯等国产主流芯片,并积极推动 RISC-V 开放指令集架构生态融合,构建坚实多元的算力底座。 该版本的主要特性更新还包括:新增集成 DeepSeek、通义千问、商汤等云端与本地大模型,初步构建起桌面智能交互中枢;首次默认搭载“磐石架构”,融合不可变系统、KARE 及开明包格式三大核心技术,显著提升系统级高稳固性并确保应用生态的广泛兼容;全新 UKUI 4.20 桌面环境融入动态光影引擎与 AI 技术,带来沉浸式交互体验;配套原生开发 SDK 升级至 3.0 版本,新增 273 个接口,深度适配 UKUI 桌面环境与 wlcom 合成器;广泛适配支持联想开天、中科可控、进迭时空等品牌超 100 款终端设备。现诚邀所有社区开发者和用户共同见证并体验全新一代openKylin智能桌面开源操作系统! openKylin 2.0 SP2亮点特性 1、6.6内核持续稳定兼容 openKylin 2.0 SP2版本针对6.6稳定版内核进一步优化和完善,累计合入上游及内核底层优化补丁10000+,并在社区会员单位的支持下,完善对海光C86-4G系列处理器、飞腾D3000系列平台、兆芯KX-7000平台、龙芯3A6000平台、格兰菲Arise2系列显卡、中关村实验室HAOC的支持,同时推动超睿等RISC-V厂商基于openKylin 6.6内核适配及代码合入,向RISC-V内核统一迈出坚实一步! 2、AI能力大跃迁 openKylin 2.0 SP2搭载全新升级AI子系统及AI助手,致力于打造全能桌面智能中枢。本次升级深度整合了DeepSeek、通义千问等主流云端大模型,实现用户零门槛调用实时AI能力,满足日常及专业分析需求;同时,针对数据敏感场景,可通过openKylin软件商店安装Qwen2.5-3B本地大模型,实现离线运行,平衡安全与效率。 更多大模型支持 1、在线模型 支持DeepSeek、百度文心一言、阿里通义千问、商汤、讯飞星火、百川等国内主流在线大模型,一键绑定API密钥即可接入使用。 2、本地模型 本地大模型安装流程简化,用户在openKylin软件商店即可快速下载安装。 AI助手全新改版 新版AI助手在界面UI显示及交互上全面优化,新增支持窗口和侧边栏双模式切换,多模态交互支持图片/文档等格式文件拖拽分析,还可以自定义设置快捷指令。新增本地文档处理功能,支持用户导入本地文档构建专属知识库,提供准确问答服务。 3、“磐石架构”完全体正式上线 磐石架构的核心是构建一个“不可变”的基础操作系统环境,并基于该环境通过配套生态兼容和管理技术,为用户提供基础稳定和安全的同时,保留原有操作习惯和丰富的应用生态。在openKylin上,磐石架构主要包括三个核心技术:不可变系统、KARE兼容环境和开明包格式,三者协同工作,有效解决了传统 Linux桌面发行版的更新升级与生态兼容矛盾的痛点问题,推动其向更高效、安全的方向发展。 默认不可变系统 ● 2.0 SP2版本正式默认启用不可变系统模式,安装系统后即为不可变系统环境 ●新增维护模式功能,用户开启后可以从任意源安装应用及调试运行环境 ●支持维护模式状态通过桌面水印的方式提醒 ●支持多版本内核共存及切换功能 KARE 3.0 ●容器引擎切换为轻量级的CRUN,提升程序启动运行速度及可控性 ●新增与开明包共享image的能力,提升系统资源调度效率 ●统一KARE环境构建日志、应用安装运行日志、后台服务日志等日志路径 开明软件包格式 ●升级运行架构,由“runtime+app”改为“base+runtime+app”,提升运行效率及灵活性 ●容器引擎切换为轻量级的CRUN,提供更多运管理机制和安全防护配置方式 ●优化基础功能,包括新增签名功能、文件反查接口等 ●新增开明可视化构建工具、支持增量构建功能等 ●新增数百款开明应用上架 ●完成十余款系统预装应用开明化替代 4、wlcom合成器日趋完善 openKylin社区Wayland SIG组持续优化完善wlcom合成器,致力于为社区用户提供体验更加流畅、功能更加完善、性能更加卓越的Wayland显示协议合成器,本次版本发布,wlcom主要有以下方面优化: ●新增拖拽窗口贴边效果及选择预览效果 ●重构drm backend ●服务端装饰统一使用ukui主题框架参数 ●优化多种特效实现,效果更加流畅 ●提供获取个别特殊按键状态接口 5、UKUI 4.20桌面环境 基于UKUI 4.0 “轻量化感知” 设计原则基础上,UKUI 4.20以 “更流畅的交互、更智能的体验、更个性化的配置、更安全的基座” 为核心目标,从五个优化方向进行桌面交互重构,为用户带来更高效、更智能、更贴心的桌面体验。 轻量视觉的沉浸式延伸 延续UKUI 4.0的设计原则,UKUI 4.20新增动态光影引擎,实现从“看得清”到“看得懂”的跨越,让界面更美观、交互更自然。 智慧锁屏 小组件与屏保进搭配组合,用户无需打开应用即可获取数据,以满足用户不同的场景和需求。 交互自由的场景化扩容 将“轻松的交互体验”理念扩展至多模态交互(语音/手势/AI预测),建立“人-机-环境”自然对话系统,让操作系统更懂用户需求。 智能架构的原生融合 首次在系统层引入AI中间件,使效率工具(如文件搜索)进化为认知助手,让系统具备更强的智能服务能力。 全局动效优化 UKUI 4.20完成窗口显示/隐藏动效、应用组动效、桌面图标动效等46个交互动效。 其他优化更新 1、主题: ●全新“磐石”壁纸上线,磐石筑基,踏浪而行 2、控制面板 ●新增AI模块管理 ●新增运维模式管理模块 ●优化原字体管理器功能集成到字体模块 ●新增系统启动模块(可配置grub默认启动项、grub启动延时等) ●优化触控校准与触摸屏导航合并 ●新增屏保新增天气、音乐、相册三种样式可选 ●优化任务栏配置选项 ●新增键盘模块新增虚拟键盘设置选项 ●优化护眼模式,新增调节色温实时预览功能; ●........ 3、文件管理器 ●实现桌面环境服务的插件化,提供统一服务框架,通过统一服务框架加载插件的方式拉起服务,对桌面环境服务进行统一管理和维护 ●文件管理器UI/UE体验优化 ●文件搜索功能优化,集成智能搜索 ●文件管理器共享与远程体验优化 4、系统监视器 ●系统监视器增加磁盘详情读写页 5、声音 ●断开音频设备时暂停播放 6、输入法配置 ●全局输入法配置工具UI界面升级优化 7、 声音 ●新增断开音频设备时暂停播放的功能 8、多任务视图 ●新增工作区名称自定义功能 9、开始菜单 ●新增支持拖拽固定到任务栏的操作 10、任务栏 ●增加托盘图标自定义(显示/隐藏) ●多屏模式下任务栏显示配置自定义 11、虚拟键盘 ●显示/隐藏逻辑优化 ●多屏幕支持 ●wlcom适配支持 ●...... 6、系统录屏工具上线 正式上线并预装openKylin系统录屏软件,支持一键启动、声音录制、区域录制、倒计时等众多经典功能,并重点支持在wlcom环境下运行,为openKylin用户提供真正好用、易用的录屏体验! 7、原生开发全链路赋能开发者 openKylin原生开发环境以全链路赋能开发者为核心,构建了覆盖多场景的技术底座。在openKylin 2.0 SP2阶段,openKylin系统SDK最新升级到3.0,整体新增15个功能模块与273个接口,助力开发者深度适配UKUI及wlcom;AI SDK进一步扩展20+专用接口,强化基于openKylin的原生智能开发能力;同时与社区伙伴厂商合作,基于openKylin嵌入式构建工具,深度支持机器人、小手机、小电脑等智能创新硬件适配开发。配套KylinCode集成开发环境提供一站式编码、调试服务,并在openKylin社区自动化开发者平台的支持下,实现仓库创建、代码构建到镜像发布的全流程自动化管理,降低开发门槛,加速原生应用创新落地。 安装方式 通过官网下载镜像全新安装(推荐) https://www.openkylin.top/downloads 请注意:由于本次默认搭载磐石架构,系统底层结构变化较大,暂时无法从openKylin 2.0 SP1及更早版本妥善升级到SP2(SP2 Beta可以),目前社区开发者们正在加急开发和验证尽可能完备的升级方案,大家敬请期待! 版本修复的重点Bug清单 系统应用 ●【AI助手】修复AI助手有进程且界面未唤出时,右键文件选择“发送至AI助手”时未唤出AI助手窗口的问题 ● 【AI助手】修复ppm pgm pbm tiff格式的图片,会回复“输入文本无效,请修改后重新发送”的问题 ● 【AI助手】修复wlcom环境下高概率出现划词不能出现划词悬浮条的问题 ● 【AI助手】修复切换至窗口模式,偶现窗口默认尺寸不正确,且无法拖拽、拉伸的问题 ● 【AI助手】修复划词悬浮条唤出时,使用alt+tab唤出快速切换区会闪退,唤出多任务视图会先显示图标再消失的问题 ● 【AI助手】修复图片处理后点击重新回答按钮无法重新进行扫描黑白件或智能抠图的问题 ● 【AI助手】修复在提示词模板添加提示词后,关闭AI助手,再次打开后所有提示词都被清空了的问题 ● 【AI助手】修复点击“取消置顶”无效的问题 ● 【AI助手】修复英文朗读时断断续续,不流畅的问题 ● 【AI助手】修复软件商店下载qwen2.5-3B大语言模型,重启系统后设置不出现“本地模型”的问题 ● 【AI模块管理】 ● 【本地模型】AI模块管理界面默认不显示本地模型 ● 【AI模块管理】修复云端账号接口Key信息泄露风险问题 ● 【KMRE】修复docker 服务无法启动的问题 ● 【U盘管理工具】修复插入移动硬盘,重启机器,无法弹出移动硬盘的问题 ● 【录屏】修复wlcom环境下,设置和关于界面存在两个标题栏的问题 ● 【刻录】修复wlcom模式下,更改主题后,界面未全部同步,只更改部分界面的问题 ● 【备份还原】【公测】修复无法删除备份的问题 ● 【备份还原】修复还原出厂备份提示失败的问题 ● 【天气】修复首次从托盘小图标处打开天气时,出现双标题栏等问题 ● 【安装器】修复使用安装器安装包,初始化环境结束后提示安装失败的问题 ● 【安装器】修复安装器安装包后开始菜单不能运行的问题 ● 【开明包格式】修复应用弹窗存在双窗口的问题 ● 【开明包格式】修复开明包应用字体与系统默认字体不一致的问题 ● 【开明包格式】修复更新6.6.0.15内核后无法使用开明应用,设置面板响应慢的问题 ● 【开明包格式】修复软件商店安装开明应用提示0003的问题 ● 【录屏】【公测】修复wlcom环境下录屏存在双标题栏的问题 ● 【录屏】修复在龙芯机型上,无法正常录制视频,录制会自动退出的问题 ● 【录屏】修复录屏应用打不开的问题 ● 【录屏】修复录屏画面卡在某处的问题 ● 【录音】修复在龙芯机器上录制音频时,文件时长为0的问题 ● 【智能剪切板】【公测】修复剪贴板显示错位的问题 ● 【智能剪切板】【公测】修复剪贴板点复制会复制两遍,产生两个条目的问题 ● 【智能剪切板】【公测】修复系统使用一段时间后,点击托盘剪切板图标无响应,复制粘贴也失效了的问题 ● 【智能剪切板】修复wlcom模式下,菜单显示的位置不固定的问题 ● 【智能剪切板】修复滑动条的显示与设计稿不符、与系统中其他滑动条也不一样的问题 ● 【智能模糊搜索】修复AI索引无法打开的问题 ● 【智能模糊搜索】修复搜索到的配置项无法打开的问题 ● 【终端】修复终端子窗口标题菜单置于底层,仅子窗口置于底层的问题 ● 【软件商店】修复英文环境下,kmre页面内介绍信息没有翻译为英文的问题 ● 【音乐】修复点击进度条,只能一段一段前进,且无法正常后退的问题 桌面环境组件 ● 【网络管理】修复从任务栏无法断开无线连接的问题 ● 【网络管理】修复点击任务栏网络图标,点击下方"更多网络设置"无反应的问题 ● 【蓝牙】修复在龙芯3A6000上蓝牙设备配对成功后一直显示未连接状态,点击无法连接的问题 ● 【触控板】修复“插入鼠标时禁用触控板”功能不生效的问题 ● 【账户信息】修复切换用户至标准用户,打开设置-账户信息,设置窗口闪退的问题 ● 【登录选项】修复绑定微信后,登录锁屏界面无法调用微信/生物识别认证的问题 ● 【登录锁屏】修复RISC-V架构上屏保界面鼠标点击右键,屏保界面卡住,随后直接进入桌面的问题 ● 【登录锁屏】修复登录界面输错密码后点击重置密码,实测重置密码点击确定不起作用的问题 ● 【登录锁屏】修复音乐屏保、天气屏保显示异常的问题 ● 【显示】【公测】修复系统更新后背景缩小的问题 ● 【显示器】修复显示器亮度、下拉框均与设计稿不一致的问题 ● 【控制面板】修复grub验证功能密码设置异常的问题 ● 【控制面板】修复删除已添加的应用后,开机启动界面显示异常的问题 ● 【控制面板】修复在wlcom模式下控制面板更新界面自动检测更新后,点击其他模块界面会重叠在一起的问题 ● 【控制面板】修复在控制面板使用鼠标滑动页面,页面滑动过程中显示异常的问题 ● 【控制面板】修复控制面板添加用户时无法设置安全问题的问题 ● 【控制面板】修复普通用户点击账户信息,控制面板闪退的问题 ● 【控制面板】修复每次打开控制面板第一次选择远程桌面都会弹窗提示请选择一个输出设备的问题 ● 【控制面板】修复部分机型存在缺少“有线网络”“无线局域网”的问题 ● 【控制面板】修复部分机型点击控制面板WIFI列表内任意WIFI无反应的问题 ● 【控制面板】修复部分机型重启后在控制面板打开或无线局域网开关,异常卡顿的问题 ● 【控制面板】修复龙芯架构控制面板-键盘中的输入法编辑按钮,点击后控制面板闪退的问题 ● 【控制面板】修复龙芯架构点击控制面板-显示器,控制面板发生闪退的问题 ● 【摄像头】修复在设置中切换摄像头闪退的问题 ● 【文件管理器】【公测】修复以root身份打开peony ,丢失主题,界面显示异常的问题 ● 【文件管理器】【公测】修复系统使用时遇到的不能删除文件夹的问题 ● 【文件管理器】修复U盘格式化为exfat 格式,设备名称处输入15个字符,格式成功,但设备名设置失败的问题 ● 【文件管理器】修复从U盘中拷贝长文件名文件到文件管理器中,点击保存-应用后,文管中不存在扩展目录的问题 ● 【文件管理器】修复使用快捷键ctrl+shift+N新建文件夹,文件夹名称未处于编辑状态的问题 ● 【文件管理器】修复删除桌面文件时,桌面会闪一下的问题 ● 【文件管理器】修复剪切一个文件名称带有"#"的文件粘贴到其他目录下,但原来目录下仍然存在该文件的问题 ● 【文件管理器】修复插入U盘启动器做的启动盘,本地分区中的图标显示错误的问题 ● 【文件管理器】修复文件对话框处于搜索状态时,点击搜索按钮关闭搜索,文件对话框的搜索框未恢复为路径的问题 ● 【文件管理器】修复文件对话框显示界面打开属性界面卡死的问题 ● 【文件管理器】修复文件搜索会进入循环,导致页面无限刷新的问题 ● 【文件管理器】修复文件管理器多选文件时会出现冲突的问题 ● 【文件管理器】修复桌面上文本文件和图片的只读角标位置异常的问题 ● 【文件管理器】修复桌面最下面一行显示不全的问题 ● 【文件管理器】修复点击文件管理器-智能空间-点击智能空间引导/使用手册,无法打开查看的问题 ● 【文本编辑器】修复wlcom环境下重命名文件后,再次右键文件名,文件名会有瞬间的空白的问题 ● 【主题】修复切换窗口外观,控制面板卡死的问题 ● 【主题】修复强调色蓝色没有选中效果的问题 ● 【主题】修复最大化背景界面,“选择图片”列表一直抖动的问题 ● 【主题】修复预览图不支持切换主题的问题 ● 【会话管理器】修复ukui-session-service组件内存占用异常的问题 系统支撑 ● 【grub引导】修复恢复出厂设置失败的问题 ● 【grub引导】修复无法引导安装内核的问题 ● 【磐石架构】修复不可变系统完成关机更新或回退后会黑屏一段时间才重启系统的问题 ● 【磐石架构】修复维护模式下,侧边栏插件会导致桌面黑屏的问题 ● 【磐石架构】修复维护模式下,无法关闭保留维护模式下数据的问题 ● 【系统安装】修复全盘加密安装失败的问题 ● 【系统安装】修复全盘加密弹窗填写完成按ENTER键,退出设置,且未设置成功的问题 ● 【系统安装】修复在华为 MateBook上安装时找不到引导项的问题 ● 【系统安装】修复安装时选择语言为英文,安装界面显示异常,没有轮播图的问题 ● 【系统安装】修复安装轮播图播放时文和图对应错误的问题 ● 【系统安装】修复新版本无法安装维、哈、柯、德、西、法、京等语言的问题 ● 【系统安装】修复直接创建用户、稍后创建用户,OOBE界面鼠标焦点默认不在用户名栏的问题 ● 【系统安装】修复非UEFI方式无法启动安装程序的问题 ● 【系统服务】【公测】修复audio服务没有关闭日志,重启后每次会在用户目录生成日志文件的问题 ● 【更新升级】修复不可变系统版本回退后,再次点击开始进行回退界面一直卡住不动的问题 ● 【更新升级】修复不支持查看本次更新变更的文件清单的问题 ● 【更新升级】修复升级完成后右上角弹出的提示重启弹窗内容显示英文的问题 ● 【更新升级】修复控制面板点击更新提示"检查更新异常"的问题 ● 【声音】修复不存在扬声器以及内置话筒时,输入输出音量无法调节的问题 ● 【声音】修复单声道选项设置不生效,开启后声道平衡选项条可调节的问题 ● 【声音】修复接入蓝牙耳机和USB耳机,在任务栏声音设置界面切换到USB模拟输出,则会自动变为蓝牙输出的问题 ● 【声音】修复来回切换输出设备,控制面板声音页面卡顿的问题 ● 【声音】修复部分机型扬声器或模拟耳机情况下插入USB设备,输出输入设备未自动变为USB输出/输入的问题 ● 【内核】修复升级到新版内核后,重启卡在logo界面(机器品牌logo,未到系统logo)的问题 ● 【树莓派5】修复安装启动openkylin系统不成功的问题 ● 【电源管理】修复睡眠唤醒后登录界面无法进入系统,按钮显示重试,只能强制关机重新进入系统的问题 X86适配清单 RISC-V适配清单 ARM适配清单 Loong64适配清单 致谢 最后,感谢每一位openKylin社区成员的不懈努力和创意贡献,正是你们的集体智慧和技术热情,推动了openKylin 2.0 SP2成功发布。你们的每一份努力,每一次代码提交,每一条建设性的反馈都为openKylin的创新和发展做出了不可磨灭的贡献!未来,让我们继续努力,携手共创,在开源的世界里落地生花~ openKylin 2.0 SP2现已正式发布,欢迎大家下载体验,系统使用过程中如有任何问题或建议,欢迎大家点击前往openKylin 小程序或openKylin Gitee仓库提交反馈。感谢大家的支持! 请注意:openKylin 2.0 SP2版本目前存在部分已知问题正在修复中,若在使用过程中遇到,不需要再次向社区提交反馈。若您希望优先解决某个问题,可以动动小手在该问题Issue下评论“+1”,这有助于提升该问题的修复优先级,推动开发者加急修复!全部的已知Issue清单见以下链接:https://gitee.com/organizations/openkylin/issues?assignee_id=&author_id=&branch=&collaborator_ids=&issue_search=&label_ids=&label_text=&milestone_id=&priority=&private_issue=&program_id=&project_id=&project_type=&scope=&single_label_id=&single_label_text=&sort=&state=progressing&target_project=

优秀的个人博客,低调大师

从 ClickHouse 到 Apache Doris:快成物流的数智化货运应用实践

导读:随着快成物流的大宗商品产业链的不断发展,货运轨迹规划和实时数据分析的需求日益迫切,为了保障数据报表更新、用户画像圈选与物流轨迹实时更新等大数据核心系统性能,快成物流引入 Apache Doris 实时数仓升级了大数据算法平台,目前已经部署在 2 套生产集群,存储数据总量达百亿规模,覆盖实时数仓、BI 多维分析、用户画像、货运轨迹信息系统等业务场景。 作者共创:快成物流大数据算法平台技术负责人 汪新禧 & SelectDB 内容团队 山西快成物流科技有限公司(简称“快成物流”)是一家以新一代信息技术为核心的“互联网 + 大宗物流产业链生态”的平台型科技企业,网络货运排名跻身全国前三。快成物流深耕“让大宗商品流通更美好”的企业使命,依托数字技术连接大宗物流全产业链,向产业参与主体提供全链路一体化物流解决方案,为行业降本、增效、提质持续助力。 目前快成物流服务卡车司机累计已破百万,货主数万家,在业务高峰期,单日新增数据量达到千万级别,大数据系统的数据处理能力面临巨大的挑战。快成物流已拥有多个数据业务线,其中核心业务包括: 网络货运平台: 服务数万货主与百万卡车司机的大宗商品物流运输平台,业务流程复杂,实体货物种类多、服务周期长,对数据实时性要求高、数据分析维度复杂。 快乐驾: 智慧物流车载终端系统,包括轨迹监控、安全驾驶等。 快乐购: 后市场消费服务平台,包括加油加气、卡车零件销售等电商服务。 随着业务规模的不断扩大,快成大数据算法平台在支撑上述业务产生海量数据存储的同时,也需应对多种多样的数据应用需求,包括基础业务支撑、BI 报表分析、可视化大屏、用户画像、智能风控、精准营销、AB 实验以及合规性监测等,这也对大数据平台提出了更高的技术要求: 极速数据处理:平台需要支持高吞吐量的复杂数据分析,在海量数据中快速准确地提取有价值的信息。 点查性能强:大数据平台需实现高 QPS 点查能力,确保在海量数据中快速定位并查询特定信息,以满足用户对数据实时性的高要求。 运维管理成本低:在保障数据处理效率和质量的同时,大数据平台期望通过自动化、智能化的运维手段降低运营成本。 运行稳定:系统需要高可靠、高可用,为业务持续发展提供有力保障。 业务诉求与技术选型 随着用户对数据分析的实时性与时效性需求的日益提升,快成物流在早期进行 OLAP 数据库技术选型时,核心诉求是寻找一款基于 MPP 架构、高性能、实时的分析型数据库。当时考察选型的数据库包括 Kylin、Druid、Doris、ClickHouse 等。经过评估后,我们先选择了已经拥有一定用户基础的 ClickHouse,其在千万级别的单表处理耗时往往在数秒内,基本满足业务需求。而此时的 Doris 仍在孵化阶段,功能与稳定性尚需时间验证,我们也在持续关注 Doris 的发版与功能升级,并定期进行性能测试。 随着业务深度使用,ClickHouse 在查询性能方面表现较好,帮助我们解决了不少业务问题,但痛点也开始显露出来: 多表 Join 性能有限:ClickHouse 只有 Global Join 和 Local Join,在大表 Join 大表时的场景下,跨节点间数据 Shuffle 时容易导致 Join 性能大打折扣,甚至造成 OOM 。 运维成本高:ClickHouse 的扩容缩容操作复杂,目前做不到自动在线操作;配置管理也相对繁琐,学习成本很高。 与此同时,Apache Doris 的功能正在不断升级完善, 我们发现 Doris 的多表 Join 能力与运维成本更加符合我们对 OLAP 数据库的预期,并且能够很好的解决 ClickHouse 出现的上述痛点,测试环境下的性能表现也十分出色。 经过一段时间的试用后,我们开始逐步替代 ClickHouse,目前快成物流大数据算法平台的主要 MPP 场景都基于 Doris 提供服务。 基于 Apache Doris 的大数据算法平台 为支撑快成多种多样的数据应用场景, 我们团队自建了相对完善的大数据算法平台,引入 Doris 后的架构如下: 按照从左至右数据流向,数据处理架构可概括为以下主要环节: 数据源端主要包括来自 MySQL 等业务数据库的运单数据、物流车终端上报的物联网数据、埋点日志数据等,在数据采集环节会分别经由 Flink CDC、SeaTunnel、Sqoop 以及 Filebeat 等工具进行数据抽取。在数据清洗计算阶段,实时数据会通过 Kafka 采集和 Flink 进行计算并存储在实时数据仓库 Doris 中,而离线数据则通过 Spark 进行 ETL 后进入离线数据仓库 Hive 中。此外,特征数据还会存储在特征平台 Feathr 中,随后在分析建模环节进行数仓分层、建模,构建指标体系和标签体系,最终服务于数据应用,支持报表生成、BI 分析、业务支撑、调度匹配、风控以及合规等核心业务。 在以上架构中,Apache Doris 担任了实时数据仓库的关键定位,对上游承接了离线和实时数据的接入、对下游支持了 BI、报表、用户画像、风控、营销等数据应用的查询分析服务,在快成的大数据技术算法平台中发挥了至关重要的作用。下文将重点分享 Apache Doris 在快成物流的大数据应用与升级实践,希望对读者产生积极的借鉴意义。 Doris 在快成的应用实践 快成物流的货运业务复杂度高,业务节点多且链路周期较长,实时数仓建设难度较高,加之对接了大量微服务系统,数据库表较为分散,这使我们在建设实时数仓的过程中,面临着诸多挑战: 保证复杂实体关系下的数据准确性; 提升实时多流 Join 的处理效率; 保障数据一致性; 平衡数据数量、时效性与算力资源之间的关系。 01 实时数据接入 针对实时数据,我们又细分为实时与近实时两种情况: 毫秒级实时(Real-time):实时数据处理指数据在产生后立即进行处理和响应,无延迟或延迟极小。实时处理对数据的处理速度要求非常高,通常需要在毫秒级别内完成,常用于需要即时反馈和实时决策的场景,例如实时风控等。 秒级近实时(Near Real-time):近实时数据处理指数据产生后,经过一定延迟再处理,通常在秒级别内完成。近实时处理常用于对数据的快速分析和决策,例如实时报表生成、数据仪表盘等场景。 对于不同源数据的写入,Doris 提供了丰富的数据接入扩展工具,包括 Spark Doris Connector、Flink Doris Connector、Seatunnel Doris Sink 等,方便用户快速从 Hive、MySQL、Kafka 等源端系统中抽取数据并导入 Doris 中。 我们的整库同步和实时数据接入主要通过 Flink Doris Connector 进行,其依赖于 Flink CDC、Debezium 等技术底层实现。通过伪装 MySQL 等关系型数据库的从库实例,进而实时捕获到 Binlog(业务库表的数据变更日志),最后通过 Stream Load 的方式导入到 Doris 库中。 Flink Doris Connector 封装的较为易用,无需提前建表,就可以快速将上游业务库的表结构及数据接入到 Doris 中,轻松实现一键整库同步。其配置文件脚本如下: <FLINK_HOME>/bin/flink run \ -Dexecution.checkpointing.interval=5s \ -Dparallelism.default=1 \ -c org.apache.doris.flink.tools.cdc.CdcTools \ lib/flink-doris-connector-1.17-1.6.1.jar \ mysql-sync-database \ --database ods \ --table-prefix ods_ \ --mysql-conf hostname=127.0.0.1 \ --mysql-conf username=root \ --mysql-conf password=123456 \ --mysql-conf database-name=test_mysql_db \ --including-tables "tbl1|test_.*" \ --sink-conf fenodes=127.0.0.1:8030 \ --sink-conf username=root \ --sink-conf password=123456 \ --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \ --sink-conf sink.label-prefix=label1 \ --table-conf replication_num=3 通过 Flink Doris Connector,5 秒内即可将 MySQL 的 CDC 日志采集到 Doris 的 ODS 层中,接着在 Doris 中构建实时数仓的下游层级。数据仓库分层架构遵循了常见的的四层架构(ODS 贴源层 - DWD 明细层 - DWS 汇总层 - ADS 应用层),以确保数据的高效管理、快速响应和便捷运维。 02 报表服务与BI实践 面对需要同时处理高并发报表查询和海量数据分析的场景时,传统的大数据解决方案已经逐渐显露不足。我们基于 Doris 重新建设的大数据算法平台,针对离线与实时数据处理效率进行了深度优化,凭借 Doris 强大的宽表查询性能与并行数据处理能力,有效促进了数据报表与 BI 分析场景的功能升级与分析效率的大幅提升。 2-1 数据报表分析 实时数据报表属于数据高并发、大规模特征并存的典型场景,此前系统中使用的 Hive 和 Spark 在处理大规模数据集方面表现出色,然而面对高并发查询时,处理效率与我们的预期存在较大差距。此外,MySQL 对大规模数据进行查询时,效率显著下降,数据报表的更新速度也因此受限。 经测试,Doris 的数据实时写入和更新能力十分强大,能够实现快速及时的查询分析响应。在实时数仓建设阶段,我们把离线数据架构下 DIM 维度层、ADS 应用层的数据通过 SeaTunel 写入了 Doris 中,实现了结果表的查询加速, 从而实现每秒上万数量级的 QPS 并发查询,数据报表更新及时度大大提高。 2-2 BI 即席分析 即席查询(Ad-Hoc Query)是面向数据分析人员的自助分析应用,因其查询条件多样化,对系统的吞吐能力提出了较高的要求。Doris 提供了灵活丰富的 SQL 函数公式,并拥有高吞吐量的计算能力,数据分析师、产品经理等业务人员通过 Metabase(数据探索与可视化工具) + Doris 即可基本满足 BI 的数据探索需求,大部分查询响应速度都在秒级完成。 03 用户画像实践 用户画像在广告推荐系统、商业分析、用户增长、产品设计、数据化运营、精准营销、量化风控等领域得到广泛应用,依托于 Doris 强大的计算能力, 团队构建了快成物流的用户画像体系。 3-1 人群画像圈选 首先,大数据开发人员将离线数仓与实时数仓计算生产的标签,写入到 Doris 的标签表。产品运营通过人群圈选服务动态生成人群圈选 SQL,最后,通过 Doris 实时计算产生结果并返回给用户。 由于充分利用了 Doris 的 Bitmap 精准去重、倒排索引等特性,在数十个标签筛选组合条件下可以在亚秒级的返回圈选结果,用户“所圈即所得”,避免了长时间等待,极大地提高了运营与营销团队的工作效率。 3-2 个体画像查询 面向客户的个体画像需求同样属于高并发查询场景, 如司机个人画像、风控预警等。Doris 的前缀索引功能,即在排序基础上实现的根据给定前缀列,能够轻松支持上万 QPS,99 分位的查询延时在 150 毫秒以内,非常适合用户画像点查,很好地替代了之前 HBase + Redis 的点查加速方案。 04 轨迹存储与分析实践 GIS 地理信息系统(Geographic Information System) 作为物流运输平台的核心功能模块之一, 在车辆轨迹、司机 APP 轨迹等方面有着重要的应用, 例如车辆在途、轨迹预警、线路预警、司机驾驶安全等。平台有责任与义务在保证司机行车安全的同时,努力降低车主车辆、货主货品财产损失的风险。 然而,技术上也给平台带来海量轨迹存储、高性能查询与分析的硬性指标要求。 另一方面,监管部门也有“五流合一”合规性的政策要求,根据《网络平台道路货物运输经营管理暂行办法》,企业至少保存长达 3 年的轨迹数据。Doris 自 2.0 版本开始支持冷热分离,我们通过在 Partition 级别上设置 Freeze time,将 3 年前的冷数据存储在类似于 S3 的对象存储上,从而节省本地的磁盘空间,进而节省存储成本。 目前公司使用 Doris 支撑了百亿规模的轨迹存储,提供实时在线轨迹回放、轨迹风控预警等能力, 相比于之前 ES 的技术方案,同等规模数据所依赖的存储资源得到极大幅度节省。 05 湖仓一体实践 Doris 通过多源数据目录(Multi-Catalog)功能,支持了包括 Apache Hive、Apache Iceberg、Apache Hudi、Apache Paimon、Elasticsearch、JDBC(MySQL、Oracle、SQL Server) 等主流数据湖、数据库的连接访问。我们通过 Multi-Catalog 拓展了外部数据源的边界,其使用方法也较为简单, 创建 Hive 数据源的 SQL 语句可参考: CREATE CATALOG hive PROPERTIES ( 'type'='hms', 'hive.metastore.uris' = 'thrift://172.21.0.1:7004' ); 在前文提到的用户画像系统中,标签元数据存储在 MySQL, 而明细数据存储在 Doris 中。进行画像圈选服务时,需要分别在 MySQL 与 Doris 两个数据库进行查询,不仅增加了画像系统的复杂度,性能也存在很大的优化空间。我们利用数据湖分析的特性,在 Doris 创建画像元数据的 MySQL Catalog,并规划了两种技术方案: 使用 SQL Join 语法,直接通过 JDBC 协议关联 MySQL 中的元数据 (数据还在 MySQL 中); 通过create table as select * from 源表把画像标签元数据同步到 Doris 内部,从而加速查询,然后再通过调度引擎(如 Apache DolphinScheduler)进行周期性调度, 考虑到方式一在批量加载数据时对 MySQL 业务库可能造成的潜在影响,针对用户画像的场景我们最终选择了方案二。建表语句参考: -- 从 MySQL 导入到 Doris DIM 临时表, 默认 3 副本 create table dim.temp_profile_lable_metadata PROPERTIES("replication_num" = "3") as select * from jm_bg_platform.kc_data_profile.profile_lable_metadata; 实践总结与规划 截至目前,基于 Apache Doris 的大数据算法平台已经接入了近 10 个物流大数据业务线,部署生产集群 2 套,存储数据总量达百亿级规模,覆盖实时数仓、BI 多维分析、用户画像、货运轨迹信息系统等业务场景,查询效率大幅提升,其简洁的开发架构与经济的资源存储方案,为业务与开发人员带来极大便利与效益增长。 基于上述应用场景,我们总结了 Doris 的核心优势,具体如下: 查询性能优越: 无论是即席分析场景的多表复杂关联,还是用户画像、特征、实时报表场景的高 QPS 点查,都可以轻松支持; 数据湖分析能力强大:可轻松与 Hive、Hudi、JDBC、ES 构建统一语法的联邦查询; 功能开放:例如 Java UDF 可以复用 Hive UDF,减少重复造轮子; 有效降本:运维方面,可以按需弹性扩缩容节省资源,方便集群数据迁移;开发方面,多表关联便利,不用再频繁改写 Join; 在业务实践环节,我们也记录了许多生产环境下基于 Doris 的开发经验,在此与诸位分享: MPP 数据库在 OLAP 场景虽然兼容 MySQL 协议,但是不建议当作 MySQL 使用,更适用于大批量的数据写入,而非高并发的单条数据写入; 构建轻量级数仓时,部分场景可以替代 Hive 数仓,尤其是中小规模的数据量并且相对简单的场景; GIS 物联网的场景下使用,可以支持存储 PB 数据级别; 分区表支持原子替换,支持对两个表进行原子的替换操作,不会中断表提供服务; 后续我们将持续深入使用 Apache Doris 的新版功能,并重点关注扩展以下方面: 引入异步物化视图:Apache Doris 在 2.1 版本推出了基于多表的异步物化视图,支持透明改写加速、自动刷新、外表到内表的物化视图以及物化视图直查,此外,还可以用于数据仓库分层建模、作业调度和数据加工等场景。 数据一体能力扩展:此前我们曾向社区提议增强数据集成能力,例如通过 JDBC Catalog 从 MySQL 直接同步数据至 Doris,意见已被社区采纳并改进完成,后续也期待更多的新功能。 增强 GIS 地理信息系统功能:如经纬度距离实时刷新、区域范围搜索提速; 期待整合 AI算法库:增加例如 Spark ML 类的机器学习算法库,整合特征平台与向量数据库。

优秀的个人博客,低调大师

云端智创 | 基于视频AI原理的音视频智能处理技术

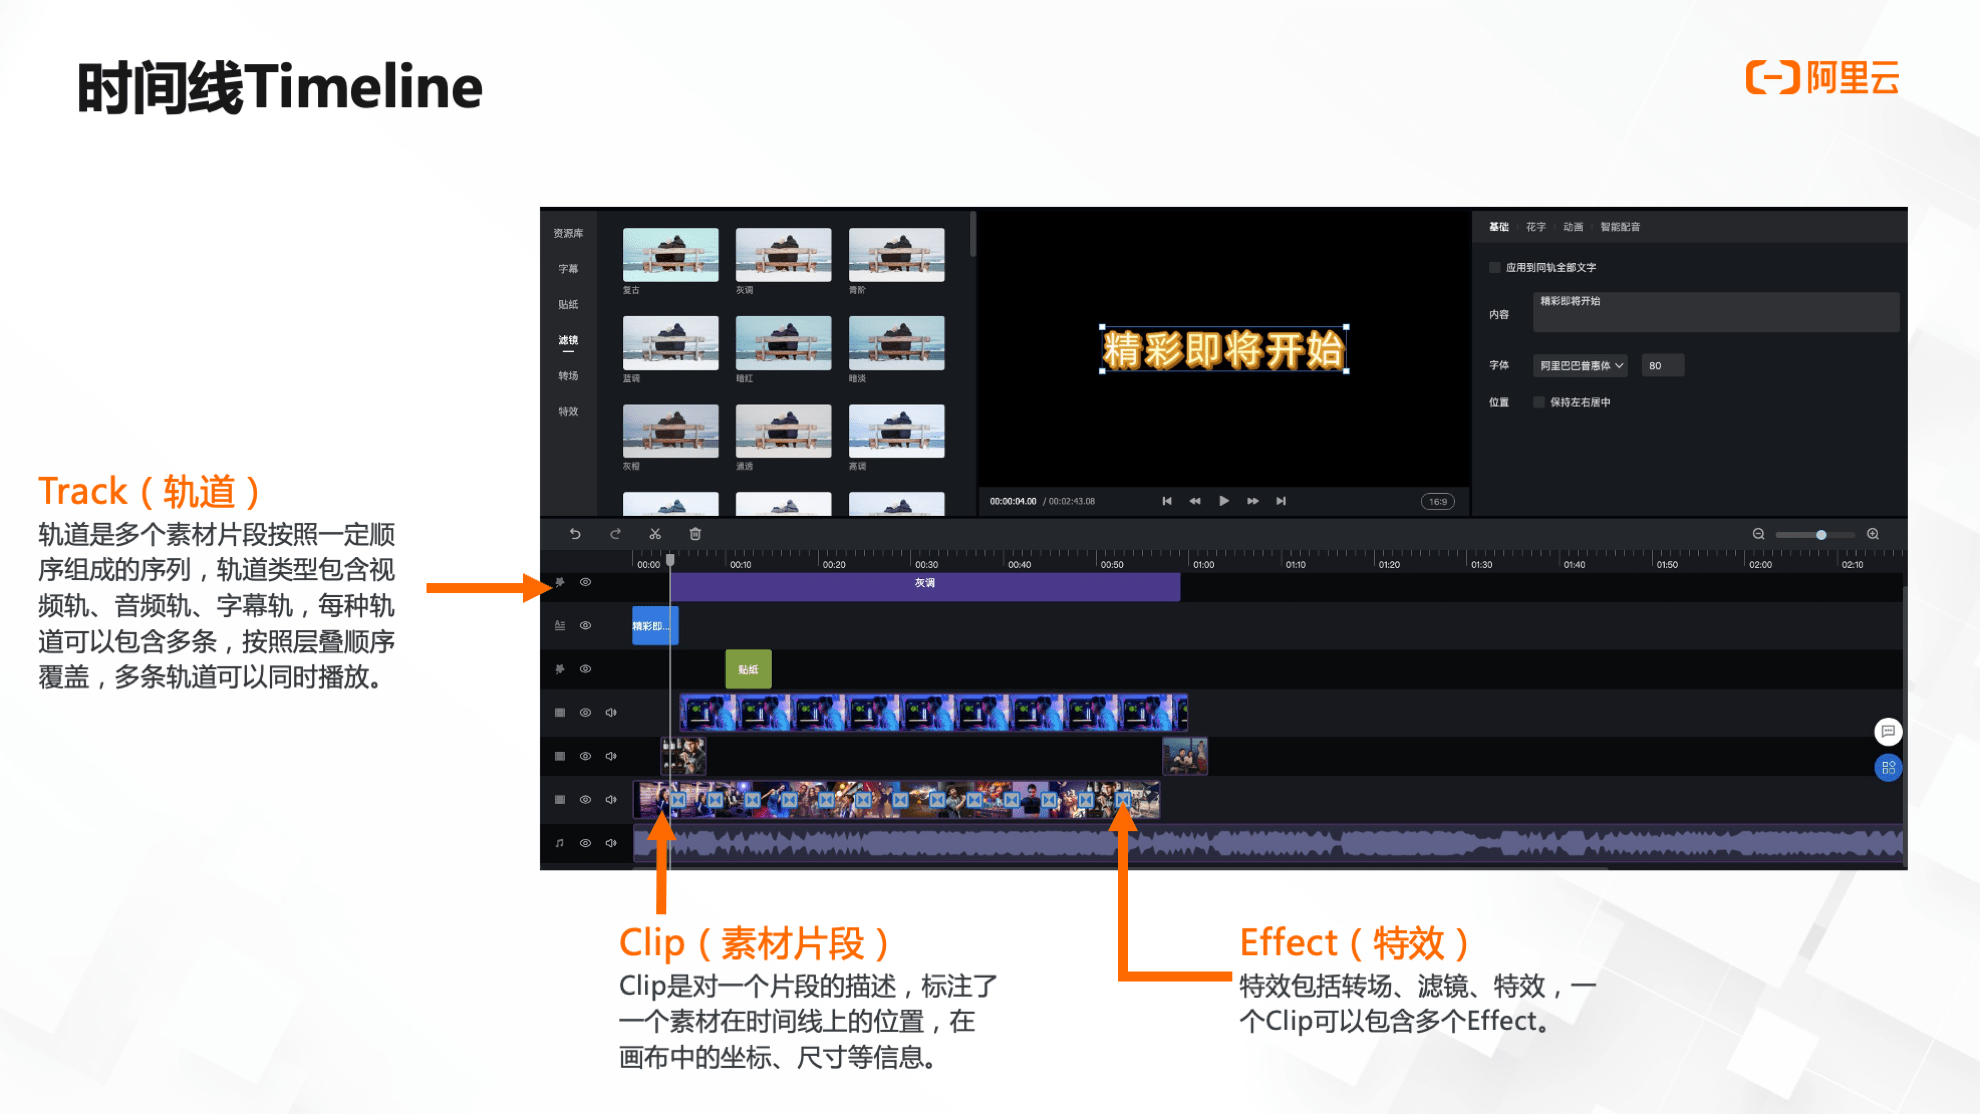
本文内容整理自「智能媒体生产」系列课程第二讲:视频AI与智能生产制作,由阿里云智能视频云高级技术专家分享视频AI原理,AI辅助媒体生产,音视频智能化能力和底层原理,以及如何利用阿里云现有资源使用音视频AI能力。课程回放见文末。 01 算法演进:视频AI原理 在媒体生产的全生命周期中,AI算法辅助提升内容生产制作效率,为创作保驾护航。 智能生产全链路 智能生产全链路可分为五大部分。传统的媒体生产包含采集、编辑、存储、管理和分发五个流程,随着人工智能技术的兴起,五大流程涉及到越来越多的机器参与,其中最主要的便是AI技术的应用。以下举例说明: l 采集 在摄像机拍摄时同步进行绿幕抠图,这在演播室或者影视制作场景中是比较常见的。 l 编辑 编辑过程运用到很多技术,比如横转竖、提取封面、叠加字幕等,同时这些字幕还可以通过语音识别的方式提取出来再叠加在画面上。 l 存储 视频在采集和编辑之后,需要存储下来进行结构化分析,像智能标签就是运用在存储场景,从视频中提取出相应的标签,进行结构化的存储,并把视频库中的视频进行结构化关联。 l 管理 存储下来的视频如何管理?如何通过关键词检索到对应的视频?在管理环节,AI可以帮助进行多模态的检索,比如人物搜索等。 l 分发 在存储和管理之后,视频分发也运用到AI技术,比如音视频DNA、溯源水印等版权保护应用。如果通过直播流的方式对广大用户进行直播,那么分发环节还会涉及到直播审核,以免出现直播故障。 基于智能生产全链路,媒体AI全景图应运而生,共分为四个层次: 最上面的层次表达媒体生产的应用场景,包含智能媒资管理、内容智能生产以及视频版权保护。 往下是产品能力,即AI组合达成的能力,比如视频分类、智能封面、智能抠图等。 再往下是AI原子能力,比如语音识别、自然语言处理这些底层的AI能力。 最下是支撑AI能力的基础底座,如编解码和GPU加速等。以上组合起来,生成一张AI运用在智能生产中的全景图。 视频AI原理 视频AI的底层原理究竟是什么? 人工智能发源于机器学习,而机器学习最早只是一种统计手段,像决策树、支持向量机、随机森林等各种数学方法。 随着时代发展,科学家提出一种人工神经网络的计算方法,或者说算法,后来发现人工神经网络可以变得更大、层次变得更深,经过进一步探索发展,在二十多年前提出了深度学习的观点和概念。 所谓深度学习,就是在原先的人工神经网络上,把中间的层次(我们称之为隐含层)扩展成两个层次、三个层次,甚至发展到现在的几十个层次,即可得到更多的输入层和输出层节点。 当神经网络变得更大、更深的时候,机器学习就演化成深度学习,也就是我们现在俗称的AI。 随之而来产生一个问题:如何将AI运用到视频和图像中? 假如有一个1080P的视频,视频大小为1920✖1080,此时一张图像上就存在百万个像素。如果把百万个像素点都放入神经网络中,会产生巨大的计算量,远远超出常规计算机所能达到的上限。 因此,在把图像放入神经网络前需要进行处理,研究人员提出了卷积神经网络,而这也是现在所有图像和视频AI的基础。 在卷积神经网络的标准模型中,图像进入神经网络之前需要进行两步操作: 第一步是卷积层。所谓卷积就是拿一个卷积核(可以简单理解为一个矩阵)和原始图像的每一个卷积核大小的矩阵进行矩阵层的操作,最后得到一个特征图像。由于有多个卷积核,所以一张图片可以提取出多个特征图像。 特征图像直接放入神经网络还是太大,因此,需要进行第二步池化层操作,池化层的作用就是下采样,可采取多种方式,比如把方格中的最大值、平均值或者加权平均值作为最终输出值,形成下采样数据。 在上述例子中,一张图像的大小降低为原先的四分之一,输入到神经网络之后,极大降低了原始数据量,即可进行图像神经网络处理。由此可见,用通俗的话来讲,视频或图像的AI模型必须是由大数据喂出来的。 大数据天然地长在云上,云和AI天然的结合,可以使AI在云上得到较好的发展与运用。 了解视频AI原理之后,如何反过来评价AI的效果? 以典型的分类问题举例,假如有100个视频,需要找出其中出现过人的视频,那么有两个指标可以评价AI模型的好坏:一个是精度,另一个是召回率。 所谓的精度是指,假设AI算法最终找出50个视频,但是检查之后发现,其中只有40个是真正有人的,那么精度计算为40➗50=0.8。 召回率是指,假设这100个视频中真正有人的一共有80个,而AI找出了其中40个,那么召回率计算为0.5。 可以发现,精度和召回率是一对矛盾。假如想提高精度,只要找出来的视频少一点,就可以保证每个找出来的视频都是对的,即精度上升,但此时召回率一定会下降。 现阶段的AI并不完美,也就是说,目前AI还只能辅助视频生产,生产视频的主体还是人。 AI辅助生产 AI辅助生产可以由以下两个示例进行说明。 示例一:通过图片搜索相关图片或视频。Demo显示,输入一张周星驰的图片后,机器虽然不认识这是谁,但是能够从图片中提取此人的外貌特征,然后在视频库里做相应搜索,找出一堆包含周星驰的视频。 示例二:智能横转竖。传统电影和电视剧均为横屏播放,随着移动互联网兴起,这些电影和电视剧需要在手机端进行投放,由此诞生了智能横转竖这样的AI算法,将大量的横屏视频转换成竖屏视频,帮助横屏视频在手机端分发。 电视剧横转竖效果 新闻横转竖效果 02 智能进阶:视频内容理解 智能标签 智能标签基于AI对于视频内容的理解,自动提取视频中的标签、关键词等信息,分析详情会展示为四部分: 第一部分是视频标签,获取视频的类目,视频出现过哪些人物,人物出现的时间点以及在视频中的位置,人物的相似度等。 第二部分是文本标签,会提炼出一些关键词,包括视频文本中出现过的组织机构,比如央视等。 后面两部分为文字识别和语音识别,分别通过图片OCR技术和语音云识别技术实现。 具体示例可在AI体验馆中进行体验,同时,也提供API接入文档进行参考。 体验中心:https://retina.aliyun.com/#/Label API接入文档:https://help.aliyun.com/document_detail/163485.html AI是如何从视频中提取出信息的呢?从视频标签的流程图中可以看到,输入一个视频,分别进行两部分操作: 一部分是对视频做抽帧处理,抽帧得到的图像通过人像识别、场景识别、物体识别、地标识别、OCR等图像AI识别模型,提炼出视频标签。 另一部分是把视频中的音频提取出来,然后通过ASR得到文本结果,最后再经过NLP(自然语言处理),提取出文本标签。 智能审核 视频审核的技术原理与视频标签相同,唯一不同的是,视频标签可以理解为一个正向的视频内容理解,而视频审核是负向的,审核需要识别出一些不合规的、有问题的内容,比如鉴黄、暴恐涉政、违规、二维码、不良场景等信息。 视频检索 视频检索的核心技术点是利用标签结果进行视频的分析和查询。 视频检索架构图显示,媒资系统中的视频通过媒资特征入库模块,导入到智能标签分析中,并得到一系列的标签,包括视频标签、文本标签,原始的ASR、OCR结果等,将这些结果连同视频的元数据信息比如标题、描述等,利用ElasticSearch开源服务进行文本信息的倒排索引和查询。 视频检索过程中会涉及到精排模块,这需要由业务层来实现。如果只是从ES中把符合检索条件的结果提取出来,不一定能满足业务层需求,比方说业务层面对政治新闻场景时,会要求把某些人物的搜索结果更靠前排序,而这就是精排模块所需要做的工作。 检索系统一般都会根据业务层排序,接入业务接口模块,由此一个基本的检索系统搭建完成。但是,现在的检索系统只能按照文本检索视频。如何通过一张图片,检索到相似的图片或视频呢? 这涉及到视频DNA检索技术。所谓的视频DNA,就是把视频里面的关键帧或者某一镜头提炼出关键信息,我们把它称之为DNA,并把这些信息放入向量数据库中进行检索,更多内容可通过体验中心和接入文档进行拓展了解。 体验中心:https://retina.aliyun.com/#/DNA API接入文档:https://help.aliyun.com/document_detail/93553.html 03 能力升级:音视频智能处理 基于视频内容理解,如何对视频进行智能处理? 绿幕抠图 绿幕抠图是在视频拍摄或者采集时,把背景替换成电脑制作的画面。在演播室场景中,实际拍摄时根据需求,在主持人的背后放置绿幕背景或者蓝幕背景。 影视制作场景同样运用到绿幕抠图,比如科幻片中无法实景拍摄的部分,会在后期进行背景叠加或其他处理工作,通过在人物背后放置绿幕的方式,把人物主体提取出来。 绿幕抠图要求输入的是蓝幕或者绿幕视频,分辨率不超过4K,同时输入一张背景图片,即可输出替换背景后的视频。以下为示例说明:一个人从绿幕前走过,替换背景后,变成此人在背景前走路,整体效果非常自然。 视频链接:https://v.youku.com/v_show/id_XNTk0MDc4Mjc3Mg==.html 视频链接: https://v.youku.com/v_show/id_XNTk0MDc4Mjc5Ng==.html 如何评价绿幕抠图的质量?首先要处理好边缘溢色,比如在头发边缘,由于原始的图像背景是绿幕,头发缝边缘必然会染上一些绿色,技术上需要把这些边缘溢色擦除掉。 此外,如何真实地呈现透明度,并叠加背后的内容,还有运动模糊,地面阴影等,均是绿幕抠图质量好坏的评价点。 横转竖 横转竖是在移动互联网上分发视频的必备处理手段。 传统人工制作横转竖视频的难点在于:一,需要专业的剪辑软件和制作人员,成本高,速度慢;二,在目标移动比较快的场景中,需要逐帧剪裁,工作量巨大;三,剪裁目标区域后,前后帧难以对齐。因此,横转竖视频更适合由机器制作实现。 智能横转竖的算法流程是:首先对视频进行镜头分割,所谓的镜头分割就是在视频制作中,按照不同拍摄机位的转变,识别镜头的切换,并把不同镜头分割开来。 视频链接:https://v.youku.com/v_show/id_XNTk0MDg4MjA0NA==.html 其次是主体选择,在主体选择时,一般选择画面中最醒目的人作为目标,在上述舞蹈场景中,主体就是这个正在跳舞的人。 然后是镜头追踪,每帧图像做好初期选择之后,下一帧都要跟随目标,即框定的图像跟随这个人进行移动。 最后是路径平滑,镜头追踪完成之后,最终生成的竖屏视频必须是平滑的,不能出现翘边等不良效果。更多内容可参见官网: 体验中心:https://retina.aliyun.com/#/H2V API接入文档:https://help.aliyun.com/document_detail/169896.html 其他视频智能处理能力 目前,阿里云视频云提供的视频智能处理能力,可分为以下四类: ROI提取,即感兴趣区域提取,包括绿幕抠图和横转竖; 智能擦除,比如去图标、去字幕; 关键信息提炼,比如智能封面,即从视频中提取出最能表现视频的一张图片;视频摘要,提取出视频中最能表现视频的简短视频; 结构化分析,比如字幕提取,把嵌入在图像中的字幕自动提取出来;PPT拆条,可以将一个课程视频自动拆成段落。 讲完视频智能处理能力,接下来介绍两项音频智能处理能力:副歌识别和节奏检测。 副歌识别 副歌是指歌曲中的高潮片段。副歌识别有何应用场景?比如,很多音乐APP的试听功能,会直接播放歌曲中的高潮片段,人为进行提取相当麻烦,而副歌识别就能很好地完成任务。 副歌识别的算法流程为:输入歌曲之后,首先进行音乐段落检测,然后提取副歌段落,并进行精调使之更贴合,最后再生成副歌片段。 副歌识别的示例显示,通过调用之后,算法会返回两个结果值,即副歌的开始时间点和结束时间点。 大家可以对返回的结果和音频进行对照,从72秒副歌开始,到102秒副歌结束,副歌识别结果还是非常准确的。 节奏检测 节奏检测即识别音乐中的节奏点,其主要应用场景为视频制作和音乐推荐,比如,通过识别出音乐节奏点,进行鬼畜视频的制作;通过识别音乐的节拍类型,是四三拍还是四四拍,帮助进行音乐分类等。 继续以上述音频示例,节奏检测算法输出两个结果:第一个是节拍时间点,如0.46秒、0.96秒均为节拍时间点;第二个是downbeat时间点,在乐理中解释为重拍,其中0.46秒为第一拍,2.46秒为第五拍,也就是说每四拍为一个小节,每小节的第一拍为重拍,由此检测出该音乐的节奏。 其他音频智能处理能力 此外,视频云还提供其他音频智能处理能力,包括混音,ASR语音识别和TTS语音合成。混音即把两个音乐片段进行叠加,其中涉及到音量增益和自动控制算法。 这些能力进行组合,还可以实现更多玩法,比如歌曲串烧,首先通过副歌识别,把几首歌曲的副歌部分提取出来,然后进行节奏检测,把合适的节拍点合在一起,最终组合成一首完整的歌曲串烧。 04 开箱即用:阿里云媒资服务 基于视频AI原理以及效果,阿里云利用现有资源,提供更方便、更高效的音视频AI使用能力。 MPS服务 MPS是媒体处理的英文简称。阿里云提供针对多媒体的数据处理服务,将媒体处理过程抽象成两种模式:一种是输入音视频等多媒体文件,经过智能化媒体处理,生成一个新的媒体文件,比如之前提到的智能横转竖。 另一种模式是输入一个媒体文件,输出经过媒体处理分析后的一系列结构化数据,比如智能标签或智能审核。 MPS支持多项音视频智能处理能力,此外,MPS的媒体文件类型,既可以输入OSS文件,也支持输入网络URL地址。 MPS接口调用的流程为: 第一步,开通MPS产品,在开通的过程中,控制台会引导进行增加权限等相关操作。 开通MPS产品:https://www.aliyun.com/product/mts 第二步,调用MPS的Open API接口,获得Access Key,包括AK的ID和密钥。所有阿里云的Open API都要通过AK和SK访问。 使用RAM服务获取AccessKey:https://ram.console.aliyun.com/manage/ak 第三步,认真阅读MPS提供的API文档:https://help.aliyun.com/document_detail/29210.html 第四步,针对开发需要,选用不同编程语言,并安装依赖模块:https://help.aliyun.com/document_detail/188024.html 第五步,编写代码。 阿里云MPS服务提供的智能化能力可以分为四个维度: 一是视频内容理解,包含智能标签,智能审核,媒体DNA,媒体DNA是视频检索中的重要组成部分,还有智能封面、视频摘要等。 二是视频智能处理,像横转竖、去图标、去字幕、字幕提取等,从电视剧或电影中抽取出字幕,并输出TXT或者SRT格式,此外,也包括绿幕抠图和PPT拆条等。 三是音频智能处理,包含副歌检测、混音处理、节奏检测和音质检测等。 四是图片智能处理,包含横转竖、去图标和人像风格化。人像风格化可以把一张人像图片风格化成不同的形式,比如把人像进行卡通化,或者进行3D处理。 IMS服务 IMS服务是阿里云近年来新上的服务,全称是智能媒体服务,和MPS服务的区别在于: IMS服务围绕直播和点播场景,是针对媒体处理的全流程服务,可认为是MPS服务的重大产品迭代和升级。 第一,IMS不仅针对于单个媒体处理过程,而是对于媒体服务全流程、全生产周期的管理和制作; 第二,IMS的集成度更高,不光可以进行单个原子能力的音视频处理,还可以进行媒资管理、工作流触发等,让开发者更方便地使用音视频智能化能力; 第三,IMS更智能,后续所有智能化能力升级后都会集中体现在IMS服务中。 IMS控制台融合了媒资管理,媒资库中的音频视频文件,包括图片、辅助的媒资,都可以通过IMS服务进行展示和管理。 利用多模检索的智能化能力,IMS可以实现多媒体文件的智能化检索。传统的音视频文件检索,只能针对标题或者简介进行,而IMS支持对上传的音视频文件做AI自动分类,并根据分类结果进行搜索,同时,也支持对视频中的文字进行自动识别检索。 比如,新闻联播的画面中出现了“康辉”两个字样,虽然视频文件的标题和简介里都没有出现过“康辉”,但在搜索“康辉”时,AI还是可以搜索识别出此视频文件,这就是多模检索的能力。 Retina多媒体AI体验中心 上述MPS和IMS服务的智能化能力,都需要通过Open API调用或者控制台开通使用,而Retina体验中心可以让大家更方便快捷地进行体验,只需上传视频或图片,就可以直观地得到经过智能化处理后的结果。 例如,在Retina平台,你可以体验人像卡通化的效果,只需上传一张人像图片,经过自动处理,就能获得童话风格的卡通人像图片,更多体验就在:http://retina.aliyun.com/ 随着视频与AI技术的发展和演进,AI在媒体生产领域中发挥着越来越重要的作用,以更快的速度、更高的效率完成之前难以实现的事情。 未来,AI将从辅助媒体生产,逐渐转变为直接生产有意义、有价值、有情感的视频,进一步加速媒体生产制作全自动处理进程。 更多完整内容详见课程回放 ⬇️ 视频链接:https://v.youku.com/v_show/id_XNTk0MjQ4Mjk5Mg==.html

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册