首页 文章 精选 留言 我的

精选列表

搜索[JavaScript库],共10000篇文章
优秀的个人博客,低调大师

12306的西天取经路 - 春节抢票与PostgreSQL数据库设计思考

标签 PostgreSQL , 12306 , 春节 , 一票难求 , 门禁广告 , 数组 , 范围类型 , 抢购 , 排他约束 , 大盘分析 , 广告查询 , 火车票 背景 马上春节了,又到了火车票的销售旺季,一票难求的问题依旧存在吗? 还记得10年前春节前买火车票得在放票前1天搬个小板凳去排队,对于热门路线,排一个晚上都有可能买不到票。 随着互联网的发展,几年前建设了12306网上购票系统,可以从电脑上买票,但是不要以为在电脑上就能买到票。 我记得12306刚推出时,经常发生12306网站打不开,无法付款的问题。 为什么呢? 原因很简单,春节期间网上购票的人可能达到几亿的级别,而且放票日期是同一天同一个时间点,也就是说同一时刻12306要接受几亿用户的访问。 处理能力和实际的访问需求更不上,带来的结果就是网站打不开,系统不稳定

优秀的个人博客,低调大师

企业销售 AI 助手落地:知识库、混合检索与口径约束的工程实践

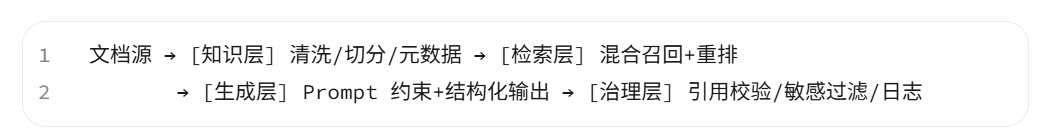
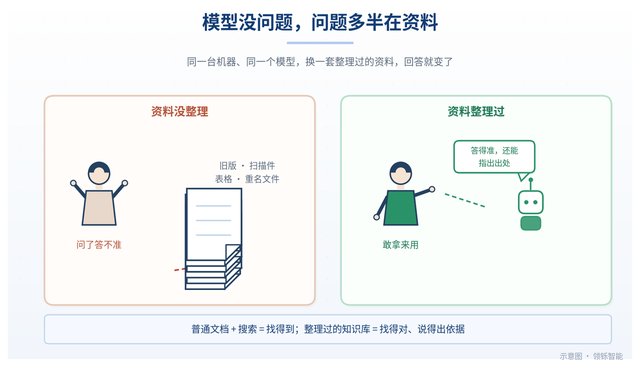
给一家通讯运营商的地市分公司做全员 AI 落地时,我们很快发现:通用的 AI 助手在真实业务里几乎不可用。原因不是模型不行,而是它"不知道这个单位的规定",输出的每一句都要人工核对,一线自然不敢用。 于是我们把问题重新定义成一个工程问题:如何构建一个答案可溯源、口径可控、能按岗位隔离的企业问答助手。下面是这次落地的技术拆解。 一、整体架构 系统分四层,职责清晰、可独立迭代: ![](https://developer.qcloudimg.com/http-save/yehe-12808664/a9bfc0784883da4e94aef8efed1b9c18.png) 二、知识层:切分与元数据是效果上限 2.1 切分策略 直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法: - 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk; - chunk 长度控制在 300–600 字,超长再按语义段落二次切分; - 相邻 chunk 保留 10%–15% 重叠,避免边界信息丢失; - 表格单独处理:转成"表头+行"的键值对文本,不要把表格拍平成乱序字符。 图片2.2 元数据 Schema关键设计原则:生成层不负责"记事实",事实只从检索结果来。模型只做归纳与表达,所有事实性内容必须带引用,否则不输出。 二、知识层:切分与元数据是效果上限 2.1 切分策略 直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法: - 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk; - chunk 长度控制在 300–600 字,超长再按语义段落二次切分; - 相邻 chunk 保留 10%–15% 重叠,避免边界信息丢失; - 表格单独处理:转成"表头+行"的键值对文本,不要把表格拍平成乱序字符。关键设计原则:生成层不负责"记事实",事实只从检索结果来。模型只做归纳与表达,所有事实性内容必须带引用,否则不输出。 二、知识层:切分与元数据是效果上限 2.1 切分策略 直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法: - 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk; - chunk 长度控制在 300–600 字,超长再按语义段落二次切分; - 相邻 chunk 保留 10%–15% 重叠,避免边界信息丢失; - 表格单独处理:转成"表头+行"的键值对文本,不要把表格拍平成乱序字符。关键设计原则:生成层不负责"记事实",事实只从检索结果来。模型只做归纳与表达,所有事实性内容必须带引用,否则不输出。 二、知识层:切分与元数据是效果上限 2.1 切分策略 直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法: - 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk; - chunk 长度控制在 300–600 字,超长再按语义段落二次切分; - 相邻 chunk 保留 10%–15% 重叠,避免边界信息丢失; - 表格单独处理:转成"表头+行"的键值对文本,不要把表格拍平成乱序字符。关键设计原则:生成层不负责"记事实",事实只从检索结果来。模型只做归纳与表达,所有事实性内容必须带引用,否则不输出。 二、知识层:切分与元数据是效果上限 2.1 切分策略 直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法: - 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk; - chunk 长度控制在 300–600 字,超长再 元数据决定了"能不能按岗位隔离、能不能按生效时间取最新版"。我们给每个 chunk 挂这套字段: 图片 检索时先按 dept + security_level + 有效期 过滤,再做语义匹配——这一步比换更大的模型更能提升准确率。 三、检索层:混合召回 + 重排 纯向量检索对"制度编号、专有名词、缩写"不敏感,纯关键词又不懂同义表达。我们用混合检索: - BM25 召回 Top 20; - 向量召回 Top 20; - RRF(Reciprocal Rank Fusion)融合去重; - 用轻量重排模型取 Top 5 喂给生成层。 图片实践中,混合检索把"答非所问"的比例从约 3 成降到 1 成以内,收益远大于单纯调 Prompt。 四、生成层:Prompt 约束与结构化输出 Prompt 的核心不是"让它聪明",而是"让它守规矩"。模板固定四段:角色、约束、输出格式、兜底。 图片结构化输出的好处:下游可以自动校验引用是否真实存在于检索结果,引用对不上就直接拦截重答——这就是"可审、可回溯"的工程实现。 五、治理层:三道闸 - 引用校验:citations 必须命中本次检索返回的 chunk_id,否则判为幻觉,打回。 - 敏感过滤:涉客信息、对外口径按 security_level 与白名单过滤。 - 低置信转人工:confidence 模型能力。文档乱、过期、互相矛盾,换再强的模型也没用。先做文档治理。 - 权限必须前置到检索层,不能靠 Prompt 说"不要回答"——那是拦不住的。 - 版本与会话隔离。制度更新要能增量重建索引,旧答案要能标记失效。 - 不要追求全自动。低置信转人工不是缺陷,是设计。 结语 企业问答助手的难点,从来不是"接一个大模型",而是把组织的规章制度变成可检索、可引用、可审计的结构化知识。这一层做扎实了,模型只是最后一公里的表达。 以上是这次落地的技术骨架,欢迎在评论区交流你们在 RAG 切分和权限隔离上的做法。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册