首页 文章 精选 留言 我的

精选列表

搜索[MSA技术],共10000篇文章
优秀的个人博客,低调大师

优酷外挂字幕技术实践

作者| 阿里文娱无线开发专家 黄陂 优酷外挂字幕的目标是实现对全平台和全机型的覆盖,同时能支持 ass 之外的多种字幕格 式、支持字幕互动等多种创新玩法。本文将分享我们对外挂字幕的探索与实践。 一、字幕的简单科普 在开始之前,先科普一些字幕知识。一般而言,字幕分为硬字幕、软字幕和外挂字幕。 硬字幕,或者叫内嵌字幕是视频生产时就直接叠加到视频画面上的,字幕不可取消、不可编辑更改,不支持多语言及国际化。软字幕是将字幕与视频打包在一起,形成独立于音频和视 频 track 流的单独一路 subtitle track 流,整体打包在视频文件中。我们今天介绍的外挂字幕,是将字幕做成一个独立文件,这些字幕文件可以有多种格式, 独立下发及展示。优点是不破坏视频画面,可随时根据需要更换字幕语言,并且可随时编辑字 幕内容并重新生产发布;缺点是由于字幕文件单

优秀的个人博客,低调大师

解密 云HBase 冷热分离技术原理

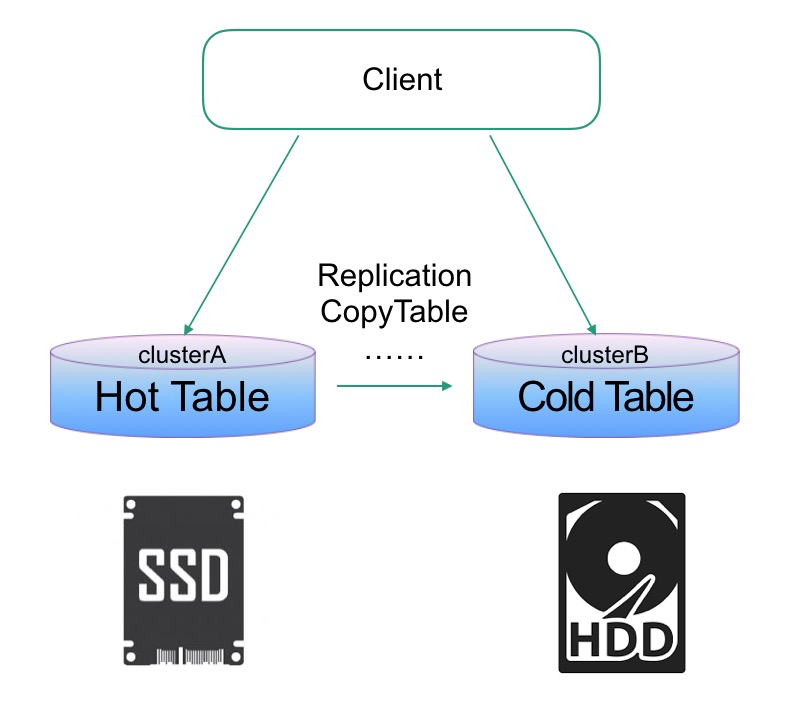
前言 HBase是当下流行的一款海量数据存储的分布式数据库。往往海量数据存储会涉及到一个成本问题,如何降低成本。常见的方案就是通过冷热分离来治理数据。冷数据可以用更高的压缩比算法(ZSTD),更低副本数算法(Erasure Coding),更便宜存储设备(HDD,高密集型存储机型)。 HBase冷热分离常见解决方案 1.主备集群 备(冷)集群用更廉价的硬件,主集群设置TTL,这样当数据热度退去,冷数据自然只在冷集群有。 优点:方案简单,现成内核版本都能搞缺点:维护开销大,冷集群CPU存在浪费 1.x版本的HBase在不改内核情况下,基本只能有这种方案。 2.HDFS Archival Storage + HBase CF-level Storage Policy 需要在2.x之后的版本才能使用。结合HDFS分层存储能力 + 在Table层面指定数据存储策略,实现同集群下,不同表数据的冷热分离。 优点:同一集群冷热分离,维护开销少,更灵活的配置不同业务表的策略缺点:磁盘配比是个很大的问题,不同业务冷热配比是不一样的,比较难整合在一起,一旦业务变动,集群硬件配置是没法跟着变的。 云HBase冷热分离解决方案 上述2套方案都不是最好的方案,对于云上来说。第一套方案就不说了,客户搞2个集群,对于数据量不大的客户其实根本降不了成本。第二套方案,云上客户千千万,业务各有各样,磁盘配置是很难定制到合适的状态。 云上要做 cloud native 的方案,必须满足同集群下,极致的弹性伸缩,才能真正意义上做到产品化。云上低成本,弹性存储,只有OSS了。所以很自然的想到如下架构: 实现这样的架构,最直接的想法是直接改HBase内核:1)增加冷表数据标记 2)根据标记增加写OSS的IO路径。 这样做的缺陷非常明显,你的外部系统(如:备份恢复,数据导入导出)很难兼容这些改动,他们需要感知哪些是冷文件得去OSS哪个位置读,哪些是热文件得去部署在云盘上的HDFS上读。这些本质上都是一些重复的工作,所以从架构设计角度来看必须抽象出一层。这一层能读写HDFS文件,读写OSS文件,感知冷热文件。这一层也就是我最后设计出的ApsaraDB FileSystem,实现了Hadoop FileSystem API。对于HBase,备份恢复,数据导入导出等系统只要替换原先FileSystem的实现即可获得冷热分离的功能。 下面将详细阐述,这套FileSystem设计的细节与难点。 ApsaraDB FileSystem 设计 核心难点A 1.OSS并非文件系统 OSS并不是一个真正意义上的文件系统,它仅仅是两级映射 bucket/object,所以它是对象存储。你在OSS上看到类似这样一个文件:/root/user/gzh/file。你会以为有3层目录+1个文件。实际上只有一个对象,这个对象的key包含了/字符罢了。 这么带来的一个问题是,你要想在其上模拟出文件系统,你必须先能创建目录。很自然想到的是用/结尾的特殊对象代表目录对象。Hadoop社区开源的OssFileSystem就是这么搞的。有了这个方法,就能判断到底存不存在某个目录,能不能创建文件,不然会凭空创建出一个文件,而这个文件没有父目录。 当然你这么做依然会有问题。除了开销比较大(创建深层目录多次HTTP请求OSS),最严重的是正确性的问题。试想一下下面这个场景:把目录/root/user/source rename 成 /root/user/target。这个过程除了该目录,它底下的子目录,子目录里的子文件都会跟着变。类似这样:/root/user/source/file => /root/user/target/file。这很好理解,文件系统就是一颗树,你rename目录,实际是把某颗子树移动到另一个节点下。这个在NameNode里的实现也很简单,改变下树结构即可。 但是如果是在OSS上,你要做rename,那你不得不递归遍历/root/user/source把其下所有目录对象,文件对象都rename。因为你没法通过移动子树这样一个简单操作一步到位。这里带来的问题就是,假设你递归遍历到一半,挂了。那么就可能会出现一半目录或文件到了目标位置,一半没过去。这样rename这个操作就不是原子的了,本来你要么rename成功,整个目录下的内容到新的地方,要么没成功就在原地。所以正确性会存在问题,像HBase这样依赖rename操作将临时数据目录移动到正式目录来做数据commit,就会面临风险。 2.OSS rename实则是数据拷贝 前面我们提到了rename,在正常文件系统中应该是一个轻量级的,数据结构修改操作。但是OSS并没有rename这个操作实际上,rename得通过 CopyObject + DeleteObject 两个操作完成。首先是copy成目标名字,然后delete掉原先的Object。这里有2个明显的问题,一个是copy是深度拷贝开销很大,直接会影响HBase的性能。另一个是rename拆分成2个操作,这2个操作是没法在一个事物里的,也就是说:可能存在copy成功,没delete掉的情况,此时你需要回滚,你需要delete掉copy出来的对象,但是delete依然可能不成功。所以rename操作本身实现上,正确性就难以保证了。 解决核心难点A 解决上面2个问题,需要自己做元数据管理,即相当于自己维护一个文件系统树,OSS上只放数据文件。而因为我们环境中仍然有HDFS存储在(为了放热数据),所以直接复用NameNode代码,让NodeNode帮助管理元数据。所以整体架构就出来了: ApsaraDB FileSystem(以下简称ADB FS)将云端存储分为:主存(PrimaryStorageFileSystem)和 冷存(ColdStorageFileSystem)。由ApsaraDistributedFileSystem类(以下简称ADFS)负责管理这两类存储文件系统,并且由ADFS负责感知冷热文件。 ApsaraDistributedFileSystem: 总入口,负责管理冷存和主存,数据该从哪里读,该写入哪里(ADFS)。主存:PrimaryStorageFileSystem 默认实现是 DistributedFileSystem(HDFS)冷存:ColdStorageFileSystem 默认实现是 HBaseOssFileSystem(HOFS) ,基于OSS实现的Hadoop API文件系统,可以模拟目录对象单独使用,也可以只作为冷存读写数据,相比社区版本有针对性优化,后面会讲。 具体,NameNode如何帮助管理冷存上的元数据,很简单。ADFS在主存上创建同名索引文件,文件内容是索引指向冷存中对应的文件。实际数据在冷存中,所以冷存中的文件有没有目录结构无所谓,只有一级文件就行。我们再看下一rename操作过程,就明白了: rename目录的场景也同理,直接在NameNode中rename就行。对于热文件,相当于全部代理HDFS操作即可,冷文件要在HDFS上创建索引文件,然后写数据文件到OSS,然后关联起来。 核心难点B 引入元数据管理解决方案,又会遇到新的问题:是索引文件和冷存中数据文件一致性问题。我们可能会遇到如下场景: 主存索引文件存在,冷存数据文件不存在 冷存数据文件存在,主存索引文件不存住 主存索引文件信息不完整,无法定位冷存数据文件 先排除BUG或者人为删除数据文件因素,上诉3种情况都会由于程序crash产生。也就是说我们要想把法,把生成索引文件,写入并生成冷数据文件,关联,这3个操作放在一个事物里。这样才能具备原子性,才能保证要么创建冷文件成功,那么索引信息是完整的,也指向一个存在的数据文件。要么创建冷文件失败(包括中途程序crash),永远也见不到这个冷文件。 解决核心难点B 核心思想是利用主存的rename操作,因为主存的rename是具备原子性的。我们先在主存的临时目录中生产索引文件,此时索引文件内容已经指向冷存中的一个路径(但是实际上这个路径的数据文件还没开始写入)。在冷存完成写入,正确close后,那么此时我们已经有完整且正确的索引文件&数据文件。然后通过rename一把将索引文件改到用户实际需要写入到目标路径,即可。 如果中途进程crash,索引文件要么已经rename成功,要么索引文件还在临时目录。在临时目录我们认为写入没有完成,是失败的。然后我们通过清理线程,定期清理掉N天以前临时目录的文件即可。所以一旦rename成功,那目标路径上的索引文件一定是完整的,一定会指向一个写好的数据文件。 为什么我们需要先写好路径信息在索引文件里?因为如果先写数据文件,在这个过程中crash了,那我们是没有索引信息指向这个数据文件的,从而造成类似“内存泄漏”的问题。 冷热文件标记 对于主存,需要实现给文件冷热标记的功能,通过标记判断要打开怎样的数据读写流。这点NameNode可以通过给文件设置StoragePolicy实现。这个过程就很简单了,不详细赘述,下面说HBaseOssFileSystem写入优化设计。 HBaseOssFileSystem 写入优化 在说HOFS写设计之前,我们先要理解Hadoop社区版本的OssFileSystem设计(这也是社区用户能直接使用的版本)。 社区版本写入设计 Write -> OutputStream -> disk buffer(128M) -> FileInputStream -> OSS 这个过程就是先写入磁盘,磁盘满128M后,将这128M的block包装成FileInputStream再提交给OSS。这个设计主要是考虑了OSS请求成本,OSS每次请求都是要收费的,但是内网流量不计费。如果你1KB写一次,费用就很高了,所以必须大块写。而且OSS大文件写入,设计最多让你提交10000个block(OSS中叫MultipartUpload),如果block太小,那么你能支持的最大文件大小也是受限。 所以要攒大buffer,另外一个因素是Hadoop FS API提供的是OutputStream让你不断write。OSS提供的是InputStream,让你提供你要写入内容,它自己不断读取。这样你必然要通过一个buffer去转换。 这里会有比较大的一个问题,就是性能慢。写入磁盘,再读取磁盘,多了这么两轮会比较慢,虽然有PageCache存在,读取过程不一定有IO。那你肯定想,用内存当buffer不就好了。内存当buffer的问题就是前面说的,有费用,所以buffer不能太小。所以你每个文件要开128M内存,是不可能的。更何况当你提交给OSS的时候,你要保证能继续写入新数据,你得有2块128M内存滚动,这个开销几乎不能接受。 HBaseOssFileSystem 写入设计 我们既要解决费用问题,也要解决性能问题,同时要保证开销很低,看似不可能,那么怎么做呢? 这里要利用的就是这个InputStream,OSS让你提供InputStream,并从中读取你要写入的内容。那么我们可以设计一个流式写入,当我传入这个InputStream给OSS的时候,流中并不一定得有数据。此时OSS调read读取数据会block在read调用上。等用户真的写入数据,InputStream中才会有数据,这时候OSS就能顺利读到数据。当OSS读了超过128M数据时候,InputStream会自动截断,返回EOF,这样OSS会以为流已经结束了,那么这块数据就算提交完成。 所以我们本质只要开发这么一个特殊的InputStream即可。用户向Hadoop API提供的OutputStream中写入数据,数据每填满一个page(2M)就发给InputStream让其可读取。OuputStream相当于生产者,InputStream相当于消费者。这里的内存开销会非常低,因为生产者速度和消费者速度相近时,也就2个page的开销。最后将这整套实现封装成OSSOutputStream类,当用户要写入冷文件时,实际提供的是OSSOutputStream,这里面就包含了这个特殊InputStream的控制过程。 当然实际生产中,我们会对page进行控制,每个文件设置最多4个page。并且这4个page循环利用,减少对GC对影响。所以最后我们得到下面一个环形缓冲的写入模式: 性能对比1:社区版本 vs 云HBase版 因为不用写磁盘,所以写入吞吐可以比社区的高很多,下图为HBase1.0上测试结果。在一些大KV,写入压力更大的场景,实测可以接近1倍。这个比较是通过替换ADFS冷存的实现(用社区版本和云HBase版本),都避免了rename深拷贝问题。如果直接裸用社区版本而不用ADFS那性能会差数倍。 性能对比2:热表 vs 冷表 热表数据在云盘,冷表数据在OSS。 得益于上述优化,加上冷表WAL也是放HDFS的,并且OSS相对HBase来说是大集群(吞吐上限高),冷表的HDFS只用抗WAL写入压力。所以冷表吞吐反而会比热表略高一点点。 不管怎么说,冷表的写入性能和热表相当了,这样的表现已经相当不错了。基本是不会影响用户灌数据,否则使用冷存后,吞吐掉很多,那意味着要更多机器,那这功能就没什么意义了。 总结 这大约是1年多前落地的项目,已经稳定运行很久。之前也有出去分享过,但是没有今天这么细致。现在写出来主要是自我总结下。当设计一个服务去解决某个问题的时候,上下游的关系,可能存在的问题得考虑清楚。在做这个项目最初的时候,想把HBase直接架设在社区版本OssFileSytem上,发现性能不行外,正确性也存在很大风险。不断思考,考虑各种情况后才有了今天这套方案。

优秀的个人博客,低调大师

2019/11/25 Android 开发技术周报

阿里P7移动互联网架构师进阶视频(每日更新中)免费学习请点击:https://space.bilibili.com/474380680 教程 Android App 启动优化全记录开源库1.Android-GetAPKInfo 获取Android应用基本信息的工具集 2.DialogV3 :fire:空祖家的对话框工具V3版,集成三种风格+夜间模式对话框,以及等待、提示、分享等特色对话框,支持花式自定义 3.PathLayoutManager RecyclerView的LayoutManager,轻松实现各种炫酷、特殊效果 4.ThreadPoster Lightweight library for explicit and unit testable multithreading in Android. 5.layercach Caching made simple for Android and Java. 6.Tracker Tracker 是Android 上的一个用户行为跟踪框架,根据预先订阅的事件链,以观察者模式监听用户的行为,当用户的行为与订阅的一样时,通知给订阅者。 7.SwipeCardRecyclerView 利用RecyelerView打造的炫酷滑动卡片,支持左滑右滑删除 8.Doki An Android library that displays information from dontkillmyapp.com to users in a clean and presentable manner. 9.Slimber Built upon Timber. Without performance penality. 10.LiquidSwipe Android LiquidSwipe Library 11.GButton A simple library that can implement custom google sign in button in your android app. 12.DslAdapter :fire: Kotlin时代的Adapter, Dsl 的形式使用 RecyclerView.Adapter, 支持情感图状态切换, 加载更多, 多类型Item等 13.RxTest Kotlin DSL for easier RxJava testing. 14.Jhash Password hashing utility in Java. It can hash passwords with PBKDF2 hmac SHA1/SHA256/SHA512, BCRYPT, or SCRYPT, and it salts automatically and has a pepper option. 示例 1.Books Jetpack A sample application to demonstrate how to use Jetpack Architecture Components in an Android Application following the Clean Architecture concepts. 2.TbsForOffice 文档在线或者本地预览,应用内打开Office(Word,PPT,PDF,Excel)文件,基于腾讯X5浏览服务 App 1.易开发 一款帮助开发人员快速开发的工具,功能包括界面分析,页面信息,加固脱壳,支持Android9.0 2.VirtualUETool VirtualUETool 扩展自UETool实现,底层基于VirtualApp的实现。可以作用于任何App在屏幕上显示的 view,比如 Activity/Fragment/Dialog/PopupWindow 等等。 插件 1.Gradle "Trust All" Plugin A gradle plugin to disable SSL certificate validation 工具 1.cpdf-binaries PDF Command Line Tools binaries for Linux, Mac, Windows. 2.Music-dl 从网易云音乐、QQ音乐、酷狗音乐、百度音乐、虾米音乐、咪咕音乐等搜索和下载歌曲 3.LuLu LuLu is the free macOS firewall: 4.百度网盘快速加解密工具 5.Memex 可以对浏览器书签和浏览历史进行全文搜索的插件 新闻 1.知名Android root神器停止营业:时至今日你还root吗 2.Google Project Zero描述了一个Android 0day 漏洞Bad Binder 3.Google 描绘 Android 支持主线 Linux 内核的计划 4.Google试图将Android设备内核统一至Linux内核主线 视频 Jetpack Compose 的最新进展 | AndroidDevSummit 中文字幕视频 Fun 1.OpenDiablo2 An open source re-implementation of Diablo 2 https://opendiablo2.com/原文链接:https://androidweekly.io/android-dev-weekly-issue-256/?utm_source=tuicool&utm_medium=referral阿里P7移动互联网架构师进阶视频(每日更新中)免费学习请点击:https://space.bilibili.com/474380680

优秀的个人博客,低调大师

java技术案例--封装JDBC工具类

JDBC简介-JDBC(Java DataBase Connectivity,java数据库连接)是一种用于执行SQL语句的Java API,可以为多种关系数据库提供统一访问,它由一组用Java语言编写的类和接口组成。JDBC提供了一种基准,据此可以构建更高级的工具和接口,使数据库开发人员能够编写数据库应用程序 -Java 具有坚固、安全、易于使用、易于理解和可从网络上自动下载等特性,是编写数据库应用程序的杰出语言。所需要的只是 Java应用程序与各种不同数据库之间进行对话的方法。 -JDBC可以在各种平台上使用Java,如Windows,Mac OS和各种版本的UNIX。 -JDBC库包括通常与数据库使用相关的下面提到的每个任务的API。 JDBC实现验证登录代码思路*键盘输入用户名和密码,对比数据库中的用户信息,判断是否登录成功*1、连接数据库 *MyJDBCUtils.getConnection() *2、获取请求对象stmt *conn.createStmtement() *3、创建键盘对象,获取用户名和密码 *3.1创建键盘录入对象 *3.2提示用户输入 *3.3获取用户输入内容 *4、编写SQL语句,把用户名和密码放入SQL语句中 *5、执行查询,获取查询结果 *stmt.executeQuery(sql); *6、根据查询结果判断登录是否成功*7、关闭连接 Java工具类在java开发过程中,代码中时常用到一些Scanner、Random一样的类,他们是键盘录入,生成随机数的类,像一个工具一样,在java中被称为工具类。 我们在编写自己的代码时,有的代码功能和java工具类似,比如连接数据库、验证登录,时长会用得到,每次都书写一次太麻烦,我们可以尝试编写自己的工具类,每次用到的时候直接导包调用就行,能提高我们的开发效率。 封装JDBC工具类加入获取数据库连接对象的方法加入释放连接的方法代码如下: 工具类代码: package com.qianfeng.util; import java.sql.Connection; import java.sql.DriverManager; import java.sql.ResultSet; import java.sql.SQLException; import java.sql.Statement; /** * JDBC工具类 * 有获取连接的方法 * @author dushine */ public class JDBCUtil { /** * 获取数据库连接的方法 * @return Connection conn * @throws SQLException */ public static Connection getConnection() throws SQLException { String url = "jdbc:mysql://localhost:3306/class?useSSL=false"; String user = "root"; String password = "root"; Connection conn = DriverManager.getConnection(url,user,password); return conn; } /** * 释放连接的方法 * @param conn * @throws SQLException */ public static void releaseSourse(Connection conn) throws SQLException { if (conn != null) { conn.close(); } } /** * 释放连接的方法 * @param conn 数据库连接对象 * @param stmt 执行SQL语句的对象 * @throws SQLException */ public static void releaseSourse(Connection conn,Statement stmt) throws SQLException { if (stmt != null) { stmt.close(); } if (conn != null) { conn.close(); } } /** * 释放连接的方法 * @param conn 数据库连接对象 * @param stmt 执行SQL语句的对象 * @param resultSet 执行SQL语句的返回的结果集 * @throws SQLException */ public static void releaseSourse(Connection conn,Statement stmt,ResultSet resultSet) throws SQLException { if (resultSet != null) { resultSet.close(); } if (stmt != null) { stmt.close(); } if (conn != null) { conn.close(); } } } 测试类代码: package com.qianfeng.demos; import java.sql.Connection; import java.sql.ResultSet; import java.sql.Statement; import java.util.Scanner; import com.qianfeng.util.JDBCUtil; public class Demo04 { public static void main(String[] args) throws Exception { /** * 登录注册 * 获取用户输入内容 * 把输入的内容当做条件查询数据库中的内容 */ Scanner sc = new Scanner(System.in); System.out.println("请输入用户名:"); String name = sc.nextLine(); System.out.println("请输入密码:"); String pwd = sc.nextLine(); // 注册驱动 Class.forName("com.mysql.jdbc.Driver"); /* String url = "jdbc:mysql://localhost:3306/class?useSSL=false"; String user = "root"; String password = "root"; // 获取和数据库的连接 Connection conn = DriverManager.getConnection(url, user, password);*/ Connection conn = JDBCUtil.getConnection(); // 使用连接对象获取执行sql的对象 Statement stmt = conn.createStatement(); // 编写SQL语句 String sql = "select * from userinfo where username='"+name+"' and password='"+pwd+"'"; System.out.println(sql); // 执行SQL语句,获取返回结果 ResultSet resultSet = stmt.executeQuery(sql); if (resultSet.next()) { System.out.println("登陆成功!"); } else { System.out.println("用户名或密码错误!"); } JDBCUtil.releaseSourse(conn, stmt, resultSet); sc.close(); } }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册