首页 文章 精选 留言 我的

精选列表

搜索[青少年编程],共10000篇文章
优秀的个人博客,低调大师

Java并发编程笔记之基础总结(一)

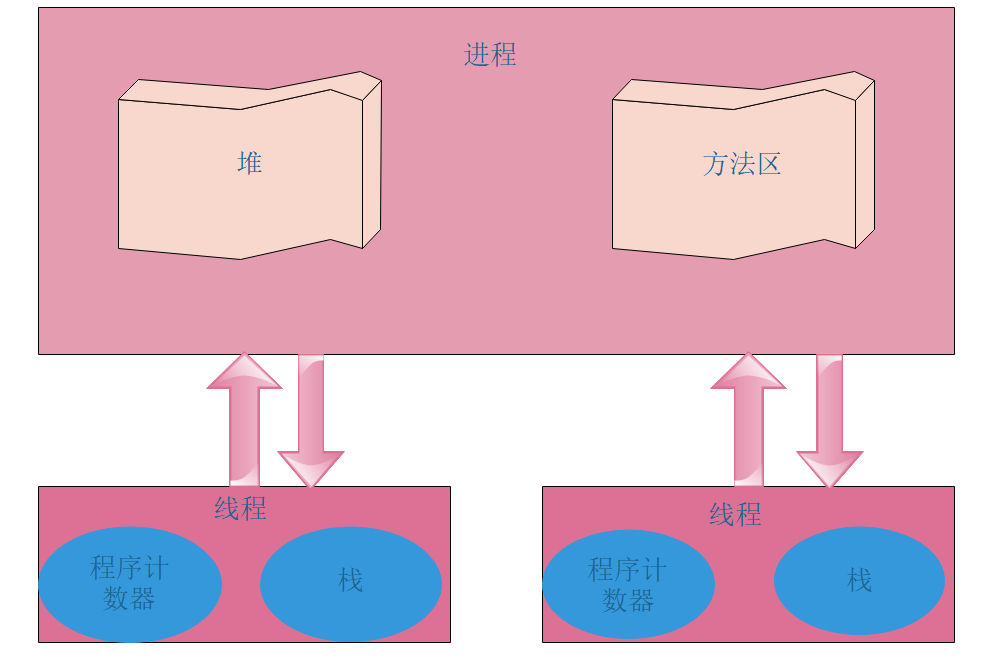
一.线程概念 说到线程就必须要提一下进程,因为线程是进程中的一个实体,线程本身是不会独立存在的。进程是代码在数据集合上的一次运行活动,是系统进行资源分配和调度的基本单位,线程则是进程的一个执行路径,一个进程至少有一个线程,进程中的多个线程是共享进程的资源的。操作系统在分配资源时候是把资源分配给进程的,但是 CPU 资源就比较特殊,它是分派到线程的,因为真正要占用 CPU 运行的是线程,所以也说线程是 CPU 分配的基本单位。 Java 中当我们启动 main 函数时候其实就启动了一个 JVM 的进程,而 main 函数所在线程就是这个进程中的一个线程,也叫做主线程。 如上图一个进程中有多个线程,多个线程共享进程的堆和方法区资源,但是每个线程有自己的程序计数器,栈区域。、 其中程序计数器是一块内存区域,用来记录线程当前要执行的指令地址,那么程序计数器为何要设计为线程私有的呢? 前面说了线程是占用 CPU 执行的基本单位,而 CPU 一般是使用时间片轮转方式让线程轮询占用的,所以当前线程 CPU 时间片用完后,要让出 CPU,等下次轮到自己时候在执行。 那么如何知道之前程序执行到哪里了? 其实程序计数器就是为了记录该线程让出 CPU 时候的执行地址,待再次分配到时间片时候就可以从自己私有的计数器指定地址继续执行了。 另外每个线程有自己的栈资源,用于存储该线程的局部变量,这些局部变量是该线程私有的,其它线程是访问不了的,另外栈还用来存放线程的调用栈帧。 堆是一个进程中最大的一块内存,堆是被进程中的所有线程共享的,是进程创建时候分配的,堆里面主要存放使用 new 操作创建的对象实例。 方法区则是用来存放进程中的代码片段的,是线程共享的。 二.线程创建方式与运行 Java 中有三种线程创建方法,分别为实现 Runnable 接口的run方法、继承 Thread 类并重写 run 方法、使用 FutureTask 方式。 1.继承 Thread 方法的实现,如下所示: /** * Created by cong on 2018/7/17. */ public class ThreadTest { //继承Thread类并重写run方法 public static class MyThread extends Thread { @Override public void run() { System.out.println("-----子线程-----"); } } public static void main(String[] args) { // 创建线程 MyThread thread = new MyThread(); // 启动线程 thread.start(); } } 运行结果如下: 如上代码 MyThread 类继承了 Thread 类,并重写了 run 方法,然后调用了线程的 start 方法启动了线程,当创建完 thread 对象后该线程并没有被启动执行.当调用了 start 方法后才是真正启动了线程。其实当调用了 start 方法后线程并没有马上执行而是处于就绪状态,这个就绪状态是指该线程已经获取了除 CPU 资源外的其它资源,等获取 CPU 资源后才会真正处于运行状态。 当 run 方法执行完毕,该线程就处于终止状态了。使用继承方式好处是 run 方法内获取当前线程直接使用 this 就可以,无须使用 Thread.currentThread() 方法,不好的地方是 Java 不支持多继承,如果继承了 Thread 类那么就不能再继承其它类,另外任务与代码没有分离,当多个线程执行一样的任务时候需要多份任务代码,而 Runable 则没有这个限制。 2.实现 Runnable 接口的 run 方法方式,例子如下所示: /** * Created by cong on 2018/7/17. */ public class RunableTest implements Runnable { @Override public void run() { System.out.println("----子线程----"); } public static void main(String[] args) throws InterruptedException{ RunableTest runableTest = new RunableTest(); new Thread(runableTest).start(); new Thread(runableTest).start(); } } 运行结果如下: 如上面代码,两个线程公用一个 task 代码逻辑,需要的话 RunableTask 可以添加参数进行任务区分,另外 RunableTask 可以继承其他类,但是上面两种方法都有一个缺点就是任务没有返回值, 3.使用 FutureTask方式,例子如下所示: /** * Created by cong on 2018/7/17. */ public class FutureTaskTest implements Callable<String> { @Override public String call() throws Exception { return "hello"; } public static void main(String[] args) throws InterruptedException { // 创建异步任务 FutureTask<String> futureTask = new FutureTask<>(new FutureTaskTest()); //启动线程 new Thread(futureTask).start(); try { //等待任务执行完毕,并返回结果 String result = futureTask.get(); System.out.println(result); } catch (ExecutionException e) { e.printStackTrace(); } } } 运行结果如下: 总结:每种方式都有自己的优缺点,应该根据实际场景进行选择。 三.线程通知与等待 Java 中 Object 类是所有类的父类,鉴于继承机制,Java 把所有类都需要的方法放到了 Object 类里面,其中就包含本节要讲的通知等待系列函数,这些通知等待函数是组成并发包中线程同步组件的基础。 下面讲解下 Object 中关于线程同步的通知等待函数。如下所示: 1.void wait() 方法:首先谈下什么是共享资源,所谓共享资源是说该资源被多个线程共享,多个线程都可以去访问或者修改的资源。当一个线程调用一个共享对象的 wait() 方法时候,调用线程会被阻塞挂起,直到下面几个事情之一发生才返回: 其它线程调用了该共享对象的 notify() 或者 notifyAll() 方法; 其它线程调用了该线程的 interrupt() 方法设置了该线程的中断标志,该线程会抛出 InterruptedException 异常返回 另外需要注意的是如果调用 wait() 方法的线程没有事先获取到该对象的监视器锁,则调用 wait() 方法时候调用线程会抛出 IllegalMonitorStateException 异常。 那么一个线程如何获取到一个共享变量的监视器呢? 1.执行使用 synchronized 同步代码块时候,使用该共享变量作为参数,例子如下: synchronized(共享变量){ //doSomething } 2.调用该共享变量的方法,并且该方法使用了 synchronized 修饰,代码如下: synchronized void add(int a,int b){ //doSomething } 另外需要注意的是一个线程可以从挂起状态变为可以运行状态(也就是被唤醒)即使该线程没有被其它线程调用 notify(),notifyAll() 进行通知,或者被中断,或者等待超时,这就是所谓的虚假唤醒。 虽然虚假唤醒在应用实践中很少发生,但是还是需要防范于未然的,做法就是不停的去测试该线程被唤醒的条件是否满足,不满足则继续等待,也就是说在一个循环中去调用 wait() 方法进行防范,退出循环的条件是条件满足了唤醒该线程。代码如下: synchronized (obj) { while (条件不满足){ obj.wait(); } } 如上代码是经典的调用共享变量 wait() 方法的实例,首先通过同步块获取 obj 上面的监视器锁,然后通过 while 循环内调用 obj 的 wait() 方法。 下面从生产者消费者例子来加深理解,例子如下: 生产者: //生产线程 synchronized (queue) { //消费队列满,则等待队列空闲 while (queue.size() == MAX_SIZE) { try { //挂起当前线程,并释放通过同步块获取的queue上面的锁,让消费线程可以获取该锁,然后获取队列里面元素 queue.wait(); } catch (Exception ex) { ex.printStackTrace(); } } //空闲则生成元素,并通知消费线程 queue.add(ele); queue.notifyAll(); } } 消费者: //消费线程 synchronized (queue) { //消费队列为空 while (queue.size() == 0) { try { //挂起当前线程,并释放通过同步块获取的queue上面的锁,让生产线程可以获取该锁,生产元素放入队列 queue.wait(); } catch (Exception ex) { ex.printStackTrace(); } } //消费元素,并通知唤醒生产线程 queue.take(); queue.notifyAll(); } 如上面代码所示是一个生产者的例子,其中 queue 为共享变量,生产者线程在调用 queue 的 wait 方法前,通过使用 synchronized 关键字拿到了该共享变量 queue 的监视器,所以调用 wait() 方法才不会抛出 IllegalMonitorStateException 异常,如果当前队列没有空闲容量则会调用 queued 的 wait() 挂起当前线程,这里使用循环就是为了避免上面说的虚假唤醒问题,这里假如当前线程虚假唤醒了,但是队列还是没有空余容量的话,当前线程还是会调用 wait() 把自己挂起。 另外当一个线程调用了共享变量的 wait() 方法后该线程会被挂起,同时该线程会暂时释放对该共享变量监视器的持有,直到另外一个线程调用了共享变量的 notify() 或者 notifyAll() 方法才有可能会重新获取到该共享变量的监视器的持有权(这里说有可能,是因为考虑到多个线程第一次都调用了 wait() 方法,所以多个线程会竞争持有该共享变量的监视器)。、 接下来讲解下调用共享变量 wait() 方法后当前线程会释放持有的共享变量的锁的理解。 如上代码假如生产线程 A 首先通过 synchronized 获取到了 queue 上的锁,那么其它生产线程和所有消费线程都会被阻塞,线程 A 获取锁后发现当前队列已满会调用 queue.wait() 方法阻塞自己,然后会释放获取的 queue 上面的锁,这里考虑下为何要释放该锁?如果不释放,由于其它生产线程和所有消费线程已经被阻塞挂起,而线程 A 也被挂起,这就处于了死锁状态。这里线程 A 挂起自己后释放共享变量上面的锁就是为了打破死锁必要条件之一的持有并等待原则。关于死锁下面章节会有讲到,线程 A 释放锁后其它生产线程和所有消费线程中会有一个线程获取 queue 上的锁进而进入同步块,这就打破了死锁。 最后再举一个例子说明当一个线程调用共享对象的 wait() 方法被阻塞挂起后,如果其它线程中断了该线程,则该线程会抛出 InterruptedException 异常后返回,代码如下: /** * Created by cong on 2018/7/17. */ public class WaitNotifyInteruptTest { static Object obj = new Object(); public static void main(String[] args) throws InterruptedException { //创建线程 Thread threadA = new Thread(new Runnable() { public void run() { try { System.out.println("---开始---"); //阻塞当前线程 obj.wait(); System.out.println("---结束---"); } catch (InterruptedException e) { e.printStackTrace(); } } }); threadA.start(); Thread.sleep(1000); System.out.println("---开始打断线程A---"); threadA.interrupt(); System.out.println("---线程A已经被打断---"); } } 运行结果如下: 如上代码 threadA 调用了共享对 obj 的 wait() 方法后阻塞挂起了自己,然后主线程在休眠1s后中断了 threadA 线程,可知中断后 threadA 在 obj.wait() 处抛出了 java.lang.IllegalMonitorStateException 异常后返回后终止。 2.void wait(long timeout) 方法:该方法相比 wait() 方法多一个超时参数,不同在于如果一个线程调用了共享对象的该方法挂起后,如果没有在指定的 timeout ms 时间内被其它线程调用该共享变量的 notify() 或者 notifyAll() 方法唤醒,那么该函数还是会因为超时而返回。需要注意的是如果在调用该函数时候 timeout 传递了负数会抛出 IllegalArgumentException 异常。 3.void wait(long timeout, int nanos) 方法:内部是调用 wait(long timeout),如下代码:只是当 nanos>0 时候让参数一递增1。源码如下: public final void wait(long timeout, int nanos) throws InterruptedException { if (timeout < 0) { throw new IllegalArgumentException("timeout value is negative"); } if (nanos < 0 || nanos > 999999) { throw new IllegalArgumentException( "nanosecond timeout value out of range"); } if (nanos > 0) { timeout++; } wait(timeout); } 4.void notify() 方法:一个线程调用共享对象的 notify() 方法后,会唤醒一个在该共享变量上调用 wait 系列方法后被挂起的线程,一个共享变量上可能会有多个线程在等待,具体唤醒哪一个等待的线程是随机的。另外被唤醒的线程不能马上从 wait 返回继续执行,它必须获取了共享对象的监视器后才可以返回,也就是唤醒它的线程释放了共享变量上面的监视器锁后,被唤醒它的线程也不一定会获取到共享对象的监视器,这是因为该线程还需要和其它线程一块竞争该锁,只有该线程竞争到了该共享变量的监视器后才可以继续执行。 类似 wait 系列方法,只有当前线程已经获取到了该共享变量的监视器锁后,才可以调用该共享变量的 notify() 方法,否者会抛出 IllegalMonitorStateException 异常。 5.void notifyAll() 方法:不同于 nofity() 方法在共享变量上调用一次就会唤醒在该共享变量上调用 wait 系列方法被挂起的一个线程,notifyAll() 则会唤醒所有在该共享变量上由于调用 wait 系列方法而被挂起的线程。 最后讲一个例子来说明 notify() 和 notifyAll() 的具体含义和一些需要注意的地方,代码实例如下: /** * Created by cong on 2018/7/17. */ public class Test1 { private static volatile Object resourceA = new Object(); public static void main(String[] args) throws InterruptedException { // 创建线程 Thread threadA = new Thread(new Runnable() { public void run() { // 获取resourceA共享资源的监视器锁 synchronized (resourceA) { System.out.println("threadA get resourceA lock"); try { System.out.println("threadA begin wait"); resourceA.wait(); System.out.println("threadA end wait"); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } }); // 创建线程 Thread threadB = new Thread(new Runnable() { public void run() { synchronized (resourceA) { System.out.println("threadB get resourceA lock"); try { System.out.println("threadB begin wait"); resourceA.wait(); System.out.println("threadB end wait"); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } }); // 创建线程 Thread threadC = new Thread(new Runnable() { public void run() { synchronized (resourceA) { System.out.println("threadC begin notify"); resourceA.notifyAll(); } } }); // 启动线程 threadA.start(); threadB.start(); Thread.sleep(1000); threadC.start(); // 等待线程结束 threadA.join(); threadB.join(); threadC.join(); System.out.println("main over"); } } 运行结果如下: 如上代码开启了三个线程,其中线程 A 和 B 分别调用了共享资源 resourceA 的 wait() 方法,线程 C 则调用了 nofity() 方法。 这里启动线程 C 前首先调用 sleep 方法让主线程休眠 1s,目的是让线程 A 和 B 全部执行到调用 wait 方法后在调用线程 C 的 notify 方法。 这个例子企图希望在线程 A 和线程 B 都因调用共享资源 resourceA 的 wait() 方法而被阻塞后,线程 C 在调用 resourceA 的 notify() 方法,希望可以唤醒线程 A 和线程 B,但是从执行结果看只有一个线程 A 被唤醒了,线程 B 没有被唤醒, 从结果看线程调度器这次先调度了线程 A 占用 CPU 来运行,线程 A 首先获取 resourceA 上面的锁,然后调用 resourceA 的 wait() 方法挂起当前线程并释放获取到的锁,然后线程 B 获取到 resourceA 上面的锁并调用了 resourceA 的 wait(),此时线程 B 也被阻塞挂起并释放了 resourceA 上的锁。 线程 C 休眠结束后在共享资源 resourceA 上调用了 notify() 方法,则会激活 resourceA 的阻塞集合里面的一个线程,这里激活了线程 A,所以线程 A 调用的 wait() 方法返回了,线程 A 执行完毕。而线程 B 还处于阻塞状态。 如果把线程 C 里面调用的 notify() 改为调用 notifyAll() 而执行结果如下: 可知线程 A 和线程 B 被挂起后,线程 C 调用 notifyAll() 函数会唤醒在 resourceA 等待的所有线程,这里线程 A 和线程 B 都会被唤醒,只是线程 B 先获取到 resourceA 上面的锁然后从 wait() 方法返回,等线程 B 执行完毕后,线程 A 又获取了 resourceA 上面的锁,然后从 wait() 方返回,当线程 A 执行完毕,主线程就返回后,然后打印输出。 总结:在调用具体共享对象的 wait 或者 notify 系列函数前要先获取共享对象的锁;另外通知和等待是实现线程同步的原生方法,理解它们的协作功能很有必要;最后由于线程虚假唤醒的存在,一定要使用循环检查的方式。 6.等待线程执行终止的 join 方法:在项目实践时候经常会遇到一个场景,就是需要等待某几件事情完成后才能继续往下执行,比如多个线程去加载资源,当多个线程全部加载完毕后在汇总处理,Thread 类中有个静态的 join 方法就可以做这个事情,前面介绍的等待通知方法是属于 Object 类的,而 join 方法则是直接在 Thread 类里面提供的,join 是无参,返回值为 void 的方法。下面看一个简单的例子来介绍 join 的使用: /** * Created by cong on 2018/7/17. */ public class Test3 { public static void main(String[] args) throws InterruptedException { Thread threadOne = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("child threadOne over!"); } }); Thread threadTwo = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("child threadTwo over!"); } }); //启动子线程 threadOne.start(); threadTwo.start(); System.out.println("wait all child thread over!"); //等待子线程执行完毕,返回 threadOne.join(); threadTwo.join(); System.out.println("all child thread over!"); } } 运行结果如下: 如代码主线程里面启动了两个子线程,然后在分别调用了它们的 join() 方法,那么主线程首先会阻塞到 threadOne.join() 方法,等 threadOne 执行完毕后返回,threadOne 执行完毕后 threadOne.join() 就会返回,然后主线程调用 threadTwo.join() 后再次被阻塞,等 threadTwo 执行完毕后主线程也就返回了。这里只是为了演示 join 的作用,对应这类需求后面会讲的 CountDownLatch 是不错选择。 另外线程 A 调用线程 B 的 join 方法后会被阻塞,当其它线程调用了线程 B 的 interrupt() 方法中断了线程 B 时候,线程 B 会抛出 InterruptedException 异常而返回,下面通过一个例子来加深理解: /** * Created by cong on 2018/7/17. */ public class Test4 { public static void main(String[] args) throws InterruptedException { //线程one Thread threadOne = new Thread(new Runnable() { @Override public void run() { System.out.println("threadOne begin run!"); for (;;) { } } }); //获取主线程 final Thread mainThread = Thread.currentThread(); //线程two Thread threadTwo = new Thread(new Runnable() { @Override public void run() { //休眠1s try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } //中断主线程 mainThread.interrupt(); } }); // 启动子线程 threadOne.start(); //延迟1s启动线程 threadTwo.start(); try{//等待线程one执行结束 threadOne.join(); }catch(InterruptedException e){ System.out.println("main thread:" + e); } } } 运行结果如下: 如上代码 threadOne 线程里面执行死循环,主线程调用 threadOne 的 join 方法阻塞自己等待线程 threadOne 执行完毕,待 threadTwo 休眠 1s 后会调用主线程的 interrupt() 方法设置主线程的中断标志。 从结果看主线程中 threadOne.join() 处会抛出 InterruptedException 异常而返回。这里需要注意的是 threadTwo 里面调用的是主线程的 interrupt(),而不是线程 threadOne 的。 总结:由于 CountDownLatch 功能比 join 更丰富,所以项目实践中一般使用 CountDownLatch。 7.让线程睡眠的 sleep 方法:Thread 类中有一个静态的 sleep 方法,当一个执行中的线程调用了 Thread 的 sleep 方法后,调用线程会暂时让出指定时间的执行权,也就是这期间不参与 CPU 的调度,但是该线程所拥有的监视器资源,比如锁还是持有不让出的。当指定的睡眠时间到了该函数会正常返回,线程就处于就绪状态,然后参与 CPU 的调度,当获取到了 CPU 资源就可以继续运行了。如果在睡眠期间其它线程调用了该线程的 interrupt() 方法中断了该线程,该线程会在调用 sleep 的地方抛出 InterruptedException 异常返回。 用一个例子来说明线程在睡眠时候拥有的监视器资源不会被释放是什么意思,例子如下: /** * Created by cong on 2018/7/17. */ public class SleepTest2 { // 创建一个独占锁 private static final Lock lock = new ReentrantLock(); public static void main(String[] args) throws InterruptedException { // 创建线程A Thread threadA = new Thread(new Runnable() { public void run() { // 获取独占锁 lock.lock(); try { System.out.println("child threadA is in sleep"); Thread.sleep(10000); System.out.println("child threadA is in awaked"); } catch (InterruptedException e) { e.printStackTrace(); } finally { // 释放锁 lock.unlock(); } } }); // 创建线程B Thread threadB = new Thread(new Runnable() { public void run() { // 获取独占锁 lock.lock(); try { System.out.println("child threadB is in sleep"); Thread.sleep(10000); System.out.println("child threadB is in awaked"); } catch (InterruptedException e) { e.printStackTrace(); } finally { // 释放锁 lock.unlock(); } } }); // 启动线程 threadA.start(); threadB.start(); } } 运行结果如下: 如上代码首先创建了一个独占锁,然后创建了两个线程,每个线程内部先获取锁,然后睡眠,睡眠结束后会释放锁。 首先无论你执行多少遍上面的代码都是先输出线程 A 的打印或者先输出线程 B 的打印,不会存在线程 A 和线程 B 交叉打印的情况。 从执行结果看线程 B 先获取了锁,那么线程 B 会先打印一行,然后调用 sleep 让自己沉睡 10s,在线程 B 沉睡的这 10s 内那个独占锁 lock 还是线程 B 自己持有的,线程 A 会一直阻塞直到线程 B 醒过来后执行 unlock 释放锁。 下面在来看下当一个线程处于睡眠时候如果另外一个线程中断了它,会不会在调用 sleep 处抛出异常。代码如下: /** * Created by cong on 2018/7/17. */ public class SleepInterruptTest { public static void main(String[] args) throws InterruptedException { //创建线程 Thread thread = new Thread(new Runnable() { public void run() { try { System.out.println("child thread is in sleep"); Thread.sleep(10000); System.out.println("child thread is in awaked"); } catch (InterruptedException e) { e.printStackTrace(); } } }); //启动线程 thread.start(); //主线程休眠2s Thread.sleep(2000); //主线程中断子线程 thread.interrupt(); } } 如上代码在子线程睡眠期间主线程中断了它,所以子线程在调用 sleep 处抛出了 InterruptedException 异常。 总结:sleep 方法只是会让调用线程暂时让出指定时间的 CPU 执行权,但是该线程所拥有的监视器资源,比如锁还是持有不让出的。

优秀的个人博客,低调大师

Java并发编程笔记之FutureTask源码分析

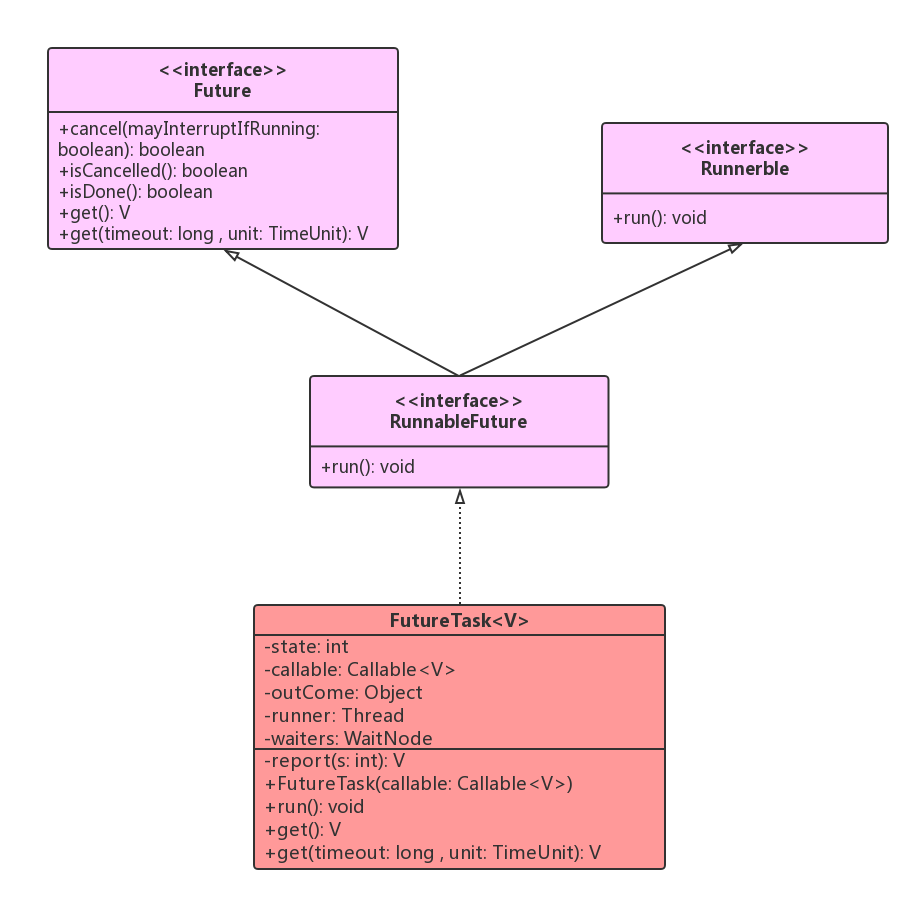
FutureTask可用于异步获取执行结果或取消执行任务的场景。通过传入Runnable或者Callable的任务给FutureTask,直接调用其run方法或者放入线程池执行,之后可以在外部通过FutureTask的get方法异步获取执行结果,因此,FutureTask非常适合用于耗时的计算,主线程可以在完成自己的任务后,再去获取结果。另外,FutureTask还可以确保即使调用了多次run方法,它都只会执行一次Runnable或者Callable任务,或者通过cancel取消FutureTask的执行等。 类图结构如下所示: 线程池使用 FutureTask 时候需要注意的一点事,FutureTask 使用不当可能会造成调用线程一直阻塞,如何避免? 线程池使用 FutureTask 的时候如果拒绝策略设置为了DiscardPolicy和DiscardOldestPolicy并且在被拒绝的任务的 Future 对象上调用无参 get 方法那么调用线程会一直被阻塞。 下面先通过一个简单的例子来复现问题,代码如下: public class FutureTest { //(1)线程池单个线程,线程池队列元素个数为1 private final static ThreadPoolExecutor executorService = new ThreadPoolExecutor(1, 1, 1L, TimeUnit.MINUTES, new ArrayBlockingQueue<Runnable>(1),new ThreadPoolExecutor.DiscardPolicy()); public static void main(String[] args) throws Exception { //(2)添加任务one Future futureOne = executorService.submit(new Runnable() { @Override public void run() { System.out.println("start runable one"); try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } } }); //(3)添加任务two Future futureTwo = executorService.submit(new Runnable() { @Override public void run() { System.out.println("start runable two"); } }); //(4)添加任务three Future futureThree=null; try { futureThree = executorService.submit(new Runnable() { @Override public void run() { System.out.println("start runable three"); } }); } catch (Exception e) { System.out.println(e.getLocalizedMessage()); } System.out.println("task one " + futureOne.get());//(5)等待任务one执行完毕 System.out.println("task two " + futureTwo.get());//(6)等待任务two执行完毕 System.out.println("task three " + (futureThree==null?null:futureThree.get()));// (7)等待任务three执行完毕 executorService.shutdown();//(8)关闭线程池,阻塞直到所有任务执行完毕 } 运行结果如下: 代码 (1) 创建了一个单线程并且队列元素个数为 1 的线程池,并且拒绝策略设置为了DiscardPolicy 代码(2)向线程池提交了一个任务 one,那么这个任务会使用唯一的一个线程进行执行,任务在打印start runable one后会阻塞该线程 5s. 代码(3)向线程池提交了一个任务 two,这时候会把任务 two 放入到阻塞队列 代码(4)向线程池提交任务 three,由于队列已经满了则会触发拒绝策略丢弃任务 three, 从执行结果看在任务 one 阻塞的 5s 内,主线程执行到了代码 (5) 等待任务 one 执行完毕,当任务 one 执行完毕后代码(5)返回,主线程打印出 task one null。任务 one 执行完成后线程池的唯一线程会去队列里面取出任务 two 并执行所以输出 start runable two 然后代码(6)会返回,这时候主线程输出 task two null,然后执行代码(7)等待任务 three 执行完毕,从执行结果看代码(7)会一直阻塞不会返回,至此问题产生,如果把拒绝策略修改为 DiscardOldestPolicy 也会存在有一个任务的 get 方法一直阻塞只是现在是任务 two 被阻塞。但是如果拒绝策略设置为默认的 AbortPolicy 则会正常返回,并且会输出如下结果: 要分析这个问题需要看下线程池的 submit 方法里面做了什么,submit 方法源码如下: public Future<?> submit(Runnable task) { ... //(1)装饰Runnable为Future对象 RunnableFuture<Void> ftask = newTaskFor(task, null); execute(ftask); //(6)返回future对象 return ftask; } protected <T> RunnableFuture<T> newTaskFor(Runnable runnable, T value) { return new FutureTask<T>(runnable, value); } public void execute(Runnable command) { ... //(2) 如果线程个数消息核心线程数则新增处理线程处理 int c = ctl.get(); if (workerCountOf(c) < corePoolSize) { if (addWorker(command, true)) return; c = ctl.get(); } //(3)如果当前线程个数已经达到核心线程数则任务放入队列 if (isRunning(c) && workQueue.offer(command)) { int recheck = ctl.get(); if (! isRunning(recheck) && remove(command)) reject(command); else if (workerCountOf(recheck) == 0) addWorker(null, false); } //(4)尝试新增处理线程进行处理 else if (!addWorker(command, false)) reject(command);//(5)新增失败则调用拒绝策略 } 代码(1)装饰 Runnable 为 FutureTask 对象,然后调用线程池的 execute 方法。 代码 (2) 如果线程个数消息核心线程数则新增处理线程处理 代码(3)如果当前线程个数已经达到核心线程数则任务放入队列 代码(4)尝试新增处理线程进行处理,失败则进行代码(5),否者直接使用新线程处理 代码(5)执行具体拒绝策略,从这里也可以看出拒绝策略执行是使用的业务线程。 所以要分析上面例子中问题所在只需要看步骤(5)对被拒绝任务的影响,这里先看下拒绝策略 DiscardPolicy 的源码,如下: public static class DiscardPolicy implements RejectedExecutionHandler { public DiscardPolicy() { } public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { } } 可知拒绝策略 rejectedExecution 方法里面什么都没做,所以代码(4)调用 submit 后会返回一个 future 对象,这里有必要在重新说 future 是有状态的,FutureTask 内部有一个state用来展示任务的状态,并且是volatile修饰的,future 的状态枚举值如下: /** Possible state transitions: * NEW -> COMPLETING -> NORMAL 正常的状态转移 * NEW -> COMPLETING -> EXCEPTIONAL 异常 * NEW -> CANCELLED 取消 * NEW -> INTERRUPTING -> INTERRUPTED 中断 */ private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; 在代码(1)的时候使用 newTaskFor 方法转换 Runnable 任务为 FutureTask,而 FutureTask 的构造函数里面设置的状态就是 New。FutureTask的构造函数源码如下: public FutureTask(Runnable runnable, V result) { this.callable = Executors.callable(runnable, result); this.state = NEW; // ensure visibility of callable } 把FutureTask提交到线程池或者线程执行start时候会调用run方法,源码如下: public void run() { //如果当前不是new状态,或者当前cas设置当前线程失败则返回,只有一个线程可以成功。 if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return; try { //当前状态为new 则调用任务的call方法执行任务 Callable<V> c = callable; if (c != null && state == NEW) { V result; boolean ran; try { result = c.call(); ran = true; } catch (Throwable ex) { result = null; ran = false; setException(ex);//完成NEW -> COMPLETING -> EXCEPTIONAL 状态转移 } //执行任务成功则保存结果更新状态,unpark所有等待线程。 if (ran) set(result); } } finally { // runner must be non-null until state is settled to // prevent concurrent calls to run() runner = null; // state must be re-read after nulling runner to prevent // leaked interrupts int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } protected void set(V v) { //状态从new->COMPLETING if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = v; //状态从COMPLETING-》NORMAL UNSAFE.putOrderedInt(this, stateOffset, NORMAL); // final state //unpark所有等待线程。 finishCompletion(); } } 所以使用 DiscardPolicy 策略提交任务后返回了一个状态值为NEW的future对象。那么我们下面就要看下当future的无参get()方法的时候,future变为什么状态才会返回,这时候就要看一下FutureTask的get方法的源码,源码如下: public V get() throws InterruptedException, ExecutionException { int s = state; //当状态值<=COMPLETING时候需要等待,否者调用report返回 if (s <= COMPLETING) s = awaitDone(false, 0L); return report(s); } private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false; for (;;) { //如果被中断,则抛异常 if (Thread.interrupted()) { removeWaiter(q); throw new InterruptedException(); } //组建单列表 int s = state; if (s > COMPLETING) { if (q != null) q.thread = null; return s; } else if (s == COMPLETING) // cannot time out yet Thread.yield(); else if (q == null) q = new WaitNode(); else if (!queued) queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q); else if (timed) { nanos = deadline - System.nanoTime(); //超时则返回 if (nanos <= 0L) { removeWaiter(q); return state; } //否者设置park超时时间 LockSupport.parkNanos(this, nanos); } else //直接挂起当前线程 LockSupport.park(this); } } private V report(int s) throws ExecutionException { Object x = outcome; //状态值为NORMAL正常返回 if (s == NORMAL) return (V)x; //状态值大于等于CANCELLED则抛异常 if (s >= CANCELLED) throw new CancellationException(); throw new ExecutionException((Throwable)x); } 也就是说当 future 的状态 > COMPLETING 时候调用 get 方法才会返回,而明显 DiscardPolicy 策略在拒绝元素的时候并没有设置该 future 的状态,后面也没有其他机会可以设置该 future 的状态,所以 future 的状态一直是 NEW,所以一直不会返回,同理 DiscardOldestPolicy 策略也是这样的问题,最老的任务被淘汰时候没有设置被淘汰任务对于 future 的状态。、 在submit任务后还可以调用futuretask的cancel来取消任务: public boolean cancel(boolean mayInterruptIfRunning) { //只有任务是new的才能取消 if (state != NEW) return false; //运行时允许中断 if (mayInterruptIfRunning) { //完成new->INTERRUPTING if (!UNSAFE.compareAndSwapInt(this, stateOffset, NEW, INTERRUPTING)) return false; Thread t = runner; if (t != null) t.interrupt(); //完成INTERRUPTING->INTERRUPTED UNSAFE.putOrderedInt(this, stateOffset, INTERRUPTED); // final state } //不允许中断则直接new->CANCELLED else if (!UNSAFE.compareAndSwapInt(this, stateOffset, NEW, CANCELLED)) return false; finishCompletion(); return true; } 那么默认的 AbortPolicy 策略为啥没问题呢? 也就是说当 future 的状态 > COMPLETING 时候调用 get 方法才会返回,而明显 DiscardPolicy 策略在拒绝元素的时候并没有设置该 future 的状态,后面也没有其他机会可以设置该 future 的状态,所以 future 的状态一直是 NEW,所以一直不会返回,同理 DiscardOldestPolicy 策略也是这样的问题,最老的任务被淘汰时候没有设置被淘汰任务对于 future 的状态。 所以当使用 Future 的时候,尽量使用带超时时间的 get 方法,这样即使使用了 DiscardPolicy 拒绝策略也不至于一直等待,等待超时时间到了会自动返回的,如果非要使用不带参数的 get 方法则可以重写 DiscardPolicy 的拒绝策略在执行策略时候设置该 Future 的状态大于 COMPLETING 即可,但是查看 FutureTask 提供的方法发现只有 cancel 方法是 public 的并且可以设置 FutureTask 的状态大于 COMPLETING,重写拒绝策略具体代码可以如下: /** * Created by cong on 2018/7/13. */ public class MyRejectedExecutionHandler implements RejectedExecutionHandler { public void rejectedExecution(Runnable runnable, ThreadPoolExecutor threadPoolExecutor) { if (!threadPoolExecutor.isShutdown()) { if(null != runnable && runnable instanceof FutureTask){ ((FutureTask) runnable).cancel(true); } } } } 使用这个策略时候由于从 report 方法知道在 cancel 的任务上调用 get() 方法会抛出异常所以代码(7)需要使用 try-catch 捕获异常代码(7)修改为如下: package com.hjc; import java.util.concurrent.*; /** * Created by cong on 2018/7/13. */ public class FutureTest { //(1)线程池单个线程,线程池队列元素个数为1 private final static ThreadPoolExecutor executorService = new ThreadPoolExecutor(1, 1, 1L, TimeUnit.MINUTES, new ArrayBlockingQueue<Runnable>(1), new MyRejectedExecutionHandler()); public static void main(String[] args) throws Exception { //(2)添加任务one Future futureOne = executorService.submit(new Runnable() { public void run() { System.out.println("start runable one"); try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } } }); //(3)添加任务two Future futureTwo = executorService.submit(new Runnable() { public void run() { System.out.println("start runable two"); } }); //(4)添加任务three Future futureThree = null; try { futureThree = executorService.submit(new Runnable() { public void run() { System.out.println("start runable three"); } }); } catch (Exception e) { System.out.println(e.getLocalizedMessage()); } System.out.println("task one " + futureOne.get());//(5)等待任务one执行完毕 System.out.println("task two " + futureTwo.get());//(6)等待任务two执行完毕 try{ System.out.println("task three " + (futureThree==null?null:futureThree.get()));// (7)等待任务three }catch(Exception e){ System.out.println(e.getLocalizedMessage()); } executorService.shutdown();//(8)关闭线程池,阻塞直到所有任务执行完毕 } } 运行结果如下: 当然这相比正常情况下多了一个异常捕获,其实最好的情况是重写拒绝策略时候设置 FutureTask 的状态为 NORMAL,但是这需要重写 FutureTask 方法了,因为 FutureTask 并没有提供接口进行设置。

优秀的个人博客,低调大师

Java并发编程笔记之Timer源码分析

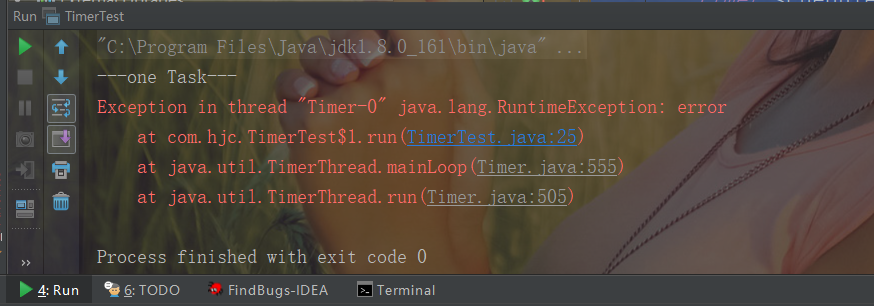
timer在JDK里面,是很早的一个API了。具有延时的,并具有周期性的任务,在newScheduledThreadPool出来之前我们一般会用Timer和TimerTask来做,但是Timer存在一些缺陷,为什么这么说呢? Timer只创建唯一的线程来执行所有Timer任务。如果一个timer任务的执行很耗时,会导致其他TimerTask的时效准确性出问题。例如一个TimerTask每10秒执行一次,而另外一个TimerTask每40ms执行一次,重复出现的任务会在后来的任务完成后快速连续的被调用4次,要么完全“丢失”4次调用。Timer的另外一个问题在于,如果TimerTask抛出未检查的异常会终止timer线程。这种情况下,Timer也不会重新回复线程的执行了;它错误的认为整个Timer都被取消了。此时已经被安排但尚未执行的TimerTask永远不会再执行了,新的任务也不能被调度了。 这里做了一个小的 demo 来复现问题,代码如下: package com.hjc; import java.util.Timer; import java.util.TimerTask; /** * Created by cong on 2018/7/12. */ public class TimerTest { //创建定时器对象 static Timer timer = new Timer(); public static void main(String[] args) { //添加任务1,延迟500ms执行 timer.schedule(new TimerTask() { @Override public void run() { System.out.println("---one Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } throw new RuntimeException("error "); } }, 500); //添加任务2,延迟1000ms执行 timer.schedule(new TimerTask() { @Override public void run() { for (;;) { System.out.println("---two Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } }, 1000); } } 如上代码先添加了一个任务在 500ms 后执行,然后添加了第二个任务在 1s 后执行,我们期望的是当第一个任务输出 ---one Task--- 后等待 1s 后第二个任务会输出 ---two Task---, 但是执行完毕代码后输出结果如下所示: 例子2, public class Shedule { private static long start; public static void main(String[] args) { TimerTask task = new TimerTask() { public void run() { System.out.println(System.currentTimeMillis()-start); try{ Thread.sleep(3000); }catch (InterruptedException e){ e.printStackTrace(); } } }; TimerTask task1 = new TimerTask() { @Override public void run() { System.out.println(System.currentTimeMillis()-start); } }; Timer timer = new Timer(); start = System.currentTimeMillis(); //启动一个调度任务,1S钟后执行 timer.schedule(task,1000); //启动一个调度任务,3S钟后执行 timer.schedule(task1,3000); } } 上面程序我们预想是第一个任务执行后,第二个任务3S后执行的,即输出一个1000,一个3000. 实际运行结果如下: 实际运行结果并不如我们所愿。世界结果,是过了4S后才输出第二个任务,即4001约等于4秒。那部分时间时间到哪里去了呢?那个时间是被我们第一个任务的sleep所占用了。 现在我们在第一个任务中去掉Thread.sleep();这一行代码,运行是否正确了呢?运行结果如下: 可以看到确实是第一个任务过了1S后执行,第二个任务在第一个任务执行完后过3S执行了。 这就说明了Timer只创建唯一的线程来执行所有Timer任务。如果一个timer任务的执行很耗时,会导致其他TimerTask的时效准确性出问题。 Timer 实现原理分析 下面简单介绍下 Timer 的原理,如下图是 Timer 的原理模型介绍: 1.其中 TaskQueue 是一个平衡二叉树堆实现的优先级队列,每个 Timer 对象内部有唯一一个 TaskQueue 队列。用户线程调用 timer 的 schedule 方法就是把 TimerTask 任务添加到 TaskQueue 队列,在调用 schedule 的方法时候 long delay 参数用来说明该任务延迟多少时间执行。 2.TimerThread 是具体执行任务的线程,它从 TaskQueue 队列里面获取优先级最小的任务进行执行,需要注意的是只有执行完了当前的任务才会从队列里面获取下一个任务而不管队列里面是否有已经到了设置的 delay 时间,一个 Timer 只有一个 TimerThread 线程,所以可知 Timer 的内部实现是一个多生产者单消费者模型。 从实现模型可以知道要探究上面的问题只需看 TimerThread 的实现就可以了,TimerThread 的 run 方法主要逻辑源码如下: public void run() { try { mainLoop(); } finally { // 有人杀死了这个线程,表现得好像Timer已取消 synchronized(queue) { newTasksMayBeScheduled = false; queue.clear(); // 消除过时的引用 } } } private void mainLoop() { while (true) { try { TimerTask task; boolean taskFired; //从队列里面获取任务时候要加锁 synchronized(queue) { ...... } if (taskFired) task.run();//执行任务 } catch(InterruptedException e) { } } } 可知当任务执行过程中抛出了除 InterruptedException 之外的异常后,唯一的消费线程就会因为抛出异常而终止,那么队列里面的其他待执行的任务就会被清除。所以 TimerTask 的 run 方法内最好使用 try-catch 结构 catch 主可能的异常,不要把异常抛出到 run 方法外。 其实要实现类似 Timer 的功能使用 ScheduledThreadPoolExecutor 的 schedule 是比较好的选择。ScheduledThreadPoolExecutor 中的一个任务抛出了异常,其他任务不受影响的。 ScheduledThreadPoolExecutor 例子如下: /** * Created by cong on 2018/7/12. */ public class ScheduledThreadPoolExecutorTest { static ScheduledThreadPoolExecutor scheduledThreadPoolExecutor = new ScheduledThreadPoolExecutor(1); public static void main(String[] args) { scheduledThreadPoolExecutor.schedule(new Runnable() { public void run() { System.out.println("---one Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } throw new RuntimeException("error "); } }, 500, TimeUnit.MICROSECONDS); scheduledThreadPoolExecutor.schedule(new Runnable() { public void run() { for (int i =0;i<5;++i) { System.out.println("---two Task---"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } } } }, 1000, TimeUnit.MICROSECONDS); scheduledThreadPoolExecutor.shutdown(); } } 运行结果如下: 之所以 ScheduledThreadPoolExecutor 的其他任务不受抛出异常的任务的影响是因为 ScheduledThreadPoolExecutor 中的 ScheduledFutureTask 任务中 catch 掉了异常,但是在线程池任务的 run 方法内使用 catch 捕获异常并打印日志是最佳实践。

优秀的个人博客,低调大师

Java并发编程笔记之SimpleDateFormat源码分析

SimpleDateFormat 是 Java 提供的一个格式化和解析日期的工具类,日常开发中应该经常会用到,但是由于它是线程不安全的,多线程公用一个 SimpleDateFormat 实例对日期进行解析或者格式化会导致程序出错,本节就讨论下它为何是线程不安全的,以及如何避免。 为了复现上面所说的不安全,我们要用一个例子来突出这个不安全,例子如下: package com.hjc; import java.text.ParseException; import java.text.SimpleDateFormat; /** * Created by cong on 2018/7/12. */ public class SimpleDateFormatTest { //(1)创建单例实例 static SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static void main(String[] args) { //(2)创建多个线程,并启动 for (int i = 0; i <10 ; ++i) { Thread thread = new Thread(new Runnable() { public void run() { try {//(3)使用单例日期实例解析文本 System.out.println(sdf.parse("2018-07-12 15:18:00")); } catch (ParseException e) { e.printStackTrace(); } } }); thread.start();//(4)启动线程 } } } 运行结果如下: 代码(1)创建了 SimpleDateFormat 的一个实例,代码(2)创建 10 个线程,每个线程都公用同一个 sdf 对象对文本日期进行解析,多运行几次就会抛出 java.lang.NumberFormatException 异常,加大线程的个数有利于该问题复现。 为什么会出现这样的问题呢? 那么接下来我们就要进入到SimpleDateFormat 源码一探究竟,为了便于分析首先查看 SimpleDateFormat 的类图结构,类图如下所示: 可知每个 SimpleDateFormat 实例里面有一个 Calendar 对象,到后面就会知道SimpleDateFormat 之所以是线程不安全的,其实就是因为 Calendar 是线程不安全的,后者之所以是线程不安全的是因为其中存放日期数据的变量都是线程不安全的,比如里面的 fields,time 等。 接下来我们要看看parse方法到底干了些什么事,源码如下: public Date parse(String text, ParsePosition pos) { //(1)解析日期字符串放入CalendarBuilder的实例calb中,源码很长,省略一部分,自己去看 ..... Date parsedDate; try {//(2)使用calb中解析好的日期数据设置calendar parsedDate = calb.establish(calendar).getTime(); ... } catch (IllegalArgumentException e) { ... return null; } return parsedDate; } Calendar establish(Calendar cal) { ... //(3)重置日期对象cal的属性值 cal.clear(); //(4) 使用calb中中属性设置cal ... //(5)返回设置好的cal对象 return cal; } 代码(1)主要的作用是解析字符串日期并把解析好的数据放入了 CalendarBuilder 的实例 calb 中,CalendarBuilder 是一个建造者模式,用来存放后面需要的数据。 代码(3)重置 Calendar 对象里面的属性值,源码如下: public final void clear(){ for (int i = 0; i < fields.length; ) { stamp[i] = fields[i] = 0; // UNSET == 0 isSet[i++] = false; } areAllFieldsSet = areFieldsSet = false; isTimeSet = false; } 代码(4)使用 calb 中解析好的日期数据设置 cal 对象 代码(5) 返回设置好的 cal 对象 从上面步骤可知代码(3)(4)(5)操作不是原子性操作,当多个线程调用 parse 方法时候比如线程 A 执行了代码(3)(4)也就是设置好了 cal 对象,在执行代码(5)前线程 B 执行了代码(3)清空了 cal 对象,由于多个线程使用的是一个 cal 对象,所以线程 A 执行代码(5)返回的就可能是被线程 B 清空后的对象,当然也有可能线程 B 执行了代码(4)被线程 B 修改后的 cal 对象。从而导致程序错误。 那么,让我们思考一个问题,如何解决SimpleDateFormat 的线程安全性问题呢? 1.第一种方式:每次使用时候 new 一个 SimpleDateFormat 的实例,这样可以保证每个实例使用自己的 Calendar 实例, 但是每次使用都需要 new 一个对象,并且使用后由于没有其它引用,就会需要被回收,开销会很大。 2.第二种方式:究其原因是因为多线程下代码(3)(4)(5)三个步骤不是一个原子性操作,那么容易想到的是对其进行同步,让(3)(4)(5)成为原子操作,可以使用 synchronized 进行同步,例子改造如下所示: /** * Created by cong on 2018/7/12. */ public class SimpleDateFormatTest1 { //(1)创建单例实例 static SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static void main(String[] args) { //(2)创建多个线程,并启动 for (int i = 0; i <10 ; ++i) { Thread thread = new Thread(new Runnable() { public void run() { try {// (3)使用单例日期实例解析文本 synchronized (sdf) { System.out.println(sdf.parse("2018-07-12 15:18:00")); } } catch (ParseException e) { e.printStackTrace(); } } }); thread.start();//(4)启动线程 } } } 运行结果如下: 3.第三种方式:使用 ThreadLocal,这样每个线程只需要使用一个 SimpleDateFormat 实例相比第一种方式大大节省了对象的创建销毁开销,并且不需要对多个线程直接进行同步,使用 ThreadLocal 方式来保证线程安全,例子如下: /** * Created by cong on 2018/7/12. */ public class SimpleDateFormatTest2 { // (1)创建threadlocal实例 static ThreadLocal<DateFormat> safeSdf = new ThreadLocal<DateFormat>(){ @Override protected SimpleDateFormat initialValue(){ return new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); } }; public static void main(String[] args) { // (2)创建多个线程,并启动 for (int i = 0; i < 10; ++i) { Thread thread = new Thread(new Runnable() { public void run() { try {// (3)使用单例日期实例解析文本 System.out.println(safeSdf.get().parse("2018-07-12 15:18:00")); } catch (ParseException e) { e.printStackTrace(); }finally { //(4)使用完毕记得清除,避免内存泄露 safeSdf.remove(); } } }); thread.start();// (4)启动线程 } } } 运行结果如下: 代码(1)创建了一个线程安全的 SimpleDateFormat 实例,代码(3)在使用的时候首先使用 get() 方法获取当前线程下 SimpleDateFormat 的实例,在第一次调用 ThreadLocal 的 get()方法适合会触发其 initialValue 方法用来创建当前线程所需要的 SimpleDateFormat 对象。另外需要注意的是代码(4)使用完毕线程变量后要记得进行清理,以避免内存泄露。

优秀的个人博客,低调大师

Java高级编程——MySql采用的算法原理

摘要 本文以MySQL数据库为研究对象,讨论与数据库索引相关的一些话题。特别需要说明的是,MySQL支持诸多存储引擎,而各种存储引擎对索引的支持也各不相同,因此MySQL数据库支持多种索引类型,如BTree索引,哈希索引,全文索引等等。为了避免混乱,本文将只关注于BTree索引,因为这是平常使用MySQL时主要打交道的索引,至于哈希索引和全文索引本文暂不讨论。 文章主要内容分为两个部分。 第一部分主要从数据结构及算法理论层面讨论MySQL数据库索引的数理基础。 第二部分结合MySQL数据库中MyISAM和InnoDB数据存储引擎中索引的架构实现讨论聚集索引、非聚集索引及覆盖索引等话题。 数据结构及算法基础 索引的本质 MySQL官方对索引的定义为:索引(Index)是帮助MySQL高效获取数据的数据结构。提取句子主干,就可以得到索引的本质:索引是数据结构。 我们知道,数据库查询是数据库的最主要功能之一。我们都希望查询数据的速度能尽可能的快,因此数据库系统的设计者会从查询算法的角度进行优化。最基本的查询算法当然是顺序查找(linear search),这种复杂度为O(n)的算法在数据量很大时显然是糟糕的,好在计算机科学的发展提供了很多更优秀的查找算法,例如二分查找(binary search)、二叉树查找(binary tree search)等。如果稍微分析一下会发现,每种查找算法都只能应用于特定的数据结构之上,例如二分查找要求被检索数据有序,而二叉树查找只能应用于二叉查找树上,但是数据本身的组织结构不可能完全满足各种数据结构(例如,理论上不可能同时将两列都按顺序进行组织),所以,在数据之外,数据库系统还维护着满足特定查找算法的数据结构,这些数据结构以某种方式引用(指向)数据,这样就可以在这些数据结构上实现高级查找算法。这种数据结构,就是索引。 看一个例子: 图1 图1展示了一种可能的索引方式。左边是数据表,一共有两列七条记录,最左边的是数据记录的物理地址(注意逻辑上相邻的记录在磁盘上也并不是一定物理相邻的)。为了加快Col2的查找,可以维护一个右边所示的二叉查找树,每个节点分别包含索引键值和一个指向对应数据记录物理地址的指针,这样就可以运用二叉查找在O(log2n)的复杂度内获取到相应数据。 虽然这是一个货真价实的索引,但是实际的数据库系统几乎没有使用二叉查找树或其进化品种红黑树(red-black tree)实现的,原因会在下文介绍。 B-Tree和B+Tree 目前大部分数据库系统及文件系统都采用B-Tree或其变种B+Tree作为索引结构,在本文的下一节会结合存储器原理及计算机存取原理讨论为什么B-Tree和B+Tree在被如此广泛用于索引,这一节先单纯从数据结构角度描述它们。 B-Tree 为了描述B-Tree,首先定义一条数据记录为一个二元组[key, data],key为记录的键值,对于不同数据记录,key是互不相同的;data为数据记录除key外的数据。那么B-Tree是满足下列条件的数据结构: 1. d为大于1的一个正整数,称为B-Tree的度。 2. h为一个正整数,称为B-Tree的高度。 3. 每个非叶子节点由n-1个key和n个指针组成,其中d<=n<=2d。 4. 每个叶子节点最少包含一个key和两个指针,最多包含2d-1个key和2d个指针,叶节点的指针均为null 。 5. 所有叶节点具有相同的深度,等于树高h。 6. key和指针互相间隔,节点两端是指针。 7. 一个节点中的key从左到右非递减排列。 8. 所有节点组成树结构。 9. 每个指针要么为null,要么指向另外一个节点。 10. 如果某个指针在节点node最左边且不为null,则其指向节点的所有key小于v(key1),其中v(key1)为node的第一个key的值。 11. 如果某个指针在节点node最右边且不为null,则其指向节点的所有key大于v(keym),其中v(keym)为node的最后一个key的值。 12. 如果某个指针在节点node的左右相邻key分别是keyi和keyi+1且不为null,则其指向节点的所有key小于v(keyi+1)且大于v(keyi)。 图2是一个d=2的B-Tree示意图。 图2 由于B-Tree的特性,在B-Tree中按key检索数据的算法非常直观:首先从根节点进行二分查找,如果找到则返回对应节点的data,否则对相应区间的指针指向的节点递归进行查找,直到找到节点或找到null指针,前者查找成功,后者查找失败。B-Tree上查找算法的伪代码如下: 关于B-Tree有一系列有趣的性质,例如一个度为d的B-Tree,设其索引N个key,则其树高h的上限为logd((N+1)/2),检索一个key,其查找节点个数的渐进复杂度为O(logdN)。从这点可以看出,B-Tree是一个非常有效率的索引数据结构。 另外,由于插入删除新的数据记录会破坏B-Tree的性质,因此在插入删除时,需要对树进行一个分裂、合并、转移等操作以保持B-Tree性质,本文不打算完整讨论B-Tree这些内容,因为已经有许多资料详细说明了B-Tree的数学性质及插入删除算法,有兴趣的朋友可以在本文末的参考文献一栏找到相应的资料进行阅读。 B+Tree B-Tree有许多变种,其中最常见的是B+Tree,例如MySQL就普遍使用B+Tree实现其索引结构。 与B-Tree相比,B+Tree有以下不同点: 1. 每个节点的指针上限为2d而不是2d+1。 2. 内节点不存储data,只存储key;叶子节点不存储指针。 图3是一个简单的B+Tree示意。 图3 由于并不是所有节点都具有相同的域,因此B+Tree中叶节点和内节点一般大小不同。这点与B-Tree不同,虽然B-Tree中不同节点存放的key和指针可能数量不一致,但是每个节点的域和上限是一致的,所以在实现中B-Tree往往对每个节点申请同等大小的空间。 一般来说,B+Tree比B-Tree更适合实现外存储索引结构,具体原因与外存储器原理及计算机存取原理有关,将在下面讨论。 带有顺序访问指针的B+Tree 一般在数据库系统或文件系统中使用的B+Tree结构都在经典B+Tree的基础上进行了优化,增加了顺序访问指针。 如图4所示,在B+Tree的每个叶子节点增加一个指向相邻叶子节点的指针,就形成了带有顺序访问指针的B+Tree。做这个优化的目的是为了提高区间访问的性能,例如图4中如果要查询key为从18到49的所有数据记录,当找到18后,只需顺着节点和指针顺序遍历就可以一次性访问到所有数据节点,极大提到了区间查询效率。 这一节对B-Tree和B+Tree进行了一个简单的介绍,下一节结合存储器存取原理介绍为什么目前B+Tree是数据库系统实现索引的首选数据结构。 为什么使用B-Tree(B+Tree) 上文说过,红黑树等数据结构也可以用来实现索引,但是文件系统及数据库系统普遍采用B-/+Tree作为索引结构,这一节将结合计算机组成原理相关知识讨论B-/+Tree作为索引的理论基础。 一般来说,索引本身也很大,不可能全部存储在内存中,因此索引往往以索引文件的形式存储的磁盘上。这样的话,索引查找过程中就要产生磁盘I/O消耗,相对于内存存取,I/O存取的消耗要高几个数量级,所以评价一个数据结构作为索引的优劣最重要的指标就是在查找过程中磁盘I/O操作次数的渐进复杂度。换句话说,索引的结构组织要尽量减少查找过程中磁盘I/O的存取次数。下面先介绍内存和磁盘存取原理,然后再结合这些原理分析B-/+Tree作为索引的效率。 主存存取原理 目前计算机使用的主存基本都是随机读写存储器(RAM),现代RAM的结构和存取原理比较复杂,这里本文抛却具体差别,抽象出一个十分简单的存取模型来说明RAM的工作原理。 图5 从抽象角度看,主存是一系列的存储单元组成的矩阵,每个存储单元存储固定大小的数据。每个存储单元有唯一的地址,现代主存的编址规则比较复杂,这里将其简化成一个二维地址:通过一个行地址和一个列地址可以唯一定位到一个存储单元。图5展示了一个4 x 4的主存模型。 主存的存取过程如下: 当系统需要读取主存时,则将地址信号放到地址总线上传给主存,主存读到地址信号后,解析信号并定位到指定存储单元,然后将此存储单元数据放到数据总线上,供其它部件读取。 写主存的过程类似,系统将要写入单元地址和数据分别放在地址总线和数据总线上,主存读取两个总线的内容,做相应的写操作。 这里可以看出,主存存取的时间仅与存取次数呈线性关系,因为不存在机械操作,两次存取的数据的“距离”不会对时间有任何影响,例如,先取A0再取A1和先取A0再取D3的时间消耗是一样的。 磁盘存取原理 上文说过,索引一般以文件形式存储在磁盘上,索引检索需要磁盘I/O操作。与主存不同,磁盘I/O存在机械运动耗费,因此磁盘I/O的时间消耗是巨大的。 图6是磁盘的整体结构示意图。 图6 一个磁盘由大小相同且同轴的圆形盘片组成,磁盘可以转动(各个磁盘必须同步转动)。在磁盘的一侧有磁头支架,磁头支架固定了一组磁头,每个磁头负责存取一个磁盘的内容。磁头不能转动,但是可以沿磁盘半径方向运动(实际是斜切向运动),每个磁头同一时刻也必须是同轴的,即从正上方向下看,所有磁头任何时候都是重叠的(不过目前已经有多磁头独立技术,可不受此限制)。 图7是磁盘结构的示意图。 图 7 盘片被划分成一系列同心环,圆心是盘片中心,每个同心环叫做一个磁道,所有半径相同的磁道组成一个柱面。磁道被沿半径线划分成一个个小的段,每个段叫做一个扇区,每个扇区是磁盘的最小存储单元。为了简单起见,我们下面假设磁盘只有一个盘片和一个磁头。 当需要从磁盘读取数据时,系统会将数据逻辑地址传给磁盘,磁盘的控制电路按照寻址逻辑将逻辑地址翻译成物理地址,即确定要读的数据在哪个磁道,哪个扇区。为了读取这个扇区的数据,需要将磁头放到这个扇区上方,为了实现这一点,磁头需要移动对准相应磁道,这个过程叫做寻道,所耗费时间叫做寻道时间,然后磁盘旋转将目标扇区旋转到磁头下,这个过程耗费的时间叫做旋转时间。 局部性原理与磁盘预读 由于存储介质的特性,磁盘本身存取就比主存慢很多,再加上机械运动耗费,磁盘的存取速度往往是主存的几百分分之一,因此为了提高效率,要尽量减少磁盘I/O。为了达到这个目的,磁盘往往不是严格按需读取,而是每次都会预读,即使只需要一个字节,磁盘也会从这个位置开始,顺序向后读取一定长度的数据放入内存。这样做的理论依据是计算机科学中著名的局部性原理: 当一个数据被用到时,其附近的数据也通常会马上被使用。 程序运行期间所需要的数据通常比较集中。 由于磁盘顺序读取的效率很高(不需要寻道时间,只需很少的旋转时间),因此对于具有局部性的程序来说,预读可以提高I/O效率。 预读的长度一般为页(page)的整倍数。页是计算机管理存储器的逻辑块,硬件及操作系统往往将主存和磁盘存储区分割为连续的大小相等的块,每个存储块称为一页(在许多操作系统中,页得大小通常为4k),主存和磁盘以页为单位交换数据。当程序要读取的数据不在主存中时,会触发一个缺页异常,此时系统会向磁盘发出读盘信号,磁盘会找到数据的起始位置并向后连续读取一页或几页载入内存中,然后异常返回,程序继续运行。 B-/+Tree索引的性能分析 到这里终于可以分析B-/+Tree索引的性能了。 上文说过一般使用磁盘I/O次数评价索引结构的优劣。先从B-Tree分析,根据B-Tree的定义,可知检索一次最多需要访问h个节点。数据库系统的设计者巧妙利用了磁盘预读原理,将一个节点的大小设为等于一个页,这样每个节点只需要一次I/O就可以完全载入。为了达到这个目的,在实际实现B-Tree还需要使用如下技巧: 每次新建节点时,直接申请一个页的空间,这样就保证一个节点物理上也存储在一个页里,加之计算机存储分配都是按页对齐的,就实现了一个node只需一次I/O。 B-Tree中一次检索最多需要h-1次I/O(根节点常驻内存),渐进复杂度为O(h)=O(logdN)。一般实际应用中,出度d是非常大的数字,通常超过100,因此h非常小(通常不超过3)。 综上所述,用B-Tree作为索引结构效率是非常高的。 而红黑树这种结构,h明显要深的多。由于逻辑上很近的节点(父子)物理上可能很远,无法利用局部性,所以红黑树的I/O渐进复杂度也为O(h),效率明显比B-Tree差很多。 上文还说过,B+Tree更适合外存索引,原因和内节点出度d有关。从上面分析可以看到,d越大索引的性能越好,而出度的上限取决于节点内key和data的大小: dmax = floor(pagesize / (keysize + datasize + pointsize)) (pagesize – dmax >= pointsize) 或 dmax = floor(pagesize / (keysize + datasize + pointsize)) – 1 (pagesize – dmax < pointsize) floor表示向下取整。由于B+Tree内节点去掉了data域,因此可以拥有更大的出度,拥有更好的性能。 本文从理论角度讨论了与索引相关的数据结构与算法问题。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5zMN6JB 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

Java并发编程-volatile关键字介绍

前言 要学习好Java的多线程,就一定得对volatile关键字的作用机制了熟于胸。最近博主看了大量关于volatile的相关博客,对其有了一点初步的理解和认识,下面通过自己的话叙述整理一遍。 有什么用? volatile主要对所修饰的变量提供两个功能 可见性 防止指令重排序 本篇博客主要对volatile可见性进行探讨,以后发表关于指令重排序的博文。 什么是可见性? 一图胜千言上图已经把JAVA内存模型(JMM)展示得很详细了,简单概括一下 每个Thread有一个属于自己的工作内存(可以理解为每个厨师有一个属于自己的铁锅) 所有Thread共用一个主内存(餐厅所有的厨师共用同一个冰箱) 每个Thread操作数据之前都会去主内存中获取数据(厨师炒菜之前都要去冰箱里拿食材) Thread:厨师 工作内存:铁锅 store&load:放熟食,取食材 主内存:冰箱 读者可思考以下情景:餐厅来了一位顾客点了一份红烧肉,此时有两位大厨(假设大厨之间互不通信),由于互不通信,所以两位大厨都打开冰箱取出食材开始炒菜。最后炒出了两份红烧肉,顾客只要一份。为什么会造成这种结果? 由于大厨之间没有可见性。 将此情景放在JAVA中即是:线程A从主内存中取了一个变量到工作内存中,操作完毕后没有及时放回主内存中,于是线程B去取这个变量已经过期了,取的是线程A操作之前的变量。 如何拥有可见性? 先介绍一下Java内存模型中定义的8种工作内存与主内存之间的原子操作 lock( 锁定 ):作用于主内存的变量,把一个变量标识为一条线程独占的状态。 unlock(解锁):作用于主内存的变量,把一个处于锁定的变量释放出来,释放变量才可以被其他线程锁定。 read(读取):作用于主内存的变量,把一个变量的值从主内存传输到线程的工作内存中,以便随后的load动作使用。 load(载入):作用于工作内存的变量,它把read操作从主内存中得到的变量值放入工作内存的变量副本中。 use(使用):作用于工作内存种的变量,它把工作内存中一个变量的值传递给执行引擎,每当虚拟机遇到一个需要使用到变量的值的字节码指令时将会执行这个操作。 assign(赋值):作用于工作内存中的变量,它把一个从执行引擎接收到的值赋给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。 store(存储):作用于工作内存的变量,它把工作内存中一个变量的值传送到主内存中,以便随后的write操作使用 write(写入):作用于主内存的变量,它把store操作从工作内存中得到的值放入主内存的变量中。 读取赋值一个普通变量的情况 当线程1对主内存对象发起read操作到write操作套流程的时间里,线程2随时都有可能对这个主内存对象发起第二套操作 有什么危害呢? 假设主内存中有一个 int a=0; 线程1和线程2分别执行一次,理想状态下最终a的值为2. a++; 线程1在执行了assign操作之后变量a的真实值已经从0变成了1,但是这个过程发生在工作内存中对其他线程不可见,若线程2此时对变量a的操作,读取到的值仍然为0,因为没有可见性,线程2的操作也仅仅是重复了线程1的操作,再次让a从0变成了1。并没有达到期望的a=2。 读取赋值一个volatile变量的情况 volatile变量对对象的操作更严格: use之前不能被read&load assign之后必须紧跟store&write 也就是说 read-load-use 和 assign-store-write成为了两个不可分割的原子操作 尽管这时候在use和assign之间依然有一段真空期,有可能变量会被其他线程读取,但是无论在哪一个时间点主内存的变量和任一工作内存的变量的值都是相等的。这个特性就导致了volatile变量不适合参与到依赖当前值的运算,如自增。那么依靠可见性的特点volatile可以用在哪些地方呢?《Java虚拟机》提到: 运算结果并不依赖变量的当前值(即结果对产生中间结果不依赖),或者能够确保只有单一的线程修改变量的值 通常volatile用做保存某个状态的boolean值。 部分参考自 volatile变量与普通变量的区别 <<深入理解Java虚拟机 高级特性与最佳实践>>

优秀的个人博客,低调大师

Java并发编程笔记之CyclicBarrier源码分析

JUC 中 回环屏障 CyclicBarrier 的使用与分析,它也可以实现像 CountDownLatch 一样让一组线程全部到达一个状态后再全部同时执行,但是 CyclicBarrier 可以被复用。那么 CyclicBarrier 内部的实现与 CountDownLatch 有何不同那? CounDownLatch在解决多个线程同步方面相对于调用线程的 join 已经提供了不少改进,但是CountDownLatch的计数器是一次性的,也就是等到计数器变为0后,再调用CountDownLatch的await ()和countDown()方法都会立刻返回,这就起不到线程同步的效果了。CyclicBarrier类的功能不限于CountDownLatch所提供的功能,从字面意思理解CyclicBarrier是回环屏障的意思,它可以实现让一组线程全部达到一个状态后再全部同时执行。这里之所以叫做回环是因为当所有等待线程执行完毕之后,重置CyclicBarrier的状态后可以被重用。下图演示了这一过程。 一.CyclicBarrier的实现原理 为了能一览CyclicBarrier的架构设计,下面先看下CyclicBarrier的类图,如下图: 如上面类图,可以知道CyclicBarrier 内部并不是直接使用AQS实现,而是使用了独占锁ReentrantLock来实现的同步;parties用来记录线程个数,用来表示需要多少线程先调用await后,所有线程才会冲破屏障继续往下运行;而 count 一开始等一parties,每当线程调用await方法后就递减 1 ,当为 0 的时候就表示所有线程都到了屏障点,另外你可能会疑惑为何维护parties 和 count 这两个变量,只有count 不就行了吗?别忘了CyclicBarries是可以被复用的,使用两个变量原因是用parties始终来记录总的线程个数,当count计数器变为 0 后,会使用parties 赋值给count,已达到复用的作用。这两个变量是在构造CyclicBarries对象的时候传递的,源码如下: 这里还有一个变量barrierConmmand也通过构造函数传递而来,这是一个任务,这个任务的执行时机是当所有线程都达到屏障点后。另外CyclicBarrier内部使用独占锁Lock来保证同时只有一个线程调用await方法时候才可以返回,使用lock首先保证了更新计数器count 的原子性,另外使用lock的条件变量 trip 支持了 线程间使用 notify,await 操作进行同步。 最后变量generation内部就一个变量broken用来记录当前屏障是否被打破,另外注意这里broken并没有被声明为volatile ,这是因为锁内使用变量不需要。源码如下: private static class Generation { boolean broken = false; } 接下来重点看一下CyclicBarrier的几个重要的函数,如下: 1.int await() 当前线程调用 CyclicBarrier 的该方法时候,当前线程会被阻塞,知道满足下面条件之一才会返回:(1)parties 个线程都调用了 await()方法,也就是线程都到了屏障点。(2)其他线程调用了当前线程的interrupt()方法中断了当前线程,则当前线程会抛出InterruptedException 异常返回。(3)当前屏障点关联的Generation对象的broken标志被设置为true的时候,会抛出BrokenBarrierException 异常。源码如下: public int await() throws InterruptedException, BrokenBarrierException { try { return dowait(false, 0L); } catch (TimeoutException toe) { throw new Error(toe); // cannot happen } } 正如上面代码可以知道内部调用了dowait 方法,第一个参数false说明不设置超时时间,这时候第二个参数没有意义。 2.boolean await(long timeout, TimeUnit unit) 当前线程调用 CyclicBarrier 的该方法时候当前线程会被阻塞,直到满足下面条件之一才会返回: (1) parties 个线程都调用了 await() 函数,也就是线程都到了屏障点,这时候返回 true。 (2) 当设置的超时时间到了后返回 false (3) 其它线程调用了当前线程的 interrupt()方法中断了当前线程,则当前线程会抛出 InterruptedException 异常返回。 (4) 当前屏障点关联的 Generation 对象的 broken 标志被设置为 true 时候,会抛出 BrokenBarrierException 异常。源码如下: public int await(long timeout, TimeUnit unit) throws InterruptedException, BrokenBarrierException, TimeoutException { return dowait(true, unit.toNanos(timeout)); } 正如上面代码可以知道内部调用了dowait 方法,第一个参数true说明设置超时时间,这时候第二个参数是超时时间。 3.int dowait(boolean timed, long nanos) 该方法是实现 CyclicBarrier 的核心功能,源码如下: private int dowait(boolean timed, long nanos) throws InterruptedException, BrokenBarrierException, TimeoutException { final ReentrantLock lock = this.lock; lock.lock(); try { ... //(1)如果index==0说明所有线程都到到了屏障点,则执行初始化时候传递的任务 int index = --count; if (index == 0) { // tripped boolean ranAction = false; try { //(2)执行任务 if (command != null) command.run(); ranAction = true; //(3)激活其它调用await而被阻塞的线程,并重置CyclicBarrier nextGeneration(); //返回 return 0; } finally { if (!ranAction) breakBarrier(); } } // (4)如果index!=0 for (;;) { try { //(5)没有设置超时时间, if (!timed) trip.await(); //(6)设置了超时时间 else if (nanos > 0L) nanos = trip.awaitNanos(nanos); } catch (InterruptedException ie) { ... } ... } } finally { lock.unlock(); } } private void nextGeneration() { //(7)唤醒条件队列里面阻塞线程 trip.signalAll(); //(8) 重置CyclicBarrier count = parties; generation = new Generation(); } 上面代码是dowait方法的主干代码,当一个线程调用了dowait方法后首先会获取独占锁lock,如果创建CyclicBarrier的时候传递的参数为 10 ,那么后面 9 个调用线程会被阻塞;然后当前获取线程对计数器count进行递减操作,递减后的count = index = 9 ,因为 index != 0 ,所以当前线程会执行代码(4)。如果是无参数的当前线程调用的是无参数的await()方法,则这里 timed = false,所以当前线程会被放入条件变量trip的阻塞队列,当前线程会被挂起并释放获取的Lock锁;如果调用的有参数的await 方法 则timed = true,则当前线程也会被放入条件变量阻塞队列并释放锁的资源,但是不同的是当前线程会在指定时间超时后自动激活。 当第一个获取锁的线程由于被阻塞释放锁后,被阻塞的 9 个线程中有一个会竞争到lock锁,然后执行第一个线程同样的操作,直到最后一个线程获取到lock的时候,已经有 9 个线程被放入了Lock 的条件队列里面,最后一个线程 count 递减后,count = index 等于 0 ,所以执行代码(2),如果创建CyclicBarrier的时候传递了任务,则在其他线程被唤醒前先执行任务,任务执行完毕后再执行代码(3),唤醒其他 9 个线程,并重置CyclicBarrier,然后这 10个线程就可以继续向下执行了。 到目前位置理解了CyclicBarrier的原理后,接下来用几个例子来加深对CyclicBarrier的理解,下面例子我们要实现的是使用两个线程去执行一个被分解的任务 A,当两个线程把自己的任务都执行完毕后在对它们的结果进行汇总处理。例子如下: package com.hjc; import java.util.concurrent.CyclicBarrier; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; /** * Created by cong on 2018/7/7. */ public class CyclicBarrierTest1 { // 创建一个CyclicBarrier实例,添加一个所有子线程全部到达屏障后执行的一个任务 private static volatile CyclicBarrier cyclicBarrier = new CyclicBarrier(2, new Runnable() { public void run() { System.out.println(Thread.currentThread() + " task1 merge result"); } }); public static void main(String[] args) throws InterruptedException { //创建一个线程个数固定为2的线程池 ExecutorService executorService = Executors.newFixedThreadPool(2); // 加入线程A到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " task1-1"); System.out.println(Thread.currentThread() + " enter in barrier"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " enter out barrier"); } catch (Exception e) { e.printStackTrace(); } } }); // 加入线程B到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " task1-2"); System.out.println(Thread.currentThread() + " enter in barrier"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " enter out barrier"); } catch (Exception e) { e.printStackTrace(); } } }); // 关闭线程池 executorService.shutdown(); } } 运行结果如下: 如上代码创建了一个 CyclicBarrier 对象,第一个参数为计数器初始值,第二个参数 Runable 是指当计数器为 0 时候需要执行的任务。main 函数里面首先创建了固定大小为 2 的线程池,然后添加两个子任务到线程池,每个子任务在执行完自己的逻辑后会调用 await 方法。 一开始计数器为 2,当第一个线程调用 await 方法时候,计数器会递减为 1,由于计数器不为 0,所以当前线程就到了屏障点会被阻塞,然后第二个线程调用 await 时候,会进入屏障,计数器也会递减现在计数器为 0,就会去执行在 CyclicBarrier 构造时候的任务,执行完毕后就会退出屏障点,并且会唤醒被阻塞的第一个线程,这时候第一个线程也会退出屏障点继续向下运行。 上面的例子说明了多个线程之间是相互等待的,假如计数器为 N,那么调用 await 方法的前面 N-1 的线程都会因为到达屏障点被阻塞,当第 N 个线程调用 await 后,计数器为 0 了,这时候第 N 个线程才会发出通知唤醒前面的 N-1 个线程。也就是全部线程达到屏障点时候才能一块继续向下执行,对与这个例子来说使用 CountDownLatch 也可以达到类似输出结果。 下面在放个例子来说明 CyclicBarrier 的可复用性。 假设一个任务由阶段 1、阶段 2、阶段 3 组成,每个线程要串行的执行阶段 1 和 2 和 3,多个线程执行该任务时候,必须要保证所有线程的阶段 1 全部完成后才能进行阶段 2 执行,所有线程的阶段 2 全部完成后才能进行阶段 3 执行,下面使用 CyclicBarrier 来完成这个需求。例子如下: package com.hjc; import java.util.concurrent.CyclicBarrier; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; /** * Created by cong on 2018/7/7. */ public class CyclicBarrierTest2 { // 创建一个CyclicBarrier实例 private static volatile CyclicBarrier cyclicBarrier = new CyclicBarrier(2); public static void main(String[] args) throws InterruptedException { ExecutorService executorService = Executors.newFixedThreadPool(2); // 加入线程A到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " step1"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " step2"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " step3"); } catch (Exception e) { // TODO Auto-generated catch block e.printStackTrace(); } } }); // 加入线程B到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " step1"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " step2"); cyclicBarrier.await(); System.out.println(Thread.currentThread() + " step3"); } catch (Exception e) { // TODO Auto-generated catch block e.printStackTrace(); } } }); //关闭线程池 executorService.shutdown(); } } 运行结果如下: 如上代码,在每个子线程执行完 step1 后都调用了 await 方法,所有线程都到达屏障点后才会一块往下执行,这就保证了所有线程完成了 step1 后才会开始执行 step2,然后在 step2 后面调用了 await 方法,这保证了所有线程的 step2 完成后,线程才能开始 step3 的执行,这个功能使用单个 CountDownLatch 是无法完成的。

优秀的个人博客,低调大师

Java并发编程笔记之PriorityBlockingQueue源码分析

JDK 中无界优先级队列PriorityBlockingQueue 内部使用堆算法保证每次出队都是优先级最高的元素,元素入队时候是如何建堆的,元素出队后如何调整堆的平衡的? PriorityBlockingQueue是带优先级的无界阻塞队列,每次出队都返回优先级最好或者最低的元素,内部是平衡二叉树堆的实现。 首先看一下PriorityBlockingQueue类图结构,如下: 可以看到PriorityBlockingQueue内部有个数组queue用来存放队列元素,size用来存放队列元素个数,allocationSpinLock 是个自旋锁,用CAS操作来保证只有一个线程可以扩容队列, 状态为0 或者1,其中0标示当前没有在进行扩容,1标示当前正在扩容。 我们首先看看PriorityBlockingQueue的构造函数,源码如下: private static final int DEFAULT_INITIAL_CAPACITY = 11; public PriorityBlockingQueue() { this(DEFAULT_INITIAL_CAPACITY, null); } public PriorityBlockingQueue(int initialCapacity) { this(initialCapacity, null); } public PriorityBlockingQueue(int initialCapacity, Comparator<? super E> comparator) { if (initialCapacity < 1) throw new IllegalArgumentException(); this.lock = new ReentrantLock(); this.notEmpty = lock.newCondition(); this.comparator = comparator; this.queue = new Object[initialCapacity]; } 如上构造函数,默认队列容量为11,默认比较器为null,也就是使用元素的compareTo方法进行比较来确定元素的优先级,这意味着队列元素必须实现Comparable接口。 接下来我们主要看PriorityBlockingQueue的几个操作的源码,如下: 1.offer 操作,offer操作的作用是在队列插入一个元素,由于是无界队列,所以一直返回true,源码如下: public boolean offer(E e) { if (e == null) throw new NullPointerException(); //获取独占锁 final ReentrantLock lock = this.lock; lock.lock(); int n, cap; Object[] array; //如果当前元素个数>=队列容量,则扩容(1) while ((n = size) >= (cap = (array = queue).length)) tryGrow(array, cap); try { Comparator<? super E> cmp = comparator; //默认比较器为null (2) if (cmp == null) siftUpComparable(n, e, array); else //自定义比较器 (3) siftUpUsingComparator(n, e, array, cmp); //队列元素增加1,并且激活notEmpty的条件队列里面的一个阻塞线程(9) size = n + 1; notEmpty.signal();//激活调用take()方法被阻塞的线程 } finally { //释放独占锁 lock.unlock(); } return true; } 可以看到上面代码,offer操作主流程比较简单,接下来主要关注PriorityBlockingQueue是如何进行扩容的和内部如何建立堆的,首先看扩容源码如下: private void tryGrow(Object[] array, int oldCap) { lock.unlock(); //释放获取的锁 Object[] newArray = null; //cas成功则扩容(4) if (allocationSpinLock == 0 && UNSAFE.compareAndSwapInt(this, allocationSpinLockOffset, 0, 1)) { try { //oldGap<64则扩容新增oldcap+2,否者扩容50%,并且最大为MAX_ARRAY_SIZE int newCap = oldCap + ((oldCap < 64) ? (oldCap + 2) : // 如果一开始容量很小,则扩容宽度变大 (oldCap >> 1)); if (newCap - MAX_ARRAY_SIZE > 0) { // 可能溢出 int minCap = oldCap + 1; if (minCap < 0 || minCap > MAX_ARRAY_SIZE) throw new OutOfMemoryError(); newCap = MAX_ARRAY_SIZE; } if (newCap > oldCap && queue == array) newArray = new Object[newCap]; } finally { allocationSpinLock = 0; } } //第一个线程cas成功后,第二个线程会进入这个地方,然后第二个线程让出cpu, //尽量让第一个线程执行下面点获取锁,但是这得不到肯定的保证。(5) if (newArray == null) // 如果两外一个线程正在分配,则让出 Thread.yield(); lock.lock();//(6) if (newArray != null && queue == array) { queue = newArray; System.arraycopy(array, 0, newArray, 0, oldCap); } } tryGrow 目的是扩容,这里要思考下为啥在扩容前要先释放锁,然后使用 cas 控制只有一个线程可以扩容成功呢? 其实这里不先释放锁也是可以的,也就是在整个扩容期间一直持有锁,但是扩容是需要花时间的,如果扩容的时候还占用锁,那么其他线程在这个时候是不能进行出队和入队操作的, 这大大降低了并发性。所以为了提高性能,使用CAS控制只有一个线程可以进行扩容,并且在扩容前释放了锁,让其他线程可以进行入队和出队操作。 spinlock锁使用CAS控制只有一个线程可以进行扩容,CAS失败的线程会调用Thread.yield() 让出 cpu,目的是为了让扩容线程扩容后优先调用lock.lock 重新获取锁, 但是这得不到一定的保证。有可能yield的线程在扩容线程扩容完成前已经退出,并执行了代码(6)获取到了锁。如果当前数组扩容还没完毕,当前线程会再次调用tryGrow方法, 然后释放锁,这又给扩容线程获取锁提供了机会,如果这时候扩容线程还没扩容完毕,则当前线程释放锁后又调用yield方法让出CPU。可知当扩容线程进行扩容期间, 其他线程是原地自旋通过代码(1)检查当前扩容是否完毕,等扩容完毕后才退出代码(1)的循环。 当扩容线程扩容完毕后会重置自旋锁变量allocationSpinLock 为 0,这里并没有使用UNSAFE方法的CAS进行设置是因为同时只可能有一个线程获取了该锁,并且 allocationSpinLock 被修饰为了 volatile。 当扩容线程扩容完毕后会执行代码 (6) 获取锁,获取锁后复制当前 queue 里面的元素到新数组。 接下来我们看看建堆算法,源码如下: private static <T> void siftUpComparable(int k, T x, Object[] array) { Comparable<? super T> key = (Comparable<? super T>) x; //队列元素个数>0则判断插入位置,否者直接入队(7) while (k > 0) { int parent = (k - 1) >>> 1; Object e = array[parent]; if (key.compareTo((T) e) >= 0) break; array[k] = e; k = parent; } array[k] = key;(8) } 接下来用图来解释上面的算法过程,假设队列初始化容量为2,创建的优先级队列的泛型参数为Integer。 首先调用队列offer(2)方法,希望插入元素2到队列,插入前队列状态如下图所示: 首先执行代码(1),从上图变量值可以知道判断值为false,所以紧接着执行代码(2),由于 k=n=size=0 所以代码(7)判断结果为 false,所以会执行代码(8)直接把元素 2 入队,最后执行代码(9)设置 size 的值加 1,这时候队列的状态如下图: 然后调用队列的 offer(4) 时候,首先执行代码(1),从上图变量值可知判断为 false,所以执行代码(2),由于 k=1, 所以进入 while 循环,由于 parent=0;e=2;key=4; 默认元素比较器是使用元素的 compareTo 方法, 可知 key>e 所以执行 break 退出 siftUpComparable 中的循环; 然后把元素存到数组下标为 1 的地方,最后执行代码(9)设置 size 的值加 1,这时候队列状态为: 然后调用队列的offer(6) 时候,首先执行代码(1),从上图变量值知道这时候判断值为true,所以嗲用tryGrow进行数组扩容,由于2 < 64 所以newCap=2 + (2+2)=6; 然后创建新数组并拷贝, 然后调用siftUpComparable 方法,由于 k=2>0 进入 while 循环,由于 parent=0;e=2;key=6;key>e 所以 break 后退出 while 循环; 并把元素 6 放入数组下标为 2 的地方,最后设置 size 的值加 1,现在队列状态: 然后调用队列的 offer(1) 时候,首先执行代码(1),从上图变量值知道这次判断值为 false,所以执行代码(2),由于k=3, 所以进入 while 循环,由于parent=0;e=4;key=1; key<e,所以把元素 4 复制到数组下标为 3 的地方, 然后 k=0 退出 while 循环;然后把元素 1 存放到下标为 0 地方,现在状态: 此时此刻的二叉树堆的树形图如下: 可知堆的根元素是 1,也就是这是一个最小堆,那么当调用这个优先级队列的 poll 方法时候,会一次返回堆里面值最小的元素。 2.poll操作,poll 操作作用是获取队列内部堆树的根节点元素,如果队列为空,则返回 null。源码如下: public E poll() { final ReentrantLock lock = this.lock; lock.lock();//获取独占锁 try { return dequeue(); } finally { lock.unlock();//释放独占锁 } } 如上代码可以知道在进行出队操作过程中要先加锁,这意味着,当前线程进行出队操作的时候,其他线程不能再进行入队和出队操作,但是从前面介绍offer函数的时候,知道这时候可以有其他线程进行扩容, 接下来,我们要看一下出队操作的dequeue方法的源码如下: private E dequeue() { //队列为空,则返回null int n = size - 1; if (n < 0) return null; else { //获取队头元素(1) Object[] array = queue; E result = (E) array[0]; //获取队尾元素,并值null(2) E x = (E) array[n]; array[n] = null; Comparator<? super E> cmp = comparator; if (cmp == null)//(3) siftDownComparable(0, x, array, n); else siftDownUsingComparator(0, x, array, n, cmp); size = n;//(4) return result; } } 如上代码,如果队列为空则直接返回 null,否者执行代码(1)获取数组第一个元素作为返回值存放到变量 Result,这里要注意一下数组里面第一个元素是优先级最小或者最大的元素,出队操作就是返回这个元素。 然后代码(2)获取队列尾部元素存放到变量X,并且置空尾部节点,然后执行代码(3)插入变量X 到数组下标为 0 的位置后,重新调整堆为最大或者最小堆,然后返回。 这里重要的是看如何去掉堆的根节点后,使用剩下的节点重新调整为一个最大或者最小堆。 接下来我们看看siftDownComparable 的源码,如下: private static <T> void siftDownComparable(int k, T x, Object[] array, int n) { if (n > 0) { Comparable<? super T> key = (Comparable<? super T>)x; int half = n >>> 1; // loop while a non-leaf while (k < half) { int child = (k << 1) + 1; // 假设左边子树最小 Object c = array[child];(5) int right = child + 1;(6) if (right < n && ((Comparable<? super T>) c).compareTo((T) array[right]) > 0)(7) c = array[child = right]; if (key.compareTo((T) c) <= 0)(8) break; array[k] = c; k = child; } array[k] = key;(9) } } 下面我们结合图来模拟上面调整堆的算法过程,接着上节队列的状态继续讲解,上节队列元素序列为 1,2,6,4: 第一次调用队列的 poll() 方法时候,首先执行代码(1)(2),这时候变量 size =4;n=3;result=1;x=4; 这时候队列状态图如下: 然后执行代码(3),调整堆后队列状态图,如下: 第二次调用队列的 poll() 方法时候,首先执行代码(1)(2),这时候变量 size =3;n=2;result=2;x=6; 这时候队列状态图,如下: 然后执行代码(3)调整堆后队列状态图,如下: 第三次调用队列的 poll() 方法时候,首先执行代码(1)(2),这时候变量 size =2;n=1;result=4;x=6; 这时候队列状态图,如下: 然后执行代码(3)调整堆后队列状态图,如下: 第四次直接返回元素 6. 接下来重点说说 siftDownComparable 这个调整堆的算法: 首先说下堆调整的思路,由于队列数组第 0 个元素为树根,出队时候要被移除,这时候数组就不在是最小堆了,所以需要调整堆, 具体是要从被移除的树根的左右子树中找一个最小的值来当树根,左右子树又会看自己作为树根节点的树的左右子树里面哪个是最小值,这是一个递归的过程,直到树叶节点结束递归, 如果不明白,下面结合图形来说明,假如当前队列内容如下: 对应的二叉堆树如下: 这时候如果调用了 poll(); 那么 result=2;x=11;队列末尾的元素设置为 null 后,剩下的元素调整堆的步骤如下图: 如上图(1)树根的 leftChildVal = 4;rightChildVal = 6; 4<6; 所以 c=4; 然后 11>4 也就是 key>c;所以使用元素 4 覆盖树根节点的值,现在堆对应的树如图(2)。 然后树根的左子树树根的左右孩子节点中 leftChildVal = 8;rightChildVal = 10; 8<10; 所以 c=8; 然后发现 11>8 也就是 key>c;所以元素 8 作为树根左子树的根节点,现在树的形状如图(3), 这时候判断 k<half 为 false 就会退出循环,然后把 x=11 设置到数组下标为 3 的地方,这时候堆树如图(4),至此调整堆完毕,siftDownComparable 返回 result=2,poll 方法也返回了。 3.put操作,put 操作内部调用的 offer, 由于是无界队列,所以不需要阻塞,源码如下: public void put(E e) { offer(e); // never need to block } 4.take 操作,take 操作作用是获取队列内部堆树的根节点元素,如果队列为空则阻塞,源码如下: public E take() throws InterruptedException { //获取锁,可被中断 final ReentrantLock lock = this.lock; lock.lockInterruptibly(); E result; try { //如果队列为空,则阻塞,把当前线程放入notEmpty的条件队列 while ( (result = dequeue()) == null) notEmpty.await();//阻塞当前线程 } finally { lock.unlock();//释放锁 } return result; } 如上代码,首先通过 lock.lockInterruptibly() 获取独占锁,这个方式获取的锁是对中断进行响应的。然后调用 dequeue 方法返回堆树根节点元素,如果队列为空,则返回 false, 然后当前线程调用 notEmpty.await() 阻塞挂起当前线程,直到有线程调用了 offer()方法(offer 方法内在添加元素成功后调用了 notEmpty.signal 方法会激活一个阻塞在 notEmpty 的条件队列里面的一个线程)。 另外这里使用 while 而不是 if 是为了避免虚假唤醒。 5.size操作,获取队列元个数,如下代码,在返回 size 前加了锁,保证在调用 size() 方法时候不会有其它线程进行入队和出队操作,另外由于 size 变量没有被修饰为 volatie,这里加锁也保证了多线程下 size 变量的内存可见性。源码如下: public int size() { final ReentrantLock lock = this.lock; lock.lock(); try { return size; } finally { lock.unlock(); } } 总结:PriorityBlockingQueue 队列内部使用二叉树堆维护元素优先级,内部使用数组作为元素存储的数据结构,这个数组是可以扩容的,当前元素个数 >= 最大容量的时候会通过算法扩容, 出队的时候始终保证出队的元素是堆树的根节点,而不是在队列里面停留时间最长的元素,默认元素优先级比较规则是使用元素的compareTo方法来做,用户可以自定义优先级的比较优先级。

优秀的个人博客,低调大师

Java并发编程笔记之ArrayBlockingQueue源码分析

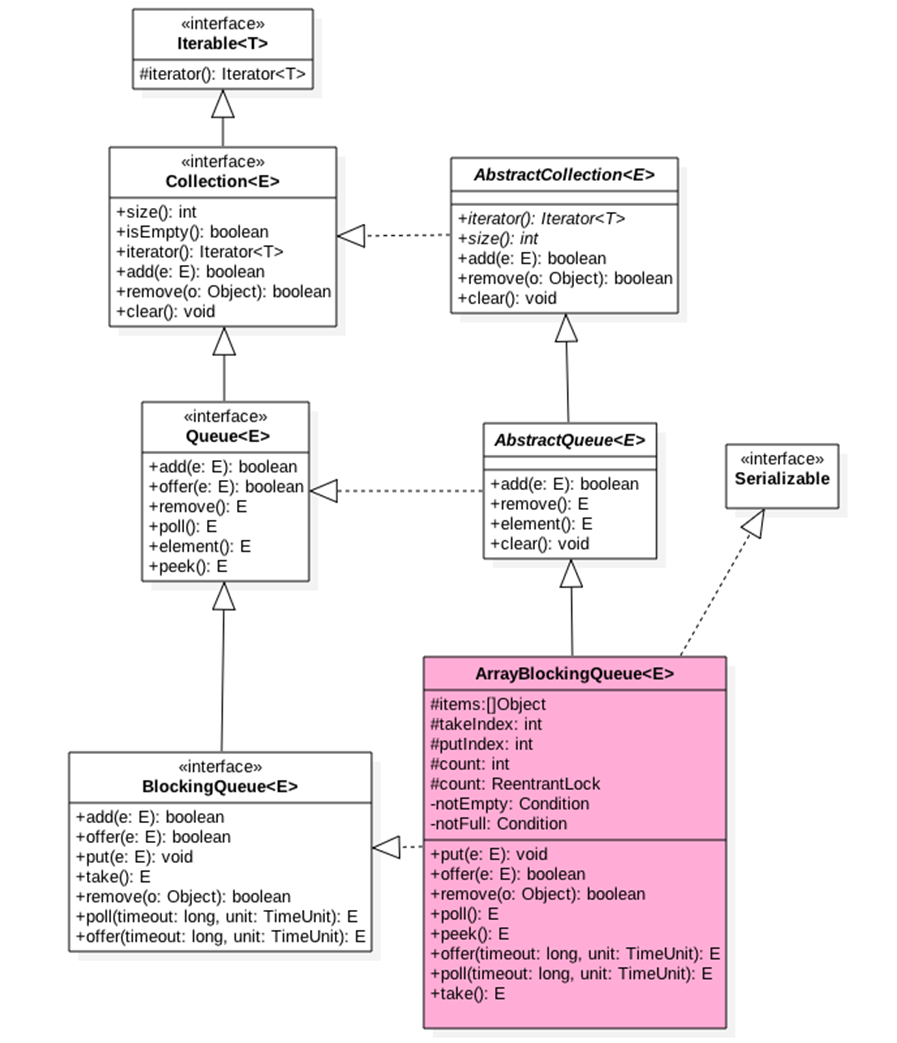
一.JDK 中基于数组的阻塞队列 ArrayBlockingQueue 原理剖析,ArrayBlockingQueue 内部如何基于一把独占锁以及对应的两个条件变量实现出入队操作的线程安全? 首先我们先大概的浏览一下ArrayBlockingQueue 的内部构造,如下类图: 如类图所示,可以看到ArrayBlockingQueue 内部有个数组items 用来存放队列元素,putIndex变量标示入队元素的下标,takeIndex是出队的下标,count是用来统计队列元素个数, 从定义可以知道,这些属性并没有使用valatile修饰,这是因为访问这些变量的使用都是在锁块内被用。而加锁了,就足以保证了锁块内变量的内存可见性。 另外还有个独占锁lock 用来保证出队入队操作的原子性,这保证了同时只有一个线程可以进行入队出队操作,另外notEmpty,notFull条件变量用来进行出队入队的同步。 由于ArrayBlockingQueue 是有界队列,所以构造函数必须传入队列大小的参数。 接下来我们进入ArrayBlockingQueue的源码看,如下: public ArrayBlockingQueue(int capacity) { this(capacity, false); } public ArrayBlockingQueue(int capacity, boolean fair) { if (capacity <= 0) throw new IllegalArgumentException(); this.items = new Object[capacity]; lock = new ReentrantLock(fair); notEmpty = lock.newCondition(); notFull = lock.newCondition(); } 如上面代码所示,默认情况下使用的是ReentrantLock提供的非公平独占锁进行入队出队操作的加锁。 接下来主要看看ArrayBlockingQueue的主要的几个操作的源码,如下: 1.offer 操作,向队列尾部插入一个元素,如果队列有空闲容量,则插入成功后返回true,如果队列已满则丢弃当前元素,然后返回false, 如果e元素为null,则抛出NullPointerException 异常,另外该方法是不阻塞的。源码如下: public boolean offer(E e) { //(1)e为null,则抛出NullPointerException异常 checkNotNull(e); //(2)获取独占锁 final ReentrantLock lock = this.lock; lock.lock(); try { //(3)如果队列满则返回false if (count == items.length) return false; else { //(4)否者插入元素 enqueue(e); return true; } } finally { lock.unlock(); } } 代码(2)获取独占锁,当前线程获取到该锁后,其他入队和出队操作的线程都会被阻塞挂起后放入lock锁的AQS阻塞队列。 代码(3)如果队列满则直接返回false,否则调用enqueue方法后返回true,enqueue的源码如下: private void enqueue(E x) { //(6)元素入队 final Object[] items = this.items; items[putIndex] = x; //(7)计算下一个元素应该存放的下标 if (++putIndex == items.length) putIndex = 0; count++; //(8) notEmpty.signal(); } 可以看到上面代码首先把当前元素放入items数组,然后计算下一个元素应该存放的下标,然后递增元素个数计数器,最后激活 notEmpty 的条件队列中因为调用 poll 或者 take 操作而被阻塞的的一个线程。 这里由于在操作共享变量,比如count前加了锁,所以不存在内存不可见问题,加过锁后获取的共享变量都是从主存获取的,而不是在CPU缓存获取寄存器里面的值。 代码(5)释放锁,释放锁后会把修改的共享变量值,比如Count的值刷新回主内存中,这样其他线程通过加锁再次读取这些共享变量后就可以看到最新的值。 2.put操作,向队列尾部插入一个元素,如果队列有空闲则插入后直接返回true,如果队列已满则阻塞当前线程直到队列有空闲插入成功后返回true, 如果在阻塞的时候被其他线程设置了中断标志,则被阻塞线程会抛出InterruptedException 异常而返回,另外如果 e 元素为 null 则抛出 NullPointerException 异常。源码如下: public void put(E e) throws InterruptedException { //(1) checkNotNull(e); final ReentrantLock lock = this.lock; //(2)获取锁(可被中断) lock.lockInterruptibly(); try { //(3)如果队列满,则把当前线程放入notFull管理的条件队列 while (count == items.length) notFull.await(); //(4)插入元素 enqueue(e); } finally { //(5) lock.unlock(); } } 代码(2)在获取锁的过程中当前线程被其它线程中断了,则当前线程会抛出 InterruptedException 异常而退出。 代码(3)判断如果当前队列满了,则把当前线程阻塞挂起后放入到 notFull 的条件队列,注意这里是使用了 while 而不是 if。为什么需要while呢? 这是因为考虑到当前线程被虚假唤醒的问题,也就是其它线程没有调用 notFull 的 singal 方法时候,notFull.await() 在某种情况下会自动返回。 如果使用if语句简单判断一下,那么虚假唤醒后会执行代码(4),元素入队,并且递增计数器,而这时候队列已经是满了的,导致队列元素个数大于了队列设置的容量,导致程序出错。 而使用使用 while 循环假如 notFull.await() 被虚假唤醒了,那么循环在检查一下当前队列是否是满的,如果是则再次进行等待。 代码(4)如果队列不满则插入当前元素。 3.poll操作,从队列头部获取并移除一个元素,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E poll() { //(1)获取锁 final ReentrantLock lock = this.lock; lock.lock(); try { //(2)当前队列为空则返回null,否者调用dequeue()获取 return (count == 0) ? null : dequeue(); } finally { //(3)释放锁 lock.unlock(); } } 代码(1)获取独占锁 代码(2)如果队列为空则返回 null,否者调用 dequeue() 方法,dequeue 源码如下: private E dequeue() { final Object[] items = this.items; //(4)获取元素值 @SuppressWarnings("unchecked") E x = (E) items[takeIndex]; //(5)数组中值值为null; items[takeIndex] = null; //(6)队头指针计算,队列元素个数减一 if (++takeIndex == items.length) takeIndex = 0; count--; //(7)发送信号激活notFull条件队列里面的一个线程 notFull.signal(); return x; } 如上代码,可以看到首先获取当前队头元素保存到局部变量,然后重置队头元素为null,并重新设置队头下标,元素计数器递减,最后发送信号激活notFull 的条件队列里面一个因为调用 put 或者 offer 而被阻塞的线程。 4.take 操作,获取当前队列头部元素,并从队列里面移除,如果队列为空则阻塞调用线程。如果队列为空则阻塞当前线程知道队列不为空,然后返回元素, 如果如果在阻塞的时候被其它线程设置了中断标志,则被阻塞线程会抛出 InterruptedException 异常而返回。源码如下: public E take() throws InterruptedException { //(1)获取锁 final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { //(2)队列为空,则等待,直到队列有元素 while (count == 0) notEmpty.await(); //(3)获取队头元素 return dequeue(); } finally { //(4) 释放锁 lock.unlock(); } } 可以看到take操作的代码也比较简单,与poll相比,只是步骤(2)如果队列为空,则把当前线程挂起后放入到notEmpty的条件队列,等其他线程调用notEmpty.signal() 方法后在返回, 需要注意的是这里也是使用 while 循环进行检测并等待而不是使用 if。之所以这样做,道理都是一样。这里就不在解释了。 5.peek 操作获取队列头部元素但是不从队列里面移除,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E peek() { //(1)获取锁 final ReentrantLock lock = this.lock; lock.lock(); try { //(2) return itemAt(takeIndex); } finally { //(3) lock.unlock(); } } @SuppressWarnings("unchecked") final E itemAt(int i) { return (E) items[i]; } peek的实现更加简单,首先获取独占锁,然后从数组items 中获取当前队头下标的值并返回,在返回之前释放了获取的锁。 6.size 操作,获取当前队列元素个数。源码如下: public int size() { final ReentrantLock lock = this.lock; lock.lock(); try { return count; } finally { lock.unlock(); } } size 操作是简单的,获取锁后直接返回 count,并在返回前释放锁。也许你会有疑问这里有没有修改Count的值,只是简单的获取下,为何要加锁呢? 答案很简单,如果count声明为volatile,这里就不需要加锁了,因为因为 volatile 类型变量保证了内存的可见性,而 ArrayBlockingQueue 的设计中 count 并没有声明为 volatile, 这是因为count的操作都是在获取锁后进行的,而获取锁的语义之一就是获取锁后访问的变量都是从主内存获取的,这就保证了变量的内存可见性。 最后用一张图来加深对ArrayBlockingQueue的理解,如下图: 总结:ArrayBlockingQueue 通过使用全局独占锁实现同时只能有一个线程进行入队或者出队操作,这个锁的粒度比较大,有点类似在方法上添加 synchronized 的意味。ArrayBlockingQueue 的 size 操作的结果是精确的,因为计算前加了全局锁。 二、Logback 框架中异步日志打印中 ArrayBlockingQueue 的使用 在高并发并且响应时间要求比较小的系统中同步打日志已经满足不了需求了,这是因为打日志本身是需要同步写磁盘的,会造成 响应时间 增加,如下图同步日志打印模型为: 异步模型是业务线程把要打印的日志任务写入一个队列后直接返回,然后使用一个线程专门负责从队列中获取日志任务写入磁盘,其模型具体如下图: 如图可知其实 logback 的异步日志模型是一个多生产者单消费者模型,通过使用队列把同步日志打印转换为了异步,业务线程调用异步 appender 只需要把日志任务放入日志队列,日志线程则负责使用同步的 appender 进行具体的日志打印到磁盘。 接下来看看异步日志打印具体实现,要把同步日志打印改为异步需要修改 logback 的 xml 配置文件如下: <appender name="PROJECT" class="ch.qos.logback.core.FileAppender"> <file>project.log</file> <encoding>UTF-8</encoding> <append>true</append> <rollingPolicy class="ch.qos.logback.core.rolling.TimeBasedRollingPolicy"> <!-- daily rollover --> <fileNamePattern>project.log.%d{yyyy-MM-dd}</fileNamePattern> <!-- keep 7 days' worth of history --> <maxHistory>7</maxHistory> </rollingPolicy> <layout class="ch.qos.logback.classic.PatternLayout"> <pattern> <![CDATA[%n%-4r [%d{yyyy-MM-dd HH:mm:ss}] %X{productionMode} - %X{method} %X{requestURIWithQueryString} [ip=%X{remoteAddr}, ref=%X{referrer}, ua=%X{userAgent}, sid=%X{cookie.JSESSIONID}]%n %-5level %logger{35} - %m%n]]> </pattern> </layout> </appender> <appender name="asyncProject" class="ch.qos.logback.classic.AsyncAppender"> <discardingThreshold>0</discardingThreshold> <queueSize>1024</queueSize> <neverBlock>true</neverBlock> <appender-ref ref="PROJECT" /> </appender> <logger name="PROJECT_LOGGER" additivity="false"> <level value="WARN" /> <appender-ref ref="asyncProject" /> </logger> 可知 AsyncAppender 是实现异步日志的关键,下节主要讲这个的内部实现。 异步原理实现 首先从 AsyncAppender 的类图结构来从全局了解下 AsyncAppender 中组件构成,类图如下所示: 从上面的类图我们可以知道如下两点: 1.如上图可知 AsyncAppender 继承自 AsyncAppenderBase,其中后者具体实现了异步日志模型的主要功能,前者只是重写了其中的一些方法。另外从上类图可知 logback 中的异步日志队列是一个阻塞队列, 后面会知道其实是一个有界阻塞队列 ArrayBlockingQueue, 其中 queueSize 是有界队列的元素个数默认为 256。 2.worker 是个线程,也就是异步日志打印模型中的单消费者线程,aai 是一个 appender 的装饰器里面存放同步日志的 appender, 其中 appenderCount 记录 aai 里面附加的同步 appender 的个数;neverBlock 是当日志队列满了的时候是否阻塞打日志的线程的一个开关;discardingThreshold 是一个阈值,当日志队列里面空闲个数小于该值时候新来的某些级别的日志会被直接丢弃,下面会具体讲到。 首先我们来看下何时创建的日志队列以及何时启动的消费线程,这需要看下 AsyncAppenderBase 的 start 方法,该方法是在解析完毕配置 AsyncAppenderBase 的 xml 的节点元素后被调用,源码如下: public void start() { ... //(1)日志队列为有界阻塞队列 blockingQueue = new ArrayBlockingQueue<E>(queueSize); //(2)如果没设置discardingThreshold则设置为队列大小的1/5 if (discardingThreshold == UNDEFINED) discardingThreshold = queueSize / 5; //(3)设置消费线程为守护线程,并设置日志名称 worker.setDaemon(true); worker.setName("AsyncAppender-Worker-" + worker.getName()); //(4)设置启动消费线程 super.start(); worker.start(); } 从上代码可知如下两点: 1. logback 使用的队列是有界队列 ArrayBlockingQueue,之所以使用有界队列是考虑到内存溢出问题,在高并发下写日志的 qps 会很高如果设置为无界队列队列本身会占用很大内存,很可能会造成 内存溢出。 2.这里消费日志队列的 worker 线程被设置为了守护线程,意味着当主线程运行结束并且当前没有用户线程时候该 worker 线程会随着 JVM 的退出而终止,而不管日志队列里面是否还有日志任务未被处理。另外这里设置了线程的名称是个很好的习惯,因为这在查找问题的时候很有帮助,根据线程名字就可以定位到是哪个线程。 既然是有界队列那么肯定需要考虑如果队列满了,该如何处置,是丢弃老的日志任务,还是阻塞日志打印线程直到队列有空余元素那? 要回答这个问题,我们需要看看具体进行日志打印的AsyncAppenderBase 的 append 方法,源码如下: protected void append(E eventObject) { //(5)调用AsyncAppender重写的isDiscardable if (isQueueBelowDiscardingThreshold() && isDiscardable(eventObject)) { return; } ... //(6)放入日志任务到队列 put(eventObject); } private boolean isQueueBelowDiscardingThreshold() { return (blockingQueue.remainingCapacity() < discardingThreshold); } 其中 (5) 调用了 AsyncAppender 重写的 isDiscardable,源码如下: //(7) protected boolean isDiscardable(ILoggingEvent event) { Level level = event.getLevel(); return level.toInt() <= Level.INFO_INT; } 结合 代码(5)和代码(7) 可知如果当前日志的级别小于 INFO_INT 级别并且当前队列的剩余容量小于 discardingThreshold 时候会直接丢弃这些日志任务。 接下来看具体步骤 (6) 的 put 方法,源码如下: private void put(E eventObject) { //(8) if (neverBlock) { blockingQueue.offer(eventObject); } else { try {//(9) blockingQueue.put(eventObject); } catch (InterruptedException e) { // Interruption of current thread when in doAppend method should not be consumed // by AsyncAppender Thread.currentThread().interrupt(); } } } 可知如果 neverBlock 设置为了 false(默认为 false)则会调用阻塞队列的 put 方法,而 put 是阻塞的,也就是说如果当前队列满了,如果在企图调用 put 方法向队列放入一个元素则调用线程会被阻塞直到队列有空余空间。这里有必要提下其中第 (9) 步当日志队列满了的时候 put 方法会调用 await() 方法阻塞当前线程,如果其它线程中断了该线程,那么该线程会抛出 InterruptedException 异常,那么当前的日志任务就会被丢弃了。如果 neverBlock 设置为了 true 则会调用阻塞队列的 offer 方法,而该方法是非阻塞的,如果当前队列满了,则会直接返回,也就是丢弃当前日志任务。 最后看下 addAppender 方法内是什么的,源码如下: public void addAppender(Appender<E> newAppender) { if (appenderCount == 0) { appenderCount++; ... aai.addAppender(newAppender); } else { addWarn("One and only one appender may be attached to AsyncAppender."); addWarn("Ignoring additional appender named [" + newAppender.getName() + "]"); } } 如上代码可知一个异步 appender 只能绑定一个同步 appender, 这个 appender 会被放到 AppenderAttachableImpl 的 appenderList 列表里面。 到这里我们已经分析完了日志生产线程放入日志任务到日志队列的实现,下面一起来看下消费线程是如何从队列里面消费日志任务并写入磁盘的,由于消费线程是一个线程,那就从 worker 的 run 方法看起,源码如下所示: class Worker extends Thread { public void run() { AsyncAppenderBase<E> parent = AsyncAppenderBase.this; AppenderAttachableImpl<E> aai = parent.aai; //(10)一直循环直到该线程被中断 while (parent.isStarted()) { try {//(11)从阻塞队列获取元素 E e = parent.blockingQueue.take(); aai.appendLoopOnAppenders(e); } catch (InterruptedException ie) { break; } } //(12)到这里说明该线程被中断,则吧队列里面的剩余日志任务 //刷新到磁盘 for (E e : parent.blockingQueue) { aai.appendLoopOnAppenders(e); parent.blockingQueue.remove(e); } ... .. } } 其中(11)从日志队列使用 take 方法获取一个日志任务,如果当前队列为空则当前线程会阻塞到 take 方法直到队列不为空才返回,获取到日志任务后会调用 AppenderAttachableImpl 的 aai.appendLoopOnAppenders 方法,该方法会循环调用通过 addAppender 注入的同步日志 appener 具体实现日志打印到磁盘的任务。

优秀的个人博客,低调大师

Java并发编程笔记之LinkedBlockingQueue源码探究

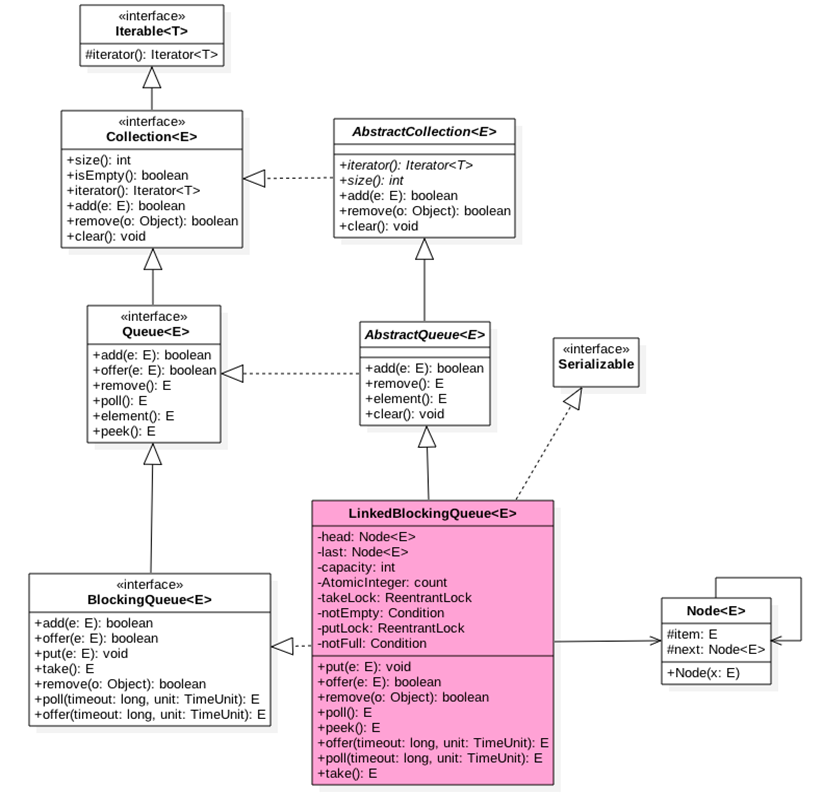
LinkedBlockingQueue的实现是使用独占锁实现的阻塞队列。首先看一下LinkedBlockingQueue的类图结构,如下图所示: 如类图所示:LinkedBlockingQueue是使用单向链表实现,有两个Node分别来存放首尾节点,并且里面有个初始值为0 的原子变量count,它用来记录队列元素个数。 另外里面有两个ReentrantLock的实例,分别用来控制元素入队和出队的原子性,其中takeLock用来控制同时只有一个线程可以从队列获取元素,其他线程必须等待, putLock控制同时只能有一个线程可以获取锁去添加元素,其他线程必须等待。另外notEmpty 和 notFull 是信号量,内部分别有一个条件队列用来存放进队和出队的时候被阻塞的线程, 说白了,这其实就是一个生产者 - 消费者模型。 我们首先看一下独占锁的源码,如下所示: /** 执行take, poll等操作时候需要获取该锁 */ private final ReentrantLock takeLock = new ReentrantLock(); /** 当队列为空时候执行出队操作(比如take)的线程会被放入这个条件队列进行等待 */ private final Condition notEmpty = takeLock.newCondition(); /** 执行put, offer等操作时候需要获取该锁*/ private final ReentrantLock putLock = new ReentrantLock(); /**当队列满时候执行进队操作(比如put)的线程会被放入这个条件队列进行等待 */ private final Condition notFull = putLock.newCondition(); /** 当前队列元素个数 */ private final AtomicInteger count = new AtomicInteger(0); 接着我们要进入LinkedBlockingQueue 无参构造函数,源码如下: public static final int MAX_VALUE = 0x7fffffff; public LinkedBlockingQueue() { this(Integer.MAX_VALUE); } public LinkedBlockingQueue(int capacity) { if (capacity <= 0) throw new IllegalArgumentException(); this.capacity = capacity; //初始化首尾节点,指向哨兵节点 last = head = new Node<E>(null); } 从源码中可以看到,默认队列的容量为0x7fffffff; 用户也可以自己指定容量,所以一定程度上 LinkedBlockingQueue 可以说是有界阻塞队列。 接下来我们主要看LinkedBlockingQueue 的几个主要方法的源码,如下: 1.offer操作,向队列尾部插入一个元素,如果队列有空闲容量则插入成功后返回true,如果队列已满则丢弃当前元素然后返回false,如果 e元素为null,则抛出空指针异常(NullPointerException),还有一点就是,该方法是非阻塞的。源码如下: public boolean offer(E e) { //(1)空元素抛空指针异常 if (e == null) throw new NullPointerException(); //(2) 如果当前队列满了则丢弃将要放入的元素,然后返回false final AtomicInteger count = this.count; if (count.get() == capacity) return false; //(3) 构造新节点,获取putLock独占锁 int c = -1; Node<E> node = new Node<E>(e); final ReentrantLock putLock = this.putLock; putLock.lock(); try { //(4)如果队列不满则进队列,并递增元素计数 if (count.get() < capacity) { enqueue(node); c = count.getAndIncrement(); //(5) if (c + 1 < capacity) notFull.signal(); } } finally { //(6)释放锁 putLock.unlock(); } //(7) if (c == 0) signalNotEmpty(); //(8) return c >= 0; } private void enqueue(Node<E> node) { last = last.next = node; } 代码(2)判断的是如果当前队列已满则丢弃当前元素并返回false。 代码(3)获取到putLock锁,当前线程获取到该锁后,则其他调用put 和 offer 的线程将会被阻塞(阻塞的线程被放到 putLock 锁的 AQS 阻塞队列)。 代码(4)这里又重新判断了一下当前队列是否满了,这是因为在执行代码(2)和获取到putLock锁期间,有可能其他线程通过put 或者 offer方法想队列里面添加了新的元素。重新判断队列确实不满则新元素入队,并递增计数器。 代码(5)判断的是如果新元素入队后还有空闲空间,则唤醒notFull的条件队列里面因为调用了notFull 的 await 操作(比如执行put方法而队列满了的时候)而被阻塞的一个线程,因为队列现在有空闲,所以这里可以提前唤醒一个入队线程。 代码(6)则释放获取的putLock锁,这里要注意锁的释放一定要在finally里面做,因为即使try块抛出异常了,finally也是会被执行到的。另外释放锁后其他因为调用put和offer而被阻塞的线程将会有一个获取到改锁。 代码(7)c == 0说明在执行代码(6)释放锁的时候队列里面至少有一个元素,队列里面有元素则执行signalNotEmpty,signalNotEmpty的源码如下: private void signalNotEmpty() { final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { notEmpty.signal(); } finally { takeLock.unlock(); } } 通过上面代码可以看到其作用是激活notEmpty 的条件队列中因为调用notEmpty的await方法(比如调用 take 方法并且队列为空的时候)而被阻塞的一个线程,这里也说明了调用条件变量的方法前,要首先获取对应的锁。 offer的总结:offer方法中通过使用putLock锁保证了在队尾新增元素的原子性和队列元素个数的比较和递增操作的原子性。 2.put操作,向队列尾部插入一个元素,如果队列有空闲则插入后直接返回true,如果队列已经满则阻塞当前线程知道队列有空闲插入成功后返回true,如果在阻塞的时候被其他线程设置了中断标志, 则被阻塞线程会抛出InterruptedException 异常而返回,另外如果 e 元素为 null 则抛出 NullPointerException 异常。源码如下: public void put(E e) throws InterruptedException { //(1)空元素抛空指针异常 if (e == null) throw new NullPointerException(); //(2) 构建新节点,并获取独占锁putLock int c = -1; Node<E> node = new Node<E>(e); final ReentrantLock putLock = this.putLock; final AtomicInteger count = this.count; putLock.lockInterruptibly(); try { //(3)如果队列满则等待 while (count.get() == capacity) { notFull.await(); } //(4)进队列并递增计数 enqueue(node); c = count.getAndIncrement(); //(5) if (c + 1 < capacity) notFull.signal(); } finally { //(6) putLock.unlock(); } //(7) if (c == 0) signalNotEmpty(); } 代码(2)中使用 putLock.lockInterruptibly() 获取独占锁,相比 offer 方法中这个获取独占锁方法意味着可以被中断,具体说是当前线程在获取锁的过程中,如果被其它线程设置了中断标志则当前线程会抛出 InterruptedException 异常, 所以put操作在获取 锁过程中是可被中断的。 代码(3)如果当前队列已经满,则notFull 的 await() 把当前线程放入 notFull 的条件队列,当前线程被阻塞挂起并释放获取到的 putLock 锁,由于putLock锁被释放了,所以现在其他线程就有机会获取到putLock锁了。 代码(3)判断队列是否为空为何使用 while 循环而不是 if 语句呢? 这是因为考虑到当前线程被虚假唤醒的问题,也就是其它线程没有调用 notFull 的 singal 方法时候,notFull.await() 在某种情况下会自动返回。 如果使用if语句简单判断一下,那么虚假唤醒后会执行代码(4),元素入队,并且递增计数器,而这时候队列已经是满了的,导致队列元素个数大于了队列设置的容量,导致程序出错。 而使用使用 while 循环假如 notFull.await() 被虚假唤醒了,那么循环在检查一下当前队列是否是满的,如果是则再次进行等待。 3.poll操作,从队列头部获取并移除一个元素,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E poll() { //(1)队列为空则返回null final AtomicInteger count = this.count; if (count.get() == 0) return null; //(2)获取独占锁 E x = null; int c = -1; final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { //(3)队列不空则出队并递减计数 if (count.get() > 0) {//3.1 x = dequeue();//3.2 c = count.getAndDecrement();//3.3 //(4) if (c > 1) notEmpty.signal(); } } finally { //(5) takeLock.unlock(); } //(6) if (c == capacity) signalNotFull(); //(7)返回 return x; } private E dequeue() { Node<E> h = head; Node<E> first = h.next; h.next = h; // help GC head = first; E x = first.item; first.item = null; return x; } 代码(1) 如果当前队列为空,则直接返回 null。 代码(2)获取独占锁 takeLock,当前线程获取该锁后,其它线程在调用 poll 或者 take 方法会被阻塞挂起。 代码 (3) 如果当前队列不为空则进行出队操作,然后递减计数器。 代码(4)如果 c>1 则说明当前线程移除掉队列里面的一个元素后队列不为空(c 是删除元素前队列元素个数),那么这时候就可以激活因为调用 poll 或者 take 方法而被阻塞到notEmpty 的条件队列里面的一个线程。 代码(5)释放锁,一定要在finally里面释放锁。 代码(6)说明当前线程移除队头元素前当前队列是满的,移除队头元素后队列当前至少有一个空闲位置,那么这时候就可以调用signalNotFull激活因为调用put 或者 offer 而被阻塞放到 notFull 的条件队列里的一个线程,signalNotFull源码如下: private void signalNotFull() { final ReentrantLock putLock = this.putLock; putLock.lock(); try { notFull.signal(); } finally { putLock.unlock(); } } poll 代码逻辑比较简单,值得注意的是获取元素时候只操作了队列的头节点。 4.peek 操作,获取队列头部元素但是不从队列里面移除,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E peek() { //(1) if (count.get() == 0) return null; //(2) final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { Node<E> first = head.next; //(3) if (first == null) return null; else //(4) return first.item; } finally { //(5) takeLock.unlock(); } } 可以看到代码(3)这里还是需要判断下 first 是否为 null 的,不能直接执行代码(4)。 正常情况下执行到代码(2)说明队列不为空,但是代码(1)和(2)不是原子性操作,也就是在执行代码(1)判断队列不为空后, 在代码(2)获取到锁前,有可能其他线程执行了poll 或者 take 操作导致队列变为了空,然后当前线程获取锁后,直接执行 first.item 会抛出空指针异常。 5.take 操作,获取当前队列头部元素并从队列里面移除,如果队列为空则阻塞调用线程。如果队列为空则阻塞当前线程知道队列不为空,然后返回元素,如果在阻塞的时候被其他线程设置了中断标志,则被阻塞线程会抛出InterruptedException 异常而返回。源码如下: public E take() throws InterruptedException { E x; int c = -1; final AtomicInteger count = this.count; //(1)获取锁 final ReentrantLock takeLock = this.takeLock; takeLock.lockInterruptibly(); try { //(2)当前队列为空则阻塞挂起 while (count.get() == 0) { notEmpty.await(); } //(3)出队并递减计数 x = dequeue(); c = count.getAndDecrement(); //(4) if (c > 1) notEmpty.signal(); } finally { //(5) takeLock.unlock(); } //(6) if (c == capacity) signalNotFull(); //(7) return x; } 代码(1)当前线程获取到独占锁,其他调用take 或者 poll的线程将会被阻塞挂起。 代码(2)如果队列为空则阻塞挂起当前线程,并把当前线程放入notEmpty 的条件队列。 代码(3)进行出队操作并递减计数。 代码(4)如果 c > 1 说明当前队列不为空,则唤醒notEmpty 的条件队列的条件队列里面的一个因为调用 take 或者 poll 而被阻塞的线程。 代码(5)释放锁。 代码(6)如果 c == capacity 则说明当前队列至少有一个空闲位置,则激活条件变量 notFull 的条件队列里面的一个因为调用 put 或者 offer 而被阻塞的线程。 6.remove操作,删除队列里面指定元素,有则删除返回 true,没有则返回 false,源码如下: public boolean remove(Object o) { if (o == null) return false; //(1)双重加锁 fullyLock(); try { //(2)遍历队列找则删除返回true for (Node<E> trail = head, p = trail.next; p != null; trail = p, p = p.next) { //(3) if (o.equals(p.item)) { unlink(p, trail); return true; } } //(4)找不到返回false return false; } finally { //(5)解锁 fullyUnlock(); } } 代码(1)通过fullyLock获取双重锁,当前线程获取后,其他线程进行入队或者出队的操作就会被阻塞挂起。双重锁方法fullyLock的源码如下: void fullyLock() { putLock.lock(); takeLock.lock(); } 代码(2)遍历队列寻找要删除的元素,找不到则直接返回false,找到则执行unlink操作,unlink的源码如下: void unlink(Node<E> p, Node<E> trail) { p.item = null; trail.next = p.next; if (last == p) last = trail; 如果当前队列满,删除后,也不忘记唤醒等待的线程 if (count.getAndDecrement() == capacity) notFull.signal(); } 可以看到删除元素后,如果发现当前队列有空闲空间,则唤醒 notFull 的条件队列中一个因为调 用 put 或者 offer 方法而被阻塞的线程。 代码(5)调用 fullyUnlock 方法使用与加锁顺序相反的顺序释放双重锁,源码如下: void fullyUnlock() { takeLock.unlock(); putLock.unlock(); } 7.size操作,获取当前队列元素个数。源码如下: public int size() { return count.get(); } 总结:由于在操作出队入队的时候操作Count的时候加了锁,因此相比ConcurrentLinkedQueue 的size方法比较准确。 最后用一张图来加深LinkedBlockingQueue的理解,如下图: 因此我们要思考一个问题:为何 ConcurrentLinkedQueue 中需要遍历链表来获取 size 而不适用一个原子变量呢? 这是因为使用原子变量保存队列元素个数需要保证入队出队操作和操作原子变量是原子操作,而ConcurrentLinkedQueue 是使用 CAS 无锁算法的,所以无法做到这个。

优秀的个人博客,低调大师

Java并发编程笔记之ConcurrentLinkedQueue源码探究

JDK 中基于链表的非阻塞无界队列 ConcurrentLinkedQueue 原理剖析,ConcurrentLinkedQueue 内部是如何使用 CAS 非阻塞算法来保证多线程下入队出队操作的线程安全? ConcurrentLinkedQueue是线程安全的无界非阻塞队列,其底层数据结构是使用单向链表实现,入队和出队操作是使用我们经常提到的CAS来保证线程安全的。 我们首先看一下ConcurrentLinkedQueue的类图结构先,好有一个内部逻辑有一个大概的印象,如下图所示: 可以清楚的看到ConcurrentLinkedQueue内部的队列是使用单向链表方式实现,类中两个volatile 类型的Node 节点分别用来存放队列的首位节点。 首先我们先来看一下ConcurrentLinkedQueue的构造函数,如下: public ConcurrentLinkedQueue() { head = tail = new Node<E>(null); } 通过无参构造函数可知默认头尾节点都是指向 item 为 null 的哨兵节点。 Node节点内部则维护一个volatile 修饰的变量item 用来存放节点的值,next用来存放链表的下一个节点,从而链接为一个单向无界链表,这就是单向无界的根本原因。如下图: 接下来看ConcurrentLinkedQueue 主要关注入队,出队,获取队列元素的方法的源码,如下所示: 1.首先看入队方法offer,offer 操作是在队列末尾添加一个元素,如果传递的参数是 null 则抛出 NPE 异常,否者由于 ConcurrentLinkedQueue 是无界队列该方法一直会返回 true。另外由于使用 CAS 无阻塞算法,该方法不会阻塞调用线程,其源码如下: public boolean offer(E e) { //(1)e为null则抛出空指针异常 checkNotNull(e); //(2)构造Node节点 final Node<E> newNode = new Node<E>(e); //(3)从尾节点进行插入 for (Node<E> t = tail, p = t;;) { Node<E> q = p.next; //(4)如果q==null说明p是尾节点,则执行插入 if (q == null) { //(5)使用CAS设置p节点的next节点 if (p.casNext(null, newNode)) { //(6)cas成功,则说明新增节点已经被放入链表,然后设置当前尾节点 if (p != t) casTail(t, newNode); // Failure is OK. return true; } } else if (p == q)//(7) //多线程操作时候,由于poll操作移除元素后有可能会把head变为自引用,然后head的next变为新head,所以这里需要 //重新找新的head,因为新的head后面的节点才是正常的节点。 p = (t != (t = tail)) ? t : head; else //(8) 寻找尾节点 p = (p != t && t != (t = tail)) ? t : q; } } 类图结构时候谈到构造队列时候参构造函数创建了一个 item 为 null 的哨兵节点,并且 head 和 tail 都是指向这个节点,下面通过图形结合来讲解下 offer 操作的代码实现。 1.首先看一下,当一个线程调用offer(item)时候情况:首先代码(1)对传参判断空检查,如果为null 则抛出空指针异常,然后代码(2)则使用item作为构造函数参数创建一个新的节点, 代码(3)从队列尾部节点开始循环,目的是从队列尾部添加元素。如下图: 上图是执行代码(4)时候队列的情况,这时候节点 p , t ,head ,tail 同时指向了item为null的哨兵节点,由于哨兵节点的next节点为null,所以这里q指向也是null。 代码(4)发现q==null 则执行代码(5),通过CAS原子操作判断p 节点的next节点是否为null,如果为null 则使用节点newNode替换p 的next节点, 然后执行代码(6),由于 p == t ,所以没有设置尾部节点,然后退出offer方法,这时候队列的状态图如下: 上面讲解的是一个线程调用offer方法的情况下,如果多个线程同时调用,就会存在多个线程同时执行到代码(5),假设线程A调用offer(item1), 线程B调用offer(item2),线程 A 和线程B同时到 p.casNext(null,newNode)。而CAS的比较并设置操作是原子性的,假设线程A先执行了比较设置操作, 则发现当前P的next节点确实是null ,则会原子性更新next节点为newNode,这时候线程B 也会判断p 的next节点是否为null,结果发现不是null,(因为线程 A 已经设置了 p 的 next 为 newNode)则会跳到代码(3), 然后执行到代码(4)的时候的队列分布图如下: 根据这个状态图可知线程B会执行代码(8),然后q 赋值给了p,这个时候状态图为: 然后线程B再次跳转到代码(3)执行,当执行到代码(4)时候队列状态图为: 由于这时候q == null ,所以线程B 会执行步骤(5),通过CAS操作判断 当前p的next 节点是否为null ,不是则再次循环后尝试,是则使用newNode替换,假设CAS成功了,那么执行步骤(6), 由于 p != t 所以设置tail节点为newNode ,然后退出offer方法。这时候队列的状态图为: 到现在为止,offer代码在执行路径现在就差步骤(7)还没有执行过,其实这个要在执行poll操作才会出现的,这里先看一下执行poll操作后可能会存在的一种情况,如下图所示: 下面分析下当队列处于这种状态调用offer添加元素代码执行到代码(4)的时候的队列状态图,如下: 由于q节点不为空并且p==q 所以执行代码(7),因为 t == tail所以p 被赋值为head ,然后进入循环,循环后执行到代码(4)的时候的队列状态图,如下: 由于 q ==null,所以执行代码(5),进行CAS操作,如果当前没有其他线程执行offer操作,则CAS操作会成功,p的next节点被设置为新增节点,然后执行代码(6), 由于p != t 所以设置新节点为队列尾节点,现在队列状态图,如下: 在这里的自引用的节点会被垃圾回收掉,可见offer操作里面关键步骤是代码(5)通过原子CAS操作来进行控制同时只有一个线程可以追加元素到队列末尾,进行cas竞争失败的线程, 则会通过循环一次次尝试进行cas操作,知道cas成功才会返回,也就是通过使用无限循环里面不断进行CAS尝试方式来替代阻塞算法挂起调用线程,相比阻塞算法,这是使用CPU资源换取阻塞带来的开销。 2.poll操作,poll 操作是在队列头部获取并且移除一个元素,如果队列为空则返回 null,我们首先看改方法的源码,如下: public E poll() { //(1) goto标记 restartFromHead: //(2)无限循环 for (;;) { for (Node<E> h = head, p = h, q;;) { //(3)保存当前节点值 E item = p.item; //(4)当前节点有值则cas变为null if (item != null && p.casItem(item, null)) { //(5)cas成功标志当前节点以及从链表中移除 if (p != h) updateHead(h, ((q = p.next) != null) ? q : p); return item; } //(6)当前队列为空则返回null else if ((q = p.next) == null) { updateHead(h, p); return null; } //(7)自引用了,则重新找新的队列头节点 else if (p == q) continue restartFromHead; else//(8) p = q; } } } final void updateHead(Node<E> h, Node<E> p) { if (h != p && casHead(h, p)) h.lazySetNext(h); } poll操作是从队头获取元素,所以代码(2)内层循环是从head节点开始迭代,代码(3)获取当前队头的节点,当队列一开始为空的时候队列状态为: 由于head 节点指向的item 为null 的哨兵节点,所以会执行到代码(6),假设这个过程没有线程调用offer,则此时q等于null ,如下图: 所以执行updateHead方法,由于h 等于 p所以没有设置头节点,poll方法直接返回null。 假设执行到代码(6)的时候已经有其他线程调用了offer 方法成功添加了一个元素到队列,这时候q执行的是新增元素的节点,这时候队列状态图为: 所以代码(6)判断结果为false,然后会转向代码(7)执行,而此时p不等于q,所以转向代码(8)执行,执行结果是p指向了节点q,此时的队列状态如下: 然后程序转向代码(3)执行,p现在指向的元素值不为null,则执行p.casItem(item, null)通过 CAS 操作尝试设置 p 的 item 值为 null, 如果此时没有其他线程进行poll操作,CAS成功则执行代码(5),由于此时 p != h ,所以设置头节点为p,poll然后返回被从队列移除的节点值item。此时队列状态为: 这个状态就是前面提到offer操作的时候,offer代码的执行路径(7)执行的前提状态。 假如现在一个线程调用了poll操作,则在执行代码(4)的时候的队列状态为: 可以看到这时候执行代码(6)返回null。 现在poll的代码还有个分支(7)还没有被执行过,那么什么时候会执行呢?假设线程A执行poll操作的时候,当前的队列状态,如下: 那么执行p.casItem(item, null)通过 CAS 操作尝试设置 p 的 item 值为 null。 假设 CAS 设置成功则标示该节点从队列中移除了,此时队列状态为: 然后由于p != h,所以会执行updateHead 方法,假如线程A执行updateHead前,另外一个线程B开始poll操作,这时候线程B的p指向head节点, 但是还没有执行到代码(6),这时候队列状态为: 然后线程A执行updateHead 操作,执行完毕后线程 A 退出,这时候队列状态为: 然后线程B继续执行代码(6)q=p.next由于该节点是自引用节点所以p==q,所以会执行代码(7)跳到外层循环restartFromHead,重新获取当前队列队头 head, 现在状态为: 总结:poll元素移除一个 元素的时候,只是简单的使用CAS操作把当前节点的item值设置为null,然后通过重新设置头节点让该元素从队列里面摘除, 被摘除的节点就成了孤立节点,这个节点会被在GC的时候会被回收掉。另外,执行分支中如果发现头节点被修改了要跳到外层循环重新获取新的头节点。 3.peek操作,peek 操作是获取队列头部一个元素(只不获取不移除),如果队列为空则返回 null,其源码如下: public E peek() { //(1) restartFromHead: for (;;) { for (Node<E> h = head, p = h, q;;) { //(2) E item = p.item; //(3) if (item != null || (q = p.next) == null) { updateHead(h, p); return item; } //(4) else if (p == q) continue restartFromHead; else //(5) p = q; } } } 代码结构与poll操作类似,不同于代码(3)的使用只是少了castItem 操作,其实这很正常,因为peek只是获取队列头元素值,并不清空其值, 根据前面我们知道第一次执行 offer 后 head 指向的是哨兵节点(也就是 item 为 null 的节点),那么第一次peek的时候,代码(3)中会发现item==null, 然后会执行 q = p.next, 这时候 q 节点指向的才是队列里面第一个真正的元素或者如果队列为 null 则 q 指向 null。 当队列为空的时候,队列状态图,如下: 这时候执行updateHead 由于 h 节点等于 p 节点所以不进行任何操作,然后 peek 操作会返回 null。 当队列中至少有一个元素的时候(假如只有一个),这时候队列状态为: 这时候执行代码(5)这时候 p 指向了 q 节点,然后执行代码(3)这时候队列状态为: 执行代码(3)发现 item 不为 null,则执行 updateHead 方法,由于 h!=p, 所以设置头结点,设置后队列状态为: 可以看到其实就是剔除了哨兵节点。 总结:peek操作代码与poll操作类似,只是前者只获取队列头元素,但是并不从队列里面删除,而后者获取后需要从队列里面删除,另外,在第一次调用peek操作的时候, 会删除哨兵节点,并让队列的head节点指向队列里面第一个元素或者null。 4.size方法,获取当前队列元素个数,在并发环境下不是很有用,因为 CAS 没有加锁所以从调用 size 函数到返回结果期间有可能增删元素,导致统计的元素个数不精确。源码如下: public int size() { int count = 0; for (Node<E> p = first(); p != null; p = succ(p)) if (p.item != null) // 最大返回Integer.MAX_VALUE if (++count == Integer.MAX_VALUE) break; return count; } //获取第一个队列元素(哨兵元素不算),没有则为null Node<E> first() { restartFromHead: for (;;) { for (Node<E> h = head, p = h, q;;) { boolean hasItem = (p.item != null); if (hasItem || (q = p.next) == null) { updateHead(h, p); return hasItem ? p : null; } else if (p == q) continue restartFromHead; else p = q; } } } //获取当前节点的next元素,如果是自引入节点则返回真正头节点 final Node<E> succ(Node<E> p) { Node<E> next = p.next; return (p == next) ? head : next; } 5.remove方法,如果队列里面存在该元素则删除给元素,如果存在多个则删除第一个,并返回 true,否者返回 false。源码如下: public boolean remove(Object o) { //查找元素为空,直接返回false if (o == null) return false; Node<E> pred = null; for (Node<E> p = first(); p != null; p = succ(p)) { E item = p.item; //相等则使用cas值null,同时一个线程成功,失败的线程循环查找队列中其它元素是否有匹配的。 if (item != null && o.equals(item) && p.casItem(item, null)) { //获取next元素 Node<E> next = succ(p); //如果有前驱节点,并且next不为空则链接前驱节点到next, if (pred != null && next != null) pred.casNext(p, next); return true; } pred = p; } return false; } ConcurrentLinkedQueue 底层使用单向链表数据结构来保存队列元素,每个元素被包装为了一个 Node 节点,队列是靠头尾节点来维护的,创建队列时候头尾节点指向一个 item 为 null 的哨兵节点, 第一次 peek 或者 first 时候会把 head 指向第一个真正的队列元素。由于使用非阻塞 CAS 算法,没有加锁,所以获取 size 的时候有可能进行了 offer,poll 或者 remove 操作,导致获取的元素个数不精确,所以在并发情况下 size 函数不是很有用。

优秀的个人博客,低调大师

Java并发编程笔记之ReentrantLock源码分析

ReentrantLock是可重入的独占锁,同时只能有一个线程可以获取该锁,其他获取该锁的线程会被阻塞后放入该锁的AQS阻塞队列里面。 首先我们先看一下ReentrantLock的类图结构,如下图所示: 从类图可以知道,ReentrantLock最终还是使用AQS来实现,并且根据参数决定内部是公平锁还是非公平锁,默认是非公平锁。 首先我们先看ReentrantLock源码,看到其构造函数及其参数,这是决定内部是公平锁还是非公平锁,如下源码所示: public ReentrantLock() { sync = new NonfairSync(); } public ReentrantLock(boolean fair) { sync = fair ? new FairSync() : new NonfairSync(); } 其中类Sync直接继承自AQS,它的子类NonfairSync和FairSync分别实现了获取锁的公平和非公平策略。 在这里AQS的状态值state代表线程获取该锁的可重入次数,默认情况下state的值为0,标示当前锁没有被任何线程持有,当一个线程第一次获取该锁的时候会尝试使用CAS设置state的值为1,如果CAS成功则当前线程获取了该锁,然后记录该锁的持有者为当前线程, 在该线程没有释放锁,第二次获取该锁后,状态值会加1,被设置为2,这就是可重入次数,在该线程释放该锁的时候,会尝试使用CAS让状态值减1,如果减1 后状态值为0 则当前线程释放该锁。 接下来我们看一下ReentrantLock是如何获取锁的,如下: 1.void lock() 当一个线程调用该方法,说明该线程希望获取该锁,如果锁当前没有被其它线程占用并且当前线程之前没有获取该锁,则当前线程会获取到该锁,然后设置当前锁的拥有者为当前线程,并设置 AQS 的状态值为 1 后直接返回。 如果当前线程之前已经获取过该锁,则这次只是简单的把 AQS 的状态值 status 加 1 后返回。 如果该锁已经被其它线程持有,则调用该方法的线程会被放入 AQS 队列后阻塞挂起。源码如下: public void lock() { sync.lock(); } 如上面代码所示,ReentrantLock的lock()是委托给sync类,根据创建ReentrantLock的时候,构造函数选择sync的实现是NonfairSync或者FairSync,这里先看sync的子类NonfairSync的情况,也就是非公平锁的时候,源码如下: final void lock() { //(1)CAS设置状态值 if (compareAndSetState(0, 1)) setExclusiveOwnerThread(Thread.currentThread()); else //(2)调用AQS的acquire方法 acquire(1); } 如上面代码所示,代码(1)因为默认AQS的状态值为0,所以第一个调用Lock的线程会通过CAS设置状态值为1,CAS成功则代表当前线程获取到了锁,然后setExclusiveOwnerThread 设置了该锁持有者是当前线程。 如果这时候有其他线程调用lock方法企图获取该锁,执行代码(1)CAS会失败,然后会调用AQS的acquire方法,这里注意传递参数为1,接下来我们看AQS的acquire的核心代码,如下: public final void acquire(int arg) { //(3)调用ReentrantLock重写的tryAcquire方法 if (!tryAcquire(arg) && // tryAcquiref返回false会把当前线程放入AQS阻塞队列 acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } 之前说过 AQS 并没有提供可用的 tryAcquire 方法,tryAcquire 方法需要子类自己定制化,所以这里代码(3)会调用 ReentrantLock 重写的 tryAcquire 方法代码。 这里先看下非公平锁的源码代码如下: protected final boolean tryAcquire(int acquires) { return nonfairTryAcquire(acquires); } final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); //(4)当前AQS状态值为0 if (c == 0) { if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } }//(5)当前线程是该锁持有者 else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; }//(6) return false; } 正如上面代码(4)会看当前锁的状态值是否为0,为0则说明当前该锁空闲,那么就尝试CAS获取该锁(尝试将 AQS 的状态值从 0 设置为 1),并设置当前锁的持有者为当前线程返回返回 true。 如果当前状态值不为0 则说明该锁已经被某个县城持有,所以代码(5)看当前线程是否是该锁的持有者,如果当前线程是该锁持有者,状态值增加1,然后返回true。 如果当前线程不是锁的持有者则返回 false, 然后会被放入 AQS 阻塞队列。 到目前为止,介绍完了非公平锁的实现代码,回过头看看非公平锁在这里是怎么体现的,首先非公平是说:先尝试获取锁的线程并不一定比后尝试获取锁的线程优先获取锁。 这里假设线程 A 调用 lock()方法时候执行到了 nonfairTryAcquire 的代码(4)发现当前状态值不为 0,所以执行代码(5)发现当前线程不是线程持有者,则执行代码(6)返回 false,然后当前线程会被放入了 AQS 阻塞队列。 这时候线程 B 也调用了 lock() 方法执行到 nonfairTryAcquire 的代码(4)时候发现当前状态值为 0 了(假设占有该锁的其它线程释放了该锁)所以通过 CAS 设置获取到了该锁。而明明是线程 A 先请求获取的该锁那,这就是非公平锁的实现, 这里线程 B 在获取锁前并没有看当前 AQS 队列里面是否有比自己请求该锁更早的线程,而是使用了抢夺策略。 好了,知道非公平锁的实现了,那么我们接下来看一下公平锁是如何实现的呢? 公平锁的实现只需要看FairSync重写的tryAcquire方法,源码如下: protected final boolean tryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); //(7)当前AQS状态值为0 if (c == 0) { //(8)公平性策略 if (!hasQueuedPredecessors() && compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } //(9)当前线程是该锁持有者 else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); setState(nextc); return true; }//(10) return false; } } 如上代码公平性的tryAcquire策略与非公平锁的类似,不同在于代码(8)处设置CAS前添加了hasQueuedPredecessors 方法,该方法是实现公平性的核心代码,源代码如下: public final boolean hasQueuedPredecessors() { Node t = tail; // Read fields in reverse initialization order Node h = head; Node s; return h != t &&((s = h.next) == null || s.thread != Thread.currentThread()); } 如上代码所示,如果当前线程节点有前驱节点则返回true,否则如果当前AQS队列为空或者当前线程节点是AQS的第一个节点则返回false。 其中如果h == t 则说明当前队列为空则直接返回false,如果h != t 并且 (s = h.next) ==null 说明有一个元素将要作为AQS的第一个节点入队列,那么返回true, 如果h != t 并且 (s = h.next) !=null 并且 s.thread !=Thread.currentThread() 则说明队列里面的第一个元素不是当前线程则返回 true。 2.void lockInterruptibly() 与 lock() 方法类似,不同在于该方法对中断响应,就是当前线程在调用该方式时候,如果其它线程调用了当前线程线程的 interrupt()方法,当前线程会抛出 InterruptedException 异常然后返回,源代码如下: public void lockInterruptibly() throws InterruptedException { sync.acquireInterruptibly(1); } public final void acquireInterruptibly(int arg)throws InterruptedException { //当前线程被中断则直接抛出异常 if (Thread.interrupted()) throw new InterruptedException(); //尝试获取资源 if (!tryAcquire(arg)) //调用AQS可被状态的方法 doAcquireInterruptibly(arg); } 3.boolean tryLock() 尝试获取锁,如果当前该锁没有被其它线程持有则当前线程获取该锁并返回 true, 否者返回 false,注意该方法不会引起当前线程阻塞。源码如下所示: public boolean tryLock() { return sync.nonfairTryAcquire(1); } final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 如上代码与非公平锁的 tryAcquire() 方法类似,所以 tryLock() 使用的是非公平策略。 4.boolean tryLock(long timeout, TimeUnit unit) 尝试获取锁与 tryLock()不同在于设置了超时时间,如果超时没有获取该锁则返回 false。源代码如下: public boolean tryLock(long timeout, TimeUnit unit)throws InterruptedException { //调用AQS的tryAcquireNanos方法。 return sync.tryAcquireNanos(1, unit.toNanos(timeout)); } 接下来我们要看一下,ReentrantLock是如何释放锁的。 1.void unlock() 尝试释放锁,如果当前线程持有该锁,调用该方法会让该线程对该线程持有的 AQS 状态值减一,如果减去 1 后当前状态值为 0 则当前线程会释放对该锁的持有,否者仅仅减一而已。 如果当前线程没有持有该锁调用了该方法则会抛出 IllegalMonitorStateException 异常 ,源代码如下: public void unlock() { sync.release(1); } protected final boolean tryRelease(int releases) { //(11)如果不是锁持有者调用UNlock则抛出异常。 int c = getState() - releases; if (Thread.currentThread() != getExclusiveOwnerThread()) throw new IllegalMonitorStateException(); boolean free = false; //(12)如果当前可重入次数为0,则清空锁持有线程 if (c == 0) { free = true; setExclusiveOwnerThread(null); } //(13)设置可重入次数为原始值-1 setState(c); return free; } 如上代码所示(11)如果当前线程不是该锁持有者则直接抛异常,否则,看状态值剩余值是否为0,为0 则说明当前线程要释放对该锁的持有权,则执行代码(12)把当前锁持有者设置为null。 如果剩余值不为0,则仅仅让当前线程对该锁的可重入次数减1。 到目前基本了解了ReentrantLock的原理,那么接下来我们是否可以用ReentrantLock来实现一个简单的线程安全的list呢? 例子如下: import java.util.ArrayList; import java.util.concurrent.locks.ReentrantLock; /** * Created by cong on 2018/6/12. */ public class ReentrantLockList { //线程不安全的list private ArrayList<String> array = new ArrayList<String>(); //独占锁 private volatile ReentrantLock lock = new ReentrantLock(); //添加元素 public void add(String e) { lock.lock(); try { array.add(e); } finally { lock.unlock(); } } //删元素 public void remove(String e) { lock.lock(); try { array.remove(e); } finally { lock.unlock(); } } //获取数据 public String get(int index) { lock.lock(); try { return array.get(index); } finally { lock.unlock(); } } } 如上代码通过在操作 array 元素前进行加锁保证同时只有一个线程可以对 array 数组进行修改,但是同时也只能有一个线程对 array 元素进行访问。 最后几个图加深前面所学的内容,如下图所示: 如上图,假如线程 Thread1,Thread2,Thread3 同时尝试获取独占锁 ReentrantLock,假设 Thread1 获取到了,则 Thread2 和 Thread3 就会被转换为 Node 节点后放入 ReentrantLock 对应的 AQS 阻塞队列后阻塞挂起。 如上图,假设 Thread1 获取锁后调用了对应的锁创建的条件变量 1,那么 Thread1 就会释放获取到的锁,然后当前线程就会被转换为 Node 节点后插入到条件变量 1 的条件队列,由于 Thread1 释放了锁, 所以阻塞到 AQS 队列里面 Thread2 和 Thread3 就有机会获取到该锁,假如使用的公平策略,那么这时候 Thread2 会获取到该锁,会从 AQS 队列里面移除 Thread2 对应的 Node 节点。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册