首页 文章 精选 留言 我的

精选列表

搜索[计算机组成原理],共10000篇文章
优秀的个人博客,低调大师

解密 云HBase 冷热分离技术原理

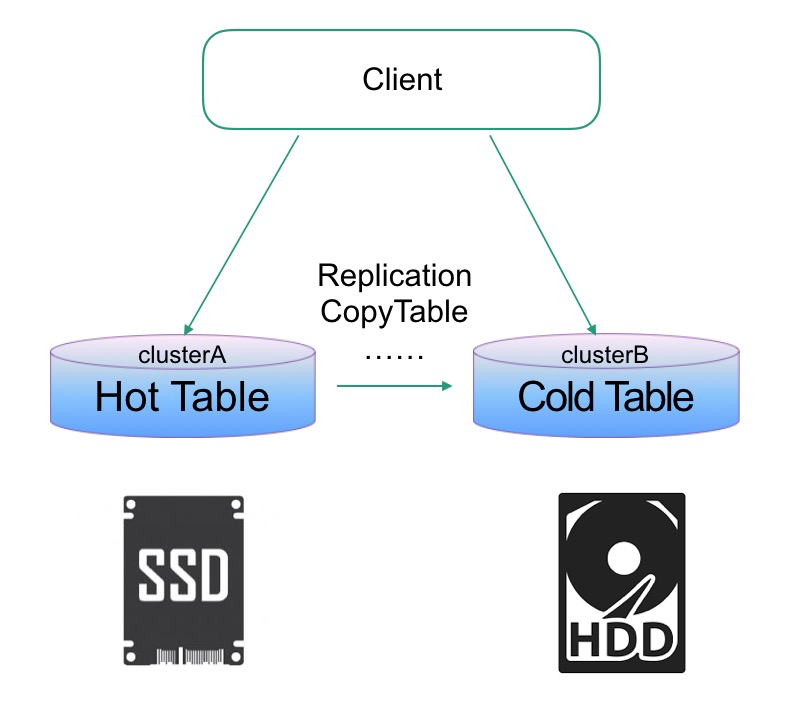
前言 HBase是当下流行的一款海量数据存储的分布式数据库。往往海量数据存储会涉及到一个成本问题,如何降低成本。常见的方案就是通过冷热分离来治理数据。冷数据可以用更高的压缩比算法(ZSTD),更低副本数算法(Erasure Coding),更便宜存储设备(HDD,高密集型存储机型)。 HBase冷热分离常见解决方案 1.主备集群 备(冷)集群用更廉价的硬件,主集群设置TTL,这样当数据热度退去,冷数据自然只在冷集群有。 优点:方案简单,现成内核版本都能搞缺点:维护开销大,冷集群CPU存在浪费 1.x版本的HBase在不改内核情况下,基本只能有这种方案。 2.HDFS Archival Storage + HBase CF-level Storage Policy 需要在2.x之后的版本才能使用。结合HDFS分层存储能力 + 在Table层面指定数据存储策略,实现同集群下,不同表数据的冷热分离。 优点:同一集群冷热分离,维护开销少,更灵活的配置不同业务表的策略缺点:磁盘配比是个很大的问题,不同业务冷热配比是不一样的,比较难整合在一起,一旦业务变动,集群硬件配置是没法跟着变的。 云HBase冷热分离解决方案 上述2套方案都不是最好的方案,对于云上来说。第一套方案就不说了,客户搞2个集群,对于数据量不大的客户其实根本降不了成本。第二套方案,云上客户千千万,业务各有各样,磁盘配置是很难定制到合适的状态。 云上要做 cloud native 的方案,必须满足同集群下,极致的弹性伸缩,才能真正意义上做到产品化。云上低成本,弹性存储,只有OSS了。所以很自然的想到如下架构: 实现这样的架构,最直接的想法是直接改HBase内核:1)增加冷表数据标记 2)根据标记增加写OSS的IO路径。 这样做的缺陷非常明显,你的外部系统(如:备份恢复,数据导入导出)很难兼容这些改动,他们需要感知哪些是冷文件得去OSS哪个位置读,哪些是热文件得去部署在云盘上的HDFS上读。这些本质上都是一些重复的工作,所以从架构设计角度来看必须抽象出一层。这一层能读写HDFS文件,读写OSS文件,感知冷热文件。这一层也就是我最后设计出的ApsaraDB FileSystem,实现了Hadoop FileSystem API。对于HBase,备份恢复,数据导入导出等系统只要替换原先FileSystem的实现即可获得冷热分离的功能。 下面将详细阐述,这套FileSystem设计的细节与难点。 ApsaraDB FileSystem 设计 核心难点A 1.OSS并非文件系统 OSS并不是一个真正意义上的文件系统,它仅仅是两级映射 bucket/object,所以它是对象存储。你在OSS上看到类似这样一个文件:/root/user/gzh/file。你会以为有3层目录+1个文件。实际上只有一个对象,这个对象的key包含了/字符罢了。 这么带来的一个问题是,你要想在其上模拟出文件系统,你必须先能创建目录。很自然想到的是用/结尾的特殊对象代表目录对象。Hadoop社区开源的OssFileSystem就是这么搞的。有了这个方法,就能判断到底存不存在某个目录,能不能创建文件,不然会凭空创建出一个文件,而这个文件没有父目录。 当然你这么做依然会有问题。除了开销比较大(创建深层目录多次HTTP请求OSS),最严重的是正确性的问题。试想一下下面这个场景:把目录/root/user/source rename 成 /root/user/target。这个过程除了该目录,它底下的子目录,子目录里的子文件都会跟着变。类似这样:/root/user/source/file => /root/user/target/file。这很好理解,文件系统就是一颗树,你rename目录,实际是把某颗子树移动到另一个节点下。这个在NameNode里的实现也很简单,改变下树结构即可。 但是如果是在OSS上,你要做rename,那你不得不递归遍历/root/user/source把其下所有目录对象,文件对象都rename。因为你没法通过移动子树这样一个简单操作一步到位。这里带来的问题就是,假设你递归遍历到一半,挂了。那么就可能会出现一半目录或文件到了目标位置,一半没过去。这样rename这个操作就不是原子的了,本来你要么rename成功,整个目录下的内容到新的地方,要么没成功就在原地。所以正确性会存在问题,像HBase这样依赖rename操作将临时数据目录移动到正式目录来做数据commit,就会面临风险。 2.OSS rename实则是数据拷贝 前面我们提到了rename,在正常文件系统中应该是一个轻量级的,数据结构修改操作。但是OSS并没有rename这个操作实际上,rename得通过 CopyObject + DeleteObject 两个操作完成。首先是copy成目标名字,然后delete掉原先的Object。这里有2个明显的问题,一个是copy是深度拷贝开销很大,直接会影响HBase的性能。另一个是rename拆分成2个操作,这2个操作是没法在一个事物里的,也就是说:可能存在copy成功,没delete掉的情况,此时你需要回滚,你需要delete掉copy出来的对象,但是delete依然可能不成功。所以rename操作本身实现上,正确性就难以保证了。 解决核心难点A 解决上面2个问题,需要自己做元数据管理,即相当于自己维护一个文件系统树,OSS上只放数据文件。而因为我们环境中仍然有HDFS存储在(为了放热数据),所以直接复用NameNode代码,让NodeNode帮助管理元数据。所以整体架构就出来了: ApsaraDB FileSystem(以下简称ADB FS)将云端存储分为:主存(PrimaryStorageFileSystem)和 冷存(ColdStorageFileSystem)。由ApsaraDistributedFileSystem类(以下简称ADFS)负责管理这两类存储文件系统,并且由ADFS负责感知冷热文件。 ApsaraDistributedFileSystem: 总入口,负责管理冷存和主存,数据该从哪里读,该写入哪里(ADFS)。主存:PrimaryStorageFileSystem 默认实现是 DistributedFileSystem(HDFS)冷存:ColdStorageFileSystem 默认实现是 HBaseOssFileSystem(HOFS) ,基于OSS实现的Hadoop API文件系统,可以模拟目录对象单独使用,也可以只作为冷存读写数据,相比社区版本有针对性优化,后面会讲。 具体,NameNode如何帮助管理冷存上的元数据,很简单。ADFS在主存上创建同名索引文件,文件内容是索引指向冷存中对应的文件。实际数据在冷存中,所以冷存中的文件有没有目录结构无所谓,只有一级文件就行。我们再看下一rename操作过程,就明白了: rename目录的场景也同理,直接在NameNode中rename就行。对于热文件,相当于全部代理HDFS操作即可,冷文件要在HDFS上创建索引文件,然后写数据文件到OSS,然后关联起来。 核心难点B 引入元数据管理解决方案,又会遇到新的问题:是索引文件和冷存中数据文件一致性问题。我们可能会遇到如下场景: 主存索引文件存在,冷存数据文件不存在 冷存数据文件存在,主存索引文件不存住 主存索引文件信息不完整,无法定位冷存数据文件 先排除BUG或者人为删除数据文件因素,上诉3种情况都会由于程序crash产生。也就是说我们要想把法,把生成索引文件,写入并生成冷数据文件,关联,这3个操作放在一个事物里。这样才能具备原子性,才能保证要么创建冷文件成功,那么索引信息是完整的,也指向一个存在的数据文件。要么创建冷文件失败(包括中途程序crash),永远也见不到这个冷文件。 解决核心难点B 核心思想是利用主存的rename操作,因为主存的rename是具备原子性的。我们先在主存的临时目录中生产索引文件,此时索引文件内容已经指向冷存中的一个路径(但是实际上这个路径的数据文件还没开始写入)。在冷存完成写入,正确close后,那么此时我们已经有完整且正确的索引文件&数据文件。然后通过rename一把将索引文件改到用户实际需要写入到目标路径,即可。 如果中途进程crash,索引文件要么已经rename成功,要么索引文件还在临时目录。在临时目录我们认为写入没有完成,是失败的。然后我们通过清理线程,定期清理掉N天以前临时目录的文件即可。所以一旦rename成功,那目标路径上的索引文件一定是完整的,一定会指向一个写好的数据文件。 为什么我们需要先写好路径信息在索引文件里?因为如果先写数据文件,在这个过程中crash了,那我们是没有索引信息指向这个数据文件的,从而造成类似“内存泄漏”的问题。 冷热文件标记 对于主存,需要实现给文件冷热标记的功能,通过标记判断要打开怎样的数据读写流。这点NameNode可以通过给文件设置StoragePolicy实现。这个过程就很简单了,不详细赘述,下面说HBaseOssFileSystem写入优化设计。 HBaseOssFileSystem 写入优化 在说HOFS写设计之前,我们先要理解Hadoop社区版本的OssFileSystem设计(这也是社区用户能直接使用的版本)。 社区版本写入设计 Write -> OutputStream -> disk buffer(128M) -> FileInputStream -> OSS 这个过程就是先写入磁盘,磁盘满128M后,将这128M的block包装成FileInputStream再提交给OSS。这个设计主要是考虑了OSS请求成本,OSS每次请求都是要收费的,但是内网流量不计费。如果你1KB写一次,费用就很高了,所以必须大块写。而且OSS大文件写入,设计最多让你提交10000个block(OSS中叫MultipartUpload),如果block太小,那么你能支持的最大文件大小也是受限。 所以要攒大buffer,另外一个因素是Hadoop FS API提供的是OutputStream让你不断write。OSS提供的是InputStream,让你提供你要写入内容,它自己不断读取。这样你必然要通过一个buffer去转换。 这里会有比较大的一个问题,就是性能慢。写入磁盘,再读取磁盘,多了这么两轮会比较慢,虽然有PageCache存在,读取过程不一定有IO。那你肯定想,用内存当buffer不就好了。内存当buffer的问题就是前面说的,有费用,所以buffer不能太小。所以你每个文件要开128M内存,是不可能的。更何况当你提交给OSS的时候,你要保证能继续写入新数据,你得有2块128M内存滚动,这个开销几乎不能接受。 HBaseOssFileSystem 写入设计 我们既要解决费用问题,也要解决性能问题,同时要保证开销很低,看似不可能,那么怎么做呢? 这里要利用的就是这个InputStream,OSS让你提供InputStream,并从中读取你要写入的内容。那么我们可以设计一个流式写入,当我传入这个InputStream给OSS的时候,流中并不一定得有数据。此时OSS调read读取数据会block在read调用上。等用户真的写入数据,InputStream中才会有数据,这时候OSS就能顺利读到数据。当OSS读了超过128M数据时候,InputStream会自动截断,返回EOF,这样OSS会以为流已经结束了,那么这块数据就算提交完成。 所以我们本质只要开发这么一个特殊的InputStream即可。用户向Hadoop API提供的OutputStream中写入数据,数据每填满一个page(2M)就发给InputStream让其可读取。OuputStream相当于生产者,InputStream相当于消费者。这里的内存开销会非常低,因为生产者速度和消费者速度相近时,也就2个page的开销。最后将这整套实现封装成OSSOutputStream类,当用户要写入冷文件时,实际提供的是OSSOutputStream,这里面就包含了这个特殊InputStream的控制过程。 当然实际生产中,我们会对page进行控制,每个文件设置最多4个page。并且这4个page循环利用,减少对GC对影响。所以最后我们得到下面一个环形缓冲的写入模式: 性能对比1:社区版本 vs 云HBase版 因为不用写磁盘,所以写入吞吐可以比社区的高很多,下图为HBase1.0上测试结果。在一些大KV,写入压力更大的场景,实测可以接近1倍。这个比较是通过替换ADFS冷存的实现(用社区版本和云HBase版本),都避免了rename深拷贝问题。如果直接裸用社区版本而不用ADFS那性能会差数倍。 性能对比2:热表 vs 冷表 热表数据在云盘,冷表数据在OSS。 得益于上述优化,加上冷表WAL也是放HDFS的,并且OSS相对HBase来说是大集群(吞吐上限高),冷表的HDFS只用抗WAL写入压力。所以冷表吞吐反而会比热表略高一点点。 不管怎么说,冷表的写入性能和热表相当了,这样的表现已经相当不错了。基本是不会影响用户灌数据,否则使用冷存后,吞吐掉很多,那意味着要更多机器,那这功能就没什么意义了。 总结 这大约是1年多前落地的项目,已经稳定运行很久。之前也有出去分享过,但是没有今天这么细致。现在写出来主要是自我总结下。当设计一个服务去解决某个问题的时候,上下游的关系,可能存在的问题得考虑清楚。在做这个项目最初的时候,想把HBase直接架设在社区版本OssFileSytem上,发现性能不行外,正确性也存在很大风险。不断思考,考虑各种情况后才有了今天这套方案。

优秀的个人博客,低调大师

浅谈Java多线程与并发原理

前序 线程安全问题的主要诱因 存在共享数据(也称临界资源) 存在多条线程共同操作这些共享数据 解决方法:同一时刻有且只有一个线程在操作共享数据,其他线程必须等到该线程处理完数据后再对共享数据进行操作 互斥锁的特征 互斥性:即在同一时间只允许一个线程持有某个对象锁,通过这种特性来实现多线程协调机制,这样在同一时间只有一个线程对需要同步的代码块(复合操作)进行访问。互斥性也称为操作的原子性。可见性:必须确保在锁被释放之前,对共享变量所做的修改,对于随后获得该锁的另一个线程是可见的(即在获得锁时应该获得最新共享变量的值),否则另一个线程可能是在本地缓存的某个副本上继续操作,从而引起不一致。注:synchronized 锁的不是代码,锁的是对象 获取锁的分类:获取对象锁、获取类锁 获取对象锁的两种用法: 同步代码块(synchronized(this),s

优秀的个人博客,低调大师

区块链的原理与应用? -2

接着上一篇.上一篇还没有输出,其实加入了index在实体类中. package com.sha256.sha256.bean; import com.sha256.sha256.utils.SHA256Util; import lombok.AllArgsConstructor; import lombok.Data; import lombok.NoArgsConstructor; import java.util.Date; @Data @NoArgsConstructor @AllArgsConstructor public class Block { private long index; private String hash; // our signature private String previousHash; // the hash of previous block private String data; //our data will be a simple message. private long timeStamp; //as number of milliseconds since 1/1/1970. //Block Constructor public Block(long index,String data,String previousHash){ this.index = index; this.data = data; this.previousHash = previousHash; this.timeStamp = new Date().getTime(); this.hash = SHA256Util.calculateHash(this); //Making sure we do this after we set the other values. } } 测试类: package com.sha256.sha256.test; import com.alibaba.fastjson.JSONArray; import com.alibaba.fastjson.JSONObject; import com.google.gson.GsonBuilder; import com.sha256.sha256.bean.Block; import com.sha256.sha256.utils.SHA256Util; import java.util.ArrayList; import java.util.Random; public class TestSHA256 { //声明一个区块链,用于添加Block实体 public static ArrayList<Block> blockChain = new ArrayList<>(); public static void main(String[] args) { //test1 测试三个被加密字符串 加密后的hash值的差别 /** * 虽然第三条信息仅仅多一个".",但加密后的数据hash相差极大 */ // String message0 = "我是要被加密的信息"; // String message1 = "我是要被加密的信息"; // String message2 = "我是要被加密的信息."; // String encryptionMessage0 = SHA256Util.applySha256(message0); // String encryptionMessage1 = SHA256Util.applySha256(message1); // String encryptionMessage2 = SHA256Util.applySha256(message2); // System.out.println(encryptionMessage0); // System.out.println(encryptionMessage1); // System.out.println(encryptionMessage2); // // //test2 创建区块链逻辑, 因为第一个块没有上一个块的hash头部值,所以输入0 作为前一个块的previous hash // /** // * 由于在{@link SHA256Util#calculateHash(Block)} // * 中对同时产生的new Date().getTime() (timestamp) // * 也加入进行了hash加密,所以固有的message (data)及 // * previoushash之和进行了加密. // */ // Block genesisBlock = new Block(0,"这是第一个区块中的要被加密的信息和交易信息","0"); // String hash1 = genesisBlock.getHash(); // System.out.println("Hash for block 1 : "+hash1); // // Block secondBlock = new Block(1,"这是第二个区块,以及其中信息!!!它的前区块头部hash我们拿上一个的来使用",hash1); // String hash2 = secondBlock.getHash(); // // System.out.println("Hash for block 2 : "+hash2); // // Block thirdBlock = new Block(2,"这是第三个区块,它的hash应该已经被前两个的信息纳入进来了,它的hash如果对不上,那么说明前面的信息被改动过了",hash2); // String hash3 = thirdBlock.getHash(); // System.out.println("Hash for block 3 : "+hash3); // //// test3 add our blocks to the blockchain ArrayList : // blockChain.add(new Block(0,"区块链上第一小节","0")); // blockChain.add(new Block(1,"区块链第二小节",blockChain.get(blockChain.size()-1).getHash())); // blockChain.add(new Block(2,"区块链第三小节",blockChain.get(blockChain.size()-1).getHash())); int chainNumber = 24; int index = 0; while (chainNumber > 0) { System.out.println("blockChain.size():" + blockChain.size()); if (blockChain.size() == 0) { blockChain.add(new Block(0, "创世块", "0")); } index++; blockChain.add(new Block(index, "区块内容" + blockChainMessage(index), blockChain.get(blockChain.size() - 1).getHash())); chainNumber--; } // JSONArray blockChainJson1 = (JSONArray)JSONArray.toJSON(blockChain); //JSONArray是不排版的 // System.out.println(blockChainJson1); String blockChainJson = new GsonBuilder().setPrettyPrinting().create().toJson(blockChain); System.out.println(blockChainJson); } //模拟一些交易信息 private static String blockChainMessage(int getNumber) { Random random = new Random(getNumber); long l = random.nextLong(); System.out.println("blockChainMessage:" + l); return String.valueOf(l); } }

优秀的个人博客,低调大师

深入剖析线程同步工具CountDownLatch原理

0 CountDownLatch的作用 CountDownLatch作为一个多线程间的同步工具,它允许一个或多个线程等待其他线程(可以是多个)完成工作后,再恢复执行。 就像下面这样: 1 从一个Demo说起 我们直接拿源码中给出的Demo看一下,源码中的这个demo可以看做模拟一个赛跑的场景。 赛跑肯定有跑得快的运动员也有跑的慢的运动员,每个运动员就表示一个线程。 运动员听到枪声后开始起跑,而最后一个运动员到达终点后,标志的比赛的结束。 整个过程如下图所示: CountDownLatch跑步模拟 源码如下所示 public class Race { private static final int N = 4; public static void main(String[] args) throws InterruptedException { CountDownLatch startSignal = new CountDownLatch(1); // 鸣枪开始信号 CountDownLatch doneSignal = new CountDownLatch(N); // 等待N个运动员都跑完后,比赛结束(结束信号) for (int i = 0; i < N; ++i) // N个运动员准备就绪,等待枪声 new Thread(new Runner(startSignal, doneSignal, i)).start(); Thread.sleep(1000); // 等待所有运动员就绪 System.out.println("所有运动员就绪"); startSignal.countDown(); // 鸣枪,开赛 System.out.println("比赛进行中..."); doneSignal.await(); // 等待N个运动员全部跑完(等待doneSignal变为0) System.out.println("比赛结束"); } } class Runner implements Runnable { private final CountDownLatch startSignal; private final CountDownLatch doneSignal; private int number; Runner(CountDownLatch startSignal, CountDownLatch doneSignal, int number) { this.startSignal = startSignal; this.doneSignal = doneSignal; this.number = number; } public void run() { try { // 等待枪声(等待开始信号startSignal变为0) System.out.println(number + "号运动员准备就绪"); startSignal.await(); // 赛跑 System.out.println(number + "号运动员跑步中..."); Thread.sleep(new Random().nextInt(10) * 1000); // 此运动员跑到终点 System.out.println(number + "号运动员到达终点"); doneSignal.countDown(); } catch (InterruptedException ex) {} // return; } } 上面代码运行后,输出如下: 0号运动员准备就绪 3号运动员准备就绪 2号运动员准备就绪 1号运动员准备就绪 所有运动员就绪 比赛进行中... 0号运动员跑步中... 1号运动员跑步中... 2号运动员跑步中... 3号运动员跑步中... 2号运动员到达终点 1号运动员到达终点 0号运动员到达终点 3号运动员到达终点 比赛结束 下面,深入到代码细节,看一下CountDownLatch初始化、countDown方法、await方法是如何实现的。 2 CountDownLatch类图 通过下图来了解一下CountDownLatch的类继承关系 CountDownLatch类图 3 CountDownLatch的初始化 CountDownLatch只有一个构造方法: public CountDownLatch(int count) { if (count < 0) throw new IllegalArgumentException("count < 0"); this.sync = new Sync(count); } 他会初始化一个Sync,这是他的一个内部类,类似于ReentrantLock,Sync也继承于AbstractQueuedSynchronizer(AQS)。 AQS是个啥?可以参考笔者的另一篇文章:Java队列同步器(AQS)到底是怎么一回事 然后看一下Sync的源码 private static final class Sync extends AbstractQueuedSynchronizer { private static final long serialVersionUID = 4982264981922014374L; // 调用AQS的setState方法,将state赋值为count的值 Sync(int count) { setState(count); } // 获取AQS state的当前值 int getCount() { return getState(); } protected int tryAcquireShared(int acquires) { return (getState() == 0) ? 1 : -1; } protected boolean tryReleaseShared(int releases) { // Decrement count; signal when transition to zero for (;;) { int c = getState(); if (c == 0) return false; int nextc = c-1; if (compareAndSetState(c, nextc)) return nextc == 0; } } } 所以CountDownLatch的初始化,其实是将参数count的值赋值给AQS的state,依然是用state来控制同步状态。 4 await方法的实现依然用上面赛跑的例子来说明这个问题。这里我们只考虑所有运动员等待枪声的情景。 回忆一下,赛跑的例子中,通过下面的方式创建了鸣枪信号: CountDownLatch startSignal = new CountDownLatch(1); // 鸣枪开始信号 然后创建了N个线程(表示N个运动员),并调用其start方法让其开始执行(运动员准备就绪,等待鸣枪开跑)。 然后通过在run方法中调用startSignal.await(),来实现等待鸣枪的动作(其实就是等startSignal的值降为0)。 我们来看一下他是怎么await的。 public void await() throws InterruptedException { sync.acquireSharedInterruptibly(1); } 调用了AQS的acquireSharedInterruptibly方法 public final void acquireSharedInterruptibly(int arg) throws InterruptedException { // 判断线程是否已经被中断 if (Thread.interrupted()) throw new InterruptedException(); // 调用CountDownLatch.Sync的tryAcquireShared方法 // 此方法判断count的值是否==0,如果==0,返回1,否则返回-1 // 目前我们还没有执行countDown,所以count肯定不等于0,这里肯定返回-1 // 所以会执行到AQS的doAcquireSharedInterruptibly方法中 if (tryAcquireShared(arg) < 0) doAcquireSharedInterruptibly(arg); } protected int tryAcquireShared(int acquires) { return (getState() == 0) ? 1 : -1; } AQS.doAcquireSharedInterruptibly的实现如下 / * Acquires in shared interruptible mode. * @param arg the acquire argument */ // 此方法会在count>0时将当前线程加入到等待队列中 // 由于我们目前还没有执行countDown,所以count会保持>0 // 启动的N个线程会全部加入到队列中 private void doAcquireSharedInterruptibly(int arg) throws InterruptedException { // 将当前线程添加到等待队列中(SHARED模式) final Node node = addWaiter(Node.SHARED); boolean failed = true; try { // 自旋获取同步状态 for (;;) { final Node p = node.predecessor(); if (p == head) { // 依然调用CountDownLatch.Sync的tryAcquireShared方法判断 // 如果count降为0,退出自旋 int r = tryAcquireShared(arg); if (r >= 0) { setHeadAndPropagate(node, r); p.next = null; // help GC failed = false; return; } } // 将node的waitStatus设置为-1(常量SIGNAL,表示需要唤醒),并阻塞 if (shouldParkAfterFailedAcquire(p, node) && parkAndCheckInterrupt()) throw new InterruptedException(); } } finally { if (failed) cancelAcquire(node); } }** ```** 假设N=4,那么4个线程全部start后,会全部加入到队列中自旋等待,像下面这样: CountDownLatch.await自旋等待 5 countDown方法的实现 countDown方法实际上就是将AQS中的state的值-1。然后判断当前state的值是否==0,如果等于0,说明所有线程都执行结束了,需要唤醒所有等待的线程。 依然继续上面的场景,鸣枪后,所有的运动员开跑。 鸣枪这个动作实际上就是在主线程中执行: startSignal.countDown(); 这就相当于向刚才队列中的所有线程发了一个恢复执行的信号,所有线程会被唤醒,继续执行await后面的代码。 countDown具体干了啥呢? public void countDown() {sync.releaseShared(1);} 他会调用AQS的releaseShared方法 public final boolean releaseShared(int arg) {// 调用CountDownLatch.Sync的tryReleaseShared方法// 该方法尝试将count值-1,并判断-1后的count是否==0,如果==0,返回true,否则false// 该方法的源码已经在Sync的源码中给出,可翻阅上文查看if (tryReleaseShared(arg)) {doReleaseShared();return true;}return false;} 由于startSignal中count的初始值==1,startSignal.countDown()后,count变为0。所以tryReleaseShared会返回true。 然后开始执行doReleaseShared,唤醒队列中的线程。 doReleaseShared是AQS中的方法。 /** Release action for shared mode -- signals successor and ensures propagation. (Note: For exclusive mode, release just amounts to calling unparkSuccessor of head if it needs signal.)/private void doReleaseShared() {/ Ensure that a release propagates, even if there are other in-progress acquires/releases. This proceeds in the usual way of trying to unparkSuccessor of head if it needs signal. But if it does not, status is set to PROPAGATE to ensure that upon release, propagation continues. Additionally, we must loop in case a new node is added while we are doing this. Also, unlike other uses of unparkSuccessor, we need to know if CAS to reset status fails, if so rechecking.*/for (;;) {Node h = head;if (h != null && h != tail) {int ws = h.waitStatus;// Node.SIGNAL == -1// 由上文可知,进入队列的线程的waitStatus都等于-1// 所以这里为trueif (ws == Node.SIGNAL) {// 尝试将waitStatus从-1改为0,如果修改成功,就恢复这个线程的执行状态if (!compareAndSetWaitStatus(h, Node.SIGNAL, 0))continue; // loop to recheck casesunparkSuccessor(h);}else if (ws == 0 &&!compareAndSetWaitStatus(h, 0, Node.PROPAGATE))continue; // loop on failed CAS}if (h == head) // loop if head changedbreak;}} 这里,被阻塞的线程又恢复执行,恢复到哪了呢?就是刚才自旋等待的那里。 把上面的源码直接拿下来,再说明一下(注释部分) private void doAcquireSharedInterruptibly(int arg) throws InterruptedException { // 将当前线程添加到等待队列中(SHARED模式) final Node node = addWaiter(Node.SHARED); boolean failed = true; try { // 线程被释放后,继续下一次循环 for (;;) { final Node p = node.predecessor(); if (p == head) { int r = tryAcquireShared(arg); // 获取头节点,从头结点开始释放,由于count已经降为0,所以r >= 0为true // 然后会将自己摘除当前队列,使下一个节点成为头节点 // 等下一个节点也恢复过来后,同样执行上面的过程 // 这样,队列中的所有线程就被释放了 if (r >= 0) { setHeadAndPropagate(node, r); p.next = null; // help GC failed = false; return; } } // 将node的waitStatus设置为-1(常量SIGNAL,表示需要唤醒),并阻塞 if (shouldParkAfterFailedAcquire(p, node) && parkAndCheckInterrupt()) throw new InterruptedException(); } } finally { if (failed) cancelAcquire(node); } } 6 总结 本文从源码层面详细说明了CountDownLatch是如何运作的。 CountDownLatch也是基于AQS实现,所以了解AQS的机制,对于理解本文至关重要。 其实,CountDownLatch最核心的就是通过控制AQS的state,来同步多个线程之间的状态。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册