首页 文章 精选 留言 我的

精选列表

搜索[基础软件],共10000篇文章
优秀的个人博客,低调大师

HarmonyOS NEXT自由流转能力解析(基础)

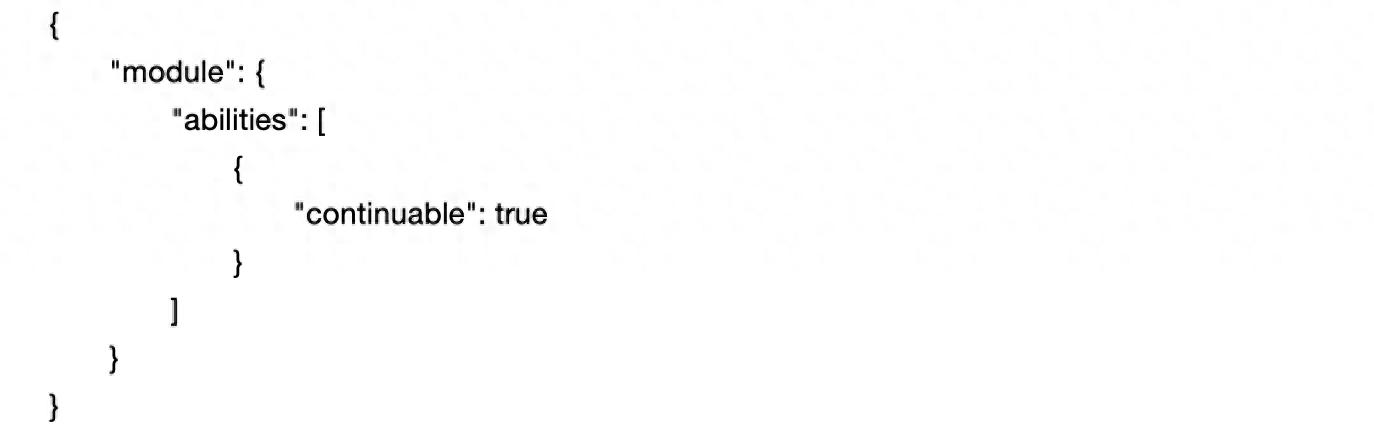
踏入鸿蒙世界的敲门砖,标志着您在技术征途上的全新起点,提升就业竞争力,获得行业认可,点亮职业成长先机,快人一步抢占未来应用开发赛道!https://developer.huawei.com/consumer/cn/training/dev-cert-detail/101666948302721398?ha_source=hmosclass-kaiyuanzhongguo&ha_sourceId=89000441 在HarmonyOS NEXT的生态体系中,自由流转能力是实现多设备协同的关键,它打破了设备之间的壁垒,让用户能够在不同设备间畅享无缝的操作体验。今天,咱们就来深入剖析一下这项强大的能力。 自由流转的核心概念(跨端迁移 vs 多端协同) 自由流转是HarmonyOS NEXT中跨多设备分布式操作的统称,其中跨端迁移和多端协同是两种重要的实现形式。 跨端迁移就像是一场应用的“设备之旅”。在用户使用设备的过程中,一旦使用情境发生变化,比如从室外回到室内,发现原本使用的手机在处理某些任务时不太方便,而身边的平板更合适,此时就可以借助跨端迁移,将正在手机上运行的应用“搬”到平板上继续使用。从开发角度来讲,就是A设备上运行的UIAbility迁移到B设备上,A设备上的UIAbility可根据实际需求选择是否退出。例如,在手机上观看视频时,回到家将视频迁移到智慧屏上继续播放,视频的播放进度、播放设置等都能原封不动地延续,给用户带来无缝的观看体验。 多端协同则更像是设备之间的“团队协作”。多个设备作为一个整体,共同为用户提供比单设备更高效、更沉浸的服务。多个设备上的不同UIAbility或ServiceExtensionAbility可以同时运行,也能交替运行来完成完整的业务。比如,在两台设备上同时打开备忘录的同一篇笔记进行协同编辑,设备A可以插入本地图库中的图片,设备B负责文字内容的编辑,不同设备各司其职,大大提升了用户的编辑效率和体验。 典型应用场景分析 1、 邮件跨设备编辑:这是跨端迁移的典型应用。当用户在手机上撰写邮件时,中途切换到电脑上继续编辑。HarmonyOS NEXT的自由流转能力会保存邮件的编辑状态,包括已输入的内容、插入的附件以及设置的格式等。在电脑上打开邮件应用时,这些信息会被完整恢复,就好像用户一直在电脑上编辑一样。开发时,通过应用接续技术,在源端UIAbility的onContinue()接口中保存邮件数据,在目的端的onCreate()或onNewWant()接口中恢复数据,实现邮件编辑的无缝切换。 2、 多设备协同健身:在这个场景中,多端协同发挥得淋漓尽致。用户佩戴智能手表进行运动,手表实时采集心率、步数等数据。同时,手机或平板上的健身应用接收这些数据,并根据数据提供个性化的运动建议、展示运动课程视频等。手机还能作为控制中心,方便用户调整健身计划。开发过程中,需要实现不同设备间的数据实时传输和交互,确保各个设备上的应用能够协同工作,为用户提供全面的健身体验。 3、 多屏游戏:多屏游戏充分展现了自由流转的魅力。以一款冒险游戏为例,玩家在手机上进行游戏的前期探索和操作。当连接到大屏电视后,游戏画面自动切换到电视上,借助电视的大屏幕和高画质,玩家能获得更震撼的视觉体验。此时,手机可以作为游戏手柄,利用其传感器实现精准操控。这一过程中,跨端迁移实现了游戏画面和操作的无缝切换,多端协同让手机和电视共同为玩家打造出沉浸式的游戏体验。开发者需要解决设备间的图形同步、操作指令传输以及性能优化等问题,确保游戏在不同设备上都能流畅运行。 实战案例:如何让一个应用在多个设备上自由切换 下面通过一个简单的文本编辑器应用示例,展示如何实现应用在多个设备上的自由切换。 配置应用接续能力 在module.json5文件的abilities中,将continuable标签配置为true,表示该UIAbility可被迁移: 在源端保存数据 在源端UIAbility中实现onContinue()接口,保存文本编辑器中的内容: 在目的端恢复数据 在目的端UIAbility中实现onCreate()或onNewWant()接口,恢复文本编辑器的内容: 通过以上步骤,就可以实现一个简单的文本编辑器应用在多个设备上的自由切换,用户在不同设备上打开应用时,都能继续之前的编辑工作。当然,在实际应用开发中,还需要考虑更多的细节,如数据的一致性、设备兼容性等问题,但这个示例为大家提供了一个基本的实现思路。 HarmonyOS NEXT的自由流转能力为开发者提供了广阔的创新空间,通过合理运用跨端迁移和多端协同技术,我们可以打造出更加智能、高效的多设备应用,为用户带来前所未有的便捷体验。希望大家在实际开发中能够充分利用这一能力,创造出更多优秀的应用。(转载自51CTO,作者:SameX)

优秀的个人博客,低调大师

GaussDB SQL基础语法示例-循环语句

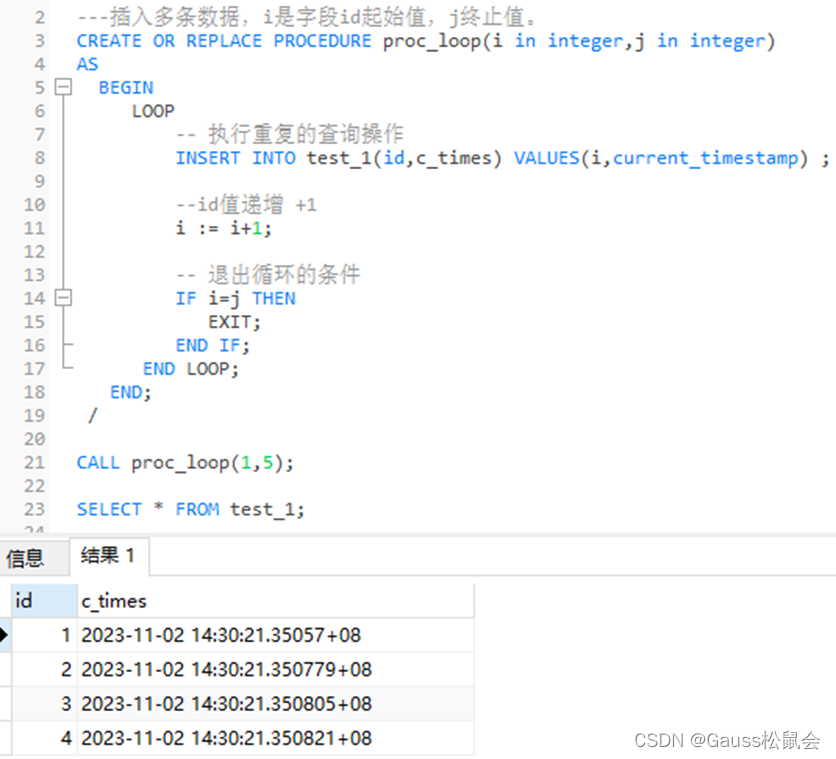
一、前言 SQL是用于访问和处理数据库的标准计算机语言。GaussDB支持SQL标准(默认支持SQL2、SQL3和SQL4的主要特性)。 本系列将以《云数据库GaussDB—SQL参考》为主线进行介绍。 二、GaussDB数据库总的循环语句 在GaussDB数据库中,循环语句是一种常用的控制流语句,用于在数据库查询中执行重复操作。通过使用循环语句,我们可以灵活地处理数据集中的每一行,并根据需要对数据进行转换、过滤或计算。循环语句在处理大规模数据、进行复杂计算和操作时具有显著的优势。 在GaussDB数据库中,循环语句主要包括LOOP、WHILE LOOP、FOR LOOP和FORALL等语句。这些语句用于在数据库查询中执行重复操作,并可以根据需要选择合适的循环类型来处理数据集中的每一行。 本文将介绍GaussDB数据库中的循环语句及其应用。 三、GaussDB中常用循环语句(语法 + 示例) 1、LOOP循环语句 LOOP循环是一个无限循环,直到显式地使用EXIT语句退出循环。在循环体内部,可以根据条件执行重复的查询操作。例如,可以使用IF语句在每次循环时检查条件,并执行相应的操作。 语法: LOOP statements END LOOP; Tip: 该循环必须要结合EXIT使用,否则将陷入死循环。 示例: ---插入多条数据,i是字段id起始值,j终止值。 CREATE OR REPLACE PROCEDURE proc_loop(i in integer,j in integer) AS BEGIN LOOP -- 执行重复的插数操作 INSERT INTO test_1(id,c_times) VALUES(i,current_timestamp) ; --id值递增 +1 i := i+1; -- 退出循环的条件 IF i=j THEN EXIT; END IF; END LOOP; END; / CALL proc_loop(1,5); SELECT * FROM test_1; 2、WHILE … LOOP 循环语句 WHILE … LOOP循环是一个有条件的循环,只要满足指定的条件,循环就会继续执行。在循环体内部,可以执行重复的查询操作。当条件不再满足时,循环会终止。 语法: WHILE condition LOOP statements END LOOP; 示例: ---插入多条数据,i是字段id起始值,j终止值。 CREATE OR REPLACE PROCEDURE proc_loop_1(i in integer,j in integer) AS BEGIN WHILE i < j LOOP -- 执行重复的查询操作 INSERT INTO test_1(id,c_times) VALUES(i,current_timestamp); --id值递增 +1 i := i+1; END LOOP; END; / CALL proc_loop_1(5,10); SELECT * FROM test_1; 3、FOR … LOOP循环语句(integer变量) FOR LOOP循环是按照指定的次数执行循环。在循环体内部,可以执行重复的查询操作。 语法: FOR name IN [REVERSE] lower_bound ..upper_bound [BY step] LOOP staements END LOOP; Tip: 变量name会自动定义为integer类型并且只在此循环里存在。变量name介于lower_bound和upper_bound之间。 当使用REVERSE关键字时,lower_bound必须大于等于upper_bound,否则循环体不会被执行。 示例: ---插入多条数据,i是字段id起始值,j终止值。 CREATE OR REPLACE PROCEDURE proc_loop_2(i in integer,j in integer) AS BEGIN FOR i IN i..j LOOP -- 执行重复的查询操作 INSERT INTO test_1(id,c_times) VALUES(i,current_timestamp); END LOOP; END; / CALL proc_loop_2(10,15); SELECT * FROM test_1; 4、FORALL循环语句(批量查询) FORALL循环是一种并行化的循环,用于在数据集上执行并行操作。它适用于处理大规模数据集,可以利用多核处理器并行执行查询操作。 语法: FORALL index IN lower_bound .. upper_bound DML; Tip:变量index会自动定义为integer类型并且只在此循环里存在。index的取值介于low_bound和upper_bound之间。 示例: ---插入多条数据, CREATE OR REPLACE PROCEDURE proc_loop_3(i in integer,j in integer) AS BEGIN FORALL i IN i..j -- 执行重复的查询操作 INSERT INTO test_1(id,c_times) VALUES(i,current_timestamp); END; / CALL proc_loop_3(16,20); SELECT * FROM test_1; 四、小结 本文介绍了GaussDB数据库中的循环语句及其使用方法。循环语句提供了灵活的数据处理能力。通过掌握循环语句的用法,我们可以更好地利用GaussDB数据库的功能,提高数据处理效率和查询性能。

优秀的个人博客,低调大师

Spring基础只是—AOP的概念介绍

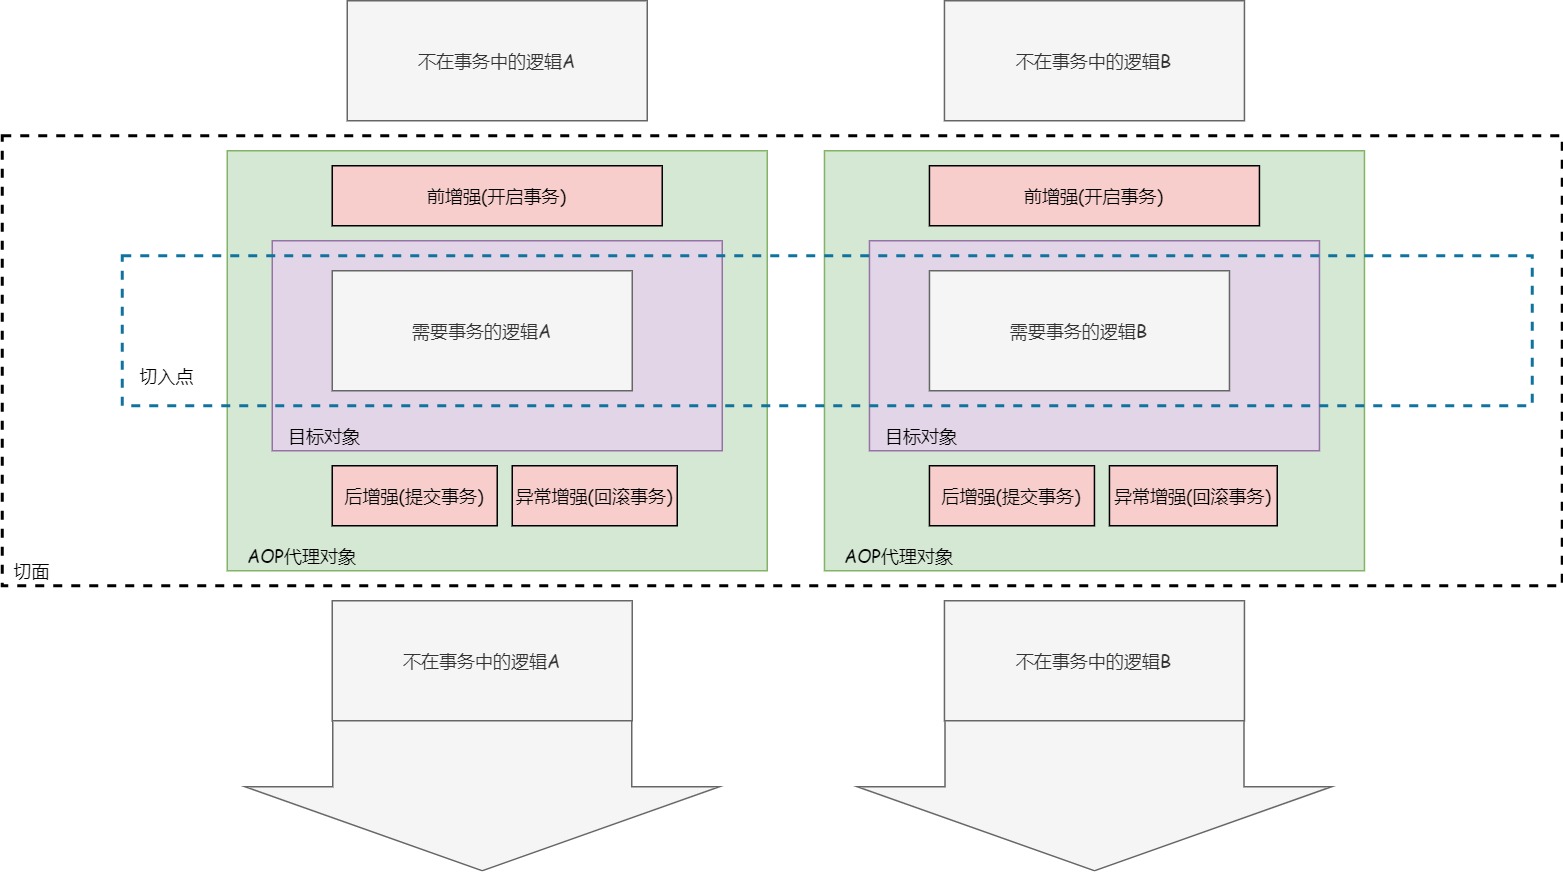
Spring容器包含两个重要的特性:面向切面编程(AOP)和控制反转(IOC)。面向切面编程是面向对象(OOP)的一种补充,在面向对象编程的过程中编程针对的目标是一个个对象,而面向切面编程中编程针对的目标是一个个切面。切面支持跨类型跨对象(如事务的切面可以加在任何地方)进行模块化。 <!--more--> 前言 AOP是Spring的关键特性之一,虽然Spring的IOC特性并不依赖于AOP(意味着你可以只使用Spring的IOC特性而不使用AOP特性),但是二者结合起来可以灵活的实现很多中间件解决方案。比如我们经常使用的事务(@Transaction),就是通过AOP方案实现的。本文重点介绍AOP编程中的一些术语,这些术语不仅仅局限于Spring,它适用于所有的AOP编程。 切面(Aspect):面向切面编程可以跨类跨对象进行切面编程,一个切面就是对一类横切关注点的模块化。 切入点(JoinPoint):程序执行过程中的一个点,如方法调用、字段访问和异常抛出等。 增强(Advice):用于对切面增强,包含前增强、后增强和环绕增强。大多数AOP框架会对切入点进行拦截,并在切入点维护一个拦截器链。 目标对象(TargetObject):包含一个或者多个切面的对象。 AOP代理(AOPProxy):通过Java动态代理或者CGLib增强得到的代理对象。 织入(Weaving):将切面整合到完整的流执行流程。 Spring的AOP的功能和目标 Spring的AOP使用纯Java语言实现(如AspectJ就不是Java语言),不需要任何额外的编译流程,不需要修改类加载器,适用于任何Servlet容器和应用服务。Spring的AOP只支持方法拦截,不支持字段拦截,如果用户需要使用字段拦截,可以考虑引入AspectJ等类似的框架。 Spring的AOP框架和其它的框架有些不同,Spring的Aop框架不仅仅是为了提供一个AOP功能,它更重要的功能是和Spring的IOC容器结合,提供一些企业应用服务的解决方案(如事务等),我们可以和定义一个普通Bean一样的方式去定以一个切面。Spring的AOP不支持非常细粒度的AOP,只支持对容器中的Bean进行AOP,如果需要更细粒度的AOP,可以考虑使用AspectJ。Spring容器的一个优秀的特性就是非侵入性,所以你可以灵活的选择自己的AOP方案,不一定非要使用Spring的方案。 代理方式 Spring对实现接口的方法默认使用Java动态代理实现AOP拦截,对于非接口方法则会使用CGLIB字节码工具实现代理。 @AspectJ的支持 @AspectJ注解可以把一个普通的Java类声明为切面。@AspectJ注解是AspectJ5引入的注解,Spring虽然可以读取AspectJ5的注解用于切面元数据的配置,但是在运行的时候使用的仍然是Spring AOP进行代理,而没有使用AspectJ的编译器或者织入逻辑。我们会在后续讨论如何在Spring中使用AspectJ的编译器和织入逻辑。 启用@AspectJ Spring默认没有启用AspectJ,如果你需要Spring支持@AspectJ注解对应的切面,可以通过在配置类上添加注解或者使用XML启用配置(AspectJ所在的包是:aspectjweaver.jar)。 通过Java注解启用AspectJ注解支持: @Configuration @EnableAspectJAutoProxy public class AppConfig { } 通过XML配置启用AspectJ注解 <aop:aspectj-autoproxy/> 定义一个切面 当启用AspectJ支持之后,开发者定义的任何Aspect切面会自动地被检测到,然后Spring AOP会对切面进行拦截。下面两个例子展示了如何配置AspectJ切面,你可以通过添加@Component注解把切面Bean注册到Spring容器中。 <bean id="myAspect" class="org.xyz.NotVeryUsefulAspect"> <!-- configure properties of the aspect here --> </bean> package org.xyz; import org.aspectj.lang.annotation.Aspect; @Aspect public class NotVeryUsefulAspect { } 声明一个切入点 切入点程序运行过程中我们感兴趣的一个点,Spring的AOP框架只支持发现对Spring Bean方法上的切入点,因此你可以简单的把切入点理解为SpringBean的方法。 切入点确定感兴趣的连接点,从而使我们能够控制何时运行通知。springaop只支持springbean的方法执行连接点,因此可以将切入点看作与springbean上方法的执行相匹配。切入点声明由两部分组成:一部分是由名称和任何参数组成的签名,另一部分是确定我们感兴趣的方法执行的切入点表达式。在AOP的@AspectJ注释样式中,切入点签名由常规方法定义提供,切入点表达式由@pointcut注释指示(用作切入点签名的方法必须具有void返回类型)。切入点由两部分组成,一部分是用于区别不同切入点的标识(下面例子中的private void anyOldTransfer() {})),另外一部分是确定我们感兴趣的Bean方法的表达式(下面例子中的@Pointcut("execution(* transfer(..))")), 下面的例子展示了一个切入点的定义: @Pointcut("execution(* transfer(..))") // the pointcut expression private void anyOldTransfer() {} // the pointcut signature Spring匹配切入点的语法使用了AspectJ5中的表达式语法,我们可以参考AspectJ文档相关的语法. 常见的切入点匹配表达 Spring支持下面常见的AspectJ切面定义语法: execution:用于匹配方法的连接点。 @Pointcut("execution(public * *(..))") private void anyPublicOperation() {} within:用于匹配类型内的方法。 @Pointcut("within(com.xyz.myapp.trading..*)") private void inTrading() {} this:匹配当前AOP代理对象的执行方法 @target(org.springframework.transaction.annotation.Transactional) target:target匹配目标对象的类型,即被代理对象的类型,例如A继承了B接口,则使用target("B"),target("A")均可以匹配到A // 当前AOP对象实现了 IPointcutService接口的任何方法 @Pointcut("target(cn.javass.spring.chapter6.service.IPointcutService)") private void anyPublicOperation() {} args:用于限定切点方法的参数类型。 args(java.io.Serializable) @target:被代理对象应该包含指定的注解。 @target(org.springframework.transaction.annotation.Transactional) @args: 被代理对象的参数包含指定的注解。 @args(com.xyz.security.Classified) @within: 被代理的对象应包含指定注解 @within(org.springframework.transaction.annotation.Transactional) @annotation:切入点包含指定的注解。 @annotation(org.springframework.transaction.annotation.Transactional) 我们可以通过“&&”和“||”对多个条件进行组合,AspectJ还有很多其它的表达式,但是Spring不支持除上述表达式以外的其它表达式。AspectJ其它表达式包含: call, get, set, preinitialization, staticinitialization, initialization, handler, adviceexecution, withincode, cflow, cflowbelow, if, @this, @withincode等。 我们在使用Spring的代理方法之前,应该知道其代理原理。Java动态代理只能拦截public接口方法上的调用,CGLib只能拦截public、protected和defult方法。如果你需要更深层次的拦截,可以考虑使用底层的Aspectj。 切面的增强 我们在上面的步骤定义好了一个切入点,我们现在就可以对这个切入点进行额外操作,这些额外操作被称为增强,Spring支持四种增强方式:前增强、后增强、异常增强和环绕增强。Spring支持在增强方法的定义上直接定义切入点。 前增强BeforeAdvice import org.aspectj.lang.annotation.Aspect; import org.aspectj.lang.annotation.Before; @Aspect public class BeforeExample { @Before("com.xyz.myapp.CommonPointcuts.dataAccessOperation()") public void doAccessCheck() { // ... } } import org.aspectj.lang.annotation.Aspect; import org.aspectj.lang.annotation.Before; @Aspect public class BeforeExample { @Before("execution(* com.xyz.myapp.dao.*.*(..))") public void doAccessCheck() { // ... } } 后增强 import org.aspectj.lang.annotation.Aspect; import org.aspectj.lang.annotation.AfterReturning; @Aspect public class AfterReturningExample { @AfterReturning( pointcut="com.xyz.myapp.CommonPointcuts.dataAccessOperation()", returning="retVal") public void doAccessCheck(Object retVal) { // ... } } 异常增强 import org.aspectj.lang.annotation.Aspect; import org.aspectj.lang.annotation.AfterThrowing; @Aspect public class AfterThrowingExample { @AfterThrowing( pointcut="com.xyz.myapp.CommonPointcuts.dataAccessOperation()", throwing="ex") public void doRecoveryActions(DataAccessException ex) { // ... } } 环绕增强 import org.aspectj.lang.annotation.Aspect; import org.aspectj.lang.annotation.Around; import org.aspectj.lang.ProceedingJoinPoint; @Aspect public class AroundExample { @Around("com.xyz.myapp.CommonPointcuts.businessService()") public Object doBasicProfiling(ProceedingJoinPoint pjp) throws Throwable { // start stopwatch Object retVal = pjp.proceed(); // stop stopwatch return retVal; } } 代理机制 我们前面说过,Spring AOP通过动态代理和CGLIB实现AOP对象的代理。我们可以通过如下配置设置动态代理全部走CGLIB。 <aop:config proxy-target-class="true"> <!-- other beans defined here... --> </aop:config> 代理工厂的使用 Spring AOP实现代理的核心类是AspectJProxyFactory,我们可以使用这个类编程式生成代理对象: // create a factory that can generate a proxy for the given target object AspectJProxyFactory factory = new AspectJProxyFactory(targetObject); // add an aspect, the class must be an @AspectJ aspect // you can call this as many times as you need with different aspects factory.addAspect(SecurityManager.class); // you can also add existing aspect instances, the type of the object supplied must be an @AspectJ aspect factory.addAspect(usageTracker); // now get the proxy object... MyInterfaceType proxy = factory.getProxy() 本文最先发布至微信公众号,版权所有,禁止转载!

优秀的个人博客,低调大师

PhotonServer(一)——服务器基础搭建

2 --> PhontonServer下载: https://www.photonengine.com/en-US/sdks#server-sdkserverserver 官方配置资料: https://doc.photonengine.com/en-us/server/current/getting-started/photon-server-in-5min 解除20人同时连接限制到100人同时连接: 下载后我们可以根据文档来进行Server的配置。刚下载并且解压下来后可以看到限制最大连接数为20人,那么这里我们可以升级到100人连接数的,首先注册并登录PhontonServer,然后再下面网址下载一个解除100人数限制的文件。https://dashboard.photonengine.com/en-US/selfhosted 下载后的文件,根据电脑系统,32位就放在PhotonServer解压下..\deploy\bin_Win32,如果是64位就放在PhotonServer解压下..\deploy\bin_Win64,我电脑是64,如下 然后我们启动PhotonControl.exe,这时候我们就可以看到最大连接数到了100人了。 创建自己的Server 我这里用的是VS 2017 完成后,要开始创建生成库,在PhotonServer解压下..\deploy中创建自己项目名称文件夹,在此文件夹中创建bin文件夹。 之后,开始开发服务器端,通过浏览,添加下载的PhotonServer中一下五个.dll文件 服务器代码: using Photon.SocketServer; using System; using System.Collections.Generic; using System.Linq; using System.Text; using System.Threading.Tasks; namespace AR_RemoteServer { //所有的Server端 主类都要继承自applicationbase public class RemoteServer : ApplicationBase { //当一个客户端请求连接的时候,服务器端就会调用这个方法 //我们使用peerbase,表示和一个客户端的链接,然后photon就会把这些链接管理起来 protected override PeerBase CreatePeer(InitRequest initRequest) { return new ClientPeer(initRequest); } protected override void Setup() { } protected override void TearDown() { } } } using Photon.SocketServer; using PhotonHostRuntimeInterfaces; using System; using System.Collections.Generic; using System.Linq; using System.Text; using System.Threading.Tasks; namespace AR_RemoteServer { //管理跟客户端的链接的 class ClientPeer : Photon.SocketServer.ClientPeer { public ClientPeer(InitRequest initRequest) : base(initRequest) { } //处理客户端断开连接的后续工作 protected override void OnDisconnect(DisconnectReason reasonCode, string reasonDetail) { } //处理客户端的请求 protected override void OnOperationRequest(OperationRequest operationRequest, SendParameters sendParameters) { } } } 至于服务端具体代码,后续我们在整合。 下面开始生成服务:配置好这些信息后,右击项目—>生成,生成后在之前设置的文件夹下就会出现.dll文件 开始配置刚才生成的Server: 首先,打开PhotonServer.config配置 开始配置我们的TCP,UDP配置。用VS打开它。可以看到LoadBalancing配置,可以根据这个写入字节的配置节点,这里我们直接复制一份出来,还是复制到PhotonServer.config下,修改一下节点就OK。 <ArRemote MaxMessageSize="512000" MaxQueuedDataPerPeer="512000" PerPeerMaxReliableDataInTransit="51200" PerPeerTransmitRateLimitKBSec="256" PerPeerTransmitRatePeriodMilliseconds="200" MinimumTimeout="5000" MaximumTimeout="30000" DirectDispatchToCLR="true" DisplayName="ArRemote"> <!-- 0.0.0.0 opens listeners on all available IPs. Machines with multiple IPs should define the correct one here. --> <!-- Port 5055 is Photon's default for UDP connections. --> <UDPListeners> <UDPListener IPAddress="0.0.0.0" Port="5055" OverrideApplication="AR_RemoteServer"> </UDPListener> </UDPListeners> <!-- 0.0.0.0 opens listeners on all available IPs. Machines with multiple IPs should define the correct one here. --> <TCPListeners> <!-- TCP listener for Game clients on Master application --> <TCPListener IPAddress="0.0.0.0" Port="4530" OverrideApplication="AR_RemoteServer" InactivityTimeout="10000"> </TCPListener> </TCPListeners> <!-- WebSocket (and Flash-Fallback) compatible listener --> <WebSocketListeners> <WebSocketListener IPAddress="0.0.0.0" Port="9090" DisableNagle="true" InactivityTimeout="10000" OverrideApplication="AR_RemoteServer"> </WebSocketListener> </WebSocketListeners> <!-- Defines the Photon Runtime Assembly to use. --> <Runtime Assembly="PhotonHostRuntime, Culture=neutral" Type="PhotonHostRuntime.PhotonDomainManager" UnhandledExceptionPolicy="TerminateProcess"> </Runtime> <!-- Defines which applications are loaded on start and which of them is used by default. Make sure the default application is defined. --> <!-- Application-folders must be located in the same folder as the bin_Win64 folders. The BaseDirectory must include a "bin" folder. --> <Applications Default="AR_RemoteServer"> <Application Name="AR_RemoteServer" BaseDirectory="AR_RemoteServer" Assembly="AR_RemoteServer" Type="AR_RemoteServer.RemoteServer"> </Application> </Applications> </ArRemote> 修改部分: Application标签中,添加 ForceAutoRestart="true"表示是“否自动重启”。 最后关闭重启下Photon,就可以看到ArRemote的Application 了,启动起来。 日志输出: 打开Open logs,会弹出 输出Server启动的一些信息,如果启动出错可以在这找错误信息。另一个CLR是提示License以及最大连接数,以及运行的Photon的应用的配置信息等,可以通过CLR看出哪些配置出错了,这个是Photon的两个日志输出. 出现上面的running就启动成功。 出现上面CServerice:OnException(),表示出现错误,看后面意思修改。 扩展自己Log输出: 上边已经引入log4net.dll文件,可以去log4net的官网找这个配置怎么写,也可以在我们下载的photon里面找这个配置文件。这里我在phonton文件下的目录里面找到了配置文件log4net.config,把配置文件log4net.config复制到我们项目里面的根目录下并且将它设置为始终复制,然后打开配置文件修改里面的配置。 下面我们开始创建一个Log对象,然后初始化。在RemoteServer这个类里面定义一个Log对象 //定义一个Log对象 public static readonly ILogger log = LogManager.GetCurrentClassLogger(); //调用 log.Info("连接"); 输出日志文件在下列路径可以找到,我定义的名字是AR.Server.log 最重要的一点:自定义的输出日志必须在Server启动时初始化它的位置等信息 protected override void Setup() { //日志的初始化(定义配置文件log4net位置) //Path.Combine 表示连接目录和文件名,可以屏蔽平台的差异 // Photon: ApplicationLogPath 就是配置文件里面路径定义的属性 //this.ApplicationPath 表示可以获取photon的根目录,就是Photon-OnPremise-Server-SDK_v5\deploy这个目录 //这一步是设置日志输出的文档文件的位置,这里我们把文档放在Photon-OnPremise-Server-SDK_v5\deploy\bin_Win64\log里面 log4net.GlobalContext.Properties["Photon:ApplicationLogPath"] = Path.Combine(Path.Combine(Path.Combine(this.ApplicationRootPath, "bin_win64")), "log"); //this.BinaryPath表示可以获取的部署目录就是目录Photon-OnPremise-Server-SDK_v5\deploy\AR_RemoteServer\bin FileInfo configFileInfo = new FileInfo(Path.Combine(this.BinaryPath, "log4net.config")); //如果这个配置文件存在 if (configFileInfo.Exists) { LogManager.SetLoggerFactory(Log4NetLoggerFactory.Instance);//设置photon使用哪个日志插件 //让log4net这个插件读取配置文件 XmlConfigurator.ConfigureAndWatch(configFileInfo); } //初始化 log.Info("Server启动!");//最后利用log对象就可以输出了 } 打开自定义日志,如下 这样整个服务就配置好了,至于服务编码后续再总结

优秀的个人博客,低调大师

PHP基础之与MySQL那些事

前言 这篇文章会对PHP的MySQL扩展库,MySQLI的扩展库,SQL批量执行,事务控制等等进行一些简单的讲解。 MySQL扩展 PHP中MySQL扩展,虽然因为安全的原因,在PHP5.6及往上不在支持MySQL扩展库,但是还是要学习的,通过编写案例的方式来讲解。 案例 先说下操作数据库的大体思路吧,就是先获取连接-》选择数据库-》设置操作编码-》发送sql指令-》对返回的结果进行处理-》释放资源,断开连接。案例是一个在线词典查询。下面是创建表的sql语句: createdatabaseworddb createtablewords( idintprimarykeyauto_increment, enwordvarchar(32)notnull, chwordvarchar(256)notnull ); insertintowords(enword,chword)values('boy','男孩') insertintowords(enword,chword)values('school','学校') 因为是练习,所以就插入了两条数据。接下来就是编写SQL工具类,代码如下: conn=mysql_connect($this->host,$this->user,$this->password); if(!$this->conn){ die("连接数据库失败!".mysql_error()); } mysql_select_db($this->db,$this->conn); mysql_query("setnamesutf8"); } //完成select functionexecute_dql($sql){ $res=mysql_query($sql)ordie(mysql_error()); return$res; } //完成insert,update,delete functionexecute_dml($sql){ $b=mysql_query($sql,$this->conn); if(!$b){ return0; }else{ //因为有些情况执行成功,但没有行数影响,所以在判断一下。 if(mysql_affected_rows($this->conn)>0){ return1; }else{ return2; } } } } ?> 之后就是前端页面的编写了,代码如下,有点丑: 在线词典字典查询英文请输入英文: 查询中文请输入中文: 接下来就是后端逻辑代码了,如下: 现在来测试一下吧,首先打开前端页面,如下图:接下来输入boy进行查询,结果如下,查询成功:因为是案例,所以直接将前端传过来的参数没有做任何处理直接拼接到SQL语句中,这样是非常危险的!!,存在SQL注入***,现在我来演示一下,在输入框中输入: boy' and updatexml(1,concat(0x7e,(select user()),0x7e),1)#结果如下图直接报出使用者!!所以在开发功能时,要秉持“外部参数皆不可信原则”进行开发。 MYSQLI扩展 其实mysqli扩展是mysql扩展的加强版,因为历史原因,有一些老程序员擅长面向过程写法,所以PHP设计者为mysqli设计了两套方案,一套面向对象,一套面向过程,甚至一个聊本里可以混着用,不过那样很怪,下面的案例都是采用面向对象的那套方案。 案例 做一个小功能吧,向数据库中插入数据。先设计一下SQL表,语句如下: createdatabaseday1; useday1; createtableuser1( idint(6)unsignedauto_incrementprimarykey, namevarchar(20)notnull, passwordvarchar(256)notnull, emailvarchar(80)notnull, ageint(128)notnull ); INSERTINTOuser1(name,password,email,age)VALUES('Lucia','13568','12345@.com',30); 因为一会儿要插入数据,所以先插入一条,构造好后,打开数据库,查询,发现没有问题接下来构造mysqli工具类代码如下: mysqli=newmysqli($this->host,$this->user,$this->pass,$this->db); if($this->mysqli->connect_error){ echo"连接失败"; } $this->mysqli->query("setnamesutf8"); } //进行select publicfunctionexecute_dql($sql){ $res=$this->mysqli->query($sql)ordie($this->mysqli->error); return$res; } //进行update,insert,delete publicfunctionexecute_dml($sql){ $res=$this->mysqli->query($sql)ordie($this->mysqli->error); if(!$res){ return0; }else{ if($this->mysqli->affected_rows>0){ return1;//成功 }else{ return2;//没有行数收影响 } } } } ?> 下面就是前端页面了,这里我用表单向后端提交数据,代码如下: 效果如下图:然后就是后端的逻辑设计了,代码如下: execute_dml($sql); if($res==1){ echo"添加成功"; }else{ if($res==0){ echo'添加失败'; }else{ echo"行数没有变化"; } } ?> 现在测试一下,我们在表单页面输入 小明,12345678,123@qq.com,25 数据,如下图:然后提交表单,看看有没有插入到数据库中。我们发现成功插入到数据库中如下:关于mysqli扩展就说到这里。 MySQL批量执行SQL语句 上面简单介绍了MySQL扩展和MySQLI扩展,接下来说一说批量执行sql语句。先提一个需求,如果我们像数据库批量添加用户,如果按照之前的办法一条一条的发送sql语句来处理,这样很占用资源,并且效率低。所以采用批量执行sql语句的方式。接下来用两个案例来讲解,因为增加,修改,删除操作返回的是布尔值,而查询操作返回的是结果集,所以分来来处理比较好。 批量执行dml语句 因为dml返回的是布尔值,所以处理起来也比较好处理。先创建表,顺便插入一条数据如下: createdatabasetest; usetest; createtableusers( idint(8)unsignedauto_incrementprimarykey, namevarchar(128)notnull, passwordvarchar(256)notnull); insertintousers(name,password)values('test','13579'); 下面就是批量执行dml操作的代码: connect_error){ echo"连接失败"; } $sqli="insertintousers(name,password)values('小利',md5('13568'));"; //批量执行dml操作时,注意上一级句的;和下一句的.两个符号 $sqli.="insertintousers(name,password)values('小利',md5('13568'));"; $sqli.="insertintousers(name,password)values('小利和小峰',md5('13568'))"; $b=$mysqli->multi_query($sqli); if(!$b){ echo"插入失败"; }else{ echo"ok!"; } $mysqli->close(); ?> 然后访问页面,返回ok,说明插入到数据库了,现在打开数据库查看,果然插入进去了,如下图: 批量执行dql操作 批量执行dql操作的作用是一次性取回多个结果集,下面看案例代码: 结果如下图:关于MySQL的批量执行sql语句就说到这里。 MySQL事务控制 上面简单介绍了MySQL扩展库,MySQLI扩展库,批量执行SQL语句,接下来说一说MySQL事务控制。 数据库配置 说MySQL事务控制之前,先查看并修改数据库引擎,查看引擎的命令如下: show engines我们发现,只有InnoDB是支持事务的,所以先查看一下现在得数据库引擎:发现是MyISAM,我们将它修改为InnoDB,打开配置文件my.ini,将“default-storage-engine=MYISAM”改为你想设定的,然后重启即可。修改成功后,然后下一步就是代码实现。 案例 我们为什么需要事务控制呢?想一想,如果这是一个转账得场景,是不是需要同时控制住,必须我减金额得同时你加金额,任何一个出错都得转账失败。也就是说要保持一致。这也是要进行事务控制得必要性。下面看案例代码: connect_error){ echo"连接失败"; } //将提交设置为假,因为事物一旦提交就没有机会回滚 $mysqli->autocommit(false); $sql1="updatepersonsetmoney=money-3whereid=1"; //这里第二条语句我故意写错表名 $sql2="updatepersonssetmoney=money+3whereid=2"; $b1=$mysqli->query($sql1); $b2=$mysqli->query($sql2); if(!$b1||!$b2){ echo"修改失败,回滚".$mysqli->error; $mysqli->rollback(); }else{ echo"修改成功!"; $mysqli->commit(); } $mysqli->close(); ?> 当我们提交页面后,查询数据库,发现数据没有变化,说明回滚有效果,事务控制起了效果,事务控制就说到这里。以上就是本篇文章的全部内容啦,如有错误,请斧正。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册