首页 文章 精选 留言 我的

精选列表

搜索[分布式账本],共10000篇文章
优秀的个人博客,低调大师

TiDB 4.0.11 发布,分布式 NewSQL 数据库

TiDB 4.0.11 现已发布,该版本具体更新内容如下: 新功能 TiDB 支持uft8_unicode_ci和utf8mb4_unicode_ci排序规则#22558 TiKV 支持utf8mb4_unicode_ci排序规则#9577 支持cast_year_as_time排序规则#9299 TiFlash 增加排队处理 Coprocessor 任务的线程池以降低内存溢出几率,并增加配置项cop_pool_size和batch_cop_pool_size,默认值为物理核数 * 2 改进提升 TiDB 重排由outer join简化的inner join顺序#22402 Grafana 面板支持多集群#22534 为多语句问题提供替代解决方案#22468 将慢查询监控区分为internal和general两类#22405 为utf8_unicode_ci和utf8mb4_unicode_ci排序规则增加接口#22099 TiKV 为 DBaaS 添加 server 信息的监控指标#9591 Grafana dashboards 支持监控多个集群#9572 汇报 RocksDB 的监控指标到 TiDB#9316 为 Coprocessor 任务记录暂停时间#9277 为 Load Base Split 添加 key 数量和大小的阀值#9354 在导入数据前检查文件是否存在#9544 改进 Fast Tune 面板#9180 PD Grafana dashboards 支持监控多个集群#3398 TiFlash 优化date_format函数的性能 优化处理 ingest SST 时的内存开销 优化 Batch Coprocessor 内部的重试逻辑以降低 Region error 的出现概率 Tools TiCDC 在capture元信息中添加版本信息和在changefeed元信息中创建该changefeed的 CLI 版本#1342 TiDB Lightning 并行创建数据表以提升导入速度#502 跳过分裂小 Region 以提升导入速度#524 添加导入进度条并提升恢复进度的精确度#506 Bug 修复 TiDB 修复异常的unicode_ci常数传递#22614 修复可能导致排序规则和 coercibility 错误的问题#22602 修复可能导致错误排序规则结果的问题#22599 修复不同排序规则的常数替换问题#22582 修复like函数使用排序规则时可能返回错误结果的问题#22531 修复least和greatest函数duration类型推导错误问题#22580 修复like函数处理_宽字符后加%出错的问题#22575 修复比较函数least和greatest类型推导错误的问题#22562 修复使用like函数处理 Unicode 字符串错误的问题#22529 修复点查请求无法取得@@tidb_snapshot变量中快照的问题#22527 修复生成多个 join 相关 hint 可能 panic 的问题#22518 修复转换字符串为BIT类型不准确的问题#22420 修复插入tidb_rowid列时出现的index out of range报错问题#22359 修复缓存计划被错误地使用的问题#22353 修复WEIGHT_STRING函数处理过长字符串出现 panic 的问题#22332 禁止参数数量不合法时使用生成列#22174 在构造执行计划前正确地设置进程执行信息#22148 修复IndexLookUp执行统计不准的问题#22136 容器部署时为内存使用信息增加缓存#22116 修复解码执行计划错误的问题#22022 使用错误的窗口函数说明时提供报错#21976 使用PREPARE语句嵌套EXECUTE、DEALLOCATE或PREPARE时报错#21972 修复使用INSERT IGNORE到不存在的分区时不报错的问题#21971 统一EXPLAIN和 slow log 中的执行计划编码#21964 修复聚合算子下 join 出现未知列的问题#21957 修复ceiling函数中类型推导错误的问题#21936 修复Double列忽略精度的问题#21916 修复关联聚合在子查询中被计算的问题#21877 当 JSON 数据长度超过 65536 时提供报错#21870 修复dyname函数和 MySQL 不兼容的问题#21850 修复输入数据过长时to_base64函数返回NULL的问题#21813 修复在子查询中比较多个字段失败的问题#21808 修复 JSON 中比较浮点数的问题#21785 修复 JSON 类型比较的问题#21718 修复cast函数的 coercibility 值设置错误的问题#21714 修复使用IF函数时可能出现 panic 的问题#21711 修复 JSON 搜索返回NULL和 MySQL 不兼容的问题#21700 修复ORDER BY和HAVING子句检查only_full_group_by模式的问题#21697 修复 Day/Time 单位和 MySQL 不兼容的问题#21676 修复LEAD和LAG函数默认值类型问题#21665 LOAD DATA时执行检测以保证只能往基础表中导入数据#21638 修复addtime和subtime函数处理非法参数的问题#21635 将近似值的舍入规则更改为“舍入到最接近的偶数”#21628 修复WEEK()在被明确读取前无法识别全局变量default_week_format的问题#21623 TiKV 修复当设置PROST=1时构建 TiKV 失败的问题#9604 修复不匹配的内存诊断信息#9589 修复在恢复 RawKV 数据时部分 key range 的 end key 的包含性问题#9583 修复当 TiCDC 增量扫数据时读取一个被回滚的事务的某个 key 的旧值时 TiKV 可能会 panic 的问题#9569 修复使用不同配置的连接拉取同一个 Region 的变更时旧值配置不匹配的问题#9565 修复 TiVK 运行在网络接口缺少 MAC 地址的设备上会崩溃的问题(自 v4.0.9 引入)#9516 修复 TiKV 在备份大 Region 时会内存溢出的问题#9448 修复region-split-check-diff无法自定义配置的问题#9530 修复系统时间回退时 TiKV 会 panic 的问题#9542 PD 修复成员健康的监控显示不正确的问题#3368 禁止有副本的不正常 tombstone store 被清除#3352 修复 store limit 无法持久化的问题#3403 调整scatter range schedler的 limit 限制#3401 TiFlash 修复 Decimal 类型的min/max计算结果错误的问题 修复读取数据时有可能导致 crash 的问题 修复 DDL 操作后写入的数据可能会在 compaction 后丢失的问题 修复 Coprocessor 中错误解析 Decimal 常量的问题 修复 Learner Read 过程中可能导致 crash 的问题 修复 TiFlash 中除以0或NULL的行为与 TiDB 不一致的问题 Tools TiCDC 修复 TiCDC 服务在同时发生ErrTaskStatusNotExists和capture会话关闭的情况下的非预期的退出的问题#1240 修复changefeed之间不同 Old Value 设置会互相影响的问题#1347 修复 TiCDC 服务在遇见错误的sort-engine参数时卡住的问题#1309 修复在非 Owner 节点上获取 debug 信息退出的问题#1349 修复ticdc_processor_num_of_tables和ticdc_processor_table_resolved_ts两个监控指标在增删数据表时没有被正确更新的问题#1351 修复 Processor 在添加同步数据表时退出而造成的潜在的数据丢失问题#1363 修复 Owner 在数据表迁移期间造成非正常状态的 TiCDC 服务退出的问题#1352 修复 TiCDC 服务在丢失 service GC safepoint 时没有及时退出的问题#1367 修复 KV client 可能跳过创建 event feed 的问题#1336 修复同步事务到下游时事务原子性被破坏的问题#1375 Backup & Restore (BR) 修复恢复备份后 TiKV 可能产生大 Region 的问题#702 修复在没有 Auto ID 的数据表上恢复 Auto ID 的问题#720 TiDB Lightning 修复使用 TiDB-backend 时可能触发column count mismatch的问题#535 修复 TiDB-backend 在导入数据源 column 个数和数据表 column 个数不匹配时非预期退出的问题#528 修复导入期间 TiKV 可能发生的非预期退出的问题#554 更新说明: https://docs.pingcap.com/zh/tidb/stable/release-4.0.11

优秀的个人博客,低调大师

分布式监控系统 WGCLOUD,v3.3.0 发布

WGCLOUD,server端基于springboot开发,agent端使用go编写。支持高并发高性能,核心模块包括:主机监控,ES集群状态监控,CPU监控,CPU温度监控,内存监控,数据监控,docker监控,网络流量监控,服务心跳检测,应用进程管理,磁盘IO监控,系统负载监控,端口监控,日志文件监控,监控告警信息(默认邮件,支持钉钉微信集成)推送。 WGCLOUD-v3.3.0更新说明,2021-01-26: 1.新增,进程管理新增流量(读取/写入)指标 2.新增,主机所有网卡流量(接收/发送)指标 3.新增,数据源连接恢复后,发送恢复通知 4.新增,win监控主机支持获取负载指标,之前版本目标监控主机win没有系统负载指标 5.新增,主机列表新增磁盘总量已使用%指标 6.新增,大屏展示优化,新增当前监控主机状态横向柱状图表,在中间区域显示 7.新增,日志监控优化,不再受告警缓存机制约束,改为有告警内容即推送,检测时间依然为每10分钟。改为每次上报出现关键字的所有行数,之前只上报每个关键字的第一次出现行数。 8.新增,数据监控,支持集群数据库模式,其实就是更灵活了,改为大家熟悉的JDBC连接字符串形式了 9.新增,手动排序模块:进程管理按照内存/cpu排序,日志文件监控按照告警数量排序 10.新增,全部/在线/下线模块:进程管理,端口监控,DOCKER监控 11.新增,数据监控图表,不再按照天筛选数据,默认显示全部 12.新增,屏蔽告警磁盘,特殊符号请用''包起来,如'C:'。支持Ant路径匹配规则,如:/top/** 13.新增,主机监控图表,在时间段基础上新增【全天】选项,之前按照时间段浏览(0-6点,6-12点,12-18点,18-0点) 14.bug修复 15.性能和UI优化提升 码云源码下载:https://gitee.com/wanghouhou/wgcloud GITHUB源码下载:https://github.com/tianshiyeben/wgcloud 安装包下载:http://www.wgstart.com

优秀的个人博客,低调大师

TiDB 4.0.10 发布,分布式 NewSQL 数据库

TiDB 4.0.10 现已发布,该版本具体更新内容如下: 新功能 PD 添加了配置项enable-redact-log,可以设置将日志中的用户数据脱敏#3266 TiFlash 添加了配置项security.redact_info_log,可以设置将日志中的用户数据脱敏 改进提升 TiDB 添加txn-entry-size-limit配置项,用于限制事务中单个 key-value 记录的大小#21843 PD 优化了store-state-filter的监控,可以显示更加具体的原因#3100 更新go.etcd.io/bbolt依赖至 v1.3.5#3331 Tools TiCDC 为maxwell协议默认开启 old value 特性#1144 默认启用 unified sorter 特性#1230 Dumpling 支持检查未定义的参数,支持输出导出的进度#228 TiDB Lightning 支持重试读 S3 遇到的错误#533 Bug 修复 TiDB 修复由于并发导致的 batch client 超时问题#22336 修复由于并发地自动捕获 SQL 绑定而导致的重复绑定问题#22295 当日志级别为'debug'时,让 SQL 语句绑定的自动捕获正确运行#22293 当 Region 合并正在发生时,正确地释放锁#22267 对Datetime类型的用户变量返回正确的值#22143 修复错误使用 Index Merge 访问方式的问题#22124 修复由于执行计划缓存导致 TiFlash 报wrong precision错误的问题#21960 修复由于 schema 变更导致的错误结果#21596 避免在ALTER TABLE中不必要地更改 column flag#21474 让包含子查询块别名的 optimizer hint 生效#21380 为IndexHashJoin和IndexMergeJoin生成正确的 optimizer hint#21020 TiKV 修复了 peer 和 ready 之间的错误映射#9409 修复一些日志信息在security.redact-info-log设置为true时未脱敏的问题#9314 PD 修复 ID 分配不是单调递增的问题#3308#3323 修复 PD client 在某些情况下可能卡住的问题#3285 TiFlash 修复了 TiFlash 解析老版本 TiDB 表结构失败导致 TiFlash 无法启动的问题 修复了在 RedHat 系统中 TiFlash 会对cpu_time进行错误处理导致 TiFlash 无法启动的问题 修复了将配置项path_realtime_mode设置为true时 TiFlash 无法启动的问题 修复了当调用有三个参数的substr函数时,返回结果错误的问题 修复了当 TiDB 对Enum枚举进行无损修改时,TiFlash 无法读取修改后的值的问题 Tools TiCDC 修复maxwell协议的问题,包括base64数据输出和将 TSO 转换成 unix timestamp#1173 修复过期的元数据可能引发新创建的 changefeed 异常的问题#1184 修复在关闭的 notifier 上创建 receiver 的问题#1199 修复在 etcd 更新缓慢时导致内存访问量增长的问题#1227 修复max-batch-size不生效的问题#1253 修复清理过期任务信息的问题#1280 修复 MySQL sink 中由于没有调用rollback而导致回收 db conn 卡住的问题#1285 Dumpling 修改默认设置的tidb_mem_quota_query的行为以避免 TiDB 内存溢出#233 Backup & Restore (BR) 修复 BR v4.0.9 无法恢复 BR v4.0.8 保存在 GCS 上的备份#688 修复在恢复 GCS 上的备份时可能发生的 panic 问题#673 默认禁用备份统计信息以避免 BR 内存溢出#693 TiDB Binlog 修复在启用AMEND TRANSACTION特性时,Drainer 可能会使用错误 schema 来生成 SQL 语句的问题#1033 TiDB Lightning 修复未正确编码 Region key 而导致分裂 Region 失败问题#531 修复可能丢失CREATE TABLE失败的错误#530 修复使用 TiDB-backend 时遇到的column count mismatch问题#535 更新说明:https://docs.pingcap.com/zh/tidb/stable/release-4.0.10

优秀的个人博客,低调大师

TiDB 3.0.20 发布,分布式 NewSQL 数据库

TiDB 3.0.20现已发布,该版本具体更新内容如下: 兼容性更改 TiDB 废弃配置文件中的enable-streaming配置项#21054 改进提升 TiDB 优化LOAD DATA语句执行PREPARE时的报错信息#21222 TiKV 增加end_point_slow_log_threshold配置#9145 Bug 修复 TiDB 修复错误缓存悲观事务提交状态的问题#21706 修复当查询INFORMATION_SCHEMA.TIDB_HOT_REGIONS时,统计信息不准确的问题#21319 修复了一处数据库名大小写处理不当,导致的DELETE未正确删除数据的问题#21205 修复创建递归的视图出现栈溢出的问题#21000 修复 TiKV 客户端 goroutine 泄漏的问题#20863 修复year类型默认值为0的问题#20828 修复 Index Lookup Join 的 goroutine 泄漏问题#20791 修复在悲观事务中执行INSERT SELECT FOR UPDATE后客户端收到 malformed packet 的问题#20681 修复'posixrules'错误时区的问题#20605 修复将无符号整型转换为 bit 类型时出现的错误#20362 修复 bit 列类型默认值错误的问题#20339 修复当等值条件中有Enum和Set类型时结果可能错误的问题#20296 修复!= any()时的错误问题#20061 修复类型转换在BETWEEN...AND...中会遇到结果错误的问题#21503 修复ADDDATE函数兼容性的问题#21008 为新增的Enum列设置正确的默认值#20999 修复SELECT DATE_ADD('2007-03-28 22:08:28',INTERVAL "-2.-2" SECOND)这类 SQL 语句的结果问题,使之兼容 MySQL#20627 修复当修改列属性时,默认类型设置错误的问题#20532 修复timestamp函数的参数为float和decimal时,结果错误的问题#20469 修复统计信息可能会死锁的问题#20424 修复溢出的 Float 类型数据被INSERT的问题#20251 TiKV 修复当事务删除 key 时却报 key 已存在的问题#8931 PD 修复当 stale Region 过多时,启动 PD 会打印过量日志的问题#3064 更新说明:https://docs.pingcap.com/zh/tidb/stable/release-3.0.20

优秀的个人博客,低调大师

TiDB 4.0.9 发布,分布式 NewSQL 数据库

TiDB 4.0.9 现已发布,该版本具体更新内容如下: 兼容性更改 TiDB 废弃配置文件中enable-streaming配置项#21055 TiKV 减少开启加密时的 I/O 开销和锁冲突。该修改向下不兼容。如果需要降级至 v4.0.9 以下,需要将security.encryption.enable-file-dictionary-log配置为false,并在降级前重启#9195 新功能 TiFlash 支持将存储引擎的新数据分布在多个硬盘上,分摊 I/O 压力(实验特性) TiDB Dashboard SQL 语句分析功能的列表界面支持显示所有字段并排序#749 集群拓扑页面支持缩放#772 SQL 语句分析及慢日志页面支持显示 SQL 语句的临时存储占用大小#777 SQL 语句分析及慢日志列表界面支持导出列表数据#778 支持配置自定义 Prometheus 地址#808 新增集群实例统计摘要页面#815 慢日志详情页面新增更多时间字段#810 优化提升 TiDB 在转换等值条件为其它条件时,通过使用启发式规则,避免生成 (index) merge join 以得到更好的执行计划#21146 区分用户变量的类型#21107 在配置文件中添加了performance.gogc配置项,用于设置GOGC#20922 提升Timestamp和Datetime类型的二进制输出结果与 MySQL 的兼容性#21135 优化用户使用LOCK IN SHARE MODESQL 语句时输出的报错信息#21005 优化在可剪切的表达式进行常量折叠时输出的错误信息,避免输出不必要的警告或错误信息#21040 优化LOAD DATA语句执行PREPARE时的报错信息#21199 修改整型列的类型时,忽略掉整型字段的零值填充的属性#20986 在EXPLAIN ANALYZE结果中输出 DML 语句执行器相关运行时的信息#21066 禁止在一条语句中对主键做出多次不同的修改#21113 添加连接空闲时间的监控项#21301 新增运行runtime/trace分析工具时系统自动临时开启慢日志的功能#20578 TiKV 添加标记以跟踪split命令的来源#8936 支持动态修改pessimistic-txn.pipelined配置项#9100 减少运行 Backup & Restore 和 TiDB Lightning 时对系统的性能影响#9098 添加 Ingesting SST 报错的监控项#9096 阻止 Leader 在任意副本需要复制日志时进入休眠状态#9093 提高 Pipelined locking 的成功率#9086 调整配置项apply-max-batch-size和store-max-batch-size的默认值为1024#9020 添加max-background-flushes配置#8947 默认关闭 RocksDB consistency check 以提高性能#9029 将 Region 大小的查询操作移出pd heartbeat worker以减轻其压力#9185 PD TiKV store 转变为Tombstone状态时检查 TiKV 集群的版本号,防止用户降级和升级过程中的开启不兼容特性#3213 禁止低版本的 TiKV 强制从Tombstone状态转为Up#3206 TiDB Dashboard 对于 SQL 语句文本点击 “展开” 后支持保持展开状态#775 默认在新窗口打开 SQL 语句分析和慢日志详情#816 改进慢日志页面部分时间字段描述#817 改进错误信息提示,显示更完整的错误内容#794 TiFlash 降低 Replica read 时的延迟 优化 TiFlash 的错误信息 优化在大数据量下,对缓存数据大小的限制 添加正在处理的 Coprocessor 请求数量的 metric Tools Backup & Restore (BR) BR 不再接受存在歧义的--checksum false(不会正确关闭 checksum) 命令行参数,正确用法为--checksum=false#588 支持暂时性地调整 PD 的参数,在 BR 意外退出后,PD 能自动恢复回正常参数#596 支持恢复数据表的统计信息#622 系统自动重试read index not ready和proposal in merging mode两种错误#626 TiCDC 添加对 TiKV 开启 Hibernate Region 的告警规则#1120 优化 schema storage 的内存使用#1127 增加 Unified Sorter 功能,可以在数据量较大的情况下提升增量扫阶段的同步速度(实验特性)#1122 支持在 TiCDC Open Protocol 中配置单条 Kafka 消息的最大大小和包含的最大行变更数量(仅在 Kafka sink 生效)#1079 Dumpling 对导出失败部分的数据进行重试#182 支持同时设置-F和-r两个参数#177 默认不导出系统表#194 在设置--transactional-consistency参数时支持重建 MySQL 链接#199 TiDB Lightning 默认不恢复系统表#459 支持为 auto-random 的主键设置默认值#457 完善 Local 模式下分裂 Region 的精度#422 支持给tikv-importer.region-split-size、mydumper.read-block-size、mydumper.batch-size和mydumper.max-region-size设置可读的参数(比如 "2.5 GiB")#471 TiDB Binlog 在写下游出错时给 Drainer 设置非零退出码#1012 Bug 修复 TiDB 修复了前缀索引和OR条件一起使用时结果不正确的问题#21287 修复了开启自动重试后可能出现的一处 panic#21285 修复了根据列类型检查分区表定义时出现的一处问题#21273 修复了分区表对于列的类型检查的一处问题。分区表达式的值的类型和分区列的类型必须一致#21136 修复了哈希分区表对于分区名唯一性检查的问题#21257 修复非INT类型的值,插入到哈希分区表后结果不正确的问题#21238 修复了在部分写入类的场景中,使用了 index join 会遇到非预期报错的问题#21249 修复了在CASE WHEN中BigInt无符列的值被错误地转换成有符类型的问题#21236 修复了 index hash join 和 index merge join 没有考虑 collation 的问题#21219 修复了分区表在建表和查询时,没有考虑 collation 的问题#21181 修复了慢日志记录的查询结果可能不全的问题#21211 修复了一处数据库名大小写处理不当,导致的DELETE未正确删除数据的问题#21206 修复了执行 DML 语句导致 schema 的内存被覆盖的问题#21050 修复了使用 join 时,无法查询到合并后的列的问题#21021 修复了一些 semi-join 的查询结果不正确的问题#21019 修复了表锁对于UPDATE语句不生效的问题#21002 修复创建递归的视图出现栈溢出的问题#21001 修复了 index merge join 在执行外连接的时候,结果不符合预期的问题#20954 修复了一处事务问题,该场景下应该返回结果未知,但是却返回了执行失败#20925 修复explain for connection无法显示最后一次执行计划的问题#21315 修复在 Read Committed 隔离级别下,Index Merge 结果不正确的问题#21253 修复了由于事务写冲突重试导致的 auto-ID 分配失败#21079 修复了 JSON 数据无法通过load data无法正确导入到 TiDB 的问题#21074 修复新增加Enum类型列的默认值问题#20998 对于日期类型的数学计算,保留原始的数据类型信息,修复adddate函数插入非法值的问题#21176 修复了部分场景错误地生成了PointGet的执行计划,导致执行结果不正确#21244 在ADD_DATE函数中忽略夏令时的转换,以和 MySQL 兼容#20888 修复了插入尾部带有超出varchar和char长度限制的空白字符的字符串时报错的 bug#21282 修复了对比int和year类型时没有将[1, 69]的整数转换为[2001, 2060]以及没有将[70, 99]的整数转换为[1970, 1999]的兼容性 bug#21283 修复了sum()函数计算Double类型字段的结果溢出导致 panic 的问题#21272 修复了DELETE语句未能给 unique key 加悲观锁的问题#20705 修复了快照读能够命中 lock cache,返回错误结果的问题#21539 修复了在同一个事务中读取大量数据时可能发生的内存泄漏问题#21129 修复了在子查询中省略表别名时的语法解析错误问题#20367 TiKV 修复当列个数大于 255 时,下推返回错误结果集的问题#9131 修复网络隔离时 Region Merge 可能会导致数据丢失的问题#9108 修复使用latin1字符集时,ANALYZE语句会导致 panic 的问题#9082 修复类型转换中将数字转成时间会得到错误结果的问题#9031 修复当开启加密时无法使用 TiDB Lightning 导入数据的问题#8995 修复使用0.0.0.0时advertise-status-addr异常的问题#9036 修复当事务删除 key 时却报 key 已存在的问题#8930 修复 RocksDB cache 映射错误导致的数据错误问题#9029 修复当 Leader 切换时 Follower Read 可能返回旧数据的问题#9240 修复悲观锁下可能读到旧值的问题#9282 修复 transfer leader 后 replica read 可能会读到旧值的问题#9240 修复 TiKV 在 profiling 结束后再收到SIGPROF会 panic 的问题#9229 PD 修复在特殊情况下 Placement Rule 指定的 leader 绑定不生效的问题#3208 修复trace-region-flow在配置更新时被置为false的问题#3120 修复特殊情况下 safepoint 有无限 TTL 的问题#3143 TiDB Dashboard 修复部分时间显示混杂中英文的问题#755 修复部分不兼容的浏览器中没有提示不兼容的问题#776 修复部分情况下事务时间戳显示不正确的问题#793 修复部分 SQL 文本格式化后成为无效 SQL 语句的问题#805 TiFlash 修复INFORMATION_SCHEMA.CLUSTER_HARDWARE中可能包含未被使用的硬盘信息的问题 修复 Delta cache 内存占用量估算偏少的问题 修复由线程统计信息引起的内存泄露问题 Tools Backup & Restore (BR) 修复因 S3 secret access keys 中存在特殊字符而导致失败的问题#617 TiCDC 修复某些异常情况下存在多个 Owner 的问题#1104 修复在 TiKV 节点意外退出或重启恢复情况下 TiCDC 不能正常同步的问题,该 bug 在 v4.0.8 引入#1198 修复在表初始化过程中会向 etcd 中重复写入元数据的问题#1191 修复 schema storage 缓存 TiDB 表信息的过程中因更新表信息延迟或过早 GC 导致同步中断的问题#1114 修复 schema storage 在 DDL 频繁的情况下会消耗过多内存的问题#1127 修复在同步任务暂停或取消之后会产生 goroutine 泄露的问题#1075 增加 Kafka producer 最大重试时间到 600s,避免在下游 Kafka 服务或网络抖动情况下同步中断#1118 修复 Kafka 消息所包含行变更数量不能正常生效的问题#1112 修复当 TiCDC 与 PD 间网络出现抖动,并且同时操作 TiCDC changefeed 暂停和恢复,可能会出现部分表数据没有被同步的问题#1213 修复 TiCDC 与 PD 网络不稳定情况下 TiCDC 可能出现进程非预期退出的问题#1218 在 TiCDC 内部使用全局 PD client,以及修复 PD client 被错误关闭导致同步阻塞的问题#1217 修复 TiCDC owner 节点可能在 etcd watch client 里消耗过多内存的问题#1224 Dumpling 修复在某些情况下 MySQL 链接关闭导致 Dumpling 卡住的问题#190 TiDB Lightning 修复使用错误信息编码 key 的问题#437 修复 GC life time TTL 不生效的问题#448 修复手动关闭时可能出现的 panic 问题#484 更新说明:https://docs.pingcap.com/zh/tidb/stable/release-4.0.9

优秀的个人博客,低调大师

分布式存储开发:Curve中的内存管理

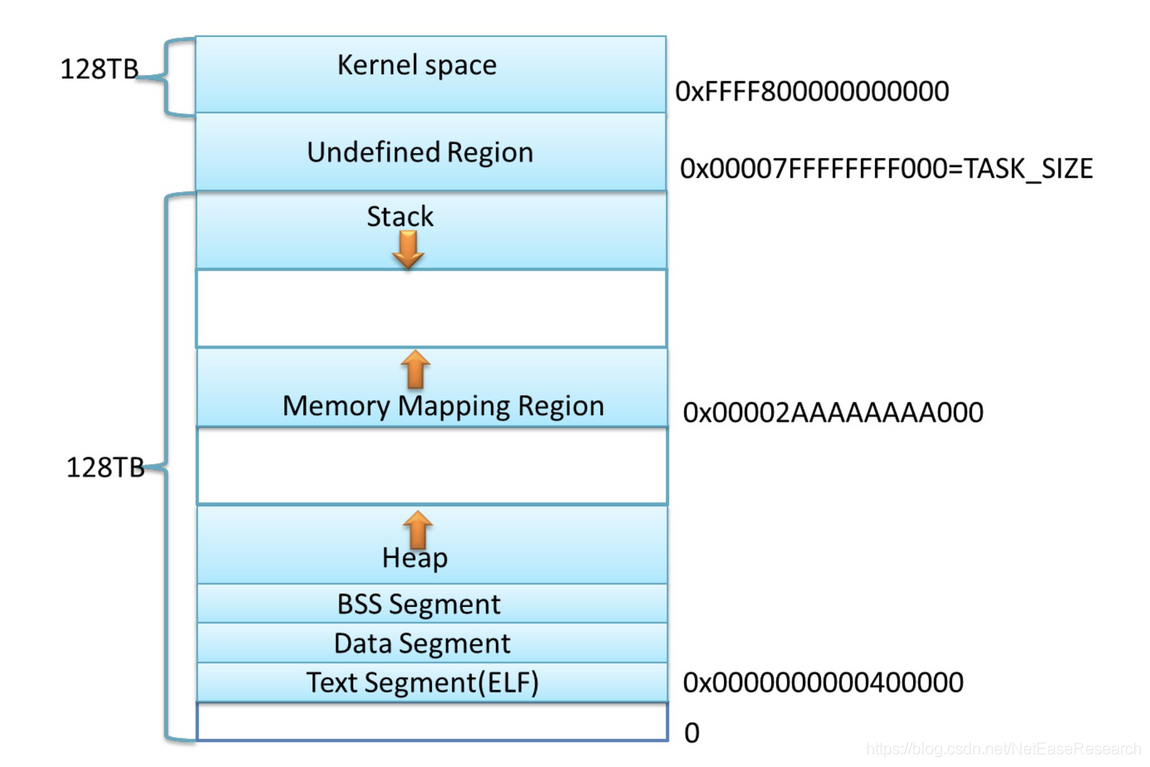
前言 Curve 实践过程中遇到过几次内存相关的问题,与操作系统内存管理相关的是以下两次: chunkserver上内存无法释放 mds出现内存缓慢增长的现象 内存问题在开发阶段大多很难发现,测试阶段大压力稳定性测试(持续跑7*24小时以上)、异常测试往往比较容易出问题,当然这还需要我们在测试阶段足够仔细,除了关注io相关指标外,还要关注服务端内存/CPU/网卡等资源使用情况以及采集的metric是否符合预期。比如上述问题mds 内存缓慢增长,如果只关注io是否正常,在测试阶段是无法发现的。内存问题出现后定位也不容易,尤其在软件规模较大的情况下。 本文主要是从开发者的角度来谈 Curve 中的内存管理,不会过度强调内存管理理论,目的是把我们在软件开发过程中对 Linux 内存管理的认知、内存问题分析的一些方法分享给大家。本文会从以下几个方面展开: 内存布局。结合 Curve 软件说明内存布局。 内存分配策略。说明内存分配器的必要性,以及需要解决的问题和具有的特点,然后通过举例说明其中一个内存分配器的内存管理方法。 Curve 的内存管理。介绍当前 Curve 软件内存分配器的选择及原因。 内存布局 在说内存管理之前,首先简要介绍下内存布局相关知识。 软件在运行时需要占用一定量的内存用来存放一些数据,但进程并不直接与存放数据的物理内存打交道,而是直接操作虚拟内存。物理内存是真实的存在,就是内存条;虚拟内存为进程隐藏了物理内存这一概念,为进程提供了简洁易用的接口和更加复杂的功能。本文说的内存管理是指虚拟内存管理。为什么需要抽象一层虚拟内存?虚拟内存和物理内存是如何映射管理的?物理寻址是怎么的?这些虚拟内存更下层的问题不在本文讨论范围。 Linux 为每个进程维护了一个单独的虚拟地址空间,包括两个部分进程虚拟存储器(用户空间)和内核虚拟存储器(内核空间),本文主要讨论进程可操作的用户空间,形式如下图。 现在我们使用pmap查看运行中的 curve-mds 虚拟空间的分布。pmap用于查看进程的内存映像信息,该命令读取的是/proc/[pid]/maps中的信息。 // pmap -X {进程id} 查看进程内存分布 sudo pmap -X 2804620 // pmap 获取的 curve-mds 内存分布有很多项 Address Perm Offset Device Inode Size Rss Pss Referenced Anonymous ShmemPmdMapped Shared_Hugetlb Private_Hugetlb Swap SwapPss Locked Mapping // 为了方便展示这里把从 Pss 后面的数值删除了, 中间部分地址做了省略 2804620: /usr/bin/curve-mds -confPath=/etc/curve/mds.conf -mdsAddr=127.0.0.1:6666 -log_dir=/data/log/curve/mds -graceful_quit_on_sigterm=true -stderrthreshold=3 Address Perm Offset Device Inode Size Rss Pss Mapping c000000000 rw-p 00000000 00:00 0 65536 1852 1852 559f0e2b9000 r-xp 00000000 41:42 37763836 9112 6296 6296 curve-mds 559f0eb9f000 r--p 008e5000 41:42 37763836 136 136 136 curve-mds 559f0ebc1000 rw-p 00907000 41:42 37763836 4 4 4 curve-mds 559f0ebc2000 rw-p 00000000 00:00 0 10040 4244 4244 559f1110a000 rw-p 00000000 00:00 0 2912 2596 2596 [heap] 7f6124000000 rw-p 00000000 00:00 0 156 156 156 7f6124027000 ---p 00000000 00:00 0 65380 0 0 7f612b7ff000 ---p 00000000 00:00 0 4 0 0 7f612b800000 rw-p 00000000 00:00 0 8192 8 8 7f612c000000 rw-p 00000000 00:00 0 132 4 4 7f612c021000 ---p 00000000 00:00 0 65404 0 0 ..... 7f6188cff000 ---p 0026c000 41:42 37750237 2044 0 0 7f61895b7000 r-xp 00000000 41:42 50201214 96 96 0 libpthread-2.24.so 7f61895cf000 ---p 00018000 41:42 50201214 2044 0 0 libpthread-2.24.so 7f61897ce000 r--p 00017000 41:42 50201214 4 4 4 libpthread-2.24.so 7f61897cf000 rw-p 00018000 41:42 50201214 4 4 4 libpthread-2.24.so 7f61897d0000 rw-p 00000000 00:00 0 16 4 4 7f61897d4000 r-xp 00000000 41:42 50200647 16 16 0 libuuid.so.1.3.0 7f61897d8000 ---p 00004000 41:42 50200647 2044 0 0 libuuid.so.1.3.0 7f61899d7000 r--p 00003000 41:42 50200647 4 4 4 libuuid.so.1.3.0 7f61899d8000 rw-p 00004000 41:42 50200647 4 4 4 libuuid.so.1.3.0 7f61899d9000 r-xp 00000000 41:42 37617895 9672 8904 8904 libetcdclient.so 7f618a34b000 ---p 00972000 41:42 37617895 2048 0 0 libetcdclient.so 7f618a54b000 r--p 00972000 41:42 37617895 6556 5664 5664 libetcdclient.so 7f618abb2000 rw-p 00fd9000 41:42 37617895 292 252 252 libetcdclient.so 7f618abfb000 rw-p 00000000 00:00 0 140 60 60 7f618ac1e000 r-xp 00000000 41:42 50201195 140 136 0 ld-2.24.so 7f618ac4a000 rw-p 00000000 00:00 0 1964 1236 1236 7f618ae41000 r--p 00023000 41:42 50201195 4 4 4 ld-2.24.so 7f618ae42000 rw-p 00024000 41:42 50201195 4 4 4 ld-2.24.so 7f618ae43000 rw-p 00000000 00:00 0 4 4 4 7fffffd19000 rw-p 00000000 00:00 0 132 24 24 [stack] 7fffffdec000 r--p 00000000 00:00 0 8 0 0 [vvar] 7fffffdee000 r-xp 00000000 00:00 0 8 4 0 [vdso] ffffffffff600000 r-xp 00000000 00:00 0 4 0 0 [vsyscall] ======= ===== ===== 1709344 42800 37113 上面输出中进程实际占用的空间是从 0x559f0e2b9000 开始,不是内存分布图上画的 0x40000000。这是因为地址空间分布随机化(ASLR),它的作用是随机生成进程地址空间(例如栈、库或者堆)的关键部分的起始地址,目的是增强系统安全性、避免恶意程序对已知地址攻击。Linux 中/proc/sys/kernel/randomize_va_space的值为 1 或 2 表示地址空间随机化已开启,数值1、2的区别在于随机化的关键部分不同;0表示关闭。 接下来 0x559f0e2b9000 0x559f0eb9f000 0x559f0ebc1000 三个地址起始对应的文件都是curve-mds ,但是对该文件的拥有不同的权限,各字母代表的权限r-读 w-写 x-可执行 p-私有 s-共享。curve-mds 是elf类型文件,从内容的角度看,它包含代码段、数据段、BSS段等;从装载到内存角度看,操作系统不关心各段所包含的内容,只关心跟装载相关的问题,主要是权限,所以操作系统会把相同权限的段合并在一起去加载,就是我们这里看到的以代码段为代表的权限为可读可执行的段、以只读数据为代表的权限为只读的段、以数据段和 BSS 段为代表的权限为可读可写的段。 再往下 0x559f1110a000 开始,对应上图的运行时堆,运行时动态分配的内存会在这上面进行 。我们发现也是在.bss段的结束位置进行了随机偏移。 接着 0x7f6124000000 开始,对应的是上图 mmap 内存映射区域,这一区域包含动态库、用户申请的大片内存等。到这里我们可以看到Heap和Memory Mapping Region都可以用于程序中使用malloc动态分配的内存,在下一节内存分配策略中会有展开,也是本文关注重点。 接着 0x7fffffd19000 开始是栈空间,一般有数兆字节。 最后 vvar、vdso、vsyscall 区域是为了实现虚拟函数调用以加速部分系统调用,使得程序可以不进入内核态1直接调用系统调用。这里不具体展开。 内存分配策略 我们平时使用malloc分配出来的内存是在Heap和Memory Mapping Region这两个区域。mallloc 实际上由两个系统调用完成:brk和mmap brk 分配的区域对应堆 heap mmap 分配的区域对应 Memory Mapping Region 如果让每个开发者在软件开发时都直接使用系统调 brk 和 mmap 用去分配释放内存,那开发效率将会变得很低,而且也很容易出错。一般来说我们在开发中都会直接使用内存管理库,当前主流的内存管理器有三种:ptmalloc``tcmalloc``jemalloc, 都提供malloc, free接口,glibc 默认使用ptmalloc。这些库的作用是管理它通过系统调用获得的内存区域,一般来说一个优秀的通用内存分配器应该具有以下特征: 额外的空间损耗量尽量少。比如应用程序只需要5k内存,结果分配器给他分配了10k,会造成空间的浪费。 分配的速度尽可能快。 尽量避免内存碎片。下面我们结合图来直观的感受下内存碎片。 通用性、兼容性、可移植性、易调试。 我们通过下面一幅图直观说明下 glibc 默认的内存管理器 ptmalloc 在单线程情况下堆内存的回收和分配: malloc(30k)通过系统调用 brk 扩展堆顶的方式分配内存。 malloc(20k)通过系统调用 brk 继续扩展堆顶。 malloc(200k)默认情况下请求内存大于 128K (由M_MMAP_THRESHOLD确定,默认大小为128K,可以调整),就利用系统调用 mmap分配内存。 free(30k)这部分空间并没有归还给系统,而是 ptmalloc 管理着。由1、2两步的 malloc 可以看出,我们分配空间的时候调用 brk 进行堆顶扩展,那归还空间给系统是相反操作即收缩堆顶。这里由于第二步 malloc(20k) 的空间并未释放,所以此时堆顶无法收缩。这部分空间是可以被再分配的,比如此时 malloc(10k),那可以从这里分配 10k 空间,而不需要通过 brk 去申请。考虑这样一种情况,堆顶的空间一直被占用,堆顶向下的空间有部分被应用程序释放但由于空间不够没有再被使用,就会形成内存碎片。 free(20k)这部分空间应用程序释放后,ptmalloc 会把刚才的 20k 和 30k 的区域合并,如果堆顶空闲超过M_TRIM_THREASHOLD,会把这块区域收缩归还给操作系统。 free(200k)mmap分配出来的空间会直接归还给系统。 那对于多线程程序,ptmalloc 又是怎么区分配的?多线程情况下需要处理各线程间的竞争,如果还是按照之前的方式,小于HEAP_MAX_SIZE( 64 位系统默认大小为 64M )的空间使用 brk 扩展堆顶, 大于HEAP_MAX_SIZE的空间使用 mmap 申请,那对于线程数量较多的程序,如果每个线程上存在比较频繁的内存分配操作,竞争会很激烈。ptmalloc 的方法是使用多个分配区域,包含两种类型分配区:主分配区 和 动态分配区。 主分配区:会在Heap和Memory Mapping Region这两个区域分配内存 动态分配区:在Memory Mapping Region区域分配内存,在 64 位系统中默认每次申请的大小位。Main 线程和先执行 malloc 的线程使用不同的动态分配区,动态分配区的数量一旦增加就不会减少了。动态分配区的数量对于 32 位系统最多是 ( 2 number of cores + 1 ) 个,对于 64 位系统最多是( 8 number of cores + 1 )个。 举个多线程的例子来看下这种情况下的空间分配: // 共有三个线程 // 主线程:分配一次 4k 空间 // 线程1: 分配 100 次 4k 空间 // 线程2: 分配 100 次 4k 空间 #include <stdio.h> #include <stdlib.h> #include <pthread.h> #include <unistd.h> #include <sys/types.h> void* threadFunc(void* id) { std::vector<char *> malloclist; for (int i = 0; i < 100; i++) { malloclist.emplace_back((char*) malloc(1024 * 4)); } sleep(300); // 这里等待是为查看内存分布 } int main() { pthread_t t1,t2; int id1 = 1; int id2 = 2; void* s; int ret; char* addr; addr = (char*) malloc(4 * 1024); pthread_create(&t1, NULL, threadFunc, (void *) &id1); pthread_create(&t2, NULL, threadFunc, (void *) &id2); pthread_join(t1, NULL); pthread_join(t2, NULL); return 0; } 我们用 pmap 查看下该程序的内存分布情况: 741545: ./memory_test Address Perm Offset Device Inode Size Rss Pss Mapping 56127705a000 r-xp 00000000 08:02 62259273 4 4 4 memory_test 56127725a000 r--p 00000000 08:02 62259273 4 4 4 memory_test 56127725b000 rw-p 00001000 08:02 62259273 4 4 4 memory_test 5612784b9000 rw-p 00000000 00:00 0 132 8 8 [heap] **7f0df0000000 rw-p 00000000 00:00 0 404 404 404 7f0df0065000 ---p 00000000 00:00 0 65132 0 0 7f0df8000000 rw-p 00000000 00:00 0 404 404 404 7f0df8065000 ---p 00000000 00:00 0 65132 0 0** 7f0dff467000 ---p 00000000 00:00 0 4 0 0 7f0dff468000 rw-p 00000000 00:00 0 8192 8 8 7f0dffc68000 ---p 00000000 00:00 0 4 0 0 7f0dffc69000 rw-p 00000000 00:00 0 8192 8 8 7f0e00469000 r-xp 00000000 08:02 50856517 1620 1052 9 libc-2.24.so 7f0e005fe000 ---p 00195000 08:02 50856517 2048 0 0 libc-2.24.so 7f0e007fe000 r--p 00195000 08:02 50856517 16 16 16 libc-2.24.so 7f0e00802000 rw-p 00199000 08:02 50856517 8 8 8 libc-2.24.so 7f0e00804000 rw-p 00000000 00:00 0 16 12 12 7f0e00808000 r-xp 00000000 08:02 50856539 96 96 1 libpthread-2.24.so 7f0e00820000 ---p 00018000 08:02 50856539 2044 0 0 libpthread-2.24.so 7f0e00a1f000 r--p 00017000 08:02 50856539 4 4 4 libpthread-2.24.so 7f0e00a20000 rw-p 00018000 08:02 50856539 4 4 4 libpthread-2.24.so 7f0e00a21000 rw-p 00000000 00:00 0 16 4 4 7f0e00a25000 r-xp 00000000 08:02 50856513 140 140 1 ld-2.24.so 7f0e00c31000 rw-p 00000000 00:00 0 16 16 16 7f0e00c48000 r--p 00023000 08:02 50856513 4 4 4 ld-2.24.so 7f0e00c49000 rw-p 00024000 08:02 50856513 4 4 4 ld-2.24.so 7f0e00c4a000 rw-p 00000000 00:00 0 4 4 4 7ffe340be000 rw-p 00000000 00:00 0 132 12 12 [stack] 7ffe3415c000 r--p 00000000 00:00 0 8 0 0 [vvar] 7ffe3415e000 r-xp 00000000 00:00 0 8 4 0 [vdso] ffffffffff600000 r-xp 00000000 00:00 0 4 0 0 [vsyscall] ====== ==== === 153800 2224 943 关注上面加粗的部分,红色区域加起来是 65536K,其中有 404K 是 rw-p (可读可写)权限,65132K 是 —-p (不可读写)权限;黄色区域类似。两个线程分配的时 ptmalloc 分别给了 动态分区,并且每次申请 64M 内存,再从这 64M 中切分出一部分给应用程序。 这里还有一个有意思的现象:我们用strace -f -e "brk, mmap, munmap" -p {pid}去跟踪程序查看下 malloc 中的系统调用: mmap(NULL, 8392704, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS|MAP_STACK, -1, 0) = 0x7f624a169000 strace: Process 774601 attached [pid 774018] mmap(NULL, 8392704, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS|MAP_STACK, -1, 0) = 0x7f6249968000 [pid 774601] mmap(NULL, 134217728, PROT_NONE, MAP_PRIVATE|MAP_ANONYMOUS|MAP_NORESERVE, -1, 0) = 0x7f6241968000 [pid 774601] munmap(0x7f6241968000, 40468480strace: Process 774602 attached ) = 0 [pid 774601] munmap(0x7f6248000000, 26640384) = 0 [pid 774602] mmap(NULL, 134217728, PROT_NONE, MAP_PRIVATE|MAP_ANONYMOUS|MAP_NORESERVE, -1, 0) = 0x7f623c000000 [pid 774602] munmap(0x7f6240000000, 67108864) = 0 这里主线程 [774018] 要求分配了 8M+4k 空间;线程1 [774601] 先 mmap 了 128M 空间,再分归还了 0x7f6241968000 为起始地址的 40468480 字节 和 0x7f6248000000为起始地址的 26640384 字节,那剩余的部分是 0x7F6244000000 ~ 0x7F6248000000。先申请再归还是为了让分配的这部分内存的起止地址是字节对齐的。 Curve 的内存管理 Curve 中选择了两种分配器:ptmalloc和jemalloc。其中 MDS 使用默认的 ptmalloc,Chunkserver 和 Client 端使用 jemalloc。 本文开头提到的两个问题在这里进行说明。首先是MDS内存缓慢增长,现象是每天增长 3G。这个问题分析的过程如下: 首先是使用pmap查看内存分布。我们用 pmap 查看内存缓慢增长的 curve-mds 内存分配情况,发现在 Memory Mapping Region 存在着大量分配的 64M 内存,且观察一段时间后都不释放还在一直分配。从这里怀疑存在内存泄露。 然后查看应用上请求的压力情况。查看MDS 上相关的业务 metric,发现 MDS 上的压力都很小,一些控制面 rpc 的 iops 在几百左右,不应该是业务压力较大导致的。 接下来查看 curve-mds 部分 64M 内存上的数据。使用gdb -p {pid} attach跟踪线程,dump meemory mem.bin {addr1} {addr2}获取指定地址段的内存,然后查看这部分内存内容,基本确定几个怀疑点。 根据这几个点去排查代码,看是否有内存泄露。 Chunkserver 端不是开始就使用 jemalloc 的,最初也是用的默认的 ptmalloc。换成 jemalloc 是本文开始提到的 Chunkserver 在测试过程中出现内存无法释放的问题,这个问题的现象是:chunkserver的内存在 2 个 小时内增长很快,一共增长了 50G 左右,但后面并未释放。这个问题分析的过程如下: 首先分析内存中数据来源。这一点跟 MDS 不同,MDS 上都是控制面的请求以及一些元数据的缓存。而Chunkserver 上的内存增长一般来自两个地方:一是用户发送的请求,二是 copyset 的 leader 和 follower 之间同步数据。这两个都会涉及到 brpc 模块。 brpc 的内存管理有两个模块 IOBuf 和 ResourcePool。IOBuf 中的空间一般用于存放用户数据,ResourcePool 管理 socket、bthread_id 等对象,管理的内存对象单位是 64K 。 查看对应模块的一些趋势指标。观察这两个模块的metric,发现 IOBuf 和 ResourcePool 这段时间内占用的内存都有相同的增长趋势。 IOBuf 后面将占用的内存归还给 ptmalloc, ResourcePool 中管理的内存不会归还给 ptmalloc 而是自己管理。 从这个现象我们怀疑 IOBuf 归还给 ptmalloc 的内存 ptmalloc 无法释放。 分析验证。结合第二节的内存分配策略,如果堆顶的空间一直被占用,那堆顶向下的空间也是无法被释放的。仍然可以使用 pmap 查看当前堆上内存的大小以及内存的权限(是否有很多 —-p 权限的内存)来确定猜想。因此后面 Chunkserver 使用了 jemalloc。这里可以看到在多线程情况下,如果一部分内存被应用长期持有,使用 ptmalloc 也许就会遇到内存无法释放的问题。 这里对 MDS 和 Chunkserver 出现的两个问题进行了总结,一方面想说明 Curve 选择不同内存分配器的原因。对于一个从 0 到 1 的项目,代码开发之初选择内存分配器不是一个特别重要的事情,如果有比较多的开发和解决类似内存问题的经验,开始做出评估是好的;但如果没有,可以先选择一个,出现问题或者到需要优化内存性能的时候再去分析。另外一方面希望可以给遇到类似内存问题的小伙伴一些定位的思路。 作者:李小翠,网易数帆存储团队Curve项目攻城狮。 如有理解和描述上有疏漏或者错误的地方,欢迎共同交流;参考已经在参考文献中注明,但仍有可能有疏漏的地方,有任何侵权或者不明确的地方,欢迎指出,必定及时更正或者删除;文章供于学习交流,转载注明出处 参考文献 [1]ptmalloc,tcmalloc,jemalloc对比分析 [2]十问linux虚拟内存管理(glibc) [3]Go语言使用cgo时的内存管理笔记 [3] 深入理解计算机系统 [美] 兰德尔 E.布莱恩特(Randal E.·Bryant) 著,龚奕利,贺莲 译 相关链接 Curv项目介绍 网易数帆存储负责人亲述:我眼中的 Curve 与 Ceph Curve开源技术直播(每周五19:00) Curve的roadmap

优秀的个人博客,低调大师

主流开源分布式图数据库 Benchmark

本文由美团 NLP 团队高辰、赵登昌撰写 首发于 Nebula Graph 官方论坛:https://discuss.nebula-graph.com.cn/t/topic/1377 1. 前言 近年来,深度学习和知识图谱技术发展迅速,相比于深度学习的“黑盒子”,知识图谱具有很强的可解释性,在搜索推荐、智能助理、金融风控等场景中有着广泛的应用。美团基于积累的海量业务数据,结合使用场景进行充分地挖掘关联,逐步建立起包括美食图谱、旅游图谱、商品图谱在内的近十个领域知识图谱,并在多业务场景落地,助力本地生活服务的智能化。 为了高效存储并检索图谱数据,相比传统关系型数据库,选择图数据库作为存储引擎,在多跳查询上具有明显的性能优势。当前业界知名的图数据库产品有数十款,选型一款能够满足美团实际业务需求的图数据库产品,是建设图存储和图学习平台的基础。我们结合业务现状,制定了选型的基本条件: 开源项目,对商业应用友好 拥有对源代码的控制力,才能保证数据安全和服务可用性。 支持集群模式,具备存储和计算的横向扩展能力 美团图谱业务数据量可以达到千亿以上点边总数,吞吐量可达到数万 qps,单节点部署无法满足存储需求。 能够服务 OLTP 场景,具备毫秒级多跳查询能力 美团搜索场景下,为确保用户搜索体验,各链路的超时时间具有严格限制,不能接受秒级以上的查询响应时间。 具备批量导入数据能力 图谱数据一般存储在 Hive 等数据仓库中。必须有快速将数据导入到图存储的手段,服务的时效性才能得到保证。 我们试用了 DB-Engines 网站上排名前 30 的图数据库产品,发现多数知名的图数据库开源版本只支持单节点,不能横向扩展存储,无法满足大规模图谱数据的存储需求,例如:Neo4j、ArangoDB、Virtuoso、TigerGraph、RedisGraph。经过调研比较,最终纳入评测范围的产品为:NebulaGraph(原阿里巴巴团队创业开发)、Dgraph(原 Google 团队创业开发)、HugeGraph(百度团队开发)。 2. 测试概要 2.1 硬件配置 数据库实例:运行在不同物理机上的 Docker 容器。 单实例资源:32 核心,64GB 内存,1TB SSD 存储。【Intel(R) Xeon(R) Gold 5218 CPU @ 2.30GHz】 实例数量:3 2.2 部署方案 Nebula v1.0.1 Metad 负责管理集群元数据,Graphd 负责执行查询,Storaged 负责数据分片存储。存储后端采用 RocksDB。 实例 1 实例 2 实例 3 Metad Metad Metad Graphd Graphd Graphd Storaged[RocksDB] Storaged[RocksDB] Storaged[RocksDB] Dgraph v20.07.0 Zero 负责管理集群元数据,Alpha 负责执行查询和存储。存储后端为 Dgraph 自有实现。 实例 1 实例 2 实例 3 Zero Zero Zero Alpha Alpha Alpha HugeGraph v0.10.4 HugeServer 负责管理集群元数据和查询。HugeGraph 虽然支持 RocksDB 后端,但不支持 RocksDB 后端的集群部署,因此存储后端采用 HBase。 实例1 实例2 实例3 HugeServer[HBase] HugeServer[HBase] HugeServer[HBase] JournalNode JournalNode JournalNode DataNode DataNode DataNode NodeManager NodeManager NodeManager RegionServer RegionServer RegionServer ZooKeeper ZooKeeper ZooKeeper NameNode NameNode[Backup] - - ResourceManager ResourceManager[Backup] HBase Master HBase Master[Backup] - 3. 评测数据集 社交图谱数据集:https://github.com/ldbc011 生成参数:branch=stable, version=0.3.3, scale=1000 实体情况:4 类实体,总数 26 亿 关系情况:19 类关系,总数 177 亿 数据格式:csv GZip 压缩后大小:194 G 4. 测试结果 4.1 批量数据导入 4.1.1 测试说明 批量导入的步骤为:Hive 仓库底层 csv 文件 -> 图数据库支持的中间文件 -> 图数据库。各图数据库具体导入方式如下: Nebula:执行 Spark 任务,从数仓生成 RocksDB 的底层存储 sst 文件,然后执行 sst Ingest 操作插入数据。 Dgraph:执行 Spark 任务,从数仓生成三元组 rdf 文件,然后执行 bulk load 操作直接生成各节点的持久化文件。 HugeGraph:支持直接从数仓的 csv 文件导入数据,因此不需要数仓-中间文件的步骤。通过 loader 批量插入数据。 4.1.2 测试结果 4.1.3 数据分析 Nebula:数据存储分布方式是主键哈希,各节点存储分布基本均衡。导入速度最快,存储放大比最优。 Dgraph:原始 194G 数据在内存 392G 的机器上执行导入命令,8.7h 后 OOM 退出,无法导入全量数据。数据存储分布方式是三元组谓词,同一种关系只能保存在一个数据节点上,导致存储和计算严重偏斜。 HugeGraph:原始 194G 的数据执行导入命令,写满了一个节点 1,000G 的磁盘,造成导入失败,无法导入全量数据。存储放大比最差,同时存在严重的数据偏斜。 4.2 实时数据写入 4.2.1 测试说明 向图数据库插入点和边,测试实时写入和并发能力。 响应时间:固定的 50,000 条数据,以固定 qps 发出写请求,全部发送完毕即结束。取客户端从发出请求到收到响应的 Avg、p99、p999 耗时。 最大吞吐量:固定的 1,000,000 条数据,以递增 qps 发出写请求,Query 循环使用。取 1 分钟内成功请求的峰值 qps 为最大吞吐量。 插入点 Nebula INSERT VERTEX t_rich_node (creation_date, first_name, last_name, gender, birthday, location_ip, browser_used) VALUES ${mid}:('2012-07-18T01:16:17.119+0000', 'Rodrigo', 'Silva', 'female', '1984-10-11', '84.194.222.86', 'Firefox') Dgraph { set { <${mid}> <creation_date> "2012-07-18T01:16:17.119+0000" . <${mid}> <first_name> "Rodrigo" . <${mid}> <last_name> "Silva" . <${mid}> <gender> "female" . <${mid}> <birthday> "1984-10-11" . <${mid}> <location_ip> "84.194.222.86" . <${mid}> <browser_used> "Firefox" . } } HugeGraph g.addVertex(T.label, "t_rich_node", T.id, ${mid}, "creation_date", "2012-07-18T01:16:17.119+0000", "first_name", "Rodrigo", "last_name", "Silva", "gender", "female", "birthday", "1984-10-11", "location_ip", "84.194.222.86", "browser_used", "Firefox") 插入边 Nebula INSERT EDGE t_edge () VALUES ${mid1}->${mid2}:(); Dgraph { set { <${mid1}> <link> <${mid2}> . } } HugeGraph g.V(${mid1}).as('src').V(${mid2}).addE('t_edge').from('src') 4.2.2 测试结果 实时写入 4.2.3 数据分析 Nebula:如 4.1.3 节分析所述,Nebula 的写入请求可以由多个存储节点分担,因此响应时间和吞吐量均大幅领先。 Dgraph:如 4.1.3 节分析所述,同一种关系只能保存在一个数据节点上,吞吐量较差。 HugeGraph:由于存储后端基于 HBase,实时并发读写能力低于 RocksDB(Nebula)和 BadgerDB(Dgraph),因此性能最差。 4.3 数据查询 4.3.1 测试说明 以常见的 N 跳查询返回 ID,N 跳查询返回属性,共同好友查询请求测试图数据库的读性能。 响应时间:固定的 50,000 条查询,以固定 qps 发出读请求,全部发送完毕即结束。取客户端从发出请求到收到响应的 Avg、p99、p999 耗时。 60s 内未返回结果为超时。 最大吞吐量:固定的 1,000,000 条查询,以递增 qps 发出读请求,Query 循环使用。取 1 分钟内成功请求的峰值 qps 为最大吞吐量。 缓存配置:参与测试的图数据库都具备读缓存机制,默认打开。每次测试前均重启服务清空缓存。 N 跳查询返回 ID Nebula GO ${n} STEPS FROM ${mid} OVER person_knows_person Dgraph { q(func:uid(${mid})) { uid person_knows_person { #${n}跳数 = 嵌套层数 uid } } } HugeGraph g.V(${mid}).out().id() #${n}跳数 = out()链长度 N 跳查询返回属性 Nebula GO ${n} STEPS FROM ${mid} OVER person_knows_person YIELDperson_knows_person.creation_date, $$.person.first_name, $$.person.last_name, $$.person.gender, $$.person.birthday, $$.person.location_ip, $$.person.browser_used Dgraph { q(func:uid(${mid})) { uid first_name last_name gender birthday location_ip browser_used person_knows_person { #${n}跳数 = 嵌套层数 uid first_name last_name gender birthday location_ip browser_used } } } HugeGraph g.V(${mid}).out() #${n}跳数 = out()链长度 共同好友查询语句 Nebula GO FROM ${mid1} OVER person_knows_person INTERSECT GO FROM ${mid2} OVER person_knows_person Dgraph { var(func: uid(${mid1})) { person_knows_person { M1 as uid } } var(func: uid(${mid2})) { person_knows_person { M2 as uid } } in_common(func: uid(M1)) @filter(uid(M2)){ uid } } HugeGraph g.V(${mid1}).out().id().aggregate('x').V(${mid2}).out().id().where(within('x')).dedup() 4.3.2 测试结果 N 跳查询返回 ID N 跳查询返回属性 单个返回节点的属性平均大小为 200 Bytes。 共同好友 本项未测试最大吞吐量。 4.3.3 数据分析 在 1 跳查询返回 ID「响应时间」实验中,Nebula 和 DGraph 都只需要进行一次出边搜索。由于 DGraph 的存储特性,相同关系存储在单个节点,1 跳查询不需要网络通信。而 Nebula 的实体分布在多个节点中,因此在实验中 DGraph 响应时间表现略优于 Nebula。 在 1 跳查询返回 ID「最大吞吐量」实验中,DGraph 集群节点的 CPU 负载主要落在存储关系的单节点上,造成集群 CPU 利用率低下,因此最大吞吐量仅有 Nebula 的 11%。 在 2 跳查询返回 ID「响应时间」实验中,由于上述原因,DGraph 在 qps=100 时已经接近了集群负载能力上限,因此响应时间大幅变慢,是 Nebula 的 3.9 倍。 在 1 跳查询返回属性实验中,Nebula 由于将实体的所有属性作为一个数据结构存储在单节点上,因此只需要进行【出边总数 Y】次搜索。而 DGraph 将实体的所有属性也视为出边,并且分布在不同节点上,需要进行【属性数量 X * 出边总数 Y】次出边搜索,因此查询性能比 Nebula 差。多跳查询同理。 在共同好友实验中,由于此实验基本等价于 2 次 1 跳查询返回 ID,因此测试结果接近,不再详述。 由于 HugeGraph 存储后端基于 HBase,实时并发读写能力低于 RocksDB(Nebula)和 BadgerDB(Dgraph),因此在多项实验中性能表现均落后于 Nebula 和 DGraph。 5. 结论 参与测试的图数据库中,Nebula 的批量导入可用性、导入速度、实时数据写入性能、数据多跳查询性能均优于竞品,因此我们最终选择了 Nebula 作为图存储引擎。 6. 参考资料 NebulaGraph Benchmark:https://discuss.nebula-graph.com.cn/t/topic/782 NebulaGraph Benchmark 微信团队:https://discuss.nebula-graph.com.cn/t/topic/1013 DGraph Benchmark:https://dgraph.io/blog/tags/benchmark/ HugeGraph Benchmark:https://hugegraph.github.io/hugegraph-doc/performance/hugegraph-benchmark-0.5.6.html TigerGraph Benchmark:https://www.tigergraph.com/benchmark/ RedisGraph Benchmark:https://redislabs.com/blog/new-redisgraph-1-0-achieves-600x-faster-performance-graph-databases/ 本次性能测试系美团 NLP 团队高辰、赵登昌撰写,如果你对本文有任意疑问,欢迎来原贴和作者交流:https://discuss.nebula-graph.com.cn/t/topic/1377

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册