前端学数据结构与算法(八): 单词前缀匹配神器-Trie树的实现及其应用
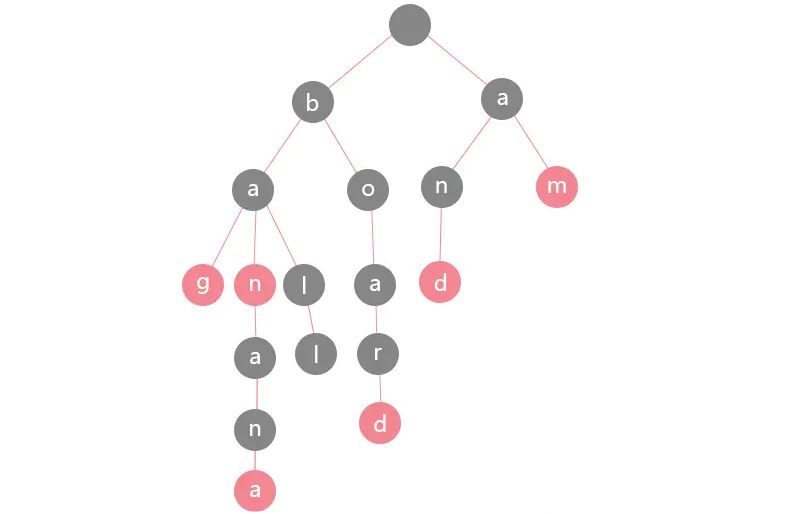
前言 继二叉树、堆之后,接下来介绍另外一种树型的数据结构-Trie树,也可以叫它前缀树、字典树。例如我们再搜索引擎里输入几个关键字之后,后续的内容会自动续上。此时我们输入的关键词也就是前缀,而后面的就是与之匹配的内容,而这么一个功能底层的数据结构就是Trie树。那到底什么是Trie树?还是三个步骤来熟悉它,首先了解、然后实现、最后应用。 什么是Trie树? 这是一种多叉树,它主要解决的问题是能在一组字符串里快速的进行某个字符串的匹配。而它 的这种高效正是建立在算法的以空间换时间的思想上,因为字符串的每一个字符都会成为一个树的节点,例如我们把这样一组单词['bag', 'and', 'banana', 'ban', 'am', 'board', 'ball']进行Trie化后就会成为以下这样: 根节点为空,因为子节点都的存储的单词开头的缘故。Trie树的本质就是将单词之间的公共前缀合并起来,这也就会造成单词ban和banana公用同一条路径,所以需要在单词的结尾处给一个标识符,表示该字符为一个单词的结束。所以当输入关键词ba后,只需要遍历后面的节点就可以将bag、banana、ball单词呈现给用户。是不是很酷~ 从零实现一颗Trie树 之前我们介绍的都是二叉树,所以使用左右孩子表示这个很方便,但Trie树是一种多叉树,如果仅仅只是存储小写字母,那么每个父节点的子节点最多就有26个子孩子。所以子节点我们都使用单个字符作为其key来存储,这样无论多少个子节点都没问题。Trie主要是操作就是两个,一个是往树里添加单词、另一个是查询树里是否有某个单词。 class Node { // 节点类 constructor(isWord = false) { this.isWord = isWord // 该节点是否是单词的结尾 this.next = new Map() // 子孩子使用map存储 } } class Trie { // 实例类 constructor() { this.root = new Node() } ... } 往Trie里增加单词(add) 将单词拆解为单个的字符,而每个字符就是一个Node类的实例,最后当单词达到末尾时,将最后字符Node节点的isWord属性设置为true即可。 class Trie { ... add(word) { // 之后的应用里有遍历的写法 const _helper = (node, word) => { if (word === '') { // 递归到底,单词已经不能被拆解了 node.isWord = true // 将上一个字符标记为单词结尾 return } const c = word[0] // 从单词的首字母开始 if (!node.next.has(c)) { // 如果孩子节点里不包含该字符 node.next.set(c, new Node()) // 设置为新的孩子节点 } _helper(node.next.get(c), word.slice(1)) // 继续拆解单词的其他字符 } _helper(this.root, word) // 加入到根节点之下 } } 通过add方法,就可以构建一颗Trie树了,但构建它最大的意义是能快速的进行查询,所以我们还需要一个search方法,能快速的查询该单词是否在Trie树里。 查询Trie里的单词(search) 因为已经有一颗Trie树了,所以要查询也很简单,只需要将要查询的单词分解为字符逐层向下的和Trie树节点进行匹配即可,只要有一个节点Trie树里没有,就可以判断Trie树不存在这个单词,单词分解完毕之后,返回最后停留那个节点的isWord属性即可。 class Trie { search(word) { const _helper = (node, word) => { if (word === '') { // 已经不能拆解了 return node.isWord // 返回停留节点的isWord属性 } const c = word[0] if (!node.next.get(c)) { // 只要有节点不匹配 return false // 表示没有 } return _helper(node.next.get(c), word.slice(1)) // 逐层向下 } return _helper(this.root, word) // 从根节点开始 } } 输出Trie树里的每个单词(log) 这个方法仅仅是个人在熟悉Trie树时添加一个方法,每次调用打印出树里所有的单词,方便调试时使用。 class Trie { ... log() { // 根之前的打印匹配的前缀类似,只需要调整 const ret = [] const _helper = (node, path) => { if (node.isWord) { ret.push(path.join('')) // 将单词放入结果里 } for (const [key, value] of node.next) { // 遍历每一个孩子节点 path.push(key) // 加入单词路径 _helper(value, path) path.pop() // 回溯 } } _helper(this.root, []) console.log(ret) } } 返回前缀匹配的单词 这个方法纯粹也是个人所加,很多介绍介绍Trie树的资料不会写这个方法,个人觉得这是很能结合Trie树特性的一个方法,因为仅仅作为精确查询来说,还真没比哈希表、红黑树优势多少。但如果只是返回匹配前缀的单词,这个优势就很大了。像输入法的自动联想、IDE的自动补全功能都可以用这个方法实现。 class Trie { ... match(prefix) { if (prefix === '') { return [] } let cur = this.root for (let i = 0; i < prefix.length; i++) { // 首先找到前缀停留的节点 const c = prefix[i] if (!cur.next.get(c)) { // 前缀都不匹配,那肯定没这单词了 return [] } cur = cur.next.get(c) // cur就是停留的节点 } const ret = [] const _helper = (node, path) => { if (node.isWord) { // 如果是一个单词 ret.push(prefix + path) // 将其添加到返回结果里 } for (const [key, value] of node.next) { path += key // 记录匹配的路径 _helper(value, path) // 递归向下查找 path = path.slice(0, -1) // 回溯 } } _helper(cur, '') // 从cur开始向下匹配 return ret // 返回结果 } } Trie树的应用 首先应用尝试一下上述我们实现的这个Trie类: const trie = new Trie(); const words = ['bag', 'and', 'banana', 'an', 'am', 'board', 'ball']; words.forEach(word => { trie.add(word); // 构建Trie树 }); trie.log() // 打印所有单词 console.log(trie.match('ba')) // ['bag', 'banana', 'ball'] 学习Trie树最重要就是学习它处理问题的思想,接下来我们拿力扣几道字典树相关的问题,来看看如果巧妙的使用Trie树思想解答它们。 720 - 词典中最长的单词 ↓ 给出一个字符串数组words组成的一本英语词典。从中找出最长的一个单词, 该单词是由words词典中其他单词逐步添加一个字母组成。若其中有多个可行的答案, 则返回答案中字典序最小的单词。若无答案,则返回空字符串。 示例 输入:words = ["a", "banana", "app", "appl", "ap", "apply", "apple"] 输出:"apple" 解释: "apply"和"apple"都能由词典中的单词组成。但是"apple"的字典序小于"apply"。 简单来说就是找到最长的单词,但这个单词必须是其他的单词一步步累加起来的,所以不能出现跨级跳跃的情况。思路就是我们把这个字典转化为一个Trie树,在树里给每个单词做好结束的标记,只能是单词的才能往下进行匹配,所以进行深度优先遍历,但其中只要有一个字符不是单词,就结束这条路接下来的遍历,最后返回匹配到最长的单词长度即可。这个字典转化为Trie树后如下图: 很明显banana直接淘汰,因为这个字符串的第一个字符就不是一个单词,而最后角逐的就是apply和apple,因为这两个单词一路都是踏着其他单词而来。实现代码如下: class Node { constructor(isWord) { this.isWord = isWord this.next = new Map() } } class Trie { constructor() { this.root = new Node() } add(word) { // 构建树 const _helper = (node, word) => { if (word === '') { node.isWord = true return } const c = word[0] if (!node.next.get(c)) { node.next.set(c, new Node()) } _helper(node.next.get(c), word.slice(1)) } _helper(this.root, word) } } var longestWord = function (words) { const trie = new Trie() words.forEach(word => { // 将字符集合构建为trie树 trie.add(word) }) let res = '' // 保存最长单词 const _helper = (node, path) => { if (path.length > res.length || (path.length === res.length && res > path)) { res = path // 只要匹配到单词长度大于已存单词长度 或者 相等时取小的那位 // 更新最长单词 } for (const [key, value] of node.next) { // 遍历多叉树 if (!value.isWord) { // 只要这个节点不是单词结尾,就略过 continue } path += key // 将这个单词加入到路径里 _helper(value, path) // 继续向下匹配 path = path.slice(0, -1) // 遍历完一个分支后,减去这个分支字符 } } _helper(trie.root, '') return res // 返回最长单词 }; 677 - 键值映射 ↓ 实现一个 MapSum 类里的两个方法,insert 和 sum。 对于方法 insert,你将得到一对(字符串,整数)的键值对。 字符串表示键,整数表示值。如果键已经存在,那么原来的键值对将被替代成新的键值对。 对于方法 sum,你将得到一个表示前缀的字符串,你需要返回所有以该前缀开头的键的值的总和。 示例: 输入: insert("apple", 3), 输出: Null 输入: sum("ap"), 输出: 3 输入: insert("app", 2), 输出: Null 输入: sum("ap"), 输出: 5 简单来说就是首先输入一些单词以及对应的权重,然后再输入前缀之后,把每个匹配的单词的权重值累加即可。这次的解题思路就和之前match方法很像,我们把insert的单词放入一颗Trie树里,单词结尾也就是该单词对应的权重值。所以首先定位前缀最后停留的节点,然后遍历的把之后的节点都遍历一遍,累加其权重值即可。代码如下: class Node { // 节点类 constructor(val = 0) { this.val = val // 权重值, 默认为0 this.next = new Map() } } var MapSum = function () { // 题目需要的类 this.root = new Node() }; MapSum.prototype.insert = function (key, val) { let cur = this.root for (let i = 0; i < key.length; i++) { const c = key[i] if (!cur.next.get(c)) { cur.next.set(c, new Node()) } cur = cur.next.get(c) } cur.val = val }; MapSum.prototype.sum = function (prefix) { let cur = this.root for (let i = 0; i < prefix.length; i++) { const c = prefix[i] if (!cur.next.get(c)) { // 前缀都不匹配,直接返回0 return 0 } cur = cur.next.get(c) // 前缀匹配完了之后,cur就是停留的节点 } let res = 0 // 总权重值 const _helper = node => { res += node.val // 遍历cur之后的每一个节点即可,因为不是单词的权重值为0 for (const item of node.next) { _helper(item[1]) } } _helper(cur) return res }; 648 - 单词替换 ↓ 在英语中,我们有一个叫做 词根(root)的概念,它可以跟着其他一些词组成另一个较长的单词—— 我们称这个词为 继承词(successor)。例如,词根an,跟随着单词 other(其他),可以形成新的单词 another(另一个)。 现在,给定一个由许多词根组成的词典和一个句子。你需要将句子中的所有继承词用词根替换掉。 如果继承词有许多可以形成它的词根,则用最短的词根替换它。 你需要输出替换之后的句子。 示例1: 输入: dictionary = ["cat","bat","rat"], sentence = "the cattle was rattled by the battery" 输出:"the cat was rat by the bat" 示例2: 输入: dictionary = ["a","b","c"], sentence = "aadsfasf absbs bbab cadsfafs" 输出:"a a b c" 思路我们还是使用Trie树,将所有的前缀(词根)构建为一颗Trie树,然后遍历的把每个单词与这颗前缀树进行匹配,当前缀树到达结尾时,就把原来字符串换为该词根即可。如图所示: 代码如下: class Node { constructor(idWord = false) { this.isWord = idWord this.next = new Map() } } class Trie { constructor() { this.root = new Node() } add(word) { const _helper = (node, word) => { if (word === '') { node.isWord = true return } const c = word[0] if (!node.next.get(c)) { node.next.set(c, new Node()) } _helper(node.next.get(c), word.slice(1)) } _helper(this.root, word) } change(words) { for (let i = 0; i < words.length; i++) { const word = words[i] let cur = this.root let dict = '' for (let j = 0; j < word.length; j++) { const c = word[j] // 遍历每个单词的每个字符 if (cur.next.get(c)) { // 如果单词有匹配的词根 dict += c // 记录遍历的词根 cur = cur.next.get(c) // 向下遍历 if (cur.isWord) { // 当词根到底时 words[i] = dict // 将记录的词根替换掉单词 break // 不用再遍历单词之后的字符了 } } else { break // 如果没有匹配的词根,直接换下一个单词 } } } return words.join(' ') // 返回新的字符串 } } var replaceWords = function (dictionary, sentence) { const trie = new Trie() dictionary.forEach(dict => { trie.add(dict) // 构建树 }) return trie.change(sentence.split(' ')) // 将单词拆分 }; 这题转换的Trie树就是三条独立的分支,如果Trie树长这样,其实就完全没必要使用Trie树,所以这也是使用Trie树的场景局限性。 最后 通过上述实现与应用,相信大家已经对Trie有了足够的了解,这是一种非常优秀的解决问题的思想,场景使用得当时,能发挥出巨大的优势。如果场景不符合,那就尽量不使用这种数据结构吧。因为...我们来总结下这种数据结构的优缺点: 优点 性能高效,从任意多的字符串中匹配某一个单词的时间复杂度,最多仅为该单词的长度而已。 前缀匹配,像搜索及IDE自动补全的场景,使用Trie树就非常适合。 缺点 对数据要求严苛,如果字符集合公共的前缀并不多时(第三题就是这个情况),表现并不好。因为每个节点不仅仅可以存储小写字母,还包括大写字母、数字等,这样的话,一颗Trie树就会异常庞大,会非常消耗内存。 JavaScript没有现成的类使用,要自己手写且要保证没bug,麻烦。 本章github源码