首页 文章 精选 留言 我的

精选列表

搜索[TASTy解析],共10003篇文章
优秀的个人博客,低调大师

HBase架构解析

Hbase组件  客户端Client 整个HBase集群的入口 使用HBase RPC机制与HMaster和HRegionserver通信 与HMaster通信进行管理类的操作 与HRegionserver通信进行读写类操作 包含访问HBase的接口,并维护cache来加快对HBase的访问,与HRegionserver交互 程序协调服务Zookeeper 保证任何时候,集群中只有一个Master 存贮所有Region的寻址入口 实时监控Region server的上线和下线信息。并实时通知给Master 存储HBase的schema和table元数据 HBase主节点Master 管理用户对Table的增删改查操作 管理HRegionServer的负载均衡,调整Region分布 在Region Split后,负责新Region的分配 在HRegionServer停机后,负责失效HRegionServer上的Region迁移 HMaster失效仅会导致所有元数据无法被修改,表的数据读写还是可以正常运行 HBase与Zookeeper HBase元数据存储在Zookeeper中 默认情况下,HBase管理Zookeeper示例,比如,启动或停止Zookeeper Zookeeper解决HBase单节点故障问题 HMaster与HRegionserver启动时回向Zookeeper注册 寻找RegionServer过程详解  - Zookeeper(读取Zookeeper找到-ROOT-表的位置) - -ROOT-(-ROOT-表包含.META.表所在的region列表,该表只会有一个Region;Zookeeper中记录了-ROOT-表的location) - .META(这个表包含所有的用户空间region列表,已经RegionServer的服务器地址) - 用户表 - Client第一次操作后,会将-ROOT-和.META.缓存到本地,不需要再访问zookeeper (PS:0.96之后的版本,ZK不再存储ROOT表信息,直接存储META表信息) HBase容错性 Master容错:Zookeeper重新选择一个新的Master 无Master过程中,数据读取仍然照常进行; 无Master中,region切分,负载均衡无法进行; RegionServer容错:定时向Zookeeper汇报心跳,如果一段时间内未出现心跳,master将该RegioinServer上的Region重新分配到其他RegionServer上;失效服务器上“预写”日志由服务器进行分割并派送给新的ReginServer zookeeper容错:Zookeeper高可靠的服务,不存在单点故障

优秀的个人博客,低调大师

柱面模型解析

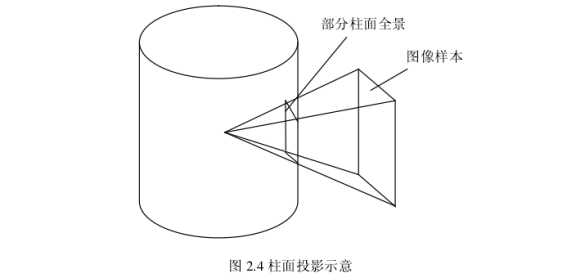
柱面全景是最为简单的全景虚拟。所谓柱面全景,可以理解为以节点为中心的具有一定高度的圆柱形的平面,平面外部的景物投影在这个平面上。如图所示。 用户可以在全景图像中 360 度的范围内任意切换视线,也可以在一个视线上改变视角,来取得接近或远离的效果,也可以认为是球面全景图的一种简化。用户在水平方向上有 360度的视角,在垂直方向上也可以做一定的视角变化,但是角度范围则受到限制。由于柱面模型的图像质量均匀,细节真实程度更高,应用范围比较广泛。 柱面全景图像也较为容易处理,因为可以将圆柱面沿轴向切开并展开在一个平面上,传统的图像处理方法常常可以直接使用。柱面全景图像并不要求照相机的标定十分准确。所以将柱面全景图显著优点归纳为以下两点: 1)它的单幅照片的获取方式比立方体形式和球面形式的获取方式简单。所需的设备只有普通的相机和一个允许连续“转动”的三角架。 2)柱面全景图容易展开为一个矩形图像,可直接用计算机常用的图像格式进行存储和访问。虽然柱面形式的全景图在垂直方向允许参与者视线的转动角度小于 180 度,但是在绝大多数应用中,水平方向的 360 度环视场景已足以表达空间信息。//ConsoleApplication.cpp:定义控制台应用程序的入口点。 //#include"stdafx.h"usingnamespacestd;usingnamespacecv;#definePI3.14159int_tmain(intargc,_TCHAR*argv[]){Matsrc=imread("e:/template/Univ4.jpg");Matresult=src.clone();for(inti=0;i<result.rows;i++){for(intj=0;j<result.cols;j++)result.at<Vec3b>(i,j)=0;}intW=src.cols;intH=src.rows;floatr=W/(2*tan(PI/6));floatk=0;floatfx=0;floatfy=0;for(inti=0;i<src.rows;i++){for(intj=0;j<src.cols;j++){k=sqrt((float)(r*r+(W/2-j)*(W/2-j)));fx=r*sin(PI/6)+r*sin(atan((j-W/2)/r));fy=H/2+r*(i-H/2)/k;intix=(int)fx;intiy=(int)fy;if(ix<W&&ix>=0&&iy<H&&iy>=0)result.at<Vec3b>(iy,ix)=src.at<Vec3b>(i,j);}}imshow("src",src);imshow("result",result);waitKey();return0;} 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

优秀的个人博客,低调大师

PaaS架构解析

一、PaaS的发展简史 PaaS作为新一代的云计算平台,目前在业界得到了广泛的关注与讨论。诸多大公司也纷纷推出自己的PaaS平台,比如Pivotal的CloudFoundry, IBM的Bluemix和Redhat的OpenShift等。其实在此之前, PaaS已经有很长一段时间的发展历程。在2007年,Salesforce最早发布force.com,其目的是支持第三方客户在Salesforce.com上开发和部署定制软件,它基本使用的元数据驱动的方式来开发和管理应用。在2008年4月的时候,技术巨头Google发布GAE(Google AppEngine),其目的是争夺独立开发者和创业公司的市场。GAE在发布之时就得到了业界的广泛关注,在很多方面都突破了原有的技术思路,比如使用容器来部署应用,简化的用户体验等。但是,我们也看到,GAE在业务上并没有获得巨大的成功,后面的发展也证明AWS的策略更加成功。一年之后,新浪SAE也发布,其命名、发展思路与架构模式和GAE非常类似,当然,业务上也同样不太成功。 AWS也看到了PaaS平台的潜力,与2011年发布其官方PaaS平台Beanstalk。在Beanstalk之前,几乎所有的PaaS平台都是基于Linux容器技术LXC。AWS提供了另外一种打造PaaS平台的思路,即基于虚拟机完成应用的自动部署和运维,同时Beanstalk也提供了自动弹性伸缩的功能。容器和虚拟机主要是在资源利用率、安全性和隔离性上有所差别。 CloudFoundry是另外一个里程碑式的PaaS产品,在推出之日就吸引了诸多的焦点,甚至带动了PaaS搜索关键字在Google趋势里面搜索量的飚升。CloudFoundry的成功有这样几个原因:首先它是开源的和免费的。开放源代码意味着全球所有的开发者都能非常简单的部署自己的PaaS平台,同时也意味着让所有的开发者看到打造一个PaaS平台需要哪些关键的技术;其次,CloudFoundry是开放的,它能够支持多种编程语言和开发框架,也能够提供多种服务类型,虽然CloudFoundry的架构经过了几次重构,但是开放性这个关键的特性一直都保留;第三,CloudFoundry提供了一个极简的用户体验,开发人员只需要简单的几个命令就能部署自己的应用系统,彻底颠覆了之前的用户体验。当然,这种用户体验最早是来自于Heroku。 最后值得一提的是大热的Docker。Linux容器技术已经出现了很多很多年,在各大互联网巨头公司也使用了很多很多年,但是Docker利用AUFS技术第一次将容器实例镜像化,这一突破性的创新能够让容器实例可复制、可迁移、可重用。该思路彻底打破了以前只有使用虚拟机才能迁移实例的局限,所以迅速在业界得到追捧。Docker的东家DotCloud甚至把自己的PaaS平台卖掉以专心发展该项技术。 目前来看,PaaS平台技术还处于群雄逐鹿的状态,诸多技术巨头都在不遗余力的发展自己的PaaS平台以跟上技术发展的脚步。以此同时,独立的PaaS提供商(如Heroku、AppFog)等也纷纷被技术巨头收购,这带来了一种质疑的声音是PaaS是否真的能够成为一项独立可持续发展的业务模式。下文将会对此做一些简单的探讨。 二、PaaS架构比较 大致来看,PaaS的实现分为两种:以虚拟机为基础或是以容器为基础。前者的代表是AWS,后者的代表则是GAE, CloudFoundry和Heroku。前文已经提到,AWS是基于虚拟机技术来打造自己的PaaS平台,其架构模式大致如下图所示: 具体而言,AWS基于如下构件打造了Beanstalk:首先是负载均衡层(ELB),该层需要将用户的请求投射到对应的服务器实例,同时,负载均衡层还需要。当应用实例出现扩容时,需要动态将调整的服务器实例注册到对应的域名上,以完成分流;中间是Web服务器层,目前ElasticBean支持Java、Python和PHP等多种编程语言,尽量为编程人员提供多样性的选择,开放性基本是所有PaaS平台的标配。在服务后端,Beanstalk基本依托于AWS本身的服务生态系统为应用提供服务,比如RDS、S3、DynamoDB等。 CloudFoundry等平台则是基于容器技术打造。相比于虚拟机,容器带来的系统开销非常低,如果一台虚拟机的操作系统需要占用2G的内存,则7个虚拟机所组成的集群只是操作系统就需要14G的内存占用。基于容器的技术如果一台16G的裸机除去2G的操作系统开销,还能够部署7个容器进程。所以,从经济性来说,容器的技术远远好于虚拟机。另外一个比较的标准是性能,容器的性能相对而言更好一些,具体的比较参数可以参见IBM研究院刚刚出的报告【1】。但是,从安全性和隔离型来说,虚拟机是远远好于容器的。 CloudFoundry的架构设计如下图所示。首先,CF也提供了一个路由模块(Router),该模块基本是基于ngnix打造,只是在ngnix技术上提供了动态注册的功能。在部署时,由于CF会同时部署非常多的应用实例,所以需要一个router集群来满足应用的需要;其次,CF的应用容器基于自己开发的warden技术,warden也是基于LXC技术,但是使用c和ruby作了一层简单的封装。Docker的大热让CloudFoundry很纠结;第三,CF使用service broker来集成各种资源服务,如mongo、mysql、rabbitmq和redis等。最后,CF使用消息总线NATS/GNATS来完成应用之间的通讯。 其他基于容器的PaaS平台(如Heroku、OpenShift、DotCloud)的平台架构和上面所描述的模式基本一致,我在附件中提供了若干链接,大家如果有兴趣可以仔细研究。 三、PaaS的参考架构模式 根据上面讨论的两种架构模式,我们可以看到PaaS平台的实现基本需要如下的构件: 路由模块:该模块的基本功能是将终端用户请求路由到对应的服务器实例,并提供应用动态注册等功能。目前绝大多数的实现是基于ngnix,同时也需要使用简单的lua脚本完成应用注册和路由查询等基本功能; 服务管理模块:该模块会为开发人员和运维人员提供管理接口,其基本功能包括创建应用实例、配置应用运行参数、启停应用、发布应用程序、扩容或缩容等。服务管理模块也需要提供相应的客户端被用户使用,如命令行或是用户界面等; 应用容器模块:应用容器是PaaS平台的核心,其主要功能是管理应用实例的生命周期,汇报应用的运行状态等。目前来看,应用容器可以基于虚拟机来实现(如AWS),也可以使用Linux容器技术来实现,最早使用的是LXC,CloudFoundry使用的是自己的warden,同样也是基于cgroup,现在最新的是docker; 应用部署模块:应用部署模块需要将应用程序打包成为可直接部署的发布包。该模块是实现PaaS平台开发性的关键。由于现有通用的PaaS平台需要支持多种编程语言和框架,如Java, Python, Ruby和PHP等,当应用发布时,PaaS平台需要根据不同的编程语言将应用打包成为通用的发布包,然后传递给容器模块部署。应用部署模块是实现这一过程的关键,目前来看起源于Heroku的buildpack已经被大家广发接受; 块存储模块:该模块主要用于存储应用的发布包,需要保证程序包的长久存储和。目前AWS的Beanstalk直接使用S3,CF可以使用网络文件系统NFS或是其他任何分布式文件存储系统(如HBase); 数据存储模块:该模块需要保存应用和服务的基本信息,可以基于任何现有的数据库技术实现,如MYSQL或是MONGODB等; 监控模块:该模块的作用是持续监控应用的运行状态,比如健康状态(是否存活)、资源使用率(CPU、内存、硬盘、网络等)和可用性等。这些指标会成为整个PaaS平台运维的关键,也为自动弹性伸缩奠定基础; 用户认证模块:该模块需要保证应用程序的安全性和隔离性,通常而言,公有云的提供商会使用OAuth等技术集成现有的用户认证服务; 消息总线模块:该模块也是最重要的模块,由于PaaS平台所搭建的是一个大规模分布式环境,通常而言,规模在数百台到上千台的机器数量,所有模块之间的通讯会变成一个核心的问题。所以消息总线会变成系统之间通讯的基础,通常需要支持pub/sub模式。 基于该架构,应用实例的弹性伸缩也能够非常容易的实现。首先需要监控服务来不断获取实时的应用状态,当某些指标超出预先定义的阈值时,平台会启动伸缩服务,首先从应用容器模块预留资源,然后调用应用部署模块打包应用并部署,最后将应用节点注册到路由模块完成整个伸缩的过程。 四、PaaS未来发展的趋势 PaaS通过开放性的设计,能够支持多种不同的编程语言、技术框架和服务,从而为应用开发人员提供了广泛的选择,能够大大提供开发人员的效率。同时,PaaS也从运维层面为企业提供了强大的支持,将以前很难实现的技术场景(如应用弹性伸缩等)转化为可能。最后,基于容器技术实现的PaaS平台也带来了经济性的优势。所以,相比于现有纯资源型的IaaS平台,PaaS确实将云计算平台提升到一个新的高度,距离应用开发更近了一步。

优秀的个人博客,低调大师

Paint类解析

在自定义组件中,Paint类是一个很重要的类,主要包含颜色、文本、图形样式、位图模式、滤镜等几个方面。Paint类的相关方法如下: 1、颜色是指绘图时使用的颜色,在 Android 中颜色可以指定透明度,使用 16 进制来表示颜色 时,格式通常为#AARRGGBB,其中,AA 表示透明度、RR 表示红色、GG 表示绿色、BB 表示蓝色, Color 类定义了颜色信息,内置了常用颜色的 int 型常量,比如 Color.RED 是红色,Color.BLUE 是 蓝色……如果您习惯了 16 进制的颜色, Color 类的静态方法 parseColor(String colorString)可以将 16进制颜色转换成 Color 类型。需要注意的是,Android 的颜色都是 int 类型的,Color 类只负责颜色的管理而不是代表某种颜色。 Paint 类中与颜色相关的方法有: public native void setColor(int color);//设置颜色 public native void setAlpha(int a);//设置透明度,a 的范围取 0~255 之间的整数 public void setARGB(int a,int r,int g,int b);//指定透明度、红、绿、蓝定义一种颜色 2、绘制文本时,可以指定文本的大小、对齐方式、文本样式等属性,文本样式主要是为文本指定粗体、下划线、删除线等修饰性属性,主要说明下设置字体大小这个: public native void setTextSize(float textSize);// 设置文本大小,单位是 px,这个和我们平时使用的字体单位 sp 不同,所以最好进行转换,这个要注意。 比较麻烦的是绘制文字时,我们还要考虑字体的基本结构,字体的信息使用 Paint.FontMetrics 类来表示,该类源码如下: public static class FontMetrics { public float ascent; public float bottom; public float descent; public float leading; public float top; } 从文字上理解可能比较晦涩,看下示意图也许很容易找到答案: 简单来说,常用字符的高度是 ascent 和 descent 的和,但是,一些特殊字符比如拼音的音调等则会延伸到 top 的位置。 baseline:基准点(绿色虚线所指); ascent:baseline 之上至字符最高处的距离; descent:baseline 之下至字符最低处的距离; top:字符可达最高处到 baseline 的值,即 ascent 的最大值; bottom:字符可达最低处到 baseline 的值,即 descent 的最大值。 leading:行间距,表示上一行字符的descent到该行字符的ascent之间的距离 根据世界范围内已入案的使用语言中能够标注在字符上方或者下方的除了类似的符号肯定是数不胜数的,一般情况下我们极少使用到类似的符号所以往往会忽略掉这些符号的存在,但是Android依然会在绘制文本的时候在文本外层留出一定的边距,这就是为什么 top和bottom总会比ascent和descent大一点的原因。而在TextView中我们可以通过xml设置其属性 android:includeFontPadding="false"去掉一定的边距值但是不能完全去掉。 要获取 FontMetrics 对象,调用 Paint 类的 getFontMetrics()即可,而在 drawText()方法中,参数 y 就是 baseline 的值,因为 FontMetrics 类并没有声明 baseline 属性,所以,我们需要通过下面的公式计算出来: int baseline=(int) (viewHeight - fontMetrics.descent - fontMetrics.ascent) /2; 其中,viewHeight 是文字所在区域的高度。 下面自定义一个文本绘制的View public class TextView1 extends View { private static final String TEXT = "Android自定义"; private Paint paint; public TextView1(Context context) { super(context); } public TextView1(Context context, AttributeSet attrs) { super(context, attrs); paint = new Paint(Paint.ANTI_ALIAS_FLAG); paint.setColor(Color.RED); FontMetrics fontMetrics = paint.getFontMetrics(); Log.d("xmr", "ascent:" + fontMetrics.ascent); Log.d("xmr", "top:" + fontMetrics.top); Log.d("xmr", "leading:" + fontMetrics.leading); Log.d("xmr", "descent:" + fontMetrics.descent); Log.d("xmr", "bottom:" + fontMetrics.bottom); } public TextView1(Context context, AttributeSet attrs, int defStyleAttr) { super(context, attrs, defStyleAttr); } @Override protected void onDraw(Canvas canvas) { super.onDraw(canvas); // 将文字放在正中间 Rect textRect = this.getTextRect(); int viewWidth = getMeasuredWidth(); int viewHeight = getMeasuredHeight(); Paint.FontMetrics fontMetrics = paint.getFontMetrics(); int x = (viewWidth - textRect.width()) / 2; int y = (int) (viewHeight - fontMetrics.descent - fontMetrics.ascent) / 2; canvas.drawText(TEXT, x, y, paint); } @Override protected void onMeasure(int widthMeasureSpec, int heightMeasureSpec) { Rect rect = getTextRect(); int textWidth = rect.width(); int textHeight = rect.height(); int width = measureWidth(widthMeasureSpec, textWidth); int height = measureHeight(heightMeasureSpec, textHeight); setMeasuredDimension(width, height); } /** * 获取文字所占的尺寸 * * @return */ private Rect getTextRect() { // 根据 Paint 设置的绘制参数计算文字所占的宽度 Rect rect = new Rect(); // 文字所占的区域大小保存在 rect 中 paint.getTextBounds(TEXT, 0, TEXT.length(), rect); return rect; } /** * 测量组件宽度 * * @param widthMeasureSpec * @param textWidth * 文字所占宽度 * @return */ private int measureWidth(int widthMeasureSpec, int textWidth) { int mode = MeasureSpec.getMode(widthMeasureSpec); int size = MeasureSpec.getSize(widthMeasureSpec); int width = 0; if (mode == MeasureSpec.EXACTLY) { // 宽度为 match_parent 和具体值时,直接将 size 作为组件的宽度 width = size; } else if (mode == MeasureSpec.AT_MOST) { // 宽度为 wrap_content,宽度需要计算,此处为文字宽度 width = textWidth; } return width; } /** * 测量组件高度 * * @param heightMeasureSpec * @param textHeight * 文字所占高度 * @return */ private int measureHeight(int heightMeasureSpec, int textHeight) { int mode = MeasureSpec.getMode(heightMeasureSpec); int size = MeasureSpec.getSize(heightMeasureSpec); int height = 0; if (mode == MeasureSpec.EXACTLY) { // 宽度为 match_parent 和具体值时,直接将 size 作为组件的高度 height = size; } else if (mode == MeasureSpec.AT_MOST) { // 高度为 wrap_content,高度需要计算,此处为文字高度 height = textHeight; } return height; } } 效果如下: logcat输出如下: 如图我们得到了top,ascent,descent,bottom和leading的值,因为只有一行文本所以leading恒为0。 从代码中可以发现在我们绘制文本之前我们便可以获取文本的FontMetrics属性值,也就是说我们FontMetrics的这些值跟我们要绘制什么文本是无关的,而仅与绘制文本Paint的size和typeface有关,我们来分别更改这两个值看看效果: paint.setTextSize(36); 如图所示所有值都改变了,我们再为Paint设置一个typeface: paint.setTypeface(Typeface.defaultFromStyle(Typeface.ITALIC)); 3、图形样式包含绘制的图形是空心样式还是实心样式,同时还能指定落笔和收笔时的笔触效 果。绘制直线或折线时,图形样式能影响到一些绘制细节。 Paint 类与图形样式相关的方法有: public void setStyle(Paint.Style style);//设置绘制的图形是空心样式还是实心样式,默认为实心样式,style 的可选值有: public static enum Style{ FILL, FILL_AND_STROKE, STROKE } 其中,FILL 表示实心样式,对于闭合图形来说,会用指定的颜色进行填充;STROKE 表 示空心样式,绘制时只有线条而无填充效果;FILL_AND_STROKE 表示同时使用实心样 式和空心样式。 public void setStrokeJoin(Paint.Join join) 当绘图样式为 STROKE 时,该方法用于指定线条连接处的拐角样式,能使绘制的图形 更加平滑。可选值如下: public static enum Join { BEVEL, MITER, ROUND } 我们通过下图来区别上面三个枚举值(比较右上角即可) ,默认值为 MITER: public void setStrokeCap(Paint.Cap cap) 该方法用于设置落笔时的样式,控制我们的画笔在离开画板时留下的最后一点图形,可选值如下: public static enum Cap { BUTT, ROUND, SQUARE } 我们通过下图来区别上面三个枚举值,默认值为 BUTT: public native void setStrokeWidth(float width) 设置线条的宽度,注意是 float 类型,在 Android 中最细的线条不是 1,可以比 1 更小更细。 参考:http://blog.csdn.net/abcdef314159/article/details/51720686

优秀的个人博客,低调大师

Flink 源码解析 —— 深度解析 Flink 是如何管理好内存的?

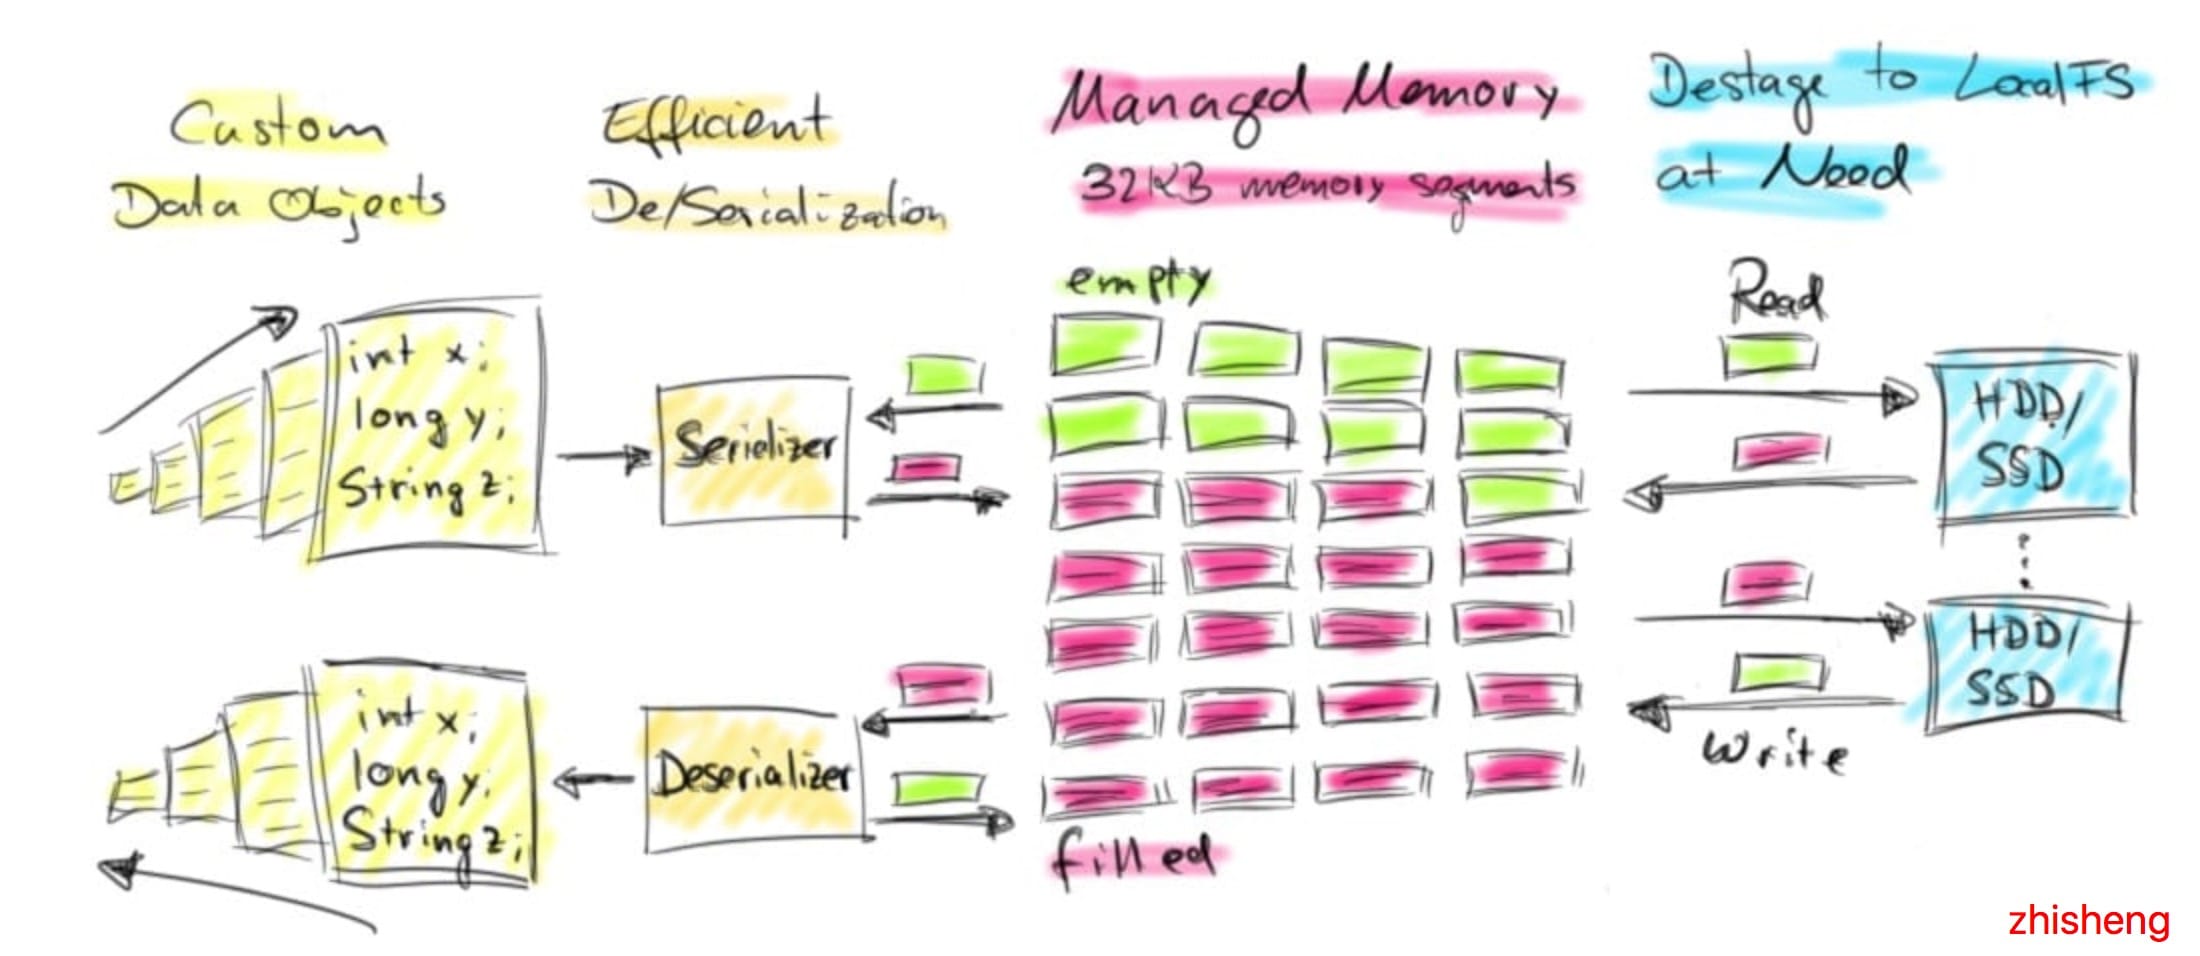
前言如今,许多用于分析大型数据集的开源系统都是用 Java 或者是基于 JVM 的编程语言实现的。最着名的例子是 Apache Hadoop,还有较新的框架,如 Apache Spark、Apache Drill、Apache Flink。基于 JVM 的数据分析引擎面临的一个常见挑战就是如何在内存中存储大量的数据(包括缓存和高效处理)。合理的管理好 JVM 内存可以将 难以配置且不可预测的系统 与 少量配置且稳定运行的系统区分开来。在这篇文章中,我们将讨论 Apache Flink 如何管理内存,讨论其自定义序列化与反序列化机制,以及它是如何操作二进制数据的。数据对象直接放在堆内存中在 JVM 中处理大量数据最直接的方式就是将这些数据做为对象存储在堆内存中,然后直接在内存中操作这些数据,如果想进行排序则就是对对象列表进行排序。然而这种方法有一些明显的缺点,首先,在频繁的创建和销毁大量对象的时候,监视和控制堆内存的使用并不是一件很简单的事情。如果对象分配过多的话,那么会导致内存过度使用,从而触发 OutOfMemoryError,导致 JVM 进程直接被杀死。 另一个方面就是因为这些对象大都是生存在新生代,当 JVM 进行垃圾回收时,垃圾收集的开销很容易达到 50% 甚至更多。最后就是 Java 对象具有一定的空间开销(具体取决于 JVM 和平台)。对于具有许多小对象的数据集,这可以显著减少有效可用的内存量。如果你精通系统设计和系统调优,你可以根据系统进行特定的参数调整,可以或多或少的控制出现 OutOfMemoryError 的次数和避免堆内存的过多使用,但是这种设置和调优的作用有限,尤其是在数据量较大和执行环境发生变化的情况下。Flink 是怎么做的?Apache Flink 起源于一个研究项目,该项目旨在结合基于 MapReduce 的系统和并行数据库系统的最佳技术。在此背景下,Flink 一直有自己的内存数据处理方法。Flink 将对象序列化为固定数量的预先分配的内存段,而不是直接把对象放在堆内存上。它的 DBMS 风格的排序和连接算法尽可能多地对这个二进制数据进行操作,以此将序列化和反序列化开销降到最低。如果需要处理的数据多于可以保存在内存中的数据,Flink 的运算符会将部分数据溢出到磁盘。事实上,很多Flink 的内部实现看起来更像是 C / C ++,而不是普通的 Java。下图概述了 Flink 如何在内存段中存储序列化数据并在必要时溢出到磁盘: Flink 的主动内存管理和操作二进制数据有几个好处:1、内存安全执行和高效的核外算法 由于分配的内存段的数量是固定的,因此监控剩余的内存资源是非常简单的。在内存不足的情况下,处理操作符可以有效地将更大批的内存段写入磁盘,后面再将它们读回到内存。因此,OutOfMemoryError 就有效的防止了。2、减少垃圾收集压力 因为所有长生命周期的数据都是在 Flink 的管理内存中以二进制表示的,所以所有数据对象都是短暂的,甚至是可变的,并且可以重用。短生命周期的对象可以更有效地进行垃圾收集,这大大降低了垃圾收集的压力。现在,预先分配的内存段是 JVM 堆上的长期存在的对象,为了降低垃圾收集的压力,Flink 社区正在积极地将其分配到堆外内存。这种努力将使得 JVM 堆变得更小,垃圾收集所消耗的时间将更少。3、节省空间的数据存储 Java 对象具有存储开销,如果数据以二进制的形式存储,则可以避免这种开销。4、高效的二进制操作和缓存敏感性 在给定合适的二进制表示的情况下,可以有效地比较和操作二进制数据。此外,二进制表示可以将相关值、哈希码、键和指针等相邻地存储在内存中。这使得数据结构通常具有更高效的缓存访问模式。主动内存管理的这些特性在用于大规模数据分析的数据处理系统中是非常可取的,但是要实现这些功能的代价也是高昂的。要实现对二进制数据的自动内存管理和操作并非易事,使用 java.util.HashMap 比实现一个可溢出的 hash-table (由字节数组和自定义序列化支持)。当然,Apache Flink 并不是唯一一个基于 JVM 且对二进制数据进行操作的数据处理系统。例如 Apache Drill、Apache Ignite、Apache Geode 也有应用类似技术,最近 Apache Spark 也宣布将向这个方向演进。下面我们将详细讨论 Flink 如何分配内存、如果对对象进行序列化和反序列化以及如果对二进制数据进行操作。我们还将通过一些性能表现数据来比较处理堆内存上的对象和对二进制数据的操作。Flink 如何分配内存?Flink TaskManager 是由几个内部组件组成的:actor 系统(负责与 Flink master 协调)、IOManager(负责将数据溢出到磁盘并将其读取回来)、MemoryManager(负责协调内存使用)。在本篇文章中,我们主要讲解 MemoryManager。MemoryManager 负责将 MemorySegments 分配、计算和分发给数据处理操作符,例如 sort 和 join 等操作符。MemorySegment 是 Flink 的内存分配单元,由常规 Java 字节数组支持(默认大小为 32 KB)。MemorySegment 通过使用 Java 的 unsafe 方法对其支持的字节数组提供非常有效的读写访问。你可以将 MemorySegment 看作是 Java 的 NIO ByteBuffer 的定制版本。为了在更大的连续内存块上操作多个 MemorySegment,Flink 使用了实现 Java 的 java.io.DataOutput 和 java.io.DataInput 接口的逻辑视图。MemorySegments 在 TaskManager 启动时分配一次,并在 TaskManager 关闭时销毁。因此,在 TaskManager 的整个生命周期中,MemorySegment 是重用的,而不会被垃圾收集的。在初始化 TaskManager 的所有内部数据结构并且已启动所有核心服务之后,MemoryManager 开始创建 MemorySegments。默认情况下,服务初始化后,70% 可用的 JVM 堆内存由 MemoryManager 分配(也可以配置全部)。剩余的 JVM 堆内存用于在任务处理期间实例化的对象,包括由用户定义的函数创建的对象。下图显示了启动后 TaskManager JVM 中的内存分布: Flink 如何序列化对象? Java 生态系统提供了几个库,可以将对象转换为二进制表示形式并返回。常见的替代方案是标准 Java 序列化,Kryo,Apache Avro,Apache Thrift 或 Google 的 Protobuf。Flink 包含自己的自定义序列化框架,以便控制数据的二进制表示。这一点很重要,因为对二进制数据进行操作需要对序列化布局有准确的了解。此外,根据在二进制数据上执行的操作配置序列化布局可以显著提升性能。Flink 的序列化机制利用了这一特性,即在执行程序之前,要序列化和反序列化的对象的类型是完全已知的。Flink 程序可以处理表示为任意 Java 或 Scala 对象的数据。在优化程序之前,需要识别程序数据流的每个处理步骤中的数据类型。对于 Java 程序,Flink 提供了一个基于反射的类型提取组件,用于分析用户定义函数的返回类型。Scala 程序可以在 Scala 编译器的帮助下进行分析。Flink 使用 TypeInformation 表示每种数据类型。 Flink 有如下几种数据类型的 TypeInformations:BasicTypeInfo:所有 Java 的基础类型或 java.lang.StringBasicArrayTypeInfo:Java 基本类型构成的数组或 java.lang.StringWritableTypeInfo:Hadoop 的 Writable 接口的任何实现TupleTypeInfo:任何 Flink tuple(Tuple1 到 Tuple25)。Flink tuples 是具有类型化字段的固定长度元组的 Java 表示CaseClassTypeInfo:任何 Scala CaseClass(包括 Scala tuples)PojoTypeInfo:任何 POJO(Java 或 Scala),即所有字段都是 public 的或通过 getter 和 setter 访问的对象,遵循通用命名约定GenericTypeInfo:不能标识为其他类型的任何数据类型 每个 TypeInformation 都为它所代表的数据类型提供了一个序列化器。例如,BasicTypeInfo 返回一个序列化器,该序列化器写入相应的基本类型;WritableTypeInfo 的序列化器将序列化和反序列化委托给实现 Hadoop 的 Writable 接口的对象的 write() 和 readFields() 方法;GenericTypeInfo 返回一个序列化器,该序列化器将序列化委托给 Kryo。对象将自动通过 Java 中高效的 Unsafe 方法来序列化到 Flink MemorySegments 支持的 DataOutput。对于可用作键的数据类型,例如哈希值,TypeInformation 提供了 TypeComparators,TypeComparators 比较和哈希对象,并且可以根据具体的数据类型有效的比较二进制并提取固定长度的二进制 key 前缀。Tuple,Pojo 和 CaseClass 类型是复合类型,它们可能嵌套一个或者多个数据类型。因此,它们的序列化和比较也都比较复杂,一般将其成员数据类型的序列化和比较都交给各自的 Serializers(序列化器) 和 Comparators(比较器)。下图说明了 Tuple3<Integer, Double, Person>对象的序列化,其中Person 是 POJO 并定义如下: public class Person { public int id; public String name;} 通过提供定制的 TypeInformations、Serializers(序列化器) 和 Comparators(比较器),可以方便地扩展 Flink 的类型系统,从而提高序列化和比较自定义数据类型的性能。Flink 如何对二进制数据进行操作?与其他的数据处理框架的 API(包括 SQL)类似,Flink 的 API 也提供了对数据集进行分组、排序和连接等转换操作。这些转换操作的数据集可能非常大。关系数据库系统具有非常高效的算法,比如 merge-sort、merge-join 和 hash-join。Flink 建立在这种技术的基础上,但是主要分为使用自定义序列化和自定义比较器来处理任意对象。在下面文章中我们将通过 Flink 的内存排序算法示例演示 Flink 如何使用二进制数据进行操作。Flink 为其数据处理操作符预先分配内存,初始化时,排序算法从 MemoryManager 请求内存预算,并接收一组相应的 MemorySegments。这些 MemorySegments 变成了缓冲区的内存池,缓冲区中收集要排序的数据。下图说明了如何将数据对象序列化到排序缓冲区中: 排序缓冲区在内部分为两个内存区域:第一个区域保存所有对象的完整二进制数据,第二个区域包含指向完整二进制对象数据的指针(取决于 key 的数据类型)。将对象添加到排序缓冲区时,它的二进制数据会追加到第一个区域,指针(可能还有一个 key)被追加到第二个区域。分离实际数据和指针以及固定长度的 key 有两个目的:它可以有效的交换固定长度的 entries(key 和指针),还可以减少排序时需要移动的数据。如果排序的 key 是可变长度的数据类型(比如 String),则固定长度的排序 key 必须是前缀 key,比如字符串的前 n 个字符。 请注意:并非所有数据类型都提供固定长度的前缀排序 key。将对象序列化到排序缓冲区时,两个内存区域都使用内存池中的 MemorySegments 进行扩展。一旦内存池为空且不能再添加对象时,则排序缓冲区将会被完全填充并可以进行排序。Flink 的排序缓冲区提供了比较和交换元素的方法,这使得实际的排序算法是可插拔的。默认情况下, Flink 使用了 Quicksort(快速排序)实现,可以使用 HeapSort(堆排序)。下图显示了如何比较两个对象: 排序缓冲区通过比较它们的二进制固定长度排序 key 来比较两个元素。如果元素的完整 key(不是前缀 key) 或者二进制前缀 key 不相等,则代表比较成功。如果前缀 key 相等(或者排序 key 的数据类型不提供二进制前缀 key),则排序缓冲区遵循指向实际对象数据的指针,对两个对象进行反序列化并比较对象。根据比较结果,排序算法决定是否交换比较的元素。排序缓冲区通过移动其固定长度 key 和指针来交换两个元素,实际数据不会移动,排序算法完成后,排序缓冲区中的指针被正确排序。下图演示了如何从排序缓冲区返回已排序的数据: 通过顺序读取排序缓冲区的指针区域,跳过排序 key 并按照实际数据的排序指针返回排序数据。此数据要么反序列化并作为对象返回,要么在外部合并排序的情况下复制二进制数据并将其写入磁盘。基准测试数据那么,对二进制数据进行操作对性能意味着什么?我们将运行一个基准测试,对 1000 万个Tuple2<Integer, String>对象进行排序以找出答案。整数字段的值从均匀分布中采样。String 字段值的长度为 12 个字符,并从长尾分布中进行采样。输入数据由返回可变对象的迭代器提供,即返回具有不同字段值的相同 Tuple 对象实例。Flink 在从内存,网络或磁盘读取数据时使用此技术,以避免不必要的对象实例化。基准测试在具有 900 MB 堆大小的 JVM 中运行,在堆上存储和排序 1000 万个 Tuple 对象并且不会导致触发 OutOfMemoryError 大约需要这么大的内存。我们使用三种排序方法在Integer 字段和 String 字段上对 Tuple 对象进行排序:1、对象存在堆中:Tuple 对象存储在常用的 java.util.ArrayList 中,初始容量设置为 1000 万,并使用 Java 中常用的集合排序进行排序。2、Flink 序列化:使用 Flink 的自定义序列化程序将 Tuple 字段序列化为 600 MB 大小的排序缓冲区,如上所述排序,最后再次反序列化。在 Integer 字段上进行排序时,完整的 Integer 用作排序 key,以便排序完全发生在二进制数据上(不需要对象的反序列化)。对于 String 字段的排序,使用 8 字节前缀 key,如果前缀 key 相等,则对 Tuple 对象进行反序列化。 3、Kryo 序列化:使用 Kryo 序列化将 Tuple 字段序列化为 600 MB 大小的排序缓冲区,并在没有二进制排序 key 的情况下进行排序。这意味着每次比较需要对两个对象进行反序列化。所有排序方法都使用单线程实现。结果的时间是十次运行结果的平均值。在每次运行之后,我们调用System.gc()请求垃圾收集运行,该运行不会进入测量的执行时间。下图显示了将输入数据存储在内存中,对其进行排序并将其作为对象读回的时间。 我们看到 Flink 使用自己的序列化器对二进制数据进行排序明显优于其他两种方法。与存储在堆内存上相比,我们看到将数据加载到内存中要快得多。因为我们实际上是在收集对象,没有机会重用对象实例,但必须重新创建每个 Tuple。这比 Flink 的序列化器(或Kryo序列化)效率低。另一方面,与反序列化相比,从堆中读取对象是无性能消耗的。在我们的基准测试中,对象克隆比序列化和反序列化组合更耗性能。 查看排序时间,我们看到对二进制数据的排序也比 Java 的集合排序更快。使用没有二进制排序 key 的 Kryo 序列化的数据排序比其他方法慢得多。这是因为反序列化带来很大的开销。在String 字段上对 Tuple 进行排序比在 Integer 字段上排序更快,因为长尾值分布显着减少了成对比较的数量。为了更好地了解排序过程中发生的状况,我们使用 VisualVM 监控执行的 JVM。以下截图显示了执行 10次 运行时的堆内存使用情况、垃圾收集情况和 CPU 使用情况。 测试是在 8 核机器上运行单线程,因此一个核心的完全利用仅对应 12.5% 的总体利用率。截图显示,对二进制数据进行操作可显著减少垃圾回收活动。对于对象存在堆中,垃圾收集器在排序缓冲区被填满时以非常短的时间间隔运行,并且即使对于单个处理线程也会导致大量 CPU 使用(排序本身不会触发垃圾收集器)。 JVM 垃圾收集多个并行线程,解释了高CPU 总体利用率。另一方面,对序列化数据进行操作的方法很少触发垃圾收集器并且 CPU 利用率低得多。实际上,如果使用 Flink 序列化的方式在 Integer 字段上对 Tuple 进行排序,则垃圾收集器根本不运行,因为对于成对比较,不需要反序列化任何对象。Kryo 序列化需要比较多的垃圾收集,因为它不使用二进制排序 key 并且每次排序都要反序列化两个对象。内存使用情况上图显示 Flink 序列化和 Kryo 序列化不断的占用大量内存存使用情况图表显示flink-serialized和kryo-serialized不断占用大量内存。这是由于 MemorySegments 的预分配。实际内存使用率要低得多,因为排序缓冲区并未完全填充。下表显示了每种方法的内存消耗。1000 万条数据产生大约 280 MB 的二进制数据(对象数据、指针和排序 key),具体取决于使用的序列化程序以及二进制排序 key 的存在和大小。将其与数据存储在堆上的方法进行比较,我们发现对二进制数据进行操作可以显著提高内存效率。在我们的基准测试中,如果序列化为排序缓冲区而不是将其作为堆上的对象保存,则可以在内存中对两倍以上的数据进行排序。 总而言之,测试验证了文章前面说的对二进制数据进行操作的好处。展望未来Apache Flink 具有相当多的高级技术,可以通过有限的内存资源安全有效地处理大量数据。但是有几点可以使 Flink 更有效率。Flink 社区正在努力将管理内存移动到堆外内存。这将允许更小的 JVM,更低的垃圾收集开销,以及更容易的系统配置。使用 Flink 的 Table API,所有操作(如 aggregation 和 projection)的语义都是已知的(与黑盒用户定义的函数相反)。因此,我们可以为直接对二进制数据进行操作的 Table API 操作生成代码。进一步的改进包括序列化设计,这些设计针对应用于二进制数据的操作和针对序列化器和比较器的代码生成而定制。总结Flink 的主动内存管理减少了因触发 OutOfMemoryErrors 而杀死 JVM 进程和垃圾收集开销的问题。Flink 具有高效的数据序列化和反序列化机制,有助于对二进制数据进行操作,并使更多数据适合内存。Flink 的 DBMS 风格的运算符本身在二进制数据上运行,在必要时可以在内存中高性能地传输到磁盘。本文地址: http://www.54tianzhisheng.cn/2019/03/24/Flink-code-memory-management/

优秀的个人博客,低调大师

Metric模块源码解析

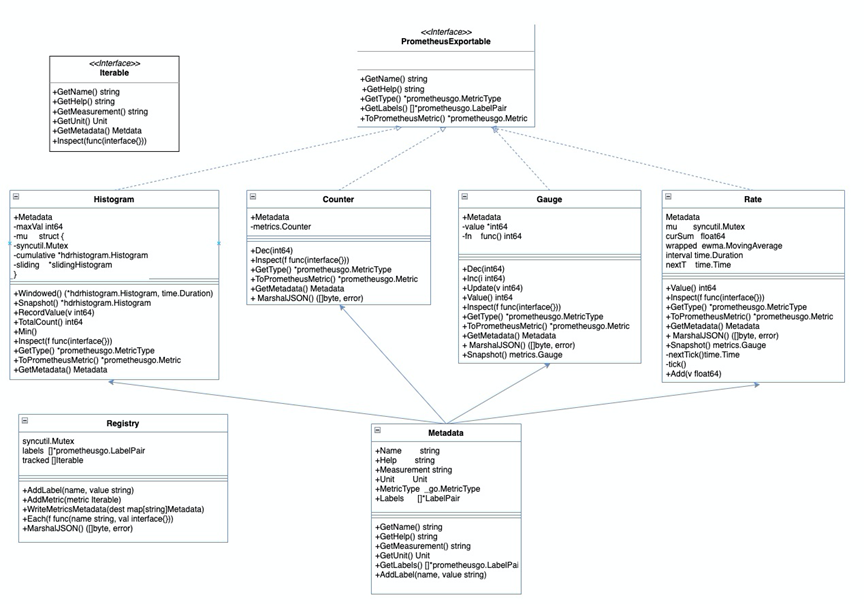
分布式系统的监控告警及运维服务离不开指标监控,开务作为浪潮自主研发的一款分布式数据库自然也不例外。在兼顾强一致性、高可用分布式架构、在线水平扩展、企业级安全等特性下,开务的metric模块可提供监控指标,实现预先定义指标的周期性采集。同时,可以提供兼容 Prometheus 标准格式的 API 接口,方便与外部的 Prometheus 服务进行集成。 开务数据库metric 模块收集各模块相关统计的metric 信息,并将其作为 Prometheus 格式的指标储存起来用于进一步查阅,对判断开务数据库的运行情况有着重要作用,同时也是开务数据库adminUI 指标的数据来源。本期内容将围绕下图展示的metric模块基本框架,带领大家深入了解开务数据库metric 模块的源码,图中各模块的详细介绍将持续为大家更新。 1、定义接口介绍 1.IterableIterable:提供了一个同步访问内部对象的方法。方法如下: GetName() string 返回指标名 GetHelp() string 返回指标帮助文本 GetMeasurement() string 返回指标的lable GetUnit() Unit 返回指标使用的单位 GetMetadata() Metdata 返回指标的Metadata Inspect(func(interface{})) Inspect对每个包含的项调用给定的闭包 2.PrometheusExportable:是标准独立指标接口,可供指标导入 Prometheus。方法如下: GetName() string 返回指标名 GetHelp() string 返回指标帮助文本 GetType() *prometheusgo.MetricType 返回指标的Prometheus类型 GetLables() []*prometheusgo.LabelPair Metadata中的一个方法,返回指标的标签 ToPrometheusMetric() *prometheusgo.Metric 返回一个完成值填充的Prometheus指标 3.PrometheusIterable:是 PrometheusExportable 的扩展,用于指示该指标由增加父标签值的子指标组成。包含成员:PrometheusExportable。方法如下: Each([]*prometheusgo.LabelPair, func(metric *prometheusgo.Metric)) “Each”获取与父指标相关联的标签对切片,并使用每个子指标调用所传递的函数 2、Metric Metadata介绍 Metadata 包含关于指标的元数据,它必须嵌入到每个 metric object 中。它用于将有关指标的信息导出到 Promethues 和 adminUI 图表。 type Metadata struct { Name string Help string Measurement string Unit Unit MetricType _go.MetricType Labels []*LabelPair } // 方法 GetName() string GetHelp() string GetMeasurement() string GetUnit() Unit GetLabels() []*prometheusgo.LabelPair Addlabel(name value string)//给一个指标添加标签/值映射 3、指标类型介绍 1.Histogram:在一段时间范围内对数据进行采样(通常是请求持续时间、响应大小等),并将其计入可配置的存储桶(bucket)中,后续可通过指定区间筛选样本,也可以统计样本总数,最后一般将数据展示为直方图。 Prometheus 的 Histogram 是一种累积直方图,与上面的区间划分方式是有差别的。它的划分方式如下:假设每个 bucket 的宽度是0.2s,那么第一个 bucket 表示响应时间小于等于0.2s 的请求数量,第二个 bucket 表示响应时间小于等于0.4s 的请求数量,以此类推。也就是说,每一个 bucket 的样本包含了之前所有 bucket 的样本,所以叫累积直方图。 type Histogram { Metadata maxVal int64 mu struct { syncutil.Mutex cumulative *hdrhistogram.Histogram sliding *slidingHistogram } //hdrhistogram.Histogram type Histogram struct { lowestTrackableValue int64 highestTrackableValue int64 unitMagnitude int64 significantFigures int64 subBucketHalfCountMagnitude int32 subBucketHalfCount int32 subBucketMask int64 subBucketCount int32 bucketCount int32 countsLen int32 totalCount int64 counts []int64 } //slidingHistogram type slidingHistogram struct { windowed *hdrhistogram.WindowedHistogram nextT time.Time duration time.Duration } type WindowedHistogram struct { idx int h []Histogram m *Histogram Current *Histogram } //相关方法介绍 func (h *Histogram) Windowed() (*hdrhistogram.Histogram, time.Duration) 返回一份当前的窗口化直方图的数据和其中的时间间隔 func (h *Histogram) Snapshot() *hdrhistogram.Histogram 返回累积(即所有样本)直方图数据的副本 func (h *Histogram) RecordValue(v int64) RecordValue将给定的值添加到直方图。记录超过该直方图配置最大值使用方法 func (h *Histogram) TotalCount() int64 TotalCount返回样本的(累计)数量 func (h *Histogram) Min() int64 返回最小值 func (h *Histogram) Inspect(f func(interface{})) 调用带有空字符串和接收方的闭包 func (h *Histogram) GetType() *prometheusgo.MetricType 返回此指标的Prometheus类型enum func (h *Histogram) ToPrometheusMetric() *prometheusgo.Metric 返回正确类型的已填充的Prometheus度量值 func (h *Histogram) GetMetadata() Metadata 返回指标的元数据,包括Prometheus MetricType func NewHistogram(metadata Metadata, duration time.Duration, maxVal int64, sigFigs int) (*Histogram) 实例化一个新histogram func NewLatency(metadata Metadata, histogramWindow time.Duration) *Histogram NewLatency 返回一个带有适当默认值的直方图来跟踪延迟。数值以ns表示,截断为间隔[0,MaxLatency],并以1位精度记录(即误差在100ms时<10ms,在60s时<6s) 2.Counter:代表一种样本数据单调递增的指标,即只增不减,除非监控系统发生了重置。例如,你可以使用 Counter 类型的指标来表示服务的请求数、已完成的任务数、错误发生的次数等。 type Counter struct { Metadata metrics.Counter } type Counter interface { Clear() Count() int64 Dec(int64) Inc(int64) Snapshot() Counter } //相关方法介绍 func (c *Counter) Dec(int64) Dec重载了metric.Counter的方法。不能使用这种方法,它只用于防止误用metric类型 func (c *Counter) GetType() *prometheusgo.MetricType 返回此指标的Prometheus类型enum func (c *Counter) Inspect(f func(interface{})) 调用带有空字符串和接收方的闭包,即返回自己c func (c *Counter) MarshalJSON() ([]byte, error) MarshalJSON将数据封装到JSON func (c *Counter) GetMetadata() Metadata 返回指标的元数据,包括Prometheus MetricType 3.Gauge:代表一种样本数据可以任意变化的指标,即可增可减。Guage 通常用于像温度或者内存使用率这种指标数据,也可以表示能随时增加或减少的“总数”,例如:当前并发请求的数量。 type Gauge struct { Metadata value *int64 fn func() int64 } //相关方法介绍 func (g *Gauge) Snapshot() metrics.Gauge Snapshot返回Gauge的只读副本 func (g *Gauge) Update(v int64) 更新Gauge的值 func (g *Gauge) Inc(i int64) 增加Gauge的当前值 func (g *Gauge) Dec(i int64) 减少Gauge的当前值 func (g *Gauge) Value() int64 Value返回Gauge的当前值 func (g *Gauge) GetType() *prometheusgo.MetricType 返回此指标的Prometheus类型enum func (g *Gauge) ToPrometheusMetric() *prometheusgo.Metric 返回此指标的Prometheus类型enum func (g *Gauge) GetMetadata() Metadata 返回指标的元数据,包括Prometheus MetricType 4.Rate:用来计算某个指标在最近一个区间时间内的变化率。 type Rate struct { Metadata mu syncutil.Mutex // protects fields below curSum float64 wrapped ewma.MovingAverage interval time.Duration nextT time.Time } //相关方法介绍 func (e *Rate) GetType() *prometheusgo.MetricType GetType返回该指标的Prometheus类型enum func (e *Rate) Inspect(f func(interface{})) Inspect用自身调用给定的闭包 func (e *Rate) ToPrometheusMetric() *prometheusgo.Metric 返回此指标的Prometheus类型enum func (c *Counter) MarshalJSON() ([]byte, error) MarshalJSON将数据封装到JSON func (e *Rate) GetMetadata() Metadata GetMetadata返回指标的元数据,包括Prometheus MetricType func (e *Rate) Value() float64 Value返回Rate的当前值 func (e *Rate) tick() Rate时间前进 func (e *Rate) nextTick() time.Time 返回Rate的当前时间。 func (e *Rate) Add(v float64) 添加将给定的测量值添加到Rate 4、注册器Registry介绍 Registry 是 metric 的列表,它提供了一种处理指标的方法,可以将 metric 编组成 JSON,并生成 Prometheus 格式的 metric。同时可以给注册的指标打上标签,当导出到 Prometheus 时,这些标签将应用于它的所有指标。 type Registry struct { syncutil.Mutex labels []*prometheusgo.LabelPair tracked []Iterable } //相关方法介绍 func (r *Registry) AddLabel(name, value string) AddLabel为这个注册表添加一个标签/值对 func (r *Registry) AddMetric(metric Iterable) AddMetric将传入的metric添加到注册表 func (r *Registry) WriteMetricsMetadata(dest map[string]Metadata) WriteMetricsMetadata将所有跟踪metric的元数据写入参数映射 func (r *Registry) Each(f func(name string, val interface{})) 每个函数对所有metric调用给定的闭包 func (r *Registry) MarshalJSON() ([]byte, error) 格式化到JSON格式 5、注册新Registry步骤 // 以txnMetric说明 //txn_metric.go //声明定义的指标结构体类型 type TxnMetrics struct { Commits *metric.Counter ... } //定义指标的metadata var( metaCommitsRates = metric.Metadata{ Name: "txn.commits", Help: "Number of committed KV transactions (including 1PC)", Measurement: "KV Transactions", Unit: metric.Unit_COUNT, } ... ) //将定义的指标类型和metadata相关联 func MakeTxnMetrics(histogramWindow time.Duration) TxnMetrics { return TxnMetrics{ Commits: metric.NewCounter(metaCommitsRates), } //server.go: //注册进Registry txnMetrics := kvcoord.MakeTxnMetrics(cfg.HistogramWindowInterval()) registry.AddMetricStruct(txnMetrics) 开务数据库是一款浪潮集团核心研发的先进、安全的云原生分布式数据库;具备云原生、多中心、高可用、事务强一致等特性,满足 HTAP 场景需求。业务范围覆盖能源、工业互联网、政务、教育、金融等多行业。我们是一支平均年龄 30 岁的年轻团队,在短短不到三年的时间里,我们已取得近 300 项发明专利受理,10 项自有产品软著授权。热烈欢迎广大伙伴加入我们的团队,热门岗位火热招聘中,简历投递邮箱: zhoubeili@inspur.com / bixueting@inspur.com 数据库存储内核研发工程师 工作职责: 1、负责存储子系统的研发路线规划、架构设计和关键技术问题攻关; 2、负责编写功能测试用例,测试工具进行系统验证; 3、负责数据库的系统性能诊断与调优; 4、负责数据库相关关键技术的预研和在团队中的引导; 5、深入理解业务场景的数据库存储需求,针对性的为不同业务场景提供最合适的存储方案。 任职要求: 1、学历:本科或者本科以上学历; 2、专业:计算机或相关专业; 3、专业知识: — 3 年及以上 GO/C++ 开发经验; — 精通 C/C++/GO 语言,Linux 系统编程。熟悉无锁数据结构,熟悉现代硬件体系结构 (CPU/Cache/Memory/Storage), 熟悉并发编程; — 熟练使用 MySQL、PostgeSQL 等主流数据库; — 熟悉数据库存储系统的基本理论,熟悉事务处理,日志与恢复策略,多版本并发控制技术的实现,对数据库的基本理论和内部实现机制有深刻的理解; — 技术视野开阔,有一定的系统性能优化经验,掌握各种性能诊断工具和各种优化方法; — 熟悉时序数据库,有实际的时序数据库开发经验优先; — 熟悉 RocksDB、Arrow、Parquet 等开源存储项目源码者优先。 Base 地: 上海 / 天津 / 济南 / 北京 数据库方案工程师 工作职责: 1、负责分布式数据库,或其相关工具、平台等产品的梳理、规划、设计和推进工作; 2、进行解决方案的调研、设计和验证; 3、设计、撰写和维护产品红皮书; 4、跨部门沟通,协调各类资源以确保产品顺利上线,推进产品迭代。 任职要求: 1、5 年以上的数据库运维及方案设计经验(ORACLE/Mysql/PostgreSQL 任意一种),对部署,优化,灾备,恢复,高可用有实际经验; 2、1 年左右的分布式数据库经验,了解国内任意一款分布式数据库,有部署,POC,问题处理经验; 3、对 OLTP 和 OLAP 系统或其中一种有实际运维设计经验; 4、对数据库灾备,同步方案有实际项目经验; 5、会一种数据库 benchmark 工具,设计相应场景进行测试并结合已有经验给与相应调整优化; 6、有基本的编程能力,如 go,shell,python 其中一项,可以写简单程序对数据库进行并发测试,功能验证; 7、有项目管理能力,很好的沟通能力,可以与开发人员顺畅沟通,并于合作高校学生完成实验及文档编写; 8、扎实的技术,linux 和数据库方面有一定积累,能对开发人员及学生进行一定指导,促使相关工作顺利推进; 9、较强的文档编写组织能力,根据实验文档及相关手册,编写用户解决方案手册; 10、有一定语言表达能力,能做数据库相关功能培训。 Base 地: 上海 / 天津 / 济南 / 北京

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册