首页 文章 精选 留言 我的

精选列表

搜索[ORM],共2403篇文章
优秀的个人博客,低调大师

真正智慧的 ORM 框架 sqltoy-orm 5.6.24 发版

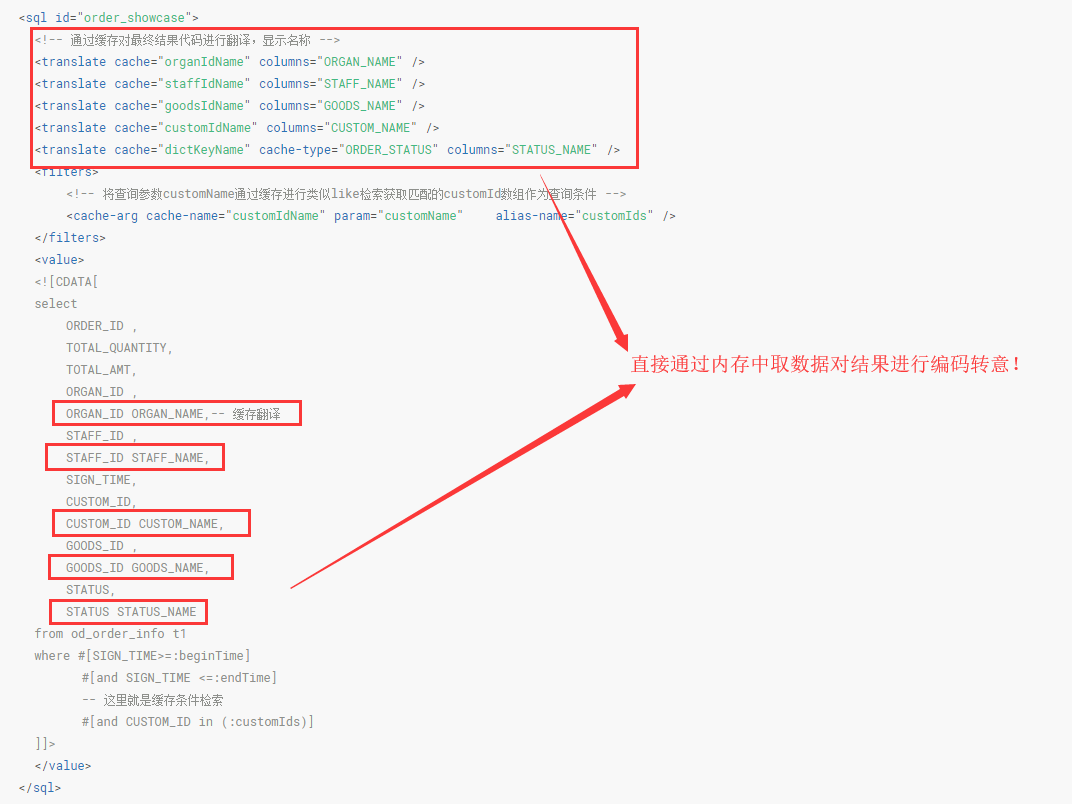
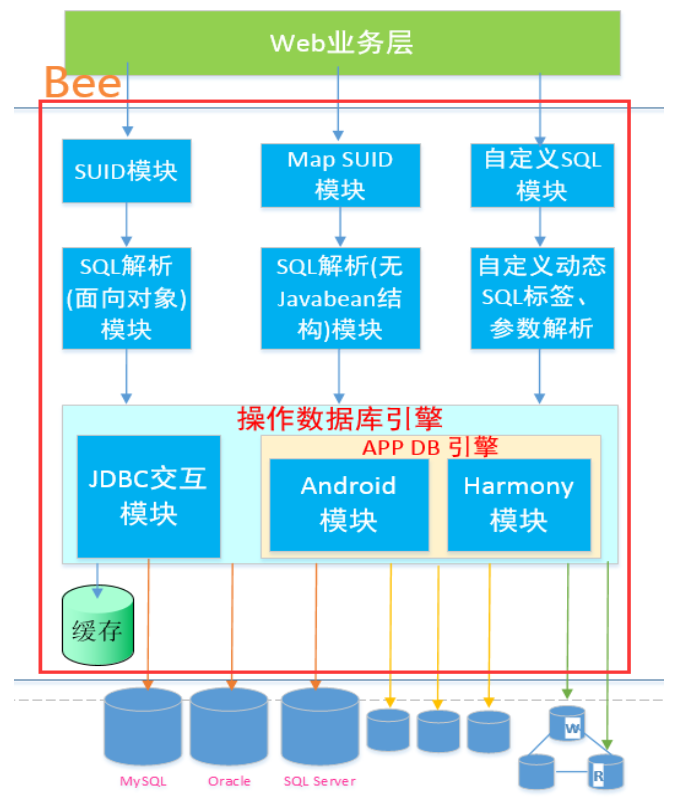
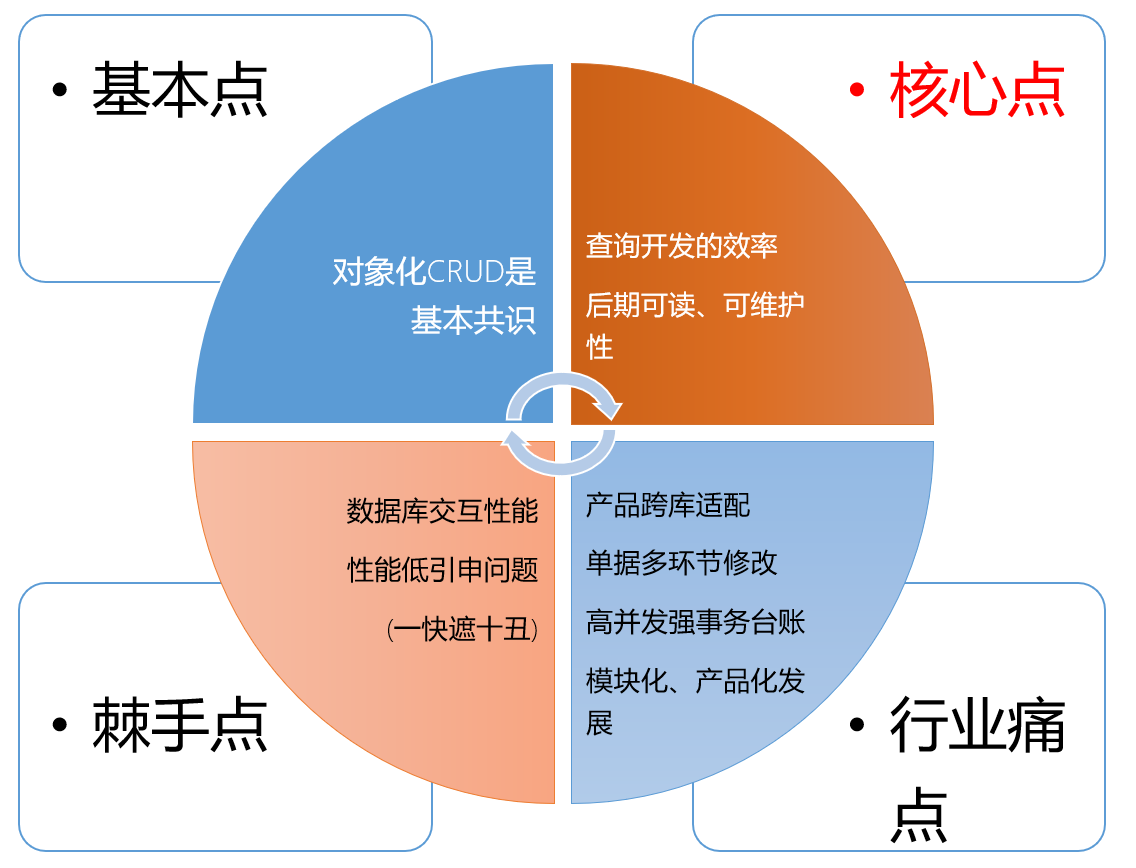
开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/imyuyu/sqltoy-idea-plugin sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、增加@if(:param exclude xxx)逻辑(include的取反)2、优化deleteAll底层逻辑,改为delete from table id in (:ids),复合主键为: (code,type) in ((:codes,:types)),提升效率3、优化loadAll级联加载,复合主键支持select * from table (id,code) in ((x1,x2),(x11,x22)) 多字段in模式,提升效率 JPA 部分 类似 JPA 的对象化 CRUD、对象级联加载和新增、更新 支持通过 POJO 生成 DDL 以及直接向数据库创建表 强化 update 操作,提供弹性字段修改能力,不同于 hibernate 先 load 后修改,而是一次数据库交互完成修改,确保了高并发场景下数据的准确性 改进了级联修改,提供了先删除或者先置无效,再覆盖的操作选项 增加了 updateFetch、updateSaveFetch 功能,强化针对强事务高并发场景的处理,类似库存台账、资金台账,实现一次数据库交互,完成锁查询、不存在则插入、存在则修改,并返回修改后的结果 增加了树结构封装,便于统一不同数据库树型结构数据的递归查询 支持分库分表、支持多种主键策略 (额外支持基于 redis 的产生特定规则的业务主键)、加密存储、数据版本校验 提供了公共属性赋值 (创建人、修改人、创建时间、修改时间、租户)、扩展类型处理等 提供了多租户统一过滤和赋值、提供了数据权限参数带入和越权校验 查询部分 极为直观的 sql 编写方式,便于从客户端 <--> 代码 双向快速迁移,便于后期变更维护 支持缓存翻译、反向缓存匹配 key 代替 like 模糊查询 提供了跨数据库支持能力:不同数据库的函数自动转换适配,多方言 sql 根据实际环境自动匹配、多数据库同步测试,大幅提升了产品化能力 提供了取 top 记录、随机记录等特殊场景的查询功能 提供了最强大的分页查询机制:1) 自动优化 count 语句;2) 提供基于缓存的分页优化,避免每次都执行 count 查询;3) 提供了独具特色的快速分页;4) 提供了并行分页 提供了分库分表能力 提供了在管理类项目中极为价值的:分组汇总计算、行列转换 (行转列、列转行)、同比环比、树形排序、树形汇总 相关算法自然集成 提供了基于查询的层次化数据结构封装 提供了大量辅助功能:数据脱敏、格式化、条件参数预处理等 支持多种数据库 常规的 mysql、oracle、db2、postgresql、 sqlserver、dm、kingbase、sqlite、h2、 oceanBase、polardb、guassdb、tidb 支持分布式 olap 数据库: clickhouse、StarRocks、greenplum、impala (kudu) 支持 elasticsearch、mongodb 所有基于 sql 和 jdbc 各类数据库查询 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

真正智慧的 ORM 框架 sqltoy-orm 5.6.23 发版

开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/imyuyu/sqltoy-idea-plugin sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、修复@fast( @include("sqlId") ) 场景缺陷2、强化where #[field1=:field1Value and] field2=:field2Value 场景sql处理缺陷 JPA 部分 类似 JPA 的对象化 CRUD、对象级联加载和新增、更新 支持通过 POJO 生成 DDL 以及直接向数据库创建表 强化 update 操作,提供弹性字段修改能力,不同于 hibernate 先 load 后修改,而是一次数据库交互完成修改,确保了高并发场景下数据的准确性 改进了级联修改,提供了先删除或者先置无效,再覆盖的操作选项 增加了 updateFetch、updateSaveFetch 功能,强化针对强事务高并发场景的处理,类似库存台账、资金台账,实现一次数据库交互,完成锁查询、不存在则插入、存在则修改,并返回修改后的结果 增加了树结构封装,便于统一不同数据库树型结构数据的递归查询 支持分库分表、支持多种主键策略 (额外支持基于 redis 的产生特定规则的业务主键)、加密存储、数据版本校验 提供了公共属性赋值 (创建人、修改人、创建时间、修改时间、租户)、扩展类型处理等 提供了多租户统一过滤和赋值、提供了数据权限参数带入和越权校验 查询部分 极为直观的 sql 编写方式,便于从客户端 <--> 代码 双向快速迁移,便于后期变更维护 支持缓存翻译、反向缓存匹配 key 代替 like 模糊查询 提供了跨数据库支持能力:不同数据库的函数自动转换适配,多方言 sql 根据实际环境自动匹配、多数据库同步测试,大幅提升了产品化能力 提供了取 top 记录、随机记录等特殊场景的查询功能 提供了最强大的分页查询机制:1) 自动优化 count 语句;2) 提供基于缓存的分页优化,避免每次都执行 count 查询;3) 提供了独具特色的快速分页;4) 提供了并行分页 提供了分库分表能力 提供了在管理类项目中极为价值的:分组汇总计算、行列转换 (行转列、列转行)、同比环比、树形排序、树形汇总 相关算法自然集成 提供了基于查询的层次化数据结构封装 提供了大量辅助功能:数据脱敏、格式化、条件参数预处理等 支持多种数据库 常规的 mysql、oracle、db2、postgresql、 sqlserver、dm、kingbase、sqlite、h2、 oceanBase、polardb、guassdb、tidb 支持分布式 olap 数据库: clickhouse、StarRocks、greenplum、impala (kudu) 支持 elasticsearch、mongodb 所有基于 sql 和 jdbc 各类数据库查询 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

优雅的 ORM 框架 sqltoy-orm-4.11.9 发版了

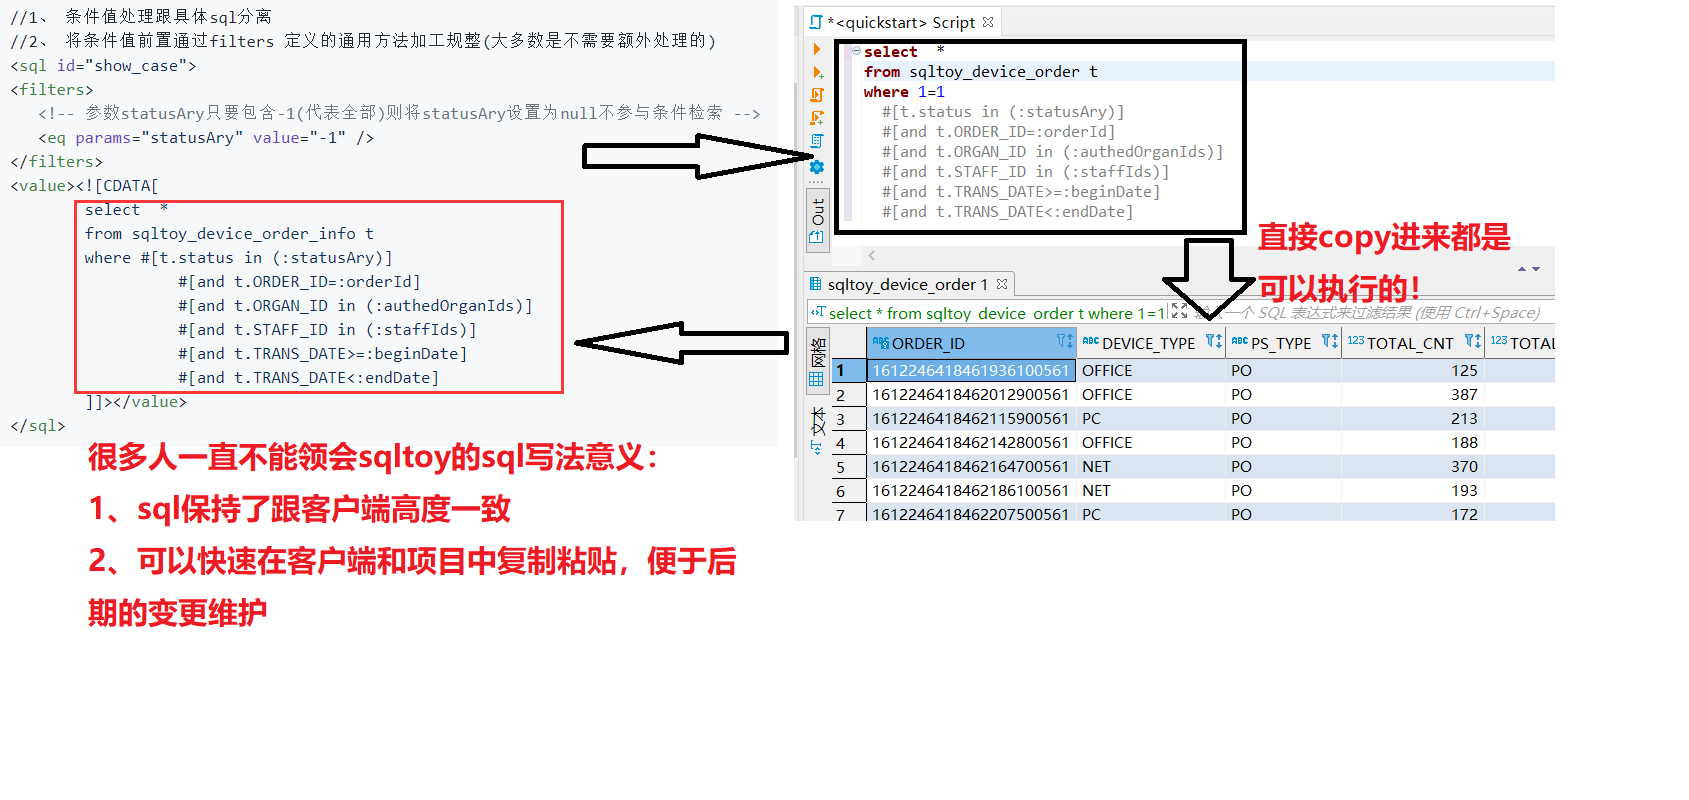
声明: 如果您的数据规模较小或者做前置交易类系统即较少涉及复杂查询领域的,可以忽视本框架!因为针对常规的CRUD sqltoy跟大家并无较大差异! 如果您的数据规模较大,涉及相对复杂的查询已经影响到了用户体验,可以深入了解sqltoy,对你会有较大的帮助! 开源地址: github:https://github.com/chenrenfei/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy 更新内容 1、支持保留字处理,对象操作自动增加保留字符号,跨数据库sql自动适配 2、重新编写修复StringUtil 分隔符号切割函数splitExcludeSymMark( 在sqltoy简单场景下不受影响) 3、增加缓存数据获取为空的日志提醒,,给开发更多信息 4、查询返回结果支持List<Object[]>,同时支持resultType 直接给Map.class等接口(之前必须是HashMap等实现类)、 5、quickvo支持yml格式的配置文件 6、增强sql执行输出 #xml配置模式 <bean id="sqlToyContext" name="sqlToyContext" class="org.sagacity.sqltoy.SqlToyContext" init-method="initialize" destroy-method="destroy"> <!-- 项目中使用到的保留字定义,多个保留字则用逗号分隔 --> <property name="reservedWords" value="maxvalue,minvalue"/> <!-- 其他配置项目此处省略 --> </bean> # yml模式 spring: sqltoy: reservedWords: maxvalue,minvalue sqltoy特点说明: 支持mysql、postgresql、db2、oracle、sqlserver、sqlite、clickhouse、elasticsearch等 具有JPA模式的CRUD功能(即CRUD无需写sql),无需写Dao,sqltoy提供了SqlToyLazyDao,同时提供了quickvo从数据库生成POJO。 根本上杜绝了sql注入问题 最科学的sql编写方式 * sqltoy的sql编写(支持嵌套) select * from sqltoy_device_order_info t where #[t.ORDER_ID=:orderId] #[and t.ORGAN_ID in (:authedOrganIds)] #[and t.STAFF_ID in (:staffIds)] #[and t.TRANS_DATE>=:beginDate] #[and t.TRANS_DATE<:endDate] * mybatis同样功能实现 select * from sqltoy_device_order_info t <where> <if test="orderId!=null"> and t.ORDER_ID=#{orderId} </if> <if test="authedOrganIds!=null"> and t.ORGAN_ID in <foreach collection="authedOrganIds" item="order_id" separator="," open="(" close=")"> #{order_id} </foreach> </if> <if test="staffIds!=null"> and t.STAFF_ID in <foreach collection="staffIds" item="staff_id" separator="," open="(" close=")"> #{staff_id} </foreach> </if> <if test="beginDate!=null"> and t.TRANS_DATE>=#{beginDate} </if> <if test="endDate!=null"> and t.TRANS_DATE<#{endDate} </if> </where> 缓存翻译大幅提升性能,减少多表关联,让sql直观可维护 最高等级的分页优化 支持用算法代替sql实现行列转换、同比环比、分组汇总等 支持分库分表 sqltoy支持跨数据库函数自适应:一套sql可以自适应多种数据库 提供了5种默认的非数据库相关的主键策略 1、shortNanoTime 22位有序安全ID,格式: 13位当前毫秒+6位纳秒+3位主机ID 2、nanoTimeId 26位有序安全ID,格式:15位:yyMMddHHmmssSSS+6位纳秒+2位(线程Id+随机数)+3位主机ID 3、uuid:32 位uuid 4、SnowflakeId 雪花算法ID 5、redisId 基于redis 来产生规则的ID主键 提供了通用字段赋值处理 提供了树形表的统一处理机制 sql文件更新自动重载,便于开发阶段无需重启应用 慢sql统计功能

优秀的个人博客,低调大师

🔥xbatis-ddl-auto 1.0.2 ORM DDL,最强 mybatis ORM DDL

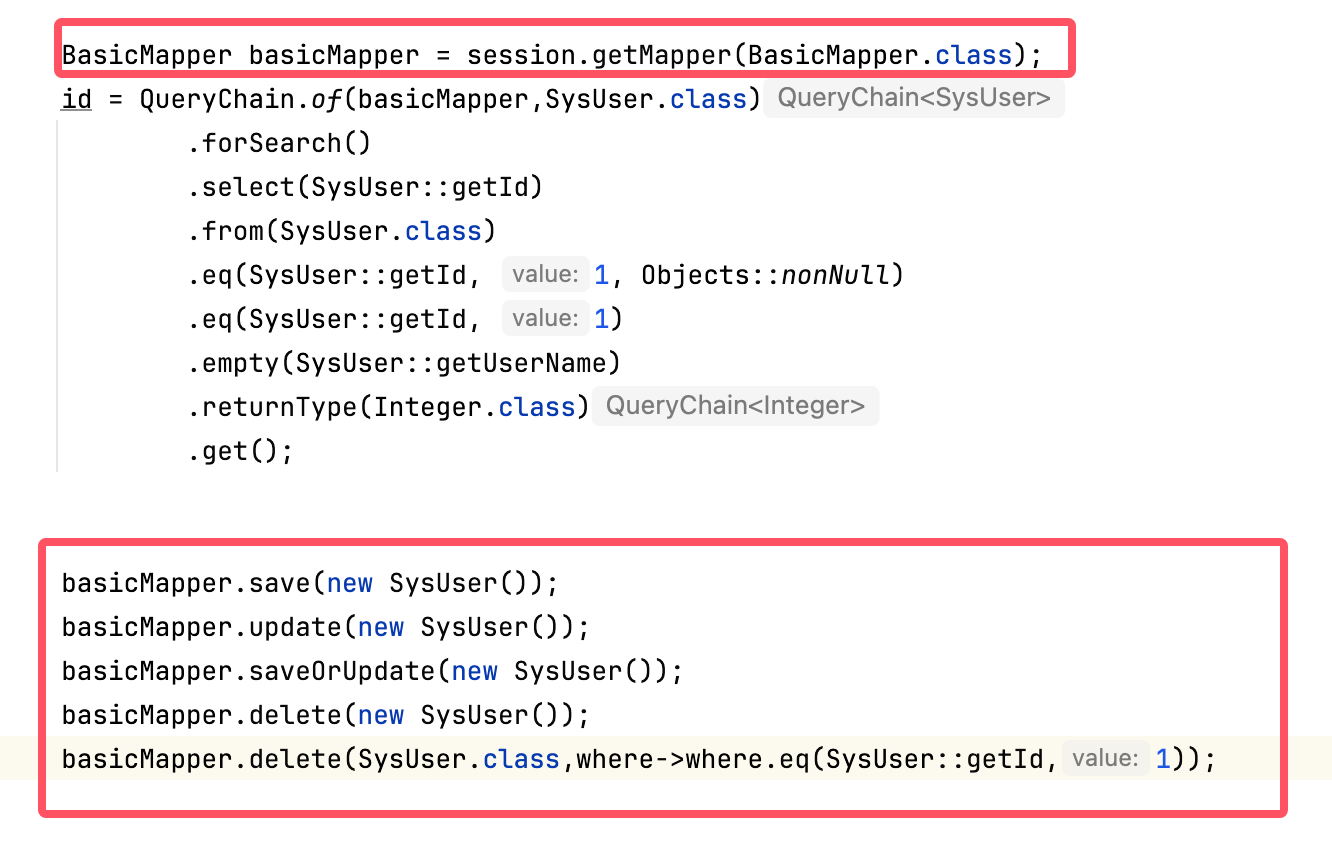
官网 https://xbatis.cn xbatis-ddl-auto 是一个基于 xbatis 实体元数据的轻量自动建表工具。 它复用 xbatis 的 @Table、@TableId、@TableField、@ColumnDefinition 等注解解析结果,根据实体类生成并执行数据库 DDL,提供接近 JPA ddl-auto=create/update 的使用体验,但不引入 JPA 或 Hibernate。 1.0.2 更新 增加SYNC模式,支持 列 索引 变更同步模式 功能 根据 xbatis 实体生成 CREATE TABLE SQL 表不存在时自动建表 表存在时可在 UPDATE 模式下自动追加新增字段 支持只生成 SQL,不执行数据库操作 通过 JDBC DatabaseMetaData 判断表、字段和索引是否存在 支持常见 Java 类型到数据库列类型映射 支持 @ColumnDefinition 配置字段长度、精度、小数位、默认值、唯一约束、非空和字段注释 支持类级 @Index 创建普通索引和唯一索引 安全边界 UPDATE 模式只会自动新增字段和缺失索引,不会自动执行以下高风险操作: 删除数据库已有字段 修改字段类型 修改字段长度 修改字段是否可空 修改默认值 重命名字段 修改或删除已有索引 删除或重建表 这些操作可能造成数据丢失或生产事故,建议通过人工审核 SQL 或专业迁移工具处理。 Maven 本工具 Maven 坐标: <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-ddl-auto</artifactId> <version>1.0.1</version> </dependency> 运行依赖 xbatis core <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-core</artifactId> <version>1.10.6</version> </dependency> 默认测试使用 JUnit 5 和 H2;需要真实数据库的集成测试通过 Maven profile 单独执行。 快速开始 定义 xbatis 实体 import cn.xbatis.db.annotations.ColumnDefinition; import cn.xbatis.db.annotations.Table; import cn.xbatis.db.annotations.TableId; import java.math.BigDecimal; import java.time.LocalDateTime; @Table("sys_user") public class SysUser { @TableId private Long id; @ColumnDefinition(length = 64, nullable = false) private String username; @ColumnDefinition(precision = 10, scale = 2, defaultValue = "0") private BigDecimal balance; private LocalDateTime createdAt; } 执行自动建表: import db.sql.api.DbType; DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); CREATE 模式 CREATE 是默认模式: DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行 CREATE TABLE 表已存在:跳过,不做任何变更 UPDATE 模式 UPDATE 模式用于补新增字段和缺失索引: import cn.xbatis.ddl.auto.Mode; DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行 CREATE TABLE 表已存在:读取数据库已有列和索引,只对实体中新增的字段执行 ALTER TABLE ... ADD COLUMN ...,并创建缺失索引 重复执行 UPDATE 模式不会重复添加已存在字段或已存在索引。 只生成 SQL / 预览 SQL 不连接数据库,只生成建表 SQL: List<String> sqlList = DDLAuto.of(DbType.PGSQL) .add(SysUser.class) .sqlList(); 如果要按当前数据库状态预览将要执行的 SQL,可以传入 DataSource 或 Connection。该方法只读取 JDBC 元数据并生成 SQL,不会执行 DDL: List<String> sqlList = DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .sqlList(dataSource); 行为: 表不存在:返回 CREATE TABLE 及附属 DDL 表已存在且是 CREATE 模式:返回空列表 表已存在且是 UPDATE 模式:只返回缺失字段的 ALTER TABLE ... ADD COLUMN ... 及附属 DDL,以及缺失索引的 CREATE INDEX 也可以使用底层构建器生成单个字段的新增列 SQL: import cn.xbatis.ddl.auto.DDLBuilder; import cn.xbatis.ddl.auto.DefaultDDLBuilder; DDLBuilder builder = new DefaultDDLBuilder(); String sql = builder.addColumnSql(DbType.MYSQL, SysUser.class, "email"); 生产或准生产环境建议先通过 sqlList(dataSource) 或 sqlList(connection) 生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 生产或准生产环境建议先通过 sqlList(dataSource) 或 sqlList(connection) 生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 执行失败时抛出的 SQLException 消息也会包含当前失败 SQL 和失败前已执行 SQL。 支持的注解 @Table 用于解析表名和 schema: @Table("sys_user") public class SysUser { } @TableId 用于识别主键和数据库自增: @TableId private Long id; 默认自增类型为 xbatis 的 IdAutoType.AUTO。 单主键会按数据库方言生成自增片段;联合主键不会为每个主键字段自动生成自增片段。 如果主键使用 IdAutoType.SQL 通过数据库序列取值,会从 sql 中解析序列名并在建表前生成 CREATE SEQUENCE: @TableId(dbType = DbType.Name.PGSQL, value = IdAutoType.SQL, sql = "select nextval('id_test_id_seq')") @TableId(dbType = DbType.Name.ORACLE, value = IdAutoType.SQL, sql = "select id_test_seq.NEXTVAL FROM dual") @TableId(dbType = DbType.Name.SQL_SERVER, value = IdAutoType.SQL, sql = "select next value for id_test_sqlserver_seq") @TableId(dbType = DbType.Name.DB2, value = IdAutoType.SQL, sql = "select next value for id_test_db2_seq from sysibm.sysdummy1") private Long id; 当前支持解析 PostgreSQL:nextval('sequence_name') Oracle / DM:sequence_name.NEXTVAL SQL Server / DB2:NEXT VALUE FOR sequence_name 其他数据库:兜底解析上述常见形式,并生成通用序列 DDL: CREATE SEQUENCE my_sequence START WITH 1 INCREMENT BY 1; UPDATE 模式会读取数据库已有序列,只创建缺失序列,不重复创建。 @ColumnDefinition 用于控制建表字段定义: @ColumnDefinition( length = 64, nullable = false, unique = true, comment = "用户名" ) private String username; 常用配置: length:字符串长度 precision:数值精度 scale:小数位数 defaultValue:数据库默认值 SQL 片段 nullable:是否允许为空 unique:是否唯一 definition:字段类型片段,配置后优先替代 Java 类型到数据库类型的自动推导,length、precision、scale、defaultValue、nullable、unique、comment 等其他配置仍会继续生效 comment:字段注释;MySQL 使用列内联 COMMENT,PostgreSQL / Oracle / DM 使用独立 COMMENT ON COLUMN,SQL Server 使用 sys.sp_addextendedproperty 当 definition 本身没有包含括号参数时,会按配置补齐长度或精度,例如 @ColumnDefinition(definition = "VARCHAR", length = 64) 会生成 VARCHAR(64);如果已经写成 VARCHAR(64),则不会再追加参数。 unique = true 目前表示单字段唯一约束: CREATE 模式下,多数关系型数据库使用列内联 UNIQUE UPDATE 模式新增字段时,SQLite 不支持 ALTER TABLE ADD COLUMN ... UNIQUE,会改为先新增字段再生成 CREATE UNIQUE INDEX ClickHouse 不支持传统唯一约束,配置 unique = true 时会直接抛出异常,避免生成无效 SQL 不支持联合唯一、部分唯一索引、命名唯一约束和已存在字段的唯一约束同步 @Index 用于在实体类上声明数据库索引: import cn.xbatis.db.IndexDirection; import cn.xbatis.db.annotations.Index; import cn.xbatis.db.annotations.IndexField; import cn.xbatis.db.annotations.Table; @Index(name = "idx_sys_user_username", fields = @IndexField(name = "username")) @Index( name = "uk_sys_user_username_created_at", unique = true, fields = { @IndexField(name = "username"), @IndexField(name = "createdAt", direction = IndexDirection.DESC) } ) @Table("sys_user") public class SysUser { } 说明: name:索引名;为空时按表名和列名生成稳定索引名 unique:是否唯一索引 fields:索引字段,name 使用实体字段名,也兼容已映射的列名 direction:索引字段排序,支持 ASC、DESC,默认不追加排序片段 CREATE 模式下,建表后生成 CREATE INDEX UPDATE 模式下,只按索引名创建数据库中缺失的索引,不修改或删除已有索引 ClickHouse 不支持传统 CREATE INDEX 时会直接抛出异常,避免生成无效 SQL PostgreSQL 字段注释会生成额外 SQL: COMMENT ON COLUMN sys_user.username IS '用户名'; SQL Server 字段注释会生成扩展属性 SQL: DECLARE @schema sysname = SCHEMA_NAME(); EXEC sys.sp_addextendedproperty @name=N'MS_Description', @value=N'用户名', @level0type=N'SCHEMA', @level0name=@schema, @level1type=N'TABLE', @level1name=N'sys_user', @level2type=N'COLUMN', @level2name=N'username'; 类型映射 默认类型映射包括: String / Character / UUID -> VARCHAR Integer / int -> INTEGER Long / long / BigInteger -> BIGINT Short / short -> SMALLINT Boolean / boolean -> BOOLEAN、MySQL 为 TINYINT(1) BigDecimal -> DECIMAL(precision, scale) Float / Double -> 浮点类型 byte[] -> 二进制大字段 LocalDate -> DATE LocalTime -> TIME,Oracle / DM 使用 TIMESTAMP LocalDateTime / Timestamp / Date -> TIMESTAMP,MySQL 使用 DATETIME,SQL Server 使用 DATETIME2 普通 enum -> VARCHAR(64) 实现 xbatis EnumSupport<T> 的枚举 -> 按 T 的类型映射,例如 EnumSupport<Integer> -> INTEGER 具体类型会根据 DbType 做方言调整。

优秀的个人博客,低调大师

🔥xbatis-ddl-auto 1.0.1 ORM DDL,最强 mybatis ORM DDL

官网https://xbatis.cn xbatis-ddl-auto 是一个基于 xbatis 实体元数据的轻量自动建表工具。 它复用 xbatis 的@Table、@TableId、@TableField、@ColumnDefinition等注解解析结果,根据实体类生成并执行数据库 DDL,提供接近 JPAddl-auto=create/update的使用体验,但不引入 JPA 或 Hibernate。 功能 根据 xbatis 实体生成CREATE TABLESQL 表不存在时自动建表 表存在时可在UPDATE模式下自动追加新增字段 支持只生成 SQL,不执行数据库操作 通过 JDBCDatabaseMetaData判断表、字段和索引是否存在 支持常见 Java 类型到数据库列类型映射 支持@ColumnDefinition配置字段长度、精度、小数位、默认值、唯一约束、非空和字段注释 支持类级@Index创建普通索引和唯一索引 安全边界 UPDATE模式只会自动新增字段和缺失索引,不会自动执行以下高风险操作: 删除数据库已有字段 修改字段类型 修改字段长度 修改字段是否可空 修改默认值 重命名字段 修改或删除已有索引 删除或重建表 这些操作可能造成数据丢失或生产事故,建议通过人工审核 SQL 或专业迁移工具处理。 Maven 本工具 Maven 坐标: <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-ddl-auto</artifactId> <version>1.0.1</version> </dependency> 运行依赖 xbatis core <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-core</artifactId> <version>1.10.6</version> </dependency> 默认测试使用 JUnit 5 和 H2;需要真实数据库的集成测试通过 Maven profile 单独执行。 快速开始 定义 xbatis 实体 import cn.xbatis.db.annotations.ColumnDefinition; import cn.xbatis.db.annotations.Table; import cn.xbatis.db.annotations.TableId; import java.math.BigDecimal; import java.time.LocalDateTime; @Table("sys_user") public class SysUser { @TableId private Long id; @ColumnDefinition(length = 64, nullable = false) private String username; @ColumnDefinition(precision = 10, scale = 2, defaultValue = "0") private BigDecimal balance; private LocalDateTime createdAt; } 执行自动建表: import db.sql.api.DbType; DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); CREATE 模式 CREATE是默认模式: DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行CREATE TABLE 表已存在:跳过,不做任何变更 UPDATE 模式 UPDATE模式用于补新增字段和缺失索引: import cn.xbatis.ddl.auto.Mode; DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行CREATE TABLE 表已存在:读取数据库已有列和索引,只对实体中新增的字段执行ALTER TABLE ... ADD COLUMN ...,并创建缺失索引 重复执行UPDATE模式不会重复添加已存在字段或已存在索引。 只生成 SQL / 预览 SQL 不连接数据库,只生成建表 SQL: List<String> sqlList = DDLAuto.of(DbType.PGSQL) .add(SysUser.class) .sqlList(); 如果要按当前数据库状态预览将要执行的 SQL,可以传入DataSource或Connection。该方法只读取 JDBC 元数据并生成 SQL,不会执行 DDL: List<String> sqlList = DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .sqlList(dataSource); 行为: 表不存在:返回CREATE TABLE及附属 DDL 表已存在且是CREATE模式:返回空列表 表已存在且是UPDATE模式:只返回缺失字段的ALTER TABLE ... ADD COLUMN ...及附属 DDL,以及缺失索引的CREATE INDEX 也可以使用底层构建器生成单个字段的新增列 SQL: import cn.xbatis.ddl.auto.DDLBuilder; import cn.xbatis.ddl.auto.DefaultDDLBuilder; DDLBuilder builder = new DefaultDDLBuilder(); String sql = builder.addColumnSql(DbType.MYSQL, SysUser.class, "email"); 生产或准生产环境建议先通过sqlList(dataSource)或sqlList(connection)生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 生产或准生产环境建议先通过sqlList(dataSource)或sqlList(connection)生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 执行失败时抛出的SQLException消息也会包含当前失败 SQL 和失败前已执行 SQL。 支持的注解 @Table 用于解析表名和 schema: @Table("sys_user") public class SysUser { } @TableId 用于识别主键和数据库自增: @TableId private Long id; 默认自增类型为 xbatis 的IdAutoType.AUTO。单主键会按数据库方言生成自增片段;联合主键不会为每个主键字段自动生成自增片段。 如果主键使用IdAutoType.SQL通过数据库序列取值,会从sql中解析序列名并在建表前生成CREATE SEQUENCE: @TableId(dbType = DbType.Name.PGSQL, value = IdAutoType.SQL, sql = "select nextval('id_test_id_seq')") @TableId(dbType = DbType.Name.ORACLE, value = IdAutoType.SQL, sql = "select id_test_seq.NEXTVAL FROM dual") @TableId(dbType = DbType.Name.SQL_SERVER, value = IdAutoType.SQL, sql = "select next value for id_test_sqlserver_seq") @TableId(dbType = DbType.Name.DB2, value = IdAutoType.SQL, sql = "select next value for id_test_db2_seq from sysibm.sysdummy1") private Long id; 当前支持解析 PostgreSQL:nextval('sequence_name') Oracle / DM:sequence_name.NEXTVAL SQL Server / DB2:NEXT VALUE FOR sequence_name 其他数据库:兜底解析上述常见形式,并生成通用序列 DDL: CREATE SEQUENCE my_sequence START WITH 1 INCREMENT BY 1; UPDATE模式会读取数据库已有序列,只创建缺失序列,不重复创建。 @ColumnDefinition 用于控制建表字段定义: @ColumnDefinition( length = 64, nullable = false, unique = true, comment = "用户名" ) private String username; 常用配置: length:字符串长度 precision:数值精度 scale:小数位数 defaultValue:数据库默认值 SQL 片段 nullable:是否允许为空 unique:是否唯一 definition:字段类型片段,配置后优先替代 Java 类型到数据库类型的自动推导,length、precision、scale、defaultValue、nullable、unique、comment等其他配置仍会继续生效 comment:字段注释;MySQL 使用列内联COMMENT,PostgreSQL / Oracle / DM 使用独立COMMENT ON COLUMN,SQL Server 使用sys.sp_addextendedproperty 当definition本身没有包含括号参数时,会按配置补齐长度或精度,例如@ColumnDefinition(definition = "VARCHAR", length = 64)会生成VARCHAR(64);如果已经写成VARCHAR(64),则不会再追加参数。 unique = true目前表示单字段唯一约束: CREATE模式下,多数关系型数据库使用列内联UNIQUE UPDATE模式新增字段时,SQLite 不支持ALTER TABLE ADD COLUMN ... UNIQUE,会改为先新增字段再生成CREATE UNIQUE INDEX ClickHouse 不支持传统唯一约束,配置unique = true时会直接抛出异常,避免生成无效 SQL 不支持联合唯一、部分唯一索引、命名唯一约束和已存在字段的唯一约束同步 @Index 用于在实体类上声明数据库索引: import cn.xbatis.db.IndexDirection; import cn.xbatis.db.annotations.Index; import cn.xbatis.db.annotations.IndexField; import cn.xbatis.db.annotations.Table; @Index(name = "idx_sys_user_username", fields = @IndexField(name = "username")) @Index( name = "uk_sys_user_username_created_at", unique = true, fields = { @IndexField(name = "username"), @IndexField(name = "createdAt", direction = IndexDirection.DESC) } ) @Table("sys_user") public class SysUser { } 说明: name:索引名;为空时按表名和列名生成稳定索引名 unique:是否唯一索引 fields:索引字段,name使用实体字段名,也兼容已映射的列名 direction:索引字段排序,支持ASC、DESC,默认不追加排序片段 CREATE模式下,建表后生成CREATE INDEX UPDATE模式下,只按索引名创建数据库中缺失的索引,不修改或删除已有索引 ClickHouse 不支持传统CREATE INDEX时会直接抛出异常,避免生成无效 SQL PostgreSQL 字段注释会生成额外 SQL: COMMENT ON COLUMN sys_user.username IS '用户名'; SQL Server 字段注释会生成扩展属性 SQL: DECLARE @schema sysname = SCHEMA_NAME(); EXEC sys.sp_addextendedproperty @name=N'MS_Description', @value=N'用户名', @level0type=N'SCHEMA', @level0name=@schema, @level1type=N'TABLE', @level1name=N'sys_user', @level2type=N'COLUMN', @level2name=N'username'; 类型映射 默认类型映射包括: String/Character/UUID->VARCHAR Integer/int->INTEGER Long/long/BigInteger->BIGINT Short/short->SMALLINT Boolean/boolean->BOOLEAN、MySQL 为TINYINT(1) BigDecimal->DECIMAL(precision, scale) Float/Double-> 浮点类型 byte[]-> 二进制大字段 LocalDate->DATE LocalTime->TIME,Oracle / DM 使用TIMESTAMP LocalDateTime/Timestamp/Date->TIMESTAMP,MySQL 使用DATETIME,SQL Server 使用DATETIME2 普通enum->VARCHAR(64) 实现 xbatisEnumSupport<T>的枚举 -> 按T的类型映射,例如EnumSupport<Integer>->INTEGER 具体类型会根据DbType做方言调整。

优秀的个人博客,低调大师

Django ORM model 操作

from django.db.models import Q,F from user.models import Users 数据基础操作包括增删查改,常用的过滤属性,Q,F库的使用,外键的反向查询 _set() class Users(models.Model): nickname = models.CharField('昵称', max_length=256, null=True) head_portrait = models.CharField('头像', max_length=256, null=True) appkey = models.CharField('appkey', max_length=256, null=True) status = models.CharField('状态', max_length=1, choices=STATUS_CHOICES, default='e') create_date = models.DateTimeField('创建时间', auto_now_add=True) update_date = models.DateTimeField('更新时间', auto_now=True) user = models.ForeignKey('auth.user', verbose_name='用户', null=True, on_delete=models.SET_NULL) class Branch(models.Model): name = models.CharField('公司名称', max_length=128, null=True) code = models.CharField('公司编码', max_length=64, null=True) logo = models.CharField('公司logo', max_length=256, null=True) invitation_code = models.CharField('邀请码', max_length=128, null=True) website = models.CharField('公司网站', max_length=128, null=True) address = models.CharField('地址', max_length=128, null=True) telephone = models.CharField('公司联系电话', max_length=32, null=True) introduction = models.TextField('公司简介', null=True) status = models.CharField('状态', max_length=1, choices=STATUS_CHOICES, default='e') create_date = models.DateTimeField('创建时间', auto_now_add=True) update_date = models.DateTimeField('更新时间', auto_now=True) users = models.ManyToManyField('Users', verbose_name='昵称', null=True, blank=True) # 增加 save users = Users( user_account=user_account, org_id=org ) users.save() # 删除 delete Users.objects.filter(id=user_id).delete() # 修改 update Users.objects.filter(id=user_id).update( user_account=user_account, org_id=org ) # 查询 # 检索记录 get #get获取单个符合条件的记录,没找到或者超过一个都会抛出异常 user = Users.objects.get(id=10) # 检索所有的记录 all user = Users.objects.all() #取前5个 Users.objects.all()[:5] #取第五个到第十个 Users.objects.all()[5:10] # 检索第一条记录 first user = Users.objects.first() # 检索记录条数 count user = Users.objects.count() # 检索记录排序 order_by user = Users.objects.order_by(‘id’) user = Users.objects.order_by(‘id’)[0:1] # 如果需要逆序 在字段前加负号 例 (‘-id’) # 检索记录特定字段 values user = Users.objects.values('id', 'nickname').all() # 返回 指定字段的数据列表 # 这里也可以指定外键字段 使用双下划线指定,返回的键值与values中的参数一致 # 检索记录特定字段 values user = Users.objects.values_list('id', flat=True).all() # 返回 id 列表 # 这里也可以指定外键字段 使用双下划线指定,返回的键值与values中的参数一致 # 条件查询exclude #和filter相反,查找不符合条件的那些记录 # 条件查询 filter # 或条件查询 user = Users.objects.filter(Q(nickname='qxt_common') | Q(nickname=u'系统管理员')).all() # 非条件查询 user = Users.objects.filter(~Q(nickname='administrator')).all() user = Users.objects.exclude(nickname='administrator').all() # 字段名加关键字 例:filter(id__gt='10') # id 大于10 常用的过滤属性 __exact 精确等于 like 'aaa' __iexact 精确等于 忽略大小写 ilike 'aaa' __contains 包含 like '%aaa%' __icontains 包含 忽略大小写 ilike '%aaa%',但是对于sqlite来说,contains的作用效果等同于icontains。 __gt 大于 __gte 大于等于 __lt 小于 __lte 小于等于 __in 存在于一个list范围内 __startswith 以...开头 __istartswith 以...开头 忽略大小写 __endswith 以...结尾 __iendswith 以...结尾,忽略大小写 __range 在...范围内 __year 日期字段的年份 __month 日期字段的月份 __day 日期字段的日 __isnull=True/False __isnull=True 与 __exact=None的区别 # Q # 或 条件查询 user = Users.objects.filter(Q(nickname='qxt_common') | Q(nickname=u'系统管理员')).all() # 非条件查询 user = Users.objects.filter(~Q(nickname='administrator')).all() # F # 例如我们有个统计点击量的字段,每次更新的操作其实就是把字段的值加1. # 一般我们的做法是把这条记录取出来,把相应字段加+1,然后在save: articles = Article.objects.filter(id=self.product_id).first() articles.likes += 1 articles.save() # 使用 F 改写: Article.objects.filter(id=self.product_id).update(likes=F('likes') + 1) # 外键反向查询 # 一对多外键,多对多外键反向查询方法一致 users = Users.objects.all() users.branch_set.all() # 反查 branchs = Branch.objects.all() branchs.users.all() # 正查 # 一对多外键绑定 # 可使用 外键对象,也可以使用外键id直接绑定 # 多对多外键绑定 branchs.users.add(users_obj) branchs.users.add(users_id) # 多对多外键删除 branchs.users.remove(users_obj) branchs.users.remove(users_id) # 多对多删除所有外键 branchs.users.clear() # 批量插入 users_list = [] users_list.append(Users(nickname='11')) users_list.append(Users(nickname='22')) users_list.append(Users(nickname='33')) Users.objects.bulk_create(users_list) distinct 去重 如果需要就一次性取出你所需要的数据 单一动作(如:同一个页面)需要多次连接数据库时,最好一次性取出所有需要的数据,减少连接数据库次数。此类需求推荐使用QuerySet.select_related() 和 prefetch_related() 相反,别取出你不需要的东西,模版templates里往往只需要实体的某几个字段而不是全部,这时QuerySet.values() 和 values_list(),对你有用,它们只取你需要的字段,返回字典dict和列表list类型的东西,在模版里够用即可,这可减少内存损耗,提高性能 同样QuerySet.defer()和only()对提高性能也有很大的帮助,一个实体里可能有不少的字段,有些字段包含很多元数据,比如博客的正文,很多字符组成,Django获取实体时(取出实体过程中会进行一些python类型转换工作),我们可以延迟大量元数据字段的处理,只处理需要的关键字段,这时QuerySet.defer()就派上用场了,在函数里传入需要延时处理的字段即可;而only()和defer()是相反功能 使用QuerySet.count()代替len(queryset),虽然这两个处理得出的结果是一样的,但前者性能优秀很多。同理判断记录存在时,QuerySet.exists()比if queryset实在强得太多了 推荐文章: https://www.sitepoint.com/doing-more-with-your-django-models/
优秀的个人博客,低调大师

sagacity-sqltoy 睿智 ORM 5.1.3、4.18.42 发版,真正睿智的 ORM

开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件(可直接在idea中检索安装):https://github.com/threefish/sqltoy-idea-plugins 更新内容 1、增加获取数据库表信息和表字段信息功能 //用法:getTableColumns(null, null, "SYS_STAFF_INFO") public List<ColumnMeta> getTableColumns(final String catalog, final String schema, final String tableName); //用法:getTables(null, null, "%") public List<TableMeta> getTables(final String catalog, final String schema, final String tableName); sqltoy的关键优势: //------------------了解 sqltoy的关键优势: -------------------------------------------------------------------------------------------*/ //1、最简最直观的sql编写方式(不仅仅是查询语句),采用条件参数前置处理规整法,让sql语句部分跟客户端保持高度一致 //2、sql中支持注释(规避了对hint特性的影响,知道hint吗?搜oracle hint),和动态更新加载,便于开发和后期维护整个过程的管理 //3、支持缓存翻译和反向缓存条件检索(通过缓存将名称匹配成精确的key),实现sql简化和性能大幅提升 //4、支持快速分页和分页优化功能,实现分页最高级别的优化,同时还考虑到了cte多个with as情况下的优化支持 //5、支持并行查询 //6、根本杜绝sql注入问题 //7、支持行列转换、分组汇总求平均、同比环比计算,在于用算法解决复杂sql,同时也解决了sql跨数据库问题 //8、支持保留字自动适配 //9、支持跨数据库函数自适配,从而非常有利于一套代码适应多种数据库便于产品化,比如oracle的nvl,当sql在mysql环境执行时自动替换为ifnull //10、支持分库分表 //11、提供了取top、取random记录、树形表结构构造和递归查询支持、updateFetch单次交互完成修改和查询等实用的功能 //12、sqltoy的update、save、saveAll、load 等crud操作规避了jpa的缺陷,参见update(entity,String...forceUpdateProps)和updateFetch //13、提供了极为人性化的条件处理:排它性条件、日期条件加减和提取月末月初处理等 //14、提供了查询结果日期、数字格式化、安全脱敏处理,让复杂的事情变得简单,大幅简化sql或结果的二次处理工作 //-----------------------------------------------------------------------------------*/ sqltoy特点介绍: JPA式的crud是基本共识,但sqltoy改进了update,增加了updateFetch sqltoy的update、updateAll,弹性设置强制修改属性,一次性数据库交互,解决并发问题 /** * @todo 修改数据并返回数据库记录变更数量(非强制修改属性,当属性值为null不参与修改) * @param entity * @param forceUpdateProps 强制修改的字段属性 * @return Long 数据库记录变更量(插入数据量) */ public Long update(Serializable entity, String... forceUpdateProps); /** * @TODO 批量修改操作,并可以指定强制修改的属性(非强制修改属性,当属性值为null不参与修改) * @param <T> * @param entities * @param forceUpdateProps * @return Long 数据库记录变更量(插入数据量) */ public <T extends Serializable> Long updateAll(List<T> entities, String... forceUpdateProps); //保存或修改数据并返回数据库记录变更数量 public Long saveOrUpdate(Serializable entity, String... forceUpdateProps); updateFetch: 一次交互完成锁查询、修改,并返回修改后的结果,尤其适用于库存台账、资金台账场景 // sqltoy的updateFetch是jpa没有的,可以深入了解其原理,一次交互完成查询、锁定、修改并返回修改后结果 /** * @todo 获取并锁定数据并进行修改(只支持针对单表查询,查询语句要简单) * @param queryExecutor * @param updateRowHandler * @return */ public List updateFetch(final QueryExecutor queryExecutor, final UpdateRowHandler updateRowHandler); sqltoy最佳sql编写模式,便于开发和后期维护 sqltoy的缓存翻译,大幅减少表关联简化sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast() 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成1.3~1.5次(用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy的分页取总记录的过程不是简单的select count(1) from (原始sql);而是智能判断是否变成:select count(1) from 'from后语句', 并自动剔除最外层的order by sqltoy支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计(含汇总求平均) 便利的跨数据库统计计算:同比环比

优秀的个人博客,低调大师

sagacity-sqltoy 睿智 ORM 5.1.2、4.18.41 发版,真正睿智的 ORM!

开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件(可直接在idea中检索安装):https://github.com/threefish/sqltoy-idea-plugins 更新内容 1、修复updateSaveFetch锁查询、修改(不存在则插入)、并返回修改后结果功能在复合主键场景下的bug 2、修复sqlite数据库identity主键策略insert的缺陷 3、优化saveOrUpdate,增加当主键值为null时直接走save操作 updateSaveFetch特点: /** * @TODO 适用于库存台账、客户资金账等高并发强事务场景,一次数据库交互实现: * <p> * <li>1、锁查询;</li> * <li>2、记录存在则修改;</li> * <li>3、记录不存在则执行insert;</li> * <li>4、返回修改或插入的记录信息</li> * </p> * @param <T> * @param entity 尽量不要使用identity、sequence主键 * @param updateRowHandler * @param uniqueProps 唯一性字段,用于做唯一性检索,不设置则按照主键进行查询 * @return */ public <T extends Serializable> T updateSaveFetch(final T entity, final UpdateRowHandler updateRowHandler,final String... uniqueProps); //使用方法范例 public TransLedgerVO updateSaveTrans(TransLedgerVO transVO) { return sqlToyLazyDao.updateSaveFetch(transVO, new UpdateRowHandler() { @Override public void updateRow(ResultSet rs, int index) throws Exception { // 一般updateFetch会依托表中的现有值做一些逻辑处理,否则可以直接update rs.updateInt("QUANTITY", rs.getInt("QUANTITY") + transVO.getQuantity()); rs.updateBigDecimal("AMT", rs.getBigDecimal("AMT").add(transVO.getAmt())); } }, "orderId"); } sqltoy的关键优势: //------------------了解 sqltoy的关键优势: -------------------------------------------------------------------------------------------*/ //1、最简最直观的sql编写方式(不仅仅是查询语句),采用条件参数前置处理规整法,让sql语句部分跟客户端保持高度一致 //2、sql中支持注释(规避了对hint特性的影响,知道hint吗?搜oracle hint),和动态更新加载,便于开发和后期维护整个过程的管理 //3、支持缓存翻译和反向缓存条件检索(通过缓存将名称匹配成精确的key),实现sql简化和性能大幅提升 //4、支持快速分页和分页优化功能,实现分页最高级别的优化,同时还考虑到了cte多个with as情况下的优化支持 //5、支持并行查询 //6、根本杜绝sql注入问题 //7、支持行列转换、分组汇总求平均、同比环比计算,在于用算法解决复杂sql,同时也解决了sql跨数据库问题 //8、支持保留字自动适配 //9、支持跨数据库函数自适配,从而非常有利于一套代码适应多种数据库便于产品化,比如oracle的nvl,当sql在mysql环境执行时自动替换为ifnull //10、支持分库分表 //11、提供了取top、取random记录、树形表结构构造和递归查询支持、updateFetch单次交互完成修改和查询等实用的功能 //12、sqltoy的update、save、saveAll、load 等crud操作规避了jpa的缺陷,参见update(entity,String...forceUpdateProps)和updateFetch //13、提供了极为人性化的条件处理:排它性条件、日期条件加减和提取月末月初处理等 //14、提供了查询结果日期、数字格式化、安全脱敏处理,让复杂的事情变得简单,大幅简化sql或结果的二次处理工作 //-----------------------------------------------------------------------------------*/ sqltoy特点介绍: JPA式的crud是基本共识,但sqltoy改进了update,增加了updateFetch sqltoy的update、updateAll,弹性设置强制修改属性,一次性数据库交互,解决并发问题 /** * @todo 修改数据并返回数据库记录变更数量(非强制修改属性,当属性值为null不参与修改) * @param entity * @param forceUpdateProps 强制修改的字段属性 * @return Long 数据库记录变更量(插入数据量) */ public Long update(Serializable entity, String... forceUpdateProps); /** * @TODO 批量修改操作,并可以指定强制修改的属性(非强制修改属性,当属性值为null不参与修改) * @param <T> * @param entities * @param forceUpdateProps * @return Long 数据库记录变更量(插入数据量) */ public <T extends Serializable> Long updateAll(List<T> entities, String... forceUpdateProps); //保存或修改数据并返回数据库记录变更数量 public Long saveOrUpdate(Serializable entity, String... forceUpdateProps); updateFetch: 一次交互完成锁查询、修改,并返回修改后的结果,尤其适用于库存台账、资金台账场景 // sqltoy的updateFetch是jpa没有的,可以深入了解其原理,一次交互完成查询、锁定、修改并返回修改后结果 /** * @todo 获取并锁定数据并进行修改(只支持针对单表查询,查询语句要简单) * @param queryExecutor * @param updateRowHandler * @return */ public List updateFetch(final QueryExecutor queryExecutor, final UpdateRowHandler updateRowHandler); sqltoy最佳sql编写模式,便于开发和后期维护 sqltoy的缓存翻译,大幅减少表关联简化sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast() 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成1.3~1.5次(用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy的分页取总记录的过程不是简单的select count(1) from (原始sql);而是智能判断是否变成:select count(1) from 'from后语句', 并自动剔除最外层的order by sqltoy支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计(含汇总求平均) 便利的跨数据库统计计算:同比环比

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册