首页 文章 精选 留言 我的

精选列表

搜索[弹性扩展],共10008篇文章
优秀的个人博客,低调大师

Serverless Spark的弹性利器 - EMR Shuffle Service

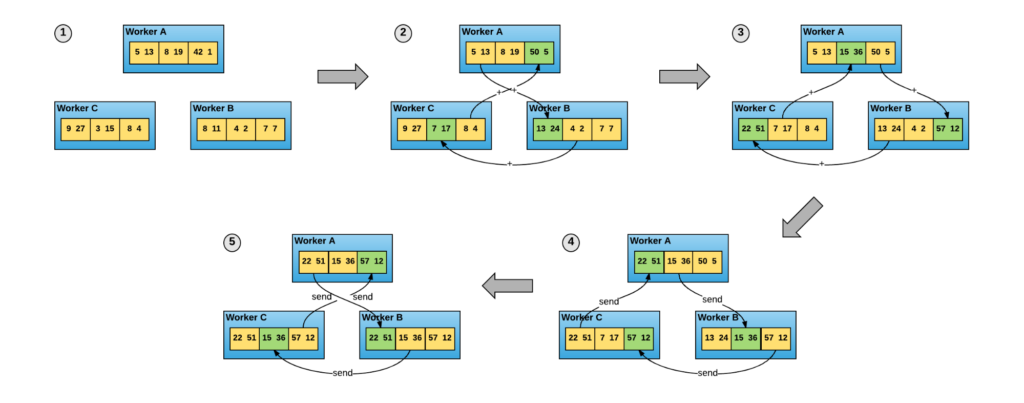
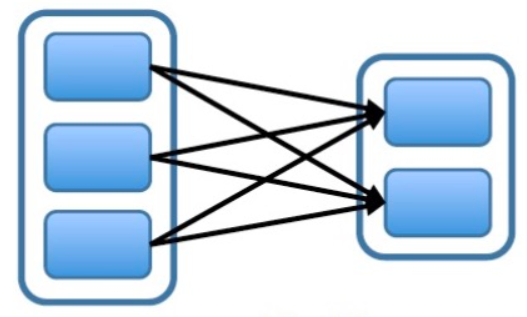
背景与动机 计算存储分离下的刚需 计算存储分离是云原生的重要特征。通常来讲,计算是CPU密集型,存储是IO密集型,他们对于硬件配置的需求是不同的。在传统计算存储混合的架构中,为了兼顾计算和存储,CPU和存储设备都不能太差,因此牺牲了灵活性,提高了成本。在计算存储分离架构中,可以独立配置计算机型和存储机型,具有极大的灵活性,从而降低成本。 存储计算分离是新型的硬件架构,但以往的系统是基于混合架构设计的,必须进行改造才能充分利用分离架构的优势,甚至不改造的话会报错,例如很多系统假设本地盘足够大,而计算节点本地盘很小;再例如有些系统在Locality上的优化在分离架构下不再适用。Spark Shuffle就是一个典型例子。众所周知,Shuffle的过程如下图所示。 每个mapper把全量shuffle数据按照partitionId排序后写本地文件,同时保存索引文件记录每个partition的offset和length。reduce task去所有的map节点拉取属于自己的shuffle数据。大数据场景T级别的shuffle数据量很常见,这就要求本地磁盘足够大,导致了跟计算存储分离架构的冲突。因此,需要重构传统的shuffle过程,把shuffle数据卸载到存储节点。 稳定性和性能 除了计算存储分离架构下的刚需,在传统的混合架构下,目前的shuffle实现也存在重要缺陷: 大量的随机读写和小数据量的网络传输。考虑1000 mapper * 2000 reducer的stage,每个mapper写128M shuffle数据,则属于每个reduce的数据量约为64k。从mapper的磁盘角度,每次磁盘IO请求随机读64K的数据; 从网络的角度,每次网络请求传输64k的数据:都是非常糟糕的pattern,导致大量不稳定和性能问题。因此,即使在混合架构下,重构shuffle也是很必要的工作。 EMR Shuffle Service设计 基于以上的动机,阿里云EMR团队设计开发了EMR Shuffle Service服务(以下称ESS),同时解决了计算存储分离和混合架构下的shuffle稳定性和性能问题。 整体设计 ESS包含三个主要角色: Master, Worker, Client。其中Master和Worker构成服务端,Client以不侵入方式集成到Spark里。Master的主要职责是资源分配和状态管理;Worker的主要职责是处理和存储shuffle数据;Client的主要职责是缓存和推送shuffle数据。整体流程如下所示(其中ResourceManager和MetaService是Master的组件): ESS采用Push Style的shuffle模式,每个Mapper持有一个按Partition分界的缓存区,Shuffle数据首先写入缓存区,每当某个Partition的缓存满了即触发PushData。 在PushData触发之前Client会检查本地是否有PartitionLocation信息,该Location规定了每个Partition的数据应该推送的Worker地址。若不存在,则向Master发起getOrAllocateBuffers请求。Master收到后检查是否已分配,若未分配则根据当前资源情况选择互为主从的两个Worker并向他们发起AllocateBuffer指令。Worker收到后记录Meta并分配内存缓存。Master收到Worker的ack之后把主副本的Location信息返回给Client。 Client开始往主副本推送数据。主副本Worker收到请求后,把数据缓存到本地内存,同时把该请求以Pipeline的方式转发给从副本。从副本收到完整数据后立即向主副本发ack,主副本收到ack后立即向Client回复ack。 为了不block PushData的请求,Worker收到PushData请求后会先塞到一个queue里,由专有的线程池异步处理。根据该Data所属的Partition拷贝到事先分配的buffer里,若buffer满了则触发flush。ESS支持多种存储后端,包括DFS和local。若后端是DFS,则主从副本只有一方会flush,依靠DFS的双副本保证容错;若后端是Local,则主从双方都会flush。 在所有的Mapper都结束后,Master会触发StageEnd事件,向所有Worker发送CommitFiles请求,Worker收到后把属于该Stage的buffer里的数据flush到存储层,close文件,并释放buffer。Master收到所有ack后记录每个partition对应的文件列表。若CommitFiles请求失败,则Master标记此Stage为DataLost。 在Reduce阶段,reduce task首先向Master请求该Partition对应的文件列表,若返回码是DataLost,则触发Stage重算或直接abort作业。若返回正常,则直接读取文件数据。 ESS的设计要点,一是采用PushStyle的方式做shuffle,避免了本地存储,从而适应了计算存储分离架构;二是按照reduce做了聚合,避免了小文件随机读写和小数据量网络请求;三是做了两副本,提高了系统稳定性。 容错 除了双副本和DataLost检测,ESS在容错上做了很多事情保证正确性。 PushData失败 当PushData失败次数(Worker挂了,网络繁忙,CPU繁忙等)超过MaxRetry后,Client会给Master发消息请求新的Partition Location,此后本Client都会使用新的Location地址。 若Revive是因为Client端而非Worker的问题导致,则会产生同一个Partition数据分布在不同Worker上的情况,Master的Meta组件会正确处理这种情形。 若发生WorkerLost,则会导致大量PushData同时失败,此时会有大量同一Partition的Revive请求打到Master。为了避免给同一个Partition分配过多的Location,Master保证仅有一个Revive请求真正得到处理,其余的请求塞到pending queue里,待Revive处理结束后返回同一个Location。 WorkerLost 当发生WorkerLost时,对于该Worker上的副本数据,Master向其peer发送CommitFile的请求,然后清理peer上的buffer。若Commit Files失败,则记录该Stage为DataLost;若成功,则后续的PushData通过Revive机制重新申请Location。 数据冗余 Speculation task和task重算会导致数据重复。解决办法是每个PushData的数据片里encode了所属的mapId,attemptId和batchId,并且Master为每个map task记录成功commit的attemtpId。read端通过attemptId过滤不同的attempt数据,并通过batchId过滤同一个attempt的重复数据。 ReadPartition失败 在DFS模式下,ReadPartition失败会直接导致Stage重算或abort job。在Local模式,ReadPartition失败会触发从peer location读,若主从都失败则触发Stage重算或abort job。 多backend支持 ESS目前支持DFS和Local两种存储后端。 跟Spark集成 ESS以不侵入Spark代码的方式跟Spark集成,用户只需把我们提供的Shuffle Client jar包配置到driver和client的classpath里,并加入以下配置即可切换到ESS方式: spark.shuffle.manager=org.apache.spark.shuffle.ess.EssShuffleManager 监控报警我们对ESS服务端进行了较为详尽的监控报警并对接了Prometheus和Grafana,如下所示: 性能数字 TeraSort的性能数字如下(2T, 4T, 10T规模): 10T规模TPC-DS的性能数字如下:

优秀的个人博客,低调大师

弹性计算双周刊 第 25 期

【重点关注】阿里云GPU云服务器现已支持NVIDIA RAPIDS加速库,是国内第一家提供RAPIDS加速库服务的公有云厂商RAPIDS,全称Real-time Acceleration Platform for Integrated Data Science,是NVIDIA针对数据科学和机器学习推出的一套开源GPU加速库,基于CUDA-X AI打造,可加速数据准备、模型训练和图分析。使用RAPIDS加速库可以实现从数据准备、模型训练到预测整个端到端流程得到GPU的加速支持,大大提升任务的执行效率,在模型精度方面实现突破的同时降低基础架构TCO。 专有宿主机DDH提供“自动部署”能力,实现云上独占资源池,提升集群部署效率在专有宿主机上创建ECS实例时,用户获得了指定宿主机创建实例的自由。当具有多台宿主机的时候,通过宿主机“允许自动部

优秀的个人博客,低调大师

基于 Kubernetes 实践弹性的 CI/CD 系统

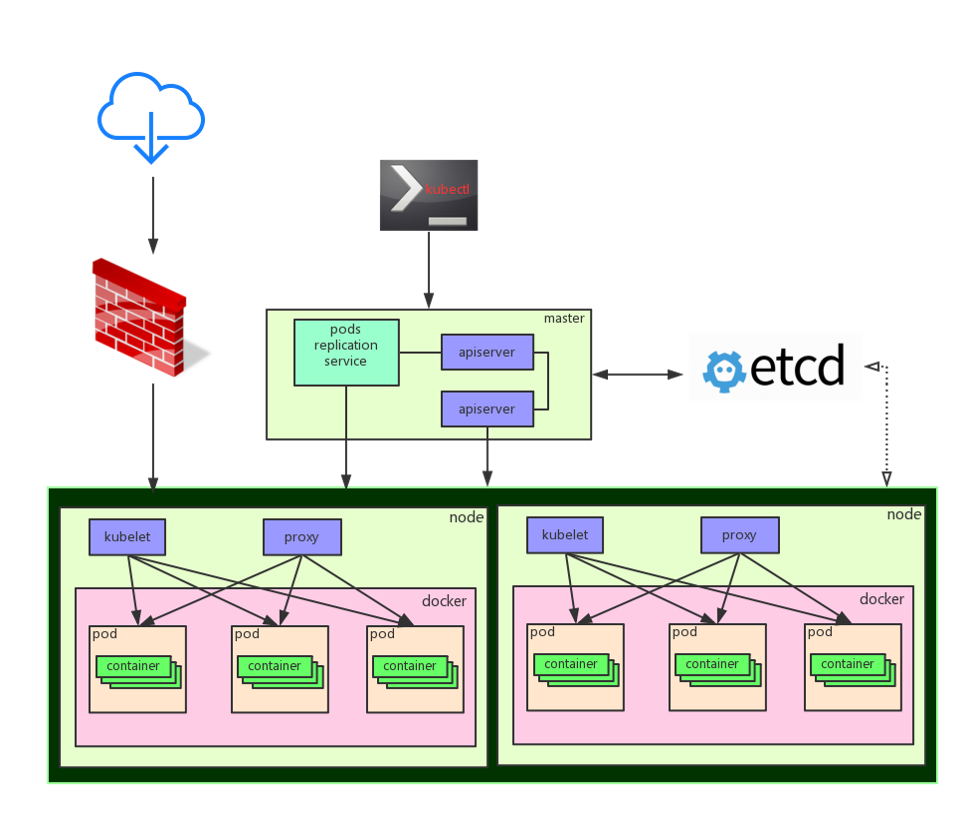
大家好,我是来自阿里云容器服务团队的华相。首先简单解释一下何为 Kubernetes 来帮助大家理解。Kuberentes 是一个生产可用的容器编排系统。Kuberentes 一方面在集群中把所有 Node 资源做一个资源池,然后它调度的单元是 Pod,当然 Pod 里面可以有多个容器。 就像一个人左手抓着 ECS 资源或计算资源,右手抓容器,然后把它们两个匹配起来,这样它就可以作为一个容器的编排系统。而Cloudnative 这个概念现在会经常被大家提起,很多人迷惑 Cloudnative 又与 Kuberentes 有什么关联?我们又该如何判断一个应用是 Cloudnative 呢?我认为有以下三个判断标准:第一,它能够给资源做池化;第二,应用可以快速接入池的网络。在 Kuberentes 里面有一层自己的独立网络,然后只需

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册