首页 文章 精选 留言 我的

精选列表

搜索[开发者常备桌面小工具],共10002篇文章
优秀的个人博客,低调大师

简单介绍我的开源小工具:SanicDB

SanicDB 是为 Python的异步 Web 框架 Sanic 方便操作MySQL而开发的工具,是对 aiomysql.Pool 的轻量级封装。Sanic 是异步IO的Web框架,同时用异步IO读写MySQL才能更大发挥它的效率。虽然这个模块叫做 SanicDB,但是它可以用在任何异步IO操作MySQL的地方。 SanicDB的灵感来源于tornado里面的对MySQLdb(MySQL的C语言接口的Python封装)的操作,后来tornado把它去除了,就有人把这部分代码写成一个单独的模块叫做 torndb,torndb是对python-mysql的封装,不能进行异步操作。但是它很简洁,用起来已经非常习惯了。 在用Sanic的时候,发现有异步IO的aiomysql可以用,但是用起来还有点麻烦,于是就着手对aiomysql进行封装,既然aiomysql支持连接池,那就直接封装aiomysql.Pool吧。 代码仓库: https://github.com/veelion/sanicdb 首先,看看它的初始化 class SanicDB: """A lightweight wrapper around aiomysql.Pool for easy to use """ def __init__(self, host, database, user, password, loop=None, sanic=None, minsize=3, maxsize=5, return_dict=True, pool_recycle=7*3600, autocommit=True, charset = "utf8mb4", **kwargs): ''' 前面4个参数是对应数据库的; loop 是你的应用程序中的事件循环(event_loop); sanic 是你的Sanic 应用中的sanic 对象; loop 和 sanic 两者只需提供一个即可,当同时存在时,连接数据库其实用的是sanic里面的loop,这在__init__()代码中可以看到。 minisize 和 maxsize 是连接池的个数限制; return_dict 是返回的数据一条记录为一个dict,key是MySQL表的字段名,value是字段的值; pool_recycle 是连接池重连的时间间隔,MySQL默认的连接闲置时间是8小时; 对MySQL的读写操作方法: async def query(self, query, parameters, *kwparameters): async def execute(self, query, parameters, *kwparameters):async def get(self, query, parameters, *kwparameters): 从代码中可以看到,以上三个函数都是调用的cursor的execute() 执行 SQL 命令,但是query(), get() 用于读操作返回数据,query返回全部数据(list),get只返回一条数据。 execute() 方法用来执行写操作,返回受影响的行ID。 上面三个函数都是一样的: query 是要执行的SQL语句, 后面两个参数是用来参数化执行sql语句的。参数化执行sql是为了防止SQL注入的,那么参数化执行SQL是什么意思呢,举个例子就目标了。 比如,进行用户登录时,我们要执行一条SQL,Python拼接SQL如下: sql = "select * from user where name='%s' and password='%s'" % (input_name, input_password) input_name 和 input_password 都是用户输入的,如果用户想捣鬼,他把input_name 输入成 “ ‘ or 1 = 1 –”,拼接出来的sql就成了: select * from user where name='' or 1 = 1 --' and password='anything' or 后面的 1=1 就是True,而 — 后面都成了注释,这条语句不管input_name, input_password 是什么都可以执行,通过用户验证,达到了注入目的。 参数化执行SQL就是把拼接SQL的任务交给SanicDB(实际上是它后的aiomysql后面的pymysql),我们只把要拼接的参数当做*parameters传给读写方法即可: mydb.query("select * from user where user=%s and password=%s", input_name, input_password) 更高级的封装: query(), get(), execute() 就是基本的操作,在此基础上,做了进一步封装,让写应用更方便: # 检查一个table中是否含有某字段为某值的记录 async def table_has(self, table_name, field, value): # 把一个item插入一个表,item为dict,key是字段名, # ignore_duplicated为True时,遇到唯一索引重复时不报错 async def table_insert(self, table_name, item, ignore_duplicated=True): # 更新一个table的记录,updates是dict,key为字段名 async def table_update(self, table_name, updates, field_where, value_where): 示例 代码仓库中有两个示例: test.py 是在普通asyncio程序中使用异步MySQL的例子 example.py 是在Sanic Web中使用的例子 特别说明一下,Sanic 对象 app 中还没有生成 event_loop 对象(它是在app.run() 之后生成的),所以在Sanic中初始化SanicDB时(app.run())之前,运行sql语句会报错。如果需要创建连接后初始化运行一些SQL操作,可以利用Sanic的Listner: @app.listener('before_server_start') async def setup_db(app, loop): app.db = await db_setup() **更多技术文章欢迎访问我的个人博客猿人学也可关注公众号:猿人学Python 。有更多拓宽Python知识视野的文章**
优秀的个人博客,低调大师

Hadoop2.6.0配置参数查看小工具

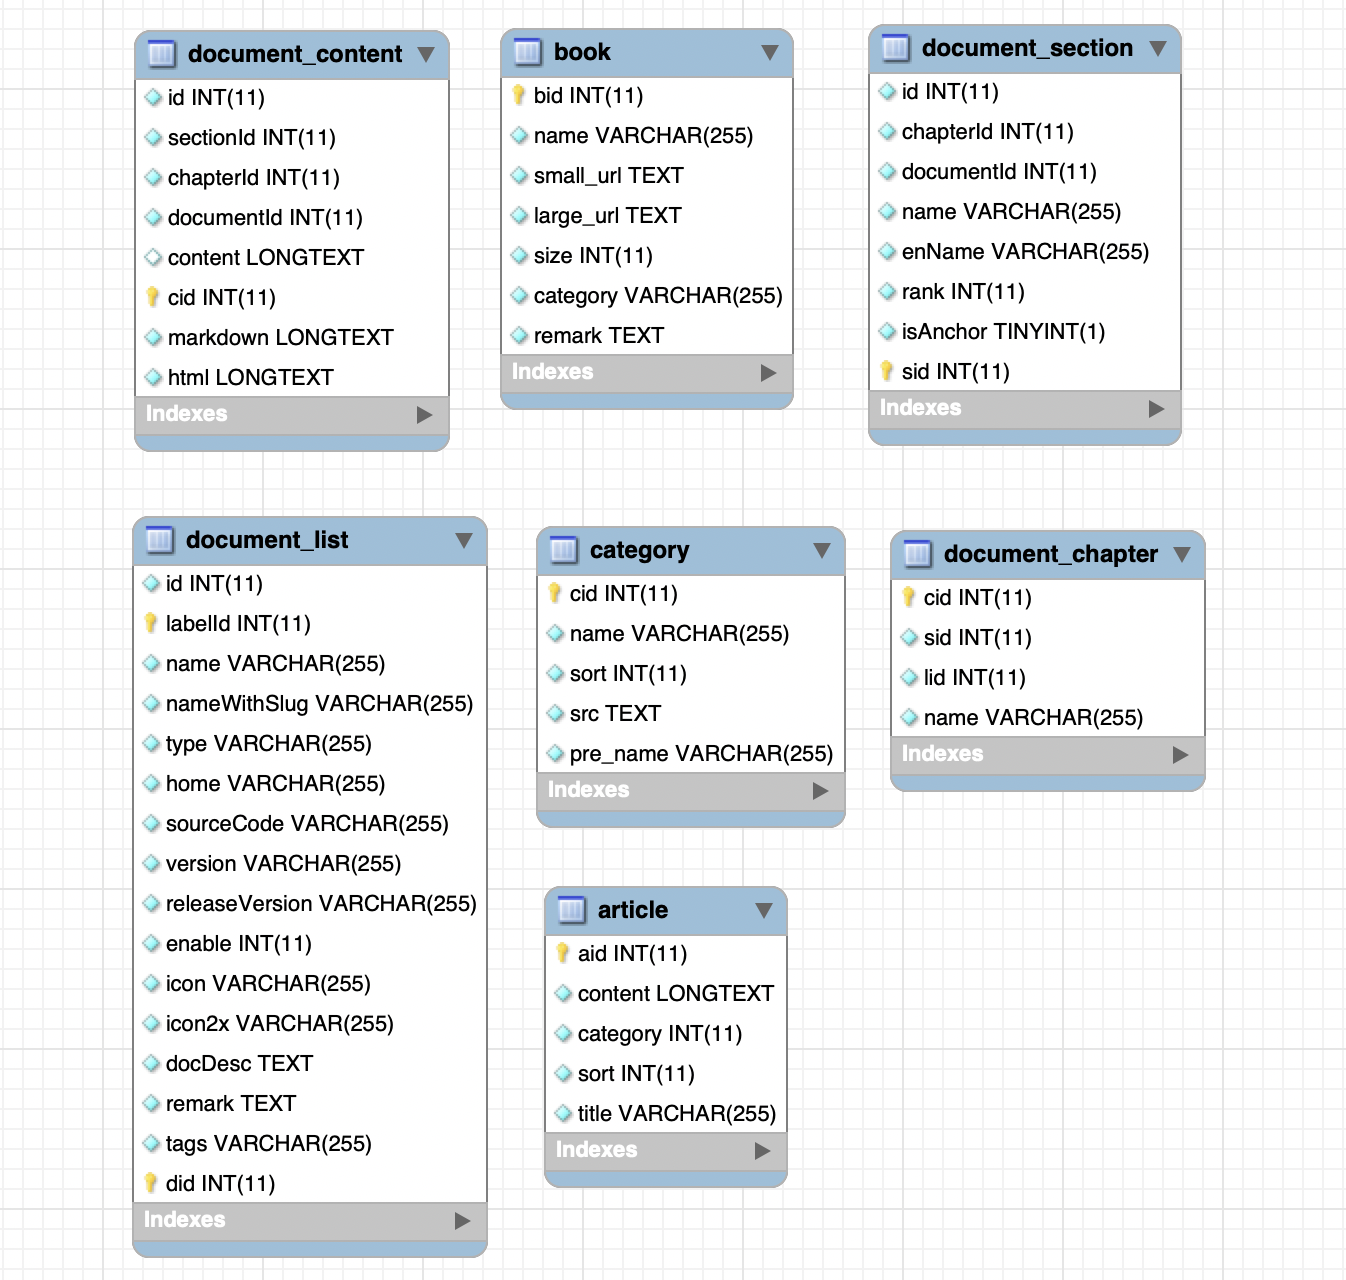
版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/beliefer/article/details/51145397 前言 使用Hadoop进行离线分析或者数据挖掘的工程师,经常会需要对Hadoop集群或者mapreduce作业进行性能调优。也许你知道通过浏览器访问http://master:18088/conf来查看配置信息,如下图所示: 但是当Linux工程师们只面对命令行时,如何查看呢?而且如果运维工程师根据集群状况及运行历史使用shell、Python、ruby等脚本写些运维代码,甚至动态调整集群参数时,该怎么办呢?性能调优的前提是需要能准确知道目前针对Hadoop集群或者mapreduce作业配置的参数。在MySQL中可以通过以下命令查询参数值: SHOW VARIABLES LIKE 'some_parameter'也可以使用以下命令查询参数值: SELECT @@session.some_parameter SELECT @@global.some_parameter或者直接查询information_schema.GLOBAL_VARIABLES得到参数值。 可惜的是Hadoop没有提供类似的方式,这对于在Linux系统下查看参数进而修改参数增加了成本和负担。尽管我们可以 本文将针对这一需求,基于Hadoop开发一个简单实用的工具查询查看各种参数。 准备工作 首先在Hadoop集群的Master节点的个人目录下创建workspace目录用于存储开发的Hadoop应用代码,命令如下: mkdir workspace进入workspace目录,开始编辑HadoopConfDisplay.java代码: 为便于大家使用,我把代码都列出来,这其实也是借鉴了网上别人的一些内容: import java.util.Map.Entry; import org.apache.hadoop.conf.*; import org.apache.hadoop.util.*; public class HadoopConfDisplay extends Configured implements Tool { static { Configuration.addDefaultResource("core-site.xml"); Configuration.addDefaultResource("hdfs-site.xml"); Configuration.addDefaultResource("mapred-site.xml"); Configuration.addDefaultResource("yarn-site.xml"); } @Override public int run(String[] args) throws Exception { Configuration conf = getConf(); for (Entry<String, String> entry: conf) { System.out.printf("%s=%s\n", entry.getKey(), entry.getValue()); } return 0; } public static void main(String[] args) throws Exception { int exitCode = ToolRunner.run(new HadoopConfDisplay(), args); System.exit(exitCode); } } 在Hadoop的根目录下创建myclass,此目录用于存储个人开发的Hadoop应用代码编译后的class或者jar包。我本地的目录为/home/jiaan.gja/install/hadoop-2.6.0/myclass/ 由于HadoopConfDisplay中使用了hadoop-common-2.6.0.jar中的类,所以编译HadoopConfDisplay.java时需要指定classpath。同时将编译后的class输出到/home/jiaan.gja/install/hadoop-2.6.0/myclass/目录下。执行命令如下: 进入myclass目录,将编译好的HadoopConfDisplay的class打到jar包里: jar cvf mytest.jar *执行过程如下: 成果验证 经过以上准备,最终我们生成了mytest.jar包文件,现在到了验证输出Hadoop配置参数的时候。输入以下命令: hadoop jar mytest.jar HadoopConfDisplay输出结果如下图: 由于参数的确很多,这里只展示了其中的一部分信息。这里显示的信息虽然很多,可是会发现很多参数并没有包括进来,比如: mapreduce.job.ubertask.enable mapreduce.job.ubertask.maxreduces mapreduce.job.ubertask.maxmaps 完善 还记得本文刚开始说的通过web界面查看Hadoop集群参数的内容吗?我在我个人搭建的集群(有关集群的搭建可以参照《Linux下Hadoop2.6.0集群环境的搭建》)上访问http://master:18088/conf页面时,可以找到以上缺失的参数如下所示: <configuration> <property> <name>mapreduce.job.ubertask.enable</name> <value>false</value> <source>mapred-default.xml</source> </property> <!-- 省略其它参数属性 --> <property> <name>mapreduce.job.ubertask.maxreduces</name> <value>1</value> <source>mapred-default.xml</source> </property> <!-- 省略其它参数属性 --> <property> <name>mapreduce.job.ubertask.maxmaps</name> <value>9</value> <source>mapred-default.xml</source> </property> <!-- 省略其它参数属性 --> </configuration>从以上内容我们可以看见缺失的参数都配置在 mapred-default.xml中,而我之前编写的HadoopConfDisplay类的代码中并未包含此配置。此外,未包括进来的配置文件还有yarn-default.xml、core-default.xml(说明Hadoop参数默认是从*-default.xml的几个文件中读取的)。最后我们将这些内容也编辑进去,代码如下: import java.util.Map.Entry; import org.apache.hadoop.conf.*; import org.apache.hadoop.util.*; public class HadoopConfDisplay extends Configured implements Tool { static { Configuration.addDefaultResource("core-default.xml"); Configuration.addDefaultResource("yarn-default.xml"); Configuration.addDefaultResource("mapred-default.xml"); Configuration.addDefaultResource("core-site.xml"); Configuration.addDefaultResource("hdfs-site.xml"); Configuration.addDefaultResource("mapred-site.xml"); Configuration.addDefaultResource("yarn-site.xml"); } @Override public int run(String[] args) throws Exception { Configuration conf = getConf(); for (Entry<String, String> entry: conf) { System.out.printf("%s=%s\n", entry.getKey(), entry.getValue()); } return 0; } public static void main(String[] args) throws Exception { int exitCode = ToolRunner.run(new HadoopConfDisplay(), args); System.exit(exitCode); } } 最后我们按照之前的方式编译打包为mytest.jar,再执行命令验证的结果如下图所示: 之前缺失的参数都出来了,呵呵! 这下大家可以愉快的进行性能调优了。 后记:个人总结整理的《深入理解Spark:核心思想与源码分析》一书现在已经正式出版上市,目前京东、当当、天猫等网站均有销售,欢迎感兴趣的同学购买。 京东(现有满150减50活动)):http://item.jd.com/11846120.html 当当:http://product.dangdang.com/23838168.html

优秀的个人博客,低调大师

百度云盘小工具 1.6 发布

fuckbaiduyun 百度网盘快速加解密工具 特性 go+qt 实现跨平台,目前有 mac、windows 版本 rc4 按块加密文件,防止文件被和谐 自动拆分文件,适应百度网盘限制 单线程执行,不耗尽系统资源 进度条显示 保存上次选项 只对输出目录写操作,保证输入目录安全 加解密的进度保存,可从断点继续 用法 打开程序 选择输入路径 选择输出路径 输入密码 选择切分文件大小 点击GO运行 下载 https://github.com/esrrhs/fuckbaiduyun/releases 示例

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册