首页 文章 精选 留言 我的

精选列表

搜索[列状态],共10017篇文章
优秀的个人博客,低调大师

程序山河程序居,经理产品列两边

Golang通用代码生成器仙童,电音仙女尝鲜版六,此版本新增了数据库自动反射功能,可以为遗留数据库配上操作软件。此版本增强了模板向导界面的编辑器功能,可以不清空数据的情况下编辑项目的元数据和数据。可以切换域对象和枚举,可以清洗登录数据。此版本新增了多对多候选功能,支持多对多候选的编辑,持久化和反射功能。此版本彻底修复了枚举和哑数据功能。并有前端界面更新。请部署在 Tomcat9 的 webapps 目录下。请参考视频:https://www.bilibili.com/video/BV1Sr421c7zY/ Golang通用代码生成器:仙童将强大的生产力赋能广大程序员。无论是新开发的软件还是通过遗留数据库反射以再次开发的遗留项目,您都可以使用动词算子式通用代码生成器的强大生产力大大加速研发速度。 代码生成器项目地址:https://gitee.com/jerryshensjf/Fairchild二进制发布包下载地址:https://gitee.com/jerryshensjf/Fairchild/attach_files Go语言通用代码生成器:仙童 项目简介 Go语言通用代码生成器:仙童,基于Java通用代码生成器:光的架构。 生成的代码基于go语言,使用gin作为web框架。目前支持MariaDB,MySQL,PostgreSQL和Oracle四种数据库。支持生成Vue和ElementUI的基于Node.js的独立前端。支持Excel,PDF两种数据导出格式。 项目图片 最新大版本号 正在研发的最新大版本号是仙童2.4.0 电音仙女 TechnoFairy 短名TF。对标java通用代码生成器光2.4.0电音之王和Rust通用代码生成器红莲。 Golang通用代码生成器仙童,电音仙女尝鲜版六,此版本新增了数据库自动反射功能,可以为遗留数据库配上操作软件。此版本增强了模板向导界面的编辑器功能,可以不清空数据的情况下编辑项目的元数据和数据。可以切换域对象和枚举,可以清洗登录数据。此版本新增了多对多候选功能,支持多对多候选的编辑,持久化和反射功能。此版本彻底修复了枚举和哑数据功能。并有前端界面更新。 百度话题 #通用代码生成器# 重点组件和功能 动词算子 域对象 棱柱 项目 时空之门前端代码生成器引擎 弹性登录模块 Grid页生成模块 多对多生成模块 数据库脚本生成模块 动态椰子树功能群 动词否定功能群 字段否定功能群 高级定制功能群 部分生成功能群 自动生成差异版本功能群 上传生成界面 模板向导生成界面 自动生成差异版本生成界面 Excel数据导出功能 PDF数据导出功能 数据库后端模式 数据库工具模式 哑数据模式 开发测试环境 jdk 17 Apache Tomcat 9 Node.js 14 golang 1.19 MariaDB 15.1 MySQL 8 PostgreSQL 14 Oracle 11 安装教程 先装好open jdk 17和Apache Tomcat 9,如果您从源码编译代码生成器还需要事先装好Apache Maven 下载编译好的Golang通用代码生成器仙童的war包,或者下载源码,解压后使用mvn install命令编译,得到代码生成器的war包 把代码生成器的war包的名字改短,成为Fairchild.war,并放置在Apache Tomcat 9的webapps目录下 启动Apache Tomcat 9 访问http://localhost:8080/Fairchild/ 即可使用代码生成器 后端代码生成物运行 使用代码生成器生成一个示例或自己的SGS2模板,得到两个代码生成物,一个前端,一个后端 将后端项目下载并解压 根据您的数据库选项,配置好您后端的数据库,并使用后端代码生成物的sql文件夹下的数据库脚本完成建库建表并加载初始化数据 您需要检查后端代码生成物内的配置文件,确认数据库和用户名密码的正确性 您需要安装配置好Golang 1.20或其他兼容版本的Golang环境 在后端代码生成物的根目录下运行go mod init 在后端代码生成物的根目录下运行go mod tidy 在后端代码生成物的根目录下运行go mod download 在后端代码生成物的根目录下运行go mod vendor 在后端代码生成物的根目录下运行go run Server.go 启动完毕后访问后端代码生成物,http://localhost:8081 前端代码生成物运行 使用代码生成器生成一个示例或自己的SGS2模板,得到两个代码生成物,一个前端,一个后端 将前端代码生成物解压 确认您已经安装好和您选择的Nodejs版本相容的前端Nodejs环境 使用npm install -registry=https://registry.npm.taobao.org安装Nodejs依赖包 如果您使用的是Nodejs 21和Nodejs18,请运行命令:export NODE_OPTIONS=--openssl-legacy-provider 运行命令:node --max-http-header-size=1000000 ./node_modules/.bin/webpack-dev-server --inline --progress --config build/webpack.dev.conf.js 如此访问前端代码生成物,http://localhost:8000/ 百度话题 #通用代码生成器# 代码生成器截图 代码生成器正在研发中,2.4.0 尝鲜版六已发布。 电音仙女尝鲜版六下载 二进制发布包下载地址: https://gitee.com/jerryshensjf/Fairchild/attach_files 仙童的安装运行 仙童是使用Java语言写成的代码生成器。运行仙童您需要装好Java8和安装好Tomcat9或8.5应用服务器。并把仙童的war包部署在Tomcat的webapps目录下。 代码生成物的运行还需要安装好Go语言开发环境,您要使用go mod管理依赖,并把代码生成物解压在go语言工作空间的src文件夹的一级子目录下。还需要对应的数据库服务器运行代码生成物的建库sql脚本。 前端代码生成物的运行需要装好node.js运行环境并安装js依赖库。 Vue独立前端截图 代码生成物截图 源码编译用户指南 通用代码生成器已经支持自己编译源码,我已把原来缺的前端代码生成器的jar包上传。支持大家自行编译源码。 需要注意的是,现在我的开发平台是Fedora 37上的openjdk 17。所以大家编译源码最好使用openjdk17。编译好的war包运行在apache tomcat 9.0上。 已有jdk8的用户报告默认下载的代码生成器war包在他的平台上无法运行。您如果遇到类似问题请报告。我的电子邮件是:jerry_shen_sjf@qq.com 附openjdk 17下载地址: https://jdk.java.net/java-se-ri/17 使用前端功能的注意事项 由于图片文件比较大,原来前端使用cnpm instll安装类型,npm run dev运行有所改动,改为先使用npm install --registry=https://registry.npm.taobao.org安装类库,出错后使用cnpminstall安装类库, 使用node --max-http-header-size=1000000 ./node_modules/.bin/webpack-dev-server --inline --progress --config build/webpack.dev.conf.js 运行系统。 您也可以从安装好的本系列代码生成器的前端项目中拷贝node_modules目录,即可运行前端。 node-sass不兼容的解决办法 办法一: npm uninstall node-sass npm install sass-loader npm i node-sass --sass_binary_site=https://npm.taobao.org/mirrors/node-sass/ 办法二: npm uninstall sass-loader node-sass //卸载 npm install sass-loader@7.3.1 node-sass@4.14.1 --save-dev //安装对应的版本 动词算子式代码生成器的应用场景 快速原型:项目或演示场景使用。可以生成具有关系型数据库后端,使用MyBatis的数据库后端和Vue和ElementUI前端。 项目前期:如果项目和动词算子式代码生成器兼容,可以使用动词算子式代码生成器执行项目前期的自动化生成。 源码研读者注意事项 无垠式代码生成器第一个完整版本源码,有兴趣可以抄写一下: https://gitee.com/jerryshensjf/InfinityGPGenerator_0_6_5 相关技术视频: https://www.bilibili.com/video/BV1Sr421c7zY/ https://www.bilibili.com/video/BV1fX4y1u7Bn/ https://www.bilibili.com/video/BV1rv41187qY/ https://www.bilibili.com/video/BV1xv41187cA/ https://www.bilibili.com/video/BV1t64y1v7WA/

优秀的个人博客,低调大师

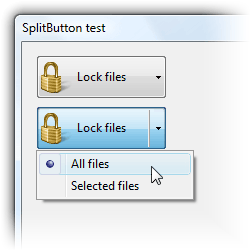
C# WinForm 按钮下拉列(SplitButton)简单使用示例

关于SplitButton网上有很多的示例教程,这里我就以 https://wyday.com/splitbutton/ 为例给大家简单的讲解下。 1.下载控件 前往 https://wyday.com/splitbutton/ 下载控件 2.引入控件 在VS工具箱栏右键,选择 选择项(I) 点击 浏览(B).. 按钮 选择下载的控件解压文件夹中的 SplitButton.dll 3.简单使用 添加控件到窗体 添加 ContextMenuStrip 控件 在 SplitButton 控件属性中绑定 ContextMenuStrip 控件 完成

优秀的个人博客,低调大师

hadoop状态分析系统chukwa

Apache 的开源项目 hadoop, 作为一个分布式存储和计算系统,已经被业界广泛应用。很多大型企业都有了各自基于 hadoop 的应用和相关扩展。当 1000+ 以上个节点的 hadoop 集群变得常见时,集群自身的相关信息如何收集和分析呢?针对这个问题, Apache 同样提出了相应的解决方案,那就是 chukwa。 述chukwa 的官方网站是这样描述自己的: chukwa 是一个开源的用于监控大型分布式系统的数据收集系统。这是构建在 hadoop 的 hdfs 和 map/reduce 框架之上的,继承了 hadoop 的可伸缩性和鲁棒性。Chukwa 还包含了一个强大和灵活的工具集,可用于展示、监控和分析已收集的数据。 在一些网站上,甚至声称 chukwa 是一个“日志处理/分析的full stack solution”。说了这么多,你心动了吗?我们先来看看 chukwa 是什么样子的: chukwa 不是什么1. chukwa 不是一个单机系统. 在单个节点部署一个 chukwa 系统,基本没有什么用处. chukwa 是一个构建在 hadoop 基础上的分布式日志处理系统.换言之,在搭建 chukwa 环境之前,你需要先构建一个 hadoop 环境,然后在 hadoop 的基础上构建 chukwa 环境,这个关系也可以从稍后的 chukwa 架构图上看出来.这也是因为 chukwa 的假设是要处理的数据量是在 T 级别的.2. chukwa 不是一个实时错误监控系统.在解决这个问题方面, ganglia,nagios 等等系统已经做得很好了,这些系统对数据的敏感性都可以达到秒级. chukwa 分析的是数据是分钟级别的,它认为像集群的整体 cpu 使用率这样的数据,延迟几分钟拿到,不是什么问题.3. chukwa 不是一个封闭的系统.虽然 chukwa 自带了许多针对 hadoop 集群的分析项,但是这并不是说它只能监控和分析 hadoop.chukwa 提供了一个对大数据量日志类数据采集、存储、分析和展示的全套解决方案和框架,在这类数据生命周期的各个阶段, chukwa 都提供了近乎完美的解决方案,这一点也可以从它的架构中看出来.chukwa 是什么上一节说了很多 chukwa 不是什么,下面来看下 chukwa 具体是干什么的一个系统呢?具体而言, chukwa 致力于以下几个方面的工作:1. 总体而言, chukwa 可以用于监控大规模(2000+ 以上的节点, 每天产生数据量在T级别) hadoop 集群的整体运行情况并对它们的日志进行分析2. 对于集群的用户而言: chukwa 展示他们的作业已经运行了多久,占用了多少资源,还有多少资源可用,一个作业是为什么失败了,一个读写操作在哪个节点出了问题.3. 对于集群的运维工程师而言: chukwa 展示了集群中的硬件错误,集群的性能变化,集群的资源瓶颈在哪里.4. 对于集群的管理者而言: chukwa 展示了集群的资源消耗情况,集群的整体作业执行情况,可以用以辅助预算和集群资源协调.5. 对于集群的开发者而言: chukwa 展示了集群中主要的性能瓶颈,经常出现的错误,从而可以着力重点解决重要问题.基本架构有了一个感性的认识后,我们来看下它的构架, chukwa 的整体结构图是下面这个样子的: 其中主要的部件为:1. agents : 负责采集最原始的数据,并发送给 collectors2. adaptor : 直接采集数据的接口和工具,一个 agent 可以管理多个 adaptor 的数据采集3. collectors 负责收集 agents 收送来的数据,并定时写入集群中4. map/reduce jobs 定时启动,负责把集群中的数据分类、排序、去重和合并5. HICC 负责数据的展示相关设计adaptors 和 agents在每个数据的产生端(基本上是集群中每一个节点上), chukwa 使用一个 agent 来采集它感兴趣的数据,每一类数据通过一个 adaptor 来实现, 数据的类型(DataType?)在相应的配置中指定. 默认地, chukwa 对以下常见的数据来源已经提供了相应的 adaptor : 命令行输出、log 文件和 httpSender等等. 这些 adaptor 会定期运行(比如每分钟读一次 df 的结果)或事件驱动地执行(比如 kernel 打了一条错误日志). 如果这些 adaptor 还不够用,用户也可以方便地自己实现一个 adaptor 来满足需求。 为防止数据采集端的 agent 出现故障,chukwa 的 agent 采用了所谓的 ‘watchdog’ 机制,会自动重启终止的数据采集进程,防止原始数据的丢失。另一方面, 对于重复采集的数据, 在 chukwa 的数据处理过程中,会自动对它们进行去重. 这样,就可以对于关键的数据在多台机器上部署相同的 agent,从而实现容错的功能.collectorsagents 采集到的数据,是存储到 hadoop 集群上的. hadoop 集群擅长于处理少量大文件,而对于大量小文件的处理则不是它的强项,针对这一点,chukwa 设计了 collector 这个角色,用于把数据先进行部分合并,再写入集群,防止大量小文件的写入。另一方面,为防止 collector 成为性能瓶颈或成为单点,产生故障, chukwa 允许和鼓励设置多个 collector, agents 随机地从 collectors 列表中选择一个 collector 传输数据,如果一个 collector 失败或繁忙,就换下一个 collector. 从而可以实现负载的均衡,实践证明,多个 collector 的负载几乎是平均的.demux 和 archive放在集群上的数据,是通过 map/reduce 作业来实现数据分析的. 在 map/reduce 阶段, chukwa 提供了 demux 和 archive 任务两种内置的作业类型.demux 作业负责对数据的分类、排序和去重. 在 agent 一节中,我们提到了数据类型(DataType?)的概念.由 collector 写入集群中的数据,都有自己的类型. demux 作业在执行过程中,通过数据类型和配置文件中指定的数据处理类,执行相应的数据分析工作,一般是把非结构化的数据结构化,抽取中其中的数据属性.由于 demux 的本质是一个 map/reduce 作业,所以我们可以根据自己的需求制定自己的 demux 作业,进行各种复杂的逻辑分析. chukwa 提供的 demux interface 可以用 java 语言来方便地扩展.而 archive 作业则负责把同类型的数据文件合并,一方面保证了同一类的数据都在一起,便于进一步分析, 另一方面减少文件数量, 减轻 hadoop 集群的存储压力。dbadmin放在集群上的数据,虽然可以满足数据的长期存储和大数据量计算需求,但是不便于展示.为此, chukwa 做了两方面的努力:1. 使用 mdl 语言,把集群上的数据抽取到 mysql 数据库中,对近一周的数据,完整保存,超过一周的数据,按数据离现在的时间长短作稀释,离现在越久的数据,所保存的数据时间间隔越长.通过 mysql 来作数据源,展示数据.2. 使用 hbase 或类似的技术,直接把索引化的数据在存储在集群上到 chukwa 0.4.0 版本为止, chukwa 都是用的第一种方法,但是第二种方法更优雅也更方便一些.hicchicc 是 chukwa 的数据展示端的名字.在展示端, chukwa 提供了一些默认的数据展示 widget,可以使用“列表”、“曲线图”、“多曲线图”、“柱状图”、“面积图式展示一类或多类数据,给用户直观的数据趋势展示。而且,在 hicc 展示端,对不断生成的新数据和历史数据,采用 robin 策略,防止数据的不断增长增大服务器压力,并对数据在时间轴上“稀释”,可以提供长时间段的数据展示从本质上, hicc 是用 jetty 来实现的一个 web 服务端,内部用的是 jsp 技术和 javascript 技术.各种需要展示的数据类型和页面的局都可以通过简直地拖拽方式来实现,更复杂的数据展示方式,可以使用 sql 语言组合出各种需要的数据.如果这样还不能满足需求,不用怕,动手修改它的 jsp 代码就可以了.其它数据接口如果对原始数据还有新的需要,用户还可以通过 map/reduce 作业或 pig 语言直接访问集群上的原始数据,以生成所需要的结果。chukwa 还提供了命令行的接口,可以直接访问到集群上数据。默认数据支持对于集群各节点的cpu使用率、内存使用率、硬盘使用率、集群整体的 cpu 平均使用率、集群整体的内存使用率、集群整体的存储使用率、集群文件数变化、作业数变化等等 hadoop 相关数据,从采集到展示的一整套流程, chukwa 都提供了内建的支持,只需要配置一下就可以使用.可以说是相当方便的.可以看出,chukwa 从数据的产生、收集、存储、分析到展示的整个生命周期都提供了全面的支持。 【本文首发于: 百度运维空间】 http://hi.baidu.com/ops_bd/blog/item/5f39abde48a10f3f10df9b12.html 【 关注百度技术沙龙】 本文转自百度技术51CTO博客,原文链接:http://blog.51cto.com/baidutech/748264 ,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册