首页 文章 精选 留言 我的

精选列表

搜索[文档系统],共10000篇文章
优秀的个人博客,低调大师

Android 3.1 r1 中文API文档 (121) —— ResourceCursorTreeAdapter

结构 继承关系 public abstract classtResourceCursorTreeAdapterextendsCursorTreeAdapter java.lang.Object android.widget.BaseExpandableListAdapter android.widget.CursorTreeAdapter android.widget.ResourceCursorTreeAdapter 直接子类 SimpleCursorTreeAdapter 类概述 一个简单的可扩展的ExpandableListAdapter,通过在XML文件来创建views。你可以指定一个定义了views外观的XML文件。 构造函数 publicResourceCursorTreeAdapter(Context context, Cursor cursor, int collapsedGroupLayout, int expandedGroupLayout, int childLayout, int lastChildLayout) 构造函数。 参数 context和正在运行的SimpleListItemFactory关联的ListView的上下文 cursor数据库游标 collapsedGroupLayout定义了收缩组的视图布局文件的资源标识 expandedGroupLayout定义了展开组的视图布局文件的资源标识 childLayout定义了除了最后一个的所有子视图的布局文件的资源标识 lastChildLayout定义了一组中最后一个子视图的布局文件的资源标识 publicResourceCursorTreeAdapter(Context context, Cursor cursor, int collapsedGroupLayout, int expandedGroupLayout, int childLayout) 构造函数。 参数 context和正在运行的SimpleListItemFactory关联的ListView的上下文 cursor数据库游标 collapsedGroupLayout定义了收缩组的视图布局文件的资源标识 expandedGroupLayout定义了展开组的视图布局文件的资源标识 childLayout定义了除了最后一个的所有子视图的布局文件的资源标识 publicResourceCursorTreeAdapter(Context context, Cursor cursor, int groupLayout, int childLayout) 构造函数。 参数 context和正在运行的SimpleListItemFactory关联的ListView的上下文 cursor数据库游标 groupLayout为所有组定义了视图布局文件的资源标识 expandedGroupLayout 定义了展开组的视图布局文件的资源标识 childLayout定义了除了最后一个的所有子视图的布局文件的资源标识 公共方法 protected abstract ViewnewChildView(Context context, Cursor cursor, booleanisLastChild, ViewGroup parent) 创建一个新的子元素视图并持有指向数据的游标cursor。 参数 context应用程序上下文对象 cursor获取数据的游标对象,它已经移动到正确的位置 IsLastChild子元素是否处于组中的最后一个 parent新视图(View)所依附于的父对象。 返回值 新创建的视图 protected abstract ViewnewGroupView(Context context, Cursor cursor, booleanisExpanded, ViewGroup parent) 创建一个新的组视图并持有组中指向数据的游标cursor。 参数 context应用程序上下文对象 cursor获取数据的游标对象,它已经移动到正确的位置 isExpanded该组是否展开状态 parent新视图(View)所依附于的父对象。 返回值 新创建的视图 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582335,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android2.2 API 中文文档系列(7) —— ImageButton

正文 一、结构 java.lang.Objectandroid.view.Viewandroid.widget.ImageView android.widget.ImageButton 已知直接子类: ZoomButton 二、类摘要 显示一个可以被用户点击的图片按钮,默认情况下,ImageButton看起来像一个普通的按钮,在不同状态(如按下)下改变背景颜色。按钮的图片可用通过<ImageButton> XML元素的android:src属性或setImageResource(int)方法指定。 要删除按钮的背景,可以定义自己的背景图片或设置背景为透明。(注:请看 原图和图片按钮,默认图片周围有按钮的背景,选中之后为黄色) 为了表示不同的按钮状态(焦点,选择等),你可以为各种状态定义不同的图片。例如,定义蓝色图片为默认图片,黄色图片为获取时焦点时显示的图片,黄色图片为按钮被按下时显示的图片。一个简单的方法可以做到这点——通过XML的"selector."配置,如下: 保存上面的XML到res/drawable/文件夹下(注:注意文件名大小写!),将该文件名作为一个参数设置到ImageButton的android:src属性(注:如xml文件名为myselector.xml,那么这里设置为"@drawable/myselector",设置android:background也是可以的,但效果不太一样)。Android根据按钮的状态改变会自动的去XML中查找相应的图片以显示。 <item>元素的顺序很重要,因为是根据这个顺序判断是否适用于当前按钮状态,这也是为什么正常(默认)状态指定的图片放在最后,是因为它只会在pressed和focused都判断失败之后才会被采用。(注:例如按钮被按下时是同时获得焦点的,但是获得焦点并不一定按了按钮,所以这里会按顺序查找,找到合适的就不往下找了。这里按钮被点击了,那么第一个将被选中,且不再在后面查找其他状态。) 参见Form Stuff tutorial。 三、 继承自父类的方法 public void setAlpha (int alpha) 设置ImageButton图片的透明度(注意不是背景图片的)。效果如图: 参数 alpha 透明值0~255,0为完全透明,255为完全不透明 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582708,如需转载请自行联系原作者

优秀的个人博客,低调大师

Androids含文档erver结束(工具包 Httputils)两

在同server在...的基础上,本文client还登录界面 Andriod简单http get请求基础上,用户注冊后跳转到下载界面,本文下载界面仅仅有两个View,一个是textView显示注冊后username(本文未做登录界面,方法与注冊类似。仅仅是在server端查询数据库中username,password是否正确)。还有一个为下载button。点击后下载到sd卡中。 以下先将工具包,该类封装了Http请求,本文使用get方法,使用HttpURLConnection类来负责详细请求。 httpUtils类中加入sendDownloadPost方法 详细代码例如以下: public static void sendDownloadPost(URL urls) { InputStream inputStream=null; //String path="http://192.168.0.179:8080/Myweb/download.do"; OutputStream outputStream=null; try { //url = new URL(urls); //本文採用HttpURLConnection,HttpClient一样能够 HttpURLConnection connection=(HttpURLConnection) urls.openConnection(); connection.setRequestMethod("GET"); //超时请求设置为3s connection.setConnectTimeout(3000); //设置响应时间10s connection.setReadTimeout(10000); connection.setDoInput(true); connection.setDoOutput(true); //获取返回码 int responseCode=connection.getResponseCode(); //请求正确 if(responseCode==200) { Log.d(TAG, "返回正确!。"); inputStream=new BufferedInputStream(connection.getInputStream()); //生成sd卡文件路径 File file=new File(Environment.getExternalStorageDirectory()+File.separator +"A.pdf"); outputStream=new BufferedOutputStream(new FileOutputStream(file)); byte[] str=new byte[2048]; int len=-1; if(Environment.MEDIA_MOUNTED.equals(Environment.getExternalStorageState())) { Log.d(TAG, "有权限"); //将inpustream写入到sd卡 while((len=inputStream.read(str))!=-1) { outputStream.write(str, 0, len); } } } } catch (IOException e) { // TODO Auto-generated catch block e.printStackTrace(); }finally{ if(inputStream!=null) { try { inputStream.close(); } catch (IOException e) { // TODO Auto-generated catch block e.printStackTrace(); } } if(outputStream!=null) { try { outputStream.close(); } catch (IOException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } return; } 友情提示:本文须要加入的权限有:internet訪问权限,SD卡文件读写权限,SD卡文件创建权限 详细在manifest.xml 加入例如以下: <uses-permission android:name="android.permission.INTERNET"></uses-permission> <uses-permission android:name="android.permission.WRITE_EXTERNAL_STORAGE"></uses-permission> <uses-permission android:name="android.permission.MOUNT_UNMOUNT_FILESYSTEMS"></uses-permission> ps:若想下载文件名称与server上文件名称同样,可在文件名称之前,中间处理了中文乱码问题 String filename = connection.getHeaderField("Content-Disposition"); filename=new String(filename.getBytes("iso8859-1"), "gbk"); filename=filename.split("filename=")[1]; 加入到 File file=new File(Environment.getExternalStorageDirectory()+File.separator +"A.pdf"); A.pdf阅读filename能够 版权声明:本文博客原创文章,博客,未经同意,不得转载。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/4676439.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android2.2 API 中文文档系列(8) —— QuickContactBadge

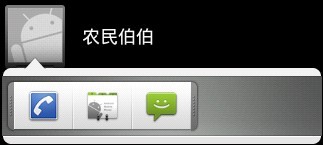
正文 一、结构 java.lang.Object android.view.View android.widget.ImageView android.widget.QuickContactBadge 二、截图 说明:在andorid自带的ApiDomos的例子中有这个的代码:App/Activity/QuickContacktsDemo。注意需要android.permission.READ_CONTACTS权限,并且联系人里面有数据,并且联系人需要有手机号码,不然出来是一个空的(看代码可知)。 三、公共方法 public void assignContactFromEmail (String emailAddress, boolean lazyLookup) 指定联系人的电子邮箱地址。(注:它会先搜索这个号码,如果没有会提醒你是否添加到联系人,参见文章1) 参数 emailAddress 联系人的电子邮箱地址 lazyLookup 如果设置为true,将不会立即查找这个邮箱地址,直到View被点击时。(注:是否延迟匹配电子邮件) public void assignContactFromPhone (String phoneNumber, boolean lazyLookup) 为联系人指定一个电话号码。(注:参见文章1) 参数 phoneNumber联系人的电话号码 lazyLookup如果设置为true,将不会立即查找这个电话号码,直到View被点击时。 public void assignContactUri (Uri contactUri) 指定和QuickContactBadge关联的联系人URI。注意,这里只是显示QuickContact窗口,并不为你绑定联系人图片。 参数 contactUri CONTENT_URI或CONTENT_LOOKUP_URI其中一种风格的URI. public void onClick (View v) 当View被点击时调用。 参数 v 被点击的View. public void setExcludeMimes (String[] excludeMimes) 设置一组要排除不显示的MIMI类型列表。例如,可以隐藏Contacts.CONTENT_ITEM_TYPE类型的图标。(注:如果像如下设置: setExcludeMimes(new String[] { Contacts.CONTENT_ITEM_TYPE }) 即隐藏了上面截图的第二个,仅显示电话和短信两个图标) public void setMode (int size) 设置QuickContact的窗口模式。如下选项:MODE_SMALL、MODE_MEDIUM、MODE_LARGE。(注:默认为QuickContact.MODE_MEDIUM,设置为MODE_LARGE时会同时显示联系人名称) 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582706,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop-2.2.0中文文档—— Common - CLI MiniCluster

目的 使用 CLI MiniCluster, 用户能够简单地仅仅用一个命令就启动或关闭一个单一节点的Hadoop集群,不须要设置不论什么环境变量或管理配置文件。 CLI MiniCluster 同一时候启动一个YARN/MapReduce和HDFS集群。 这对那些想要高速体验一个真实的Hadoop集群或是測试依赖明显的Hadoop函数的非Java程序 的用户非常实用。 Hadoop Tarball 你须要从公布页获取tar包。或者。你能够从源代码中自己编译。 $ mvn clean install -DskipTests $ mvn package -Pdist -Dtar -DskipTests -Dmaven.javadoc.skip 注意:你须要事先安装有 protoc 2.5.0 。 tar包应该在hadoop-dist/target/文件夹. 执行 MiniCluster 从解压出的tar包的根文件夹。你能够用以下的命令启动 CLI MiniCluster : $ bin/hadoop jar ./share/hadoop/mapreduce/hadoop-mapreduce-client-jobclient-2.2.0-tests.jar minicluster -rmport RM_PORT -jhsport JHS_PORT 在上面的命令演示样例中,RM_PORT和JHS_PORT应该由用户的port号替换。假设不指定。会随机使用空暇的port。 命令行參数中有一个数字,用户能够用来控制启动哪个服务。或者传递别的属性。可用的命令行參数例如以下: $ -D <property=value> Options to pass into configuration object $ -datanodes <arg> 启动多少个 datanodes (默认是 1) $ -format 格式化 DFS (默认是 false) $ -help 打印帮助选项 $ -jhsport <arg> JobHistoryServer 端口 (默认是 0--我们选的) $ -namenode <arg> namenode 的 URL (默认 要么是 DFS 集群,要么是暂时文件夹) $ -nnport <arg> NameNode 端口 (默认是 0--我们选的) $ -nodemanagers <arg> 要启动多少个 nodemanagers(默认是 1) $ -nodfs 不启动一个 mini DFS 集群 $ -nomr Don't start a mini MR cluster $ -rmport <arg> ResourceManager 端口 (默认是 0--我们选的) $ -writeConfig <path> 保存配置文件到这个XML文件中。 $ -writeDetails <path> 写出基本信息到这个JSON文件中。 要显示可用的參数的全列表。用户能够传-help參数给上面的命令。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5389794.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 在生产环境中运行拓扑

在生产环境集群中运行拓扑的方式与本地模式非常相似,主要包括以下几个步骤: 1) 定义拓扑(如果使用 Java 进行开发就可以使用TopologyBuilder) 2) 使用StormSubmitter向集群提交拓扑。StormSubmitter接收拓扑名称、拓扑配置信息以及拓扑对象本身作为参数,如下所示: Config conf = new Config(); conf.setNumWorkers(20); conf.setMaxSpoutPending(5000); StormSubmitter.submitTopology("mytopology", conf, topology); 3) 将你的拓扑程序以及相关依赖库(除了 Storm 本身的依赖 —— 这些依赖已经添加到 Storm 的工作节点的 classpath 中了)打包为一个 jar 文件。 如果你使用 Maven 进行开发,可以使用Maven Assembly Plugin来打包,你需要做的仅仅是将下述插件配置添加到你的 pom.xml 中: <plugin> <artifactId>maven-assembly-plugin</artifactId> <configuration> <descriptorRefs> <descriptorRef>jar-with-dependencies</descriptorRef> </descriptorRefs> <archive> <manifest> <mainClass>com.path.to.main.Class</mainClass> </manifest> </archive> </configuration> </plugin> 然后就可以运行mvn assembly:assembly来打包。请确保你已经在 dependencies 中排除了 Storm 本身的 jar 包。 4) 使用storm客户端向集群提交拓扑,在提交时需要指定好你的 jar 包的相关路径、主函数所在类名称以及其他一些需要的参数,下面是一个提交拓扑的例子: storm jar path/to/allmycode.jar org.me.MyTopology arg1 arg2 arg3 storm jar会将 jar 提交到集群中,同时配置StormSubmitter类来与正确的集群建立连接。在上面的例子里,上传 jar 包之后,storm jar就会使用 “arg1”、“arg2”、“arg3” 三个参数来运行org.me.MyTopology的 main 函数。 关于如何配置 Storm 客户端与 Storm 集群的交互的详细信息,请参阅配置开发环境一文。 常用配置 拓扑中有很多参数可以设置。你可以在这里找到完整的配置项列表。其中,以 “TOPOLOGY” 开头的参数可以被拓扑中的对应配置项覆盖(其他参数是集群的配置参数,不能被直接覆盖)。以下是拓扑中的一些常用参数: Config.TOPOLOGY_WORKERS:此项设置了可以用于执行拓扑的 worker 进程数。例如,如果你将该参数值设置为 25,那么在集群中就会有 25 个可以执行任务的 Java 进程。另外,如果你将拓扑的并行度设置成了 150,那么每个 worker 进程就会执行 6 个任务线程。 Config.TOPOLOGY_ACKERS:此项设置了用于跟踪 spout 发送的 tuple 树的 ack 任务数。Ackers 是 Storm 可靠性模型的重要组成部分,你可以在消息的可靠性保障一文中了解更多相信信息。 Config.TOPOLOGY_MAX_SPOUT_PENDING:此项设置了单个 Spout 任务能够挂起的最大的 tuple 数(tuple 挂起表示该 tuple 已经被发送但是尚未被 ack 或者 fail)。强烈建议设置此参数来防止消息队列的爆发性增长。 Config.TOPOLOGY_MESSAGE_TIMEOUT_SECS:此项设置了 ackers 跟踪 tuple 的超时时间。默认值是 30 秒,对于大部分拓扑而言这个值基本上是不需要改动的。关于 Storm 的消息可靠性模型请参考消息的可靠性保障一文。 Config.TOPOLOGY_SERIALIZATIONS:此项用于在 Storm 中注册更多的序列化工具,这样你就可以使用自定义的序列化类型来处理 tuple。 Kill 拓扑 执行以下命令来 kill 拓扑: storm kill {topologyname} 其中topologyname就是你提交拓扑时使用的拓扑名称。 不过,在执行该命令后 Storm 不会马上 kill 掉该拓扑。Storm 会先停止所有 spouts 的活动,使得他们不能继续发送 tuple,然后 Storm 会等待Config.TOPOLOGY_MESSAGE_TIMEOUT_SECS参数表示的一段时间,然后才会结束所有的 worker 进程。这可以保证拓扑在被 kill 之前可以有足够的时间完成已有的 tuple 的处理。 更新运行中的拓扑 目前只能通过先 kill 掉当前的拓扑再重新提交新拓扑的方式来更新运行中的拓扑。不过社区计划在将来实现一个storm swap命令来将一个运行中的拓扑替换为一个新的拓扑,尽可能减少停机时间,同时确保不会有两个拓扑同时处理 tuple 的情况发生。 监控拓扑 监控拓扑运行的最好方式是使用 Storm UI。Storm UI 可以显示任务中的错误信息以及每个运行中拓扑中每个组件的吞吐量与端到端延时的性能信息。 当然,你也可以通过查看在工作节点机器上的日志信息来了解拓扑运行情况。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 消息的可靠性保障

Storm 能够保证每一个由 Spout 发送的消息都能够得到完整地处理。本文详细解释了 Storm 如何实现这种保障机制,以及作为用户如何使用好 Storm 的可靠性机制。 消息的“完整性处理”是什么意思 一个从 spout 中发送出的 tuple 会产生上千个基于它创建的 tuples。例如,有这样一个 word-count 拓扑: TopologyBuilder builder = new TopologyBuilder(); builder.setSpout("sentences", new KestrelSpout("kestrel.backtype.com", 22133, "sentence_queue", new StringScheme())); builder.setBolt("split", new SplitSentence(), 10) .shuffleGrouping("sentences"); builder.setBolt("count", new WordCount(), 20) .fieldsGrouping("split", new Fields("word")); 这个拓扑从一个 Kestrel 队列中读取句子,然后将句子分解成若干个单词,然后将它每个单词和该单词的数量发送出去。这种情况下,从 spout 中发出的 tuple 就会产生很多基于它创建的新 tuple:包括句子中单词的 tuple 和 每个单词的个数的 tuple。这些消息构成了这样一棵树: 如果这棵 tuple 树发送完成,并且树中的每一条消息都得到了正确的处理,就表明发送 tuple 的 spout 已经得到了“完整性处理”。对应的,如果在指定的超时时间内 tuple 树中有消息没有完成处理就意味着这个 tuple 失败了。这个超时时间可以使用Config.TOPOLOGY_MESSAGE_TIMEOUT_SECS参数在构造拓扑时进行配置,如果不配置,则默认时间为 30 秒。 在消息得到完整性处理后或者处理失败后会发生什么 为了理解这个问题,让我们先了解一下 tuple 的生命周期。下面是定义 spout 的接口(可以在Javadoc中查看更多细节信息): public interface ISpout extends Serializable { void open(Map conf, TopologyContext context, SpoutOutputCollector collector); void close(); void nextTuple(); void ack(Object msgId); void fail(Object msgId); } 首先,通过调用Spout的nextTuple方法,Storm 向Spout请求一个 tuple。Spout会使用open方法中提供的SpoutOutputCollector向它的一个输出数据流中发送一个 tuple。在发送 tuple 的时候,Spout会提供一个 “消息 id”,这个 id 会在后续过程中用于识别 tuple。例如,上面的KestrelSpout就是从一个 kestrel 队列中读取一条消息,然后再发送一条带有“消息 id”的消息,这个 id 是由 Kestrel 提供的。使用SpoutOutputCollector发送消息一般是这样的形式: _collector.emit(new Values("field1", "field2", 3) , msgId); 随后,tuple 会被发送到对应的 bolt 中去,在这个过程中,Storm 会很小心地跟踪创建的消息树。如果 Storm 检测到某个 tuple 被完整处理, Storm 会根据Spout提供的“消息 id”调用最初发送 tuple 的Spout任务的ack方法。对应的,Storm 在检测到 tuple 超时之后就会调用fail方法。注意,对于一个特定的 tuple,响应(ack)和失败处理(fail)都只会由最初创建这个 tuple 的任务执行。也就是说,及时Spout在集群中有很多个任务,某个特定的 tuple 也只会由创建它的那个任务——而不是其他的任务——来处理成功或失败的结果。 我们再以KestrlSpout为例来看看在消息的可靠性处理中Spout做了什么。在KestrlSpout从 Kestrel 队列中取出一条消息时,可以看作它“打开”了这条消息。也就是说,这条消息实际上并没有从队列中真正地取出来,而是保持着一个“挂起”状态,等待消息处理完成的信号。在挂起状态的消息不回被发送到其他的消费者中。另外,如果消费者(客户端)断开了连接,所有处于挂起状态的消息都会重新放回到队列中。在消息“打开”的时候 Kestrel 会给客户端同时提供消息体数据和一个唯一的 id。KestrelSpout在使用SpoutOutputCollector发送 tuple 的时候就会把这个唯一的 id 当作“消息 id”。一段时间之后,在KestrelSpout的ack或者fail方法被调用的时候,KestrelSpout就会通过这个消息 id 向 Kestrel 请求将消息从队列中移除(对应ack的情况)或者将消息重新放回队列(对应fail的情况)。 Storm 的可靠性 API 使用 Storm 的可靠性机制的时候你需要注意两件事:首先,在 tuple 树中创建新节点连接时务必通知 Storm;其次,在每个 tuple 处理结束的时候也必须向 Storm 发出通知。通过这两个操作,Storm 就能够检测到 tuple 树会在何时完成处理,并适时地调用 ack 或者 fail 方法。Storm 的 API 提供了一种非常精确的方式来实现着两个操作。 Storm 中指定 tuple 树中的一个连接称为“锚定”(anchoring)。锚定是在发送新 tuple 的同时发生的。让我们以下面的 Bolt 为例说明这一点,这个 Bolt 将一个包含句子的 tuple 分割成若干个单词 tuple: public class SplitSentence extends BaseRichBolt { OutputCollector _collector; public void prepare(Map conf, TopologyContext context, OutputCollector collector) { _collector = collector; } public void execute(Tuple tuple) { String sentence = tuple.getString(0); for(String word: sentence.split(" ")) { _collector.emit(tuple, new Values(word)); } _collector.ack(tuple); } public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields("word")); } } 通过将输入 tuple 指定为emit方法的第一个参数,每个单词 tuple 都被“锚定”了。这样,如果单词 tuple 在后续处理过程中失败了,作为这棵 tuple 树的根节点的原始 Spout tuple 就会被重新处理。相对应的,如果这样发送 tuple: _collector.emit(new Values(word)); 就称为“非锚定”。在这种情况下,下游的 tuple 处理失败不会触发原始 tuple 的任何处理操作。有时候发送这种“非锚定” tuple 也是必要的,这取决于你的拓扑的容错性要求。 一个输出 tuple 可以被锚定到多个输入 tuple 上,这在流式连接或者聚合操作时很有用。显然,一个多锚定的 tuple 失败会导致 Spout 中多个 tuple 的重新处理。多锚定操作是通过指定一个 tuple 列表而不是单一的 tuple 来实现的,如下面的例子所示: List<Tuple> anchors = new ArrayList<Tuple>(); anchors.add(tuple1); anchors.add(tuple2); _collector.emit(anchors, new Values(1, 2, 3)); 多锚定操作会把输出 tuple 添加到多个 tuple 树中。注意,多锚定也可能会打破树的结构从而创建一个 tuple 的有向无环图(DAG),如下图所示: Storm 的程序实现既支持对树的处理,同样也支持对 DAG 的处理(由于早期的 Storm 版本仅仅对树有效,所以“tuple 树”的这个糟糕的概念就一直沿袭下来了)。 锚定其实可以看作是将 tuple 树具象化的过程 —— 在结束对一棵 tuple 树中一个单独 tuple 的处理的时候,后续以及最终的 tuple 都会在 Storm 可靠性 API 的作用下得到标定。这是通过OutputCollector的ack和fail方法实现的。如果你再回过头看一下SplitSentence的例子,你就会发现输入 tuple 是在所有的单词 tuple 发送出去之后被 ack 的。 你可以使用OutputCollector的fail方法来使得位于 tuple 树根节点的 Spout tuple 立即失败。例如,你的应用可以在建立数据库连接的时候抓取异常,并且在异常出现的时候立即让输入 tuple 失败。通过这种立即失败的方式,原始 Spout tuple 就会比等待 tuple 超时的方式响应更快。 每个待处理的 tuple 都必须显式地应答(ack)或者失效(fail)。因为 Storm 是使用内存来跟踪每个 tuple 的,所以,如果你不对每个 tuple 进行应答或者失效,那么负责跟踪的任务很快就会发生内存溢出。 Bolt 处理 tuple 的一种通用模式是在execute方法中读取输入 tuple、发送出基于输入 tuple 的新 tuple,然后在方法末尾对 tuple 进行应答。大部分 Bolt 都会使用这样的过程。这些 Bolt 大多属于过滤器或者简单的处理函数一类。Storm 有一个可以简化这种操作的简便接口,称为BasicBolt。例如,如果使用BasicBolt,SplitSentence的例子可以这样写: public class SplitSentence extends BaseBasicBolt { public void execute(Tuple tuple, BasicOutputCollector collector) { String sentence = tuple.getString(0); for(String word: sentence.split(" ")) { collector.emit(new Values(word)); } } public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields("word")); } } 这个实现方式比之前的方式要简单许多,而且在语义上有着完全一致的效果。发送到BasicOutputCollector的 tuple 会被自动锚定到输入 tuple 上,而且输入 tuple 会在execute方法结束的时候自动应答。 相对应的,执行聚合或者联结操作的 Bolt 可能需要延迟应答 tuple,因为它需要等待一批 tuple 来完成某种结果计算。聚合和联结操作一般也会需要对他们的输出 tuple 进行多锚定。这个过程已经超出了IBasicBolt的应用范围。 在 tuple 可以被重新处理的前提下,如何让我的应用可以得到正确的运行? 按照软件设计的一般思路,这个问题的答案是“取决于实际情况”。Storm 0.7.0 版本引入了“事务拓扑”的特性,它能够保证大多数计算过程都能够满足恰好一次(exactly-once)的消息语义的容错性要求。想要了解“事务拓扑”的更多内容可以参考这篇文章。 Storm 是以怎样一种高效的方式实现可靠性的? Storm 的拓扑有一些特殊的称为“acker”的任务,这些任务负责跟踪每个 Spout 发出的 tuple 的 DAG。当一个 acker 发现一个 DAG 结束了,它就会给创建 spout tuple 的 Spout 任务发送一条消息,让这个任务来应答这个消息。你可以使用Config.TOPOLOGY_ACKERS来配置拓扑的 acker 数量。Storm 默认会将 acker 的数量设置为一,不过如果你有大量消息的处理需求,你可能需要增加这个数量。 理解 Storm 的可靠性实现的最好方式还是通过了解 tuple 和 tuple DAG 的生命周期。当一个 tuple 在拓扑中被创建出来的时候 —— 不管是在 Spout 中还是在 Bolt 中创建的 —— 这个 tuple 都会被配置一个随机的 64 位 id。acker 就是使用这些 id 来跟踪每个 spout tuple 的 tuple DAG 的。 Spout tuple 的 tuple 树中的每个 tuple 都知道 spout tuple 的 id。当你在 bolt 中发送一个新 tuple 的时候,输入 tuple 中的所有 spout tuple 的 id 都会被复制到新的 tuple 中。在 tuple 被 ack 的时候,它会通过回掉函数向合适的 acker 发送一条消息,这条消息显示了 tuple 树中发生的变化。也就是说,它会告诉 acker 这样一条消息:“在这个 tuple 树中,我的处理已经结束了,接下来这个就是被我标记的新 tuple”。 以下图为例,如果 D tuple 和 E tuple 是由 C tuple 创建的,那么在 C 应答的时候 tuple 树就会发生变化: 由于在 D 和 E 添加到 tuple 树中的时候 C 已经从树中移除了,所以这个树并不会被过早地结束。 关于 Storm 如何跟踪 tuple 树还有更多的细节。正如上面所提到的,你可以随意设置拓扑中 acker 的数量。这就会引起下面的问题:当 tuple 在拓扑中被 ack 的时候,它是怎么知道向那个 acker 任务发送信息的? 对于这个问题,Storm 实际上是使用哈希算法来将 spout tuple 匹配到 acker 任务上的。由于每个 tuple 都会包含原始的 spout tuple id,所以他们会知道需要与哪个 acker 任务通信。 关于 Storm 的另一个问题是 acker 是如何知道它所跟踪的 spout tuple 是由哪个 Spout 任务处理的。实际上,在 Spout 任务发送新 tuple 的时候,它也会给对应的 acker 发送一条消息,告诉 acker 这个 spout tuple 是与它的任务 id 相关联的。随后,在 acker 观察到 tuple 树结束处理的时候,它就会知道向哪个 Spout 任务发送结束消息。 Acker 实际上并不会直接跟踪 tuple 树。对于一棵包含数万个 tuple 节点的树,如果直接跟踪其中的每个 tuple,显然会很快把这个 acker 的内存撑爆。所以,这里 acker 使用一个特殊的策略来实现跟踪的功能,使用这个方法对于每个 spout tuple 只需要占用固定的内存空间(大约 20 字节)。这个跟踪算法是 Storm 运行的关键,也是 Storm 的一个突破性技术。 在 acker 任务中储存了一个表,用于将 spout tuple 的 id 和一对值相映射。其中第一个值是创建这个 tuple 的任务 id,这个 id 主要用于在后续操作中发送结束消息。第二个值是一个 64 比特的数字,称为“应答值”(ack val)。这个应答值是整个 tuple 树的一个完整的状态表述,而且它与树的大小无关。因为这个值仅仅是这棵树中所有被创建的或者被应答的 tuple 的 tuple id 进行异或运算的结果值。 当一个 acker 任务观察到“应答值”变为 0 的时候,它就知道这个 tuple 树已经完成处理了。因为 tuple id 实际上是随机生成的 64 比特数值,所以“应答值”碰巧为 0 是一种极小概率的事件。理论计算得以得出,在每秒应答一万次的情况下,需要 5000 万年才会发生一次错误。而且即使是这样,也仅仅会在 tuple 碰巧在拓扑中失败的时候才会发生数据丢失的情况。 假设你现在已经理解了这个可靠性算法,让我们再分析一下所有失败的情形,看看这些情形下 Storm 是如何避免数据缺失的: 由于任务(线程)挂掉导致 tuple 没有被应答(ack)的情况:这时位于 tuple 树根节点的 spout tuple 会在任务超时后得到重新处理。 Acker 任务挂掉的情形:这种情况下 acker 所跟踪的所有 spout tuple 都会由于超时被重新处理。 Spout 任务挂掉的情形:这种情况下 Spout 任务的来源就会负责重新处理消息。例如,对于像 Kestrel 和 RabbitMQ 这样的消息队列就会在客户端断开连接时将所有的挂起状态的消息放回队列(关于挂起状态的概念可以参考Storm 的容错性——译者注)。 综上所述,Storm 的可靠性机制完全具备分布的、可伸缩的、容错的特征。 调整可靠性 由于 acker 任务是轻量级的,在拓扑中你并不需要很多 acker 任务。你可以通过 Storm UI 监控他们的性能(acker 任务的 id 为“__acker”)。如果发现观察结果存在问题,你可能就需要增加更多的 acker 任务。 如果你不关注消息的可靠性 —— 也就是说你不关心在失败情形下发生的 tuple 丢失 —— 那么你就可以通过不跟踪 tuple 树的处理来提升拓扑的性能。由于 tuple 树中的每个 tuple 都会带有一个应答消息,不追踪 tuple 树会使得传输的消息的数量减半。同时,下游数据流中的 id 也会变少,这样可以降低网络带宽的消耗。 有三种方法可以移除 Storm 的可靠性机制。第一种方法是将 Config.TOPOLOGY_ACKERS 设置为0,在这种情况下,Storm 会在 Spout 发送 tuple 之后立即调用ack方法,tuple 树叶就不会被跟踪了。 第二种方法是基于消息本身移除可靠性。你可以通过在SpoutOutputCollector.emit方法中省略消息 id 来关闭 spout tuple 的跟踪功能。 最后,如果你不关心拓扑中的下游 tuple 是否会失败,你可以在发送 tuple 的时候选择发送“非锚定”的(unanchored)tuple。由于这些 tuple 不会被标记到任何一个 spout tuple 中,显然在他们处理失败的时候不会引起任何 spout tuple 的重新处理(注意,在使用这种方法时,如果上游有 spout 或 bolt 仍然保持可靠性机制,那么需要在execute方法之初调用OutputCollector.ack来立即响应上游的消息,否则上游组件会误认为消息没有发送成功导致所有的消息会被反复发送——译者注)。 转载自并发编程网 - ifeve.com

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册