首页 文章 精选 留言 我的

精选列表

搜索[分区技术],共10000篇文章
优秀的个人博客,低调大师

技术分享连载(四十五)

资源管理 Q1:我从UWA的报告中看出我们的GC比较严重,里面有我们自己GC的地方(切换场景的时候),然后就是系统GC的。这个我们无法控制,那么有什么办法优化吗?我发现一个很尴尬的地方,如果我们不自己去GC,内存好像不会返回,但是GC又会引起卡顿。 一般来说,手动调用GC都不太必要,而切换场景时多数情况下会因为堆内存的大量分配导致系统GC的自动触发,但这里的卡顿相对可以接受(只是稍微增加了切场景的时间)。但在非场景切换的时间里,如果系统GC也频繁出现,那么就需要对脚本的堆内存分配进行严格的控制,可以通过查看堆内存分配的TOP10函数,逐个进行分析和优化,减少各个函数的累积堆内存分配量。另外,内存的下降与GC并没有十分的关联。开发者需要注意两点:首先,在Android平台上,GC无法降低Mono部分的总内存(只是把空闲内存变大);其次,Unity部分的内存是通过Resources相关的接口来释放的,GC的操作对这部分内存也没有直接影响(理论上只要引用某资源的GameObject被销毁,那么该资源就能被Resources.UnloadUnusedAssets卸载,因此和GC也没有直接关系)。 资源管理 Q2:场景切换完了后,我们发现上个场景的内容并没有卸载完毕,所以我们调用了Assetbundle.Unload(true)这个函数,紧接着我们调用了UnloadUnusedAssets+GC操作帮我们清理资源(如果不调用后续两个操作的话,我发现内存曲线并没有得到明显下降),而这个时候GC次数又高了,GC次数高了CPU降低,不去GC内存得不到完整释放。我在你们网站上看到说不要开发者频繁去使用UnloadUnusedAssets+GC这个操作,所以希望得到一些帮助。 通过LoadLevel等API来切换场景时,Unity会自动触发Resources.UnloadUnusedAssets的操作,但在切换完成后再次调用Resources.UnloadUnusedAssets来确保卸载完全的做法也是较为常见的,而我们网站上主要是建议开发者不要在其他的时间点来手动调用Resources.UnloadUnusedAssets,在切换场景时还是可以酌情调用一次的,另外对于大场景的MMO类型的游戏,因为切换场景的频率较低,也可以考虑每隔几分钟来手动触发一次Resources.UnloadUnusedAssets来降低内存。而GC的话,则不建议手动调用,即使是在切换场景时。 资源管理 Q3:我们没有使用AssestBundle的方式,使用的都是在Resources路径下的Load,请问Resources目录下的所有内容都会加载到内存里吗?如果里面东西多,是不是会导致占用内存过高? 不会,Resources.Load也是即用即加载,但就目前我们统计的结果来看,Resources文件下的资源越多,其生成的ResourceManager内存占用也越大,研发团队可在Unity Profiler中通过Take Sample来进行查看。 资源管理 Q4:请问下,Unity 5.3.3版本,Android用AssetBundle.LoadFromFile读取Application.streamingAssetsPath目录下的AssetBundle文件,用什么样的地址? 在Unity 5.3之前,安卓上加载 StreamingAssets 目录下的 AssetBundle 时,可以直接使用 Application.streamingAssetsPath 作为目录路径,而Unity 5.3之后,通过新增的LoadFromFile接口加载AssetBundle时,则需要改为 Application.dataPath+"!assets。具体也可参考雨松的博客http://www.xuanyusong.com/archives/4033。 资源管理 Q5:Font Texture 资源是如何生成的,因为我发现好像有重复的出现,如何优化呢? 这是Unity为动态字体自动产生的纹理,一般来说不用特别关注。即使重复出现,里面的内容一般也是不一样的(内容即屏幕上显示的文字)。 原文出处:侑虎科技 本文作者:admin 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

技术分享连载(八十六)

加载 Q1:在手机上测试LoadLevelAsync和LoadLevel的加载速度,同一个场景,LoadLevelAsync要比LoadLevel多花费40%左右的时间,请问这是正常的么?LoadLevel会有卡顿,导致Loading进度条不平滑,但是LoadLevelAsync好像又会增加Loading的时间?我项目中场景动态加载的做法是,是把物件做成Prefab,然后根据主角的位置做动态加载相应的Prefab,用的是Resources.LoadAsync方法。现在加载一些比较大的物件时,在红米2等低端机上,仍然比较卡,要消耗200ms以上。请问有什么好的方式,能平滑这个加载过程么,谢谢! LoadLevelAsync一般情况下是要比LoadLevel慢的,但是否要慢40%,这个其实是根据每个场景所要加载的不同量而定的,并不是确数。 LoadLevel和LoadLevelAsync其实最本质的区别,是前者一定要在下一帧结束前完成加载操作,所以当加载场景较大时,其随后的单帧开销就会很大,而后者则没有这个限制,引擎可以根据当前的使用情况或者ThreadPriority(这个值是是否对LoadLevelAsync有影响,还没做过具体实验,但对于LoadAsync确实有影响 )来自行调控。 但还需要说明一点的是,不是说使用Async,它就一定是绝对平滑,下图红框是LoadLevel,绿框是LoadLevelAsync操作。 关于真正“平滑”异步的加载方式,Unity引擎目前还是没有的。在遇到较为复杂的Prefab(比如大纹理、多AnimationClip等等)时,其加载依然会出现卡顿。如果想要缓解该问题,建议如下: (1)先定位具体是哪个Prefab加载造成的CPU耗时较高; (2)查看该Prefab中是否含有大量加载耗时开销(比如大纹理、较多AnimationClip、较多Shader等等); (3)定位后尝试将其进行前期预加载,从而缓解该Prefab加载时的局部高开销。 该问题来自UWA问答社区,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/5a06cc3cc4ccc1804bea31ac 内存 Q2:我使用了IL2CPP后是否还存在Mono内存呢?使用IL2CPP后,通过Profiler工具获取的managedObject(例如: int32[])是哪种内存? 可以简单地认为,Il2CPP只是替换掉了Mono的虚拟机实现,所以该分配堆内存的地方还是会一样的分配(可能会有某些细节的地方不一样)。 IL2CPP在堆内存分配方面和Mono 最大的不同主要是Reserved Total 是可以下降的,而 Mono的 Reserved Total 只会上升不会下降。 该问题来自UWA问答社区,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/5a0271297acd3ac1606d5d32 渲染 Q3:场景自动烘焙的导航网格信息保存在 NavMesh.asset 中,打开可以可以看到数据如下:项目需要在服务器上进行寻路,希望有大牛帮忙解析这个数据,还原成 recast 用的导航网格。Unity版本是 5.5.1,Unity 4.2版本的解析代码是有的,新版本格式变了。 首先用 NavMesh.CalculateTriangulation 获取所有的顶点和索引数据,这个是完整的、构建过的NavMesh,包括了多边形信息(最大边数为6边型的凸多边形),但是这个数据中所有的多边形是不共边的(多边形的边是重复数据),所以需要首先合并重复的边,可以利用 RacastNavigation提供的代码,基于 rcBuildPolyMesh 增加一个修改版本(比如叫:rcBuildPolyMeshBySeparatePolyTriangle),目的是合并已有的多边形的重复边,这一步结束后,就可以借用 RacastNavigation 剩余的构建流程: 1)创建 NavMesh并使用以上的 PolyMesh 初始化 (dtCreateNavMeshData, dtNavMesh::Init); 2)根据已有的 NavMesh 更新包围盒; 3)根据现有的 NavMesh 将每一个 Tile 写入文件(这之前可以写入自定义的文件头信息,方便读取); 4)服务器读取存储的数据,并用来初始化生成 NavMesh,就可以 findpath 了。(也可以将这个数据导入 RacastNavigation 的 Demo 中查看可视化情况)。 以上 1-4 是RacastNavigation示例中构建流程的一部分,重点是 rcBuildPolyMeshBySeparatePolyTriangle 这一步合并多边形即可。这么做的好处是,导出的 NavMesh,跟 Unity 里构建的,多边形信息是一模一样的。想要支持 DetailMesh,估计还不行。 另外,服务器直接用可能还有点问题,如果 Unity 导出的数据很多细长的三角形,那么RacastNavigation的结果会和 Unity出现很大的差异,需要稍微修改下RacastNavigation的代码 。 我之前记录了个不太详细的描述,仅供参考:http://www.cnblogs.com/yaukey/p/recastnavigation_unity_optimize_visible_result.html 该问题来自UWA问答社区,感谢 Yaukey提供了回答,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/59f93d2aa740da296dd03662 渲染 Q4:目前我在用的Unity版本是2017.1.0f3 for MAC,在iOS平台下Bake Environment Reflections的时候丢失HDR信息,操作步骤如下: 1、当我使用Standalone Platform时,我使用了一张带有HDR的SkyBox CubeMap贴图(默认压缩方式BC6H),通过它生成的ReflectionProbe-0.exr会给物体带来明显的一个高光效果,如图所示:2、当切换到iOS Platform后,再次用同样的SkyBox CubeMap贴图(压缩方式为PVRTC,或不压缩RGB24 bit都试过)烘焙ReflectionProbe-0.exr时,发现这个效果消失了,如图所示:3、此时,如果我把之前的那张Standalone下面生成ReflectionProbe-0.exr替换过来,可以获得跟Standalone下一样的高光效果。把该工程发布到iPhone 7P上运行,效果与“步骤一”中一致。 说明ReflectionProbe-0中的HDR信息得到了保留。但是我注意到,在iOS Platform下面,ReflectionProbe-0的默认压缩方式是PVRTC或RGB 24 bit,这两种方式都无法保留HDR信息。如图所示:4、通过对比两张ReflectionProbe-0.exr贴图,发现他们的文件大小是不同的,Standalone下面的贴图要大一些。如图所示,请问这是Unity的Bug吗?我在此上传了示例工程:exr_EnvRef_iOS.zip,默认是PC Standalone,需要手动切换一下Platform,切换后重新Generate Lighting。 用题主的工程文件尝试了一下,的确是出现同样问题,并且在Android平台也是一样。目前看来只能判断是Reflection-Probe烘焙时使用了两套不同的操作。 再提供一个线索,用renderdoc->texture viewer可以查看像素值:Standalone(PC) Android 从上图可以看到相似区域Standalone比Android的烘焙结果数值要高出许多。 该回复由UWA提供。 我在Unity 5.6下发现效果是一样的,结论和题主一样:Mobile平台下Bake出来的Probe是LDR的。他是通过放大亮度来做的,但其实有更简单的办法:看高mip就行,首先是PC模式下Bake的。 然后是Android下Bake的: 出现亮度区别的原因是PC上有亮度>1的像素(一般是太阳之类的) 然后在卷积的时候就值大一些;而Android下就相对值低 在mip=0的情况下大家都是0-1看不出(显示时候截断了) ,目前的结论就是在移动平台Bake的Probe依然是LDR的,这是有问题的…临时解决方案就是在Standalone上Bake完复制过来。感谢钱康来提供了以上解答。 题主补充:有了新的发现,基本上可以确认是Bug了。两张reflectionProbe-0.exr贴图的确不一样!除了尺寸之外,切换到iOS平台后生成的exr丢失了高光部分的HDR信息。 这两张图片初看没什么不一样的: 调整exposure,令exposure变为-5 (我用的是openexr,也可以用ps直接调整曝光度): 可以看到上图有两个非常明显的光斑,这个光斑的亮度非常高,因此会在物体上产生非常强的亮度。然而,在iOS Platform下面进行烘焙的时候,Unity把这个信息给丢失了。但不是所有的exr都会出现这样的问题。只有那些具有局部强光源的HDR图片才会出现这种情况,例如楼主用的那张,还有这张图片: http://gl.ict.usc.edu/Data/HighResProbes/probes/grace-new.exr 原文出处:侑虎科技 本文作者:admin 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。
优秀的个人博客,低调大师

技术分享连载(八十三)

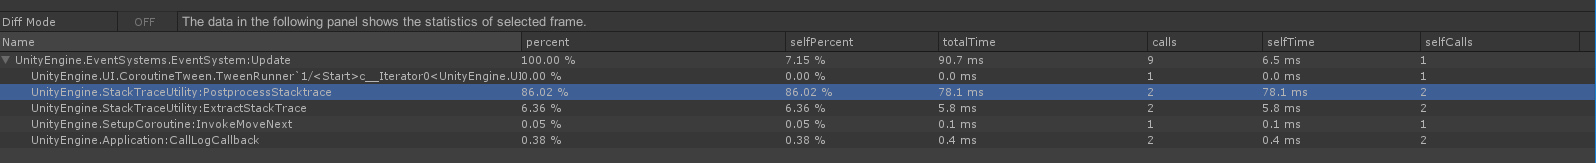
性能 Q1:我用UWA GOT进行本地性能测试,在CPU的数据分析中发现,某些帧StackTraceUtility耗时特别高,这是什么原因导致的呢? StackTraceUtility.XXX是Unity引擎的Log输出,可能是本身Debug.Log/LogError的调用输出,也可能是使用过程中引擎端出现了Warning/Error等信息而自动输出的。 该问题来自UWA问答社区,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/59ed93681b83b8df50804f6a 加载 Q2:我在Profiler中观察性能曲线,发现某一帧AssetBundle加载中,LockPersistentManager耗时比较大。请问这部分能否优化? 这说明当前帧或前几帧中存在较大量的资源在通过LoadAsync来进行加载,其本质是所加载的资源过大所致,对自身资源进行合理优化可降低Loading.LockPersistentManager的开销。另外,将异步加载换成同步加载,LockPersistentManager就不会出现了,但其总加载耗时是没有变化的,因为总加载量没变。 关于主要资源的加载优化,可参考如下链接: Unity加载模块深度解析(纹理篇) Unity加载模块深度解析(网格篇) Unity加载模块深度解析(Shader篇) Unity加载模块深度解析(动画片段篇) UWA 六月直播季 | 6.8 移动游戏加载性能和内存管理全解析 该问题来自UWA问答社区,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/59eae0c4e0a5e637724a1572 制作 Q3:我在Unity 5.4.4f1下打出的AssetBundle无法加载,抛出以下错误,但是只是部分无法加载,平台是iOS ,打包参数有以下:DeterministicAssetBundle;DisableWriteTypeTree;ChunkBasedCompression;CollectDependencies;CompleteAssets。 出现这个Log是因为项目的逻辑脚本序列化信息更新了,也就是资源的Typetree变化了。这种情况下,需要重新Build相应的AssetBundle,如果使用之前的AssetBundle,那么就会出现上述Log。 该问题来自UWA问答社区,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/59e8aa5fe02a95cc6d0c498a 性能 Q4:我在安卓真机上跑游戏,发现Profiler下的合批数据和PC或者iOS下的不一样,因此不确定Android的合批是否有效。如下图,左边的是Android的,右边的是PC的(iOS和PC基本一致),Android的Render.Mesh明显比PC和iOS的高好多。我用的设备是魅族 mote2 Android版本 - 5.1补上FrameDebug的数据,上下的Mesh数据都是一样的,也没有z-fighting的情况,因为都是间隔地渲的,同样的物体一个一个地渲出来。经过分析,Android上不能设置Graphics Jobs(在Player Settings里面),也是不断打包测试发现这个问题,想了解一下具体是什么原因呢? Graphics Job目前在Android平台上是为Vulkan而设计的,也就是只有支持Vulkan设备的才会真正起作用。按照Unity原厂的说法,该选项在不支持Vulkan的Android设备上应该是没有效果的。 另外,Graphics Job和MultiThread Rendering并不建议同时使用,而且以目前的Android设备来说,建议只开启MultiThread Rendering一项即可。 该问题来自UWA问答社区,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/59e4510ce5b24a0754868985 制作 Q5:Unity 5.5.1版本下,Sprite Packer在iOS平台下RGBA PVRTC4打包图集失真非常严重(对单个的Sprite设置PVRTC4是正常的),参照了4.6.7版本是正常的,我想知道为什么呢? 确实可以复现。Unity 5.5 的PVRTC压缩有三档 fast/nomal/best,但都比Unity 4.7下的质量要差。找到一个官方的 issue ,说是 pvrtc 压缩工具(第三方)的Bug。 https://issuetracker.unity3d.com/issues/textures-rgba-compressed-pvrtc-2-slash-4bit-texture-with-compression-quality-set-to-to-best-slash-normal-is-less-detailed-than-fast 有人在这个帖子里提到,在 Windows 下尝试用 4.7 的 pvrtextool.exe 替换了 5.x 的,暂时解决了这个问题,建议也尝试一下。 原文出处:侑虎科技 本文作者:admin 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。
优秀的个人博客,低调大师

大数据技术原理与应用

推荐一个视频: http://study.163.com/course/courseMain.htm?courseId=1002887002 章节1课程介绍 课时1课程介绍06:53 章节2大数据概述 课时2大数据概述第1部分26:56 课时3大数据概述第2部分31:11 课时4大数据概述第3部分13:04 章节3大数据处理架构Hadoop 课时5大数据处理架构Hadoop第1部分26:52 课时6大数据处理架构Hadoop第2部分20:50 课时7大数据处理架构Hadoop第3部分15:14 课时8大数据处理架构Hadoop第4部分18:43 章节4分布式文件系统HDFS 课时9分布式文件系统HDFS第1部分24:43 课时10分布式文件系统HDFS第2部分20:15 课时11分布式文件系统HDFS第3部分20:19 课时12分布式文件系统HDFS第4部分21:33 章节5分布式数据库HBase 课时13分布式数据库HBase第1部分24:49 课时14分布式数据库HBase第2部分26:17 课时15分布式数据库HBase第3部分30:37 课时16分布式数据库HBase第4部分25:26 章节6NoSQL数据库 课时17NoSQL数据库第1部分23:45 课时18NoSQL数据库第2部分26:44 课时19NoSQL数据库第3部分23:09 课时20NoSQL数据库第4部分16:24 章节7云数据库 课时21云数据库第1部分21:59 课时22云数据库第2部分28:40 课时23云数据库第3部分31:04 课时24云数据库第4部分21:28 章节8MapReduce 课时25MapReduce第1部分25:11 课时26MapReduce第2部分28:17 课时27MapReduce第3部分26:35 课时28MapReduce第4部分19:40 章节9基于Hadoop的数据仓库Hive 课时29基于Hadoop的数据仓库Hive第1部分29:10 课时30基于Hadoop的数据仓库Hive第2部分25:56 课时31基于Hadoop的数据仓库Hive第3部分23:30 课时32基于Hadoop的数据仓库Hive第4部分25:17 章节10Hadoop架构再探讨 课时33Hadoop架构再探讨第1部分28:32 课时34Hadoop架构再探讨第2部分25:58 课时35Hadoop架构再探讨第3部分21:39 课时36Hadoop架构再探讨第4部分35:39 章节11Spark 课时37Spark第1部分30:15 课时38Spark第2部分31:38 课时39Spark第3部分35:53 课时40Spark第4部分26:05 章节12流计算 课时41流计算第1部分30:17 课时42流计算第2部分35:36 课时43流计算第3部分33:41 课时44流计算第4部分26:43 章节13图计算 课时45图计算第1部分28:51 课时46图计算第2部分35:38 课时47图计算第3部分34:47 课时48图计算第4部分30:30 章节14大数据在不同领域的应用 课时49大数据在不同领域的应用第1部分22:41 课时50大数据在不同领域的应用第2部分24:09 课时51大数据在不同领域的应用第3部分25:09 章节15附录:大数据在线课程建设团队风采 课时52附录:大数据在线课程建设团队风

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册