首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

深度学习入门笔记系列 ( 一 )

本系列将分为 8 篇 。今天是第一篇 ,工欲善其事必先利其器 ,先简单讲讲当前的主流深度学习框架 TensorFlow 及其安装方法 。 我们知道 ,深度学习研究的热潮持续高涨 ,许多的开源深度学习框架也层出不穷 ,比如 TensorFlow、Caffe、Keras、Theano、Torch7……其中 ,TensorFlow 由强大的谷歌研发 ,应用也十分广泛 ,从 GitHub 上的数据统计可以看出来其有着大一统之势头 。 关于 TensorFlow 的安装 ,我们首先得知道 : Window 、MacOS 、Linux 都已支持 TensorFlow Window用户只能使用python3.5+ ,MacOS,Linux支持python2.7和python3.3+ 有GPU可以安装带GPU版本的,没有GPU就安装CPU版本的。 关于 TensorFlow 的安装 ,这里推荐使用 pip 方式安装 ,简单粗暴 !这里小詹安利一款神器 ,谁用谁说好哈哈 !Anaconda ,你可以试试 ,自带python3.5 ,也包含了很多模块 ,配置其他模块的时候也很好用 。 首先是 windows 下的 pip 安装 :(命令窗口执行) CPU 版本 :pip install tensorflow GPU 版本 :pip install tensorflow-gpu 如果要更新 ,可以选择先pip uninstall tensorflow 再执行pip install tensorflow 至于 Linux 和 MacOS 安装 Tensorflow : CPU版本:Python 2.7 用户:pip install tensorflow Python 3.3+ 用户:pip3 install tensorflow GPU版本:Python 2.7用户:pip install tensorflow-gpu Python3.3+用户:pip3 install tensorflow-gpu 磨刀不误砍柴工 ,花较少的篇幅汇总下如何安装 TensorFlow 在我看来还是很有必要的 ! 原文发布时间为:2018-07-25本文作者: 小詹学Python本文来自云栖社区合作伙伴“小詹学Python”,了解相关信息可以关注“小詹学Python”

优秀的个人博客,低调大师

Appium+Python3+Android入门

前言: Appium 是一个自动化测试开源工具,支持 iOS 平台和 Android 平台上的原生应用,web 应用和混合应用。 一、环境配置 1、安装Node.js https://nodejs.org/ 2、安装Appium http://appium.io/ 3、安装Android SDK http://tools.android-studio.org/index.php/sdk 4、安装Python-client pip3 install Appium-Python-Client 5、安装Appium-client npm install wd 最后,打开命令行,输入“appium-doctor”命令,提示Appium所需要的各项环境准备情况。 二、服务关键字 Desired Capabilities在启动session的时候是必须提供的。 Desired Capabilities本质上是以key value字典的方式存放,客户端将这些键值对发给服务端,告诉服务端我们想要怎么测试。 desired_caps = {} desired_caps['platformName'] ='Android' desired_caps['platformVersion'] ='6.0.1' desired_caps['deviceName'] ='e0bbc8b7' desired_caps['appPackage'] ='com.ximalaya.ting.android' desired_caps['appActivity'] ='com.ximalaya.ting.android.host.activity.WelComeActivity' desired_caps["unicodeKeyboard"] ="True" desired_caps["resetKeyboard"] ="True" self.driver = webdriver.Remote('http://127.0.0.1:4723/wd/hub', desired_caps) 它告诉appium Server这样一些事情: deviceName:启动哪种设备,是真机还是模拟器?iPhone Simulator,iPad Simulator,iPhone Retina 4-inch,Android Emulator,Galaxy S4… automationName:使用哪种自动化引擎。appium(默认)还是Selendroid。 platformName:使用哪种移动平台。iOS, Android, orFirefoxOS。 platformVersion:指定平台的系统版本。例如指的Android平台,版本为5.1。 appActivity:待测试的app的Activity名字。比如MainActivity、.Settings。注意,原生app的话要在activity前加个”.“。 appPackage:待测试的app的Java package。比如com.example.android.myApp, com.android.settings。 注️:aapt工具可获取appActivity,appPackage aapt dump badging <file.apk> 即可获取appActivity,appPackage等~~ 三、定位控件 1、ID定位 使用方法:driver.find_element_by_id(‘com.android.calculator2:id/formula’) image 2、name定位 使用方法:driver.find_element_by_name("9")) image 3、class name定位 使用方法:driver.find_element_by_class_name(“android.widget.Button")) image 4、XPath定位 使用方法:用class的属性来替代做标签的名字。 driver.find_element_by.xpath(“//android.view.ViewGroup/android.widget.Button”) image 当果如果出现class相同的情况下可以用控件的属性值进行区分。 driver.find_element_by_xpath("//android.widget.Button[contains(@text,'7')]").click(); driver.find_element_by_xpath(”//android.widget.Button[contains(@content-desc,’times')]").click(); driver.find_element_by_xpath("//android.widget.Button[contains(@text,'7')]").click(); driver.ffind_element_by_xpath("//android.widget.Button[contains(@content-desc,'equals')]").click(); XPath在Appium上的用法依然很强大,有时需要写更臭更长的定位语法,因为APP上元素的class命令本来就长,再加上多层级,结果可想而知。 5、Accessibility ID定位 使用方法:其实,我们的核心是要找到元素的contentDescription属性。它就是元素的content-desc。 driver.find_element_by_accessibility_id("plus").click(); image 6、android uiautomator定位 使用方法: 一个元素的任意属性都可以通过android uiautomator方法来进行定位,但要保证这种定位方式的唯一性。 driver.find_element_by_android_uiautomator("new UiSelector().text(\”8\")").click(); driver.find_element_by_android_uiautomator("new UiSelector().description(\”plus\")").click(); image 四、应用操作 1、安装应用 installApp() 安装应用到设备中去。需要apk包的路径。 2、卸载应用 removeApp() 从设备中删除一个应用。 3、关闭应用 closeApp() 关闭打开的应用,默认关闭当前打开的应用,所以不需要入参。这个方法并非真正的关闭应用,相当于按home键将应用置于后台,可以通过launchApp()再次启动。 4、启动应用 launchApp() 启动应用。你一定很迷惑,不是在初始化的配置信息已经指定了应用,脚本运行的时候就需要启动应用,为什么还要有这个方法去启动应用呢?重新启动应用也是一个测试点,该方法需要配合closeApp()使用的。 5、检查应用是否安装 isAppInstalled() 检查应用是否已经安装。需要传参应用包的名字。返回结果为Ture或False。 6、将应用置于后台 runAppInBackground() 将当前活跃的应用程序发送到后台。这个方法需要入参,需要指定应用置于后台的时长。 7、应用重置 resetApp() 重置当前被测程序到出始化状态。该方法不需要入参。 五、键盘操作 1、SendKeys()方法 driver.find_element_by_name(“Name”).send_keys("jack"); 2、PressKeyCode()方法 除此之外,Appium扩展提供了pressKeyCode()方法。该方法Android特有。 发送一个键码的操作。(键码对照表请自行百度,此处不展示了。) driver.press_keycode(3)//点击Android的HOME键 driver.press_keycode(27)//点击拍照键 3、输入法问题: 必须使用appium自带键盘,并添加: desired_caps["unicodeKeyboard"] = "True" desired_caps["resetKeyboard"] = "True" 六、TouchAction操作 Appium的辅助类,主要针对手势操作,比如滑动、长按、拖动等。 1、按压控件press() 开始按压一个元素或坐标点(x,y)。通过手指按压手机屏幕的某个位置。 press(WebElement el, int x, int y) 2、长按控件longPress() 开始按压一个元素或坐标点(x,y)。相比press()方法,longPress()多了一个入参,既然长按,得有按的时间吧。duration以毫秒为单位。1000表示按一秒钟。其用法与press()方法相同。 longPress(WebElement el, int x, int y, Duration duration) 3、点击控件tap() 对一个元素或控件执行点击操作。用法参考press()。 tap(WebElement el, int x, int y) 4、移动moveTo() 将指针(光标)从过去指向指定的元素或点。 movTo(WebElement el, int x, int y) 5、暂停wait() 暂停脚本的执行,单位为毫秒。 action.wait(1000); 七、其他操作 其它操作针对移动设备上特有的一些操作。 1、熄屏 方法:lockDevice() 点击电源键熄灭屏幕。 在iOS设备可以设置熄屏一段时间。Android上面不带参数,所以熄屏之后就不会再点亮屏幕了。 driver.lockDevice(1000);// iOS driver.lockDriice();//Android 2、收起键盘 方法:hideKeyboard() 收起键盘,这个方法很有用,当我们对一个输入框输入完成后,需要将键盘收起,再切换到一下输入框进行输入。 driver.hideKeyboard();//收起键盘 3、滑动 方法:swipe() 模拟用户滑动。将控件或元素从一个位置(x,y)拖动到另一个位置(x,y)。 swipe(int startx, int starty, int endx, int endy, int duration) * start_x:开始滑动的x坐标。* start_y:开始滑动的y坐标。 * end_x:结束滑动的x坐标。* end_y:结束滑动的y坐标。 * duration:持续时间。 例:driver.swipe(75, 500, 75, 0, 800); 4、截屏 方法:get_screenshot_as_file() 用法:driver.get_screenshot_as_file('../screenshot/foo.png'),参数为保存的图片路径和名称 5、获取控件各种属性 方法:get_attribute() 用法: driver.find_element_by_id().get_attribute(name), name即是左侧的标志(class,package,checkable,checked....), 可获取的字符串类型: name(返回content-desc或text) text(返回text) className(返回class,只有API=>18才能支持) resourceId(返回resource-id,只有API=>18才能支持) 八、unittest之断言 在unittest单元测试框架中,TestCase类提供了一些方法来检查并报告故障: assertEqual(first, second, msg=None) 判断first和second的值是否相等,如果不相等则测试失败,msg用于定义失败后所抛出的异常信息。 assertNotEqual(first, second, msg=None) 测试first和second不相等,如果相等,则测试失败。 assertTure(expr,msg=None) assertFalse(expr,msg=None) 测试expr为Ture(或为False) assertIs(first, second, msg=None) assertIsNot(first, second, msg=None) 测试的first和second是(或不是)相同的对象。 assertIsNone(expr, msg=None) assertIsNotNone(expr, msg=None) 测试expr是(或不是)为None assertIn(first, second, msg=None) assertNotIn(first, second, msg=None) 测试first是(或不是)在second中。second包含是否包含first。 九、实例代码(例子app:喜马拉雅FM) import os import unittest from appium import webdriver from time import sleep # Returns abs path relative to this file and not cwd PATH =lambdap: os.path.abspath( os.path.join(os.path.dirname(__file__), p) ) class Contacts Android Tests(unittest.TestCase): def setUp(self): desired_caps = {} desired_caps['platformName'] ='Android' desired_caps['platformVersion'] ='6.0.1' desired_caps['deviceName'] ='e0bbc8b7' desired_caps['appPackage'] ='com.ximalaya.ting.android' desired_caps['appActivity'] ='com.ximalaya.ting.android.host.activity.WelComeActivity' desired_caps["unicodeKeyboard"] ="True" desired_caps["resetKeyboard"] ="True" self.driver = webdriver.Remote('http://127.0.0.1:4723/wd/hub', desired_caps) sleep(6) def tearDown(self): self.driver.close_app() self.driver.quit() deftest_Login(self): self.driver.find_element_by_id('com.ximalaya.ting.android:id/tab_myspace').click() sleep(2) self.driver.find_element_by_accessibility_id('设置').click() sleep(2) width =self.driver.get_window_size()['width'] height =self.driver.get_window_size()['height'] self.driver.swipe(width /2, height *7/8, width /2, height *4/8,1000) # 不同的手机分辨率不同,所以一个坐标如果用另一个分辨率不同的手机可能位置就有所变化了,为了让apppium 更好的兼容不同分辨率的设备, # 在执行滑动前先获取屏幕的分辨率。 self.driver.find_element_by_id('com.ximalaya.ting.android:id/main_tv_login').click() self.driver.find_element_by_id('com.ximalaya.ting.android:id/main_username').send_keys('18500425217') self.driver.find_element_by_id('com.ximalaya.ting.android:id/main_password').send_keys('wj1234') self.driver.find_element_by_id('com.ximalaya.ting.android:id/main_login').click() sleep(4) text =self.driver.find_element_by_id('com.ximalaya.ting.android:id/tab_myspace').text self.assertEqual(text,'我的') deftest_Search(self): sleep(3) message =self.driver.find_element_by_id('com.ximalaya.ting.android:id/main_item_finding_title').text self.assertEqual(message,'天天好书') self.driver.find_element_by_accessibility_id("搜索").click() self.driver.find_element_by_id('com.ximalaya.ting.android:id/main_search_et').send_keys('段子') self.driver.find_element_by_id('com.ximalaya.ting.android:id/main_search_button').click() self.driver.get_screenshot_as_file('/Users/wangjuan/截图图库/1.jpg') self.driver.press_keycode(4) self.assertEqual(message,'天天好书') if__name__ =='__main__': suite = unittest.TestLoader().loadTestsFromTestCase(ContactsAndroidTests) unittest.TextTestRunner(verbosity=2).run(suite) 以上,希望对你有所帮助~~


优秀的个人博客,低调大师

Gauva的安装——入门篇

Guava工程包含了若干被Google的 Java项目广泛依赖 的核心库,例如:集合 [collections] 、缓存 [caching] 、原生类型支持 [primitives support] 、并发库 [concurrency libraries] 、通用注解 [common annotations] 、字符串处理 [string processing] 、I/O 等等。 guava类似Apache Commons工具集 一、guava的安装 1.下载guava的最新的版本,网址:https://github.com/google/guava/wiki/Release19 (ps:jar,javadoc,sources都下载下来,后面都要用到) 2.打开eclipse,在java项目右键-->Build Path-->Add External Archievs 3.选择刚才下载好的jar包(jar包其实就是一个压缩文件夹,可以解压出来的) 二、guava源代码的下载 1.还是刚刚下载guava的页面,这一次下载的是源代码 2.把源代码添加到eclipse,方便查看和以后的开发 1)在java项目右键-->Build Path-->Configure Build Path 2)java build path-->Libraries-->guava-->Source attachment:(None) -->Edit 3)选择External location-->External File ; 如果你已经把源代码的jar解压成文件夹了,选择External location-->External Folder ; 4)选择源代码的jar包,双击,确定, (如果解压成文件夹了就选择对应的最外层的文件夹,确定) 5)接下来就是一路确定,然后就可以在eclipse中看guava的源码了。

优秀的个人博客,低调大师

python3入门与实践

Day 1 语言特点,环境搭建,数据结构 python 官网:http://python.org 集成开发环境:Geany,一个字:快,各个平台都有对应版本 变量 变量名只能包含字母,数字和下划线 变量名不能包含空格 不要将Python关键字和函数名用作变量名 变量名应既简短而又具有描述性 慎用小写字母l和大写字母O,因为它们可能被人错堪称1和0 字符串 用单引号或者双引号括起来,主要是为了方便在字符串中包含引号和撇号。 比如: 'I told my friend,"python is my favorite language!"' 使用方法修改字符串的大小写 字符串可以看过为对象,所以他有很多实现好了的方法 title() :返回此字符串每个单词的首字母大写状态的字符串 upper():全部大写 lower():全部小写 拼接字符串 1.直接“+”相连 删除空白 rstrip():返回字符串末尾没有空白状态的字符串 lstrip():返回字符串开头没有空白状态的字符串 strip():返回字符串两端没有空白状态的字符串 数字 整数 在Python中,可对整数执行加(+)减(-)乘(*)除(/)运算。在终端会话中,Python直接返回运算结果。Python使用两个乘号表示乘方运算: result = 3 ** 2 print(result) 浮点数 使用str()函数避免类型错误 和非字符串类型的变量或常量与字符串拼接时应该调一下str函数确保类型一致 例子: result = 3 ** 2 message = "happy "+str(result)+" brithday!" print(message) 注释 注释用“#”标识 编码 # -*- coding: gbk -*-

优秀的个人博客,低调大师

区块链比特币入门详解

比特币和区块链技术的发展非常迅速,即使那些没有听说过加密货币或了解其工作的人也在寻求投资和探索这个领域。区块链技术和加密货币今天已经成为人们开始执行标准交易的平行平台。现在,如果一个新系统正在慢慢取代现有系统,那么目前的系统肯定存在一些问题。我们将通过了解当前银行系统的问题引出当前的比特币和区块链的概念。 目前银行体系存在的问题: 任何现有的系统都会有一些问题。让我们看看银行系统最常见的一些问题: 高交易费用 我们来看一个例子来更好地理解这个问题: 在这里,钱德勒给乔发送100美元,但在乔可以收到钱之前, 它必须通过像银行或金融服务公司这样的可信第三方。从这笔金额中扣除2%的交易费用,Joe在交易结束时仅收到98美元。现在这似乎不是一个大数目,但想象一下,如果您发送的是100000美元而不是100美元,那么交易费用也会增加到2,000美元,这是一笔很大的数额。根据SNL Financial和CNNMoney的报告, 摩根大通,美国银行和富国银行在2015年从ATM和透支费用中获得超过60亿美元的收入。 双重支出 双重支出是数字现金计划中的一个错误,其中同一单个数字代币花费两次或更多。为了帮助你更好地理解这个问题,让我举个例子: 彼得在他的账户中只有500美元。他同时向亚当发起了2笔交易,价格为400美元,玛丽为500美元。通常这笔交易不会经过,因为他的账户中没有足够的900美元余额。但是,通过复制或伪造与每个数字交易相关的数字令牌,他可以在没有所需余额的情况下完成这些交易。此操作称为双重支出。 网络欺诈和帐户黑客 在印度,2016年与信用卡/借记卡和网上银行有关的欺诈案件数量为14,824件。涉及这些欺诈案件的净金额为77.79亿卢比,其中21亿卢比来自互联网欺诈,41.64亿卢比为从ATM /借记卡相关的欺诈行为。 金融危机和崩溃 image 想象一下,把你所有的存款都交给你信任的人,只知道他们已经去了,并在别的地方失去了它。这就是2007 - 08年发生的情况,当时银行和投资机构已经大举借贷,并将其作为次级抵押贷款给那些甚至无力偿还这些贷款的人。这反过来又导致了有史以来最严重的金融危机之一,估计造成全球接近11万亿美元(11亿美元)的损失。这只是最受欢迎的例子之一,我们多久听说银行和金融服务公司因内部欺诈而崩溃?整个第三方系统是建立在对中间人盲目信任的基础之上的。 我们看到了每个人都面临的一些最常见的问题。拥有一套克服这些问题的系统并为我们提供一个这正是Blockchain Technology所做的事情,这不是一件好事。 现在让我们试着了解区块链和比特币如何解决这些问题,下面引出区块链。 区块链如何解决这些问题? 以下是区块链技术解决上述问题的一些方法: 分散系统 与被中央或联邦当局控制和管理的银行和金融组织相比,区块链系统采用分散的方式。在这里,作为系统一部分的每个人都对系统的增长和崩溃负有同样的责任。每个参与系统的人都有权力,而不是一个单独的实体拥有权力。 公共总帐 持有区块链上发生的所有交易细节的分类账是开放的,并且与系统相关的每个人都可以完全访问。一旦加入区块链网络,您就可以下载自启动以来的完整交易列表。尽管完整的分类帐可公开访问,但涉及交易的人员的详细信息仍然完全匿名。 每笔交易的验证 每一笔交易都通过交叉检查分类账 进行核实,并在几分钟后发送交易的确认信号。通过使用多种复杂的加密算法和哈希算法,消除了双重支出的问题。 低或无交易费用 交易费 通常不适用,但区块链的某些变体确实实施了某些最低交易费用。与银行和其他金融机构暗示的费用相比,这些交易费用相对较少。如果交易需要优先完成,那么用户可以添加额外的交易费用,以便优先验证交易。 现在我们已经谈到了现有系统的问题,并了解了区块链技术如何克服这些挑战,我相信您一定对区块链系统有了一些了解。 在这一点上,你可能仍然想知道区块链和比特币到底是什么。所以让我们尝试在本区块链教程的下一部分中了解这些重要概念。 什么是区块链和比特币? 在我们继续了解区块链之前,了解什么是比特币非常重要: 比特币是一个由未知程序员或一群程序员发明的加密货币和数字支付系统,其名称是Satoshi Nakamoto。这意味着它们可以像通常的货币一样使用,但不会像美元钞票那样在物理上存在。他们是可以用来购买东西的在线货币。这些与人们电脑上的“数字现金”类似。比特币只存在于云端,如Paypal,Citrus或Paytm。即使它们是虚拟的,而不是物质的,当它们通过网络在人与人之间转移时,它们就像现金一样使用。 比特币系统是基于对等网络的,并且交易直接发生在用户之间,没有中介。这些交易由网络节点验证并记录在称为区块链的公共分布式账本中。由于该系统没有中央存储库或单一管理员,因此比特币被称为第一个分散数字货币。 比特币生产使他们成为独特的货币。与普通货币不同,比特币不能根据需要创建。只有2100万比特币可以创建,其中已经创建了1700万比特币。只要包含有效交易的区块添加到区块链,就会创建比特币。这是创建比特币和通过各种数学和加密算法确保没有伪造比特币被创建或传播的唯一手段。让我们现在了解更多Blockchain。 什么是区块链? 区块链可以被称为整个加密货币系统的脊柱。区块链技术不仅有助于用户使用加密货币执行交易,还可确保所涉及用户的安全性和匿名性。它是一个不断增长的记录列表,称为块,它们使用密码技术进行链接和保护。区块链可以充当“开放和分布式账本,可以以可验证和永久的方式记录双方之间的交易”。该网络中的每个人都共享的这个账户是公开的,所有人都可以查看。这带来了透明度和信任进入系统。 一个区块是区块链的'当前'部分,它记录了一些或所有最近的交易,并且一旦完成就作为永久数据库进入Vlockchain。每次块完成时,都会生成一个新块。 区块链通常由对等网络管理,共同遵守验证新区块的协议。一旦记录,任何给定的数据块中的数据都不能追溯更改,而不会改变所有后续的数据块和网络多数的合谋。一旦存储在区块链中的交易是永久性的。他们不能被黑客攻击或操纵。一旦我们进入区块链的概念,我们将进一步了解这一点。 您可以通过这个简短的动画视频来了解什么是区块链,通过例子来了解这些主题,以帮助您更好地理解这一概念。 现在我希望你对比特币和区块链有更好的理解。在我们的Blockchain教程博客中继续前进,让我们看看Blockchain技术的功能,以帮助我们理解它为何如此受欢迎。 Blockchain的特点 以下是区块链技术的最重要特性,使其成为革命性的技术: SHA256散列函数 公钥加密 分布式总账和对等网络 工作证明 确认奖励 让我们试着逐一了解他们中的每一个。 SHA256散列函数 区块链技术中使用的核心散列算法是SHA256。使用散列的目的是因为输出不是'加密',即它不能被解密回原始文本。它是一种“单向”加密函数,对于任何大小的源文本都是固定的大小。为了更好地理解,让我们看看下面的例子: 如果你看第一个例子,我们将输入作为“Hello World”输入,并得到一个输出为“a591a6d40bf420404a011733cfb7b190d62c65bf0bcda32b57b277d9ad9f146e”。但是,通过在最后加上“!”,输出完全变为“7f83b1657ff1fc53b92dc18148a1d65dfc2d4b1fa3d677284addd200126d9069”。如果我们将“H”改变为“h”和“W”改为“w”,则输出值变为“7509e5bda0c762d2bac7f90d758b5b2263fa01ccbc542ab5e3df163be08e6ca9”。 我希望通过这个例子,您已经理解了算法的复杂程度,因为即使输入中的最小变化都会导致输出的巨大变化。 公钥加密 这种密码技术通过创建一组称为公钥和私钥的密钥来帮助用户。在这里,公钥与其他人共享,而私钥作为用户保密。为了理解这些密钥的作用,让我们看看下面的例子以获得更好的理解: image 如果钱德勒给乔伊寄了一些比特币,那笔交易将会有三条信息: 乔伊的比特币地址(乔伊的公钥) Chandler送给Joey的比特币数量。 钱德勒的比特币地址(钱德勒的公钥) 现在,所有这些数据以及加密数字签名都会通过网络发送进行验证。数字签名再次是Chandler的比特币地址和他发送给joey的金额的组合实现的哈希值。该数字签名由私钥加密。一旦必须验证此交易的矿工收到这些数据,他就会同时进行2个过程: 他将Joey和Chandler的所有未加密数据(如交易金额和公钥),并将其提供给散列算法以获取散列值,我们将其称为Hash1 他采用数字签名并使用chandler的公钥解密,得到一个散列值,我们将其称为Hash2 如果Hash1和Hash2都相同,那么这意味着这是一个有效的事务。 分布式账本和P2P网络 image 网络上的每个人都拥有分类帐的副本。没有单一的集中式副本。让我通过以下示例帮助您了解账簿是什么:假设您需要将10比特币发送给您的朋友约翰,您的比特币余额为974.65,约翰在这里余额为37.您的余额将被扣除10 BTC并且记入John的账户。 区块链有一个独特的方式来实现这一点。比特币区块链账本中没有账户和余额。来自第一个交易的每笔交易都存储在一个名为Blockchain的不断增长的数据库中。有大约2050个交易的交易区块,截至目前,区块链中有484,000个交易区块,约有2.5亿笔交易。 这个分类账分布在比特币区块链的所有用户中,即分类账没有存储的中央位置。网络上的每个人都拥有分类账的副本,而真正的副本是所有分布式分类账的集合。 工作证明 您可能想知道是否每个人都拥有分块账户,谁给区块链增加了块?人们如何相信这个人? 为此,我们有工作证明的概念。这基本上就像解决一个非常大的难题。它需要大量的计算工作。这项工作是由我们称为矿工的比特币网络中的人完成的。 这些矿工的工作是验证交易并解决与创建块相关的复杂数学难题。调整问题的难度,以便在10分钟内平均可以解决问题。矿工搜索特定的随机数(数学值),它给出了 预定的期望散列。目前的难度级别是这样的,你需要尝试20.6万亿次以上的随机数来得到正确的散列。 每个块都有一个散列值,它是前一个块的最终散列值,事务数据的散列值和随机数的组合。该块的最终结果散列必须以指定数量的尾随零开始。正是这种计算才能找到满足条件的随机数,这使得采矿的计算成本很高。 因此,发现这种随机数的人是成功的矿工,他/她可以将他们的区块添加到区块链中。通过我们的P2P分布式网络,他/她广播它们的块,并且每个人都验证散列是否匹配,更新它们的区块链并立即开始解决下一个区块。 确认奖励 image 比特币交易的最后一步是给创建最新街区的矿工给予奖励。Blockchain系统提供此奖励用于验证交易和维护区块链。目前每块的奖励是12.5 比特币(3,427,850卢比/或 53,390美元)。这是比特币矿山最有趣的部分。 比特币激励是产生新货币进入系统的唯一途径,并且相信到2140年,所有2100万比特币将被开采。 有了这个,我希望你现在对Blockchain技术有更多的理解和欣赏。区块链比比特币要多得多。金融只是Blockchain旨在破坏的众多行业之一。继续阅读Blockchain教程,现在让我们看看IBM和Maersk的一个例子,了解供应链行业如何被区块链破坏。 区块链教程:用例 马士基是一家丹麦的企业集团,在运输和物流以及能源领域开展活动。自1996年以来,马士基一直是全球最大的集装箱船和供应船运营商。该公司总部位于丹麦哥本哈根,在130个国家设有分公司和办事处,员工人数约为88,000人。 IBM是一家美国跨国技术公司,主要从事自1921年以来的业务解决方案,安全解决方案和存储解决方案 业务需求: 作为极具活力的供应链行业的一部分,跟踪最轻微的变化对于客户来说是最重要的。他们需要一种解决方案,使他们能够完成装运流程,而不会延误纸质工作。这个解决方案能够将系统的所有利益相关方聚集在一起,并为货件提供实时状态。 挑战: 今天,全球贸易中90%的商品都由航运业承担。这种供应链由于点对点通信的复杂性和庞大的流量而流动。这些沟通是通过松散耦合的陆路运输提供者,货运代理,海关,经纪人,政府的港口和海运承运人处理的。 估计集装箱货物的文件和信息的成本是实际实际运输的两倍以上。 解: IBM和Maersk正在通过设计用于交换事件数据和处理文档工作流的供应链生态系统访问分布式许可平台来解决这个问题。 image 默克和IBM正在采用区块链技术,通过数字化交易工作流程和端到端追踪货物来创建全球防篡改系统。这消除了包括昂贵的点对点通信在内的摩擦。这项合作将启动,每年可追踪数百万集装箱航程,并与选定贸易航道上的海关当局进行整合。 结果: 为参与供应链系统的所有利益相关者提供了一个安全的数据交换平台。 建立防篡改存储库,以存储作为该过程一部分的所有文档。 定期航运活动有助于减少重大延误和欺诈行为,每年节省数十亿美元。 减少贸易组织之间的壁垒,从而使全球GDP增长3%。 帮助整体贸易量增加 12%。 这就是区块链技术如何帮助马士基,并一直在帮助全球许多其他公司。 上面只是区块链1.0的概念,现在区块链已经发展到了2.0了,可以将很多应用使用区块链去中心化的实现完成,保证数据的安全、公平、公正。 使用区块链可以开发去中心化应用,现在区块链2.0应用的领域: 智能合约 分布式记账使得能够在符合指定条件时执行简单合同的编码。Ethereum是一个专门为实现这一可能性而开发的开源块链项目。 尽管如此,在它的早期阶段,Ethereum有可能在真正世界变化的规模上验证区块链的可用性。 在技术当前的发展水平上,智能合同可以被编程为执行简单的功能。 例如,当金融工具符合某些基准时,衍生产品可以支付,使用区块链技术,Bitcoin可以实现自动付款。 分享经济 像Uber和滴滴这样的公司蓬勃发展,分享经济已经取得了成功。 然而,目前,想要分享履行共享服务的用户必须依靠像Uber这样的中介。 通过实现对等支付,该区块开启了双方之间直接互动的大门 - 真正地实现了去中心化的共享经济。 早期的例子,OpenBazaar使用区块链来创建一个对等eBay。 将应用程序下载到计算设备上,您可以与OpenBazzar供应商进行交易,而无需支付交易费用。 协议的无规则精神意味着个人声誉对于商业互动将比目前在eBay上更为重要。 众筹 像Kickstarter和Gofundme这样的众筹平台正在为新兴的同行经济进行先进的工作。 这些网站的普及表明人们希望在产品开发中有直接的发言权。 区块链将这个兴趣提高到一个新的水平,潜在地创造了大量的风险投资基金。 在2016年,一个这样的实验,即以爱心为基础的DAO(权力下放自治组织)在短短两个月内众筹了惊人的2亿美元。 参与者购买了“DAO令牌”,允许他们对智能合同风险投资进行投票(投票权与其持有的DAO数量成比例)。 随后的项目资金遭到破坏,证明该项目没有进行适当的尽职调查,造成灾难性的后果。 无论如何,DAO实验表明,该块有潜力开创“经济合作的新范式”。 治理 通过使结果完全透明和公开访问,分布式数据库技术可以使选举或任何其他形式的投票获得透明度。 基于Ethereum的智能合同有助于自动化流程。 应用程序,会议室,使组织化决策发生在区块上。 实际上,这意味着在管理数字资产,股权或信息时,公司治理将变得完全透明和可验证。 供应链审计 消费者越来越想知道公司对其产品的道德声明是真实的。 分布式分类帐提供了一种简单的方式来证明我们购买的东西的背景是真实的。 透明度带有日期和位置的基于块的时间戳,例如对应于产品编号的伦理钻石。 位于英国的Provenance为一系列消费品提供供应链审核。 利用Ethereum区块链,Provenance试点项目确保日本寿司餐厅销售的鱼已经在印度尼西亚的供应商可持续收获。 文件存储 在互联网上去中心化文件存储带来明显的好处。 在整个网络中分发数据可以保护文件免遭黑客入侵或丢失。 行星文件系统(IPFS)可以很容易地概括分布式网络的运行方式。 类似于Bittorrent在互联网上移动数据的方式,IPFS摆脱了对集中的客户端 - 服务器关系(即当前Web)的需求。 由完全分散网站组成的互联网有可能加快文件传输和流媒体时间。 这样的改进不仅方便。 这是网络目前重载的内容传送系统的必要升级。 预测市场 对事件概率的预测的众包被证明具有高度的准确性。 平均意见取消了歪理判断的未经审查的偏见。 根据事件结果支付的预测市场已经活跃。 区块链是一种“智慧的人群”技术,无疑将在未来几年内找到其他应用。 然而,在Beta版中,预测市场应用Augur可以为现实世界事件的结果提供分享。 参与者可以通过购买正确的预测来赚钱。 在正确结果中购买的股票越多,支付就越高。 由于资金投入少(一美元),任何人都可以提出问题,根据预测结果创造市场,并收集市场产生的所有交易费用的一半。 保护知识产权 众所周知,数字信息可以无限再生 - 由于互联网而广泛分发。 这给全球网络用户提供了免费内容的金矿。 然而,版权所有者并没有那么幸运,因此失去了对知识产权的控制和财政困境。 智能合同可以保护版权,并在线自动销售创意作品,消除文件复制和再分发的风险。 Mycelia使用块链来创建一个对等音乐分发系统。 Mycelia由英国歌手 - 创作者Imogen Heap创立,让音乐家直接向观众销售歌曲,以及向制片人发放许可证样本,并向歌曲作者和音乐家分发版税,所有这些功能都通过智能合同进行自动化。 区块分发能力以小数加密的金额支付(微支付)表明,这种用例对于块链有很大的成功机会。 物联网(IoT) 什么是物联网? 对某些类型的电子设备的网络控制管理 - 例如监视存储设备中的空气温度。 智能合同使远程系统管理的自动化成为可能。 软件,传感器和网络的组合有助于对象和机制之间的数据交换。 结果提高了系统效率,并提高了成本监控。 制造业,科技和电讯业最大的厂商正在争夺物联网的统治地位。 认为三星,IBM和AT&T。 现有基础设施的自然扩展由现任公司控制,物联网应用将从机械部件的预测性维护到数据分析以及大规模自动化系统管理等领域。 邻里微电网 块链技术能够购买和销售邻里微电网产生的可再生能源。 当太阳能电池板产生过剩的能量时,基于Ethereum的智能合约将自动重新分配。 类似类型的智能合约自动化将具有许多其他应用,因为物联网成为现实。 Consensys位于布鲁克林,是全球最重要的公司之一,正在为Ethereum开发一系列应用。 他们正在合作的一个项目是Transactive Grid,与分布式能源装备LO3合作。 目前正在运行的原型项目使用Ethereum智能合同来自动监测和重新分配微电网。 这种所谓的“智能电网”是IoT功能的早期例子。 身份管理 在网络上需要更好的身份管理。 验证您的身份的能力降低在线发生的金融交易的隐患。 但是,网络商务所带来的安全隐患的补救办法是不完美的。 分布式分类帐提供增强的方法来证明您是谁,以及将个人文档数字化的可能性。 拥有安全身份对于在线互动也是重要的,例如在共享经济中。 毕竟,良好的信誉是在线交易的最重要条件。 开发数字身份标准被证明是一个非常复杂的过程。 除了技术挑战之外,通用的在线身份解决方案需要私营机构和政府之间的合作。 此外,需要在不同的国家进行法律制度的导航,问题变得十分困难。 互联网上的电子商务目前依赖于SSL证书(小绿色锁),用于网络上的安全交易。 Netki是一个希望为区块链创建SSL标准的创业公司。 Netki最近宣布了350万美元的种子,Netki在2017年初将推出产品。 反洗钱(AML)和 充分了解你的客户(KYC) 反洗钱(AML)和充分了解您的客户(KYC)在区块链应用这块有很大的开发潜力。 目前,金融机构必须为每位新客户执行劳动密集型多步骤流程。 通过跨机构客户验证可以减少KYC成本,同时增加监控和分析的有效性。 启动Polycoin有一个涉及分析交易的AML / KYC解决方案。 被认定为可疑的交易转交给合规官。 Tradle正在开发一个名为Trust in Motion(TiM)的应用程序。 作为“KYC的Instagram”,TiM允许客户拍摄关键文件(护照,公用事业帐单等)的快照。 一旦经过银行的验证,这些数据被加密地存储在区块上。 数据管理 今天,为了交换大家的个人资料,人们可以免费使用Facebook等社交媒体平台。 将来,用户将能够管理和销售其在线活动产生的数据。 因为它可以容易地以小数量的分发,比特币(或类似的东西)很可能是用于这种类型的交易的货币。 麻省理工学院项目Enigma了解到,用户隐私是创建个人数据市场的关键前提。 Enigma使用加密技术来允许单个数据集在节点之间分割,同时在整个数据组上运行批量计算。 数据碎片也使Enigma可扩展(不像那些在每个节点上复制数据的区块链解决方案)。 土地所有权登记 作为可公开访问的分布式账本,区块链可以使各种记录更有效率。 属性标题就是一个例子。 他们往往容易受欺诈,以及管理费用高昂和劳动密集。 一些国家正在进行以封锁为基础的土地登记项目。 洪都拉斯是第一个在2015年宣布这一举措的政府,尽管该项目目前的状况不明确。 今年,格鲁吉亚共和国与Bitfury集团达成协议,开发了一个区块链产权制度。 据报道,高调的经济学家和产权倡导者Hernando de Soto将就该项目提供建议。 最近,瑞典宣布正在试验一个块式的财产申请。 股票交易 股票结算增加效率的潜力为股票交易中的区块结构提供了强有力的用例。 执行点对点时,交易确认变得几乎瞬间(而不是花三天时间清算)。 潜在地,这意味着中介机构(如结算所,审计师和监管人)被从过程中移除。 许多股票和商品交易所都是为其提供的服务提供原始形式的封锁应用程序,包括澳大利亚证券交易所(澳大利亚证券交易所),德意志交易所(德国法兰克福证券交易所)和JPX(日本交易所集团)。 纳斯达克的Linq是私人市场交易的平台(通常在IPO前创业公司和投资者之间),这是该地区公认的先行者最为高调。 与积木科技公司Chain的合作,Linq宣布在2015年完成其首次股票交易。纳斯达克近日宣布,开发一项针对爱沙尼亚股票代理投票的试用块链项目。

优秀的个人博客,低调大师

ELK入门使用-与springboot集成

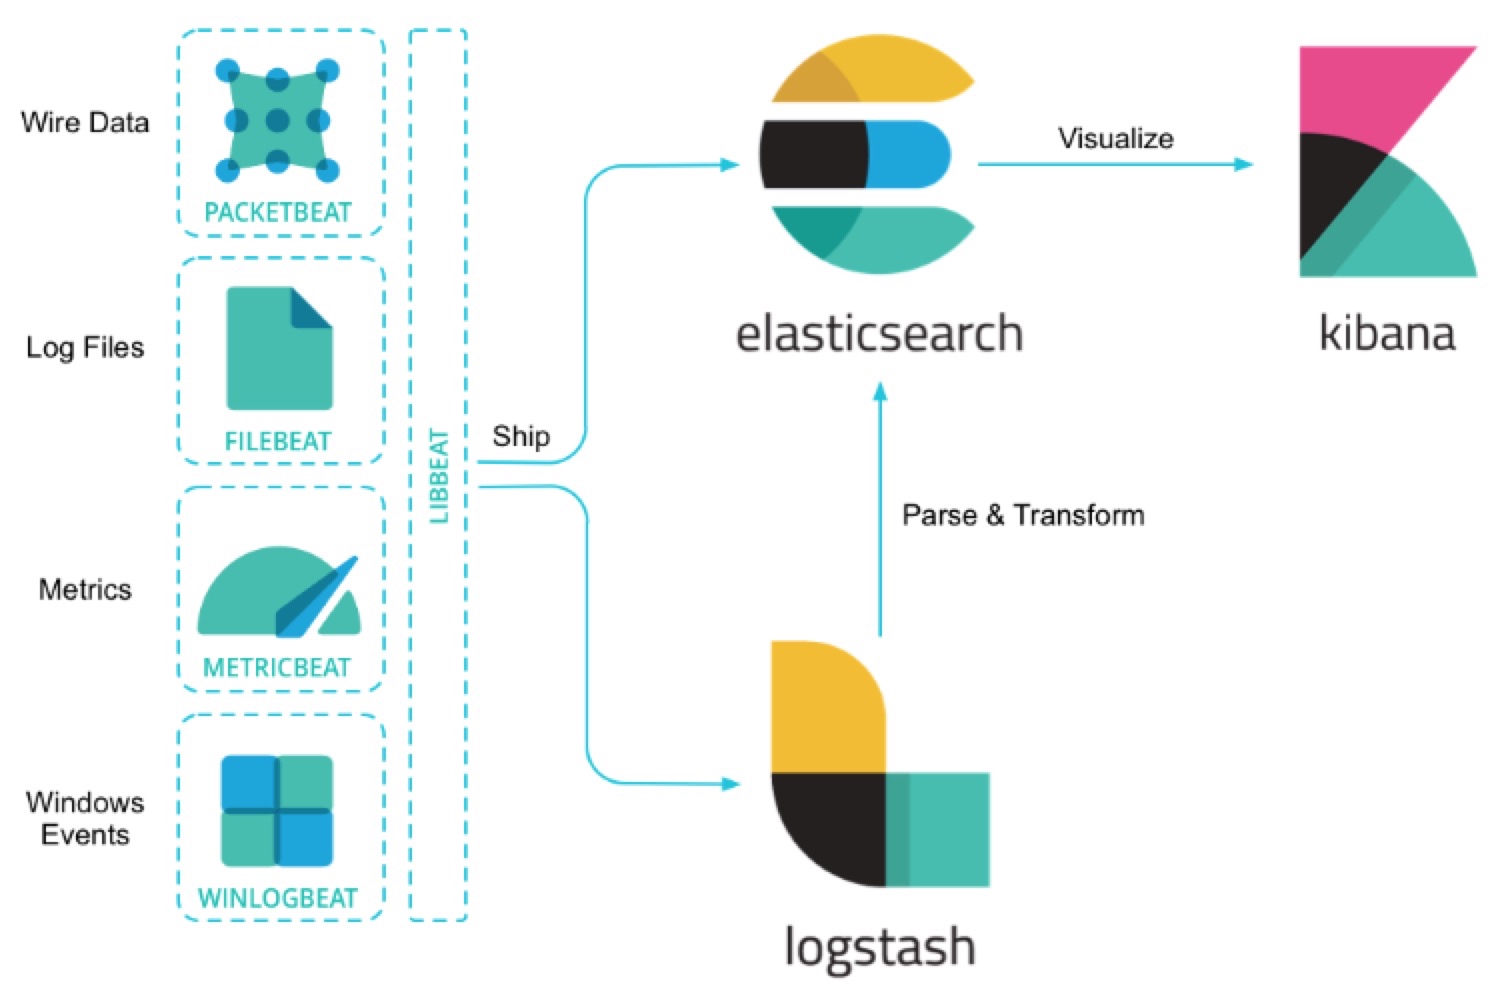
前言 ELK官方的中文文档写的已经挺好了,为啥还要记录本文?因为我发现,我如果不写下来,过几天就忘记了,而再次捡起来必然还要经历资料查找筛选测试的过程。虽然这个过程很有意义,但并不总是有那么多时间去做。因此,接下来的内容仅仅是我根据查询到的资料,筛选,组装,测试后达到我的目标的一个过程。 什么是ELK K我最初还以为是Kafka,事实上,ELK平台是一个完整的日志分析解决方案,由这三个开源工具构建而成:Elasticsearch、Logstash、Kibana。 Elasticsearch用于深度搜索和数据分析,它是基于Apache Lucene的分布式开源搜索引擎,无须预先定义数据结构就能动态地对数据进行索引; Logstash用于日志集中管理,包括从多台服务器上传输和转发日志,并对日志进行丰富和解析,是一个数据管道,提供了大量插件来支持数据的输入和输出处理; 最后是Kibana,提供了强大而美观的数据可视化,Kibana完全使用HTML和Javascript编写,它利用Elasticsearch 的RESTful API来实现其强大的搜索能力,将结果显示位各种震撼的图形提供给最终的用户。 安装Elasticsearch 官网下载对应平台的安装包。 Windows用法比较简单,只要下载后双机bin/elasticsearch.bat就启动成功了. 下面关注linux上的安装使用。 ES不允许root运行,所以,最好我们创建专门的用户来运行。 解压后,运行./bin/elasticsearch就会启动成功。如果失败,应该是用root启动的,改成普通用户即可。 然后浏览器访问:http://localhost:9200/ 可以看到响应 { "name": "ZSedUub", "cluster_name": "elasticsearch", "cluster_uuid": "_pS5AOR4Rf2oGPk5uRKK-A", "version": { "number": "6.2.4", "build_hash": "ccec39f", "build_date": "2018-04-12T20:37:28.497551Z", "build_snapshot": false, "lucene_version": "7.2.1", "minimum_wire_compatibility_version": "5.6.0", "minimum_index_compatibility_version": "5.0.0" }, "tagline": "You Know, for Search" } 安装Kibana 官网下载对应平台的安装包。然后,解压。 启动: ./bin/kibana 浏览器访问: http://localhost:5601 安装logstash 官网下载对应平台的安装包。然后,解压。 这里采用压缩包的方式,当然也可以使用系统安装包,比如 //ubuntu sudo apt-get update && sudo apt-get install logstash centos rpm --import https://artifacts.elastic.co/GPG-KEY-elasticsearch 在/etc/yum.repos.d/ 新建logstash.repo [logstash-6.x] name=Elastic repository for 6.x packages baseurl=https://artifacts.elastic.co/packages/6.x/yum gpgcheck=1 gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch enabled=1 autorefresh=1 type=rpm-md sudo yum install logstash 甚至docker。 修改ruby仓库地址为中国:编辑Gemfile 修改为source "https://gems.ruby-china.org/" 启动: bin/logstash -e 'input { stdin { } } output { stdout {} }' 这是一个交互式输入,你输入的内容将被当做message收集起来。 test { "message" => "test", "@version" => "1", "@timestamp" => 2018-05-26T14:29:09.212Z, "host" => "ryan-900X5L" } 到这里就算安装成功了。 遇到的问题, Unsupported platform: x86_64-linux 原因是Java9不支持,卸载Java9即可。 安装logstash-codec-json_lines插件 ryan@ryan-900X5L:~/apps/logstash-6.2.4$ ./bin/logstash-plugin install logstash-codec-json_lines Validating logstash-codec-json_lines Installing logstash-codec-json_lines Installation successful 接下来,我们直接编写我们springboot需要的配置方案,新建config/logstash-sample.conf input { tcp { port => 4560 codec => json_lines } } output{ elasticsearch { hosts => ["localhost:9200"] index => "%{[appName]}-%{+YYYY.MM.dd}" #用一个项目名称来做索引 } stdout { codec => rubydebug } } 4560 是logstash接收数据的端口 codec => json_lines是一个json解析器,接收json的数据。这个要装 logstash-codec-json_lines 插件 ouput elasticsearch指向我们安装的地址 stdout会打印收到的消息,调试用 启动: ./bin/logstash -f config/logstash-sample.conf 新建一个springboot项目 项目地址: https://github.com/Ryan-Miao/springboot-with-elk pom <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.test</groupId> <artifactId>springboot-with-elk</artifactId> <version>0.0.1-SNAPSHOT</version> <packaging>jar</packaging> <name>springboot-with-elk</name> <description>Demo project for Spring Boot</description> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>2.0.2.RELEASE</version> <relativePath/> <!-- lookup parent from repository --> </parent> <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding> <java.version>1.8</java.version> </properties> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>net.logstash.logback</groupId> <artifactId>logstash-logback-encoder</artifactId> <version>5.1</version> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-devtools</artifactId> <scope>runtime</scope> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> </plugins> </build> </project> 新建启动类 @SpringBootApplication public class SpringbootWithElkApplication implements CommandLineRunner { public static void main(String[] args) { SpringApplication.run(SpringbootWithElkApplication.class, args); } @Override public void run(String... args) throws Exception { Logger logger = LoggerFactory.getLogger(SpringbootWithElkApplication.class); logger.info("测试log"); for (int i = 0; i < 10; i++) { logger.error("something wrong. id={}; name=Ryan-{};", i, i); } } } 在resources下新建logback-spring.xml <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE configuration> <configuration> <appender name="LOGSTASH" class="net.logstash.logback.appender.LogstashTcpSocketAppender"> <destination>localhost:4560</destination> <encoder charset="UTF-8" class="net.logstash.logback.encoder.LogstashEncoder" /> </appender> <include resource="org/springframework/boot/logging/logback/base.xml"/> <root level="INFO"> <appender-ref ref="LOGSTASH" /> <appender-ref ref="CONSOLE" /> </root> </configuration> 启动。然后就可以观察到,logsash控制台打印我们的日志 { "@version" => "1", "thread_name" => "restartedMain", "message" => "something wrong. id=9; name=Ryan-9;", "logger_name" => "com.test.springbootwithelk.SpringbootWithElkApplication", "level_value" => 40000, "@timestamp" => 2018-05-26T15:21:05.109Z, "host" => "localhost", "level" => "ERROR", "port" => 34902 } 在kibana- management - index pattern里新建一个pattern,我们就用*吧。创建好了,点击discover。就可以看到我们的日志了 到这里,hello world完成。当然还要继续高级配置和查询啥的,后面再说。 参考 logstash官网 关注我的公众号 唯有不断学习方能改变! -- Ryan Miao

优秀的个人博客,低调大师

任务调度工具Quartz入门笔记

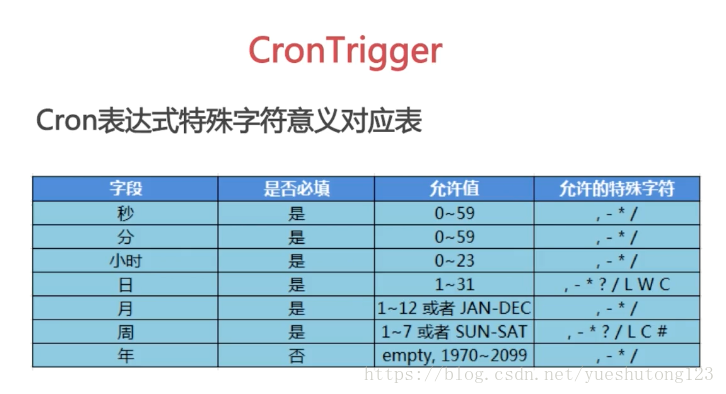
一,导包 1)官网下载:http://www.quartz-scheduler.org/downloads/ 2)Maven <dependency> <groupId>org.quartz-scheduler</groupId> <artifactId>quartz</artifactId> <version>2.2.1</version> </dependency> 二,实例 1.先定义一个作业任务类,写我们的执行代码 package cn.zyzpp.quartz.demo; import java.text.SimpleDateFormat; import java.util.Date; import org.quartz.Job; import org.quartz.JobDataMap; import org.quartz.JobDetail; import org.quartz.JobExecutionContext; import org.quartz.JobExecutionException; import org.quartz.JobKey; import org.quartz.Trigger; /** * Created by yster@foxmail.com * 2018年4月9日 下午11:00:52 */ public class HelloJob implements Job { //第(2)种获取传入的参数的方法:setter方法 属性对应key的值 private String setKey; public void execute(JobExecutionContext context) throws JobExecutionException { //获取JobDetail对象 String now = new SimpleDateFormat("yyyy-mm-dd hh:mm:ss").format(new Date()); JobDetail detail = context.getJobDetail(); String group = detail.getKey().getGroup(); String value = detail.getJobDataMap().getString("key"); //获取Trigger对象 Trigger trigger = context.getTrigger(); value= trigger.getJobDataMap().getString("key"); //获取JobDataMap对象 //第(1)种获取传入的参数的方法 JobDataMap data = context.getMergedJobDataMap(); value = data.getString("key");//相同key 调用trigger的value //System.out.println(group + ":" + value + " at " + now + setKey); //获取Jobkey对象 JobKey jobKey = trigger.getJobKey(); String name = jobKey.getName(); group = jobKey.getGroup(); try { Thread.sleep(5000l); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println(now + ":" + name + " " +group); } public String getSetKey() { return setKey; } public void setSetKey(String setKey) { this.setKey = setKey; } } 2. package cn.zyzpp.quartz.demo; import java.text.SimpleDateFormat; import java.util.Date; import org.quartz.CronScheduleBuilder; import org.quartz.CronTrigger; import org.quartz.JobBuilder; import org.quartz.SimpleScheduleBuilder; import org.quartz.SimpleTrigger; import org.quartz.TriggerBuilder; import org.quartz.JobDetail; import org.quartz.Scheduler; import org.quartz.Trigger; import org.quartz.impl.StdSchedulerFactory; /** * Created by yster@foxmail.com 2018年4月9日 下午10:57:14 */ public class QuartzTest { public static void main(String[] args) { SimpleDateFormat sf =new SimpleDateFormat("yyyy-mm-dd hh:mm:ss"); try { // Quartz 作业:定义一个JobDetail:为Job类设置属性 JobDetail jobDetail = JobBuilder.newJob(HelloJob.class) // 定义Job类为HelloQuartz类,这是真正的执行逻辑所在 .withIdentity("job1", "group1") // 定义name/group .usingJobData("key", "job-value") // 自定义参数 .usingJobData("setKey", "setValue").build(); // System.out.println(jobDetail.getKey().getName()); // System.out.println(jobDetail.getKey().getGroup()); // System.out.println(jobDetail.getJobClass()); // 定义任务开始时间以及结束时间 Date startDate = new Date(); System.out.println("scheduler开始:" + sf.format(new Date())); startDate.setTime(new Date().getTime() + 2000); Date endDate = new Date(); endDate.setTime(startDate.getTime() + 4000); // Quartz触发器:定义一个Trigger Trigger trigger = TriggerBuilder.newTrigger() .withIdentity("trigger1", "group1") // 定义name/group // .startNow()//一旦加入scheduler,立即生效 .startAt(startDate) .endAt(endDate) .withSchedule(SimpleScheduleBuilder.simpleSchedule() .withIntervalInSeconds(1) // 每隔一秒执行一次 .repeatForever()) // 一直执行,奔腾到老不停歇 .usingJobData("key", "trigger-value") .build(); //SimpleTrigger 在一个指定时间段内执行一次作业任务 或者在指定时间间隔内多次执行作业任务 SimpleTrigger simpleTrigger = (SimpleTrigger) TriggerBuilder .newTrigger() .withIdentity("trigger1", "group1") // 定义name/group .startAt(startDate) .withSchedule(SimpleScheduleBuilder.simpleSchedule() .withIntervalInSeconds(2) .withRepeatCount(3)) //执行第1次后再执行3次(SimpleTrigger.REPEAT_INDEFINITELY) .build(); //CronTrigger 基于 cron 表达式,更常用 CronTrigger cronTrigger = (CronTrigger) TriggerBuilder .newTrigger() .withIdentity("trigger1", "group1") // 定义name/group .startAt(startDate) .withSchedule( //Cron表达式:[秒][分][时][日][月][周][年] (周日1-周六7,年可不写) *每 ?不关心 -至 #第 /递增 ,和 L最后 W最近工作日 CronScheduleBuilder.cronSchedule("0/2 * * * * ? * ") ) .build(); // 调度类链接“工作”和“触发器”到一起,并执行它 // 创建scheduler StdSchedulerFactory sfact = new StdSchedulerFactory(); Scheduler scheduler = sfact.getScheduler(); // 加入这个调度 返回第一次执行时间 scheduler.scheduleJob(jobDetail, cronTrigger); //System.out.println("调度器:" + sf.format(scheduler.scheduleJob(jobDetail, cronTrigger))); // 启动之 scheduler.start(); // 运行一段时间后暂停 可再次start 当前主线程不终止 Thread.sleep(10000l); // scheduler.standby(); // System.out.println("暂停:三秒后再次开启"); // Thread.sleep(3000l); // scheduler.start(); // Thread.sleep(5000l); scheduler.shutdown(true);//true等待执行的job完成后关闭scheduler,false直接关闭 System.out.println("scheduler终止" + sf.format(new Date())); } catch (Exception e) { e.printStackTrace(); } } } 三,干货 1)Cron表达式 2)/org/quartz/quartz.properties 3)集成Spring <!-- JobDetail --> <!-- (1)simpleJobDetail : 定义任务类和任务方法--> <bean id="simpleJobDetail" class="org.springframework.scheduling.quartz.MethodInvokingJobDetailFactoryBean"> <property name="targetObject" ref="myBean" /> <property name="targetMethod" value="printMessage" /> </bean> <!--(2)继承 QuartzJobBean 传参--> <bean id="firstComplexJobDetail" class="org.springframework.scheduling.quartz.JobDetailFactoryBean"> <property name="jobClass" value="com.imooc.springquartz.quartz.FirstScheduledJob" /> <property name="jobDataMap"> <map> <entry key="anotherBean" value-ref="anotherBean" /> </map> </property> <property name="durability" value="true"/> </bean> <!--Trigger--> <!-- (1)距离当前时间1秒之后执行,之后每隔两秒钟执行一次 --> <bean id="mySimpleTrigger" class="org.springframework.scheduling.quartz.SimpleTriggerFactoryBean"> <property name="jobDetail" ref="simpleJobDetail"/> <property name="startDelay" value="1000"/> <property name="repeatInterval" value="2000"/> </bean> <!-- (2)每隔5秒钟执行一次 --> <bean id="myCronTrigger" class="org.springframework.scheduling.quartz.CronTriggerFactoryBean"> <property name="jobDetail" ref="firstComplexJobDetail"/> <property name="cronExpression" value="0/5 * * ? * *"/> </bean> <!-- (3)Scheduler --> <bean class="org.springframework.scheduling.quartz.SchedulerFactoryBean"> <property name="jobDetails"> <list> <ref bean="simpleJobDetail"/> <ref bean="firstComplexJobDetail"/> </list> </property> <property name="triggers"> <list> <ref bean="mySimpleTrigger"/> <ref bean="myCronTrigger"/> </list> </property> </bean> 1.MyBean.java import java.text.SimpleDateFormat; import java.util.Date; import org.springframework.stereotype.Component; @Component("myBean") public class MyBean { public void printMessage() { // 打印当前的执行时间,格式为2017-01-01 00:00:00 Date date = new Date(); SimpleDateFormat sf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); System.out.println("MyBean Executes!" + sf.format(date)); } } 2.AnotherBean.java import org.springframework.stereotype.Component; @Component("anotherBean") public class AnotherBean { public void printAnotherMessage() { System.out.println("AnotherMessage"); } } 3.FirstScheduledJob.java import java.text.SimpleDateFormat; import java.util.Date; import org.quartz.JobExecutionContext; import org.quartz.JobExecutionException; import org.springframework.scheduling.quartz.QuartzJobBean; public class FirstScheduledJob extends QuartzJobBean{ private AnotherBean anotherBean; public void setAnotherBean(AnotherBean anotherBean){ this.anotherBean = anotherBean; } @Override protected void executeInternal(JobExecutionContext arg0) throws JobExecutionException { Date date = new Date(); SimpleDateFormat sf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); System.out.println("FirstScheduledJob Executes!" + sf.format(date)); this.anotherBean.printAnotherMessage(); } }

优秀的个人博客,低调大师

Docker技术笔记:Docker入门浅尝

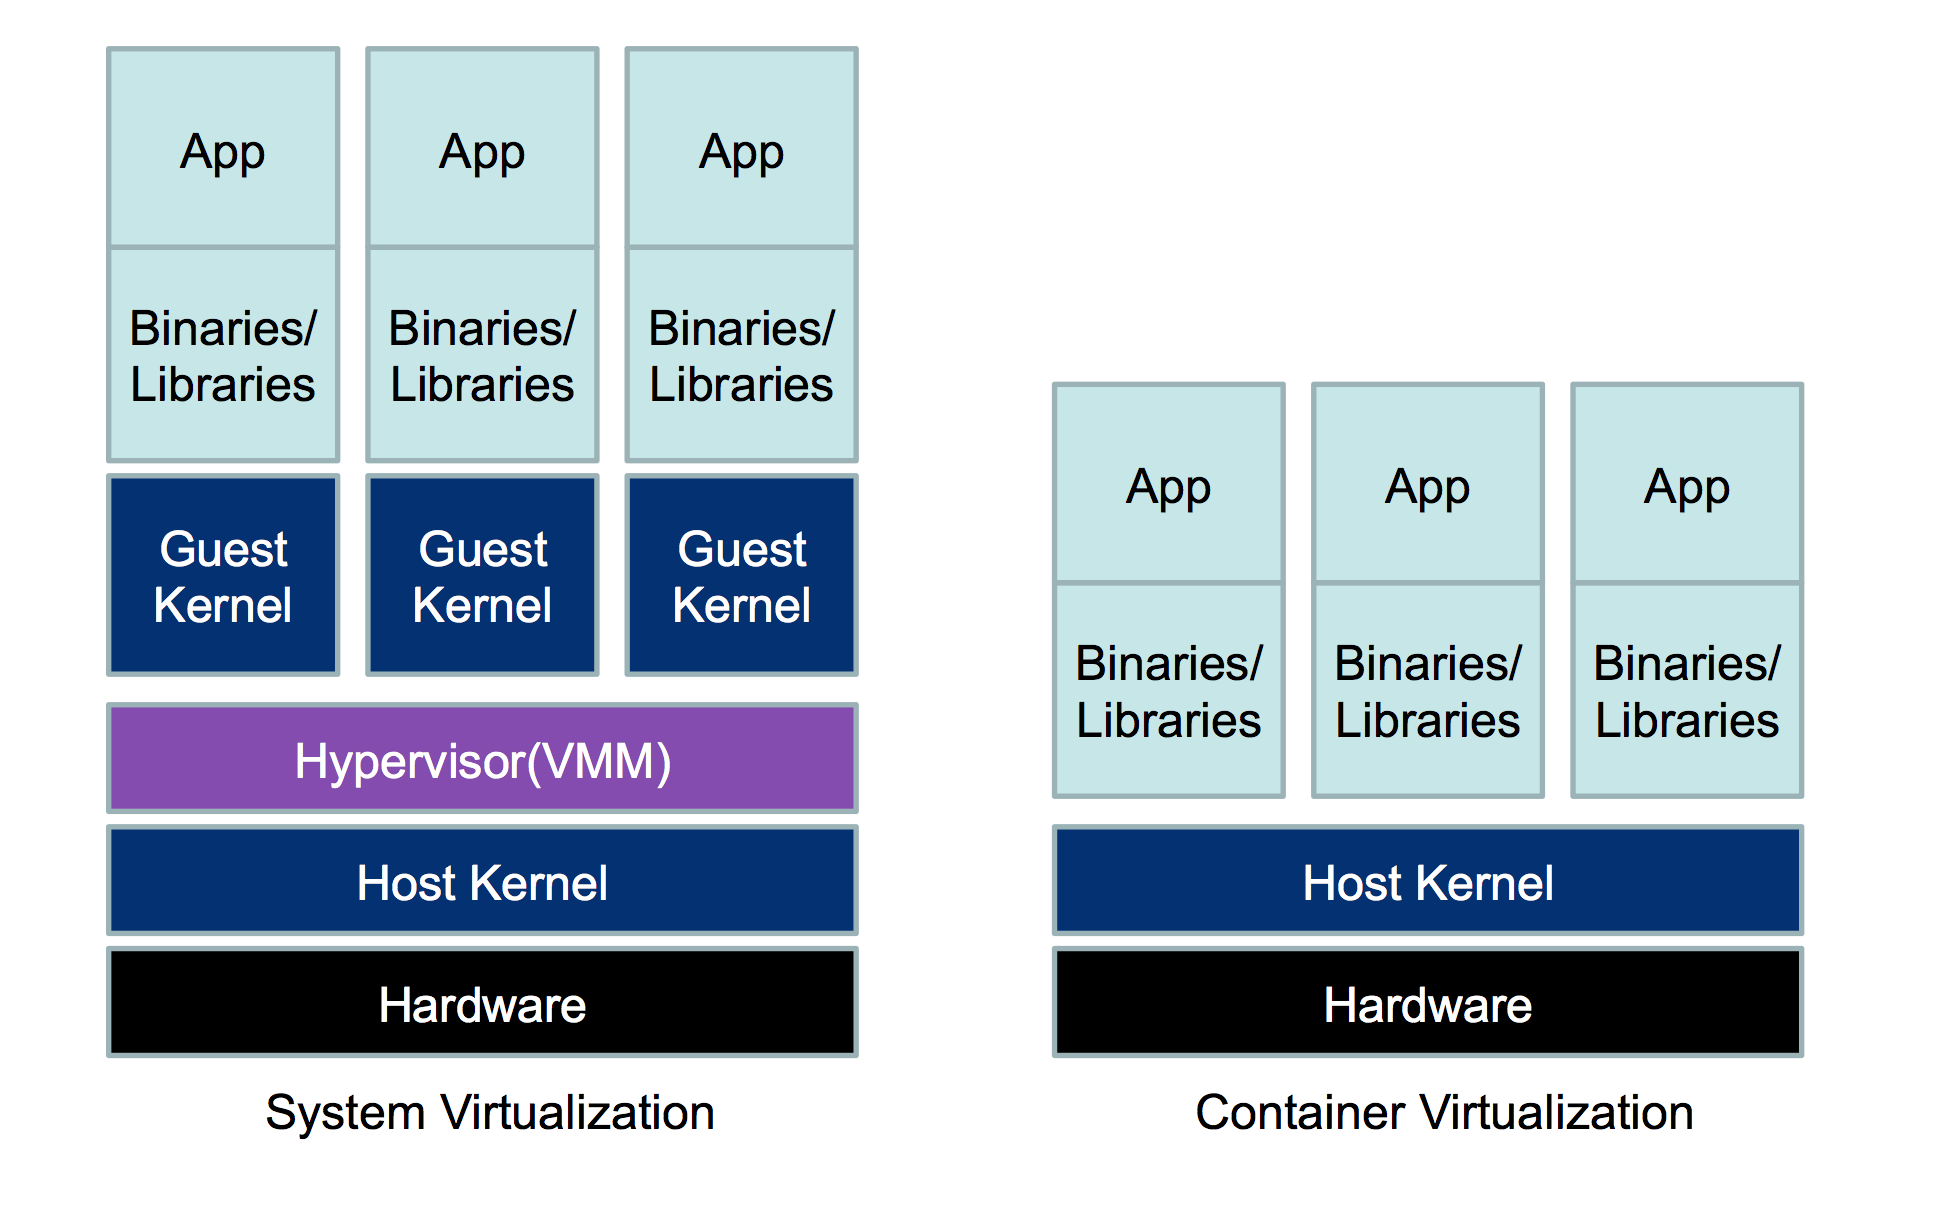
版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/zhaobryant/article/details/79600059 简介 本文将用Docker的方式来构建一个应用APP。 过去,如果要开发一个Python应用APP,所需做的第一件事就是在开发机上安装Python运行时环境。在这种情形下,开发机的环境必须与APP所要求的环境一致,同时还需要与生产环境相匹配。 通过使用Docker,可以将一个可移植的Python运行时环境作为一个image获取,而无需安装。然后,就可以基于Python运行时环境image,将APP代码及其依赖库合并构建,从而简化了应用APP的部署难度。 用Dockerfile定义容器Container Dockerfile是由一系列命令和参数构成的脚本,这些命令应用于基础镜像并最终创建一个新的镜像。它简化了业务部署的流程,大大提高了业务的部署速度。Dockerfile的产出为一个新的可以用于创建容器的镜像。 Dockerfile语法由两部分构成,分别是“注释”和“命令+参数”。 # Line blocks used for commenting COMMAND argument1 argument2 ... 对于Dockerfile,我们首先创建一个空目录,然后cd到该目录,并创建Dockerfile文件。 # Use an official Python runtime as a parent image FROM python:2.7-slim # Set the working directory to /app WORKDIR /app # Copy the current directory contents into the container at /app ADD . /app # Install any needed packages specified in requirements.txt RUN pip install --trusted-host pypi.python.org -r requirements.txt # Make port 80 available to the world outside this container EXPOSE 80 # Define environment variable ENV NAME World # Run app.py when the container launches CMD ["python", "app.py"] 其中,app.py和requirements.txt都位于与Dockerfile相同的目录下,具体如下: zjl@ubuntu:~/docker/pyapp$ ls app.py Dockerfile requirements.txt 对于requirements.txt,其内容如下: Flask Redis 对于app.py,其内容如下: from flask import Flask from redis import Redis, RedisError import os import socket redis = Redis(host="redis", db=0, socket_connect_timeout=2, socket_timeout=2) app = Flask(__name__) @app.route("/") def hello(): try: visits = redis.incr("counter") except RedisError: visits = "<i>cannot connect to Redis, counter disabled</i>" html = "<h3>Hello {name}!</h3>" \ "<b>Hostname:</b> {hostname}<br/>" \ "<b>Visits:</b> {visits}" return html.format(name=os.getenv("NAME", "world"), hostname=socket.gethostname(), visits=visits) if __name__ == "__main__": app.run(host="0.0.0.0", port=80) 现在,我们知道,pip install -r requirements.txt为Python安装了Flask和Redis库,同时APP会打印出环境变量NAME,同时将socket.gethostname()打印出来。 构建新的image镜像 下面,我们进行构建,具体如下: zjl@ubuntu:~/docker/pyapp$ ls app.py Dockerfile requirements.txt zjl@ubuntu:~/docker/pyapp$ sudo docker build -t fhello . Sending build context to Docker daemon 4.608kB Step 1/7 : FROM python:2.7-slim 2.7-slim: Pulling from library/python d2ca7eff5948: Pull complete cef69dd0e5b9: Pull complete 50e1d7e4f3c6: Pull complete 861e9de5333f: Pull complete Digest: sha256:e9baca9b405d3bbba71d4c3c4ce8a461e4937413b8b910cb1801dfac0a2423aa Status: Downloaded newer image for python:2.7-slim ---> 52ad41c7aea4 Step 2/7 : WORKDIR /app ... Step 3/7 : ADD . /app ... Step 4/7 : RUN pip install --trusted-host pypi.python.org -r requirements.txt ... Step 5/7 : EXPOSE 80 ... Step 6/7 : ENV NAME World ... Step 7/7 : CMD ["python", "app.py"] ... Successfully built d3fafd68e807 Successfully tagged fhello:latest zjl@ubuntu:~/docker/pyapp$ sudo docker image ls REPOSITORY TAG IMAGE ID CREATED SIZE fhello latest 12d000cd7a1b 12 minutes ago 148MB 运行新的image镜像 $ sudo docker run -p 4000:80 fhello * Running on http://0.0.0.0:80/ (Press CTRL+C to quit) # 访问该网站 $ curl localhost:4000 <h3>Hello World!</h3><b>Hostname:</b> f4e37f061593<br/><b>Visits:</b> <i>cannot connect to Redis, counter disabled</i> $ sudo docker container ls CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 4a150bdc67cd fhello "python app.py" 10 seconds ago Up 9 seconds 0.0.0.0:4000->80/tcp upbeat_austin 关闭容器,命令如下: $ sudo docker container stop 4a150bdc67cd 4a150bdc67cd 给镜像打上标签 syntax: -->> docker tag image username/repository:tag $ sudo docker tag fhello zhjl/getstarted:alpha-1 $ sudo docker image ls REPOSITORY TAG IMAGE ID CREATED SIZE fhello latest 12d000cd7a1b 18 minutes ago 148MB zhjl/getstarted alpha-1 12d000cd7a1b 18 minutes ago 148MB $ docker run -p 4000:80 zhjl/getstarted:alpha-1 Recap and cheat sheet # Create image using this directory's Dockerfile docker build -t fhello . # Run "friendlyname" mapping port 4000 to 80 docker run -p 4000:80 fhello # Same thing, but in detached mode docker run -d -p 4000:80 fhello # List all running containers docker container ls # List all containers, even those not running docker container ls -a # Gracefully stop the specified container docker container stop <hash> # Force shutdown of the specified container docker container kill <hash> # Remove specified container from this machine docker container rm <hash> # Remove all containers docker container rm $(docker container ls -a -q) # List all images on this machine docker image ls -a # Remove specified image from this machine docker image rm <image id> # Remove all images from this machine docker image rm $(docker image ls -a -q) # Log in this CLI session using your Docker credential docker login # Tag <image> for upload to registry docker tag <image> username/repository:tag # Upload tagged image to registry docker push username/repository:tag # Run image from a registry docker run username/repository:tag

优秀的个人博客,低调大师

Python入门(八)分支与循环

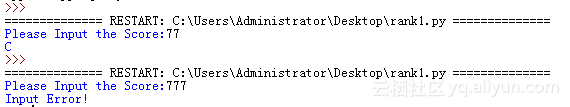
分支 先例 写一个程序,按百分制评等级:[90,100]等级为A,[80,90)等级为B,[60,80)等级为C,[0,60)等级为D,当用户输入分数时,自动转换为ABCD的形式输出。 rank1.py >>> score = int ( input ('Please Input the Score:')) if score < 0 or score > 100: print ('Input Error!') if 90 <= score <= 100: print ('A') if 80 < score <90: print ('B') if 60 < score <=80: print ('C') if 0 <= score <=60: print ('D') F5运行后,输入分数: rank2.py >>> score = int ( input ('Please Input the Score:')) if score < 0 or score > 100: print ('Input Error!') elif 90 <= score <= 100: print ('A') elif 80 < score <90: print ('B') elif 60 < score <=80: print ('C') elif 0 <= score <=60: print ('D') F5运行后,输入分数: rank3.py >>> score = int ( input ('Please Input the Score:')) if score < 0 or score > 100: print ('Input Error!') else: if 90 <= score <= 100: print ('A') else: if 80 < score <90: print ('B') else: if 60 < score <=80: print ('C') else: print ('D') F5运行后,输入分数: rank1 VS rank2 VS rank3 rank1的特点:不论程序执行到哪一步能满足条件,都会把整个程序都走一遍,再输出结果。 rank2的特点:只要程序执行到满足条件的那一步,就会终止程序输出结果,比rank1节省时间。 rank3的特点:与rank2的执行方式一样,只是运用了python中特有的elif语句,简洁明了!rank2体现了python中的缩进机制,完美的避开了,在其他语言中经常会掉的坑。 悬挂else 像C语言中有如下代码: if (a > 0) if (b > 0) printf("^_^") else printf("&-&"); 请问else是和哪个if搭配的呢?对和第二个if搭配!BUT,在大量代码面前,这种框架的关键字像沧海一粟,找起来很费劲。所以,悬挂else的问题在python中完全不存在。 条件表达式(三元操作符) 买家秀: x,y = 1,2 if x < y: print('min =',x) else: print('min =',y) F5运行后得: 卖家秀: x,y =1,2 print('min =', x if x < y else y) F5运行后得:即使得到相同的结果,过程仍可能有很大的差别!由上述对比可知,条件表达式的语法为: x if 条件 else y 当条件为真时,程序将返回x的值,反之,返回y的值。 断言(assert) >>> assert 1 > 2 Traceback (most recent call last): File "<pyshell#8>", line 1, in <module> assert 1 > 2 AssertionError 由此异常可知,关键字 assert 后的条件为假时程序便会产生AssertionError,所以说,当我们需要确保程序中的某一个条件一定为真才能让程序正常工作的话时,用assert在程序中置入检查点。 循环 while 循环 while 条件: 循环体 只要条件为真,程序就会一直执行循环体。 while 1: str1=str(input("你现在有什么想法:")) print("原来你很",str1,"呀!") for 循环 for 目标 in 表达式: 循环体 目标是指变量,表达式可为序列,可以是列表也可以是字符串。 >>> players = ['网易云音乐','酷狗音乐','QQ音乐'] >>> for player in players: print ('安装:',player,len(player)) 安装: 网易云音乐 5 安装: 酷狗音乐 4 安装: QQ音乐 4 for 与很多BIF连用时会实现各种各样的功能,这里以range([star,]stop[,step=1])为例: >>> for i in range(1,10,2): print(i) 1 3 5 7 break和continue 关键字break的作用是终止当前循环,跳出循环体。 >>> for i in '123456789': if i == '7': break print(i) 1 2 3 4 5 6 关键字continue的作用是终止当前循环,开始下次循环。 >>> for i in '123456789': if i == '7': continue print(i) 1 2 3 4 5 6 8 9 需要注意,循环语句可以有 else 子句,它在穷尽列表(以for循环)或条件变为 false (以while循环)导致循环终止时被执行,但循环被break终止时不执行。 >>> for i in range(1,10): for x in range(2,i): if i % x == 0: print(i,'能分解成',x,'*',i//x) break else: print(i,'是质数!') 1 是质数! 2 是质数! 3 是质数! 4 能分解成 2 * 2 5 是质数! 6 能分解成 2 * 3 7 是质数! 8 能分解成 2 * 4 9 能分解成 3 * 3 END!

优秀的个人博客,低调大师

【入门指南】操作阿里云Kibana

Elastic公司的“ELK”是目前最火的日志分析三剑客,其中ElasticSearch负责日志的索引,Logstash负责日志的收集,Kibana负责日志的展示和分析。事实上并不局限于日志分析,ELK技术栈同样适用于通用的数据采集、索引、分析业务,不可谓不强大。 Elastic与阿里云达成了合作伙伴关系,推出“阿里云 Elasticsearch”服务,提供了开箱即用的Elasticsearch和Kibana环境,方便我们快速搭建数据分析平台。下面我们将手把手演示一下如何在阿里云上创建并使用ElasticSearch服务。 首先,我们创建阿里云Elasticsearch服务,阿里云提供了一个月的免费体验服务。如图,选择自己服务器所在的区域、VPC以及下面的虚拟交换机。对于大规模集群,可以勾选dedicated master,专用主节点

优秀的个人博客,低调大师

SQLite入门与分析(一)---简介

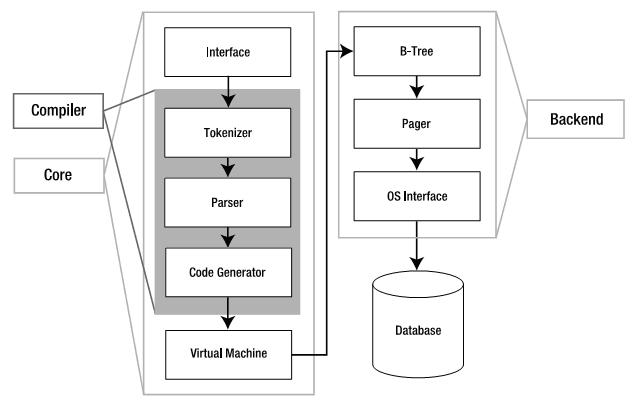
写在前面:出于项目的需要,最近打算对SQLite的内核进行一个完整的剖析,在此希望和对SQLite有兴趣的一起交流。我知道,这是一个漫长的过程,就像曾经去读Linux内核一样,这个过程也将是辛苦的,但我相信结果一定是美好的... ...接下来是第一章。 1、SQLite介绍 自几十年前出现的商业应用程序以来,数据库就成为软件应用程序的主要组成部分。正与数据库管理系统非常关键一样,它们也变得非常庞大,并占用了相当多的系统资源,增加了管理的复杂性。随着软件应用程序逐渐模块模块化,一种新型数据库会比大型复杂的传统数据库管理系统更适应。嵌入式数据库直接在应用程序进程中运行,提供了零配置(zero-configuration)运行模式,并且资源占用非常少。SQLite是一个开源的嵌入式关系数据库,它在2000年由D. Richard Hipp发布,它的减少应用程序管理数据的开销,SQLite可移植性好,很容易使用,很小,高效而且可靠。SQLite嵌入到使用它的应用程序中,它们共用相同的进程空间,而不是单独的一个进程。从外部看,它并不像一个RDBMS,但在进程内部,它却是完整的,自包含的数据库引擎。 嵌入式数据库的一大好处就是在你的程序内部不需要网络配置,也不需要管理。因为客户端和服务器在同一进程空间运行。SQLite 的数据库权限只依赖于文件系统,没有用户帐户的概念。SQLite 有数据库级锁定,没有网络服务器。它需要的内存,其它开销很小,适合用于嵌入式设备。你需要做的仅仅是把它正确的编译到你的程序。 2、架构(architecture) SQLite采用了模块的设计,它由三个子系统,包括8个独立的模块构成。2.1、接口(Interface)接口由SQLite C API组成,也就是说不管是程序、脚本语言还是库文件,最终都是通过它与SQLite交互的(我们通常用得较多的ODBC/JDBC最后也会转化为相应C API的调用)。2.2、编译器(Compiler)在编译器中,分词器(Tokenizer)和分析器(Parser)对SQL进行语法检查,然后把它转化为底层能更方便处理的分层的数据结构---语法树,然后把语法树传给代码生成器(code generator)进行处理。而代码生成器根据它生成一种针对SQLite的汇编代码,最后由虚拟机(Virtual Machine)执行。2.3、虚拟机(Virtual Machine)架构中最核心的部分是虚拟机,或者叫做虚拟数据库引擎(Virtual Database Engine,VDBE)。它和Java虚拟机相似,解释执行字节代码。VDBE的字节代码由128个操作码(opcodes)构成,它们主要集中在数据库操作。它的每一条指令都用来完成特定的数据库操作(比如打开一个表的游标)或者为这些操作栈空间的准备(比如压入参数)。总之,所有的这些指令都是为了满足SQL命令的要求(关于VM,后面会做详细介绍)。2.4、后端(Back-End)后端由B-树(B-tree),页缓存(page cache,pager)和操作系统接口(即系统调用)构成。B-tree和page cache共同对数据进行管理。B-tree的主要功能就是索引,它维护着各个页面之间的复杂的关系,便于快速找到所需数据。而pager的主要作用就是通过OS接口在B-tree和Disk之间传递页面。3、SQLite的特点(SQLite’s Features and Philosophy)3.1、零配置(Zero Configuration)3.2、可移植(Portability):它是运行在Windows,Linux,BSD,Mac OS X和一些商用Unix系统,比如Sun的Solaris,IBM的AIX,同样,它也可以工作在许多嵌入式操作系统下,比如QNX,VxWorks,Palm OS, Symbin和Windows CE。3.3、Compactness:SQLite是被设计成轻量级,自包含的。one header file, one library, and you’re relational, no external database server required3.4、简单(Simplicity)3.5、灵活(Flexibility)3.6、可靠(Reliability):SQLite的核心大约有3万行标准C代码,这些代码都是模块化的,很容易阅读。 主要参考:The Definitive Guide to SQLite

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册