首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

Python 系统编程 (全)

进程 1.进程 简单的说就是实现唱歌跳舞同时进行,那么就需要一个新的方法,叫做:多任务 2.多任务的概念 ①简单地说,就是操作系统可以同时运行多个任务 ②并行执行多任务只能在多核CPU上实现,但是,由于任务数量远远多于CPU的核心数量,所以,操作系统也会自动把很多任务轮流调度到每个核心上执行 ③就是说当cpu核心数量大于任务数量就是并行,反过来,就是并发 ④依照的规则有时间片轮转,优先级调度 3.进程的创建-fork ①程序:编写完毕的代码,在没有运行的时候,称之为程序 ②进程:正在运行着的代码,还有需要运行的环境等 ③fork( ): Python的os模块封装了常见的系统调用,其中就包括fork importos #注意,fork函数,只在Unix/Linux/Mac上运行,windows不可以 pid=os.fork() ifpid==0: print('哈哈1') else: print('哈哈2') #程序执行到os.fork()时,操作系统会创建一个新的进程(子进程),然后复制父进程的所有信息到子进程中 #然后父进程和子进程都会从fork()函数中得到一个返回值,在子进程中这个值一定是0,而父进程中是子进程的id号 #普通的函数调用,调用一次,返回一次,但是fork()调用一次,返回两次,因为操作系统自动把当前进程(称为父进程)复制了一份(称为子进程),然后,分别在父进程和子进程内返回 #getpid()是获取当前进程(主进程或子进程)的id、getppid()获取父进程的id 4.多进程修改全局变量 多进程中,每个进程中所有数据(包括全局变量)都各有拥有一份,互不影响,所以在修改全局变量的时候,两个变量相互独立 5.多次fork问题 下次遇到多进程就画图,再如: os.fork() os.fork() os.fork()#就变成了8个进程 在while True中,如果有os.fork(),程序一定崩,这就相当于fork炸弹,死循环创建进程 6.multiprocessing模块 ①multiprocessing模块提供了一个Process类来代表一个进程对象 ②跨平台的操作,fork只在linux下才有效,所以平时应该使用process,它是一个类 程序如下: frommultiprocessingimportProcess importtime deftest(): whileTrue: print("---test---") time.sleep(1) P=Process(target=test) P.start()#让这个进程开始执行test函数里的代码 whileTrue: print("---main---") time.sleep(1) 说明: #创建子进程时,只需要传入一个执行函数和函数的参数,创建一个Process实例,用start()方法启动 #这样创建进程比fork()还要简单 #join()方法可以等待子进程结束后再继续往下运行,通常用于进程间的同步,这就与fork不同,需要等子进程结束,主进程才可以结束 7.Process语法结构 Process([group[,target[,name[,args[,kwargs]]]]]) ①target:表示这个进程实例所调用对象; ②args:表示调用对象的位置参数元组; ③kwargs:表示调用对象的关键字参数字典; ④name:为当前进程实例的别名; ⑤group:大多数情况下用不到; 8.Process类常用方法 ①is_alive():判断进程实例是否还在执行; ②join([timeout]):是否等待进程实例执行结束,或等待多少秒; ③start():启动进程实例(创建子进程); ④run():如果没有给定target参数,对这个对象调用start()方法时,就将执行对象中 的run()方法; ⑤terminate():不管任务是否完成,立即终止; 9.Process类常用属性 ①name:当前进程实例别名,默认为Process-N,N为从1开始递增的整数; ②pid:当前进程实例的PID值 ③进程的创建-Process子类: 创建新的进程还能够使用类的方式,可以自定义一个类,继承Process类,每次实例化这个类的时候,就等同于实例化一个进程对象 如果想知道程序的运行时间,可以用开始和结束的time.time()两个时间差,就代表运行时间 10.进程池pool ①当需要创建的子进程数量不多时,可以直接利用multiprocessing中的Process动态成生多个进程 ②但如果是上百甚至上千个目标,手动的去创建进程的工作量巨大,此时就可以用到multiprocessing模块提供的Pool方法 P0=Pool(3)#定义一个进程池,最大进程数3 foriinrange(0,10): #Pool.apply_async(要调用的目标,(传递给目标的参数元组,))(非堵塞式) #Pool.apply(worker,(i,))(堵塞式),主进程卡在这里,需要等子进程完成才能添加 #每次循环将会用空闲出来的子进程去调用目标 P0.apply_async(worker,(i,))#work是一个函数 P0.close()#关闭进程池,关闭后po不再接收新的请求 P0.join()#等待po中所有子进程执行完成,必须放在close语句之后 11.多种创建进程的方式比较 os.fork()中,子进程和父进程可以都执行,而且父进程可以不必等待子进程结束 p=process(target=xxx) p.start() #子进程和父进程都可执行 pool=Pool(3) pool.apply_async(xxx) #主进程一般用来等待,真正的任务都在子进程中执行 12.进程间通信-Queue ①Process之间有时需要通信,操作系统提供了很多机制来实现进程间的通信。 ②Queue的使用: 可以使用multiprocessing模块的Queue实现多进程之间的数据传递,Queue本身是一个消息列队程序 队列:先进先出 栈:先进后出 初始化Queue()对象时(例如:q=Queue()),若括号中没有指定最大可接收的消息数量,或数量为负值,那么就代表可接受的消息数量没有上限(直到内存的尽头) frommultiprocessingimportQueue q=Queue(3)#初始化一个Queue对象,最多可接收三条put消息 try: q.put_nowait("消息4") except: print("消息列队已满,现有消息数量:%s"%q.qsize()) Queue.qsize():返回当前队列包含的消息数量; Queue.empty():如果队列为空,返回True,反之False; Queue.full():如果队列满了,返回True,反之False; Queue.get([block[, timeout]]):获取队列中的一条消息,然后将其从列队中移除,block默认值为True Queue.get_nowait():相当Queue.get(False);应该把它放在try里面 Queue.put(item,[block[, timeout]]):将item消息写入队列,block默认值为True ③进程池中的Queue: 如果要使用Pool创建进程,就需要使用multiprocessing.Manager()中的Queue(),而不是multiprocessing.Queue() 13.孤儿进程和僵尸进程 ①孤儿进程:是指父进程结束,但子进程还未结束,通常的情况下父进程可以清除子进程 的垃圾,表示子进程没人收尸了 ②僵尸进程:是指子进程结束了,父进程还未结束 ③一般在操作系统中,0号进程负责切换任务,1号进程负责生子进程,并负责打理孤儿进程 线程 1.多线程threading python的thread模块是比较底层的模块,python的threading模块是对thread做了一些包装的,可以更加方便的被使用 2.进程和线程的关系 ①线程是进程里面一种真正执行代码的东西,类似进程里面的箭头 ②进程是资源分配的单位,线程是cpu调度的单位 ③进程,能够完成多任务,比如 在一台电脑上能够同时运行多个QQ ④线程,能够完成多任务,比如 一个QQ中的多个聊天窗口 ⑤定义的不同: 进程是系统进行资源分配和调度的一个独立单位. 线程是进程的一个实体,是CPU调度和分派的基本单位,它是比进程更小的能独立运行的基本单位 线程自己基本上不拥有系统资源,只拥有一点在运行中必不可少的资源(如程序计数器,一组寄存器和栈), 但是它可与同属一个进程的其他的线程共享进程所拥有的全部资源 ⑥区别: 一个程序至少有一个进程,一个进程至少有一个线程 线程的划分尺度小于进程(资源比进程少),使得多线程程序的并发性高 进程在执行过程中拥有独立的内存单元,而多个线程共享内存,从而极大地提高了程序的运行效率 线程不能够独立执行,必须依存在进程中 ⑦优缺点: 线程和进程在使用上各有优缺点:线程执行开销小,但不利于资源的管理和保护;而进程正相反 3.多线程执行 importthreading importtime defsaySorry(): print("Python才是最好的语言") time.sleep(1) if__name__=="__main__": foriinrange(5): t=threading.Thread(target=saySorry) t.start()#启动线程,即让线程开始执行 说明: #可以明显看出使用了多线程并发的操作,花费时间要短很多 #创建好的线程,需要调用start()方法来启动 #主线程会等待所有的子线程结束后才结束 4.线程执行代码的封装 ①通过使用threading模块能完成多任务的程序开发,为了让每个线程的封装性更完美,所以使用threading模块时,往往会定义一个新的子类class,只要继承threading.Thread就可以了,然后重写 run方法 ②python的threading.Thread类有一个run方法,用于定义线程的功能函数,可以在自己的线程类中覆盖该方法。而创建自己的线程实例后,通过Thread类的start方法,可以启动该线程,交给python 虚拟机进行调度,当该线程获得执行的机会时,就会调用run方法执行线程 ③多线程程序的执行顺序与多进程类似,都是不确定的 5.总结 ①每个线程一定会有一个名字,尽管上面的例子中没有指定线程对象的name,但是python会自动为线程指定一个名字。 ②当线程的run()方法结束时该线程完成。 ③无法控制线程调度程序,但可以通过别的方式来影响线程调度的方式 6.多线程-共享全局变量 ①在一个进程内的所有线程共享全局变量,能够在不适用其他方式的前提下完成多线程之间的数据共享(这点要比多进程要好) ②缺点就是,线程是对全局变量随意遂改可能造成多线程之间对全局变量的混乱(即线程非安全),在线程中,不能同时对全局变量进行修改,解决办法是轮流让线程进行修改 7.同步 ①多线程开发可能遇到的问题 ②假设两个线程t1和t2都要对num=0进行增1运算,t1和t2都各对num修改10次, num的最终的结果应该为20。但是由于是多线程访问,答案可能不一样,所以在修改时, 就要让其修改完再轮到下一个线程来修改 ③什么是同步: 同步就是协同步调,按预定的先后次序进行运行。如:你说完,我再说,"同"字从字面上 容易理解为一起动作其实不是,"同"字应是指协同、协助、互相配合 ④解决问题的思路: 系统调用t1,然后获取到num的值为0,此时上一把锁,即不允许其他现在操作num 对num的值进行+1解锁,此时num的值为1,其他的线程就可以使用num了,而且是 num的值不是0而是1 同理其他线程在对num进行修改时,都要先上锁,处理完后再解锁,在上锁的整个过程 中不允许其他线程访问,就保证了数据的正确性 8.互斥锁 ①当多个线程几乎同时修改某一个共享数据的时候,需要进行同步控制 ②某个线程要更改共享数据时,先将其锁定,此时资源的状态为锁定,其他线程不能更改;直到该线程释放资源,将资源的状态变成非锁定,其他的线程才能再次锁定该资源。互斥锁保证了每次 只有一个线程进行写入操作,从而保证了多线程情况下数据的正确性 ③threading模块中定义了Lock类,可以方便的处理锁定: #创建锁 mutex=threading.Lock() #锁定 mutex.acquire([blocking]) #释放 mutex.release() ④如果设定blocking为True,则当前线程会堵塞,直到获取到这个锁为止(如果没有指定,那么默认为True)如果设定blocking为False,则当前线程不会堵塞 ⑤上锁解锁过程: 每次只有一个线程可以获得锁。如果此时另一个线程试图获得这个锁,该线程就会变为 &ldquo;blocked&rdquo; 状态,称为&ldquo;阻塞&rdquo;,直到拥有锁的线程调用锁的release()方法释放锁之后,锁进 入 &ldquo;unlocked&rdquo;状态。 线程调度程序从处于同步阻塞状态的线程中选择一个来获得锁,并使得该线程进入运行( running)状态。 ⑥总结: 锁的好处: 确保了某段关键代码只能由一个线程从头到尾完整地执行 锁的坏处: 阻止了多线程并发执行,包含锁的某段代码实际上只能以单线程模式执行,效率就大大地下降了 由于可以存在多个锁,不同的线程持有不同的锁,并试图获取对方持有的锁时, 可能会造成死锁 9.多线程-非共享数据 ①对于全局变量,在多线程中要格外小心,否则容易造成数据错乱的情况发生 ②在多线程开发中,全局变量是多个线程都共享的数据,而局部变量等是各自线程的,是非共享的 10.死锁 ①举个例子:就好比是现实社会中,男女双方都在等待对方先道歉 ②在线程间共享多个资源的时候,如果两个线程分别占有一部分资源并且同时等待对方的资源,就会造成死锁 ③避免死锁: #程序设计时要尽量避免(银行家算法) #添加超时时间等 ifmutex.acquire(2): 11.同步应用 可以使用互斥锁完成多个任务,有序的进程工作,这就是线程的同步 12.生产者与消费者模式 ①Python的Queue模块中提供了同步的、线程安全的队列类,包括FIFO(先入先出)队列 Queue,LIFO(后入先出)队列LifoQueue,和优先级队列PriorityQueue ②这些队列都实现了锁原语(可以理解为原子操作,即要么不做,要么就做完),能够在多线程中直接使用 ③可以使用队列来实现线程间的同步 ④Queue的说明: 对于Queue,在多线程通信之间扮演重要的角色 添加数据到队列中,使用put()方法 从队列中取数据,使用get()方法 判断队列中是否还有数据,使用qsize()方法 队列就是用来给生产者和消费者解耦的 13.ThreadLocal 在多线程环境下,每个线程都有自己的数据。一个线程使用自己的局部变量比使用全局变量好,因为局部变量只有线程自己能看见,不会影响其他线程,而全局变量的修改必须加锁一个thread.local()变量虽然是全局变量,但每个线程都只能读写自己线程的独立副本,互不干扰。thread.local()解决了参数在一个线程中各个函数之间互相传递的问题 14.异步 ①同步调用就是你喊你朋友吃饭,你朋友在忙,你就一直在那等,等你朋友忙完了,你们一起去 ②异步调用就是你喊你朋友吃饭,你朋友说知道了,待会忙完去找你 ,你就去做别的了 pool.apply_async(func=test,callback=test2)#callback是回调 进程整理代码 1. getpid()、getppid() importos rpid=os.fork() ifrpid<0: print("fork调用失败") elifrpid==0: print("我是子进程(%s),我的父进程是(%s)"%(os.getpid(),os.getppid())) x+=1 else: print("我是父进程(%s),我的子进程是(%s)"%(os.getpid(),rpid)) print("父子进程都可以执行这里的代码") 2.多进程修改全局变量 importos importtime num=0 #注意,fork函数,只在Unix/Linux/Mac上运行,windows不可以 pid=os.fork() ifpid==0: num+=1 print('哈哈1---num=%d'%num) else: time.sleep(1) num+=1 print('哈哈2---num=%d'%num) 3.进程的创建-Process子类 frommultiprocessingimportProcess importtime importos #继承Process类 classProcess_Class(Process): #因为Process类本身也有__init__方法,这个子类相当于重写了这个方法, #但这样就会带来一个问题,我们并没有完全的初始化一个Process类,所以就不能使用从这个类继承的一些方法和属性, #最好的方法就是将继承类本身传递给Process.__init__方法,完成这些初始化操作 def__init__(self,interval): Process.__init__(self) self.interval=interval #重写了Process类的run()方法 defrun(self): print("子进程(%s)开始执行,父进程为(%s)"%(os.getpid(),os.getppid())) t_start=time.time() time.sleep(self.interval) t_stop=time.time() print("(%s)执行结束,耗时%0.2f秒"%(os.getpid(),t_stop-t_start)) if__name__=="__main__": t_start=time.time() print("当前程序进程(%s)"%os.getpid()) p1=Process_Class(2) #对一个不包含target属性的Process类执行start()方法,就会运行这个类中的run()方法,所以这里会执行p1.run() p1.start() p1.join() t_stop=time.time() print("(%s)执行结束,耗时%0.2f"%(os.getpid(),t_stop-t_start)) 4.进程池pool frommultiprocessingimportPool importos,time,random defworker(msg): t_start=time.time() print("%s开始执行,进程号为%d"%(msg,os.getpid())) #random.random()随机生成0~1之间的浮点数 time.sleep(random.random()*2) t_stop=time.time() print(msg,"执行完毕,耗时%0.2f"%(t_stop-t_start)) po=Pool(3)#定义一个进程池,最大进程数3 foriinrange(0,10): #Pool.apply_async(要调用的目标,(传递给目标的参数元祖,)) #每次循环将会用空闲出来的子进程去调用目标 po.apply_async(worker,(i,)) print("----start----") po.close()#关闭进程池,关闭后po不再接收新的请求 po.join()#等待po中所有子进程执行完成,必须放在close语句之后 print("-----end-----") 5.进程Queue的读写 frommultiprocessingimportProcess,Queue importos,time,random #写数据进程执行的代码: defwrite(q): forvaluein['A','B','C']: print'Put%stoqueue...'%value q.put(value) time.sleep(random.random()) #读数据进程执行的代码: defread(q): whileTrue: ifnotq.empty(): value=q.get(True) print'Get%sfromqueue.'%value time.sleep(random.random()) else: break if__name__=='__main__': #父进程创建Queue,并传给各个子进程: q=Queue() pw=Process(target=write,args=(q,)) pr=Process(target=read,args=(q,)) #启动子进程pw,写入: pw.start() #等待pw结束: pw.join() #启动子进程pr,读取: pr.start() pr.join() #pr进程里是死循环,无法等待其结束,只能强行终止: print''" print'所有数据都写入并且读完' 线程整理代码 1.多线程 importthreading fromtimeimportsleep,ctime defsing(): foriinrange(3): print("正在唱歌...%d"%i) sleep(1) defdance(): foriinrange(3): print("正在跳舞...%d"%i) sleep(1) if__name__=='__main__': print('---开始---:%s'%ctime()) t1=threading.Thread(target=sing) t2=threading.Thread(target=dance) t1.start() t2.start() #sleep(5)#屏蔽此行代码,试试看,程序是否会立马结束? print('---结束---:%s'%ctime()) 2.多线程-共享全局变量 fromthreadingimportThread importtime g_num=100 defwork1(): globalg_num foriinrange(3): g_num+=1 print("----inwork1,g_numis%d---"%g_num) defwork2(): globalg_num print("----inwork2,g_numis%d---"%g_num) print("---线程创建之前g_numis%d---"%g_num) t1=Thread(target=work1) t1.start() #延时一会,保证t1线程中的事情做完 time.sleep(1) t2=Thread(target=work2) t2.start() 3.死锁 importthreading importtime classMyThread1(threading.Thread): defrun(self): ifmutexA.acquire(): print(self.name+'----do1---up----') time.sleep(1) ifmutexB.acquire(): print(self.name+'----do1---down----') mutexB.release() mutexA.release() classMyThread2(threading.Thread): defrun(self): ifmutexB.acquire(): print(self.name+'----do2---up----') time.sleep(1) ifmutexA.acquire(): print(self.name+'----do2---down----') mutexA.release() mutexB.release() mutexA=threading.Lock() mutexB=threading.Lock() if__name__=='__main__': t1=MyThread1() t2=MyThread2() t1.start() t2.start() 4.生产者和消费者模式 importthreading importtime #python2中 fromQueueimportQueue #python3中 #fromqueueimportQueue classProducer(threading.Thread): defrun(self): globalqueue count=0 whileTrue: ifqueue.qsize()<1000: foriinrange(100): count=count+1 msg='生成产品'+str(count) queue.put(msg) print(msg) time.sleep(0.5) classConsumer(threading.Thread): defrun(self): globalqueue whileTrue: ifqueue.qsize()>100: foriinrange(3): msg=self.name+'消费了'+queue.get() print(msg) time.sleep(1) if__name__=='__main__': queue=Queue() foriinrange(500): queue.put('初始产品'+str(i))

优秀的个人博客,低调大师

初学Python——Socket网络编程

认识socket socket本质上就是在2台网络互通的电脑之间,架设一个通道,两台电脑通过这个通道来实现数据的互相传递。我们知道网络 通信 都 是基于 ip+port(端口) 方能定位到目标的具体机器上的具体服务,操作系统有0-65535个端口,每个端口都可以独立对外提供服务,如果 把一个公司比做一台电脑 ,那公司的总机号码就相当于ip地址, 每个员工的分机号就相当于端口, 你想找公司某个人,必须 先打电话到总机,然后再转分机 。 建立一个socket必须至少有2端, 一个服务端,一个客户端, 服务端被动等待并接收请求,客户端主动发起请求, 连接建立之后,双方可以互发数据。 基本参数 Socket Families(地址簇) socket.AF_UNIX 本机进程间通信 socket.AF_INET IPV4(默认) socket.AF_INET6 IPV6 Socket Types(类型) socket.SOCK_STREAM 流式socket,代表TCP协议(默认) socket.SOCK_DGRAM 数据报式socket,代表UDP协议 socket方法 sk = socket.socket(family=AF_INET,type=SOCK_STREAM,proto=0,fileno=None) 建立socket连接对象 sk.bind(address) s.bind(address) 将套接字绑定到地址。address地址的格式取决于地址族。在AF_INET下,以元组(host,port)的形式表示地址。 sk.listen(backlog) 开始监听传入连接。backlog指定在拒绝连接之前,可以挂起的最大连接数量。 backlog等于5,表示内核已经接到了连接请求,但服务器还没有调用accept进行处理的连接个数最大为5 这个值不能无限大,因为要在内核中维护连接队列 sk.setblocking(bool) 是否阻塞(默认True),如果设置False,那么accept和recv时一旦无数据,则报错。 sk.accept() 接受连接并返回(conn,address),其中conn是新的套接字对象,可以用来接收和发送数据。address是连接客户端的地址。 接收TCP 客户的连接(阻塞式)等待连接的到来 sk.connect(address) 连接到address处的套接字。一般,address的格式为元组(hostname,port),如果连接出错,返回socket.error错误。 sk.connect_ex(address) 同上,只不过会有返回值,连接成功时返回 0 ,连接失败时候返回编码,例如:10061 sk.close() 关闭套接字 sk.recv(bufsize[,flag]) 接受套接字的数据。数据以字符串形式返回,bufsize指定最多可以接收的数量。flag提供有关消息的其他信息,通常可以忽略。 sk.recvfrom(bufsize[.flag]) 与recv()类似,但返回值是(data,address)。其中data是包含接收数据的字符串,address是发送数据的套接字地址。 sk.send(string[,flag]) 将string中的数据发送到连接的套接字。返回值是要发送的字节数量,该数量可能小于string的字节大小。即:可能未将指定内容全部发送。 sk.sendall(string[,flag]) 将string中的数据发送到连接的套接字,但在返回之前会尝试发送所有数据。成功返回None,失败则抛出异常。 内部通过递归调用send,将所有内容发送出去。 服务端步骤: 步骤:1.server = socket.socket() 声明实例,生成连接对象2.server.bind() 绑定要监听的端口3.server.listen() 开始监听4.conn,addr = server.accept()等待客户端发起连接,阻塞5.接收数据(发送数据)6.当客户端断开连接后,继续监听等待下一个客户端建立连接……关闭连接对象 代码示例: import socket "服务器端" server = socket.socket() # 生成连接对象 server.bind(("localhost",6000)) # 绑定要监听的端口 server.listen(5) # 开始监听(最大允许挂起的连接) while True: print("\n服务器在等待...") conn,addr = server.accept() # 等待客户端发起建立连接,起到阻塞作用 # conn 是客户端链接过来而在服务器端为其生成的连接实例,addr是IP地址+端口 print("已成功连接") print("连接对象:{0},地址:{1}\n".format(conn,addr)) while True: try: data = conn.recv(1024) # 接收数据 # (如果客服端断开连接,此步骤将会被无限循环操作,所以一定要有检查机制) if data != b"000001": # 接收到的信号不是"000001"的话就正常执行 print("接收客户端信息:", data.decode()) msg = input(">>输入返回客户端的数据:") conn.send(msg.encode(encoding="utf-8")) # 向客户端发送数据 else: print("该客户已主动断开连接") break except ConnectionResetError as e: print("该客户机异常!已被强迫断开连接",e) break else: print("It's OK !") server.close() 客户端步骤: 步骤:1.client = socket.socket() 声明实例,生成连接对象2.client.connect() 与服务器建立连接3.与服务器交互(发送接收数据)4.client.close() 断开连接 代码示例: import socket "通信案例客户端消息接收与发送" client = socket.socket() # 声明socket类型,并生成socket连接对象 try: client.connect(("localhost",6000)) # 与服务器建立连接 while True: msg = input(">>输入要向服务器发送的信息:") client.send(msg.encode(encoding="utf-8")) # 向服务器发送信息(只能发送bytes字节类型,不能是str字符类型) data = client.recv(1024) # 接收来自服务器的1024个字节 print("接收来自服务器的数据:",data.decode()) # 打印服务器发送的数据 chioce = input("按任意键继续,按0退出客户端") if chioce == "0": client.send(b"000001") # 发送此信号表明客户端要断开连接 break client.close() except ConnectionRefusedError as e: print("服务器还没开机!请静候") 需要注意的是: 1.客户端再发送数据时,要主要服务器接收的大小限制。如果超过了这个限制,超出的部分暂时存在系统缓冲区,第二次接收的时候再输出剩下的部分。例如服务器端的recv(1024),而客户端一次发了2024字节,那么剩下的1000字节存在缓冲区,第二次接收的时候会接收缓冲区的内容,将不会接收新发来的数据,会造成数据错误。官方建议一次性不超过8192字节 2.双发收发数据只能是bytes类型 3.粘包问题,下面讲 socket粘包问题 什么是粘包呢?我们知道发送数据,并且数据量比较大时,并不会一次性发送,即使能一次发送,客户端也不一定能一次性接收,所以服务器有个缓冲区,等客户端下次再接收数据的时候再发送给客户端,所以,就需要将数据分成几次发送,客户端分成几次接收。那又出来问题了,客户端知道数据(文件)有多大么?它怎么知道要接收几次?当然是要服务器告诉他啦! 于是,我们设计服务器首先发送数据大小(数据),再开始分批发送数据,客户端先接收文件大小(数据),再开始分批接收。问题就有可能在这里出现了。如果连续2次send数据,很有可能将两次的数据黏在一起发送出去,在客户端也无法将其分开,怎么办呢? 我们可以让服务器每次发送数据后,接收来自客户端的确认,这样会强制清空缓冲区,就不会造成粘包。当然,基于上面讲的方法,只需要在发送正式数据之前接收确认就好。 最后,如果希望100%确认双发收发数据是否一致,可以采用MD5校验。 服务器端步骤: 1.读取文件名2.检测文件是否存在3.打开文件4.检测文件大小5.将文件大小发给客户端6.确认7.开始边读边发(循环发送)8.发送MD5 代码: import socket,os,hashlib ser = socket.socket() ser.bind(("localhost",5000)) ser.listen() while True: try: print("正在等待客户端连接...") conn,addr = ser.accept() print("已连接,new conn:",addr) while True: data = conn.recv(8192) filename = data.decode() print("寻找文件",filename) if os.path.isfile(filename): conn.send(b"01") conn.recv(1024) f = open(filename,"rb") m = hashlib.md5() file_size = os.stat(filename).st_size conn.send(str(file_size).encode(encoding="utf-8")) client_ack = conn.recv(1024) # 接收确认信息 if client_ack == b"1": print("开始发送数据") for line in f: m.update(line) conn.send(line) f.close() conn.send(m.hexdigest().encode(encoding="utf-8")) # 发送MD5值 else: conn.send(b"00") #表示文件不存在 print("该文件不存在!") except ConnectionResetError: print("该客户端已断开连接") ser.close() print("服务器已关闭") 客户端步骤: 1.发送接收文件请求,同时将文件名发送给服务器 2.接收文件长度 3.本地新建同名文件,循环接收数据,并将其写入文件 4.同时更新本地MD5值 5.接收数据完毕后,再接收服务器的MD5值,与本地MD5值进行比较 代码: import socket,hashlib def receive1(client): "真正的数据接收" while True: res = b"" res = res + client.recv(1024) return res def receive(client,filename): "接收处理" m = hashlib.md5() rece_res_size = int(client.recv(1024).decode()) # 接收的结果长度,转成int型 client.send(b"1") rece_size = 0 res = b"" filename = filename.decode() f = open(filename + ".new","wb") while rece_size < rece_res_size: if rece_res_size - rece_size >1024: # 如果不是最后一次接收数据 size = 1024 else: # 最后一次接收数据 size = rece_res_size - rece_size a = client.recv(size) # 循环接收数据 res = res + a rece_size = len(res) m.update(a) f.write(a) print("发送数据量:{0},接收数据量:{1}".format(rece_res_size,rece_size)) else: serves_md5 = client.recv(1024).decode() print("服务器MD5:",serves_md5) print("客户端MD5:",m.hexdigest()) if serves_md5 == m.hexdigest(): print("文件接收并校验完毕!") res.decode() f.close() def main(): client = socket.socket() try: client.connect(("localhost", 5000)) while True: filename = input("请输入需要的文件名").strip().encode(encoding="utf-8") if len(filename) == 0: print("输入为空,重新输入") continue client.send(filename) is_file = client.recv(1024) if is_file == b"01": client.send(b"OK") receive(client,filename) # 调用函数接收数据,返回结果res(bytes) else: print(" {0} 文件不存在!".format(filename.decode())) except ConnectionRefusedError: print("等待服务器开机") client.close() main() socketserver 什么是socketserver?为什么需要它呢? 我们在前面的文章中普通的socket并不能同时处理多个客户端,当一个客户端在与服务器连接时,其它客户端只能排队。而sockerserver则不同,它可以并发地处理多个客户端请求。 import socketserver ''' 每一个客户端请求过来,都会实例化 MyTCPHandler ''' class MyTCPHandler(socketserver.BaseRequestHandler): def handle(self): "跟客户端所有的交互都是在handle里完成的" while True: try: self.data = self.request.recv(1024).strip() print("{0} wrote:".format(self.client_address[0])) print(self.data) if not self.data: print("输入为空") self.request.send(bytes("输入为空", "utf-8")) else: self.request.send(self.data.upper()) except ConnectionResetError : print("客户已断开连接") break if __name__ == "__main__": HOST, PORT = "localhost", 9999 #server = socketserver.TCPServer((HOST, PORT), MyTCPHandler) # 实例化一对一的连接对象 server = socketserver.ThreadingTCPServer((HOST, PORT), MyTCPHandler) # 实例化多并发的连接对象(多线程) server.serve_forever() 客户端并没有什么区别: import socket HOST, PORT = "localhost", 9999 sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM) sock.connect((HOST, PORT)) while True: data = input("输入字符") try: sock.sendall(bytes(data + "\n", "utf-8")) received = str(sock.recv(1024), "utf-8") finally: print("Sent: {0}".format(data)) print("Received: {0}".format(received)) sock.close()

优秀的个人博客,低调大师

Python网络编程——协程

个人独立博客:www.limiao.tech 微信公众号:TechBoard 协程的概念 协程,又称微线程,纤程,也称用户级线程,在不开辟线程的基础上实现多任务,也就是在单线程的情况下完成多任务,多个任务按照一定顺序交替执行的,通俗理解只要在def里面只看到一个yield关键字表示就是协程 协程也是实现多任务的一种方式 协程yield的代码实现 简单实现协程 import time # 定义协程 def work1(): while True: print("work1...") time.sleep(1) yield def work2(): while True: print("work2...") time.sleep(1) yield if __name__ == '__main__': g1 = work1() g2 = work2() while True: next(g1) next(g2) 实现协程的第二种方式:greenlet greenlet介绍:为了更好使用协程来完成多任务,python中的greenlet模块对其封装,从而使得切换任务变得更加简单 首先使用pip安装greenlet模块: pip3 install greenlet greenlet的使用: # greentlet的使用 import greenlet import time def work1(): for i in range(10): print("work1") time.sleep(1) g2.switch() def work2(): for i in range(10): print("work2") time.sleep(1) g1.switch() # 创建协程并指定任务 g1 = greenlet.greenlet(work1) g2 = greenlet.greenlet(work2) if __name__ == '__main__': g1.switch() 实现协程的第三种方式:gevent greenlet已经实现了协程,但是这个还要人工切换,这里介绍一个比greenlet更强大而且能够自动切换任务的第三方库——gevent gevent内部封装的greenlet,其原理是当一个greenlet遇到IO操作时,比如访问网络,就自动切换到其他的greenlet,等到IO操作完成,再在适当的时候切换回来继续执行 由于IO操作非常耗时,经常使程序处于等待状态,有了gevent为我们自动切换协程,就保证总有greenlet在运行,而不是等待IO 安装: pip install gevent gevent的使用 # gevent的使用 import gevent, time from gevent import monkey # gevent 遇到耗时操作(time, sleep, accept, recv, 网络请求)会切换到其他协程执行代码 # 打补丁,让gevent 能够识别耗时操作 monkey.patch_all() # 任务1 def work1(): for i in range(10): print("work1") # gevent.sleep(1) time.sleep(1) def work2(): for i in range(10): print("work2") # gevent.sleep(1) time.sleep(1) if __name__ == '__main__': # 创建协程并指定执行的任务 g1 = gevent.spawn(work1) g2 = gevent.spawn(work2) # 让主线程等待协程执行完成以后程序再退出 g1.join() g2.join() # 注意点:如果程序一直运行,并且还有耗时操作,那么不需要使用join 个人独立博客:www.limiao.tech 微信公众号:TechBoard

优秀的个人博客,低调大师

PHP多进程编程实例

场景:日常任务中,有时需要通过php脚本执行一些日志分析,队列处理等任务,当数据量比较大时,可以使用多进程来处理。 准备:php多进程需要pcntl,posix扩展支持,可以通过 php - m 查看,没安装的话需要重新编译php,加上参数--enable-pcntl,posix一般默认会有。 创建子进程的函数fork pcntl_fork — 在当前进程当前位置产生分支(子进程)。译注:fork是创建了一个子进程,父进程和子进程 都从fork的位置开始向下继续执行,不同的是父进程执行过程中,得到的fork返回值为子进程号,而子进程得到的是0。 一个fork子进程的基础示例: 1 <?php 2 $pid = pcntl_fork();//父进程和子进程都会执行下面代码 3 if ($pid == -1) { 4 //错误处理:创建子进程失败时返回-1. 5 die('could not fork'); 6 } else if ($pid) { 7 //父进程会得到子进程号,所以这里是父进程执行的逻辑 8 pcntl_wait($status); 9 //等待子进程中断,防止子进程成为僵尸进程。 10 } else { 11 //子进程得到的$pid为0, 所以这里是子进程执行的逻辑。 12 } 如果一个任务被分解成多个进程执行,就会减少整体的耗时。 比如有一个比较大的数据文件要处理,这个文件由很多行组成。如果单进程执行要处理的任务,量很大时要耗时比较久。这时可以考虑多进程。 多进程处理分解任务,每个进程处理文件的一部分,这样需要均分割一下这个大文件成多个小文件(进程数和小文件的个数等同就可以)。 比如该文件file.log有10万行数据,现在想分4个进程处理。需要分割2.5万行一个文件。命令split可以做到。 split的用法比较简单,可以man split查看下手册。 split -l 25000 -d file.log prefix_name -l是按照行分割,-d是分割后的文件名按照数字,-a是分割后的文件个数位数(默认是2,做多就是99个;比如超过100个,-a可以写3)。自己尝试分割一下就知道了。 处理代码: <?php shell_exec('split -l 25000 -d file.log prefix_name'); // 3个子进程处理任务 for ($i = 0; $i < 3; $i++){ $pid = pcntl_fork(); if ($pid == -1) { die("could not fork"); } elseif ($pid) { echo "I'm the Parent $i\n"; } else {// 子进程处理 $content = file_get_contents("prefix_name0".$i); // 业务处理 begin // 业务处理 end exit; // 一定要注意退出子进程,否则pcntl_fork() 会被子进程再fork,带来处理上的影响。 } }// 等待子进程执行结束 while (pcntl_waitpid(0, $status) != -1) { $status = pcntl_wexitstatus($status); echo "Child $status completed\n";} 可以关注微信公众号 lovephp 一起学习

优秀的个人博客,低调大师

Java并发编程-重入锁

章节目录 什么是重入锁 底层实现-如何实现重入 公平与非公平获取锁的区别与底层实现 1.什么是重入锁 1.1 重入锁的定义 重入锁ReentrantLock,支持重入的锁,表示一个线程对资源的重复加锁。 1.2 重入锁的特性 1.重进入 2.非/公平性获取锁 1.3 自定义同步器Mutex 的缺陷 当线程调用Mutex的lock()方法获取锁之后,再次调用lock()方法,该线程将会被 自己阻塞,原因是Mutex在实现tryAcquire(int acquires)方法时没有考虑占有锁 的线程再次获取锁的场景。 1.4 ReentrantLock & synchronized 关键字 1.synchronized 关键字支持隐式的重进入 2.ReentrantLock 在调用lock() 方法时,已经获取到锁的线程,能够再次调用 lock()方法获取到锁而不被阻塞,即可支持重入 1.4 公平性获取锁 公平性 含义 公平性获取锁 在绝对时间上,先对锁进行获取请求的请求一定先被满足,那么这个锁就是公平的 非公平性获取锁 无上述限制 事实上 公平锁机制往往没有非公平性机制获取锁的效率高,因为会牵扯到频繁的上下文切换,但公平锁可以减少饥饿发生的概率,等待越久的请求越能得到优先满足。 2. 底层实现-如何实现重入 重进入是指任意线程在获取到锁之后能够再次获取该锁,而不被阻塞,改特性实现需要解决以下两个问题: 线程再次获取锁 线程再次获取锁。锁需要去识别获取锁的线程是否为当前占据锁的线程,如果是,则再次成功获取。 锁的最终释放 线程重复n次获取了锁,随后在第n次释放锁,锁的释放要求锁对于被获取递 增的次数进行递减操作,当计数==0时表示锁已经成功释放。 2.1 可重入锁的源码非公平性获取同步状态(锁)的 nonfairTryAcquire() 方法 final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 该方法增加了再次获取同步状态的处理逻辑:通过判断当前线程是否为获取锁的线程来决定获取操作是否成功,如果是获取锁的线程的再次请求 则将同步状态值计数器进行递增并返回true,表示获取同步状态成功。 释放同步状态(锁) protected final boolean tryRelease(int releases) { int c = getState() - releases; if (Thread.currentThread() != getExclusiveOwnerThread()) throw new IllegalMonitorStateException(); boolean free = false; if (c == 0) { free = true; setExclusiveOwnerThread(null); } setState(c); return free; } 如果该锁被获取了n次,那么前n-1此tryRelease(int release) 方法必须返回false,而只有同步状态完全释放了,才能返回true。 3.公平与非公平获取锁的区别与底层实现 3.1 公平性获取锁的底层实现 公平性获取锁即按照客观时间顺序,FIFO方式获取同步状态 具体源码如下所示 protected final boolean tryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { if (!hasQueuedPredecessors() && compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 公平性获取同步状态的与非公平性获取同步状态的区别在于hasQueuedPredecessors()方法的使用,即加入了当前节点是否有前驱节点的判断,如果该方法返回true,则表示有线程比当前线程更早的加入到同步队列(更早的请求获取锁),因此需要等待前驱线程获取并释放锁之后才能继续获取锁。 非公平性获取锁的实现 公平性获取锁保证了锁的获取顺序按照FIFO原则,不会出现线程“饥饿”的现象,但代价是进行大量的线程切换。 非公平性锁虽然可能造成线程饥饿,但是有极少的线程切换,保证了其更大的吞吐量。

优秀的个人博客,低调大师

Java并发编程之CountDownLatch

CountDownLatch(闭锁)是一个很有用的工具类,利用它我们可以拦截一个或多个线程使其在某个条件成熟后再执行。 说到这,给大家举一个最典型的例子:假设一条流水线上有三个工作者:worker0,worker1,worker2。有一个任务的完成需要他们三者协作完成,worker2可以开始这个任务的前提是worker0和worker1完成了他们的工作,而worker0和worker1是可以并行他们各自的工作的。 如果使用普通的线程阻塞方式,我想大家很容易就会想到使用join的方式来做。当在当前线程中调用某个线程 thread 的 join() 方法时,当前线程就会阻塞,直到thread 执行完成,当前线程才可以继续往下执行。 如果使用这种方式编码实现的话,代码如下: public class Worker extends Thread { private String name; private long time; public Worker(String name, long time) { this.name = name; this.time = time; } @Override public void run() { try { System.out.println(name+"开始工作"); Thread.sleep(time); System.out.println(name+"工作完成,耗费时间="+time); } catch (InterruptedException e) { e.printStackTrace(); } } } 然后我们添加一个测试方法: public class Test { public static void main(String[] args) throws InterruptedException { // TODO 自动生成的方法存根 Worker worker0 = new Worker("worker0", (long) (Math.random()*2000+3000)); Worker worker1 = new Worker("worker1", (long) (Math.random()*2000+3000)); Worker worker2 = new Worker("worker2", (long) (Math.random()*2000+3000)); worker0.start(); worker1.start(); worker0.join(); //调用join阻塞worker0 worker1.join(); //调用join阻塞worker1 System.out.println("准备工作就绪"); worker2.start(); } } 然后运行上面的代码,我们可以发现就可以满足上面的结果。 除此之外,我们还可以使用CountDownLatch来实现上面的效果,说到这就不得不说下CountDownLatch的一个实现原理。 CountDownLatch CountDownLatch类是位于java.util.concurrent包下的一个并发工具类,是通过一个计数器来实现的,计数器的初始值为线程的数量。 每当一个线程完成了自己的任务后,计数器的值就会减1。当计数器值到达0时,它表示所有的线程已经完成了任务,然后在闭锁上等待的线程就可以恢复执行任务。也就是说,构造器中的计数值(count)实际上就是闭锁需要等待的线程数量,这个值只能被设置一次,而且CountDownLatch没有提供任何机制去重新设置这个计数值。当这个CountDownLatch数量归0后,其他的线程采用执行的机会。 与CountDownLatch的第一次交互是主线程等待其他线程,主线程必须在启动其他线程后立即调用CountDownLatch.await()方法。这样主线程的操作就会在这个方法上阻塞,直到其他线程完成各自的任务。 例如,对于文章开头的实例,要实现同样的效果,我们需要做以下的修改。 public class Worker extends Thread { private String name; private long time; private CountDownLatch countDownLatch; public Worker(String name, long time, CountDownLatch countDownLatch) { this.name = name; this.time = time; this.countDownLatch = countDownLatch; } @Override public void run() { try { System.out.println(name+"开始工作"); Thread.sleep(time); System.out.println(name+"工作完成,耗费时间="+time); countDownLatch.countDown(); System.out.println("countDownLatch.getCount()="+countDownLatch.getCount()); } catch (InterruptedException e) { e.printStackTrace(); } } } 然后,我们编写一个测试用例: public class Test { public static void main(String[] args) throws InterruptedException { CountDownLatch countDownLatch = new CountDownLatch(2); Worker worker0 = new Worker("worker0", (long) (Math.random()*2000+3000), countDownLatch); Worker worker1 = new Worker("worker1", (long) (Math.random()*2000+3000), countDownLatch); Worker worker2 = new Worker("worker2", (long) (Math.random()*2000+3000), countDownLatch); worker0.start(); worker1.start(); //立即调用CountDownLatch.await() countDownLatch.await(); System.out.println("准备工作就绪"); worker2.start(); } } 试想以下,有下面一种应用场景:假设worker的工作可以分为两个阶段,work2 只需要等待work0和work1完成他们各自工作的第一个阶段之后就可以开始自己的工作了,而不是场景1中的必须等待work0和work1把他们的工作全部完成之后才能开始。 这种情况下,join是没办法实现这个场景的,而CountDownLatch却可以,因为它持有一个计数器,只要计数器为0,那么主线程就可以结束阻塞往下执行。相关代码如下: public class Worker extends Thread { private String name; private long time; private CountDownLatch countDownLatch; public Worker(String name, long time, CountDownLatch countDownLatch) { this.name = name; this.time = time; this.countDownLatch = countDownLatch; } @Override public void run() { try { System.out.println(name+"开始工作"); Thread.sleep(time); System.out.println(name+"第一阶段工作完成"); countDownLatch.countDown(); Thread.sleep(2000); //这里就姑且假设第二阶段工作都是要2秒完成 System.out.println(name+"第二阶段工作完成"); System.out.println(name+"工作完成,耗费时间="+(time+2000)); } catch (InterruptedException e) { e.printStackTrace(); } } } 测试方法: public class Test { public static void main(String[] args) throws InterruptedException { CountDownLatch countDownLatch = new CountDownLatch(2); Worker worker0 = new Worker("worker0", (long) (Math.random()*2000+3000), countDownLatch); Worker worker1 = new Worker("worker1", (long) (Math.random()*2000+3000), countDownLatch); Worker worker2 = new Worker("worker2", (long) (Math.random()*2000+3000), countDownLatch); worker0.start(); worker1.start(); countDownLatch.await(); System.out.println("准备工作就绪"); worker2.start(); } } 运行上面的测试用例,可以看到满足我们条件的输出: worker0开始工作 worker1开始工作 worker1第一阶段工作完成 worker0第一阶段工作完成 准备工作就绪 worker2开始工作 worker1第二阶段工作完成 worker1工作完成,耗费时间=5521 worker0第二阶段工作完成 worker0工作完成,耗费时间=6147 worker2第一阶段工作完成 worker2第二阶段工作完成 worker2工作完成,耗费时间=5384

优秀的个人博客,低调大师

java并发编程笔记--CopyOnWriteArrayList

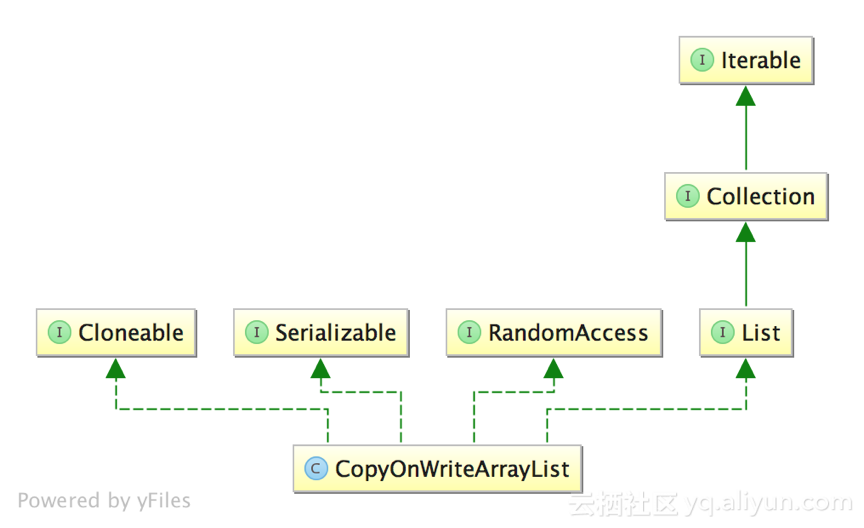
1 描述 1) CopyOnWriteArrayList是List的一种线程安全的实现;2) 其实现原理采用”CopyOnWrite”的思路(不可变元素),即所有写操作,包括:add,remove,set等都会触发底层数组的拷贝,从而在写操作过程中,不会影响读操作;避免了使用synchronized等进行读写操作的线程同步;3) CopyOnWrite对于写操作来说代价很大,故不适合于写操作很多的场景;当遍历操作远远多于写操作的时候,适合使用CopyOnWriteArrayList;4) 迭代器以”快照”方式实现,在迭代器创建时,引用指向List当前状态的底层数组,所以在迭代器使用的整个生命周期中,其内部数据不会被改变;并且集合在遍历过程中进行修改,也不会抛出ConcurrentModificationException;迭代器在遍历过程中,不会感知集合的add,remove,set等操作;5) 因为迭代器指向的是底层数组的”快照”,因此也不支持对迭代器本身的修改操作,包括add,remove,set等操作,如果使用这些操作,将会抛出UnsupportedOperationException;6) 相关Happens-Before规则:一个线程将元素放入集合的操作happens-before于其它线程访问/删除该元素的操作; 2 类图 主要角色:1) Iterable接口:定义创建迭代器操作,赋予实现类创建迭代器的能力;2) Collection接口:定义集合基本操作,所有集合类都需实现该接口;3) List接口:定义列表基本操作,所有列表类都需要实现该接口;4) Serializable接口:标记接口,允许对象序列化;5) Cloneable接口:标记接口,允许对象被克隆,如果类没有实现Cloneable接口,调用类对象的clone方法抛出CloneNotSupportedException;6) RandomAccess接口:标记接口,用来表明其支持快速(通常是固定时间)随机访问(比如:ArrayList支持快速随机访问,所以使用普通遍历方式效率更高;而LinkedList则更适合顺序访问,所以使用迭代器的方式效率更高);JDK中推荐的是对List集合尽量要实现RandomAccess接口;7) COWIterator:CopyOnWriteArrayList对应的迭代器;不支持写操作,当调用写操作时,将抛出UnsupportedOperationException异常;8) COWSubList:调用subList方法时,CopyOnWriteArrayList对应的子列表对象,和CopyOnWriteArrayList共享同一个array对象,使用使用offset和size维护对array的位置偏移;且当CopyOnWriteArrayList调用写操作更新array引用时,COWSubList对应的操作会抛出ConcurrentModificationException;9) COWSubListIterator:COWSubList对应的迭代器,底层通过COWIterator实现,使用offset和size维护对array的位置偏移;不支持写操作,当调用写操作时,将抛出UnsupportedOperationException异常; 3 主要实现 3.1 基本属性定义 /** * 互斥锁,用于保护所有修改操作,通过Unsafe进行初始化 */ final transient ReentrantLock lock = new ReentrantLock(); /** * 存放数据的底层数据结构,只能通过getArray()和setArray()两个方法访问; */ private transient volatile Object[] array; /** * <h2>array属性的getter和setter</h2> * <p>声明为非private类型,以便于CopyOnWriteArraySet访问</p> */ final Object[] getArray() { return array; } final void setArray(Object[] array) { this.array = array; } 1) lock属性:互斥锁,用于控制CopyOnWriteArrayList所有的写操作的同步,以及对应的COWSubList的所有读写操作的同步;2) array属性:Object[]数组,用于存放集合元素的底层数据结构;array只允许CopyOnWriteArrayList定义的getter和setter方法访问;(原因?) 3.2 构造器定义 /** * <h2>初始化array为空数组</h2> */ public CopyOnWriteArrayList() { setArray(new Object[0]); } /** * <h2>将集合参数中的元素作为当前集合对象的元素</h2> */ public CopyOnWriteArrayList(Collection<? extends E> c) { Object[] elements; if (c.getClass() == CopyOnWriteArrayList.class) { elements = ((CopyOnWriteArrayList<?>) c).getArray(); } else { elements = c.toArray(); //注:c.toArray()可能不一定返回Object[] if (elements.getClass() != Object[].class) { elements = Arrays.copyOf(elements, elements.length, Object[].class); } } } /** * <h2>将数组参数中的元素作为当前集合对象的元素</h2> */ public CopyOnWriteArrayList(E[] toCopyIn) { //注:传入数组对象并不是传递引用,而是新建一个数组拷贝原有数组 setArray(Arrays.copyOf(toCopyIn, toCopyIn.length, Object[].class)); } 1) 定义了3个构造函数,第一个构造函数为无参构造函数,默认初始化array为空数组;后两个构造函数分别接收Collection对象和数组对象作为参数,使用参数的元素作为初始化array的元素;2) 使用数组对象作为参数时,需要通过浅拷贝的方式初始化array,而非直接使用数组对象的引用; 3.3 查找元素 @Override public int size() { return getArray().length; } @Override public boolean isEmpty() { return size() == 0; } private static boolean eq(Object o1, Object o2) { return (o1 == null) ? o2 == null : o1.equals(o2); } private static int indexOf(Object o, Object[] elements, int index, int fence) { if (o == null) { for (int i = index; i < fence; i++) { if (elements[i] == null) { return i; } } } else { for (int i = index; i < fence; i++) { if (o.equals(elements[i])) { return i; } } } return -1; } private static int lastIndexOf(Object o, Object[] elements, int index) { if (o == null) { for (int i = index; i >= 0; i--) { if (elements[i] == null) { return i; } } } else { for (int i = index; i >= 0; i--) { if (o.equals(elements[i])) { return i; } } } return -1; } @Override public boolean contains(Object o) { Object[] elements = getArray(); return indexOf(o, elements, 0, elements.length) >= 0; } @Override public int indexOf(Object o) { Object[] elements = getArray(); return indexOf(o, elements, 0, elements.length); } public int indexOf(E e, int index) { Object[] elements = getArray(); return indexOf(e, elements, index, elements.length); } public int lastIndexOf(Object o) { Object[] elements = getArray(); return lastIndexOf(o, elements, elements.length - 1); } public int lastIndexOf(E e, int index) { Object[] elements = getArray(); return lastIndexOf(e, elements, index); } 1) CopyOnWriteArrayList的所有读操作都不需要加锁;2) 单个元素的访问,直接通过索引访问底层数组;3) 查找遍历等涉及多个元素的读操作,都会针对array的快照进行,即每次操作开始前使用名为elements的Object[]局部变量存放array当前的引用。在遍历过程中,array发生变化时,遍历操作遍历的依然是原来的快照,从而保证了读操作不需要加锁,写操作也不会发生ConcurrentModificationException异常; 3.4 新增元素 @Override public boolean add(E e) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); int len = elements.length; Object[] newElements = Arrays.copyOf(elements, len + 1); newElements[len] = e; setArray(newElements); return true; } finally { lock.unlock(); } } 1) 所有的新增元素操作都需要使用lock加互斥锁;2) 新增元素需要考虑添加元素的个数(单个/集合),添加元素的位置(末尾/非末尾); 3.5 更新元素 @Override public E set(int index, E element) { //加锁 final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); E oldValue = get(elements, index); //待更新元素不是原来的元素,才执行copyOnWrite if (oldValue != element) { int len = elements.length; Object[] newElements = Arrays.copyOf(elements, len); newElements[index] = element; setArray(newElements); } else { // 注:再次更新引用,为了触发volatile的语义,通知所有线程 setArray(elements); } return oldValue; } finally { //解锁 lock.unlock(); } } 1) 同添加元素操作一样,更新元素也需要使用lock加互斥锁;2) 需要注意的是,即使待更新元素和集合中元素引用相同,也需要执行setArray()操作,以便触发volatile语义,通知所有线程; 3.6 删除元素 @Override public E remove(int index) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); int len = elements.length; E oldValue = get(elements, index); //计算需要移动的元素个数 int numMoved = len - index - 1; //如果删除元素在数组末尾 if (numMoved == 0) { setArray(Arrays.copyOf(elements, len - 1)); } else { Object[] newElements = new Object[len - 1]; System.arraycopy(elements, 0, newElements, 0, index); System.arraycopy(elements, index + 1, newElements, index, numMoved); setArray(newElements); } return oldValue; } finally { lock.unlock(); } } private boolean remove(Object o, Object[] snapshot, int index) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] current = getArray(); int len = current.length; //如果此时已经进行过写操作 if (snapshot != current) { //校准索引 FINDINDEX: { //在当前代码获取锁时,有可能len已经小于index,故需要取二者中较小的; int prefix = Math.min(index, len); //情形1:[0,index)区间的元素有删除操作,导致index所指元素前移 for (int i = 0; i < prefix; i++) { //如果元素引用已经替换 if (current[i] != snapshot[i] && eq(o, current[i])) { index = i; break FINDINDEX; } } //情形2:当前数组删除元素较多,导致数组长度小于原先index if (index >= len) { return false; } //情形3:[0,index)区间的元素没有删除操作,index所指元素未移动 if (current[index] == o) { break FINDINDEX; } //情形4:[0,index)区间有添加元素操作,导致index所指元素后移,重新定位元素索引 index = indexOf(o, current, index, len); } } Object[] newElements = new Object[len - 1]; System.arraycopy(current, 0, newElements, 0, index); System.arraycopy(current, index + 1, newElements, index, len - index - 1); setArray(newElements); return true; } finally { lock.unlock(); } } @Override public boolean remove(Object o) { Object[] snapshot = getArray(); int index = indexOf(o, snapshot, 0, snapshot.length); return index >= 0 && remove(o, snapshot, index); } 1) 删除元素时,同样需要加互斥锁,但出于效率考虑,在加锁前都检测待删除元素是否存在,如果不存在则不加锁,直接返回false;2) 由于判断元素是否存在的操作时未加锁,不能保证删除方法执行过程中,其它线程进行写操作。故在加锁后,依然需要对索引进行校准,增加了删除操作实现难度; 3.7 迭代器实现 @Override public Iterator<E> iterator() { return new COWIterator<E>(getArray(), 0); } @Override public ListIterator<E> listIterator() { return new COWIterator<E>(getArray(), 0); } @Override public ListIterator<E> listIterator(int index) { Object[] elements = getArray(); int len = elements.length; if (index < 0 || index > len) { throw new IndexOutOfBoundsException("Index: " + index); } return new COWIterator<E>(elements, index); } /** * <h2>Copy-On-Write迭代器定义</h2> * <p>限定为final,表示不可以被继承</p> */ static final class COWIterator<E> implements ListIterator<E> { /** * 限定为final,指定为不可变对象,存放arry快照 */ private final Object[] snapshot; /** * 迭代器索引 */ private int cursor; private COWIterator(Object[] elements, int initialCursor) { cursor = initialCursor; snapshot = elements; } public boolean hasNext() { return cursor < snapshot.length; } public boolean hasPrevious() { return cursor > 0; } @SuppressWarnings("unchecked") public E next() { if (!hasNext()) { throw new NoSuchElementException(); } return (E) snapshot[cursor++]; } @SuppressWarnings("unchecked") public E previous() { if (!hasPrevious()) { throw new NoSuchElementException(); } return (E) snapshot[--cursor]; } public int nextIndex() { return cursor; } public int previousIndex() { return cursor - 1; } /** * Not supported. Always throws UnsupportedOperationException. * * @throws UnsupportedOperationException always; {@code remove} * is not supported by this iterator. */ public void remove() { throw new UnsupportedOperationException(); } /** * Not supported. Always throws UnsupportedOperationException. * * @throws UnsupportedOperationException always; {@code set} * is not supported by this iterator. */ public void set(E e) { throw new UnsupportedOperationException(); } /** * Not supported. Always throws UnsupportedOperationException. * * @throws UnsupportedOperationException always; {@code add} * is not supported by this iterator. */ public void add(E e) { throw new UnsupportedOperationException(); } @Override public void forEachRemaining(Consumer<? super E> action) { Objects.requireNonNull(action); Object[] elements = snapshot; final int size = elements.length; for (int i = cursor; i < size; i++) { @SuppressWarnings("unchecked") E e = (E) elements[i]; action.accept(e); } cursor = size; } } 1) COWIterator迭代器实现是基于快照的,即在调用iterator()方法创建迭代器时,传入array的引用作为快照; 通过一个整型游标记录当前访问到元素的索引;2) 因为迭代器是基于快照的,故所有读操作都无须加锁,且迭代过程中,对CopyOnWriteArrayList集合的修改不会影响到迭代操作,也不会抛出ConcurrentModificationException;3) 注意:因为COWSubList是作为CopyOnWriteArrayList的子列表的,所有操作都依赖于array,所以COWSubList的所有操作都必须检测array是否有改变,并且读写操作都要加锁,以保证写操作替换array的时候,没有读操作同步进行; 4 适用场景 4.1 小数据量,读多写少 数据量较小,读操作尤其是遍历操作远多于写操作时候,适合使用CopyOnWriteArrayList。 5 缺点&权衡点 5.1 写操作耗时更多 不可变对象的每次写操作就要进行一次copy/new操作,带来的性能消耗随着copy的数据量显著增加,包括内存的消耗以及copy/new过程的时间消耗;故不适合copy/new数据量很大,并且写操作很多的场景。 5.2 集合占用内存更多 使用Copy-On-Write,如果短时间有大量读伴随着写,则会有很多”快照”引用得不到释放,占用大量内存。 6 应用案例 7 相关知识点 7.1 迭代器模式 7.2 CopyOnWriteArraySet 8 问题思考 1)CopyOnWriteList如何保证在遍历的过程中修改集合不会触发ConcurrentModificationException?2)为什么CopyOnWriteList的迭代器不支持写操作?3)如下代码为什么不直接使用array,而要通过getArray方法? 4)加锁的代码为什么要按照如下方式写?是要防止锁的引用改变吗? 参考 [Java多线程系列--“JUC集合”02之 CopyOnWriteArrayList]()sun.misc.Unsafe类的使用CopyOnWriteArrayList解读

优秀的个人博客,低调大师

Java并发编程-各种锁

安全性和活跃度通常相互牵制。我们使用锁来保证线程安全,但是滥用锁可能引起锁顺序死锁。类似地,我们使用线程池和信号量来约束资源的使用, 但是缺不能知晓哪些管辖范围内的活动可能形成的资源死锁。Java应用程序不能从死锁中恢复,所以确保你的设计能够避免死锁出现的先决条件是非常有价值。 一.死锁 经典的“哲学家进餐”问题很好的阐释了死锁。5个哲学家一起出门去吃中餐,他们围坐在一个圆桌边。他们只有五只筷子(不是5双),每两个人中间放有一只。 哲学家边吃边思考,交替进行。每个人都需要获得两只筷子才能吃东西,但是吃后要把筷子放回原处继续思考。有一些管理筷子的算法,使每一个人都能够或多或少,及时 吃到东西(一个饥饿的哲学家试图获得两只临近的筷子,但是如果其中的一只正在被别人占用,那么他英爱放弃其中一只可用的筷子,等待几分钟再尝试)。但是这样做可能导致 一些哲学家或者所有哲学家都饿死 (每个人都迅速捉住自己左边的筷子,然后等待自己右边的筷子变成可用,同时并不放下左边的筷子)。这最后一种情况,当每个人都拥有他人需要的 资源,并且等待其他人正在占有的资源,如果大家一致占有资源,直到获得自己需要却没占有的其他资源,如果大家一致占有资源,直到获得自己需要却没被占有的其他资源,那么就会产生死锁。 当一个线程永远占有一个锁,而其他线程尝试去获得这个锁,那么他们将永远被阻塞。当线程Thread1占有锁A时,想要获得锁B,但是同时线程Thread2持有B锁,并尝试获得A锁,两个线程将永远等待下去。 这种情况是死锁最简单的形式. 例子如下代码: public class DeadLock { private static Object lockA = new Object(); private static Object lockB = new Object(); public static void main(String[] args) { new DeadLock().deadLock(); } private void deadLock() { Thread thread1 = new Thread(new Runnable() { public void run() { synchronized (lockA){ try { System.out.println(Thread.currentThread().getName() + "获取A锁 ing!"); Thread.sleep(500); System.out.println(Thread.currentThread().getName() + "睡眠500ms"); } catch (Exception e) { e.printStackTrace(); } System.out.println(Thread.currentThread().getName() + "需要B锁!!!"); synchronized (lockB){ System.out.println(Thread.currentThread().getName() + "B锁获取成功"); } } } },"Thread1"); Thread thread2 = new Thread(new Runnable() { public void run() { synchronized (lockB){ try { System.out.println(Thread.currentThread().getName() + "获取B锁 ing!"); Thread.sleep(500); System.out.println(Thread.currentThread().getName() + "睡眠500ms"); } catch (Exception e) { e.printStackTrace(); } System.out.println(Thread.currentThread().getName() + "需要A锁!!!"); synchronized (lockA){ System.out.println(Thread.currentThread().getName() + "A锁获取成功"); } } } },"Thread2"); thread1.start(); thread2.start(); } } 运行结果如下图: 结果很明显了,这两个线程陷入了死锁状态了,发生死锁的原因是,两个线程试图通过不同的顺序获得多个相同的锁。如果请求锁的顺序相同, 就不会出现循环的锁依赖现象(你等我放锁,我等你放锁),也就不会产生死锁了。如果你能够保证同时请求锁A和锁B的每一个线程,都是按照从锁A到锁B的顺序,那么就不会发生死锁了。 如果所有线程以通用的固定秩序获取锁,程序就不会出现锁顺序死锁问题了。 什么情况下会发生死锁呢? 1.锁的嵌套容易发生死锁。解决办法:获取锁时,查看是否有嵌套。尽量不要用锁的嵌套,如果必须要用到锁的嵌套,就要指定锁的顺序,因为参数的顺序是超乎我们控制的,为了解决这个问题,我们必须指定锁的顺序,并且在整个应用程序中, 获得锁都必须始终遵守这个既定的顺序。 上面的例子出现死锁的根本原因就是获取所的顺序是乱序的,超乎我们控制的。上面例子最理想的情况就是把业务逻辑抽离出来,把获取锁的代码放在一个公共的方法里面,让这两个线程获取锁 都是从我的公共的方法里面获取,当Thread1线程进入公共方法时,获取了A锁,另外Thread2又进来了,但是A锁已经被Thread1线程获取了,Thread1接着又获取锁B,Thread2线程就不能再获取不到了锁A,更别说再去获取锁B了,这样就有一定的顺序了。 上面例子的改造如下: public class DeadLock { private static Object lockA = new Object(); private static Object lockB = new Object(); public static void main(String[] args) { new DeadLock().deadLock(); } private void deadLock() { Thread thread1 = new Thread(new Runnable() { public void run() { getLock(); } },"Thread1"); Thread thread2 = new Thread(new Runnable() { public void run() { getLock(); } },"Thread2"); thread1.start(); thread2.start(); } public void getLock() { synchronized (lockA){ try { System.out.println(Thread.currentThread().getName() + "获取A锁 ing!"); Thread.sleep(500); System.out.println(Thread.currentThread().getName() + "睡眠500ms"); } catch (Exception e) { e.printStackTrace(); } System.out.println(Thread.currentThread().getName() + "需要B锁!!!"); synchronized (lockB){ System.out.println(Thread.currentThread().getName() + "B锁获取成功"); } } } } 运行结果如下: 可以看到把业务逻辑抽离出来,把获取锁的代码放在一个公共的方法里面,获得锁都必须始终遵守这个既定的顺序。 2.引入显式锁的超时机制特性来避免死锁 超时机制是监控死锁和从死锁中恢复的技术,是使用每个显式所Lock类中定时tryLock特性,来替代使用颞部所机制。在内部锁的机制中,只要没有获得锁,就永远保持等待,而 显示的锁使你能狗定义超时的时间,在规定时间之后tryLock还没有获得锁就会返回失败。通过使用超时,尽管这段时间比你预期能够获得所的时间长很多,你仍然可以在意外发生后重新 获得控制权。当尝试获得定时锁失败时,你并不需要知道原因。也许是因为有死锁发生,也许是线程在持有锁的时候错误地进入无限循环;也有可能是执行一些活动所花费的时间比你 预期慢了许多。不过至少你有机会了解到你的尝试已经失败,记录下这次尝试中有用的信息,并重新开始计算,这远比关闭整个线程要优雅得多。 即使定时锁并没有应用于整个系统,使用它来获得多重锁还是能够有效应对死锁。如果获取锁的请求超时,你可以释放这个锁,并后退,等待一会后再尝试,这很可能消除了死锁发生的条件, 并且循序程序恢复。(这项技术只有在同时获得两个锁的时候才有效;如果多个锁是在嵌套的方法中被请求的,你无法仅仅释放外层的锁,尽管你知道自己已经持有该锁) 显式锁Lock,Lock是一个接口,定义了一些抽象的所操作。与内部锁机制不同,Lock提供了无条件,可轮询,定时的,可中断的锁获取操作,所有加锁和解锁的方法都是显式的。 Lock的实现必须提供举报与内部锁相同的内存可见性的语义。但是加锁的语义,调度算法,顺序保证,性能特性这些可以不同。 Lock接口源码如下: public interface Lock { //加锁 void lock(); //可中断的锁,打算线程的等待状态,即A线程已经获取该锁,B线程又来获 //取,但是A线程会通知B,来打算B线程的等待。 void lockInterruptibly() throws InterruptedException; //尝试去获取锁,失败返回False boolean tryLock(); //超时机制获取锁 boolean tryLock(long time, TimeUnit unit) throws InterruptedException; //释放锁 void unlock(); Condition newCondition(); } ReentranLock实现了Lock接口,提供了与synchronized相同的互斥和内存可见性的保证。获得ReentrantLock的锁与进入synchronized块有着相同内存含义,释放ReentrantLock锁与退出synchronized块有着相同内存含义。 ReentrantLock提供了与synchronized一样可重入加锁的语义。ReentrantLock支持Lock接口定义的所有获取锁的方式。与synchronized相比,ReentranLock为处理不可用的锁提供了更多灵活性。 但是对于现在的JDK的更新,synchronized的性能被优化的越来越好,内部锁(synchronized)已经获得相当可观的性能,性能不仅仅是个不断变化的目标,而且变化的非常快。 如下图: 看到图,随着JDK的更新迭代,内部锁的性能越来越快,这不是ReentrantLock的衰退,而是内部锁(synchronized)越来越快,特别在JDK目前跟新到现在1.9. 下面用显式锁Lock再来改造上面的例子 public class DeadLock { Lock lock = new ReentrantLock(); private static Object lockA = new Object(); private static Object lockB = new Object(); public static void main(String[] args) { new DeadLock().deadLock(); } private void deadLock() { Thread thread1 = new Thread(new Runnable() { public void run() { try { lock.lock(); System.out.println(Thread.currentThread().getName() + "获取A锁 ing!"); Thread.sleep(500); System.out.println(Thread.currentThread().getName() + "睡眠500ms"); } catch (Exception e) { e.printStackTrace(); } finally { lock.unlock(); } System.out.println(Thread.currentThread().getName() + "需要B锁!!!"); try { lock.lock(); System.out.println(Thread.currentThread().getName() + "B锁获取成功"); } catch (Exception e) { e.printStackTrace(); } finally { lock.unlock(); } } }, "Thread1"); Thread thread2 = new Thread(new Runnable() { public void run() { try { lock.lock(); System.out.println(Thread.currentThread().getName() + "获取B锁 ing!"); Thread.sleep(500); System.out.println(Thread.currentThread().getName() + "睡眠500ms"); } catch (Exception e) { e.printStackTrace(); } finally { lock.unlock(); } System.out.println(Thread.currentThread().getName() + "需要A锁!!!"); try { lock.lock(); System.out.println(Thread.currentThread().getName() + "A锁获取成功"); } catch (Exception e) { e.printStackTrace(); } finally { lock.unlock(); } } }, "Thread1"); thread1.start(); thread2.start(); } } 运行结果如下: 可以看到显示锁Lock是可以避免死锁的。 注意:Lock接口规范形式。这种模式在某种程度上比使用内部锁更加复杂:锁必须在finally块中释放。另一方面,如果锁守护的代码在try块之外抛出了异常,它将永远都不会被释放了;如果对象 能够被置于不一致状态,可能需要额外的try-catch,或try-finally块。(当你在使用任何形式的锁时,你总是应该关注异常带来的影响,包括内部锁)。 忘记时候finally释放Lock是一个定时炸弹。当不幸发生的时候,你将很难追踪到错误的发生点,因为根本没有记录锁本应该被释放的位置和时间。这就是ReentrantLock不能完全替代synchronized的原因:它更加危险, 因为当程序的控制权离开守护的块,不会自动清除锁。尽管记得在finally块中释放锁并不苦难,但忘记的可能仍然存在。 sy 可轮询的和可定时的锁请求 可定时的与可轮询的锁获取模式,是由tryLock方法实现,与物体爱建的锁获取相比,它具有更完善的错误恢复机制。在内部锁中,死锁是致命的,唯一的恢复方法是重新启动程序,唯一的预防方法是在构建程序时不要出错, 所以不可能循序不一致的锁顺序。可定时的与可轮询的锁提供了另外一个选择:可以规避死锁的放生。 如果你不能获得所有需要的锁,那么使用可定时的与可轮询的获取方式(tryLock)使你能够重新拿到控制权,它会释放你已经获得的这些锁,然后再重新尝试(或者至少会记录这个失败,抑或者采取其他措施)。使用tryLock试图获得两个锁, 如果不能同时获得两个,就回退,并重新尝试。休眠时间由一个特定的组件管理,并由一个随机组件减少活锁发生的可能性。如果一定时间内,没有获得所有需要的锁,就会返回一个失败状态,这样操作就能优雅的失败了。 tryLock()经常与if esle一起使用。 读-写锁 ReentrantLock实现了标准的互斥锁:一次最多只有一个线程能够持有相同ReentrantLock。但是互斥通常做为保护数据一致性的很强的加锁约束,因此,过分的限制了并发性。互斥是保守的加锁策略,避免了 “写/写”和“写/读"的重读,但是同样避开了"读/读"的重叠。在很多情况下,数据结构是”频繁被读取“的——它们是可变的,有时候会被改变,但多数访问只进行读操作。此时,如果能够放宽,允许多个读者同时访问数据结构就 非常好了。只要每个线程保证能够读到最新的数据(线程的可见性),并且在读者读取数据的时候没有其他线程修改数据,就不会发生问题。这就是读-写锁允许的情况:一个资源能够被多个读者访问,或者被一个写者访问,两者不能同时进行。 ReadWriteLock,暴露了2个Lock对象,一个用来读,另一个用来写。读取ReadWriteLock锁守护的数据,你必须首先获得读取的锁,当需要修改ReadWriteLock守护的数据,你必须首先获得写入锁。 ReadWriteLock源码接口如下: public interface ReadWriteLock { /** * Returns the lock used for reading. * * @return the lock used for reading */ Lock readLock(); /** * Returns the lock used for writing. * * @return the lock used for writing */ Lock writeLock(); } 读写锁实现的加锁策略允许多个同时存在的读者,但是只允许一个写者。与Lock一样,ReadWriteLock允许多种实现,造成性能,调度保证,获取优先,公平性,以及加锁语义等方面的不尽相同。 读写锁的设计是用来进行性能改进的,使得特定情况下能够有更好的并发性。时间实践中,当多处理器系统中,频繁的访问主要为读取数据结构的时候哦,读写锁能够改进性能;在其他情况下运行的情况比独占 的锁要稍微差一些,这归因于它更大的复杂性。使用它能否带来改进,最好通过对系统进行剖析来判断:好在ReadWriteLock使用Lock作为读写部分的锁,所以如果剖析得的结果发现读写锁没有能提高性能,把读写锁置换为独占锁是比较容易。 下面我们用synchonized来进行读操作,对于读操作性能如何呢? 例子如下: public class ReadWriteLockTest { private ReentrantReadWriteLock rw1 = new ReentrantReadWriteLock(); public static void main(String[] args) { final ReadWriteLockTest test = new ReadWriteLockTest(); new Thread(){ @Override public void run() { test.get(Thread.currentThread()); } }.start(); new Thread(){ @Override public void run() { test.get(Thread.currentThread()); } }.start(); } public synchronized void get(Thread thread) { long start = System.currentTimeMillis(); while (System.currentTimeMillis() - start <= 1){ System.out.println(thread.getName() + "正在读操作"); } System.out.println(thread.getName() + "读操作完成"); } } 运行结果如下: 可以看到要线程Thread0读操作完了,Thread1才能进行读操作。明显这样性能很慢。 现在我们用ReadWriteLock来进行读操作,看一下性能如何 例子如下: public class ReadWriteLockTest { private ReentrantReadWriteLock rw1 = new ReentrantReadWriteLock(); public static void main(String[] args) { final ReadWriteLockTest test = new ReadWriteLockTest(); new Thread(){ @Override public void run() { test.get(Thread.currentThread()); } }.start(); new Thread(){ @Override public void run() { test.get(Thread.currentThread()); } }.start(); } public void get(Thread thread) { try { rw1.readLock().lock(); long start = System.currentTimeMillis(); while (System.currentTimeMillis() - start <= 1){ System.out.println(thread.getName() + "正在读操作"); } System.out.println(thread.getName() + "读操作完成"); } catch (Exception e) { e.printStackTrace(); } finally { rw1.readLock().unlock(); } } } 运行结果如下: 可以看到线程间是不用排队来读操作的。这样效率明显很高。 我们再看一下写操作,如下: public class ReadWriteLockTest { private ReentrantReadWriteLock rw1 = new ReentrantReadWriteLock(); public static void main(String[] args) { final ReadWriteLockTest test = new ReadWriteLockTest(); new Thread(){ @Override public void run() { test.get(Thread.currentThread()); } }.start(); new Thread(){ @Override public void run() { test.get(Thread.currentThread()); } }.start(); } public void get(Thread thread) { try { rw1.writeLock().lock(); long start = System.currentTimeMillis(); while (System.currentTimeMillis() - start <= 1){ System.out.println(thread.getName() + "正在写操作"); } System.out.println(thread.getName() + "写操作完成"); } catch (Exception e) { e.printStackTrace(); } finally { rw1.writeLock().unlock(); } } } 运行结果如下: 可以看到ReadWriteLock只允许一个写者。 公平锁 ReentrantReadWriteLock为两个锁提供了可重入的加锁语义,它是继承了ReadWriteLock,扩展了ReadWriteLock。它与ReadWriteLock相同,ReentrantReadWriteLock能够被构造 为非公平锁(构造方法不设置参数,默认是非公平),或者公平。在公平锁中,选择权交给等待时间最长的线程;如果锁由读者获得,而一个线程请求写入锁,那么不再允许读者获得读取锁,直到写者被受理,平且已经释放了写锁。 在非公平的锁中,线程允许访问的顺序是不定的。由写者降级为读者是允许的;从读者升级为写者是不允许的(尝试这样的行为会导致死锁) 当锁被持有的时间相对较长,并且大部分操作都不会改变锁守护的资源,那么读写锁能够改进并发性。ReadWriteMap使用了ReentrantReadWriteLock来包装Map,使得它能够在多线程间 被安全的共享,并仍然能够避免 "读-写" 或者 ”写-写“冲突。显示中ConcurrentHashMap并发容器的性能已经足够好了,所以你可以是使用他,而不必使用这个新的解决方案,如果你需要并发的部分 只有哈希Map,但是如果你需要为LinkedHashMap这种可替换元素Map提供更好的并发访问,那么这项技术是非常有用的。 用读写锁包装的Map如下图: 读写锁的性能如下图: 总结: 显式的Lock与内部锁相比提供了一些扩展的特性,包括处理不可用的锁时更好的灵活性,以及对队列行为更好的控制。但是ReentrantLock不能完全替代synchronized;只有当你需要 synchronized没能提供的特性时才应该使用。 读-写锁允许多个读者并发访问被守护的对象,当访问多为读取数据结构的时候,它具有改进可伸缩性的潜力。 数据库层面上的锁——悲观锁和乐观锁 乐观锁:他对世界比较乐观,认为别人访问正在改变的数据的概率是很低的,所以直到修改完成准备提交所做的的修改到数据库的时候才会将数据锁住。完成更改后释放。 我想一下一个这样的业务场景:我们从数据库中获取了一条数据,我们正要修改他的数据时,刚好另外一个用户此时已经修改过了这条数据,这是我们是不知道别人修改过这条数据的。 解决办法,我们可以在表中增加一个version字段,让这个version自增或者自减,或者用一个时间戳字段,这个时间搓字段是唯一的。我们写数据的时候带上version,也就是每个人更新的时候都会判断当前的版本号是否跟我查询出来得到的版本号是否一致,不一致就更新失败,一致就更新这条记录并更改版本号。 例子如下: 1.查询出商品信息 select (status,status,version) from t_goods where id=#{id} 2.根据商品信息生成订单 3.修改商品status为2 update t_goods set status=2,version=version+1 where id=#{id} and version=#{version}; 用户体验表现层面通常表现为系统繁忙之类的。 在这里还要注意乐观锁的一个细节:就是version字段要自增或者自减,否者会出现ABA问题。 ABA问题:线程Thread1拿到了version字段为A,由于CAS操作(即先进行比较然后设值),线程Thread2先拿到的version,将version改成B,线程Thread3来拿到version,将version值又改回了A。此时Thread1的CAS(先比较后set值)操作结束了,继续执行,它发现version的值还是A,以为没有发生变化,所以就继续执行了。这个过程中,version从A变为B,再由B变为A就被形象地称为ABA问题了。 悲观锁:也称排它锁,当事务在操作数据时把这部分数据进行锁定,直到操作完毕后再解锁,其他事务操作才可操作该部分数据。这将防止其他进程读取或修改表中的数据。 一般使用 select ...for update 对所选择的数据进行加锁处理,例如 select * from account where name=”JAVA” for update, 这条sql 语句锁定了account 表中所有符合检索条件(name=”JAVA”)的记录。本次事务提交之前(事务提交时会释放事务过程中的锁),外界无法修改这些记录。 用户界面常表现为转圈圈等待。 如果数据库分库分表了,不再是单个数据库了,那么我们可以用分布式锁,比如redis的setnx特性,zookeeper的节点唯一性和顺序性特性来做分布式锁。

优秀的个人博客,低调大师

大数据||MapReduce编程模板

标准模板代码 package com.lizh.hadoop.mapreduce; import java.io.IOException; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.conf.Configured; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.LongWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import org.apache.hadoop.util.Tool; import org.apache.hadoop.util.ToolRunner; import com.lizh.hadoop.mapreduce.WordCountMapReduce.WordCountMapper; import com.lizh.hadoop.mapreduce.WordCountMapReduce.WordCountReduces; public class MouldMapReduce extends Configured implements Tool{ public class MouldMap extends Mapper<LongWritable, Text, Text, IntWritable>{ @Override protected void setup(Context context) throws IOException, InterruptedException { // TODO 读取数据前的一些初始化工作或者读取文件前的一些初始化工作 super.setup(context); } @Override protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { // TODO super.map(key, value, context); } @Override protected void cleanup(Context context) throws IOException, InterruptedException { // TODO Auto-generated method stub super.cleanup(context); } } public class MouldReduce extends Reducer<Text, IntWritable, Text,IntWritable>{ @Override protected void setup(Context context) throws IOException, InterruptedException { // TODO 读取数据前的一些初始化工作或者读取文件前的一些初始化工作 super.setup(context); } @Override protected void reduce(Text arg0, Iterable<IntWritable> arg1,Context arg2) throws IOException, InterruptedException { // TODO Auto-generated method stub super.reduce(arg0, arg1, arg2); } @Override protected void cleanup( org.apache.hadoop.mapreduce.Reducer.Context context) throws IOException, InterruptedException { // TODO Auto-generated method stub super.cleanup(context); } } private Job getJob(String[] args){ Configuration configuration = this.getConf(); Job job = null; try { job = Job.getInstance(configuration, this.getClass().getSimpleName()); job.setJarByClass(this.getClass()); } catch (IOException e) { // TODO Auto-generated catch block e.printStackTrace(); } return job; } public int run(String[] args) throws Exception { // TODO Auto-generated method stub //input-->map--reduce--output //getjob Job job = getJob(args); //setjob Path path = new Path(args[0]); FileInputFormat.addInputPath(job, path); // map job.setMapperClass(WordCountMapper.class); job.setMapOutputKeyClass(Text.class); job.setMapOutputValueClass(IntWritable.class); // reduce job.setReducerClass(WordCountReduces.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(IntWritable.class); //output Path outputpath = new Path(args[1]); FileOutputFormat.setOutputPath(job, outputpath); // submit job boolean rv = job.waitForCompletion(true);//true的时候打印日志 return rv ? 0:1; } public static void main(String[] args) throws Exception{ Configuration conf = new Configuration(); ToolRunner.run(conf, new MouldMapReduce(), args); } }

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册