首页 文章 精选 留言 我的

精选列表

搜索[自适应爬虫],共4675篇文章
优秀的个人博客,低调大师

Python3网络爬虫——(2)设置User Agent模拟浏览器访问

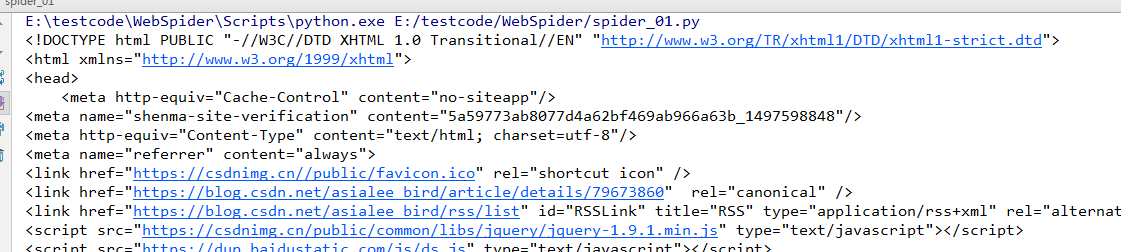
设置User Agent模拟浏览器访问 方法一、使用build_opener()修改报头 # -*- coding: UTF-8 -*- #使用build_opener()修改报头 from urllib import request if __name__ == "__main__": url="https://blog.csdn.net/asialee_bird/article/details/79673860" headers=("User-Agent","Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/64.0.3282.168 Safari/537.36") opener=request.build_opener() opener.addheaders=[headers] file=opener.open(url) data=file.read() print(data) 方法二、使用add_header修改报头 # -*- coding: UTF-8 -*- #使用add_header修改报头 from urllib import request if __name__ == "__main__": url="https://blog.csdn.net/asialee_bird/article/details/79673860" req=request.Request(url) #创建一个Request对象 req.add_header("User-Agent","Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/64.0.3282.168 Safari/537.36") file=request.urlopen(req) data=file.read() data=data.decode('utf-8') #对读取的信息进行解码 print(data) 结果: 方法三、 # -*- coding: UTF-8 -*- from urllib import request if __name__ == "__main__": #以CSDN为例,CSDN不更改User Agent是无法访问的 url = 'http://www.csdn.net/' head = {} #写入User Agent信息 head['User-Agent'] = 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/64.0.3282.168 Safari/537.36' req = request.Request(url, headers=head) #创建Request对象 response = request.urlopen(req) #传入创建好的Request对象 html = response.read().decode('utf-8') #读取响应信息并解码 print(html) #打印信息 注: 常见的User Agent 1.Android Mozilla/5.0 (Linux; Android 4.1.1; Nexus 7 Build/JRO03D) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.166 Safari/535.19 Mozilla/5.0 (Linux; U; Android 4.0.4; en-gb; GT-I9300 Build/IMM76D) AppleWebKit/534.30 (KHTML, like Gecko) Version/4.0 Mobile Safari/534.30 Mozilla/5.0 (Linux; U; Android 2.2; en-gb; GT-P1000 Build/FROYO) AppleWebKit/533.1 (KHTML, like Gecko) Version/4.0 Mobile Safari/533.1 2.Firefox Mozilla/5.0 (Windows NT 6.2; WOW64; rv:21.0) Gecko/20100101 Firefox/21.0 Mozilla/5.0 (Android; Mobile; rv:14.0) Gecko/14.0 Firefox/14.0 3.Google Chrome Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/27.0.1453.94 Safari/537.36 Mozilla/5.0 (Linux; Android 4.0.4; Galaxy Nexus Build/IMM76B) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.133 Mobile Safari/535.19 4.iOS Mozilla/5.0 (iPad; CPU OS 5_0 like Mac OS X) AppleWebKit/534.46 (KHTML, like Gecko) Version/5.1 Mobile/9A334 Safari/7534.48.3 Mozilla/5.0 (iPod; U; CPU like Mac OS X; en) AppleWebKit/420.1 (KHTML, like Gecko) Version/3.0 Mobile/3A101a Safari/419.3 上面列举了Andriod、Firefox、Google Chrome、iOS的一些User Agent,直接copy就能用

优秀的个人博客,低调大师

scrapy爬虫框架和selenium的使用:对优惠券推荐网站数据LDA文本挖掘

原文链接:http://tecdat.cn/?p=12203 介绍 每个人都喜欢省钱。我们都试图充分利用我们的资金,有时候这是最简单的事情,可以造成最大的不同。长期以来,优惠券一直被带到超市拿到折扣,但使用优惠券从未如此简单,这要归功于Groupon。 Groupon是一个优惠券推荐服务,可以在您附近的餐馆和商店广播电子优惠券。其中一些优惠券可能非常重要,特别是在计划小组活动时,因为折扣可以高达60%。 数据 这些数据是从Groupon网站的纽约市区域获得的。网站的布局分为所有不同groupon的专辑搜索,然后是每个特定groupon的深度页面。网站外观如下所示: 两个页面的布局都不是动态的,所以建立了一个自定义scrapy ,以便快速浏览所有的页面并检索要分析的信息。然而,评论,重要的信息,通过JavaScript呈现和加载 。Selenium脚本使用从scrapy获取的groupons的URL,实质上模仿了人类点击用户注释部分中的“next”按钮。 forurlinurl_list.url[0:50]: try: driver.get(url) time.sleep(2) #关闭出现的任何弹出窗口# #if(driver.switch_to_alert()): try: close=driver.find_element_by_xpath('//a[@id="nothx"]') close.click() except: pass time.sleep(1) try: link=driver.find_element_by_xpath('//div[@id="all-tips-link"]') driver.execute_script("arguments[0].click();",link) time.sleep(2) except: next i=1 print(url) whileTrue: try: time.sleep(2) print("ScrapingPage:"+str(i)) reviews=driver.find_elements_by_xpath('//div[@class="tip-itemclassic-tip"]') next_bt=driver.find_element_by_link_text('Next') forreviewinreviews[3:]: review_dict={} content=review.find_element_by_xpath('.//div[@class="twelvecolumnstip-textugc-ellipsisable-tipellipsis"]').text author=review.find_element_by_xpath('.//div[@class="user-text"]/span[@class="tips-reviewer-name"]').text date=review.find_element_by_xpath('.//div[@class="user-text"]/span[@class="reviewer-reviewed-date"]').text review_dict['author']=author review_dict['date']=date review_dict['content']=content review_dict['url']=url writer.writerow(review_dict.values()) i+=1 next_bt.click() except: break except: next csv_file.close() driver.close() 从每个组中检索的数据如下所示。 Groupon标题 分类信息 交易功能位置 总评分数网址 作者日期 评论网址 大约有89,000个用户评论。从每个评论中检索的数据如下所示。 print(all_groupon_reviews[all_groupon_reviews.content.apply(lambdax:isinstance(x,float))]) indx=[10096] all_groupon_reviews.content.iloc[indx] authordatecontent\ 10096PatriciaD.2017-02-15NaN 15846PatH.2016-09-24NaN 19595TovaF.2012-12-20NaN 40328PhyllisH.2015-06-28NaN 80140AndreA.2013-03-26NaN urlyearmonthday 10096https://www.groupon.com/deals/statler-grill-92017215 15846https://www.groupon.com/deals/impark-32016924 19595https://www.groupon.com/deals/hair-bar-nyc-120121220 40328https://www.groupon.com/deals/kumo-sushi-12015628 80140https://www.groupon.com/deals/woodburybus-com2013326 探索性数据分析 一个有趣的发现是在过去的几年里,群体的使用已经大大增加了。我们通过检查评论提供的日期来发现这一点。看下面的图像,其中x轴表示月/年和y轴,表示计数,这个结论变得明显。最后的小幅下滑是由于当时的一些小组可能是季节性的。 一个有趣的发现是在过去的几年里,群体的使用已经大大增加了。我们通过检查评论提供的日期来发现这一点。看下面的图像,其中x轴表示月/年和y轴,表示计数。最后的小幅下滑是由于当时的一些小组可能是季节性的。 pie_chart_df=Groupons.groupby('categories').agg('count') plt.rcParams['figure.figsize']=(8,8) sizes=list(pie_chart_df.mini_info) labels=pie_chart_df.index plt.pie(sizes,shadow=True,labels=labels,autopct='%1.1f%%',startangle=140) #plt.legend(labels,loc="best") plt.axis('equal') 最后,由于大部分数据是通过文本:价格(原价),导出了一个正则表达式来解析价格信息,以及它们提供的交易数量。该信息显示在以下条形图中: objects=list(offer_counts.keys()) y=list(offer_counts.values()) tst=np.arange(len(y)) plt.bar(tst,y,align='center') plt.xticks(tst,objects) plt.ylabel('TotalNumberofGroupons') plt.xlabel('DifferentDiscountsOffers') plt.show() plt.ylabel('NumberofOfferings') plt.xticks(ind,('Auto','Beauty','Food','Health','Home','Personal','Things')) plt.xlabel('CategoryofGroupon') plt.legend((p0[0],p1[0],p2[0],p3[0],p4[0],p5[0],p6[0],p7[0],p10[0]),('0','1','2','3','4','5','6','7','10')) sns.violinplot(data=savings_dataframe) 最后,利用用户评论数据生成一个文字云: plt.rcParams['figure.figsize']=(20,20) wordcloud=WordCloud(width=4000,height=2000,max_words=150,background_color='white').generate(text) plt.imshow(wordcloud,interpolation='bilinear') plt.axis("off") 主题建模 为了进行主题建模,使用的两个最重要的软件包是gensim和spacy。创建一个语料库的第一步是删除所有停用词,如“,”等。最后创造trigrams。 选择的模型是Latent Dirichlet Allocation,因为它能够区分来自不同文档的主题,并且存在一个可以清晰有效地将结果可视化的包。由于该方法是无监督的,因此必须事先选择主题数量,在模型的25次连续迭代中最优数目为3。结果如下: 上面的可视化是将主题投影到两个组件上,其中相似的主题会更接近,而不相似的主题会更远。右边的单词是组成每个主题的单词,lambda参数控制单词的排他性。0的lambda表示每个主题周围的最排斥的单词,而1的lambda表示每个主题周围的最频繁的单词。 第一个话题代表服务的质量和接待。第二个话题有描述锻炼和身体活动的词语。最后,第三个话题有属于食品类的词语。 结论 主题建模是无监督学习的一种形式,这个项目的范围是简要地检查在基础词语背后发现模式的功能。虽然我们认为我们对某些产品/服务的评论是独一无二的,但是这个模型清楚地表明,实际上,某些词汇在整个人群中被使用。
优秀的个人博客,低调大师

Python爬虫入门教程 32-100 B站博人传评论数据抓取 scrapy

1. B站博人传评论数据爬取简介 今天想了半天不知道抓啥,去B站看跳舞的小姐姐,忽然看到了评论,那就抓取一下B站的评论数据,视频动画那么多,也不知道抓取哪个,选了一个博人传跟火影相关的,抓取看看。网址: https://www.bilibili.com/bangumi/media/md5978/?from=search&seid=16013388136765436883#short在这个网页看到了18560条短评,数据量也不大,抓取看看,使用的还是scrapy。 2. B站博人传评论数据案例---获取链接 从开发者工具中你能轻易的得到如下链接,有链接之后就好办了,如何创建项目就不在啰嗦了,我们直接进入主题。 我在代码中的parse函数中,设定了两个yield一个用来返回items 一个用来返回requests。然后实现一个新的功能

优秀的个人博客,低调大师

Python爬虫入门教程 25-100 知乎文章图片爬取器之一

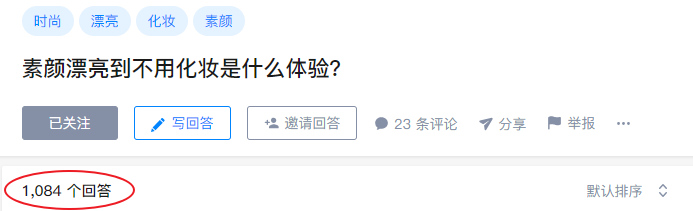
1. 知乎文章图片爬取器之一写在前面 今天开始尝试爬取一下知乎,看一下这个网站都有什么好玩的内容可以爬取到,可能断断续续会写几篇文章,今天首先爬取最简单的,单一文章的所有回答,爬取这个没有什么难度。 找到我们要爬取的页面,我随便选了一个 https://www.zhihu.com/question/292393947 1084个回答,数据量可以说非常小了,就爬取它吧。 2. 知乎文章图片爬取器之一选取操作库和爬取地址 爬取使用requests 存储使用 mongodb 就可以了 爬取地址经过分析之后,找到了一个可以返回json的数据接口 提取链接,看一下各参数的意思,方便我们程序模拟 https://www.zhihu.com/api/v4/questions/292393947/answers?include=data%5B%2A%5D.is_

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册