首页 文章 精选 留言 我的

精选列表

搜索[orm框架],共10000篇文章
优秀的个人博客,低调大师

国产 sqltoy-orm 5.2.61 发版,别再 mybatis 以及 plus、plus 了!

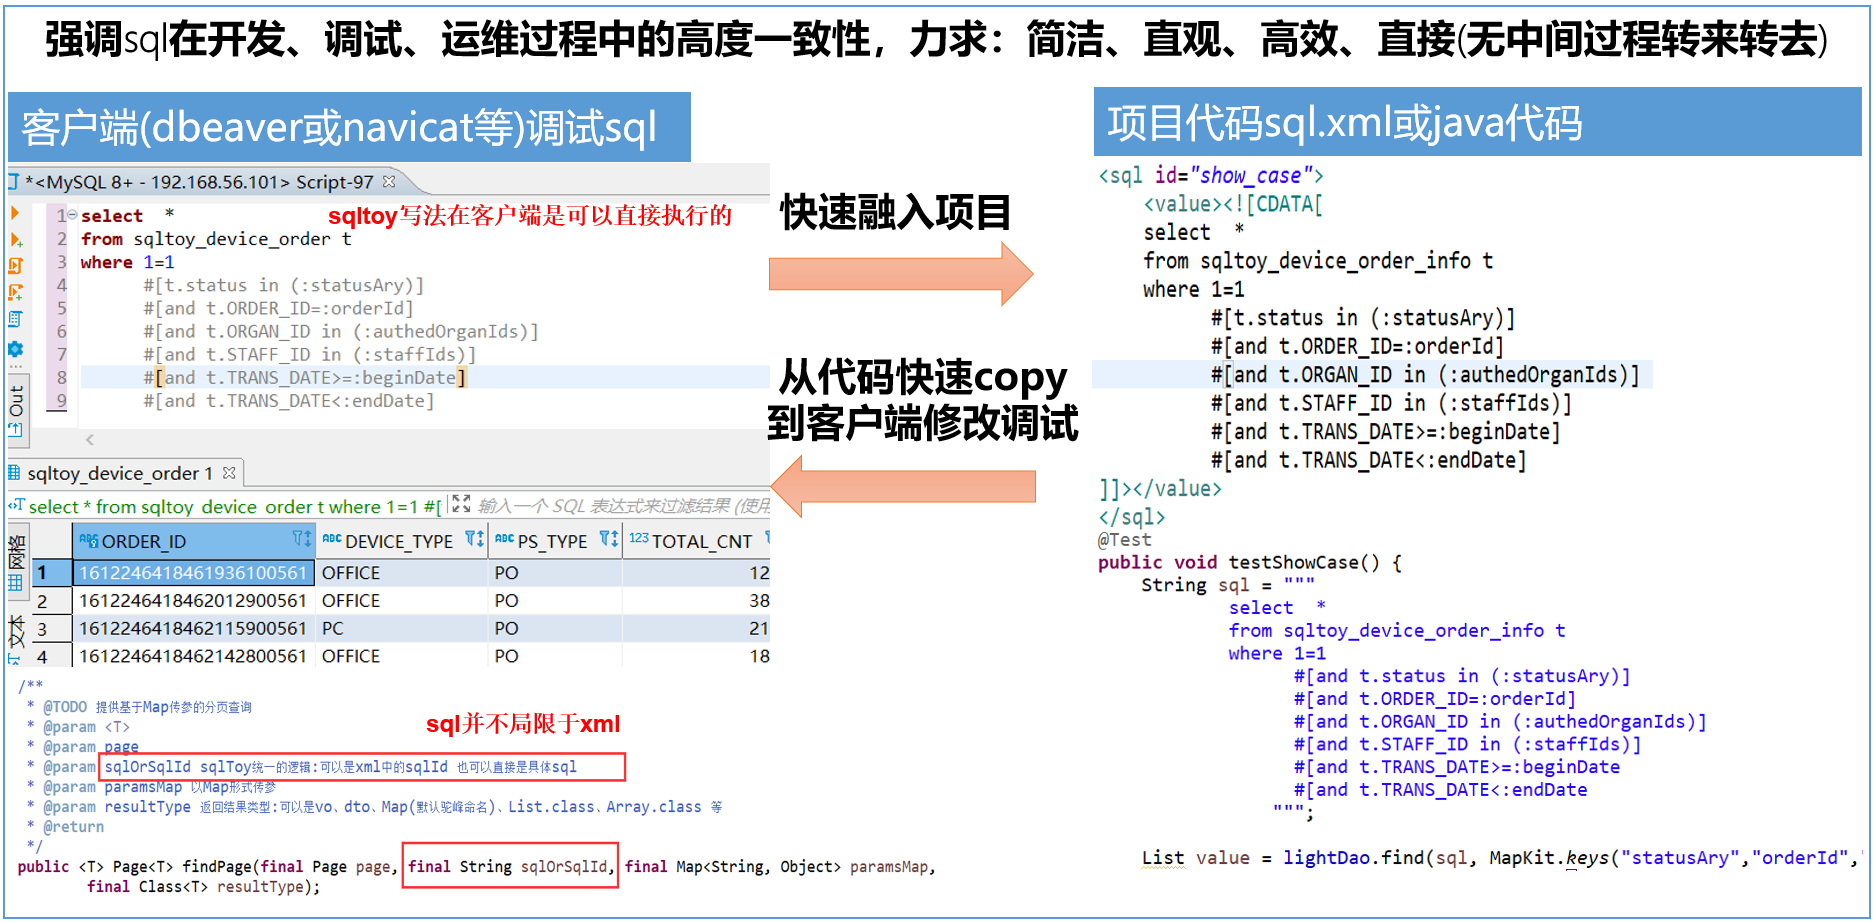
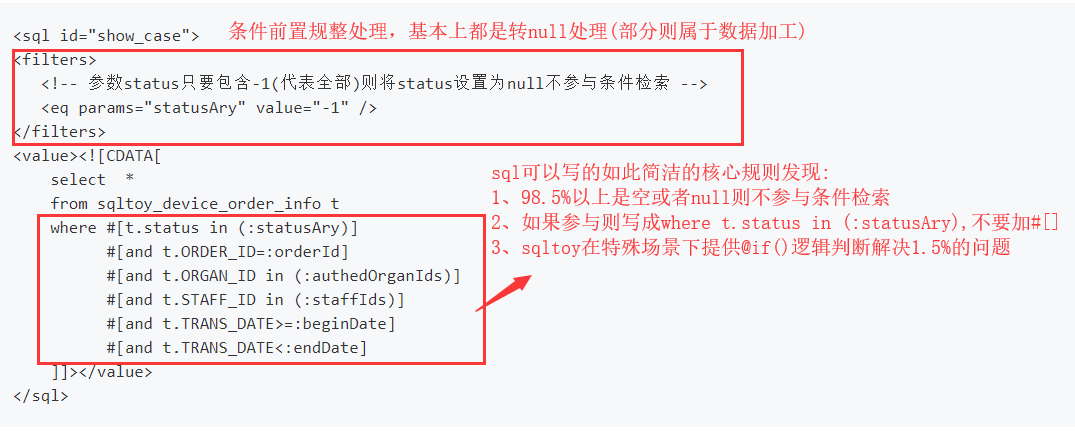
这样的标题不少人认为sqltoy在踩mybatis,搞一踩一捧模式,所以开篇强调一下! 大家为什么选择mybatis,而不选JPA?不就是因为mybatis写sql灵活吗?可以自由的优化 sqltoy真正值得肯定的是sql的编写,如果大家认为sqltoy的sql写法更科学直观便于后期维护那算不算直接否定了mybatis的核心价值点? 开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/threefish/sqltoy-idea-plugins sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、增加默认支持字段枚举类型(无需写typeHandler:取key的方法要求:getValue\getKey\getCode\getId四者之一)2、支持存储过程返回多个集合 /** * @TODO 存储过程调用,outParams可以为null * @param storeSqlOrKey 可以是xml中的sqlId 或者直接{call storeName (?,?)} * @param inParamValues * @param outParamsType 可以为null * @param resultTypes 可以是VO、Map.class、LinkedHashMap.class、Array.class,null(二维List) * @return StoreResult */ public StoreResult executeMoreResultStore(String storeSqlOrKey, Object[] inParamValues, Integer[] outParamsType, Class... resultTypes); sqltoy 的关键优势: //------------------了解 sqltoy的关键优势: -------------------------------------------------------------------------------------------*/ //1、最简最直观的sql编写方式(不仅仅是查询语句),采用条件参数前置处理规整法,让sql语句部分跟客户端保持高度一致 //2、sql中支持注释(规避了对hint特性的影响,知道hint吗?搜oracle hint),和动态更新加载,便于开发和后期维护整个过程的管理 //3、支持缓存翻译和反向缓存条件检索(通过缓存将名称匹配成精确的key),实现sql简化和性能大幅提升 //4、支持快速分页和分页优化功能,实现分页最高级别的优化,同时还考虑到了cte多个with as情况下的优化支持 //5、支持并行查询 //6、根本杜绝sql注入问题 //7、支持行列转换、分组汇总求平均、同比环比计算,在于用算法解决复杂sql,同时也解决了sql跨数据库问题 //8、支持保留字自动适配 //9、支持跨数据库函数自适配,从而非常有利于一套代码适应多种数据库便于产品化,比如oracle的nvl,当sql在mysql环境执行时自动替换为ifnull //10、支持分库分表 //11、提供了取top、取random记录、树形表结构构造和递归查询支持、updateFetch单次交互完成修改和查询等实用的功能 //12、sqltoy的update、save、saveAll、load 等crud操作规避了jpa的缺陷,参见update(entity,String...forceUpdateProps)和updateFetch //13、提供了极为人性化的条件处理:排它性条件、日期条件加减和提取月末月初处理等 //14、提供了查询结果日期、数字格式化、安全脱敏处理,让复杂的事情变得简单,大幅简化sql或结果的二次处理工作 //-----------------------------------------------------------------------------------*/ sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

Bouyei.DbFactory 22.5.6 发布,多种数据库 Ado+ORM

.net 多种数据库统一接口 Bouyei.DbFactory 已经发布 22.5.6 版本,带来如下改动 增加Join扩展方法。 升级依赖库支持,(.net core 6,standard 2.1) 优化流读取方法支持多种返回类型和方式 增加.net core的 bulkcopy入库方法 优化DbParameter插入方法 优化odbc和oledb(.net core 和standard)问题和引用方式 其他细节问题修复和优化 详情查看:https://gitee.com/bouyei/Bouyei.DbFactory/releases/22.5.6

优秀的个人博客,低调大师

sqltoy-orm 4.18.2 发版,支持 es ssl 和 jdbc 模式访问

开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件(可直接在idea中检索安装):https://github.com/threefish/sqltoy-idea-plugins 更新内容 1、elasticsearch restclient模式支持ssl模式 ```yml spring: sqltoy: # 多个路径用逗号分隔 sqlResourcesDir: classpath:com/sagframe/sqltoy/showcase # 默认为classpath:sqltoy-translate.xml,一致则可以不用设置 translateConfig: classpath:sqltoy-translate.xml # 默认为false,debug模式将打印执行sql,并自动检测sql文件更新并重新加载 debug: true # 设置默认使用的datasource(可选配置) defaultDataSource: dataSource # sql执行超过多长时间则进行日志输出,用于监控哪些慢sql(可选配置:默认30秒) printSqlTimeoutMillis: 300000 # elastic 节点配置 elastic: # 默认节点可以不设置,默认第一个 defaultId: default endpoints[0]: id: default # 集群多个节点可以用逗号分隔 url: http://192.168.56.104:9200 # 证书文件 #keyStore: #证书密码 #keyStorePass: # 默认jks,可不设置 #keyStoreType: jks username: elastic password: SagFrame@123 # 原生:_sql(_xpack/sql);es-sql:_nlpcn/sql;_opendistro/_sql # 原生es的sql不支持分页,推荐使用其他插件 sqlPath: _sql ``` 2、elasticsearch jdbc模式方法适配(es 不支持/* */注释和分页:count(1) 需调整为count(*)) 感谢: 网友碧涛的反馈和验证 分页优化过程介绍 https://my.oschina.net/u/4234377/blog/3233919 简要介绍sqltoy的几个特点(jpa式的对象crud大家早习以为常不作介绍) sqltoy 提供了最简洁的动态 sql 编写 我们对比一下mybatis的实现(从可阅读、可维护等视角看): 缓存翻译,利用缓存减少关联查询,简化sql同时大幅提升效率 极致分页优化 并行查询 // 使用并行查询同时执行2个sql,条件参数是2个查询的合集 String[] paramNames = new String[] { "userId", "defaultRoles", "deployId", "authObjType" }; Object[] paramValues = new Object[] { userId, defaultRoles, DEPLOY_ID,GROUP }; List<QueryResult<TreeModel>> list = super.parallQuery( Arrays.asList(ParallQuery.create().sql("webframe_searchAllModuleMenus").resultType(TreeModel.class), ParallQuery.create().sql("webframe_searchAllUserReports").resultType(TreeModel.class)), paramNames, paramValues); 数据旋转 无限极分组统计(含汇总求平均),算法配置简单又跨数据库! 同比环比

优秀的个人博客,低调大师

jSqlBox 4.0.3 发布,Java 全功能数据库持久层 ORM 工具

jSqlBox是一个Java全功能数据库持久层工具,主页 https://gitee.com/drinkjava2/jsqlbox jSqlBox主要特点是架构优、尺寸小、功能全,基本上所有与数据库操作相关的功能,jSqlBox都已提供。其它数据库工具的主要功能,jSqlBox通常都有对应的方案提供,不提供的往往是不重要甚至是反模式的功能,不信可以随便找一个其它持久层工具的功能,而jSqlBox却没有提供或无法轻易实现的功能来,我会给一个合理解释。反之,如下jSqlBox具备的功能其它持久层工具往往并不提供: 1.支持在Java里存放和定位多行(SQL)文本 2.参数内嵌式SQL写法 3.自带分库分表 4.自带声明式事务、分布式事务 5.ActiveRecord模式实体类可以只声明接口,不占用宝贵的单继承 6.支持多种数据库方言的DDL生成 jSqlBox的目标是做最好的通用持久层工具,正如我喜欢给别的项目找缺点一样,也欢迎大家来找出jSqlBox的缺点。开源项目就是在不断的对比和相互学习中进步的。另外如果有谁想听我唠叨其它持久层工具优缺点的,也可以在评论里提出,一起来讨论,jSqlBox是因为无法忍受现有持久层工具的缺点而诞生的,但是缺点是不是都找对了是值得花时间讨论的。 本次更新(4.0.3.jre8版)内容: 1. [I19WO0] 添加@CreateTimestamp和@UpdateTimestamp两个实体注解,前者在实体插入到数据库时自动写入当前时间戳,后者在实体更新时自动更新对应字段的时间戳,这两个注解添加在Date或Timestamp类型上,一个使用示例如下: public class SomeEntity { @CreateTimestamp java.sql.TimeStamp createTime; @Temporal(TemporalType.TIMESTAMP) //指定Date的映射类型,可选 @UpdateTimestamp java.util.Date updateTime; ... } 2. 添加@CreatedBy和@LastModifiedBy两个实体注解,前者在实体插入到数据库时自动写入当前创建者ID,后者在实体更新时自动更新对应字段的编辑者ID,这两个注解添加在实体的String类型属性上,一个使用示例如下: public class SomeEntity { @CreatedBy String creator; @LastModifiedBy String modifier; ... } 因为这两个注解的当前创建者或修改者ID是在运行期动态获取的,所以如果用到这两个注解,必须在jSqlBox的DbContext上下文初始化时,先设置一个编辑者ID获取类的实例,这个类中必须有一个名为getCurrentAuditor的方法。示例如下: public static class GetUserIdDemo { public Object getCurrentAuditor() { //从Spring Security或Shiro之类的单点登录工具中获取当前用户ID值 return SomeSecurityUtil.getCurrentUserID(); } } DbContext db=new DbContext(dataSource); db.setAuditorGetter(new GetUserIdDemo()); 3. 添加一个@COLUMN实体注解 @COLUMN这个全大写的注解表示它是非标的,与标准JPA的@Column注解的区别是多了creationTimestamp, cpdateTimestamp, createdBy, lastModifiedBy, comment, tail这几个私房货字段。所以@CreationTimestamp注解也可以写成@COLUMN(creationTimestamp=true),效果等同。 @COLUMN注解中的comment和tail不会覆盖掉columnDefinition的内容,而是累加在后面。comment顾名思义是数据表collumn列定义的comment片段,tail则可以加入任意字符串内容到column的DDL列定义未尾。 4. 增强了从数据库生成Java实体源代码功能,将细节配置放在map里作为参数,并增加了linkStyle和fieldFlags两个选项。使用示例如下,以下语句会读取数据库所有表格并在指定的"c:\temp"目录下生成与所有数据库表格对应的实体类源码: Map<String, Object> setting = new HashMap<String, Object>(); setting.put("packageName", "somepackage"); setting.put("imports", "import com.github.drinkjava2.jdialects.annotation.jdia.*;\n" + "import com.github.drinkjava2.jdialects.annotation.jpa.*;\n" + "import com.github.drinkjava2.jsqlbox.*;\n" + "import static com.github.drinkjava2.jsqlbox.DB.*;\n"); setting.put("classDefinition", "public class $1 extends ActiveRecord<$1>"); setting.put("linkStyle", true); setting.put("fieldFlags", true); ... TableModelUtils.db2JavaSrcFiles(dataSource, Dialect.MySqlDialect, "c:/temp", setting); db2JavaSrcFiles方法的第一个参数是数据池,第二个参数是方言,第三个参数是输出目录,第四个参数是一个细节配置Map,其中的设定有: packageName: 实体类的包名 imports: 要引入哪些外部包 classDefinition: 类定义模板,$1占位符会被类名替换,类可以是POJO,也可以继承于jSqlBox的ActiveRecord或只声明实现ActiveEntity接口(限Java8)。 linkStyle:生成链式风格的setter, 即settter方法不再是void声明,而是会返回类实例本身。链式风格的优点是可以写出非常简洁高效的语句,如: new User().setId("张三").load().setAge(13).update(); fieldFlags: 为每一个实体属性生成一个字符串常量,常量名为为属性的大写,值为数据表的列名。有了这个字段,可以利用它来拼写支持重构的SQL。 以下是一个实际由jSqlBox的源码生成程序生成的实体类示例,它的linkStyle属性和fieldFlags属性都设为了true: package somepackage; import com.github.drinkjava2.jdialects.annotation.jdia.*; import com.github.drinkjava2.jdialects.annotation.jpa.*; import com.github.drinkjava2.jsqlbox.*; import static com.github.drinkjava2.jsqlbox.DB.*; @Table(name="entity1") public class Entity1 extends ActiveRecord<Entity1> { public static final String ID = "id"; @Id @Column(name=ID) private Integer id; public static final String NAME = "name"; @Id @Column(name=NAME, length=10) private String name; public static final String CUSTID = "cust_id"; @Column(name=CUSTID) private Integer custId; public Integer getId(){ return id; } public Entity1 setId(Integer id){ this.id=id; return this; } public String getName(){ return name; } public Entity1 setName(String name){ this.name=name; return this; } public Integer getCustId(){ return custId; } public Entity1 setCustId(Integer custId){ this.custId=custId; return this; } } 实体源码自动生成功能在项目开发初期比较有用,尤其是以数据库建模驱动而不是以实体建模驱动开发的项目,但是不能过分依赖它,代码生成工具到了项目后期就成了鸡肋,实体字段的增减、重构,直接在IDE里修改反而更简单稳当。

优秀的个人博客,低调大师

【框架】121:spring框架之IOC容器

今天是刘小爱自学Java的第121天。 感谢你的观看,谢谢你。 在spring核心配置文件中,有一个bean标签,我们以前创建一个对象都是直接new。 而在spring中可以将对象交给spring管理,再通过spring工厂直接获取。 所以我们也称之为spring容器。 今天的学习内容就是关于bean标签: Bean的作用域:单例与多例说明。 Bean属性依赖注入的两种方式,以及p名称空间、seEL表达式的引入。 补充说明一个IDEA插件。 一、bean的作用域 作用域也就是指:由spring创建的bean对象在什么情况下有效?主要有单例和多例两种。 在spring核心配置文件中可以配置对象是单例还是多例,通过scope属性设定: 值为singleton即为单例,默认值,可省略。 值为prototype即为多例。 1单例测试 多次获取单例对象,并打印输出。 我们会发现:如果是单例的话,构造方法只运行一次,多次获取的是同一个对象。 在spring IOC容器中仅存在一个bean实例,bean以单例方式存在。 注意:这边我大致提下,昨天忘记说明了,通过spring工厂获取对象时,参数可以是id,也可以是bean的类型,也就是对应接口/类的Class对象。 使用id获取最稳妥,如果根据类型获取,配置了多个类型的话,会抛出异常。 2多例测试 多次获取单例对象,并打印输出。 我们会发现:多例构造方法会运行多次,多次获取的都是不同的对象。 每次从容器中调用bean时,都会返回一个新的实例,即每次调用getBean()的时候,相当于new了一次bean对象。 二、bean属性的依赖注入 什么是Bean属性的依赖注入? 就可以理解成对一个对象的属性赋值,这个我们昨天就接触过,其有两种注入方式: 1构造器参数注入 constructor-arg ①创建Car类,定义构造方法 既然是通过构造器参数注入,那肯定需要有参构造方法,其中为了方便测试时观看,还在该类中重写一个toString方法。 ②spring配置构造器参数 constructor-arg:该标签相当于在告诉spring容器,要调用有参构造方法了,不再调用默认的构造方法了。 所以必须要有有参构造方法,不然会报错。 index:根据索引定位属性,0表示首位。 name:根据属性参数名称定位属性。 type:根据属性数据类型定位属性。 value:简单的值,字符串。 ref:复杂的值,就是通过该属性可以引用由spring容器创建的其它bean对象。 一般都是使用name属性赋值,这样最合理,也一目了然,name和type这两种都不靠谱。 配置完成,做一个测试 根据运行结果我们能发现,通过spring的配置,可以给对象初始化赋值。 也就相当于new Car(1,"长安",20000)。 通过spring就不需要我们自己new了。 2setXXX方法属性注入 和上述构造器参数注入的效果是差不多的,只不过setXXX方法更具有选择性。 构造器参数注入有几个参数都得设置,少一个都不行,而该方法想设置哪个就设置哪个。 ①创建Person类,定义setXXX方法 使用Lombok插件可以快速创建一个Javabean,这个插件文章最后有说明。 ②spring配置setXXX方法参数 property标签:spring中专门进行setXXX属性注入的标签 。 name:setXXX方法的属性名字,例如setXXX()那么name的属性值为XXX。 value:简单的值。 ref:复杂的值,引用由spring容器创建的其它bean对象的名字。 配置完成,做一个测试 根据运行结果我们能发现,通过spring的setXXX方法属性注入,也可以给对象赋值。 该方法也就相当于通过对象调用方法setId(1),setName(“刘小爱”)… 三、p名称空间和spEL表达式 为简化XML文件的配置,Spring2.5版本开始引入了一个新的p名称空间。 准确地说,它的作用是为了简化setXXX方法属性依赖注入配置的,使用方式如下图: 在配置文件表头,引入p名称空间。 可以将property标签直接作为属性使用。 如果是引用简单对象,直接用属性名说明即可,比如p:id,p:name。 如果是引用复杂对象,需要用ref来补充说明,比如p:car-ref。 通过上图,我们能发现p名称空间能进一步地简化了代码的编写。 2spEL表达式 spEL全称Spring Expression Language,一种表达式语言,和前面学的EL表达式很像。 语法:#{…} ,通过该表达式可以引用属性、另一个Bean、甚至运算,方法都可以。 spEL表达式的使用功能比较多,Bean操作相关的通常有: #{bean的Id} 引用Bean,比如#{car}。 #{bean的Id.属性} 引用Bean的属性,比如#{person1.name}。 #{bean的Id.方法(参数)} 调用Bean的方法 附:补充一个Lombok插件 在idea开发工具中,选择File-settings,找到Plugins,在搜索框中搜索lombok。 如果以前没使用过该插件,右侧下载即可。 插件下载好后,还需要导入依赖才能使用。 在maven网站中找到lombok,随便选择一个版本,将依赖复制到我们项目对应的pom文件中即可。 依赖导入完毕,就可以使用该插件了。 它有什么用呢? 我们以前创建一个标准的JavaBean,有构造方法,有getset方法,有toString方法,一下子要写很多方法。 但是现在有了lombok插件后,只需要在类上加一个注释@Data,这些方法就都不用写了。 最后 谢谢你的观看。 如果可以的话,麻烦帮忙点个赞,谢谢你。 本文分享自微信公众号 - 刘小爱(liuxiaoai946)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册