Python爬虫入门教程 26-100 知乎文章图片爬取器之二
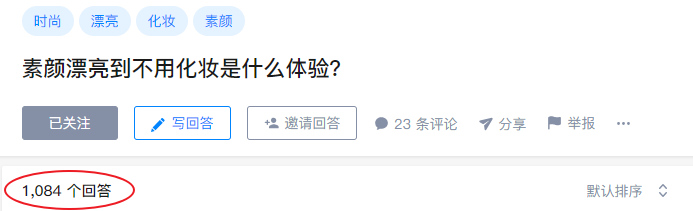
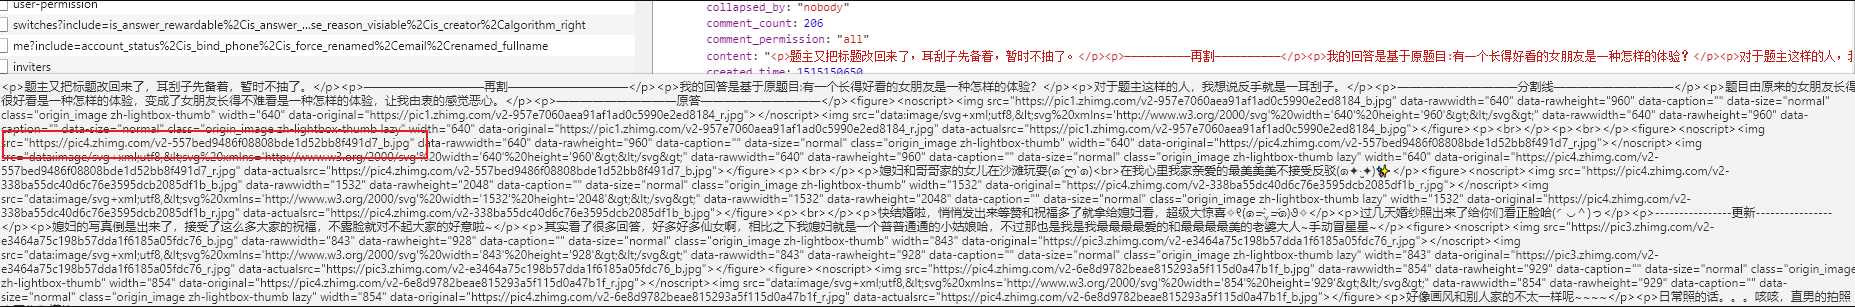
1. 知乎文章图片爬取器之二博客背景 昨天写了知乎文章图片爬取器的一部分代码,针对知乎问题的答案json进行了数据抓取,博客中出现了部分写死的内容,今天把那部分信息调整完毕,并且将图片下载完善到代码中去。 首先,需要获取任意知乎的问题,只需要你输入问题的ID,就可以获取相关的页面信息,比如最重要的合计有多少人回答问题。问题ID为如下标红数字 https://www.zhihu.com/question/ color=red>29024583 编写代码,下面的代码用来检测用户输入的是否是正确的ID,并且通过拼接URL去获取该问题下面合计有多少答案。 import requests import re import pymongo import time DATABASE_IP = '127.0.0.1' DATABASE_PORT = 27017 DATABASE_NAME = 'sun' client = pymongo.MongoClient(DATABASE_IP,DATABASE_PORT) db = client.sun db.authenticate("dba", "dba") collection = db.zhihuone # 准备插入数据 BASE_URL = "https://www.zhihu.com/question/{}" def get_totle_answers(article_id): headers = { "user-agent": "需要自己补全 Mozilla/5.0 (Windows NT 10.0; WOW64)" } with requests.Session() as s: with s.get(BASE_URL.format(article_id),headers=headers,timeout=3) as rep: html = rep.text pattern =re.compile( '<meta itemProp="answerCount" content="(\d*?)"/>') s = pattern.search(html) print("查找到{}条数据".format(s.groups()[0])) return s.groups()[0] if __name__ == '__main__': # 用死循环判断用户输入的是否是数字 article_id = "" while not article_id.isdigit(): article_id = input("请输入文章ID:") totle = get_totle_answers(article_id) if int(totle)>0: zhi = ZhihuOne(article_id,totle) zhi.run() else: print("没有任何数据!") 完善图片下载部分,图片下载地址在查阅过程中发现,存在json字段的content中,我们采用简单的正则表达式将他匹配出来。细节如下图展示 编写代码吧,下面的代码注释请仔细阅读,中间有一个小BUG,需要手动把pic3修改为pic2这个地方目前原因不明确,可能是我本地网络的原因,还有请在项目根目录先创建一个imgs的文件夹,用来存储图片 def download_img(self,data): ## 下载图片 for item in data["data"]: content = item["content"] pattern = re.compile('<noscript>(.*?)</noscript>') imgs = pattern.findall(content) if len(imgs) > 0: for img in imgs: match = re.search('<img src="(.*?)"', img) download = match.groups()[0] download = download.replace("pic3", "pic2") # 小BUG,pic3的下载不到 print("正在下载{}".format(download), end="") try: with requests.Session() as s: with s.get(download) as img_down: # 获取文件名称 file = download[download.rindex("/") + 1:] content = img_down.content with open("imgs/{}".format(file), "wb+") as f: # 这个地方进行了硬编码 f.write(content) print("图片下载完成", end="\n") except Exception as e: print(e.args) else: pass 更多内容,欢迎关注 https://dwz.cn/r4lCXEuL