数字人动画云端渲染方案
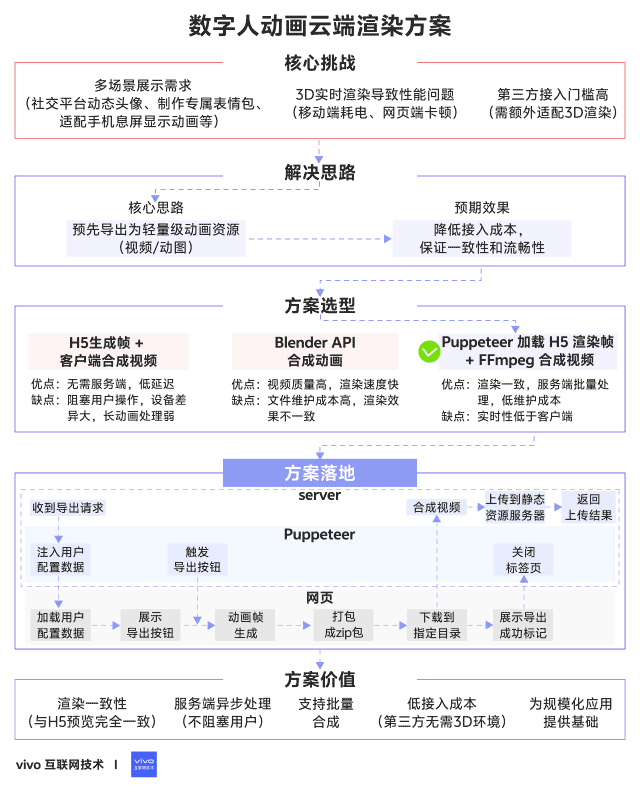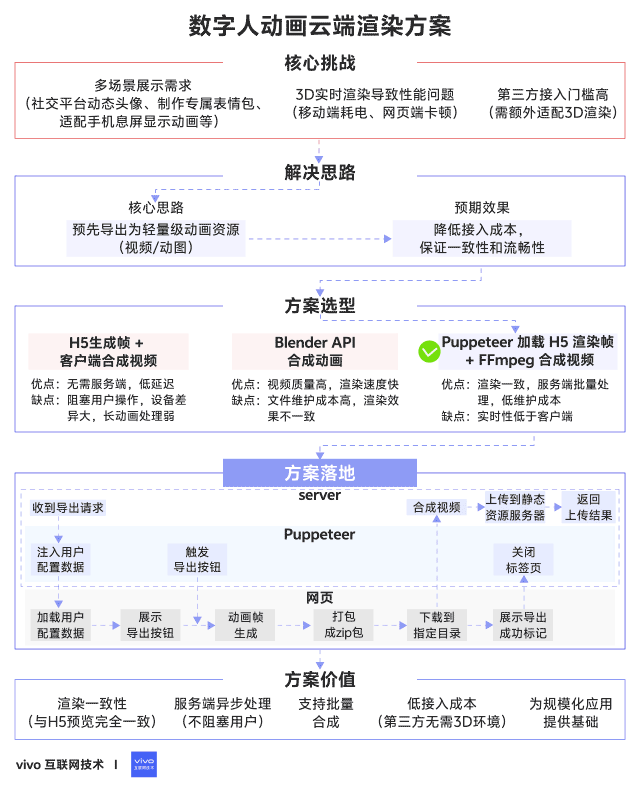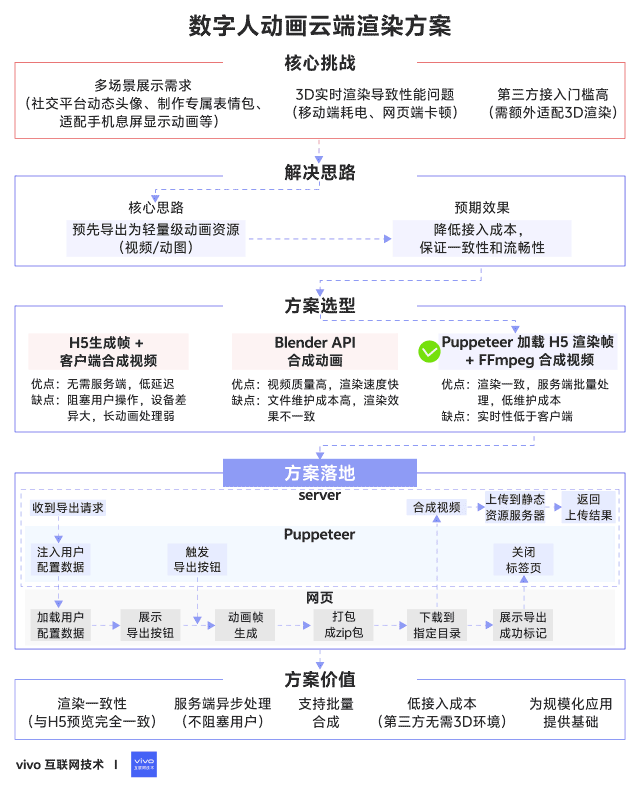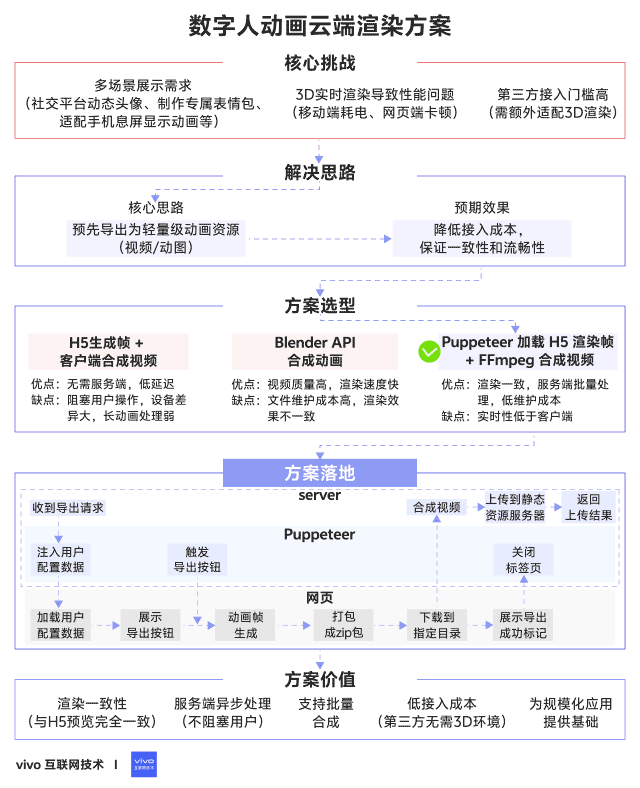
作者:vivo 互联网前端团队 - Su Ning 为解决拟我形象在多场景展示中依赖 3D 渲染导致的性能与接入问题,本文提出将形象预先导出为视频或动图资源。对比三种技术路径后,最终选择 Puppeteer + H5 渲染帧 + FFmpeg 合成视频 的方案,实现了渲染效果一致、服务端批量处理和低接入成本,为拟我形象的规模化应用提供了高效可扩展的技术基础。 1分钟看图掌握核心观点_👇_ 图1 VS 图2,您更倾向于哪张图来辅助理解全文呢?欢迎在评论区留言 _一、_背景 在拟我形象功能的实际应用中,用户完成形象配置后,普遍存在将该形象应用于多场景展示的需求 —— 例如将其设置为社交平台的动态头像、制作专属表情包、适配手机息屏显示动画,或是生成个性化壁纸等。 然而,这里存在一个关键技术矛盾:拟我形象的渲染依赖 3D 运行环境,若在动态头像、息屏显示等多场景中均实时加载完整 3D 渲染环境,会导致设备性能过载(如移动端耗电加剧、网页端卡顿),同时大幅提高第三方场景的接入门槛(需额外适配 3D 渲染逻辑)。 为解决这一矛盾,核心思路是将用户配置的拟我形象预先导出为指定格式的动画资源 —— 即通过技术手段将 3D 形象转换为轻量级的视频或动图文件,后续各场景仅需直接调用已生成的动画资源即可展示,无需依赖 3D 渲染环境。这一方案能显著降低第三方场景的接入成本,同时保证形象展示的一致性与流畅性。 但新的问题随之产生:如何高效、高质量地完成拟我形象的动效合成?需结合各场景的需求,选择最优的动效合成技术路径,成为当前亟待解决的核心问题。 二、方案选择 想要实现动效视频的合成,可选的方案有三种: 2.1 H5生成动画帧,H5/客户端合成视频 拟我形象本身是一个混合开发方案,H5负责整个捏脸流程的实现,在客户端则提供包括资源缓存等基础能力的实现。如果是输出长度较短的单个动画,如动态头像,可以直接通过操作模型执行指定的动画输出视频帧,再将视频帧合成视频。 合成视频可以在H5端使用FFmpeg或者webcodec,但是前者的导出效率只有端侧的1/20,后者存在很严重的兼容性问题,在移动端上甚至有概率出现黑色闪烁。所以还是选择在客户端进行视频的合成与上传的操作。 2.2 blender api合成动画 端侧合成视频实现简单且容易维护,但是存在很强的局限性:帧输出的过程用户无法进行任何操作,且受限于移动端设备种类多样,不同手机中的导出时长也不统一,导出单段动画还好,如果是导出多段动画,相信在动画导出之前用户已经流失掉了。 这种情况下将渲染放到服务端进行就顺理成章了,我们首先想到的是通过脚本调用blender api进行渲染。 blender -b ./avatar.blend -P render.py -o ./result/ 需要将底模以及所有的服装、发型、配饰等部件放到同一个模型里面,调用前置的python脚本还原用户的配置,然后输出对应的视频。 使用blender渲染的优点是输出视频的质量很高,且Eevee渲染器的渲染速度也很快,但是也会带来一系列棘手的问题: 首先是blend文件的维护,由于不同的部件可能是不同的设计师输出的,最终都要整合到同一个文件中,会导致额外的维护成本。相比于上面的问题,更麻烦的是前端使用的不同部位的glb文件是通过管理后台进行维护,不同环境之间的同一部件可能id、命名都不相同,也就意味着在不同环境下需要维护不同的blend文件;使用后台进行模型文件的管理本意是为了增加配置的灵活性,但是使用单个blend文件进行管理又会失去这种维护性。随着模型和动画的不断更新,这个方案的维护成本很难控制。 即使不考虑开发和维护的成本,使用blender渲染的视频和前端渲染的质量和效果也不一致,相比于H5需要考虑设备的兼容性和性能限制,使用blender渲染的动画确实画质更佳、细节更丰富,但是也会让用户产生“货不对版”的错觉。所以统一不同设备的渲染风格也很重要。 2.3 Puppeteer访问H5输出动画帧,FFmpeg合成视频 综合上面两个方案,在大量动画需要渲染的场景下,既要不阻塞用户,又要保证渲染的一致性。 如果不阻塞用户,那么渲染行为就要放在服务端。 如果保证渲染的一致性,那么最好是使用H5渲染。 答案呼之欲出了,那就是使用Puppeteer或Playwright这种网页自动化工具,加载H5页面进行渲染。结合我们的使用场景,最终选择了Puppeteer。 三、实现思路 针对Puppeteer方案,我们设计了如图的实现路径 具体实现拆分为三个部分,分别为用于帧输出的页面开发、Puppeteer流程设计以及视频合成。 3.1 用于帧输出的页面 为尽量降低维护成本,我们将根据配置文件加载的模型抽象为独立模块,并同时应用在用户访问页面和云端渲染页面中。 在页面唤醒时,Puppeteer 会将所需的用户数据与导出的动画名称注入到 window 对象中。网页在读取并加载对应配置后,会展示一个“导出视频”的按钮。理论上在配置加载完成后即可直接开始帧生成,但为了方便本地开发与调试,我们仍保留了手动触发导出的按钮。 当帧生成完成后,系统会将所有图片打包压缩为一个 ZIP 文件并保存到本地。随后,页面会展示一个指定 ID 的 DOM 元素,Puppeteer 检测到该元素后,即视为帧输出已完成,随后关闭页面并进入后续流程。 3.2 Puppeteer流程设计 作为一个常驻服务,Puppeteer只需要初始化一次浏览器,随服务的启动即创建。所有的任务都作为标签页运行在这个浏览器下,每新建一个导出任务都会新建一个标签页,在导出任务完成之后关闭相应的页面。 // 创建浏览器,并禁用沙箱,不禁用沙箱会导致运行在镜像环境中报错 constbrowser =awaitpuppeteer.launch({ headless:'new', args: [ '--no-sandbox',// 禁用沙箱 '--disable-setuid-sandbox',// 禁用 setuid 沙箱 ] }); functionexportAnimate(){ // 创建新的标签页 constpage =awaitbrowser.newPage(); // do something... // 关闭标签页 awaitpage.close() } 由于用户配置对应的静态资源全部都是远程链接,如果不做资源的本地缓存会导致每次访问页面都会重新请求,造成带宽的浪费,网络请求也会影响到用户配置的还原速度,所以我们通过监听page的request和response事件对资源进行缓存与拦截。 // 启用请求拦截 awaitpage.setRequestInterception(true); // 监听网络请求,如果本地有缓存的资源则直接返回本地缓存的内容,反之则继续正常返回 page.on('request',async(request) => { consturl = request.url(); // 判断文件类型是否支持缓存 if(isCacheableFile(url)) { constfileName =getFileNameFromUrl(url); constcacheFilePath = path.join(cacheDir, fileName); // 检查缓存是否存在 if(fs.existsSync(cacheFilePath)) { console.log(`从缓存加载文件:${fileName}`); constcachedContent = fs.readFileSync(cacheFilePath); console.log(`缓存文件大小:${cachedContent.length}bytes`); awaitrequest.respond({ status:200, contentType:getContentType(fileName), headers: { 'Access-Control-Allow-Origin':'*' }, body: cachedContent }); return; } } // 继续正常请求 request.continue(); }); // 监听响应事件 page.on('response',async(response) => { consturl = response.url(); if(isCacheableFile(url) && response.status() ===200) { constfileName =getFileNameFromUrl(url); constcacheFilePath = path.join(cacheDir, fileName); // 如果缓存不存在,则保存 if(!fs.existsSync(cacheFilePath)) { console.log(`正在缓存文件:${fileName}`); try{ // 使用 axios 重新下载文件 constaxiosResponse =awaitaxios({ method:'GET', url: url, responseType:'arraybuffer', timeout:60000 }); fs.writeFileSync(cacheFilePath, axiosResponse.data); console.log(`缓存文件成功:${fileName}, 大小:${axiosResponse.data.length}bytes`); }catch(error) { console.error(`缓存文件失败${url}:${error.message}`); } } } }); 由于网页导出帧以后会将zip包保存到本地,所以需要指定下载的目录便于读取文件,为了防止并发请求下载的文件命名混乱,在每个方法执行一开始生成一个唯一id,并将这个id作为文件的下载名。 // 设置唯一的taskid consttaskId =nanoid(); // 指定文件的下载目录 constclient=awaitpage.createCDPSession(); awaitclient.send('Page.setDownloadBehavior',{ behavior:'allow', downloadPath:path.resolve('./temp/') }); // 访问指定的页面并将数据注入到网页的window对象中 awaitpage.goto(targetUrl, {waitUntil:'domcontentloaded',timeout:0}); awaitpage.evaluate((data,id,animate) =>{ window.__INIT_DATA__=data window.__TASKID__=id window.__ANIMATE__=animate },config,taskId,animate); 在准备工作做完以后就可以监听网页的按钮状态,执行对应的操作了。 constbtn=awaitpage.waitForSelector('#export-btn', { timeout:10000// 10秒超时 }); awaitbtn.click(); awaitpage.waitForSelector('#exported', { timeout:30000 }); // 在检测到#exported这个dom出现以后,意味着文件导出完成已经开始下载,但是无法获取到文件下载的状态,由于本地文件下载速度很快,所以这里仅设置一个2s的等待,不做其他的监听操作 awaitnewPromise(resolve=>setTimeout(resolve,2000)); 3.3 视频合成 现在我们获取到视频帧的压缩包了,接下来需要将压缩包进行解压操作并合成视频或者gif,合成完将内容上传到静态资源库,最终返回资源的url。视频合成使用FFmpeg,这里以输出mp4文件为例。 // 构建文件名是数字序列的输入模式 constinputPattern = path.join(framesDir, frames[0].replace(/\d+/,'%d')); // 输入参数 constffmpegArgs = [ '-framerate', fps.toString(), '-start_number','0', '-i', inputPattern, '-vf',`scale=${width}:${height}`, '-c:v','libx264', '-preset','medium', '-crf','23', '-pix_fmt','yuv420p', '-f','mp4', '-y', outputPath ]; constffmpegProcess =spawn('ffmpeg', ffmpegArgs); ffmpegProcess.on('close',(code) =>{ if(code ===0) { // 视频合成完成 } }); 四、结语 通过对比多种动效合成路径,最终选用 Puppeteer + H5 渲染帧 + FFmpeg 合成视频 的方案,在保证渲染一致性的同时,兼顾了服务端异步处理与多场景复用的需求。该方案有效解决了拟我形象在多场景应用中存在的性能瓶颈和一致性问题,大幅降低了接入门槛,也为后续规模化生成和分发提供了技术基础。