首页 文章 精选 留言 我的

精选列表

搜索[博客搭建],共10000篇文章
优秀的个人博客,低调大师

[雪峰磁针石博客]python网络基础工具书籍下载-持续更新

爬虫书籍参见: 2018最佳人工智能数据采集(爬虫)工具书下载 Python Network Programming Cookbook, 2nd Edition - 2017.pdf 介绍了现实世界中几乎所有网络任务的真实示例,通过简明易懂的形式让读者掌握如何使用Python完成这些网络编程任务。具体说来,书中通过70多篇攻略讨论了Python网络编程的高阶话题,包括编写简单的网络客户端和服务器、HTTP协议网络编程、跨设备编程、屏幕抓取以及网络安全监控,等等。本书可以作为任何一门网络编程课程中培养实践技能的补充材料。《图灵程序设计丛书:Python网络编程攻略》需要读者对Python语言及TCP/IP等基本的网络概念有了解。 Practical Network Automation Leverage the power of Python and Ansible to optimize your network - 2017.pdf O'Reilly.Twisted.Network.Programming.Essentials.2nd.Edition.Mar.2013.pdf Learning Python Network Programming - 2015.pdf Foundations of Python Network Programming, 3rd Edition - 2014.pdf Data Science and Complex Networks Real Case Studies with Python - 2016.pdf 参考资料 讨论qq群144081101 591302926 567351477 钉钉免费群21745728 本文最新版本地址 本文涉及的python测试开发库 谢谢点赞! 本文相关海量书籍下载 Complex Network Analysis in Python Recognize – Construct – Visualize – Analyze – Interpret - 2018.pdf

优秀的个人博客,低调大师

[雪峰磁针石博客]使用jython进行dubbo接口及ngrinder性能测试

快速入门(接口测试) 确认mvn和jdk、jython安装ok。 先下载dubbo的demo,编译运行demo。 # git clone https://github.com/alibaba/dubbo.git dubbo # cd dubbo/ # mvn clean install -Dmaven.test.skip # cd dubbo-demo/dubbo-demo-provider/target/ # tar xzvf dubbo-demo-provider-2.5.4-SNAPSHOT-assembly.tar.gz # cd dubbo-demo-provider-2.5.4-SNAPSHOT/bin # ./start.sh # cd /opt/code/dubbo-demo/dubbo-demo-consumer/target/ # tar xzvf dubbo-demo-provider-2.5.4-SNAPSHOT-assembly.tar.gz # cd dubbo-demo-consumer-2.5.4-SNAPSHOT/bin # ./start.sh 注意:阿里的demo启动脚本有bug,如果启动时报进程已经存在,请修改start.sh中的grep部分,增加" | grep -v grep"。 确认在consumer的的日志可以看到"hello"输出,恭喜你,dubbo的demo已经成功。现在关闭上面程序,用eclipse或其他IDE打开工程进行修改。 安装zk, 下载地址:http://www.apache.org/dyn/closer.cgi/zookeeper/ 下载完毕后解压,执行:"# ./zkServer.sh start" 修改工程 修改工程dubbo-demo-provider和dubbo-demo-consumer的dubbo.properties: dubbo.container=log4j,spring dubbo.application.name=demo-provider dubbo.application.owner=william #dubbo.registry.address=multicast://224.5.6.7:1234 dubbo.registry.address=zookeeper://127.0.0.1:2181 #dubbo.registry.address=redis://127.0.0.1:6379 #dubbo.registry.address=dubbo://127.0.0.1:9090 #dubbo.monitor.protocol=registry dubbo.protocol.name=dubbo dubbo.protocol.port=20880 dubbo.service.loadbalance=roundrobin #dubbo.log4j.file=logs/dubbo-demo-consumer.log #dubbo.log4j.level=WARN dubbo-demo-consumer的pom.xml加载的内容太多,需要进行精简,如下: <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/maven-v4_0_0.xsd"> <modelVersion>4.0.0</modelVersion> <parent> <groupId>com.alibaba</groupId> <artifactId>dubbo-demo</artifactId> <version>2.5.4-SNAPSHOT</version> </parent> <artifactId>dubbo-demo-consumer</artifactId> <packaging>jar</packaging> <name>${project.artifactId}</name> <description>The demo consumer module of dubbo project</description> <properties> <skip_maven_deploy>false</skip_maven_deploy> </properties> <dependencies> <dependency> <groupId>com.alibaba</groupId> <artifactId>dubbo-demo-api</artifactId> <version>${project.parent.version}</version> </dependency> <dependency> <groupId>com.alibaba</groupId> <artifactId>dubbo</artifactId> <version>${project.parent.version}</version> </dependency> <dependency> <groupId>org.javassist</groupId> <artifactId>javassist</artifactId> </dependency> <dependency> <groupId>org.apache.zookeeper</groupId> <artifactId>zookeeper</artifactId> </dependency> <dependency> <groupId>com.github.sgroschupf</groupId> <artifactId>zkclient</artifactId> </dependency> <dependency> <groupId>log4j</groupId> <artifactId>log4j</artifactId> </dependency> </dependencies> <build> <plugins> <plugin> <artifactId>maven-dependency-plugin</artifactId> <executions> <execution> <id>unpack</id> <phase>package</phase> <goals> <goal>unpack</goal> </goals> <configuration> <artifactItems> <artifactItem> <groupId>com.alibaba</groupId> <artifactId>dubbo</artifactId> <version>${project.parent.version}</version> <outputDirectory>${project.build.directory}/dubbo</outputDirectory> <includes>META-INF/assembly/**</includes> </artifactItem> </artifactItems> </configuration> </execution> </executions> </plugin> <plugin> <artifactId>maven-assembly-plugin</artifactId> <configuration> <descriptor>src/main/assembly/assembly.xml</descriptor> </configuration> <executions> <execution> <id>make-assembly</id> <phase>package</phase> <goals> <goal>single</goal> </goals> </execution> </executions> </plugin> </plugins> </build> </project> dubbo-demo-consumer工程新增demo.xml, 为jython访问dubbo的定义。 <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:dubbo="http://code.alibabatech.com/schema/dubbo" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans-2.5.xsd http://code.alibabatech.com/schema/dubbo http://code.alibabatech.com/schema/dubbo/dubbo.xsd"> <dubbo:application name="hello-world-app" /> <dubbo:registry address="zookeeper://127.0.0.1:2181"/> <dubbo:reference id="demoService" interface="com.alibaba.dubbo.demo.DemoService" /> </beans> 新增jython脚本: from org.springframework.context.support import ClassPathXmlApplicationContext context = ClassPathXmlApplicationContext("demo.xml") service = context.getBean("demoService") print service.sayHello("How are you!") 重新执行第2步的编译,并在CLASSPATH添加对应的目录,比如: export CLASSPATH=$CLASSPATH:/opt/lib/* 在IDE中运行:DemoProvider 执行: $ jython dubbo_test.py "my" variable $jythonHome masks earlier declaration in same scope at /usr/bin/jython line 15. log4j:WARN No appenders could be found for logger (org.springframework.core.env.StandardEnvironment). log4j:WARN Please initialize the log4j system properly. log4j:WARN See http://logging.apache.org/log4j/1.2/faq.html#noconfig for more info. Hello How are you!, response form provider: 172.17.153.6:20880 java里面也可以采用这种方法。下面修改DemoConsumer类: package com.alibaba.dubbo.demo.consumer; import org.springframework.context.ApplicationContext; import org.springframework.context.support.ClassPathXmlApplicationContext; import com.alibaba.dubbo.demo.DemoService; public class DemoConsumer { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("demo.xml"); DemoService service = context.getBean(DemoService.class); System.out.println(service.sayHello("How are you!")); } } 可见java的操作和jython是极其类似的,只是在实际测试中,java改动需要频繁,带来不少不便。实际应用通常把多个包含dubbo服务定义的文件放在一个jar包中,这样一个jython就可以灵活地测试多个dubbo接口。当然不同接口要加载的jar是不同的,好在jython可以动态修改CLASSPATH, 参见:http://www.jython.org/jythonbook/en/1.0/appendixB.html#working-with-classpath。 Jmeter做dubbo性能测试就可以用上面这种方法,继承AbstractJavaSamplerClient类就可以。参考资料如下: http://jmeter.apache.org/api/ 下面是一个实际使用的jython接口测试脚本: #!/usr/local/jython/bin/jython # -*- coding: utf-8 -*- # Author Rongzhong Xu 2016-09-06 wechat: pythontesting """ Name: dubbo.py Tesed in python3.5 """ from org.springframework.context.support import ClassPathXmlApplicationContext from com.oppo.sso.model.request import SecurityRequest context = ClassPathXmlApplicationContext("onekey-register-consumer.xml") service = context.getBean("registerService") request = SecurityRequest() request.setMobile("13244448888") request.setApplicationKey("test") request.setCreateBy("127.0.0.1") request.setCreateIP("127.0.0.1") print("{0} {1} {0}".format("="*30, "Result(")) print(service.register(request)) result = service.register(request) print(result.getResultCode()) print(result.getResultDesc()) 性能测试支持 这里对nGrinder不做入门介绍,相关资料请参考:测试工具nGrinder介绍 nGrinder管理库的方式和grinder并不一样。可以通过web操作,但是如果文件较多的话,还是建议使用svn。 在nGrinder的web页面点击"脚本",选中测试目标之后,里面有个"TestRunner.py"之类的脚本,在当前目前新建lib目录,jar包和python库文件都可以扔到这里,这样nGrinder就可以访问了。 上面demo的测试脚本如下: # -*- coding:utf-8 -*- # A simple example using the HTTP plugin that shows the retrieval of a # single page via HTTP. # # This script is automatically generated by ngrinder. # # @author admin from net.grinder.script.Grinder import grinder from net.grinder.script import Test from net.grinder.plugin.http import HTTPRequest from net.grinder.plugin.http import HTTPPluginControl from java.util import Date from HTTPClient import NVPair, Cookie, CookieModule from org.springframework.context.support import ClassPathXmlApplicationContext control = HTTPPluginControl.getConnectionDefaults() # if you don't want that HTTPRequest follows the redirection, please modify the following option 0. # control.followRedirects = 1 # if you want to increase the timeout, please modify the following option. control.timeout = 6000 test1 = Test(1, "127.0.0.1") request1 = HTTPRequest() # Set header datas headers = [] # Array of NVPair # Set param datas params = [] # Array of NVPair # Set cookie datas cookies = [] # Array of Cookie class TestRunner: # initlialize a thread def __init__(self): test1.record(TestRunner.__call__) grinder.statistics.delayReports=True context = ClassPathXmlApplicationContext("demo.xml") self.service = context.getBean("demoService") def before(self): request1.headers = headers for c in cookies: CookieModule.addCookie(c, HTTPPluginControl.getThreadHTTPClientContext()) # test method def __call__(self): self.before() result = self.service.sayHello("How are you!") print result jython英文教程: http://www.jython.org/jythonbook/en/1.0/ 参考资料 本文最新版本地址 本文涉及的python测试开发库 谢谢点赞! 本文相关海量书籍下载 2018最佳人工智能机器学习工具书及下载(持续更新) 接口测试面试题.pdf 软件测试精品书籍下载 python通过协议支持dubbo接口 以下方式支持dubbo的部分协议,序列化是个难点。 # git clone https://github.com/alibaba/dubbo.git dubbo # cd dubbo/ # mvn clean install -Dmaven.test.skip # cd dubbo-demo/dubbo-demo-provider/target/ # tar xzvf dubbo-demo-provider-2.5.4-SNAPSHOT-assembly.tar.gz # cd dubbo-demo-provider-2.5.4-SNAPSHOT/bin # ./start.sh # cd /opt/code/dubbo-demo/dubbo-demo-consumer/target/ # tar xzvf dubbo-demo-provider-2.5.4-SNAPSHOT-assembly.tar.gz # cd dubbo-demo-consumer-2.5.4-SNAPSHOT/bin # ./start.sh python环境安装 # git clone https://github.com/dmall/dudubbo # cd dudubbo/ # git checkout remotes/origin/feature/block-socket # python3 setup.py install python测试 # /opt/python3.5/bin/python3 Python 3.5.1 (default, May 19 2016, 11:47:26) [GCC 4.4.7 20120313 (Red Hat 4.4.7-16)] on linux Type "help", "copyright", "credits" or "license" for more information. >>> from dubbo import Dubbo >>> from dubbo._model import Object >>> config = { 'classpath' : '/data/code/dubbo/dubbo-demo/dubbo-demo-api/target/dubbo-demo-api-2.5.4-SNAPSHOT.jar' } >>> client = Dubbo((('localhost', 20880),), config, enable_heartbeat=True) >>> q = client.getProxy('com.alibaba.dubbo.demo.DemoService') >>> type(q) <class 'dubbo.dubbo.ServiceProxy'> >>> q.sayHello("Test") Connected to localhost:20880 successfully 'Hello Test, response form provider: 10.51.51.152:20880'

优秀的个人博客,低调大师

[雪峰磁针石博客]python计算机视觉深度学习1简介

神经网络和深度学习简史 人工神经网络(ANN Artificial Neural Network)是一类学习的机器学习算法,它专注于模式识别,对数据进行学习,灵感来自大脑的结构和功能深度学习属于ANN算法的家族,在大多数情况下,两者可以互换使用。 事实上,你可能会惊讶地发现深度学习领域已经存在了60多年。自20世纪40年代以来,“深度学习”一直存在着各种各样的名字变化,包括控制论,连接主义和最熟悉的人工神经网络。 第一个神经网络模型来自McCulloch和Pitts,1943年。这个网络是一个二元分类器,能够根据一些输入识别两个不同的类别。 然后,在20世纪50年代,开创性的Perceptron算法由Rosenblatt发表 - 这个模型可以自动学习输入分类所需的权重(无人为干预需要)。这个自动训练程序构成了随机梯度下降(SGD Stochastic Gradient Descent)的基础,今天仍用于训练非常深的神经网络。 在此期间,基于感知器的技术在神经网络社区中风靡一时。然而,Minsky和Papert 在1969年出版的一本书有效地停滞了神经网络研究近十年。他们的工作证明了具有线性的感知器激活函数(深度无关)只是线性分类器,无法解决非线性问题问题。 上图中无法用直线分隔蓝色星星与红色圆圈。此外,作者认为(当时)我们没有计算资源来构建大型深度神经网络(事后看来,它们绝对正确)。 反向传播算法和Werbos(1974),Rumelhart(1986)和LeCun(1998)的研究[17]唤醒了神经网络。他们在反向传播算法中的研究启用了多层要训​​练的前馈神经网络。 结合非线性激活函数,研究人员现在可以学习非线性函数并解决XOR问题,为神经网络研究的全新领域打开了大门。进一步的研究表明神经网络是通用的近似,能够近似任何连续函数(但不保证网络是否正常可以学习表示函数所需的参数)。 反向传播算法是现代神经网络的基石.有效地训练神经网络并“教导”他们从错误中吸取教训。但即便如此,在由于(1)计算机速度慢(与现代机器相比)和(2)缺少大量标记的训练集,研究人员无法(可靠地)训练超过两个隐藏的层的神经网络,因为计算上是不可行的。 今天最新神经网络为深度学习,我们拥有更快,更专业的硬件,提供更多可用的训练数据。我们现在可以训练具有更多隐藏层的网络,能够进行分级学习,在较低层和更多层次中学习简单的概念,在较高层中的抽象模式。 应用深度学习到特征学习的典型例子是应用于手写字符识别的Convo-lutional神经网络(LeCun 1988)。通过顺序堆叠自动从图像中学习区分模式(称为“过滤器”)。网络较低级别的过滤器代表边缘和角落,而更高级别的图层使用边缘和角落来学习更有用的抽象概念以区分图像类。 在许多领域中,CNN现在被认为是最强大的图像分类器,是目前负责推动计算机视觉子领域的最先进技术。 分层特征学习 机器学习算法通常分为三个阵营 - 监督,无人监督和半监督学习。 在监督的情况下,机器学习算法被给予一组输入和目标输出。然后,该算法尝试学习可用于自动映射输入数据的模式指向正确的目标输出。监督学习类似于让老师看着你参加考试。鉴于您以前的知识,您尽力在您的标记上标记正确的答案考试; 但是如果你不对老师会指导你做一个更好的,让你更有根据的猜测下一次。 在无监督的情况下,没有任何提示关于输入是什么,机器学习算法试图自动发现。在这种情况下,我们的学生会尝试将类似的问题和答案组合在一起,即使学生不知道正确的答案,老师也不提供真正的答案。无监督学习显然是比监督学习更具挑战性的问题。 过去我们手工衡量图像的内容 ,很少使用原始像素强度作为我们机器学习模型的输入。现在对于每个图像,我们执行了特征提取,并返回旨在量化内容的矢量。 局部二元模式(Local Binary Patterns),Haralick纹理[22]),形状(shape)、Zernike Moments [24])和颜色(color moments, color histograms, color correlograms)广发用于识别。 其他方法,如关键点检测器(keypoint detector)和局部不变描述符(local invariant descriptor)用于处理图像关键区域。 当我们的图像的视点角度和训练的分类器没有显着变化时,定向梯度直方图(HOG Histogram of Oriented Gradient)非常擅长检测图像中的对象。 有一段时间,HOG及其变体引导了图像中物体检测的研究,如可变形零件模型( Deformable Parts Model)和范例SVM。 在深度学习中,特征提取由系统学习完成。 该有多深 我个人认为可以考虑任何具有两个以上隐藏层的网络为“深”。 我们现在有:1.更快的电脑2.高度优化的硬件(即GPU)3.数百万张图像的大型标记数据集4.更好地理解权重初始化函数以及什么/不起作用5.卓越的激活功能和对前一非线性原因的理解 可爱的python测试开发库 请在github上点赞,谢谢! 技术支持qq群: 144081101(后期会录制视频存在该群群文件) 591302926 567351477 钉钉免费群:21745728 处理您自己的深度学习应用程序的建议: 1.您使用的是专门的网络架构,如卷积神经网络,回归神经网络或长期短期记忆(LSTM)网络?如果是的话,是的,你正在进行深度学习。2.您的网络深度是否> 2?如果是的话,你正在深入学习。3.您的网络深度是否> 10?如果是这样,你正在进行非常深入的学习。 不要太纠结于概念,无论如何你还在使用人工神经网络进行机器学习。 代码地址:https://github.com/whydna/Deep-Learning-For-Computer-Vision 注意不是: https://github.com/PacktPublishing/Deep-Learning-for-Computer-Vision

优秀的个人博客,低调大师

[雪峰磁针石博客]软件测试专家工具包3移动端

UI Automator UI Automator提供了一组API来构建基于交互UI的测试。API允许你执行操作,如打开设置菜单,非常适合黑盒自动化测试,在测试代码不依赖于应用的内部实现 uiautomatorviewer提供了一个方便的图形用户界面进行扫描和分析在Android设备上当前显示的UI组件。您可以使用此工具来检查的布局层次和查看UI组件。 UiDevice类可以访问设备并进行操作。你可以调用它的方法来访问设备属性,如当前的方向或显示尺寸。该UiDevice类也让您执行操作,例如:旋转设备;按下D-pad按钮;按Back、Home、Menu等;打开通知树栏;当前窗口截图等。 应用相关的API: UiCollection枚举容器的UI元素以计数,或通过文字(或属性等)针定位子元素; UIObject表示是在设备上可见的UI元素; UiScrollable?:为可滚动UI容器提供查找支持; UiSelector?:查询一个或者多个UI元素; Configurator: 设置参数。 示例:更改语言 #!/usr/bin/env python # -*- coding: utf-8 -*- from uiautomator import device as d d.screen.on() d.press.home() d(text=u"设置").click() d(text=u"其他高级设置").click() d(text=u"语言和输入法").click() d(text=u"中文 (简体)").click() d(text=u"English").click() https://github.com/xiaocong/uiautomator Appium Appium是一个移动端的自动化框架,可用于测试原生应用,移动网页应用和混合型应用,且是跨平台的。可用于IOS和Android以及firefox的操作系统。原生应用是指用android或ios的sdk编写的应用,移动网页应用是指网页应用,类似于ios中safari应用或者Chrome应用或者类浏览器的应用。混合应用是指一种包裹webview的应用,原生应用网页内容交互性的应用。跨平台,是当今比较流行的开源测试工具。 配置比uiautomator复杂,需要指定被测应用。 示例:python代码操作计算器 #-*-coding: utf-8 -*- #coding=utf-8 from appium import webdriver desired_caps = {} desired_caps['platformName'] = 'Android' desired_caps['platformVersion'] = '4.4.4' desired_caps['deviceName'] = 'baf59937' desired_caps["unicodeKeyboard"]="True" desired_caps["resetKeyboard"]="True" desired_caps['appPackage'] = 'com.miui.calculator' desired_caps['appActivity'] = '.cal.CalculatorActivity' driver = webdriver.Remote('http://localhost:4723/wd/hub',desired_caps) driver.find_element_by_name("1").click() driver.find_element_by_name("5").click() driver.find_element_by_id("btn_plus").click() driver.find_element_by_name("6").click() driver.find_element_by_id("btn_equal").click() driver.quit() Eggplant 使用VNC server之类的网关。 支持iOS, Android,Windows Phone, BlackBerry,是基于图像识别的测试工具。脚本:SenseTalk。不受坐标限制。 脚本跨OS、不会修改应用,能完全控制设备。 商业软件 http://www.testplant.com/eggplant/testing-tools/ adb adb用于获取Android日志,android设备的日志存储在设备的循环内存缓冲区中。adb在android SDK的platform-tools目录。首先在系统设置 - >开发人员设置中打开USB调试。 然后使用USB连接线将手机连接到计算机。运行adb devices获取连接的设备列表。 如果要将整个日志保存到文件而不进行过滤,请使用命令“adb logcat> logs.txt“。 运行命令“adb logcat | findstr Exception“仅显示例外情况。Linux使用“adb logcat | grep Exception“。 或者,您可以从Google Play安装logcat查看器(如Catlog)查看logcat条目。 CPU Monitor Advanced Lite 来自Google Play,用于监控CPU,可以保存历史记录,并以图形直观展示,但是大陆的应用市场貌似搜索不到。 通常使用替代:CPU Monitor(豌豆荚)、CPU-Z等。 TestObject TestObject是拥有成百上千真实设备的测试平台,可以直接通过浏览器访问。上载APP然后可以查看执行情况,支持Robotium, Espresso和Appium。 通常用于安卓机型的测试。 商业软件:https://testobject.com/ 有几个类似的提供云测试服务的公司: 云测汇:https://www.yuncehui.cn/ 专注于性能测试 Testin: 即云测,http://testin.cn/ 支持Robotium、淘宝Athrun框架 易测云:支持Robotium、Athrun、Guerrilla等开源测试框架,并使用基于控件识别的、东软自主研发的测试工具Radar。http://www.yiceyun.com/ 以上几家没有TestObject强大,但是有中国特色的选择之一。 Scan IOS命令行工具: ZAPTEST 用于测试跨平台应用程序的软件测试自动化解决方案。ZAPTEST允许在任何现代操作系统,移动设备或移动设备上测试任何基于GUI的软件。包括iOS,Android,WinMo,Blackberry,Windows,Mac和Linux,并支持Agile和CI(DevOps)开发的测试。 社区版本是免费的,允许您测试网络,新的Windows应用程序或移动应用程序。 Traceview 很好的性能分析的工具。它可以通过图形化的方式让我们了解我们要跟踪的程序的性能,并且能具体到method。 记录过程中每个API的耗时及调用次数,出现卡顿时,可通过top排序等手段分析是哪些API引起的。 https://developer.android.com/studio/profile/traceview Memory Profiler Android Profiler 中的一个组件,可帮助您识别导致应用卡顿、冻结甚至崩溃的内存泄漏和流失。 它显示一个应用内存使用量的实时图表,让您可以捕获堆转储、强制执行垃圾回收以及跟踪内存分配。 要打开 Memory Profiler,请按以下步骤操作: 点击 View > Tool Windows > Android Profiler(也可以点击工具栏中的 Android Profiler )。 从 Android Profiler 工具栏中选择您想要分析的设备和应用进程。 如果您通过 USB 连接了某个设备但该设备未在设备列表中列出,请确保您已启用 USB 调试。 点击 **MEMORY **时间线中的任意位置可打开 Memory Profiler。 或者,您可以在命令行中使用 dumpsys 检查您的应用内存,同时查看 logcat 中的 GC Event。 https://developer.android.com/studio/profile/memory-profiler Systrace Systrace的功能包括跟踪系统的I/O操作、内核工作队列、CPU负载以及Android各个子系统的运行状况等。 它能展示API的执行时序、耗时及各线程状态,出现卡顿时可分析API调用逻辑是否合理及是否出现主线程阻塞。 https://github.com/catapult-project/catapult/tree/master/systrace AndroidJUnitRunner AndroidJUnitRunner类是JUnit测试运行器,可以让你在Android设备上执行JUnit3或JUnit4中风格的测试类,兼容Espresso和UI Automator测试框架。测试运行器加载测试包和应用,运行测试并报告测试结果。该类取代 InstrumentationTestRunner类(仅支持JUnit 3)。 这个运行器的主要特点: JUnit支持 获得Instrumentation信息 测试筛选 测试分片 要求的Android2.2(API 8)或更高。 AndroidJunitRunner通过InstrumentationRegistry提供了访问instrumentation的API。 InstrumentationRegistry.getInstrumentation()返回当前正在运行的Instrumentation InstrumentationRegistry.getContext()返回此Instrumentation软件包的上下文。 InstrumentationRegistry.getTargetContext()返回目标应用的应用上下文。 InstrumentationRegistry.getArguments()返回传递给此Instrumentation的参数Bundle。当你要访问命令行参数时非常有用。 测试运行器兼容JUnit3和JUnit4的(最高JUnit4.10)测试。在同一个包混淆JUnit 3和和JUnit4测试代码可能会导致不可预测的结果。instrumented JUnit 4测试类在设备或仿真器上运行,必须在前面加上@RunWith(AndroidJUnit4.class)注释。 比如测试CalculatorActivity类中的加操作: import android.support.test.runner.AndroidJUnit4; import android.support.test.runner.AndroidJUnitRunner; import android.test.ActivityInstrumentationTestCase2; @RunWith(AndroidJUnit4.class) public class CalculatorInstrumentationTest extends ActivityInstrumentationTestCase2<CalculatorActivity> { @Before public void setUp() throws Exception { super.setUp(); // Injecting the Instrumentation instance is required // for your test to run with AndroidJUnitRunner. injectInstrumentation(InstrumentationRegistry.getInstrumentation()); mActivity = getActivity(); } @Test public void typeOperandsAndPerformAddOperation() { // Call the CalculatorActivity add() method and pass in some operand values, then // check that the expected value is returned. } @After public void tearDown() throws Exception { super.tearDown(); } } InstrumentationRegistry类可以访问测试运行的信息。该类包括Instrumentation对象,目标应用上下文对象,测试应用上下文对象及传递到测试的命令行参数。 JUnit 4.x的测试可以使用annotation来配置测试运行,并支持Androidannotation: @RequiresDevice:物理设备上运行。 @SdkSupress:限定最低SDK版本。例如@SDKSupress(minSdkVersion=18)。 @SmallTest,@MediumTest和@LargeTest:测试分级。 单个test suite可以分片,同一Instrumentation的同一分片可以作为一个组。每个片都有索引号。当运行测试,使用-e numShards选项指定片数和-e shardIndex选项来指定要运行的片。 例如分成10个碎片,仅执行第二片测试,请使用以下命令: adb shell am instrument -w -e numShards 10 -e shardIndex 2 Espresso Espresso提供了一组API来构建UI测试来测试用户流程。这些API让你写简洁和可靠运行的自动化UI测试。Espresso非常适合白盒自动测试,测试代码利用了被测应用的代码细节。 Espresso的主要特性: 视图匹配(View matching): 灵活的API用于查看和适配目标应用。 Action API:一套扩展的action API自动化UI交互。 UI线程同步(UI thread synchronization)以提高测试的可靠性。 要求Android2.2(API 8)或更高。 Espresso.onView()方法可以访问目标应用程序的UI组件并与之交互。该方法接受一个Matcher参数,搜索视图层来定位视图实例。定位方法可以基于类名、内容描述、R.id、显示的文本。比如 onView(withId(R.id.my_button)); 如果搜索成功,onView()方法返回对应view的引用,可执行用户操作和断言。 AdapterView由子view动态生成。如果目标视图在AdapterView(ListView或GridView)中,onView()方法可能不起作用,因为可能只加载了一部分,Espresso.onData()则可以。 ViewActions可以执行视图点击(View clicks),滑动(Swipes),按键或者按钮(Key and button press)、文本输入(Typing text)、打开链接(Opening a link)。 // Type text into an EditText view, then close the soft keyboard onView(withId(R.id.editTextUserInput)) .perform(typeText(STRING_TO_BE_TYPED), closeSoftKeyboard()); // Press the button to submit the text change onView(withId(R.id.changeTextBt)).perform(click()); 由于时间问题,在Android设备上测试随机失败。之前一般通过sleep和超时处理解决。Espresso测试框架处理Instrumentation和UI线程之间的同步,很好地解决了这些问题。 API参考:developer.android.com/reference/android/support/test/package-summary.html 测试参考:http://developer.android.com/training/testing/ui-testing/espresso-testing.html robotium Android用户场景测试,在Espresso出来直接比较流行,现在有弱化的趋势。 https://github.com/RobotiumTech/robotium Genymotion 高效的安卓模拟器 http://www.genymotion.net/ Robolectric 开源。使用shadow objects运行测试于普通的工作站/服务器JVM,它并不依赖于Android提供的测试功能,无须模拟器、设备,效率高。无须dexing(编译成Dalvik VM使用的格式),打包,部署和运行的过程。 是安卓单元测试的首选工具。 网址:pivotal.github.com/robolectric Monkey Monkey是Android中的命令行工具,可以运行在模拟器里或实际设备中。它向系统发送伪随机的用户事件流(如按键输入、触摸屏输入、手势输入等),实现对正在开发的应用程序进行压力测试。Monkey测试是一种为了测试软件的稳定性、健壮性的快速有效的方法。 https://developer.android.com/studio/test/monkey Android Lint Android Studio 提供一个名为 Lint 的代码扫描工具,可帮助您发现并纠正代码结构质量的问题,而无需实际执行该应用,也不必编写测试用例。该工具会报告其检测到的每个问题并提供该问题的描述消息和严重级别,以便您可以快速确定需要优先进行哪些关键改进。此外,您可以调低问题的严重级别,忽略与项目无关的问题,也可以调高严重级别,以突出特定问题。 Lint 工具可检查您的 Android 项目源文件是否包含潜在错误,以及在正确性、安全性、性能、易用性、便利性和国际化方面是否需要优化改进。在使用 Android Studio 时,配置的 Lint 和 IDE 检查会在您每次构建应用时运行。不过,您可以手动运行检查或从命令行运行 Lint。 https://developer.android.com/studio/write/lint?hl=zh-cn#commandline 兼容性测试套件 (CTS) 兼容性测试套件 (CTS) 是一个免费的商业级测试套件CTS 代表兼容性的“机制”。 CTS 在桌面设备上运行,并直接在连接的设备或模拟器上执行测试用例。CTS 是一套单元测试,旨在集成到工程师构建设备的日常工作流程(例如通过连续构建系统)中。其目的是尽早发现不兼容性,并确保软件在整个开发过程中保持兼容性。 CTS 是一个自动化测试工具,其中包括两个主要软件组件: CTS tradefed 自动化测试框架会在桌面设备上运行,并管理测试执行情况。 单独的测试用例会在被测设备 (DUT) 上执行。测试用例采用 Java 语言编写为 JUnit 测试,并打包为 Android .apk 文件,以在实际目标设备上运行。 兼容性测试套件验证程序(CTS 验证程序)是对 CTS(可在此处下载)的补充。CTS 验证程序为无法在没有手动输入(例如音频质量、加速度计等)的固定设备上进行测试的 API 和功能提供测试。 CTS 验证程序是一款手动测试工具,包含以下软件组件: 在 DUT 上执行并收集结果的 CTS 验证程序应用。 在桌面设备上执行,以便为 CTS 验证程序应用中的某些测试用例提供数据或额外控制的可执行文件或脚本。 monkey runner monkeyrunner工具提供了API,使用此API写出的程序可以在Android代码之外控制Android设备和模拟器。通过monkeyrunner,您可以写出一个Python程序去安装一个Android应用程序或测试包,运行它,向它发送模拟击键,截取它的用户界面图片,并将截图存储于工作站上。monkeyrunner工具的主要设计目的是用于测试功能/框架水平上的应用程序和设备,或用于运行单元测试套件,但您当然也可以将其用于其它目的。 下面是简单的monkeyrunner程序,它连接到设备,创建MonkeyDevice对象。 程序使用MonkeyDevice对象安装Android应用程序包,运行activity,并将关键事件发送到activity。 然后程序截取结果的屏幕截图,创建MonkeyImage对象。 从该对象,程序输出包含屏幕截图的.png文件。 # Imports the monkeyrunner modules used by this program from com.android.monkeyrunner import MonkeyRunner, MonkeyDevice # Connects to the current device, returning a MonkeyDevice object device = MonkeyRunner.waitForConnection() # Installs the Android package. Notice that this method returns a boolean, so you can test # to see if the installation worked. device.installPackage('myproject/bin/MyApplication.apk') # sets a variable with the package's internal name package = 'com.example.android.myapplication' # sets a variable with the name of an Activity in the package activity = 'com.example.android.myapplication.MainActivity' # sets the name of the component to start runComponent = package + '/' + activity # Runs the component device.startActivity(component=runComponent) # Presses the Menu button device.press('KEYCODE_MENU', MonkeyDevice.DOWN_AND_UP) # Takes a screenshot result = device.takeSnapshot() # Writes the screenshot to a file result.writeToFile('myproject/shot1.png','png') DDMS DDMS 的全称是DalvikDebug Monitor Service,是 Android 开发环境中的Dalvik虚拟机调试监控服务。提供测试设备截屏、查看特定进程正在运行的线程以及堆信息、Logcat、广播状态信息、模拟电话呼叫、模拟接收及发送SMS、虚拟地理坐标等服务。 https://developer.android.com/studio/profile/monitor 参考资料 紧张整理更新中,讨论 钉钉免费群21745728 qq群144081101 567351477 本文涉及的python测试开发库 谢谢点赞! 本文相关书籍下载 更多python性能测试工具参考 2018最佳12个开源或免费web服务器和客户端性能测试工具

优秀的个人博客,低调大师

[雪峰磁针石博客]软件测试专家工具包2性能测试

Locust(推荐) 了解服务器端性能的好工具。 语言python3。源码 python3+ python2.7+ github上star和fork最多的性能测试工具。 Locust是易于使用、分布式的用户负载测试工具。用于网站(或其他系统)的负载测试,计算出系统可以处理并发用户数。 测试时大量蝗虫会攻击你的网站。每只蝗虫(或叫测试用户)可以自定义、测试过程由web界面实时监控。这能帮助测试并确定瓶颈。 Locust 完全基于的事件,单机可以支持数千用户。它不使用回调,而是基于轻量进程gevent, 能简单地实线各种场景。 Multi-Mechanize(推荐) Multi-Mechanize 是一个开源的性能和负载测试框架,它并发运行多个 Python 脚本对网站或者服务生成负载(组合事务)。测试输出报告保存为HTML或JMeter的兼容的XML。Multi-Mechanize最常用于web性能 和可扩展性(scalability)测试,也适用于任何python可以访问的API。尤其适合后台性能测试。稍微懂点编程的话,这个工具会远强过商业 的性能测试工具。 主要特性: 支持各种 HTTP methods 高级超链接和HTML表单支持 支持 SSL 自动处理 Cookies 可设置HTTP头 自动处理重定向 支持代理 支持 HTTP 认证 --基于python多进程和多线程实现,学习自行开发性能测试的佳品。 Python 2.6 or 2.7 较长时间没有更新,一般只建议改造使用。 ![](https://upload-images.jianshu.io/upload_images/12713060-2ad4113d61eb2f47.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240) nGrinder(推荐) nGrinder是基于Grinder开源项目,由NHN公司的开发团队进行了重新设计和完善。nGrinder是一款非常易用,有简洁友好的用户界面和controller-agent分布式结构的强大的压力测试工具。nGrinder测试基于python测试脚本(groovy也可),用户按照一定规范编写测试脚本,controller会将脚本一集需要的资源分发到agent,用jython执行。并且在执行的过程中收集运行情况、相应时间、测试目标服务器的运行情况等。并且保存这些数据生成测试报告,以供查看。这款框架的一大特点就是非常的简单易用,安装也很容易,可以说是开箱即用。 源码地址:https://naver.github.io/ngrinder/性能测试工具nGrinder介绍 grinder 分布式结构的强大的压力测试工具 http://grinder.sourceforge.net/ GTmetrix https://gtmetrix.com/ 基于Google的Pagespeed和Yslow,还可以监控网站。 收集关键性能指标如页面加载时间,总页面大小和请求的总数。 在真实Android设备上分析页面。 从世界各地测试你的页面。 LoadWise LoadWise是一个简单的性能负载测试工具,使用Firefox浏览器脚本记录器。 也可用于功能测试,免费版本只支持三个用户。 Badboy Badboy是功能强大的开源工具,专门用于复杂的Web应用的自动化测试和负载测试。支持录制/回放界面、性能测试、报告等功能,很多地方和JMeter类似,在处理AJAX方面更好。 Webperformance Webperformance是商业负载测试工具,无需安装应用程序和配置服务器。测试启动可以创建基于URL和录制。 主页:http://www.webperformance.com/ webPagetest WebPagetest是用于测量和分析网页性能的开源工具。提交URL后它产生的页面级指标问题的报告,包括加载时间,所有加载时间,第一个字节的时间,开始渲染时间,速度指标,DOM元素和返回码。 主页:http://www.webpagetest.org/ 百度也提供了类似功能,参见:http://developer.baidu.com/apm/ Loader.io Loader.io是免费的负载测试服务,可以对你的webapps和API进行上千并发连接的压力测试。上传token文件验证网站之后即可实时或定时测试。 主页:https://loader.io/ SourceMonitor 免费程序SourceMonitor可查看软件源代码大小及相对模块复杂度。 分析速度:一万行/秒 支持C++, C, C#, VB.NET, Java, Delphi, Visual Basic (VB6) or HTML 在软件开发过程中保存检查点指标 显示和打印度量表格和图表,包括Kiviat图。 主页:http://www.campwoodsw.com/sourcemonitor.html 性能测试参考资料: https://blazemeter.com/blog/open-source-load-testing-tools-which-one-should-you-use Bees with Machine Guns 进行负载测试的蜜蜂(微型EC2实例)。 语言python3+ python2.6+ Siege http负载测试和基准测试工具。 Siege支持基本身份验证,Cookie以及HTTP和HTTPS协议,并允许用户使用可配置数量模拟Web浏览器访问Web服务器。 Apache Bench ApacheBench 是一个用来衡量http服务器性能的单线程命令行工具。原本针对Apache http服务器,但是也适用于其他http服务器。 Httperf 测量Web服务器性能,并为生成各种HTTP工作负载和测量服务器性能提供灵活的工具。重点不是实施特定的基准,而是提供强大的高性能工具,有助于构建微观和宏观基准。 httperf的三个显着特征是强大,包括产生和维持服务器过载的能力;支持HTTP / 1.1和SSL协议;及其对新工作负载生成器和性能测量的可扩展性。 JMeter (推荐) 测试静态和动态资源(文件,servlet,Perl脚本,Java对象,数据库和查询,FTP服务器等)的性能。您还可以使用它来模拟服务器,网络或对象上的重负载,以测试其强度或分析不同负载类型下的整体性能。还可对性能进行图形分析,或者在繁重的并发负载下测试服务器/脚本/对象的行为。 Google PageSpeed Insights 分析网页内容并生成建议以加快网页加载速度的服务。 Sitespeed.io 根据性能最佳实践和时序指标分析您网站的速度和性能。您可以分析一个站点,分析和比较多个站点,或者在性能不合格时让持续集成服务器停止构建。 Google ngx_pagespeed 可加快您的网站速度并缩短网页加载时间。此开源Apache服务器模块自动将Web性能最佳实践应用于页面和关联资源CSS,JavaScript,图像。 Google mod_pagespeed 可加快您的网站速度并缩短网页加载时间。此开源nginx服务器模块自动将Web性能最佳实践应用于页面和关联资源CSS,JavaScript,图像。 参考资料 本文涉及的python测试开发库 请在github上点赞,谢谢! 紧张整理更新中,讨论 钉钉免费群21745728 qq群144081101 567351477 本文相关书籍下载 更多python性能测试工具参考 2018最佳12个开源或免费web服务器和客户端性能测试工具

优秀的个人博客,低调大师

[雪峰磁针石博客]Bokeh数据可视化工具1快速入门

简介 数据可视化python库参考 python数据可视化库最突出的为Matplotlib、Seaborn和Bokeh。前两个,Matplotlib和Seaborn,绘制静态图。Bokeh可以绘制交互式图。 安装 conda install bokeh pip2 install bokeh pip3 install bokeh 检验安装 from bokeh.plotting import figure, output_file, show #HTML file to output your plot into output_file("bokeh.html") #Constructing a basic line plot x = [1,2,3] y = [4,5,6] p = figure() p.line(x,y) show(p) image.png 问题讨论: https://groups.google.com/a/anaconda.com/forum/#!forum/bokeh bug跟踪:https://github.com/bokeh/bokeh/issues 应用程序:Bokeh应用程序是在浏览器中运行的Bokeh渲染文档 Glyph:Glyph是Bokeh的基石,它们是线条,圆形,矩形等。 服务器:Bokeh服务器用于共享和发布交互式图表 小部件Widgets::Bokeh中的小部件是滑块,下拉菜单等 输出方法有:output_file('plot.html')和output_notebook() 构建图片的方式: #Code to construct a figure from bokeh.plotting import figure # create a Figure object p = figure(plot_width=500, plot_height=400, tools="pan,hover") 绘图基础 线状图 #Creating a line plot #Importing the required packages from bokeh.io import output_file, show from bokeh.plotting import figure #Creating our data arrays used for plotting the line plot x = [5,6,7,8,9,10] y = [1,2,3,4,5,6] #Calling the figure() function to create the figure of the plot plot = figure() #Creating a line plot using the line() function plot.line(x,y) #Creating markers on our line plot at the location of the intersection between x and y plot.cross(x,y, size = 15) #Output the plot output_file('line_plot.html') show(plot) image.png 柱形图 #Creating bar plots #Importing the required packages from bokeh.plotting import figure, show, output_file #Points on the x axis x = [8,9,10] #Points on the y axis y = [1,2,3] #Creating the figure of the plot plot = figure() #Code to create the barplot plot.vbar(x,top = y, color = "blue", width= 0.5) #Output the plot output_file('barplot.html') show(plot) image.png 补丁图 #Creating patch plots #Importing the required packages from bokeh.io import output_file, show from bokeh.plotting import figure #Creating the regions to map x_region = [[1,1,2,], [2,3,4], [2,3,5,4]] y_region = [[2,5,6], [3,6,7], [2,4,7,8]] #Creating the figure plot = figure() #Building the patch plot plot.patches(x_region, y_region, fill_color = ['yellow', 'black', 'green'], line_color = 'white') #Output the plot output_file('patch_plot.html') show(plot) image.png 散列图 #Creating scatter plots #Importing the required packages from bokeh.io import output_file, show from bokeh.plotting import figure #Creating the figure plot = figure() #Creating the x and y points x = [1,2,3,4,5] y = [5,7,2,2,4] #Plotting the points with a cirle marker plot.circle(x,y, size = 30) #Output the plot output_file('scatter.html') show(plot) image.png 更多资源 #- cross() #- x() #- diamond() #- diamond_cross() #- circle_x() #- circle_cross() #- triangle() #- inverted_triangle() #- square() #- square_x() #- square_cross() #- asterisk() #Adding labels to the plot plot.figure(x_axis_label = "Label name of x axis", y_axis_label = "Label name of y axis") #Customizing transperancy of the plot plot.circle(x, y, alpha = 0.5) plot.circle(x, y, alpha = 0.5) 参考资料 本文最新版本地址 讨论 钉钉免费群21745728 qq群144081101 567351477 本文涉及的python测试开发库 谢谢点赞! 本文相关海量书籍下载 代码仓库

优秀的个人博客,低调大师

[雪峰磁针石博客]构建工具buildbot教程 持续交付与构建

Buildbot是python实现的开源持续构建和持续交付工具,为Python, Mozilla, Chromium, WebKit等知名项目使用。 与Jenkins相比,Buildbot在大陆使用者较少。原因在于Jenkins的界面相对较美观,更容易上手;Jenkins的中文文档比较丰富。但是Jenkins因为资源消耗庞大、不太方便定制而不受一些有实力的公司欢迎。这些不少把目光聚焦在Buildbot。 究竟Buildbot有哪些优点让这些公司青睐呢?Buildbot基于python网络框架Twisted,分布式做得好。Buildbot可以直接使用python包,轻松拥有上万库,具备强大的扩展能力。如果你觉得Jenkins已经轻松地满足你的需求,你不需要Buildbot。如果你在Jenkins时觉得效率低下、扩展困难、一些用python等脚本可以实现的动作在Jenkins困难重重,那么可以看看Buildbot。 python的buildbot站点: http://buildbot.python.org/all/#/ Buildbot是开源的自动化软件构建,测试,发布流程的框架。 Buildbot支持跨平台,分布式,并行执行jobs,与版本控制系统的灵活集成,丰富的状态报告等等。 Buildbot是一个作业调度系统:它会对作业进行排队,在所需要的资源可用时执行任务,并报告结果。 Buildbot有一个或多个主机和从机。主机监控源代码库的变化,调配从机,并给用户和开发者报告结果。从机可在多种操作系统上运行。 可以配置Python脚本到主机。这个脚本可以简单到只配置内置组件,也可以充分发挥python所长,可以动态生成的配置,定制的组件及其他任何你能想到的。 该框架基于Twisted实现,并与所有主要的操作系统兼容。 Buildbot支持持续集成,持续部署,发布管理等的。Buildbot支持持续集成测试,自动化复杂的编译系统,应用程序部署和复杂的软件发布流程管理。比CruiseControl或Jenkins更适合混合语言的环境。在 Chromium,WebKit, Firefox, Python和Twisted等有广泛的使用。 缺点:buildbot对多项目支持并不好。 参考资料 本文涉及的python测试开发库 谢谢点赞! 本文相关书籍下载 讨论 钉钉免费群21745728 qq群144081101 567351477 本文代码地址:https://github.com/china-testing/python-api-tesing/tree/master/buildbot/ https://en.wikipedia.org/wiki/Buildbot http://buildbot.readthedocs.org/en/v0.8.9 https://docs.buildbot.net/ https://www.ibm.com/developerworks/cn/linux/l-buildbot/ https://pypi.python.org/pypi/buildbot http://buildbot.net/ https://www.digitalocean.com/community/tutorials/how-to-set-up-continuous-integration-with-buildbot-on-ubuntu-16-04 安装 目的 本教程从零开始,尽可能快地运行您的第一个buildbot master和worker,而不会更改默认配置。 本教程假设您正在运行Linux,但可能适用于Windows。 准备 pip3 install buildbot pip3 install buildbot-www pip3 install buildbot-grid-view pip3 install buildbot-console_view pip3 install buildbot-worker pip3 install setuptools-trial 创建master $ buildbot create-master master mkdir /opt/master creating /opt/master/master.cfg.sample creating database (sqlite:///state.sqlite) buildmaster configured in /opt/master $ mv master/master.cfg.sample master/master.cfg $ buildbot start master Following twistd.log until startup finished.. The buildmaster appears to have (re)started correctly. 日志在master/twistd.log 此时访问 http://localhost:8010/ image.png 创建worker $ buildbot-worker create-worker worker localhost example-worker pass mkdir /opt/worker mkdir /opt/worker/info Creating info/admin, you need to edit it appropriately. Creating info/host, you need to edit it appropriately. Not creating info/access_uri - add it if you wish Please edit the files in /opt/worker/info appropriately. worker configured in /opt/worker $ buildbot-worker start worker Following twistd.log until startup finished.. The buildbot-worker appears to have (re)started correctly. 日志在worker/twistd.log 快速入门 本章从china-testing拉取代码,调用pytest执行buildbot/hello-world/hello下的单元测试。 配置项目名和URL $ vi master/master.cfg # -*- python -*- # ex: set filetype=python: from buildbot.plugins import * # This is a sample buildmaster config file. It must be installed as # 'master.cfg' in your buildmaster's base directory. # This is the dictionary that the buildmaster pays attention to. We also use # a shorter alias to save typing. c = BuildmasterConfig = {} ####### WORKERS # The 'workers' list defines the set of recognized workers. Each element is # a Worker object, specifying a unique worker name and password. The same # worker name and password must be configured on the worker. c['workers'] = [worker.Worker("example-worker", "pass")] # 'protocols' contains information about protocols which master will use for # communicating with workers. You must define at least 'port' option that workers # could connect to your master with this protocol. # 'port' must match the value configured into the workers (with their # --master option) c['protocols'] = {'pb': {'port': 9989}} ####### CHANGESOURCES # the 'change_source' setting tells the buildmaster how it should find out # about source code changes. Here we point to the buildbot version of a python hello-world project. c['change_source'] = [] c['change_source'].append(changes.GitPoller( 'git://github.com/china-testing/python-api-tesing.git', workdir='gitpoller-workdir', branch='master', pollinterval=300)) ####### SCHEDULERS # Configure the Schedulers, which decide how to react to incoming changes. In this # case, just kick off a 'runtests' build c['schedulers'] = [] c['schedulers'].append(schedulers.SingleBranchScheduler( name="all", change_filter=util.ChangeFilter(branch='master'), treeStableTimer=None, builderNames=["runtests"])) c['schedulers'].append(schedulers.ForceScheduler( name="force", builderNames=["runtests"])) ####### BUILDERS # The 'builders' list defines the Builders, which tell Buildbot how to perform a build: # what steps, and which workers can execute them. Note that any particular build will # only take place on one worker. factory = util.BuildFactory() # check out the source factory.addStep(steps.Git(repourl='git://github.com/china-testing/python-api-tesing.git', mode='incremental')) # run the tests (note that this will require that 'trial' is installed) factory.addStep(steps.ShellCommand(command=["pytest", "buildbot/hello-world/hello"])) c['builders'] = [] c['builders'].append( util.BuilderConfig(name="runtests", workernames=["example-worker"], factory=factory)) ####### BUILDBOT SERVICES # 'services' is a list of BuildbotService items like reporter targets. The # status of each build will be pushed to these targets. buildbot/reporters/*.py # has a variety to choose from, like IRC bots. c['services'] = [] ####### PROJECT IDENTITY # the 'title' string will appear at the top of this buildbot installation's # home pages (linked to the 'titleURL'). c['title'] = "Hello World CI" c['titleURL'] = "https://github.com/china-testing/python-api-tesing" # the 'buildbotURL' string should point to the location where the buildbot's # internal web server is visible. This typically uses the port number set in # the 'www' entry below, but with an externally-visible host name which the # buildbot cannot figure out without some help. c['buildbotURL'] = "http://localhost:8010/" # minimalistic config to activate new web UI c['www'] = dict(port=8010, plugins=dict(waterfall_view={}, console_view={}, grid_view={})) ####### DB URL c['db'] = { # This specifies what database buildbot uses to store its state. You can leave # this at its default for all but the largest installations. 'db_url' : "sqlite:///state.sqlite", } $ $ buildbot reconfig master sending SIGHUP to process 4194 b'2018-01-24 15:13:07+0800 [-] beginning configuration update' b"2018-01-24 15:13:07+0800 [-] Loading configuration from '/opt/master/master.cfg'" b'2018-01-24 15:13:07+0800 [-] /usr/local/lib/python3.5/dist-packages/buildbot/config.py:102: buildbot.config.ConfigWarning: [0.9.0 and later] `buildbotNetUsageData` is not configured and defaults to basic.' b'\tThis parameter helps the buildbot development team to understand the installation base.' b'\tNo personal information is collected.' b'\tOnly installation software version info and plugin usage is sent.' b'\tYou can `opt-out` by setting this variable to None.' b'\tOr `opt-in` for more information by setting it to "full".' b'\t' b"2018-01-24 15:13:07+0800 [-] gitpoller: using workdir '/opt/master/gitpoller-workdir'" b"2018-01-24 15:13:08+0800 [-] initializing www plugin 'waterfall_view'" b"2018-01-24 15:13:08+0800 [-] initializing www plugin 'console_view'" b"2018-01-24 15:13:08+0800 [-] initializing www plugin 'grid_view'" b'2018-01-24 15:13:08+0800 [-] configuration update complete' Reconfiguration appears to have completed successfully 首次构建 打开:http://localhost:8010/#/builders 点击右上角的force,表单可以什么都不填,点击“Start Build”就会开始构建。 image.png 很快可以看到输出: SESSION=ubuntu SESSIONTYPE=gnome-session SESSION_MANAGER=local/andrew-MS-7A71:@/tmp/.ICE-unix/2824,unix/andrew-MS-7A71:/tmp/.ICE-unix/2824 SHELL=/bin/bash SHLVL=1 SSH_AUTH_SOCK=/run/user/1000/keyring/ssh TERM=xterm TMDB_API_KEY=ee6623075bcc5519ef16be16e1f139e7 UPSTART_EVENTS=xsession started UPSTART_INSTANCE= UPSTART_JOB=unity7 UPSTART_SESSION=unix:abstract=/com/ubuntu/upstart-session/1000/2570 USER=andrew XAUTHORITY=/home/andrew/.Xauthority XDG_CONFIG_DIRS=/etc/xdg/xdg-ubuntu:/usr/share/upstart/xdg:/etc/xdg XDG_CURRENT_DESKTOP=Unity XDG_DATA_DIRS=/usr/share/ubuntu:/usr/share/gnome:/usr/local/share:/usr/share:/var/lib/snapd/desktop:/var/lib/snapd/desktop XDG_GREETER_DATA_DIR=/var/lib/lightdm-data/andrew XDG_MENU_PREFIX=gnome- XDG_RUNTIME_DIR=/run/user/1000 XDG_SEAT=seat0 XDG_SEAT_PATH=/org/freedesktop/DisplayManager/Seat0 XDG_SESSION_DESKTOP=ubuntu XDG_SESSION_ID=c2 XDG_SESSION_PATH=/org/freedesktop/DisplayManager/Session0 XDG_SESSION_TYPE=x11 XDG_VTNR=7 XMODIFIERS=@im=fcitx _=/usr/local/bin/buildbot-worker using PTY: False ============================= test session starts ============================== platform linux2 -- Python 2.7.12, pytest-2.8.7, py-1.4.31, pluggy-0.3.1 rootdir: /opt/worker/runtests/build/buildbot/hello-world, inifile: collected 2 items buildbot/hello-world/hello/test_hello.py .. =========================== 2 passed in 0.01 seconds =========================== program finished with exit code 0 elapsedTime=0.168047

优秀的个人博客,低调大师

[雪峰磁针石博客]python标准模块介绍-string:文本常量和模板

string—文本常量和模板 作用:包含处理文本的常量和类。 Python版本:1.4及以后版本 最早的Python版本就有string模块。 之前在这个模块中实现的许多函数已经移至str对象的方法。 string模块保留了几个有用的常量和类,用于处理str对象。 代码地址 函数 capwords()的将字符串中所有单词的首字母大写。 #!python >>> import string >>> t = "hello world!" >>> string.capwords(t) 'Hello World!' >>> t 'hello world!' >>> t.capitalize() 'Hello world!' >>> t 'hello world!' 结果等同于先调用split(),把结果列表中各个单词的首字母大写,然后调用join()合并结果。 因为str对象已经有capitalize()方法,该函数的实际意义并不大。 模板 字符串模板已经作为PEP 292的一部分增加到Python 2.4中,并得到扩展,以替代内置拼接(interpolation)语法类似。使用string.Template拼接时,可以在变量名前面加上前缀$(如$var)来标识变量,如果需要与两侧的文本相区分,还可以用大括号将变量括起(如${var})。 下面的例子对简单的模板和使用%操作符及str.format()进行了比较。 #!python import string values = {'var': 'foo'} t = string.Template(""" Variable : $var Escape : $$ Variable in text: ${var}iable """) print('TEMPLATE:', t.substitute(values)) s = """ Variable : %(var)s Escape : %% Variable in text: %(var)siable """ print('INTERPOLATION:', s % values) s = """ Variable : {var} Escape : {{}} Variable in text: {var}iable """ print('FORMAT:', s.format(**values)) """ print 'INTERPOLATION:', s % values 执行结果: #!python python3 string_template.py TEMPLATE: Variable : foo Escape : $ Variable in text: fooiable INTERPOLATION: Variable : foo Escape : % Variable in text: fooiable FORMAT: Variable : foo Escape : {} Variable in text: fooiable 模板与标准字符串拼接的重要区别是模板不考虑参数类型。模板中值会转换为字符串且没有提供格式化选项。例如没有办法控制使用几位有效数字来表示浮点数值。 通过使用safe_substitute()方法,可以避免未能提供模板所需全部参数值时可能产生的异常。 tring_template_missing.py #!python import string values = {'var': 'foo'} t = string.Template("$var is here but $missing is not provided") try: print('substitute() :', t.substitute(values)) except KeyError as err: print('ERROR:', str(err)) print('safe_substitute():', t.safe_substitute(values)) 由于values字典中没有对应missing的值,因此substitute()会产生KeyError。不过,safe_substitute()不会抛出这个错误,它将捕获这个异常,并在文本中保留变量表达式。 #!python $ python3 string_template_missing.py ERROR: 'missing' safe_substitute(): foo is here but $missing is not provided 高级模板(非常用) 可以修改string.Template的默认语法,为此要调整它在模板体中查找变量名所使用的正则表达式模式。简单的做法是修改delimiter和idpattern类属性。 string_template_advanced.py #!python import string class MyTemplate(string.Template): delimiter = '%' idpattern = '[a-z]+_[a-z]+' template_text = ''' Delimiter : %% Replaced : %with_underscore Ignored : %notunderscored ''' d = { 'with_underscore': 'replaced', 'notunderscored': 'not replaced', } t = MyTemplate(template_text) print('Modified ID pattern:') print(t.safe_substitute(d)) 执行结果: #!python $ python3 string_template_advanced.py Modified ID pattern: Delimiter : % Replaced : replaced Ignored : %notunderscored 默认模式 #!python >>> import string >>> t = string.Template('$var') >>> print(t.pattern.pattern) \$(?: (?P<escaped>\$) | # Escape sequence of two delimiters (?P<named>(?-i:[_a-zA-Z][_a-zA-Z0-9]*)) | # delimiter and a Python identifier {(?P<braced>(?-i:[_a-zA-Z][_a-zA-Z0-9]*))} | # delimiter and a braced identifier (?P<invalid>) # Other ill-formed delimiter exprs ) string_template_newsyntax.py #!python import re import string class MyTemplate(string.Template): delimiter = '{{' pattern = r''' \{\{(?: (?P<escaped>\{\{)| (?P<named>[_a-z][_a-z0-9]*)\}\}| (?P<braced>[_a-z][_a-z0-9]*)\}\}| (?P<invalid>) ) ''' t = MyTemplate(''' {{{{ {{var}} ''') print('MATCHES:', t.pattern.findall(t.template)) print('SUBSTITUTED:', t.safe_substitute(var='replacement')) 执行结果: #!python $ python3 string_template_newsyntax.py MATCHES: [('{{', '', '', ''), ('', 'var', '', '')] SUBSTITUTED: {{ replacement 格式化 Formatter类实现与str.format()类似。 其功能包括类型转换,对齐,属性和字段引用,命名和位置模板参数以及特定类型的格式选项。 大多数情况下,fformat()方法是这些功能的更方便的接口,但是Formatter是作为父类,用于需要变化的情况。 常量 string模块包含许多与ASCII和数字字符集有关的常量。 string_constants.py #!python #!/usr/bin/env python3 # -*- coding: utf-8 -*- # Author: xurongzhong#126.com wechat:pythontesting qq:37391319 # 技术支持 钉钉群:21745728(可以加钉钉pythontesting邀请加入) # qq群:144081101 591302926 567351477 # CreateDate: 2018-6-12 import inspect import string def is_str(value): return isinstance(value, str) for name, value in inspect.getmembers(string, is_str): if name.startswith('_'): continue print('%s=%r\n' % (name, value)) 执行结果 #!python $ python3 string_constants.py ascii_letters='abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ' ascii_lowercase='abcdefghijklmnopqrstuvwxyz' ascii_uppercase='ABCDEFGHIJKLMNOPQRSTUVWXYZ' digits='0123456789' hexdigits='0123456789abcdefABCDEF' octdigits='01234567' printable='0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ!"#$%&\'()*+,-./:;<=>?@[\\]^_`{|}~ \t\n\r\x0b\x0c' punctuation='!"#$%&\'()*+,-./:;<=>?@[\\]^_`{|}~' whitespace=' \t\n\r\x0b\x0c' 参考资料 本文最新版本地址 本文涉及的python测试开发库 谢谢点赞! 本文相关海量书籍下载 讨论 钉钉免费群21745728 qq群144081101 567351477 Standard library documentation for string String Methods – Methods of str objects that replace the deprecated functions in string. PEP 292 – Simpler String Substitutions Format String Syntax – The formal definition of the layout specification language used by Formatter and str.format().

优秀的个人博客,低调大师

[雪峰磁针石博客]软件自动化测试初学者忠告

题外话 测试入门 很多受过高等教育的大学生经常问要不要去报测试培训班来入门测试。 答案是否。 高等教育的合格毕业生要具备自学能力,如果你不具备自学能力,要好好地反省一下,为什么自己受了高等教育迷恋于各种入门级别的培训?是没有毅力还是不知道学习方法? 没有毅力的话,要自己多看些励志的书,多想想社会的残酷,亲人的失望等来勉励自己,毕竟企业多半也不会喜欢懒散的人的。 不知道学习方法的话,可以去知乎上看看,有些地方是回答得挺好的。简而言之,读《软件评测师教程》(国内软件评测师教材),《Software Testing Foundations 4th》(强烈推荐 国外测试认证ISTQB教材),《谷歌测试之道》是通常比培训机构更好地入门测试。这些测试入门书籍可以在 qq群144081101 567351477的共享找到。 附录:经典的软件测试基础书籍免费下载 我身边碰到比较有水平的软件测试,没有一个是什么*石、*testing、*林、*鸟、*内等入门测试的。而且这些机构经常打着包就业的名义骗人去培训,培训的老师通常口才很好,善于包装,但是关键的一点,这些老师多数自己都不是合格的测试。培训完之后有些学生重学几次又无法就业,甚至出现学生和培训机构对簿公堂的情况(这种情况通常是培训机构败诉,如果你身边有这样的被骗朋友可以建议他们先交涉不行再找律师保护自己)。 实体培训业尤其成为打着就业的幌子进行行骗的重灾区,导致现在主流企业一看到有某些机构经历的简历直接连面试机会都没有了。 当然不是一棍子打死所有的测试培训,比如斯特沃克的培训,google的gtac等分享是做得相当不错,建议自己先对测试有一定的了解,了解测试培训授课老师的水平之后再选择培训,尽量自学为主,在身边找有经验的实际测试人员稍微带下。 测试的方向整体是功能测试的工作岗位逐渐减小。facebook就没有测试人员,google也没有专职的功能测试,功能测试由开发、产品、用户等分担会降低沟通等成本。未来的测试人员更加需要开发技能。 对于太极,推拿之类的,视频是一个很好的学习方法。但是对于软件自动化测试,最好的学习方法不是听课,也不是看视频,而是在有经验的专业人士指导下进行项目实战、发现问题、解决问题。实战实战再实战! 本人曾在公司项目中曾手把手教刚毕业的毫无编程基础的技校生接口、性能、自动化等测试,结果3个月之后他们都跳槽,薪水从4k涨到10k以上(2015年)。 自动化测试进阶 IT主要技术体现为英文,要想提升到比较高的水平,必须要有流利的英文阅读能力。 搜索引擎方面要珍惜生命,远离竞价排名,做个有良知不受骗的人,从不用死不悔改的*度开始,优选google,其他的还有 必应 雅虎, 很多QQ群还有免费fanqiang工具。google的搜索通常能直中目标,stackoverlow的回答通常是首选方案。 选择有水平的业内人士帮助是掌握linux、python和测试基础之后一个迅速提升的方法。 技术支持qq群: 144081101(后期会录制视频存在该群群文件) 591302926 567351477 钉钉免费群:21745728 自动化测试的层次 从图看出自动化尽量以单元、接口为主,如果你有志在自动化测试深入,还在死磕QTP,selenium等的话,建议看下pytest、pexpect、API测试、单元测试等。 脚本 1-1 不要在实际项目中使用录制和回放 大多数自动化工具(特别是商业工具)具有记录和播放功能,这个功能的表面简单,实际是一个众所周知的陷阱。录制和回放在广告视频和演示文稿中看起来非常棒。但录制的脚本不使用变量,循环和条件。自动创建的程序和函数的名称通常不直观,通常所有操作都录在一个函数中(可能很大),执行不稳定,维护成本也高。 录制和回放适用点 在学习自动化工具 不重用的工作 很难识别和处理的控件 1-2 不要使用暂停 暂停,比如python中的: #!python import time time.sleep(5) 定义全局变量可以避免大量代码修改,如下 #!python WAIT_TIME = 5 ... time.sleep(WAIT_TIME) 上述等待不利于快速执行,较快出现的控件同样需要常见等待。等待对象或对象属性是更好的选择,比如selenium中的显式等待: #!python from selenium import webdriver from selenium.webdriver.common.by import By from selenium.webdriver.support.ui import WebDriverWait from selenium.webdriver.support import expected_conditions as EC driver = webdriver.Firefox() driver.get("http://somedomain/url_that_delays_loading") try: element = WebDriverWait(driver, 10).until( EC.presence_of_element_located((By.ID, "myDynamicElement")) ) finally: driver.quit() 又如selenium中的隐式等待: #!python from selenium import webdriver driver = webdriver.Firefox() driver.implicitly_wait(10) # seconds driver.get("http://somedomain/url_that_delays_loading") myDynamicElement = driver.find_element_by_id("myDynamicElement") 以WebDriverWait一定的时间间隔检查对象的存在(例如每秒一次),如果象出现对,则返回true。如果对象在timeout参数指定的时间内没有出现,则返回false。因此,如果控件一秒钟内出现,那么等待时间将会是 1秒。 当然短时间的等待,有时也是必要的,比如降低CPU使用率,短时间等待状态改变等。 1-3 在循环中超时退出 以常量的形式定义类似超时。例如定义两种类型的短超时(3秒)和长超时(3分钟)。 1-4 不要将自动化测试完全等同于开发 然自动化需要编程技巧,但它通常不是完整的开发项目。自动化常由初级程序员开发,因为工作简单得多,并一般为内部需求。在99%的情况下不需要大多数设计模式。在使用数据库时不会使用事务。测试数据量一般不会很大。 代码要力求简单,快速开发。即使使用了行为驱动开发(BDD:behavior-driven development)或关键字驱动的测试(KDT:keyword-driven testing)等方法也要尽量保证代码简单。 1-5 不要写复杂的代码 在使用条件和条件时,尽量遵循“不超过三个嵌套级别”的规则。 代码嵌套超过三层非常难以调试。宁肯代码多重复也不要嵌套超过三层。 1-6 验证逻辑条件的所有选项 #!python if A and B or C: # if (A and B) or (C and D) 定要检查这些代码的每个条件(在这个例子中的A,B,C)和所有可能的True和False。添加括号能增加可读性。 1-7 使用编程规范 初学者通常不太关注变量和函数的名称使用任何规则。尽管如此,几乎所有的语言都有所谓的编码标准。比如python的PEP8, google的编程规范。 在大项目中这些标准成为强制性规则,方便互相理解代码。 1-8 使用静态代码分析器 对于流行的编程语言,有特殊的代码分析器。例如Python的pylint,JavaScript语言的jslint等。 特别指出对python这样的动态类型的语言,这个更加重要。 pylint通常有很多误报,但是mypy的检查则比较实用。参考:python代码分析和lint。 1-9 随机 比如打开菜单有快捷键、下拉菜单、图标等多种方式,尽量写方法随机调用各种方式。以求覆盖各种场景,不过要记得添加日志以便跟踪错误。 1-10 不要使用坐标 非标准控件尽量不要使用坐标,可以用图像识别的方法: #!python Window.Toolbar.Click(135, 15) 替换为: #!python toolbar_click_button_by_image(Window.Toolbar, "Button Caption") 1-11 学习和使用库 比如: #!python full_name = '{0}\\{1}'.format(file_path, file_name) 在linux上就比较尴尬,可以替换为: #!python full_name = os.path.join(file_path, file_name) 附: python自动化测试开发库 1-12 避免复制和粘贴 复制的代码维护成本很高,尽量提取为公共库。 公共测试库示例 1-13 异常捕捉到具体的类 异常通常是程序考虑不周到才会发生: #!python try: x = input('Enter the first number: ') y = input('Enter the second number: ') print x/y except Exception as e: pass 上述捕捉所有异常并忽略异常的代码通常只在临时代码中使用。通常也要把异常异常信息显示出来。比如 #!python import sys try: x = input('Enter the first number: ') y = input('Enter the second number: ') print x/y except Exception as e: print e for item in sys.exc_info(): print item 又如: #!python import traceback import cv2 import numpy as np def raw2jpg(filename, height=480, width=640): try: img = np.fromfile(filename, dtype=np.uint16) img = img.reshape( (height, width) ) img.astype(np.float) img = np.sqrt(img) img = img * (255 / img.max()) #img.astype(np.uint8) cv2.imwrite(filename+'.jpg', img) except Exception as info: print('Error: {}'.format(filename)) print(info) traceback.print_exc() return False return True 更佳的方式是捕捉到具体异常: #!python try: x = input('Enter the first number: ') y = input('Enter the second number: ') print x/y except ZeroDivisionError as e1: print("ZeroDivisionError") except TypeError as e2: print("TypeError") 另外一种异常处理方式: #!python far = 0 if not no_number else far_number/float(no_number) 1-14 代码与数据分离 对于小数据集可以使用数组或列表。大数据可以使用数据驱动测试(DDT:data-driven testing)。数据源可能为数据库,Excel或CSV文件等。 注意点: 以读模式打开数据文件。 每列只存储一种类型的数据。在数据库的情况下, 用完关闭与数据源 数据文件中不要用空行 公共测试库示例 1-15 调试 简单的可以多使用print或者logging打印一些信息。更高级的内容有 •断点 •单步执行 •查看本地和全局变量的值 •观察变量和表达式 1-16 不要为未来编写代码 项目的变化是很频繁,可以做一些自动化测试的技术预研,但一般不要书写有些只供未来使用的代码。 1-17 让代码更好 在不影响性能的情况下提高可读性。 1-18 测试选择适当的语言 •很重要:语言上手的难易程序和流行度及库支持。一般而言python因为其容易上手、是胶水语言(与其他语言调用方便)、语法简洁、维护成本低、方便调试,是目前自动化测试占有率最高的首选语言。但是c#在windows平台、java、c++等也有一定的市场。虽然python的占有率最高,但是一定要考虑到有些自动化测试开发可能已经有c++,go,java之类的现成的工具。 •尽量不要产生新的编程语言。 •咨询开发 •可以和开发采用同一种语言,尤其是单元测试,一般为采用和开发一样的语言。 • 简化API测试等其他原因 值得注意的是TCL(Tool Command Language)早起因为expect的命令自动化拥有一定的名声,且testcenter、smartbits等仪表一度不支持python等主流语言。但是TCL的语法晦涩,功能弱小,是能不用就不要去用的语言。 参考资料: 编程流行度 tiobe 1-19 使用变量前要初始化 这个在python中可以用mypy检查。 测试最佳实践 2-1 不要实现被测应用的功能 因为: •计算和逻辑可能很复杂,且开发已经实现了 •计算和逻辑可能会更改 •使用浮点数的精度可能和语言有关。 白盒和灰盒测试中一般是知道输入和预期结果就好,不要知道具体内部实现得的过程。 例外:大数据、搜索引擎中间算法等不明确预期结果的测试,经常用python快速实现一遍,与开发用c++等语言实现得结果进行比对。 2-2 测试的独立性 2-3 哪些不应该自动化 主要是基于成本考虑 •难以维护的自动化。 •尽量多做单元测试和接口测试的自动化,少做UI层的自动化 •重复使用次数不多的自动化 有些手工不能做的必要测试,即便自动化的成本很高,也是需要自动化。 2-4 向开发人员寻求帮助 开发在具体的开发方面可以值得学习,但是在自动化测试很方案方面自己定夺比较好。比如结果验证,开发大多喜欢直接从数据库中读数据,但是实际上展示数据库数据的应用也是可能出问题的。 2-5 云测试 云测试 •要测试桌面应用程序,必须打开会话,操作系统是否支持 •硬件相关的测试云测试支持并不方便。 •移动设备的云服务通常比较贵 •Web应用程序的自动化比较适合在云中执行。 •手机兼容性的测试可以考虑云,功能自动化测试则不用云比较好。 2-6 充分利用边界值和等价类 2-7 错误与警告 注意区分自动化测试平台或工具的错误和被测应用的bug。 2-8 使用合适的技术 在测试自动化中使用了许多特定的方法:ODT,DDT,KDT,BDD,页面对象,基于模型的测试等等。比如那么对KDT一般需要一部分写测试平台,一部分写测试库,一部分写测试用例。 2-9 特殊错误的验证 可以书写一个临时的测试来处理某些特定的bug。 2-10 在写真实测试之前做POC 环境 软件测试自动化中有两种主要的环境类型。一个创建和调试测试,另一个用于运行测试。 3-1 为您的需要选择一套适当的工具 以接口自动化测试为例,一些团队,执着的认为java是最好的语言,要用java去发HTTP请求,更有甚者,用jmeter去做接口自动化测试。不排除个别场景,这可能是合适的方式,但是通常的HTTP接口测试,用requests,代码行数通常比java少一个数量级,还不用编译。 python是主流语言中的胶水语言,和其他语言配合都比较完美,通常情况下是自动化测试的首选语言,但是python未必适用所有地方,还需要其他工具和语言进行补充,不过不要太多,学习很多语言也是一件痛苦的事情。 现在还有很多培训机构在鼓吹UI自动化就是自动化测试的全部,一说自动化就是QTP,一问Selenium,Testcomplete之类的都不知为何物,更不用说什么junit,pytest之类的了。 3-2 慎用自动提交bug 配置错误,测试代码错误经常导致测试失败。 测试代码有时难以描述清楚测试步骤 注意不要提交重复的bug。 在没有十足的把握的情况下可以用半自动的方式,发送邮件给测试人员,然后又测试人员提交bug。 3-3 不要使用欺骗的结果 避免注释测试代码的问题部分或改变预期的结果,以便测试不会出现失败。 如果实在用禁用,要知道禁用用例的比例,后面定期检查修改。 3-4 熟练使用工具 比如wingide中Ctrl + \为注释代码的快捷键 3-5 使用版本控制系统 避免文件丢失,方便协作,尽快使用hg、git之类的。 3-6 避免自定义表单 本来自动化就是为了把页面的东西尽可能走后台,你为了取悦领导(附:大陆目前多数测试领导是不太合格的)还是什么原因,搞成形式主义了。 参数可以用配置文件等方式。 3-7 自动化所有能自动化的东东 比如:测试,代码,测试环境,虚拟机,SQL查询,测试数据,报告等等 运行,日志记录,验证 4-1 尽可能经常运行脚本 4-2 测试失败时重新执行 当出现错误时应用程序运行很长一段时间,或特定情况下要尽量定位问题。 一般而言失败的测试先记录下来,所有测试执行完之后在重新执行一次。 4-3 丰富的日志内容 错误日志尽量包含:预期值,实际值,地点和操作。 参数尽量用引号等括起来,以免把包含空格的参数当成多个参数。 4-4 截图 UI测试必要的时候可以截图,同时处理好滚动。 4-5 尽量避免比较图像 审查 审查是保持码清晰易懂的好方法,要做代码的互相评审。 5-1 让非自动化者也可以看懂代码 #!python def test_login(url, user, password, text): open_page(url) login_as(login=user, password=password) verify_page_opened(text) 5-2 避免不必要的优化 在开始执行任何优化之前如需要慎重考虑。 通常不需要的优化工作看起来像这样: 1.应用程序启动3秒钟,然后进行5秒钟的测试脚本填充搜索字段,还有5秒钟搜索过程,之后脚本用1秒钟读取找到的数据并进行验证。 2.测试人员开始优化读取和验证 3.测试人员花费一天时间进行优化并达到目标:阅读和阅读每次运行时间为半秒 事实上,测试工程师的代码生产力已经翻了一番,但是结果是他整体方案取得了约5%的收益。花一天时间是不值得的。一般需要综合考虑,涉及脚本、被测应用、环境、执行频率等。 建议你在两种情况下优化测试: •如果测试运行时间过长,并且测试的应用程序是在测试执行期间空闲。 •如果您在代码中看到明显的问题,请更正其中的问题。 pandas大数据分析性能优化实例-read_csv引擎和分组等,这里是一个必要的优化实例。 5-3 定期审查别人的代码 定期审查别人的新代码。可以结对编程,甚至是同时一个人写,一个人看。 5-4 参与论坛和讨论 如果您是自动化领域的初学者,并且在自动化团队中工作,那么会从你的同事那里学到很多东西。如果你是唯一的自动化工程师在公司或你的部门没有人能帮助你? 知乎,特别是stackoverflow等社区常常可以找到自己问题满意的答案。同时试图帮助别人也可以扩展自己的眼见。 5-5 执行重构 重构是对现有代码的简化,功能和应用程序不会改变。尽管测试自动化中的代码通常很多实际应用更简单,有时候你仍然需要重构。 •您可能会发现您所支持的代码太复杂。 •可能有编写新测试的请求,需要修改代码 •可能需要重构来改进已编写的代码 重构后可以执行所有测试来验证,也可以在公共库等地方添加必要的单元测试。 5-6 删除低收益的测试 •测试执行了多少次; •测试发现了多少实际问题; •测试需要多久进行一次维护。 参考资料 本文涉及的python测试开发库请在github上点赞,谢谢! 本文相关书籍下载

优秀的个人博客,低调大师

阿里云(企业云解析DNS)让你的博客飞起来

你是否还在为网站访问速度而苦恼,你是否还在恐惧全国各地而来的访客。 不用慌、不用怕 企业云解析DNS为你保驾护航排忧解难,在这互联网的冬天让你依靠温暖的胸膛。 不要998,不要888,不要668,一年只需要103.2,没错你没听错。只要103.2元 完美解析领回家!103.2元你买了不吃亏,103.2元你买了也不上当。不要怀疑你的眼睛,先到先得,程序员优先,现在购买一年还可以享受85折优惠,只要86.02元 全能DNS带回家,不用你接不用你送,一键购买服务直达。优惠多多,现在购买3年还可以享受5折优惠,请各位单身域名抓紧时间订购!!! 云解析 云解析(Domain Name System,简称DNS)是一种高可用性、高可扩展的权威DNS服务和DNS管理服务。它的目的是为企业和开发者提供稳定、安全、智能的把网站域名或应用资源转换为计算机用于互连的数字 IP地址,从而将最终用户的访问路由到相应的网站或应用资源上同时提供DNS的管理服务。详细介绍:https://wanwang.aliyun.com/domain/dns/ 当前配置: CDN 阿里云 CDN(内容分发网络)全称是 Alibaba Cloud Content Delivery Network,建立并覆盖在承载网之上、由分布在不同区域的边缘节点服务器群组成的分布式网络,替代传统以WEB Server为中心的数据传输模式。 将源内容发布到边缘节点,配合精准的调度系统;将用户的请求分配至最适合他的节点,使用户可以以最快的速度取得他所需的内容,有效解决Internet网络拥塞状况,提高用户访问的响应速度。 详细介绍:https://help.aliyun.com/document_detail/27101.html 之所以在这里介绍CDN,因为企业云解析,附赠了增值服务CDN加速。 操作流程 一、添加域名只云解析 二、点击解析,添加加速域名 三、解析域名,添加 CNAME记录,新增加速域名后,会看到CNAME相应的值 四、点击图中,更多配置,进入CDN配置界面 基础配置里面、可以开启页面优化,只能压缩,还可以自定义404页面(这里选择了公益) http://blog.52itstyle.com/404 当然,你还可以添加防盗链和缓存配置,缓存可以分别设置目录和文件后缀名。 五、测试配置成功,ping一下域名即可 六、资源监控相关,出现以下图示,说明正式配置成功 到这里,基本就没什么问题了,来来来,起飞了,带你去装逼。

优秀的个人博客,低调大师

精选博客系列|将基于决策树的Ensemble方法用于边缘计算

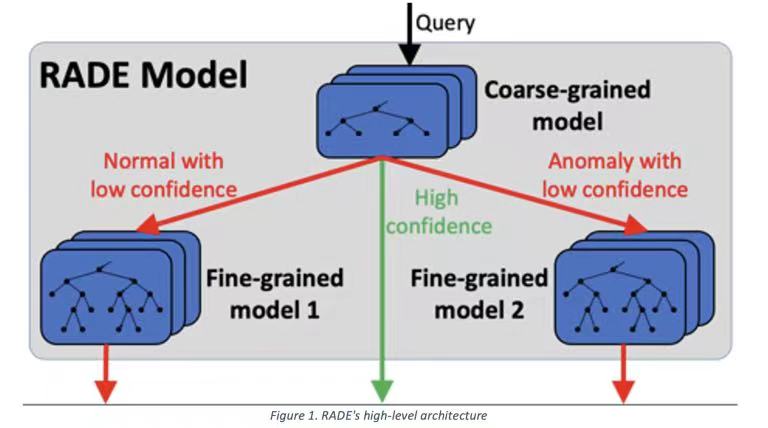
在即将到来的边缘计算时代,越来越需要边缘设备执行本地快速训练和分类的能力。事实上,无论是手机上的健康应用程序、冰箱上的传感器还是扫地机器人上的摄像头,由于许多原因,例如需要快速响应时间、增强安全性、数据隐私,甚至考虑到盈利能力,通常都需要进行本地计算。 无论是以什么方式进行机器学习,对于此类设备来说,具有异构性、有限的连接和有限的硬件资源是一个持续存在的、我们必须解决的挑战。事实上,人们经常面临着矛盾的需求,边缘设备必须在本地执行大量的计算、存储和通信,同时还要遵守如有限的内存、网络连接和计算的资源限制。这通常是由于时间或功率限制以及增加的数据和可用信息量。 这里,我们重点讨论利用基于决策树的Ensemble方法进行计算和内存高效的本地(即设备上)训练和分类,这是处理表格数据的实际标准。 基于决策树的Ensemble方法 事实上,基于树的Ensemble方法,例如随机森林(RF)和XGBoost,由于其健壮性、易用性和泛化性,经常用于对表格数据进行分类。反过来,分类任务通常用作许多应用域中的子例程,例如金融、欺诈检测、医疗保健和入侵检测。因此,这种方法的效率和精度与效用之间的权衡至关重要。 让我们特别关注随机森林和XGBoost,并了解它们的优势: 随机森林可以说是最流行的bagging方法,它使用数据的随机子样本来生长每个决策树,从而生成不同且弱相关的树。然后,使用多数票确定分类。随机森林有几个优点,包括健壮性、快速训练、处理不平衡数据集的能力、嵌入式特征选择、处理缺失的、分类的和连续的特征,以及高级人工分析或法规要求的、任何时候的可解释性。 XGBoost是一种著名且流行的boosting算法,它在每次迭代时都会生成一个小的决策树(例如,具有8–32个终端节点)。每个这样的树都是为了减少以前树的错误分类。XGBoost分享了随机森林的大部分优点,并且由于其可控偏差,通常可以实现更高的精度。 然而,这些方法也带来了一些与资源相关的缺点: 随机森林往往受内存限制,分类速度较慢。此外,由于随机森林占用大量内存,因此通常无法部署在内存有限的边缘设备上,而这些设备通常需要执行分类任务。 XGBoost模型通常比随机森林需要更少的内存,但它们是计算密集型的,导致训练速度较慢。 我们解决了随机森林和XGBoost的资源消耗缺点。特别的是,我们引入了一种新的混合方法,该方法继承了bagging和boosting方法的良好特性,具有可比较的机器学习性能,同时大大提高了资源效率。 数据集中的冗余 众所周知,机器学习模型的资源消耗与用于训练的数据集的大小高度相关。因此,减少数据集大小是可取的。因此,我们想提出以下问题: 数据集中的所有数据实例对于基于树的ensemble模型的训练是否同样重要? 如果没有,我们应该如何在训练期间区分数据实例以节省资源?这将如何影响分类? 事实上,数据集通常包含许多简单的(例如90%)数据实例,因为它们很容易识别,因此很容易分类;以及罕见或更独特的数据实例,因此更难分类。 直观地说,如果在培训之前可以进行这种区分,那么应该能够利用这些知识来节省资源,而不会对准确性产生重大影响。其中一个想法是在培训期间使用较少的“简单”数据实例。面临的挑战是如何制定这样的计划,并以有效的方式这样做。 RADE–资源高效的异常检测模型 数据集只有两个类,其中大多数实例是正常的或良性的(例如99%)。 RADE以以下方式利用上述观察结果:它首先使用整个数据集构建一个小(粗粒度)模型。然后,它使用该模型对用于训练的所有数据实例进行分类。正确分类且具有高度可信度的实例被标记为简单实例(通常是大多数正常实例),而所有其他实例都被标记为困难实例(通常为大多数异常实例)。 如图所示,RADE引入了一种高级体系结构,只要粗粒度模型及其分类提供了有意义的分类置信水平,就可以与不同的分类模型一起使用。 直观地说,由于粗粒度模型足以正确分类简单的查询,所以我们只剩下困难查询。利用这些,我们构建了两个专家(细粒度)模型,用于处理与粗粒度模型的分类结果有关的两种不同情况:细粒度模型1负责(低置信度)正常分类和细粒度模型2用于(低置信度)异常分类。这些模型可能具有比粗粒度模型更大的内存占用需求,但明显低于基于整体的树模型。 训练效率 如前所述,RADE分两个阶段进行训练。首先,使用整个数据集训练粗粒度模型。由于我们使用的是一个小模型,所以这个训练阶段相对较快。然后,我们使用粗粒度模型对整个训练数据集进行分类,并根据所得到的分类和置信度,生成两个数据子集用于训练细粒度模型。由于我们只使用训练数据的子集(例如10%)训练每个细粒度模型,所以这个训练阶段也相对较快。 分类效率 RADE的分类也有两个阶段。首先,根据粗粒度模型对实例进行分类。如果得到的分类置信度较高(例如0.9),则完成分类。否则,根据粗粒度模型分类结果,由其中一个细粒度模型转发查询以进行重新分类。这意味着RADE的分类时间等于仅由粗粒度模型提供服务的分类,以及由粗粒度和细粒度模型提供的分类时间的加权平均值。直觉上,因为目的是为了只通过粗粒度模型(例如90%)服务大多数查询,平均分类时间预计将比标准的整体模型显著改进。 Duet–资源高效的多类分类模型 RADE是为二进制分类设计的,因此使用两个细粒度模型。就多类分类用例而言,扩展RADE的体系结构并不是一个可扩展的解决方案,因为它需要K类的K个细粒度模型,因此需要一个新的体系结构。 为此,我们开发了Duet。Duet遵循RADE的原则,即使用粗粒度模型,该模型在整个数据集上经过训练,并对简单的查询进行分类。然而,与RADE不同,Duet只使用单个细粒度分类器,该分类器在训练数据集的子集上进行训练,并对困难(低置信度)查询进行分类。 Duet的高级体系结构如图所示。从本质上讲,它使用了两个分类器:一个小型bagging分类器(随机森林),提供有意义的分类置信度、受控方差和内存限制,另一个boosting分类器(XGBoost),提供受控偏差和计算限制。总的来说,与单例分类器相比,Duet引入了一种不同且通常更好的系统/机器学习性能的权衡。 Duet的主要问题是如何确定boosting分类器的训练数据子集。 在这种情况下,使用RADE中的置信度指标是不够的,因为我们有一个多维问题。因此,我们使用类概率分布向量(通过粗粒度模型)来确定实例对训练过程的重要性。 对于六个类别的分类任务,考虑两个具有相同(第一)分类置信度的分类结果。第一个在两个类别上的概率(几乎)相等(例如[0.5,0.5,0,0,0,0]),第二个在正确类别上概率较高,而在所有剩余类别上概率低得多(例如[0.5,0.1,0.1,0.1,0.1,0.1])。显然,第一个查询比较困难,可能更有利于增强分类器的训练。 为了捕获此属性,我们定义了一个新的度量标准–可预测性这是由欧几里得距离函数给出的,该函数测量得到的类概率分布向量相对于实例的真实标签与完美分布向量之间的距离。完美分布向量在正确标签(即类)中的概率应为1。 请注意,可预测性是训练过的bagging分类器和训练数据集的具体度量,因此是Duet训练过程中的一个集成步骤。此外,使用可预测性不同于仅依赖于数据集属性的采样方法(例如,分层采样,它保留了每个类的实例百分比)。 进一步的潜力 上述设计原则可能适用于其他机器学习领域。虽然Duet主要使用可预测性度量来降低训练和分类过程的计算成本,但可以使用可预测度度量来减少训练数据集的大小,从而降低存储和通信成本。 此外,RADE和Duet还可能适用于分布式学习。例如,参与方可以联合训练一个粗粒度模型,然后使用该模型从本地数据集中选择子集,最后使用这些子集训练全局细粒度模型。 这里的挑战是确定参与方选择其子集的标准。例如,一种高级方法是使用安全计算来收集有关全局训练数据的一些统计信息。这样的统计数据可能会使每个参与者选择更好的子集,总的来说,对于细粒度模型的分布式训练,这样有更高的训练价值。 内容来源|公众号:VMware 中国研发中心

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册