首页 文章 精选 留言 我的

精选列表

搜索[分库分表],共10000篇文章
优秀的个人博客,低调大师

Rainbond 5分钟部署 Spark Standalone 集群

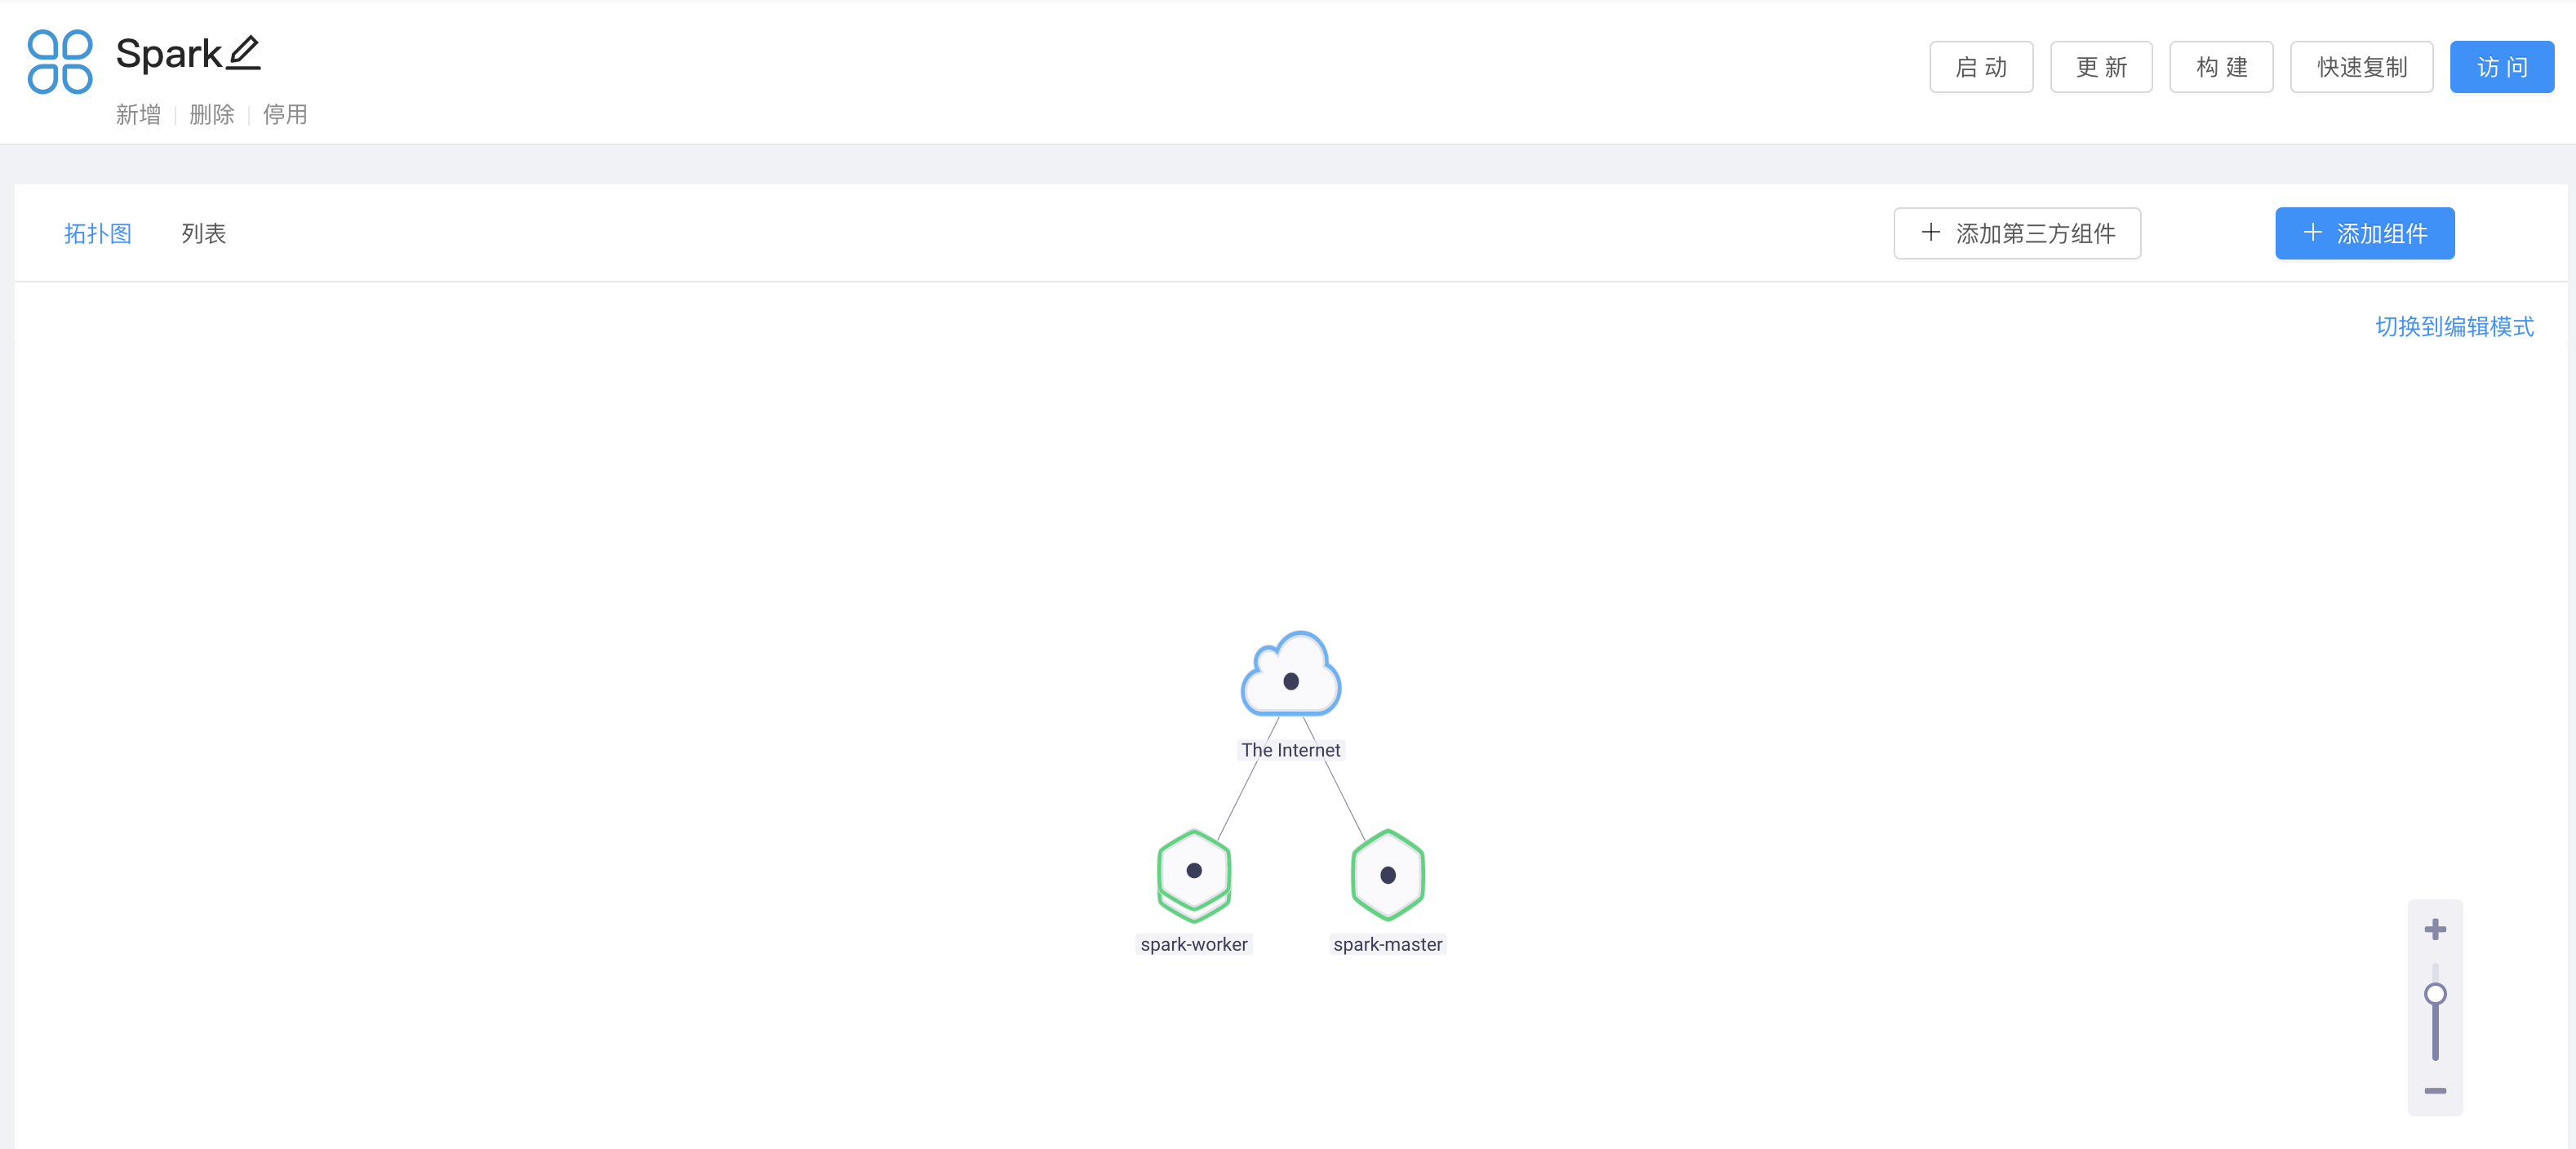
Standalone 是 Spark 自身提供的一种主从集群部署模式。本文讲述一个常规1主多从的集群部署模式,该模式下master服务依靠Rainbond平台监控保障其可用性,支持重新调度重启。 worker服务可以根据需要伸缩多个节点。 部署效果截图如下: <center>Rainbond 部署效果图</center> <center>Spark master UI 图</center> 部署步骤 开始前,你需要完成Rainbond平台的安装和搭建,参考Rainbond 安装与部署 本参考文档适合已掌握Rainbond 基础操作的同学,因此如果你还刚接触Rainbond平台,请先参考 Rainbond 快速入门指南 部署单实例的master服务 部署spark-master,采用Rainbond基于Docker镜像创建组件: bde2020/spark-master:3.0.1-hadoop3.2 确认创建检测成功后选择高级设置进行三个特殊设置。 在环境变量模块中添加环境变量 SPARK_DAEMON_JAVA_OPTS=-Dspark.deploy.recoveryMode=FILESYSTEM -Dspark.deploy.recoveryDirectory=/data 我们需要设置spark-master为“Recovery with Local File System”模式。可以在master发生重启后从持久化文件中恢复数据,保持master服务的可用性。 在存储设置中添加共享存储 /data 持久化master的数据,使其可以重启后恢复。 在端口管理中将 8080端口的对外服务打开,组件启动成功后即可访问master的UI。 在部署属性中选择组件类型为有状态单实例 部署为有状态组件后,其可以获得一个稳定的内部访问域名,供worker组件连接。有状态服务控制权可以保障master节点不会重复启动多个实例。 设置完成后选择确认创建即可启动master服务。 组件成功点击访问即可打开master UI。如上图所示,我们可以在UI中获取到master服务的访问地址是:spark://gr7b570e:7077 ,注意UI上显示的地址是spark://gr7b570e-0:7077 我们需要使用的是spark://gr7b570e:7077 ,复制并记录这个地址。 注意,地址实际值请查看你的UI显示,这里只是举例说明。 部署多实例的worker实例 部署spark-worker,采用基于Docker-run命令创建组件,这种创建方式可以直接设置一些必要属性: docker run -it -e SPARK_MASTER=spark://gr7b570e:7077 -e SPARK_WORKER_MEMORY=1g bde2020/spark-worker:3.0.1-hadoop3.2 如上创建方式指定了两个环境变量。 SPARK_MASTER 指定的是master的地址,由上一步创建的组件获取。 SPARK_WORKER_MEMORY 设置worker单个实例的内存量,这个根据每个实例分配的内存进行设置即可。比如每个实例分配1GB, 则设置SPARK_WORKER_MEMORY=1g 。如果不设置此变量,服务会自动读取操作系统的内存量。由于我们是采用的容器部署方式,读取的值会是宿主机的全部内存。将远大于worker实例实际分配的可用内存值。 同样进入高级设置,设置组件部署模式为 有状态多实例。 确认创建组件,启动成功后即可在组件的伸缩页面中设置worker的运行实例数。 到此,我们的Spark集群已部署完成。 Spark数据读取 <b>就近数据处理原则逐步打破</b> 过去我们更偏爱于把数据处理服务(hadoop、yarn等)部署到离数据最近的地方。主要原因是hadoop计算数据的模式对IO消耗较多,如果数据与计算分类,网络IO带来的消耗将更大,对网络带宽要求较大。 但Spark机制不同,Spark计算模式是将数据尽可能缓存到内存中,也就意味着Spark消耗的资源主要是内存和CPU。然后存储数据的设备内存和CPU配属不一定充足。因此数据与计算分离将是更好的选择。 <b>数据与计算分离后的更多选择</b> 数据与计算分离是指计算服务单独部署,存储服务通过网络为计算服务提供数据。通过网络也就意味着可以有多种协议模式可选,除了传统的HDFS,目前常用的就是对象存储,比如兼容S3的各类服务,也可以是分布式文件系统,可以根据数据类型和实际需要合理选择。计算服务(spark worker) 可以根据任务的需要灵活的在分布式集群中分配计算资源。 本文讲述的在Rainbond中部署Spark集群即是这种用例。 Master节点主备高可用 Spark 基于 ZooKeeper可以提供master服务的主备切换。 配置方式也比较简单,参考 官方文档。 Rainbond 云原生应用管理平台,实现微服务架构不用改代码,管理 Kubernetes 不用学容器,帮企业实现应用上云,一站式将任何企业应用持续交付到 Kubernetes 集群、混合云、多云等基础设施。是 Rainstore 云原生应用商店的支撑平台。 1. Rainbond 官网 2. Rainbond 安装使用 3. Rainbond 参考手册全集

优秀的个人博客,低调大师

5分钟快速安装thinkphp5.1

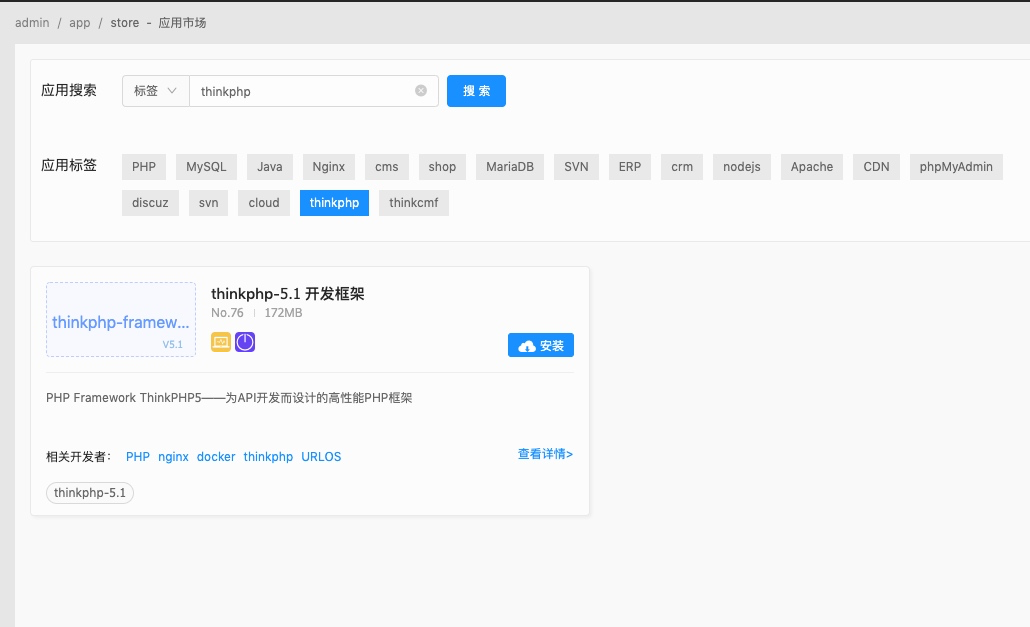
简介 ThinkPHP是一个免费开源的,快速、简单的面向对象的轻量级PHP开发框架,是为了敏捷WEB应用开发和简化企业应用开发而诞生的。ThinkPHP从诞生以来一直秉承简洁实用的设计原则,在保持出色的性能和至简的代码的同时,也注重易用性。遵循Apache2开源许可协议发布,意味着你可以免费使用ThinkPHP,甚至允许把你基于ThinkPHP开发的应用开源或商业产品发布/销售。 安装 为了方便部署和解决环境兼容性等问题,采用docker来部署安装thinkphp。 首先安装Docker容器管理面板URLOS,请参考官方文档:https://www.URLOS.com/center-home-index-detail-10-22-y.html。 登录URLOS:http://ip:9968(其中的IP是你的服务器的IP,登录的默认用户名和密码均为urlos) 在应用市场中搜索“thinkphp”并安装,如下图: 安装流程如下: 1. 填写服务名称、服务端口、选择运行节点、选择智能部署 2. 填写域名:www.aaa.com(这里填写自己的域名) 3. 设置数据库 选择自动添加并部署数据库,填写数据库密码;数据库名和数据库用户名跟前面的服务名称一致,这里已经自动设置好; 记下数据库密码、数据库名和数据库用户名,下面要用到; 然后点击“提交”按钮,等待部署完成; 访问网站 访问:http://domain(domain是你的服务器的域名) 这样thinkphp5.1就已经安装完成。 设置SFTP 选择“修改并部署”我们刚刚安装完成的thinkphp 选择“上传与下载”选项卡,开启SFTP上传下载并填写SFTP端口、SFTP密码;先别急着提交,接着看下面。 然后选择“基本信息”选项卡,选中智能部署,再点击“提交”,等待部署完成。 部署完成后,用ssh或者SFTP客户端登录: 网站根目录是:/mounts/thinkphp001/data/www(由于本次教程的服务名称为thinkphp001,实际操作中根据你创建的服务名称自动创建)

优秀的个人博客,低调大师

5分钟了解分页的那些事?

写在前面 最近面试,我问了一个非常通用的问题,题目是什么呢? 题目就是,谈谈你对分页里面逻辑的理解以及如何实现的?面试题目不难,但是90%的人讲不清楚分页逻辑,对分页的一些细节问题更是回答的很模糊。不是很清晰。下面借此机会给大家讲讲分页有哪些逻辑。 分页的那些事 如上图所示: 分页包含很多小细节, 每页展示10条,多余的下一页展示,这里就涉及的知识点有,是否采取逻辑分页还是物理分页,物理分页的实现方式有哪些,各位自行百度,这里主要讲前台页面如何编写分页的逻辑 <#– 是否上一页–> <#if page.hasPreviousPage> <li><a class=”pointer” data-page=”1″>首页</i></a></li> <li><a class=”pointer” data-page=”${page.prePage}”>上一页</i></a></li> </#if> <#–处理开头部分逻辑 开头省略号实现逻辑–> <#if (page.navigateFirstPage = 2)> <li><a class=”pointer” data-page=”1″>1</a></li> <#elseif (page.navigateFirstPage > 2)> <li><a class=”pointer” data-page=”1″>1</a></li> <li>…</li> </#if> <#– 是否下一页–> <#if page.hasNextPage> <li><a class=”pointer active” data-page=”${page.nextPage}”>下一页</i></a></li> <li><a class=”pointer” data-page=”${page.pages}”>尾页</i></a></li> </#if> <#–处理结果部分显示的逻辑 开头省略号实现逻辑–> <#if (page.navigateLastPage = page.pages-1)> <li><a class=”pointer” data-page=”${page.pages}”>${page.pages}</a></li> <#elseif (page.navigateLastPage < page.pages-1)> <li>…</li> <li><a class=”pointer” data-page=”${page.pages}”>${page.pages}</a></li> </#if> <#– 中间显示页数–> <#list page.navigateFirstPage..page.navigateLastPage as item> <li><a ${(page.pageNum == item)?string(‘class=”pointer active”‘,’class=”pointer” data-page=”${item?c}”‘)}>${item?c}</a></li> </#list> <#– 显示总页数–> <li> 共 ${page.pages} 页 </li> 分页的实现 上面分页的逻辑已经讲的比较清晰,逻辑需求理解清楚了,实现起来就简单了,这里要提醒大家的是,一个系统很多地方都有可能用到分页,所以大家最好封装成一个通用的组件,以便项目中实现复用。还有最后啰嗦一句,分页虽然不难,但是做一个通用的且体验感很强的分页组件需要大家去下一翻功夫。 原文发布时间为:2018-11-5 本文作者:HARRIES 本文来自云栖社区合作伙伴“Java杂记”,了解相关信息可以关注“Java杂记”。

优秀的个人博客,低调大师

3分钟了解阿里云容器服务

容器是什么 软件集装箱,把程序和依赖项打包成镜像,在主机上启动运行成为容器。 和虚拟机的差别:镜像小,启动快;可以跨平台运行。 集群管理:在主机集群中部署和管理容器应用。目前主流的管控系统是Kubernetes ( K8S)和Docker Swarm。 K8S介绍 Kubernetes(k8s)是自动化容器操作的开源平台,包括部署,调度和节点集群间扩展。你可以将Docker看成Kubernetes内部使用的低级别组件。 使用Kubernetes可以: 自动化容器的部署和复制 随时扩展或收缩容器规模 将容器组织成组,并且提供容器间的负载均衡 很容易地升级应用程序容器的新版本 提供容器弹性,如果容器失效就替换它,等等... 容器作用:助力企业IT敏捷进化 阿里云容器服务亮点 和阿里云产品集成度高; 混合云支持能力强; 能够支持大规模集群; 自动化运维程度高; K8S和D

优秀的个人博客,低调大师

10分钟大数据Hadoop基础入门

前言 目前人工智能和大数据火热,使用的场景也越来越广,日常开发中前端同学也逐渐接触了更多与大数据相关的开发需求。因此对大数据知识也有必要进行一些学习理解。 基础概念 大数据的本质 一、数据的存储:分布式文件系统(分布式存储)二、数据的计算:分部署计算 基础知识 学习大数据需要具备Java知识基础及Linux知识基础 学习路线 (1)Java基础和Linux基础(2)Hadoop的学习:体系结构、原理、编程第一阶段:HDFS、MapReduce、HBase(NoSQL数据库)第二阶段:数据分析引擎 -> Hive、Pig 数据采集引擎 -> Sqoop、Flume第三阶段:HUE:Web管理工具 ZooKeeper:实现Hadoop的HAOozie:工作流引擎(3)Spark的学习 第一阶段:Scala编程语言 第二阶段:Spark Core

优秀的个人博客,低调大师

1分钟了解区块链的本质

区块链,比特币这些概念最近都很火,但很多人搞不清楚它究竟是啥,准备从技术的角度,从架构的角度,用通俗的语言谈谈楼主的理解。 究竟啥是区块链? 答:一句话,区块链是一个存储系统。 更细一点,区块链是一个没有管理员,每个节点都拥有全部数据的分布式存储系统。 通常所见的存储系统是啥样的? 答:如上图,一块空间存储数据,一个软件管理数据,提供接口写入数据,这是存储系统,例如mysql。 普通的存储系统会有什么常见的问题? 答:常见的有两个问题: 数据存在一个地方很危险,空间损坏数据就丢了,用技术的话说即“数据不高可用” 写入点只有一个,用技术的话说即“单点控制” 如何保证数据高可用? 答:解决高可用要“冗余”,如上图,如果能把数据冗余到多个地方,就能保证高可用,一个地方的数据挂了,另外的地方仍存有数据。例如mysql主从集群,以及磁盘的RAID都是这个

优秀的个人博客,低调大师

F# 20分钟快速上手(一)

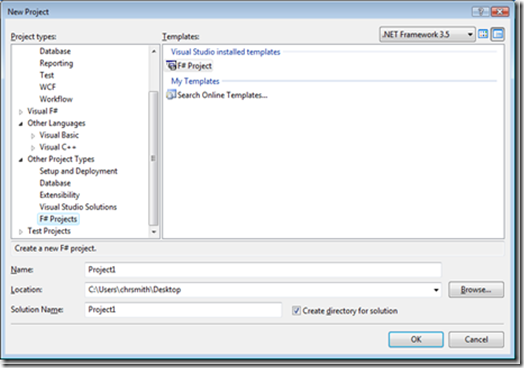
从Allen Lee的《从C# 3.0到F#》一文开始,感觉园子里F#正在升温。Chris Smith写了一个F#的小系列,这里翻译出来与大家分享。 第一篇,从零开始编写我们的第一个F#程序。 什么是F#,我为何要学它? F#是一种.NET平台上的函数式编程语言。就像C#和VB.NET,F#可以利用.NET的核心类库,如WPF,WCF,VSTO等等,通过F#您甚至可以使用XNA编写XBox游戏。 仅仅如此并不意味着您应该去学习它。那为何要使用F#呢?作为一种函数式编程语言,F#使得某些领域的编程要比命令式编程(如使用C#)更为容易。并行编程(Parallel Programming)和面向语言编程(Language-Oriented Programming)是其中的两个领域。 如果您曾经编写过.NET应用程序,并感觉自己在努力使用手头的语言表达自己的想法,也许F#就是您在寻找的。 上路 首先得下载(F#的最新版本1.9.4.19)和安装。安装程序会在VS2005和VS2008中安装F#的项目系统(项目模板和项模板)。先来创建一个新的F#项目。 然后添加一个新的F#源文件。默认条件下,新建的源文件包含了很多“教学”代码,全部删除,然后输入下面的代码: #light letsquarex = x * x letnumbers = [ 1 .. 10 ] letsquares = List.mapsquarenumbers printfn " N^2=%A " squares openSystem Console.ReadKey( true ) 按下F5运行程序,您会看到: 这些并没有太多让人兴奋的。我们来逐行的分析下代码,看看到底有什么不同之处,在此之前先介绍下VFSI。 Visual Studio中的F#交互(Interactive) F#交互控制台(F# Interactive Console, FSI)采用的是“REPL loop”模式,即Read-Evaluate-Print-Loop。也就是输入一段代码,编译并执行,然后输出结果。通过它您可以快速地开发和测试程序。要在VS中启用FSI,打开Add-in Manager窗口。 选中“F# Inactive for Visual Studio”。然后,选中程序的前两行代码: 接着按下Alt+Enter(实际上,如果FSI还么有打开,需要按两次Alt+Enter)。这时会看到出现了一个工具窗口: 我们刚才做的事情是将代码片段直接发送给FSI会话,FSI将结果输出。结果是函数“square”的定义,它接受int类型参数,返回类型也是int。 接下来在FSI窗口输入“List.map square [1 .. 2 .. 10];;”。“;;”是告诉FSI停止阅读程序,立即进行求值。 > List.mapsquare[ 1 .. 2 .. 10 ];; valit: int list = [ 1 ; 9 ; 25 ; 49 ; 81 ] 现在我们可以方便地通过FSI来学习F#了,马上来看看我们的程序究竟做了什么吧。不过仍建议您在VS源代码编辑器中输入代码,使用“Select(原文是Highlight,感觉Select更贴切) + Alt + Enter”将代码片段发送至FSI。 语言基础 #light(OCaml兼容) F#源自OCaml,具有交互编译OCaml的能力,也就是可以不经修改即可编译简单的OCaml程序。这种能力也带来了令人讨厌的语法。#light(发音为hash-light)是一个编译器指令,可以简化F#的语法。 强烈建议您保持使用#light,您会发现,在大多数F#代码片段中要么会声明它,要么是假定已经声明了它。 let square x = x * x(类型推演) 这行代码定义了一个函数:square,它会求得数字x的平方。考虑一下C#中等价的代码: public static int square( int x) { return x * x; } 在C#中,您需要制定参数和返回值的类型信息,而F#则帮您搞定了。这种行为称为类型推演(Type Inference)。 从函数的签名,F#可以知道“square”函数接受一个参数“x”,并且函数返回“x * x”(在函数体内的最后一次求值将作为返回值,因此无须return关键字)。因为很多基元类型都支持*操作,比如byte,uint64,double等,F#默认会使用int类型,有符号的32位整数。 现在考虑下面的代码,它为其中的一个参数提供了“类型注解(type annotation)”,告诉编译器期望的类型。因为x标为“string”,“+”操作只定义在两个string间,因此y也必须为string类型,返回值是两个字符串拼接的结果。 > letconcat(x: string )y = x + y;; valconcat: string -> string -> string > concat " Hello, " " World! " ;; valit: string = " Hello,World! " 后面我们将讨论类型推演的更多高级主题,现在您只要享受F#编译器的智能带来的方便就好了。 let numbers = [1 .. 10](F# lists) 这行代码声明了一个列表(list),其元素是从1至10。如果您用的是[|1 .. 10|],F#会创建一个.NET的整型数组(array)。而在F#中,列表是一个不可变的链表(linked list),这也是函数式编程的基础。试着将这些代码输入到FSI中(记住添加“;;”): // Definealist letvowels = [ ' e ' ; ' i ' ; ' o ' ; ' u ' ] // Attachitemtofront(cons) letcons = ' a ' ::vowels // Concattwolists letsometimes = vowels@[ ' y ' ] 我将在本系列的第二篇中更深入地介绍列表。 let squares = List.map square numbers 现在我们有了一个整型列表(numbers)和一个函数(square),我们希望创建一个新的列表,它的每一项是对numbers的每一项进行square运算后的结果。 幸运的是,List.map可以做到。考虑下面的例子: > List.map(funx -> x % 2 = 0 )[ 1 .. 10 ];; valit: bool list = [ false ; true ; false ; true ; false ; true ; false ; true ; false ; true ] 代码(fun x -> x % 2 = 0)定义了一个匿名函数,称为lamdba表达式,接受一个参数x,返回值为表达式“x % 2 = 0”的结果,也就是判断x是否为偶数。 注意我们刚才做的——将一个函数作为参数传递给另一个函数。在C#中这个并不容易。但在F#可以很清楚地表达出来,而且代码很简洁。将函数像值一样传递被称为“一等函数(first order functions)”,也是函数式编程的基础。 printfn "N^2 = %A" squares printf是打印文本到控制台窗口的一种简单而又类型安全的方式。要更好地了解printf,考虑下面的例子,它打印一个整数、浮点数和字符串。 > printfn " %d*%f=%s " 5 0.75 (( 5.0 * 0.75 ).ToString());; 5 * 0.750000 = 3.75 valit:unit = () %d,%f,%s分别是int、float、string的占位符。%A则可用于打印任何值。 Console.ReadKey(true) (.NET互操作) 我们程序的最后一行只是简单地调用了System.Console.ReadKey方法,这样可以让程序在关闭其暂停。因为F#建立在.NET的基础上,您可以在F#中调用任何.NET类库——从正则表达式到WinForms。代码“open System”用于打开命名空间,类似于C#中的using。 现在我们已经有了F#的基础知识,可以继续学习更有趣的基础类型和F#概念了,希望您关注第二篇文章! 原文链接:http://blogs.msdn.com/chrsmith/archive/2008/05/02/f-in-20-minutes-part-i.aspx。 本文转自一个程序员的自省博客园博客,原文链接:http://www.cnblogs.com/anderslly/archive/2008/08/03/fs-in-20-minutes.html,如需转载请自行联系原作者。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册