首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

Python-OpenCV学习(七)边界框、最小矩形区域和最小闭圆的轮廓:

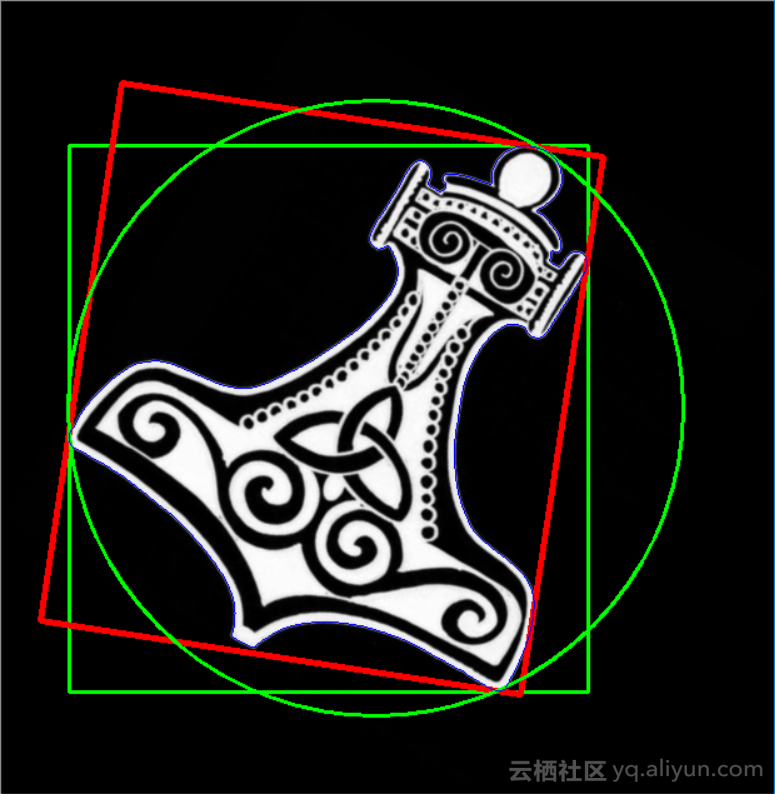
边界框、最小矩形区域和最小闭圆的轮廓:找到一个正方形轮廓很简单 找不规则的、歪斜的以及旋转的形状可用OpencV的cv2.findContours函数。 import cv2 import numpy as np img = cv2.pyrDown(cv2.imread("hammer.jpg", cv2.IMREAD_UNCHANGED)) ret, thresh = cv2.threshold(cv2.cvtColor(img.copy(), cv2.COLOR_BGR2GRAY) , 127, 255, cv2.THRESH_BINARY) image, contours, hier = cv2.findContours(thresh, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE) for c in contours: # find bounding box coordinates x,y,w,h = cv2.boundingRect(c) cv2.rectangle(img, (x,y), (x+w, y+h), (0, 255, 0), 2) # find minimum area rect = cv2.minAreaRect(c) # calculate coordinates of the minimum area rectangle box = cv2.boxPoints(rect) # normalize coordinates to integers box = np.int0(box) # draw contours cv2.drawContours(img, [box], 0, (0,0, 255), 3) # calculate center and radius of minimum enclosing circle (x,y),radius = cv2.minEnclosingCircle(c) # cast to integers center = (int(x),int(y)) radius = int(radius) # draw the circle img = cv2.circle(img,center,radius,(0,255,0),2) cv2.drawContours(img, contours, -1, (255, 0, 0), 1) cv2.imshow("contours", img) cv2.waitKey() cv2.destroyAllWindows() 结果:加载图片后先进行阈值处理,由于原图为黑白图片所以阈值较为简单计算简单的边界框: x,y,w,h=cv2.boundingRect(c) 转化为框的坐标及宽度,再画出框: cv.rectangle(img,(x,y),(x+w,y+h),(0,255,0),2) 第二步计算出包围最小的矩形区域 rect = cv2.minAreaRect(c) # calculate coordinates of the minimum area rectangle box = cv2.boxPoints(rect) # normalize coordinates to integers box = np.int0(box) 注意计算所得的顶点坐标为浮点型的,像素坐标必须为整数,所以必须做一个转换,然后画出这个矩形,可以用cv2.drawContours函数来: cv2.drawContours(img,[box],0,(0,0,255),3) 该函数的第二个参数接收一个保存着轮廓的数组,从而可以在一次操作中绘制一系列轮廓。第三个参数为所要绘制的轮廓的索引,-1为绘制所有的轮廓,否则只会绘制轮廓组中指定的轮廓最后检查的边界轮廓为最小闭圆: (x,y),radius = cv2.minEnclosingCircle(c) # cast to integers center = (int(x),int(y)) radius = int(radius) cv2.minEnclosingCircle函数会返回一个二元组,第一个元素为圆心坐标组成的元组,第二个元素为圆的半径值。

优秀的个人博客,低调大师

python3.6抓取出现TypeError: cannot use a string pattern on a bytes-like ob...

import reimport requestsfrom requests.exceptions import RequestExceptionimport jsondef get_one_page(url):try: response = requests.get(url)if response.status_code == 200:return response.contentreturn None except RequestException:return Nonedef parse_page_html(html): pattern = re.compile('<dd>.*?board-index.*?>(\d+)</i>.*?data-src="(.*?)".*?name"><a'+ '.*?>(.*?)</a>.*?star">(.*?)</p>.*?releasetime">(.*?)</p>'+ '.*?integer">(.*?)</i>.*?fraction">(.*?)</i>.*?</dd>', re.S) items = re.findall(pattern, html)for item in items:yield {'index':item[0],'image':item[1],'title':item[2],'actor':item[3].strip()[3:],'time':item[4].strip()[5:],'score':item[5]+item[6] }def write_to_file(content):with open('result.txt','a',encoding='utf-8') as f: f.write(json.dumps(content,ensure_ascii=False)+'\n') f.close()def main(): url = 'http://maoyan.com/board/4?' html = get_one_page(url)for item in parse_page_html(html): write_to_file(item)if __name__ == '__main__': main() 如果没有以上红色代码,会出现TypeError: cannot use a string pattern on a bytes-like object,只需要加上html = html.decode('utf-8')即可

优秀的个人博客,低调大师

学习了《python网络爬虫实战》第一个爬虫,爬取新浪新闻

请安装anaconda,其中附带的spyder方便运行完查看变量 1.进入cmd控制台, 输入 pip install BeautifulSoup4 pip install requests 2.编写代码,代码已经很清晰了,直接运行不会报错并有成功的结果 def getNewsDetail(newsUrl): import requests from bs4 import BeautifulSoup from datetime import datetime newsWeb = requests.get(newsUrl) newsWeb.encoding = 'utf-8' soup = BeautifulSoup(newsWeb.text,'lxml') result = {} result['title'] = soup.select('.main-title')[0].text result['newsSource'] = soup.select('.source')[0].text timeSource = soup.select('.date')[0].text result['datetime'] = datetime.strptime(timeSource,'%Y年%m月%d日 %H:%M') result['article'] = soup.select('.article')[0].text result['editor'] = soup.select('.show_author')[0].text.strip('责任编辑:') result['comment'] = soup.select('.num')[0].text return result def parseListLinks(url): import requests import json newsDetails = [] request = requests.get(url) jsonLoad = json.loads(request.text.lstrip(' newsloadercallback(').rstrip(');')) newsUrls = [] for item in jsonLoad['result']['data']: newsUrls.append(item['url']) for url in newsUrls: newsDetails.append(getNewsDetail(url)) return newsDetails if __name__ == '__main__': #获取单个新闻页面的信息 newsUrl = 'http://news.sina.com.cn/s/wh/2018-01-08/doc-ifyqkarr7830426.shtml' newsDetail = getNewsDetail(newsUrl) #获取整个列表各个新闻页面的信息 rollUrl='http://api.roll.news.sina.com.cn/zt_list?channel=news&cat_1=gnxw\ &cat_2==gdxw1||=gatxw||=zs-pl||=mtjj&level==1||=2&show_ext=1&show_all=1&\ show_num=22&tag=1&format=json&page=23&callback=newsloadercallback&_=1515911333929' newsDetails = parseListLinks(rollUrl)

优秀的个人博客,低调大师

gunicorn django nginx多站点 pyvenv virutalvenv python 3 django 2这些限制下,如何让...

昨天测试的是uwsgi, 为了能运行在alphine的docker上面, (听说uwsgi正在改进不是基于于gcc库的应用), 改进一下gunicorn的配置,来实现跟昨天同样的多站点配置。 其实,在配置gunicorn时,它本身的配置不用变, 只要更改nginx为其增加多一级目录即可。 gunicorn.conf bind = "0.0.0.0:9090" workers = 12 #workers是工作线程数,一般设置成:2 * 服务器CPU个数 + 1 errorlog = '/var/log/xxx/gunicorn.error.log' accesslog = '/var/log/xxx/gunicorn.access.log' #loglevel = 'debug' #proc_name = 'gunicorn_xxx' nginx.conf upstream xxx_host { server ip:9090; } server { listen 80; server_name localhost; location /prism/ { # include uwsgi_params; #注释这两行为uwsgi # uwsgi_pass xxx_host; #多目录实现在uwsgi配置 proxy_pass http://xxx_host; #注意有http哟 proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_set_header Host $http_host; proxy_set_header SCRIPT_NAME /xxx; #这种就可以凭空多一级目录 proxy_set_header REMOTE_USER $remote_user; proxy_set_header X-Forwarded-Proto $scheme; client_max_body_size 1000m; client_body_timeout 5m; proxy_connect_timeout 5m; proxy_read_timeout 5m; proxy_send_timeout 5m; } } 以如下方式运行,指定配置文个,wsgi文件位置,优化速度时,可以考虑用-k指定运行模式( gevent, gaihttp,pthread,torado....): gunicorn -c gunicorn.conf settings.wsgi

优秀的个人博客,低调大师

[Spark][python]从 web log 中提取出 UserID 作为key 值,形成新的 RDD

针对RDD, 使用 keyBy 来构筑 key-line 对: [training@localhost ~]$ cat webs.log 56.31.230.188 - 90700 "GET/KDDOC-00101.html HTTP/1.0" 56.32.230.186 - 90700 "GET/contents.css HTTP/1.0" 202.156.27.99 - 25223 "GET /KDDOC-00220.html HTTP/1.0" [training@localhost ~]$ [training@localhost ~]$ hdfs dfs -put webs.log [training@localhost ~]$ [training@localhost ~]$ hdfs dfs -cat webs.log 56.31.230.188 - 90700 "GET/KDDOC-00101.html HTTP/1.0" 56.32.230.186 - 90700 "GET/contents.css HTTP/1.0" 202.156.27.99 - 25223 "GET /KDDOC-00220.html HTTP/1.0" [training@localhost ~]$ [training@localhost ~]$ In [23]: mylogs = sc.textFile("webs.log") In [25]: mylogs001 = mylogs.keyBy(lambda line: line.split(' ')[2]) In [26]: mylogs001.take(1) Out[26]: [(u'90700', u'56.31.230.188 - 90700 "GET/KDDOC-00101.html HTTP/1.0"')] In [28]: mylogs001.take(2) Out[28]: [(u'90700', u'56.31.230.188 - 90700 "GET/KDDOC-00101.html HTTP/1.0"'), (u'90700', u'56.32.230.186 - 90700 "GET/contents.css HTTP/1.0"')] 作一个对比,看看 mylogs001.take(3) 和 mylogs.take(3) In [30]: mylogs001.take(3) Out[30]: [(u'90700', u'56.31.230.188 - 90700 "GET/KDDOC-00101.html HTTP/1.0"'), (u'90700', u'56.32.230.186 - 90700 "GET/contents.css HTTP/1.0"'), (u'25223', u'202.156.27.99 - 25223 "GET /KDDOC-00220.html HTTP/1.0"')] In [31]: mylogs.take(3) Out[31]: [u'56.31.230.188 - 90700 "GET/KDDOC-00101.html HTTP/1.0"', u'56.32.230.186 - 90700 "GET/contents.css HTTP/1.0"', u'202.156.27.99 - 25223 "GET /KDDOC-00220.html HTTP/1.0"'] 本文转自健哥的数据花园博客园博客,原文链接:http://www.cnblogs.com/gaojian/p/008-Aggregating-Data-with-Pair-RDDs-keyBy.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

马哥2016全新Linux+Python高端运维班第四周作业

1、复制/etc/skel目录为/home/tuser1,要求/home/tuser1及其内部文件的属组和其它用户均没有任何访问权限。 2、编辑/etc/group文件,添加组hadoop。 #echo"hadoop:x:1003:">>/etc/group 3、手动编辑/etc/passwd文件新增一行,添加用户hadoop,其基本组ID为hadoop组的id号;其家目录为/home/hadoop。 #echo"hadoop:x:1003:1003:hadoop:/home/hadoop:/bin/bash">>/etc/passwd 4、复制/etc/skel目录为/home/hadoop,要求修改hadoop目录的属组和其它用户没有任何访问权限。 5、修改/home/hadoop目录及其内部所有文件的属主为hadoop,属组为hadoop。 6、显示/proc/meminfo文件中以大写或小写S开头的行;用两种方式; #grep-i‘^s‘/proc/meminfo #grep‘^[Ss]‘/proc/meminfo 7、显示/etc/passw d文件中其默认shell为非/sbin/nologin的用户; 8、显示/etc/passwd文件中其默认shell为/bin/bash的用户; # grep ‘/bin/bash‘ /etc/passwd | cut -d: -f1 9、找出/etc/passwd文件中的一位数或两位数; # grep -o ‘\b[0-9]\{1,2\}\b‘ /etc/passwd 10、显示/boot/grub/grub.conf中以至少一个空白字符开头的行; #egrep‘^[[:space:]]+‘/boot/grub/grub.conf 11、显示/etc/rc.d/rc.sysinit文件中以#开头,后面跟至少一个空白字符,而后又有至少一个非空白字符的行; #egrep‘^#[[:space:]]+[^[:space:]]+‘/etc/rc.d/rc.sysinit 12、打出netstat -tan命令执行结果中以‘LISTEN’,后或跟空白字符结尾的行; #netstat-tan|egrep‘LISTEN[[:space:]]*$‘ 13、添加用户bash, testbash, basher, nologin (此用户的shell为/sbin/nologin),而后找出当前系统上其用户名和默认shell相同的用户的信息; # useradd bash && useradd testbash && useradd basher && useradd -s /sbin/nologin nologin awk -F‘[:/]‘ ‘$1==$NF{print $0}‘ /etc/passwd 本文转自xinrenbaodao 51CTO博客,原文链接http://blog.51cto.com/11832904/1844068:,如需转载请自行联系原作者

优秀的个人博客,低调大师

马哥2016全新Linux+Python高端运维班第三周作业

1、列出当前系统上所有已经登录的用户的用户名,注意:同一个用户登录多次,则只显示一次即可。 w命令用于显示已经登录系统的用户的名称,以及他们正在做的事。该命令所使用的信息来源于/var/run/utmp文件。w命令输出的信息包括: 用户名称 用户的机器名称或tty号 远程主机地址 用户登录系统的时间 空闲时间(作用不大) 附加到tty(终端)的进程所用的时间(JCPU时间) 当前进程所用时间(PCPU时间) 用户当前正在使用的命令 w命令还可以使用以下选项 -h忽略头文件信息 -u显示结果的加载时间 -s不显示JCPU, PCPU, 登录时间 2、取出最后登录到当前系统的用户的相关信息。 3、取出当前系统上被用户当作其默认shell的最多的那个shell。 4、将/etc/passw d 中的第三个字段数值最大的后10个用户的信息全部改为大写后保存至/tmp/maxusers.txt文件中。 #sort-t:-k3-n-r/etc/passwd|head-10|tr'a-z''A-Z'|tee/tmp/maxuser.txt 5、取出当前主机的IP地址,提示:对ifconfig命令的结果进行切分。 #ifconfig|grep'inet\b'|awk'{print$2}'|cut-d:-f2 6、列出/etc目录下所有以.conf结尾的文件的文件名,并将其名字转换为大写后保存至/tmp/etc.conf文件中。 #ls/etc/*.conf|tr'a-z''A-Z'|tee/tmp/etc.conf 7、显示/var目录下一级子目录或文件的总个数。 #ls/var/|wc-l 8、取出/etc/group文件中第三个字段数值最小的10个组的名字。 #sort-t:-k3-n/etc/group|head-10|cut-d:-f1 9、将/etc/fstab和/etc/issue文件的内容合并为同一个内容后保存至/tmp/etc.test文件中。 #cat/etc/{fstab,issue}|tee/tmp/etc.test 10、请总结描述用户和组管理类命令的使用方法并完成以下练习: Linux用户的组相关的配置文件有4个: /etc/passwd:保存用户及其属性信息 各字段的含义root:x:0:0:root:/root:/bin/bash用户名:密码点位符:UID:GID:注释信息:家目录:用户默认shell /etc/group:组及其属性信息 各字段的含义:root:x:0:root 组名:组密码点位符:GID:以逗号分隔的属于此组的用户列表 /etc/shadow:用户密码及其相关属性 各字段的含义:root:$1$mq0Q9ij0$Mjtq5caVkiBPd5PVBFLNp0:16521:0:99999:7::: 用户名:加密了的密码:最近一次更改密码的日期:密码的最小使用期限:最大密码使用期限:密码禁用期:账户过期日期:保留字段; /etc/gshadow:组密码及其相关属性; 用户和组相关的管理命令: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 useradd :创建用户 -u:指定UID -g:指定GID -c:用户的注释信息 -d:指定用户的家目录 -s:指定用户的默认shell程序 -G:指定用户的附加组 -r:创建系统用户 groupadd:创建组 -g:指明GID -r:创建系统组 usermod :用户属性修改 -u:新UID -g:新GID -G:新附加组,原来的附加组会被覆盖;若保留原有,则要同时使用-a选项,表示append -s:新的默认shell -c:新的注释信息 -d:新的家目录;原有家目录中的文件不会同时移动至新的家目录,若要移动,则同时使用-m选项 -l:新的名字 -L:锁定指定用户 -U:解锁指定用户 passwd :更改密码 --stdin:可不通过交互方式更改密码 userdel:删除用户 -r:删除用户家目录 groupmod:组属性修改 -n:新的组名 -g:新的GID groupdel:组删除 gpasswd:组密码 -auser:将user添加至指定组 -duser:删除用户user的以当前组为组名的附加组 -Auser1,user2,...:设置有管理权限的用户列表 (1)、创建组distro,其GID为2016; #groupadd-g2016distro (2)、创建用户mandriva, 其ID号为1005;基本组为distro; 1 #useradd-u1005-gdistromandriva (3)、创建用户mageia,其ID号为1100,家目录为/home/linux; #useradd-u1100-d/home/linuxmageia (4)、给用户mageia添加密码,密码为mageedu; #echomageedu|passwd--stdinmageia (5)、删除mandriva,但保留其家目录; #userdelmandriva (6)、创建用户slackware,其ID号为2002,基本组为distro,附加组peguin; (7)、修改slackware的默认shell为/bin/tcsh; #usermod-s/bin/tcshslackware (8)、为用户slackware新增附加组admins; (9)、为slackware添加密码,且要求密码最短使用期限为3天,最长为180天,警告为3天; #echoslack123|passwd-n3-x180-w3--stdinslackware (10)、添加用户openstack,其ID号为3003, 基本组为clouds,附加组为peguin和nova; (11)、添加系统用户mysql,要求其shell为/sbin/nologin; (12)、使用echo命令,非交互式为openstack添加密码。 # echo 123456 | passwd --stdin openstack 本文转自xinrenbaodao 51CTO博客,原文链接:http://blog.51cto.com/11832904/1840778,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册