首页 文章 精选 留言 我的

精选列表

搜索[orm框架],共10000篇文章
优秀的个人博客,低调大师

sqltoy-orm 5.2.63 发版,是时候跟 mybatis 告别了!

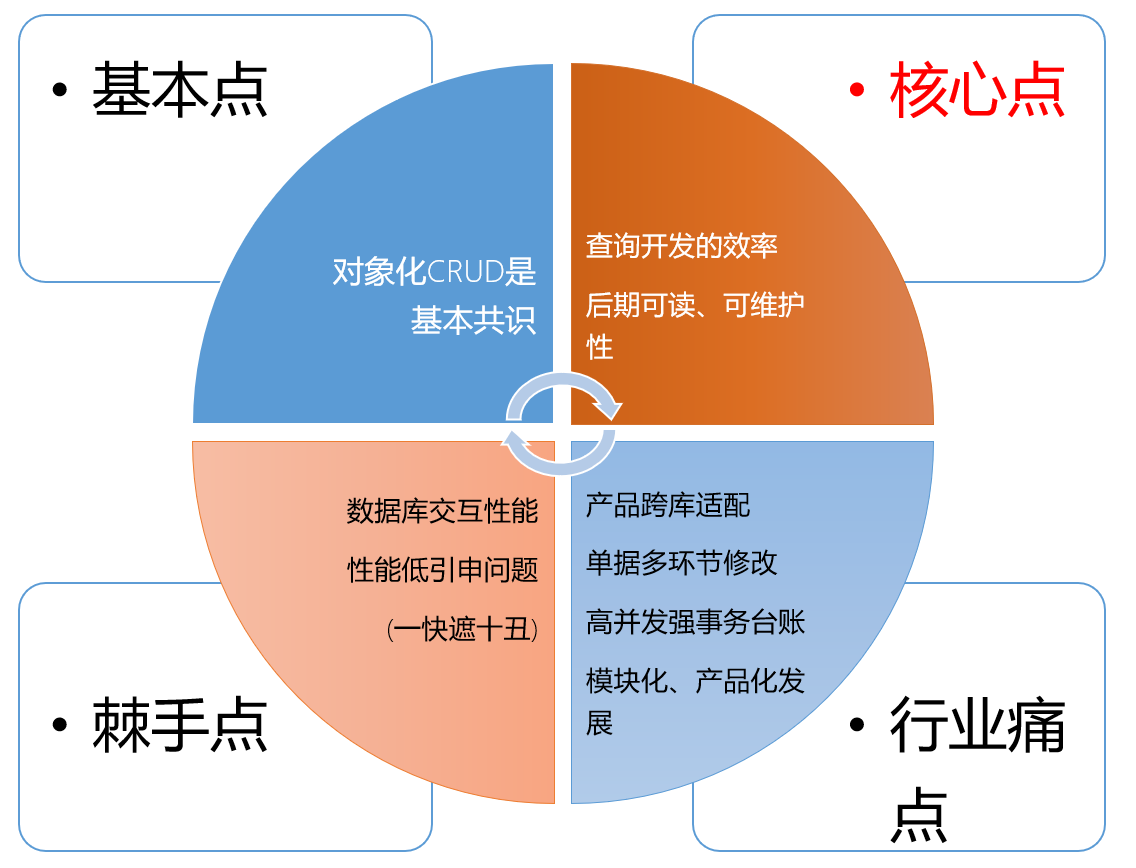
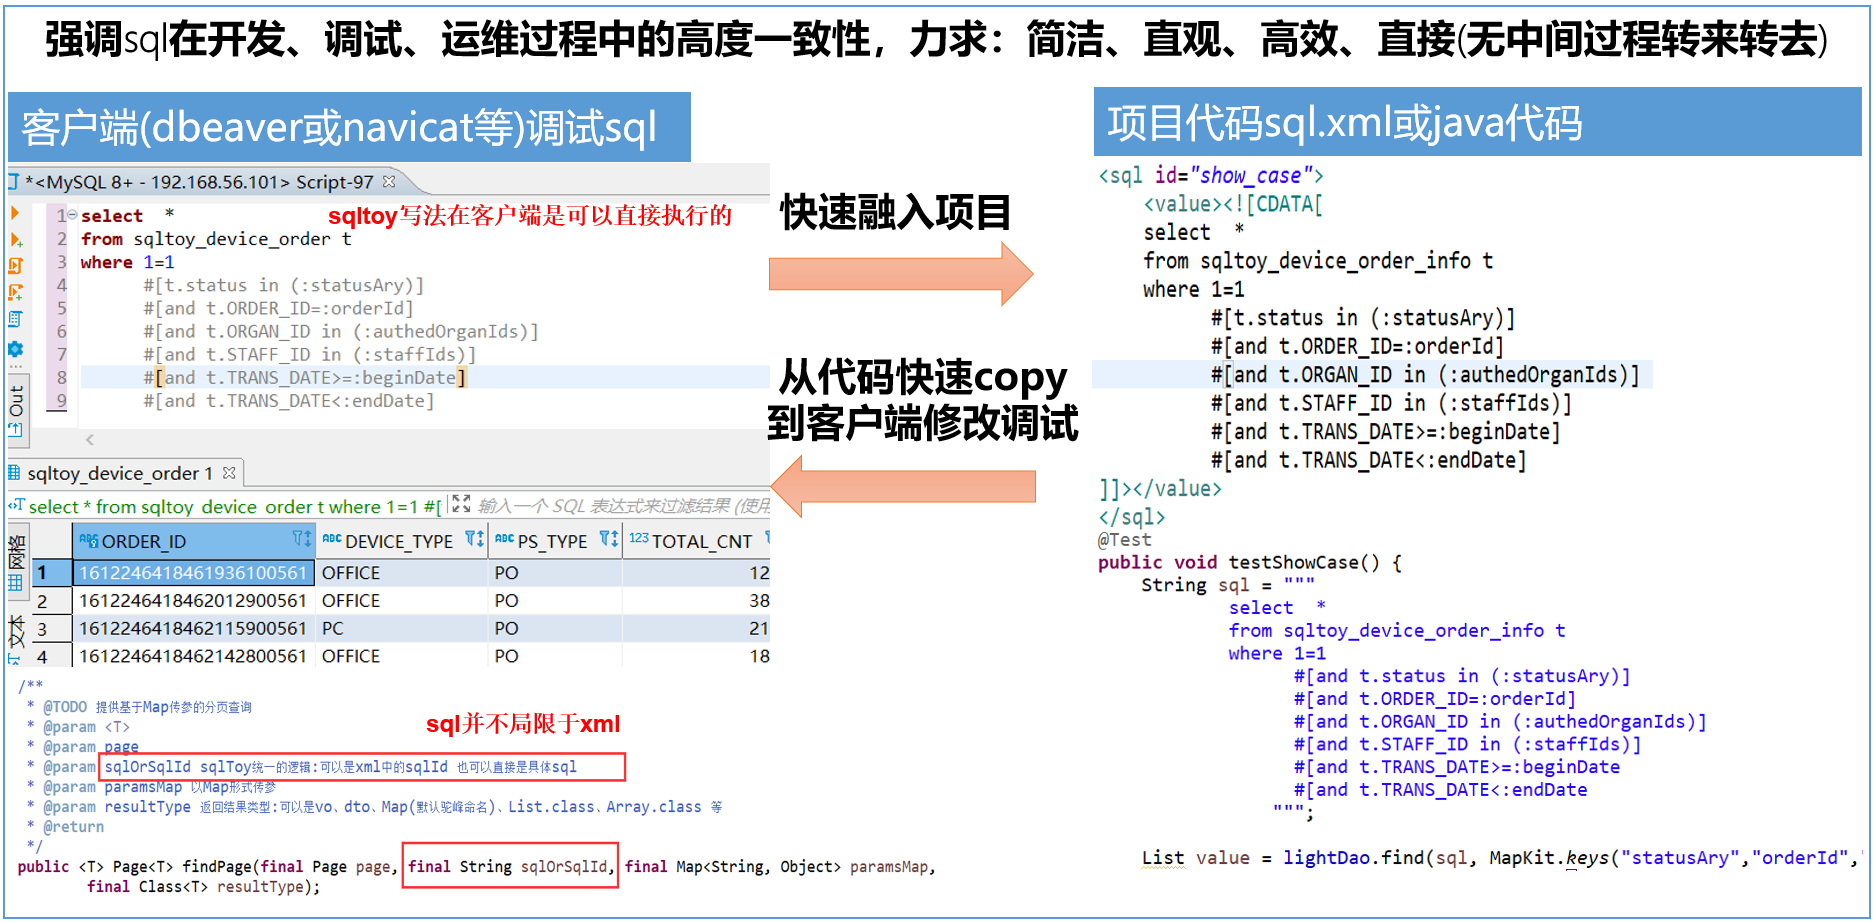
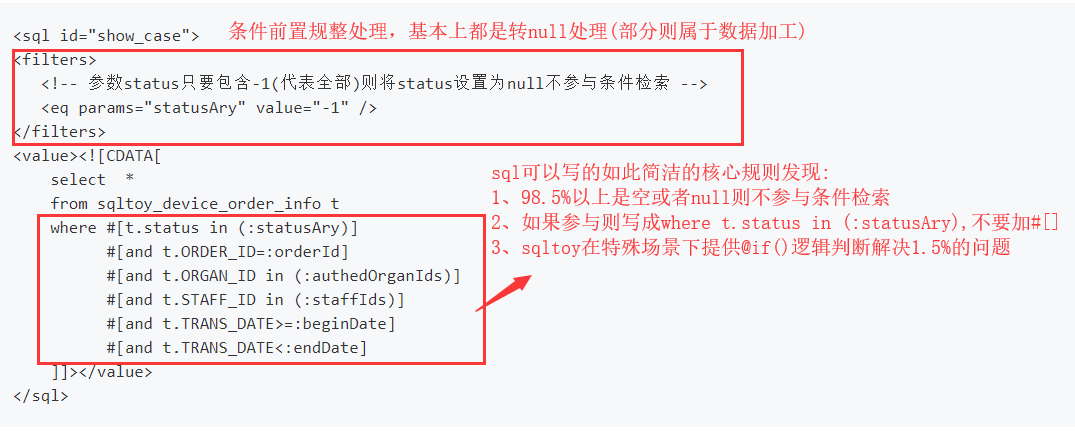
为什么选择mybatis?自由的sql?假设其他一切对等,sqltoy的sql写法是否可以否定掉mybatis的写法? 开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/threefish/sqltoy-idea-plugins sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、支持itemList[0].fieldName或itemList[0].item.name 形式传参 2、在@include(sqlId)基础上扩展支持@include(:scriptParam)动态sql,便于动态传递sql片段 String sql="select * from sqltoy_fruit_order where status=:status @include(:sqlScript)"; result = lightDao.find(sql,MapKit.keys("status", "saleCount", "sqlScript").values(1, 12, "and sale_count>:saleCount")); sqltoy 的关键优势: //------------------了解 sqltoy的关键优势: -------------------------------------------------------------------------------------------*/ //1、最简最直观的sql编写方式(不仅仅是查询语句),采用条件参数前置处理规整法,让sql语句部分跟客户端保持高度一致 //2、sql中支持注释(规避了对hint特性的影响,知道hint吗?搜oracle hint),和动态更新加载,便于开发和后期维护整个过程的管理 //3、支持缓存翻译和反向缓存条件检索(通过缓存将名称匹配成精确的key),实现sql简化和性能大幅提升 //4、支持快速分页和分页优化功能,实现分页最高级别的优化,同时还考虑到了cte多个with as情况下的优化支持 //5、支持并行查询 //6、根本杜绝sql注入问题 //7、支持行列转换、分组汇总求平均、同比环比计算,在于用算法解决复杂sql,同时也解决了sql跨数据库问题 //8、支持保留字自动适配 //9、支持跨数据库函数自适配,从而非常有利于一套代码适应多种数据库便于产品化,比如oracle的nvl,当sql在mysql环境执行时自动替换为ifnull //10、支持分库分表 //11、提供了取top、取random记录、树形表结构构造和递归查询支持、updateFetch单次交互完成修改和查询等实用的功能 //12、sqltoy的update、save、saveAll、load 等crud操作规避了jpa的缺陷,参见update(entity,String...forceUpdateProps)和updateFetch //13、提供了极为人性化的条件处理:排它性条件、日期条件加减和提取月末月初处理等 //14、提供了查询结果日期、数字格式化、安全脱敏处理,让复杂的事情变得简单,大幅简化sql或结果的二次处理工作 //-----------------------------------------------------------------------------------*/ sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

sqltoy-orm-4.17.5 发布,支持 QueryExecutor 中定义分库分表

开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件(可直接在idea中检索安装):https://github.com/threefish/sqltoy-idea-plugins 更新内容 1、 支持QueryExecutor、EntityQuery中使用分库分表策略配置 (原本只支持xml中定义) //分库 dbSharding(String strategy, String... paramNames) //分表 tableSharding(String strategy, String[] tables, String... paramNames) sqltoy的十四个关键特点: 1、最简最直观的sql编写方式(不仅仅是查询语句),采用条件参数前置处理规整法,让sql语句部分跟客户端保持高度一致 2、sql中支持注释(规避了对hint特性的影响,知道hint吗?搜oracle hint),和动态更新加载,便于开发和后期维护整个过程的管理 3、支持缓存翻译和反向缓存条件检索(通过缓存将名称匹配成精确的key),实现sql简化和性能大幅提升 4、支持快速分页和分页优化功能,实现分页最高级别的优化,同时还考虑到了cte多个with as情况下的优化支持 5、支持并行查询 6、根本杜绝sql注入问题,以后不需要讨论这个话题 7、支持行列转换、分组汇总求平均、同比环比计算,在于用算法解决复杂sql,同时也解决了sql跨数据库问题 8、支持保留字自动适配 9、支持跨数据库函数自适配,从而非常有利于一套代码适应多种数据库便于产品化,比如oracle的nvl,当sql在mysql环境执行时自动替换为ifnull 10、支持分库分表 11、提供了取top、取random记录、树形表结构构造和递归查询支持、updateFetch单次交互完成修改和查询等实用的功能 12、sqltoy的update、save、saveAll、load 等crud操作规避了hibernate jpa的缺陷,可以深入对比update/updateAll、saveOrUpdate/saveOrUpdateAll内部差异 13、提供了极为人性化的条件处理:排它性条件、日期条件加减和提取月末月初处理等 14、提供了查询结果日期、数字格式化、安全脱敏处理,让复杂的事情变得简单,大幅简化sql或结果的二次处理工作 sqltoy的crud:了解hibernate jpa吧?原理一致,但在update等一些功能上更加细致 StaffInfoVO staffInfo = new StaffInfoVO(); staffInfo.setStaffId("S2007").setStaffName("测试员工9"); //保存 sqlToyLazyDao.save(staffInfo); //保持或修改 sqlToyLazyDao.saveOrUpdate(staffInfo); //针对照片属性强制更新 sqlToyLazyDao.update(staffInfo, "photo"); //加载 sqlToyLazyDao.load(new StaffInfoVO("S2007")) //删除 sqlToyLazyDao.delete(new StaffInfoVO("S2007")) 简要介绍一下sqltoy的几个特点 sqltoy提供了最简洁的动态sql编写 我们对比一下mybatis的实现(从可阅读、可维护等视角看): 缓存翻译,利用缓存减少关联查询,简化sql同时大幅提升效率 极致分页优化 并行查询 // 使用并行查询同时执行2个sql,条件参数是2个查询的合集 String[] paramNames = new String[] { "userId", "defaultRoles", "deployId", "authObjType" }; Object[] paramValues = new Object[] { userId, defaultRoles, DEPLOY_ID,GROUP }; List<QueryResult<TreeModel>> list = super.parallQuery( Arrays.asList(ParallQuery.create().sql("webframe_searchAllModuleMenus").resultType(TreeModel.class), ParallQuery.create().sql("webframe_searchAllUserReports").resultType(TreeModel.class)), paramNames, paramValues); 数据旋转 无限极分组统计(含汇总求平均),算法配置简单又跨数据库! 同比环比

优秀的个人博客,低调大师

jSqlBox 4.0.8 发布,在 Java 里直接写 SQL 的 ORM 工具

jSqlBox主要特点是架构优、尺寸小、功能全,基本上所有与数据库操作相关的功能,jSqlBox都已提供。它的主要特点有: 1.内核基于DbUtils并与之兼容。 2.提倡在java里拼写SQL,独创参数内嵌式SQL写法, 而且任意CRUD方法里都可以混插SQl片段,例如: new Demo().setName("张三").insert().putField("age", 15).update(" and name=?", param("李四"), " or age>? ",param(20)); 3.只有单个1M大小的jar包,不依赖任何第三方库,不依赖Spring。 4.支持分库分表、声明式事务、分布式事务,缓存翻译。 5.支持80多种数据库方言,支持DDL生成、实体或数据库结构导出Excel,分页、函数变换、实体源码生成。 6.学习成本低,兼容主要的实体JPA注解。 在Java中直接写SQL是jSqlBox的主要特点之一,可能有人问XML或其它模板方式写SQL不香吗? 是的,用XML之类的模板有以下几个缺点: 1. 需要与插件配合才可以定位SQL,而且通常不支持SQL标记符的重构。 2. XML中的占位符,在实际调用时是需要赋值的,这相当于又重复敲了一遍代码。很多人一看模板方式写SQL很简洁,但不要忘记了,模板是需要赋值的,赋值语句也是要占用源码行数的,一旦变量名变动,需要同时在模板和赋值语句两处修改。 3. XML 之类的模板如果要写自定义函数很困难,而使用Java则没有这个问题。 4. XML需要单独的文件存放,而且如果要在前端直接写SQL,则XML文件没法保存。(参见本人GoSqlGo项目) 本次(jSqlBox4.0.8.jre8)更新内容: 把实体结构或数据库结构导出到Excel中 1.实体结构导出 以下语句会扫描指定包domain,把此包下的所有实体类的结构输出为Excel的CSV格式: TableModelUtils.entityPackage2Excel("com.abc.domain", "d:/packageOutput.csv"); 也可以指定具体的实体类导出,如: TableModelUtils.entity2Excel("d:/entitiesOutput.csv", User.class, Customer.class, Order.class); 以下为导出的Excel示例: 2.将数据库结构导出为Excel的CSV格式,第二个参数为方言类型: @Autowired DataSource ds; TableModelUtils.db2Excel(ds.getConnection(), Dialect.MySQL57Dialect, "d:/dbOutput.csv"); 以下是导出的Excel示例: 导出Excel功能目前只有固定的这几个方法。如果有不同格式、语言的导出需求,可以参照jSqlBox中的TableModelUtilsOfExcel.java源码写一个你自已的工具类即可,TableModelUtilsOfExcel.java这个工具类只有168行源码,相信在这个基础上你可以很快写出你想要的Excel输出工具来。 导出Excel有专用的工具或专门的项目,为什么jSqlBox要开发这个功能?不为别的,只因为jSqlBox能做到,从架构上jSqlBox内含了jDialects方言子项目,能轻而易举实现导出Excel这个功能,这个是早就有的打算,源码中早就注明了会有这个功能,不是为了跟风。

优秀的个人博客,低调大师

比 mybatis 强大优雅的 sqltoy-orm-4.10.5 发版了

开源项目地址: https://github.com/chenrenfei/sagacity-sqltoy 感受sqltoy之美: https://chenrenfei.github.io/sqltoy/#/ 更新内容: 1、缓存翻译对应的缓存更新机制增加增量更新 2、查询结果计算增加环比计算,请参见sqltoy-showcase下的QueryCaseTest类 sqltoy的代表性特性展示: 1、最优雅的sql编写模式 mybatis的写法(一板一眼很工程化) select * from sqltoy_device_order_info t <where> <if test="orderId!=null"> and t.ORDER_ID=#{orderId} </if> <if test="authedOrganIds!=null"> and t.ORGAN_ID in <foreach collection="authedOrganIds" item="order_id" separator="," open="(" close=")"> #{order_id} </foreach> </if> <if test="staffIds!=null"> and t.STAFF_ID in <foreach collection="staffIds" item="staff_id" separator="," open="(" close=")"> #{staff_id} </foreach> </if> <if test="beginDate!=null"> and t.TRANS_DATE>=#{beginDate} </if> <if test="endDate!=null"> and t.TRANS_DATE<#{endDate} </if> </where> sqltoy的写法: select * from sqltoy_device_order_info t where #[t.ORDER_ID=:orderId] #[and t.ORGAN_ID in (:authedOrganIds)] #[and t.STAFF_ID in (:staffIds)] #[and t.TRANS_DATE>=:beginDate] #[and t.TRANS_DATE<:endDate] 2、最具特色的缓存翻译和缓存条件检索,让复杂查询最接近单表查询 1. 感受sqltoy之美--缓存翻译、缓存条件检索 缓存翻译和缓存检索化繁为简---查询订单表(简化为单商品订单便于演示) 订单号 客户ID 商品ID 下单日期 商品数量 商品价格 订单金额 订单状态 业务员ID 部门 S0001 C10001 101 2020-03-10 10 3000 30000 02 1001 N002 要求查询日期在2020年1月10日至3月20日、客户名称中含<<星云科技>>字符的全部订单信息,要求显示商品名称、客户名称、业务员姓名、部门名称、订单状态中文 往常的做法:硬功夫硬碰硬系列 关联客户表做like 关联商品表查询品名 关联员工信息表显示员工名字 关联机构表显示机构名称 关联数据字典翻译状态 你是这么做的吗?看一下sqltoy怎么做吧!是不是变成了单表查询,效率毫无疑问秒杀多表关联无数倍! <sql id="order_showcase"> <!-- 通过缓存对最终结果代码进行翻译,显示名称 --> <translate cache="organIdName" columns="ORGAN_NAME" /> <translate cache="staffIdName" columns="STAFF_NAME" /> <translate cache="goodsIdName" columns="GOODS_NAME" /> <translate cache="customIdName" columns="CUSTOM_NAME" /> <translate cache="dictKeyName" cache-type="ORDER_STATUS" columns="STATUS_NAME" /> <filters> <!-- 将查询参数customName通过缓存进行类似like检索获取匹配的customId数组作为查询条件 --> <cache-arg cache-name="customIdName" param="customName" alias-name="customIds" /> </filters> <value> <![CDATA[ select ORDER_ID , TOTAL_QUANTITY, TOTAL_AMT, ORGAN_ID , ORGAN_ID ORGAN_NAME,-- 缓存翻译 STAFF_ID , STAFF_ID STAFF_NAME, SIGN_TIME, CUSTOM_ID, CUSTOM_ID CUSTOM_NAME, GOODS_ID , GOODS_ID GOODS_NAME, STATUS, STATUS STATUS_NAME from od_order_info t1 where #[SIGN_TIME>=:beginTime] #[and SIGN_TIME <=:endTime] -- 这里就是缓存条件检索 #[and CUSTOM_ID in (:customIds)] ]]> </value> </sql> 3、最高层级的分页查询优化:@fast 实现先分页后关联,page-optimize 将分页2次查询变成1.4次查询。 <!-- 快速分页和分页优化演示 --> <sql id="sqltoy_fastPage"> <!-- 分页优化器,通过缓存实现查询条件一致的情况下在一定时间周期内缓存总记录数量,从而无需每次查询总记录数量 --> <!-- alive-max:最大存放多少个不同查询条件的总记录量; alive-seconds:查询条件记录量存活时长(比如120秒,超过阀值则重新查询) --> <page-optimize alive-max="100" alive-seconds="120" /> <value> <![CDATA[ select t1.*,t2.ORGAN_NAME -- @fast() 实现先分页取10条(具体数量由pageSize确定),然后再关联 from @fast(select t.* from sqltoy_staff_info t where t.STATUS=1 #[and t.STAFF_NAME like :staffName] order by t.ENTRY_DATE desc ) t1 left join sqltoy_organ_info t2 on t1.organ_id=t2.ORGAN_ID ]]> </value> <!-- 这里为极特殊情况下提供了自定义count-sql来实现极致性能优化 --> <!-- <count-sql></count-sql> --> </sql>

优秀的个人博客,低调大师

🔥 xbatis-ddl-auto 1.0.1 发布全自动 DDL,最强 orm xbatis !!!

官网https://xbatis.cn xbatis-ddl-auto 是一个基于 xbatis 实体元数据的轻量自动建表工具。 它复用 xbatis 的@Table、@TableId、@TableField、@ColumnDefinition等注解解析结果,根据实体类生成并执行数据库 DDL,提供接近 JPAddl-auto=create/update的使用体验,但不引入 JPA 或 Hibernate。 功能 根据 xbatis 实体生成CREATE TABLESQL 表不存在时自动建表 表存在时可在UPDATE模式下自动追加新增字段 支持只生成 SQL,不执行数据库操作 通过 JDBCDatabaseMetaData判断表、字段和索引是否存在 支持常见 Java 类型到数据库列类型映射 支持@ColumnDefinition配置字段长度、精度、小数位、默认值、唯一约束、非空和字段注释 支持类级@Index创建普通索引和唯一索引 安全边界 UPDATE模式只会自动新增字段和缺失索引,不会自动执行以下高风险操作: 删除数据库已有字段 修改字段类型 修改字段长度 修改字段是否可空 修改默认值 重命名字段 修改或删除已有索引 删除或重建表 这些操作可能造成数据丢失或生产事故,建议通过人工审核 SQL 或专业迁移工具处理。 Maven 本工具 Maven 坐标: <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-ddl-auto</artifactId> <version>1.0.1</version> </dependency> 运行依赖 xbatis core <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-core</artifactId> <version>1.10.6</version> </dependency> 默认测试使用 JUnit 5 和 H2;需要真实数据库的集成测试通过 Maven profile 单独执行。 快速开始 定义 xbatis 实体 import cn.xbatis.db.annotations.ColumnDefinition; import cn.xbatis.db.annotations.Table; import cn.xbatis.db.annotations.TableId; import java.math.BigDecimal; import java.time.LocalDateTime; @Table("sys_user") public class SysUser { @TableId private Long id; @ColumnDefinition(length = 64, nullable = false) private String username; @ColumnDefinition(precision = 10, scale = 2, defaultValue = "0") private BigDecimal balance; private LocalDateTime createdAt; } 执行自动建表: import db.sql.api.DbType; DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); CREATE 模式 CREATE是默认模式: DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行CREATE TABLE 表已存在:跳过,不做任何变更 UPDATE 模式 UPDATE模式用于补新增字段和缺失索引: import cn.xbatis.ddl.auto.Mode; DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行CREATE TABLE 表已存在:读取数据库已有列和索引,只对实体中新增的字段执行ALTER TABLE ... ADD COLUMN ...,并创建缺失索引 重复执行UPDATE模式不会重复添加已存在字段或已存在索引。 只生成 SQL / 预览 SQL 不连接数据库,只生成建表 SQL: List<String> sqlList = DDLAuto.of(DbType.PGSQL) .add(SysUser.class) .sqlList(); 如果要按当前数据库状态预览将要执行的 SQL,可以传入DataSource或Connection。该方法只读取 JDBC 元数据并生成 SQL,不会执行 DDL: List<String> sqlList = DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .sqlList(dataSource); 行为: 表不存在:返回CREATE TABLE及附属 DDL 表已存在且是CREATE模式:返回空列表 表已存在且是UPDATE模式:只返回缺失字段的ALTER TABLE ... ADD COLUMN ...及附属 DDL,以及缺失索引的CREATE INDEX 也可以使用底层构建器生成单个字段的新增列 SQL: import cn.xbatis.ddl.auto.DDLBuilder; import cn.xbatis.ddl.auto.DefaultDDLBuilder; DDLBuilder builder = new DefaultDDLBuilder(); String sql = builder.addColumnSql(DbType.MYSQL, SysUser.class, "email"); 生产或准生产环境建议先通过sqlList(dataSource)或sqlList(connection)生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 生产或准生产环境建议先通过sqlList(dataSource)或sqlList(connection)生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 执行失败时抛出的SQLException消息也会包含当前失败 SQL 和失败前已执行 SQL。 支持的注解 @Table 用于解析表名和 schema: @Table("sys_user") public class SysUser { } @TableId 用于识别主键和数据库自增: @TableId private Long id; 默认自增类型为 xbatis 的IdAutoType.AUTO。单主键会按数据库方言生成自增片段;联合主键不会为每个主键字段自动生成自增片段。 如果主键使用IdAutoType.SQL通过数据库序列取值,会从sql中解析序列名并在建表前生成CREATE SEQUENCE: @TableId(dbType = DbType.Name.PGSQL, value = IdAutoType.SQL, sql = "select nextval('id_test_id_seq')") @TableId(dbType = DbType.Name.ORACLE, value = IdAutoType.SQL, sql = "select id_test_seq.NEXTVAL FROM dual") @TableId(dbType = DbType.Name.SQL_SERVER, value = IdAutoType.SQL, sql = "select next value for id_test_sqlserver_seq") @TableId(dbType = DbType.Name.DB2, value = IdAutoType.SQL, sql = "select next value for id_test_db2_seq from sysibm.sysdummy1") private Long id; 当前支持解析 PostgreSQL:nextval('sequence_name') Oracle / DM:sequence_name.NEXTVAL SQL Server / DB2:NEXT VALUE FOR sequence_name 其他数据库:兜底解析上述常见形式,并生成通用序列 DDL: CREATE SEQUENCE my_sequence START WITH 1 INCREMENT BY 1; UPDATE模式会读取数据库已有序列,只创建缺失序列,不重复创建。 @ColumnDefinition 用于控制建表字段定义: @ColumnDefinition( length = 64, nullable = false, unique = true, comment = "用户名" ) private String username; 常用配置: length:字符串长度 precision:数值精度 scale:小数位数 defaultValue:数据库默认值 SQL 片段 nullable:是否允许为空 unique:是否唯一 definition:字段类型片段,配置后优先替代 Java 类型到数据库类型的自动推导,length、precision、scale、defaultValue、nullable、unique、comment等其他配置仍会继续生效 comment:字段注释;MySQL 使用列内联COMMENT,PostgreSQL / Oracle / DM 使用独立COMMENT ON COLUMN,SQL Server 使用sys.sp_addextendedproperty 当definition本身没有包含括号参数时,会按配置补齐长度或精度,例如@ColumnDefinition(definition = "VARCHAR", length = 64)会生成VARCHAR(64);如果已经写成VARCHAR(64),则不会再追加参数。 unique = true目前表示单字段唯一约束: CREATE模式下,多数关系型数据库使用列内联UNIQUE UPDATE模式新增字段时,SQLite 不支持ALTER TABLE ADD COLUMN ... UNIQUE,会改为先新增字段再生成CREATE UNIQUE INDEX ClickHouse 不支持传统唯一约束,配置unique = true时会直接抛出异常,避免生成无效 SQL 不支持联合唯一、部分唯一索引、命名唯一约束和已存在字段的唯一约束同步 @Index 用于在实体类上声明数据库索引: import cn.xbatis.db.IndexDirection; import cn.xbatis.db.annotations.Index; import cn.xbatis.db.annotations.IndexField; import cn.xbatis.db.annotations.Table; @Index(name = "idx_sys_user_username", fields = @IndexField(name = "username")) @Index( name = "uk_sys_user_username_created_at", unique = true, fields = { @IndexField(name = "username"), @IndexField(name = "createdAt", direction = IndexDirection.DESC) } ) @Table("sys_user") public class SysUser { } 说明: name:索引名;为空时按表名和列名生成稳定索引名 unique:是否唯一索引 fields:索引字段,name使用实体字段名,也兼容已映射的列名 direction:索引字段排序,支持ASC、DESC,默认不追加排序片段 CREATE模式下,建表后生成CREATE INDEX UPDATE模式下,只按索引名创建数据库中缺失的索引,不修改或删除已有索引 ClickHouse 不支持传统CREATE INDEX时会直接抛出异常,避免生成无效 SQL PostgreSQL 字段注释会生成额外 SQL: COMMENT ON COLUMN sys_user.username IS '用户名'; SQL Server 字段注释会生成扩展属性 SQL: DECLARE @schema sysname = SCHEMA_NAME(); EXEC sys.sp_addextendedproperty @name=N'MS_Description', @value=N'用户名', @level0type=N'SCHEMA', @level0name=@schema, @level1type=N'TABLE', @level1name=N'sys_user', @level2type=N'COLUMN', @level2name=N'username'; 类型映射 默认类型映射包括: String/Character/UUID->VARCHAR Integer/int->INTEGER Long/long/BigInteger->BIGINT Short/short->SMALLINT Boolean/boolean->BOOLEAN、MySQL 为TINYINT(1) BigDecimal->DECIMAL(precision, scale) Float/Double-> 浮点类型 byte[]-> 二进制大字段 LocalDate->DATE LocalTime->TIME,Oracle / DM 使用TIMESTAMP LocalDateTime/Timestamp/Date->TIMESTAMP,MySQL 使用DATETIME,SQL Server 使用DATETIME2 普通enum->VARCHAR(64) 实现 xbatisEnumSupport<T>的枚举 -> 按T的类型映射,例如EnumSupport<Integer>->INTEGER 具体类型会根据DbType做方言调整。

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册