首页 文章 精选 留言 我的

精选列表

搜索[效率提升],共10000篇文章
优秀的个人博客,低调大师

开发效率优化之自动化构建系统Gradle(二)上篇

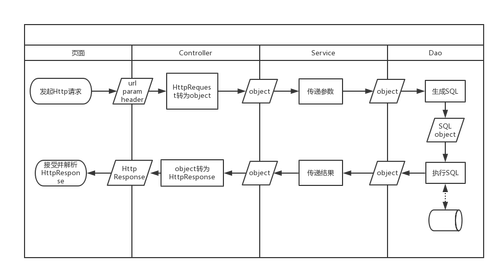
阿里P7移动互联网架构师进阶视频(每日更新中)免费学习请点击:https://space.bilibili.com/474380680 本篇文章将以下两个内容来介绍自动化构建系统Gradle: gradle 与 android gradle 插件的关系 Gradle Transform API 的基本使用 一、gradle 与 android gradle 插件的关系 1.1名词解释: 1.1.1,Gradle Gradle是一种构建工具,它使用一种基于Groovy的特定领域语言(DSL)来构建项目。不仅仅用于android 工程的构建。 1.1.2,Android Plugin for Gradle 这就是为了编译android 工程而开发的插件。下面就是申明Android Gradle 插件的位置。(build.gradle) buildscript { ... dependencies { classpath 'com.android.tools.build:gradle:2.2.0' } } 1.2 gradle 与 android gradle 1.2.1,gradle 各版本源码地址 http://services.gradle.org/distributions/ 1.2.2, google 官网 gradle 插件 与 gradle 版本对照地址 https://developer.android.google.cn/studio/releases/gradle-plugin#updating-plugin 1.2.3,gradle 版本与google gradle 插件版本的区别 在gradle wrapper.properties 中写的是 gradle 版本。 distributionUrl=https\://services.gradle.org/distributions/gradle-4.4-all.zip 在build.gradle 中依赖的是 gradle插件版本。 dependencies { //[this is the android gradle plugin version] classpath 'com.android.tools.build:gradle:3.1.0' // NOTE: Do not place your application dependencies here; they belong // in the individual module build.gradle files } 二、Gradle Transform API 的基本使用 2.1什么是Transform 官方API文档: http://google.github.io/android-gradle-dsl/javadoc/2.1/com/android/build/api/transform/Transform.html 我们编译Android项目时,如果我们想拿到编译时产生的Class文件,并在生成Dex之前做一些处理,我们可以通过编写一个Transform来接收这些输入(编译产生的Class文件),并向已经产生的输入中添加一些东西。 我们可以通过Gradle插件来注册我们编写的Transform。注册后的Transform会被Gradle包装成一个Gradle Task,这个TransForm Task会在java compile Task执行完毕后运行。 对于编写Transform的API, 我们可以通过引入下面这个依赖来使用: compile 'com.android.tools.build:gradle:2.3.3' //版本应该在 2.x以上 先大致看一下Transform的执行流程图: 2.2 Transform的使用场景 一般我们使用Transform会有下面两种场景 我们需要对编译class文件做自定义的处理。 我们需要读取编译产生的class文件,做一些其他事情,但是不需要修改它。 接下来我们就来看一下这些Transform API吧 : 2.3 Transform API学习 我们编写一个自定义的transform需要继承Transform,它是一个抽象类, 我们这里先看一下Transform的抽象方法: public abstract class Transform { public abstract String getName(); public abstract Set<ContentType> getInputTypes(); public abstract Set<? super Scope> getScopes(); public abstract boolean isIncremental(); // 是否支持增量编译 } getName()就是指定自定义的Transform的名字。 2.4 输入的类型 Set<ContentType> getInputTypes()是指明你自定义的这个Transform处理的输入类型,输入类型共有以下几种: enum DefaultContentType implements ContentType { /** * The content is compiled Java code. This can be in a Jar file or in a folder. If * in a folder, it is expected to in sub-folders matching package names. */ CLASSES(0x01), /** * The content is standard Java resources. */ RESOURCES(0x02); } 即分为class文件或者java资源。class文件来自于jar或者文件夹。资源就是标准的java资源。 2.5 输入文件所属的范围 Scope getScopes()用来指明自定的Transform的输入文件所属的范围, 这是因为gradle是支持多工程编译的。总共有以下几种: /** * This indicates what the content represents, so that Transforms can apply to only part(s) * of the classes or resources that the build manipulates. */ enum Scope implements ScopeType { /** Only the project content */ PROJECT(0x01), //只是当前工程的代码 /** Only the project's local dependencies (local jars) */ PROJECT_LOCAL_DEPS(0x02), // 工程的本地jar /** Only the sub-projects. */ SUB_PROJECTS(0x04), // 只包含子工工程 /** Only the sub-projects's local dependencies (local jars). */ SUB_PROJECTS_LOCAL_DEPS(0x08), /** Only the external libraries */ EXTERNAL_LIBRARIES(0x10), /** Code that is being tested by the current variant, including dependencies */ TESTED_CODE(0x20), /** Local or remote dependencies that are provided-only */ PROVIDED_ONLY(0x40); } 对于getScopes()的返回,其实TransformManager已经为我们定义了一些,比如: public static final Set<Scope> SCOPE_FULL_PROJECT = Sets.immutableEnumSet( Scope.PROJECT, Scope.PROJECT_LOCAL_DEPS, Scope.SUB_PROJECTS, Scope.SUB_PROJECTS_LOCAL_DEPS, Scope.EXTERNAL_LIBRARIES); 如果一个Transform不想处理任何输入,只是想查看输入的内容,那么只需在getScopes()返回一个空集合,在getReferencedScopes()返回想要接收的范围。 public Set<? super Scope> getReferencedScopes() { return ImmutableSet.of(); } 2.6 transform() 它是Transform的关键方法: public void transform(@NonNull TransformInvocation transformInvocation) {} 它是一个空实现,input的内容将会打包成一个TransformInvocation对象,因为我们要想使用input,我们需要详细了解一下TransformInvocation参数。 2.7 TransformInvocation 我们看一下这个类相关的API: public interface TransformInvocation { Collection<TransformInput> getInputs(); // 输入作为 TransformInput 返回 TransformOutputProvider getOutputProvider(); //TransformOutputProvider 可以用来创建输出内容 boolean isIncremental(); } public interface TransformInput { Collection<JarInput> getJarInputs(); Collection<DirectoryInput> getDirectoryInputs(); } public interface JarInput extends QualifiedContent { File getFile(); //jar文件 Set<ContentType> getContentTypes(); // 是class还是resource Set<? super Scope> getScopes(); //属于Scope: } DirectoryInput与JarInput定义基本相同。 public interface TransformOutputProvider { //根据 name、ContentType、QualifiedContent.Scope返回对应的文件( jar / directory) File getContentLocation(String name, Set<QualifiedContent.ContentType> types, Set<? super QualifiedContent.Scope> scopes, Format format); } 即我们可以通过TransformInvocation来获取输入,同时也获得了输出的功能。举个例子, public void transform(TransformInvocation invocation) { for (TransformInput input : invocation.getInputs()) { input.getJarInputs().parallelStream().forEach(jarInput -> { File src = jarInput.getFile(); JarFile jarFile = new JarFile(file); Enumeration<JarEntry> entries = jarFile.entries(); while (entries.hasMoreElements()) { JarEntry entry = entries.nextElement(); //处理 } } } 上面这段代码就是获取jar的输入,然后遍历每一个jar做一些自定义的处理。 我们在做完自定义的处理后,如果想自己输出一些东西怎么办? 比如一个class文件,就可以通过TransformOutputProvider来完成。比如下面这段代码: File dest = invocation.getOutputProvider().getContentLocation("susion", TransformManager.CONTENT_CLASS, ImmutableSet.of(QualifiedContent.Scope.PROJECT), Format.DIRECTORY; 这段代码就是在本工程(ImmutableSet.of(QualifiedContent.Scope.PROJECT))下产生一个目录(Format.DIRECTORY), 目录的名字是(susion),里面的内容是TransformManager.CONTENT_CLASS。 创建这个文件夹后,我们就可以向其中写入一些内容,比如class文件。 2.8 注册Transform 我们在了解transform api后,我们可以编写一个自定义的Transform。但是我们编写的这个Transform,如何在构建过程中生效呢?我们需要注册它 在自定义插件中注册它,然后在build.gradle中apply就可以了。 //MyCustomPlgin.groovy public class MyCustomPlgin implements Plugin<Project> { @Override public void apply(Project project) { project.getExtensions().findByType(BaseExtension.class) .registerTransform(new MyCustomTransform()); } } 其实如果你包含了你编写的transform库,我们也可以直接在build.gradle中注册: //在build.gradle中也是可以直接编写 groovy代码的。 project.extensions.findByType(BaseExtension.class).registerTransform(new MyCustomTransform()); 参考:https://www.jianshu.com/p/031b62d02607https://my.oschina.net/u/592116/blog/1851743 阿里P7移动互联网架构师进阶视频(每日更新中)免费学习请点击:https://space.bilibili.com/474380680 结束语 希望读到这的您能转发分享和关注一下我,以后还会持续分享阿里P7 Android高级架构进阶知识点及解析,您的支持就是我最大的动力!!

优秀的个人博客,低调大师

物联网中的边缘计算:提高网络效率以减少流量

企业对边缘计算越来越感兴趣,因为随着更多物联网设备的部署,企业需要快速分析和处理它们生成数据的方法。目标是消除将数据传输回云或内部数据中心的需要。 根据Gartner 的数据,今天只有20%的企业数据是在数据中心之外处理的。但是,到2022年,大多数企业数据将在数据中心外部产生和处理,Gartner说。到2025年,边缘设备可以处理高达90%的数据。根据Smoker的说法,Purdue的研究人员使用边缘计算有很多原因。例如,边缘计算用于预处理数据,允许工作人员仅从原始图像中提取有价值的数据。这大大减小了通过网络发送的数据文件的大小,并优化了有限带宽的使用。 在其他情况下,边缘计算允许研究人员分析传感器数据以确保质量,然后再将其添加到更大的数据存储库以供进一步研究或者,他们可以向传感器数据添加适当的元数据,例如GPS坐标和绘图信息。 “在其他方面,我们可以用边缘计算在农场封闭系统内做出决策,就像在今天的汽车中使用车载计算一样,”Smoker解释说。 这包括使用传感器跟踪工具的性能,并根据收集到的信息采取实时操作。这些信息可以涵盖许多变量,其中包括农场中耕田地的速度,种子密度或与优化相关的行动,如燃料消耗或施肥量。 “我们用这些工具来研究作物遗传,”Smoker说。“到2050年,我们希望能够养活全世界的人口,因此我们必须提高我们生产粮食的能力,增加粮食营养并使作物能在新的地区生长“。 专注于物联网中的边缘计算 Gartner副总裁兼分析师Thomas Bittman认为物联网的采用是推动边缘计算发展的主要力量之一。因此,公司正在竞相寻找重组IT基础设施的方法,以便利用现有的运营技术将传感器和其他远程设备缝合在一起。 Bittman说:“重要的是不要把边缘计算看作是一个市场,而是一种计算拓扑,它将适用于许多独特的市场:企业、消费者、工业和移动等领域。” “我想说,只要有工厂,员工,客户或地点,所有垂直行业都将出现边缘计算,”他补充道。“主要的努力将是实现全新的用例,追求更小的延迟,更广泛地在工厂实现自动化,并为购物者和员工增加身临其境的体验。” 数据处理,压缩和过滤是将在边缘执行的常见任务,“德克萨斯州Round Rock的制造自动化公司自动化解决方案部门总监Mike Boudreaux表示。 服务提供商可以很好地部署没有应用软件的边缘设备。然后,云系统可以将特定应用程序的软件推送到设备。Boudreaux补充说,这将使公司能够监控他们想要的应用程序并定期提供软件更新。 物联网中的边缘计算有助于养活全世界 Purdue大学的精准农业计划依赖于物联网边缘计算的各种设备,包括传感器,太阳能无线设备,服务器和其他设备 - 所有设备都旨在帮助Smoker跟踪大学里1,408英亩农场的情况。 在给定的研究实验期间,计算设备会精确地计算需要处理的内容,地点和程度。在大多数情况下,一旦工具完成其工作,最终数据将被发送到主校区的学院中央数据中心。 “对我们来说,使用内部数据中心更具成本效益,”Smoker说。“我们研究过云计算服务,但对于我们正在做的工作,它太贵了。” 农业学院还使用被称为Phenomobile的车辆收集研究数据,该车辆收集光反射和波长等数据。在农业研究的背景下,植物的表型描述了在环境影响它后产生的可观察特征,例如高度,生物量和叶子形状。 Purdue的物联网基础设施使其能够自动化传感器数据采集并实时传输到数据中心。拖车外壳12 IoT排放传感器还配备了Hewlett Packard Enterprise Edgeline服务器,收集的数据在通过网络发送到学校的数据存储库之前进行分析和质量检查。Phenomobile收集的数据也可直接从现场流入中央数据中心。 “服务器对错误的检查以确保我们将正确的数据发送回主数据中心,”Smoker说。“例如,如果数据不符合某个标准,可能是因为传感器可能已被闪电击中。” “关于要养活全世界的问题,”他说。“我们没有太多时间耽误了。到2050年,我们预计我们必须将粮食产量翻番,以满足世界人口的需求。” 关于在物联网中使用边缘计算的4个问题 在决定边缘计算是否合适之前,企业需要考虑四个主要问题,Hewlett Packard Enterprise公司Aruba战略合作伙伴副总裁Michael Tennefoss表示。虽然边缘计算,云和内部数据中心的使用可以互补,但使用任何选项都有助于实现公司的业务目标。 Tennefoss建议,公司不应该急于将一切都转移到云端,也不应该决定所有的处理现在必须在边缘进行。一个很好的例子是:在世界各地运营多个工厂的制造商可能希望在工厂地板上集成边缘计算,以跟踪生产缺陷,但当他们想看到明各工厂之间相互比较的数据时,他们会在云中或内部数据中心中收集数据。 需要考虑的关键问题包括: 公司需要多快的数据? 如果生产线每分钟需要对1000瓶液体进行快速检测,以实时识别缺陷。将这种环境与城市污水处理进行比较,因为在城市污水处理过程中流体的水平会随着时间的推移而变化。企业应该确定他们在边缘所需的响应时间有多快,以及他们是否能够接受与在远处的云设施处理该数据相关的延迟。有时,公司将边缘和云计算混合在一起。例如,如果一家公司拥有多个工厂并希望在这些工厂中汇总性能数据,那么它可以使用边缘计算来支持高速决策并处理云中的聚合数据。 公司在多大程度上可以容忍WAN中断? 对于严重受中断影响的公司,使用边缘计算处理靠近生成的数据是有意义的。重视正常运行时间并希望使用云计算的企业需要考虑使用蜂窝,互联网或卫星连接混合的冗余WAN链路的网络。 公司能买得起什么? 数据传输成本可能会迅速上升,特别是在使用卫星通信或蜂窝等高成本服务的情况下。另一种方法是在边缘处理数据,并在每天结束时通过互联网连接发送压缩和聚合数据转储。 公司政策是否要求某些数据保留在本地? 在许多制造和国防应用中,或者在公司处理敏感知识产权或商业机密的情况下,数据可能必须保持在本地。因此,公司可能希望将所有数据保留在边缘,或者只将相关的摘要数据集通过安全的私有云发送到中央数据中心。出于安全性和合规性原因,全云计算选项可能永远不会有意义。 原文发布时间为:2018-11-2 本文来自云栖社区合作伙伴“SDNLAB”,了解相关信息可以关注“SDNLAB”。

优秀的个人博客,低调大师

30个极大提高开发效率的Visual Studio Code插件

译者按: 看完这篇文章,我打算从 Sublime Text 转到 Visual Studio Code 了! 原文: Immensely upgrade your development environment with these Visual Studio Code extensions 译者: Fundebug 为了保证可读性,本文采用意译而非直译。另外,本文版权归原作者所有,翻译仅用于学习。 我们的 VSC(VSCode)将会像一个长了五只可以发射激光的独角兽一样!接下来会介绍我每天使用的非常有用的插件。 如果你还是一个 VSC 的新手,那么点击左侧最下方的按钮来安装插件。 Material Theme 下载量:130 万 Visual Studio Code 最悠久的主题! Auto Import 下载量:46 万 自动去查找、分析、然后提供代码补全。对于 TypeScript 和 TSX,可以适用。 Import Cost 下载量:41 万 该插件会在行尾显示导入的包的大小。为了计算包大小,该插件要使用 Webpack 和 babili-webpack-plugin。 Indent-Rainbow 下载量:13 万 一个简单的插件可以使得对齐更加具有可读性。 IntelliSense for CSS class names in HTML 下载量:243 万 基于你的项目以及通过link标签引用的外部文件,该智能插件提供 HTML 中 CSS class 名字的补全。 SVG Viewer 下载量:29 万 一个用来预览 SVG 的插件。 Prettier 下载量:357 万 你绝对不能少了这个插件,你需要它来一键美化你的 JavaScript/TypeScript/CSS 代码。 React Native Tools 下载量:218 万 代码提示、Debugging、集成 RN 的命令。 Sublime Text Keymap and Settings Importer 下载量:76 万 从下载量来看,看来不少人从 Sublime Text 转移过来了。 这个插件将 visual studio code 的快捷键绑定改成了和 Sublime Text 3 一样。你可以试一试:cmd + P (Mac),ctrl + P (Windows)。 你可以跳转到文件,如果在搜索前添加>符号,你甚至可以搜索动作,比如打开内置的终端、安装插件等等。 对于习惯使用 ST3 的人,这是一个很大的加分项。 npm Intellisense 下载量:88 万 VSCode 插件可以在导入语句自动补全 npm 模块名称。 lit-html 下载量:3 万 在 JavaScript/TypeScript 的文件中,如果有使用到 HTML 标记,lit-html 提供语法高亮和相应的补全支持。 highlight-matching-tag 下载量:6 万 这本来应该是 VSCode 应该默认提供的功能,高亮匹配的标签。 GitLens 下载量:772 万 啥也别说,直接上图! Git Project Manager 下载量:37 万 Git Project Manager 可以然你直接一键搜索并打开某个的基于 Git 管理的项目。 Git History 下载量:332 万 用来查看 git log 或则一个文件的 git 历史,比较不同的分支,commits。 File Utils 下载量:8 万 提供了一个更加简洁的方法来创建、复制、移动、重命名、删除文件/文件夹。 Bracket Pair Colorizer 下载量:228 万 如果你的代码有很多的回调,那么这种高亮可以帮助你更好地区分不同的代码块。 Color Highlight 下载量:25 万 直观展示你定义的颜色。 CSS Peek 下载量:23 万 可以在 HTML 中通过 CSS id 或则 class 来定位到其定义。 Debugger for Chrome 下载量:1111 万 用 Chrome 来 Debug 你的 JavaScript 代码,或则其它支持 Chrome Debugger 协议的平台。 Quokka.js 下载量:172 万 实时执行 JavaScript 代码(做快速的 demo 很有用)。 Trailing Spaces 下载量:7 万 高亮那些冗余的空格,可以快速删掉。 TypeScript Hero 下载量:72 万 辅助用 TypeScript 编程的童鞋! WakaTime 下载量:24 万 从你的使用习惯中生成数据报表。 Vetur 下载量:451 万 VS Code 下面的 Vue 工具!有 Pine Wu 开发,已经累计 400 多万下载量! Code Runner 下载量:346 万 支持多种语言的代码的立即执行。支持的语言:C, C++, Java, JavaScript, PHP, Python, Perl, Perl 6, Ruby, Go, Lua, Groovy, PowerShell, BAT/CMD, BASH/SH, F# Script, F# (.NET Core), C# Script, C# (.NET Core), VBScript, TypeScript, CoffeeScript, Scala, Swift, Julia, Crystal, OCaml Script, R, AppleScript, Elixir, Visual Basic .NET, Clojure, Haxe, Objective-C, Rust, Racket, AutoHotkey, AutoIt, Kotlin, Dart, Free Pascal, Haskell, Nim, D。 PHP IntelliSense 下载量:415 万 vscode-icons 下载量:799 万 Icon 集合。 Jest 下载量:29 万 愉快地使用 Facebook 的 Jest。 React.js code snippets 下载量:59 万 用 ES6 语法去开发 React.js 应用非常方便。 关于Fundebug Fundebug专注于JavaScript、微信小程序、微信小游戏、支付宝小程序、React Native、Node.js和Java实时BUG监控。 自从2016年双十一正式上线,Fundebug累计处理了6亿+错误事件,得到了Google、360、金山软件等众多知名用户的认可。欢迎免费试用! 版权声明: 转载时请注明作者Fundebug以及本文地址:https://blog.fundebug.com/2018/07/24/vs-extensions/ 我的博客即将入驻“云栖社区”,诚邀技术同仁一同入驻。


优秀的个人博客,低调大师

DataBuff v0.1.5 发布 · 写入性能大幅提升

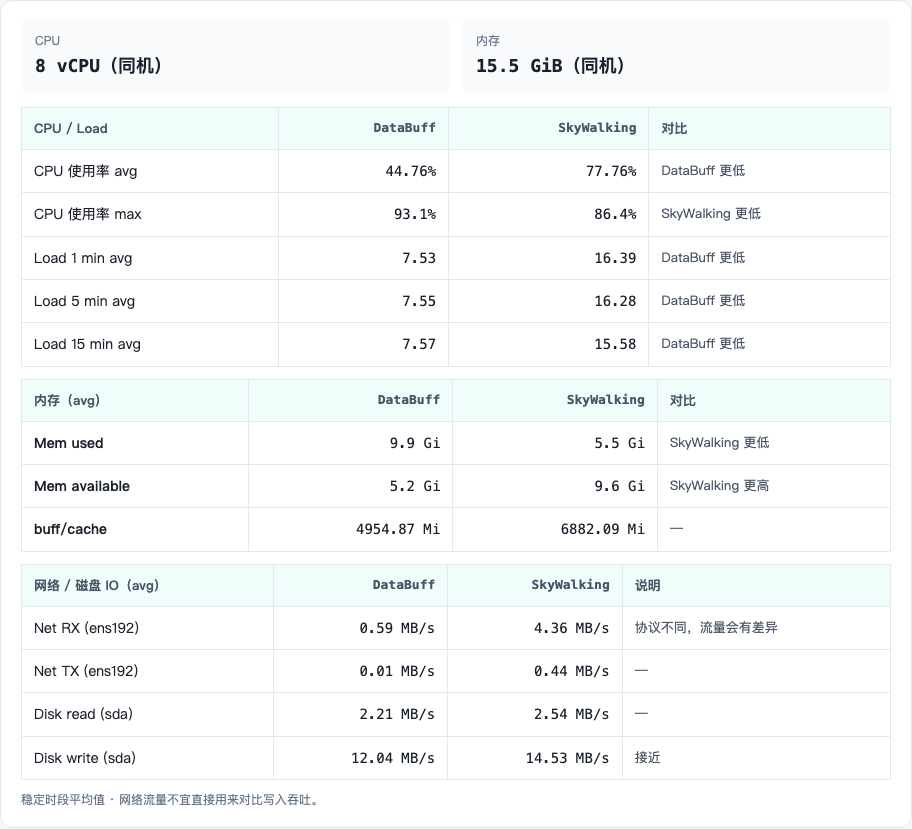
DataBuff 是一款面向云原生与微服务场景的开源AI Native OpenTelemetry APM,采用 OTLP 标准接入、Apache Doris 统一存储,Web 端提供拓扑 / Trace / 指标与多 Agent 排障。项目已在 OSCHINA 软件库收录:https://www.oschina.net/p/databuff 今天,DataBuff 正式发布v0.1.5(2026-07-21)。相对 v0.1.4 共25 个提交、394 个文件变更。本版我们拿同一套微服务 Demo、在相同业务写入压力(QPS=35)下,与SkyWalking OAP 10.4.0做了一次写入压测:同档负载下,两侧写入吞吐基本持平;DataBuff 主机 CPU 占用更低,SkyWalking 内存占用更低。测试条件、逐分钟曲线与组件明细见对比报告:https://databuff.ai/blog/zh/databuff-vs-skywalking-write-perf/ 写入压测环境 业务 Demo:17 个微服务 × 各 2 副本,Redis / MySQL / Kafka 等9个中间件,合计43个 Pod 写入压力:业务侧QPS = 35(两侧相同) 压测机:192.168.50.114(8 vCPU / 15.5 GiB),流量从192.168.50.145打入 对比版本:DataBuff0.1.5vs SkyWalking OAP10.4.0+ BanyanDB0.10.2 采样:预热约 60 分钟,取稳定40分钟均值 图:同档 QPS=35 下,DataBuff 与 SkyWalking 主机 CPU / 内存 / 负载对比 图:DataBuff 0.1.5 逐分钟入库吞吐(稳定 40 分钟) 本次压测关注写入路径与同机资源,不含查询时延与 UI 体验;完整对比报告(含 SkyWalking 趋势与组件明细):https://databuff.ai/blog/zh/databuff-vs-skywalking-write-perf/ 本版本亮点 1. AI 对话 Mermaid v0.1.5 在对话渲染链路接入 Mermaid:运维专家可用拓扑图、时序关系图等结构化图形回答问题,而不只是长段落文字。 2. 日志详情抽屉 日志列表保持轻量;点击任意一行,右侧滑出详情抽屉,按需加载全字段。 3. 接入与写入加固 OTLP 压缩:gRPC / HTTP 支持 gzip、snappy、zstd 等;Collector 默认 gzip 可直接对接,无需再强制compression: none。 Span 资源忽略:ingest 在 enrich / 落库前按精确名或正则丢弃健康检查、探活等噪声 Span。 Doris 按体积刷写:线程本地缓冲 + 估算体积触发 Stream Load(默认约 50 MiB),降低高频 load 压力。 AI 运行时:hydrate 不打断正在运行的专家会话;LLM 配置热读;工具调用格式对齐 OpenAI / Anthropic。 已有 Docker 部署可执行升级脚本,保留data/目录: curl -fsSL https://databuff.ai/databuff/ai-apm-update.sh | bash 离线升级:解压目标版本离线包后,在离线包目录执行(保留data/): tar -xzf databuff-ai-apm-offline-0.1.5-amd64.tar.gz cd databuff-ai-apm-offline-0.1.5-amd64 sudo ./update.sh 同时提供0.1.5架构的 amd64 / arm64 离线安装包,适合内网无外网环境。 快速开始(新装) # 安装平台 curl -fsSL https://databuff.ai/databuff/ai-apm-install.sh | bash # 可选:样例服务 curl -fsSL https://databuff.ai/databuff/ai-apm-demo-install.sh | bash 浏览器访问http://<你的主机>:27403,登录后配置 LLM API Key 即可使用 AI 运维能力与运维专家。 组件与镜像(v0.1.5) 组件 镜像 Web Platform databuffhub/ai-apm-web:0.1.5 Ingest databuffhub/ai-apm-ingest:0.1.5 Demo databuffhub/ai-apm-demo:0.1.5 架构简述:应用 (OTLP / SkyWalking) → ai-apm-ingest → Doris → ai-apm-web (Platform + AI Agents + 运维专家) 获取项目 Release:https://github.com/databufflabs/databuff/releases/tag/0.1.5 写入压测报告:https://databuff.ai/blog/zh/databuff-vs-skywalking-write-perf/ 源码:https://github.com/databufflabs/databuff 文档:https://github.com/databufflabs/databuff/tree/master/docs 官网:https://databuff.ai 在线演示:https://demo.databuff.ai OSCHINA 软件主页:https://www.oschina.net/p/databuff 欢迎试用 v0.1.5,在GitHub 给我们一个 Star,并在软件主页留言交流部署与压测复现体验。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册