首页 文章 精选 留言 我的

精选列表

搜索[基础模型],共10000篇文章
优秀的个人博客,低调大师

Go基础(复杂类型):指针

Go语言指针 Go 具有指针。 指针保存了变量的内存地址。 类型 *T 是指向类型 T 的值的指针。其零值是 nil。 var p *int & 符号会生成一个指向其作用对象的指针。 i := 42 p = &i * 符号表示指针指向的底层的值。 fmt.Println(*p) // 通过指针 p 读取 i *p = 21 // 通过指针 p 设置 i 这也就是通常所说的“间接引用”或“非直接引用”。 与 C 不同,Go 没有指针运算。 例如以下的例子: package main import "fmt" func main() { //定义一个变量i等于42 i := 42 //方式一 //&i指针,生成一个指针,指向作用对象i p := &i //*T符号表示指针指向的底层的值 fmt.Println(*p) //通过这个指针去操作i,去改变i的值 *p = 21 fmt.Println(i) //定义一个变量j,值为2701 j := 2701 //方式二 //&i指针,生成一个指针,指向作用对象i //*p(除后的值) = *p(2701)/37 p = &j *p = *p/37 fmt.Println(j) } 输出结果: 42 21 73 好啦,指针的学习就到此结束啦。

优秀的个人博客,低调大师

Java并发编程基础-理解中断

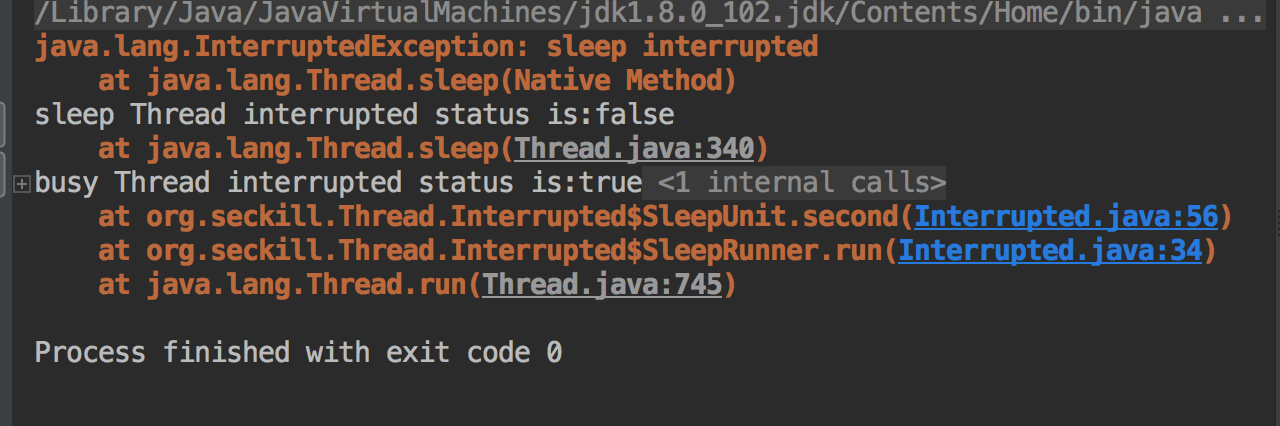
章节 什么是中断 中断线程的方法 线程中断状态的判断以及何时被中断的线程所处 isInterrupted() 状态为 false? 1.什么是中断 线程标识位 中断可以理解为线程的一个标识位属性,它标识一个运行中的线程是否被其他线程进行了中断操作。 2.中断线程的方法 其他线程通过调用该线程的 interrupt() 方法对其进行中断操作。 其实就是其他线程对该线程打了个招呼,要求其中断。 3. 线程中断状态的判断 线程通过方法isInterrupted()方法来进行判断是否被中断。 如下两种情况需要注意: 1.如果被中断的线程已经处于终结状态,那么调用该线程对象的 thread.isInterrupted() 返回的仍是 false。 2.在Java API中可以看到,许多抛出 InterruptedException 的方法,(其实线程已经终结了,因为遇到了异常)如Thread.sleep( long mills) 方法)这些方法在抛出InterruptedException 异常之前,JVM会将中断标识位清除,然后抛出InterruptedException,此时调用isInterrupted()仍会返回false。 package org.seckill.Thread; import java.util.concurrent.TimeUnit; public class Interrupted { public static void main(String[] args) throws InterruptedException{ Thread sleepThread = new Thread(new SleepRunner(),"sleepRunner"); sleepThread.setDaemon(true);//支持性线程 Thread busyThread = new Thread(new BusyRunner(),"busyRunner"); busyThread.setDaemon(true); sleepThread.start(); busyThread.start(); TimeUnit.SECONDS.sleep(5); sleepThread.interrupt(); busyThread.interrupt(); System.out.println("sleep Thread interrupted status is:"+sleepThread.isInterrupted()); System.out.println("busy Thread interrupted status is:"+busyThread.isInterrupted()); SleepUnit.second(500); } /** * 沉睡中的线程-静态内部类 */ static class SleepRunner implements Runnable { public void run() { while (true) { SleepUnit.second(10); } } } /** * 不停运行,空耗cpu的线程-静态内部类 */ static class BusyRunner implements Runnable { public void run() { while (true) { } } } /** * 静态内部工具类 */ static class SleepUnit { public static void second(int seconds) { try { TimeUnit.SECONDS.sleep(10); } catch (InterruptedException e) { e.printStackTrace(); } } } } 运行结果: 运行结果 我们可以发现 sleep线程的 isInterrupted 状态为false,其中断标识位被清除了。 busy 线程属于正常中断所以isInterrupted 状态为 true,中断标识位没有被清除。

优秀的个人博客,低调大师

07.Java基础(泛型)

在类上定义泛型 类上定义的泛型是在对象实例化的时候指定的,可以用于类中定义的成员变量和成员方法,但是不包括静态成员变量和静态成员方法,因为静态变量和方法的调用可以通过类名实现,不需要创建类的对象,因此此时类上定义的泛型还没有被指定,所以静态不能使用类定义的泛型,相反对于普通成员变量和方法,它们的调用是通过类的对象来实现地,创建对象之后泛型已经被指定,所以它们可以和类的泛型保持一致 public class Tool<R> { //Cannot make a static reference to the non-static type R //public static R r; public R r; public void setR(R r) { this.r = r; } public R getR() { return r; } } 在方法上定义泛型 方法上使用的泛型可以和类泛型保持一致,比如我们上边得到setR getR方法,也可以设置和类泛型不同的泛型,如下便setParam方法泛型Z的指定,这样在调用这个方法的时候就可以你指定什么泛型就设置什么类型,但是这样操作似乎意义不大,方法泛型最好和类泛型保持一致 public class Tool<R> { public R r; public void setR(R r) { this.r = r; } public R getR() { return r; } //这种使用形式会报错:Z cannot be resolved to a type //因为Z泛型并没有被定义,正确的方式是下边 //public void setParam(Z z) { //}; //把泛型指定在方法返回值类型的前边,注意不可以是后边 public <Z>void setParam(Z z) { }; } 在静态方法上使用泛型 静态方法随着类的加载就已经存在,所以先于对象的创建,因此不能使用类上定义的泛型,类泛型是在创建对象的时候指定的,静态方法泛型在调用静态方法的时候指定 public class Tool<R> { public R r; public void setR(R r) { this.r = r; } public R getR() { return r; } //public void setParam(Z z) { //}; public <Z>void setParam(Z z) { }; //同样这种使用形式会报错:M cannot be resolved to a type //因为Z泛型并没有被定义,正确的方式是下边 //public static void setData(M m) { //} //静态方法的泛型要定义在返回值的左边,static关键字的右边 public static <M>void setData(M m) { } } 在接口上使用泛型 在接口上定义泛型的目的很简单,就是对实现类做限制,保证规则的统一 定义接口中所有方法都可以使用的泛型,接口中可能存在多个方法,这样一来每个方法都可以使用这个泛型 public interface Inter<R> { void process(R r); } class Demo implements Inter<String>{ @Override public void process(String r) { } } 针对接口中单独的方法指定独有的泛型 public interface Inter { <R>void process(R r); } class Demo implements Inter{ @Override public <R> void process(R r) { } } 接口中虽然定义了泛型,但是我操作实现类的时侯再指定这个实现类特定的泛型,这样做是可行的,但是没有实际意义 public interface Inter<R> { void process(R r); } class Demo<Z> implements Inter<Z>{ @Override public void process(Z r) { // TODO Auto-generated method stub } } 泛型通配符<?> <?>表示任意类型,如果没有明确指定那就是Object以及任意的Java类 通配符的两种使用场景 ?extends E : 向下限定,固定上边界,E及其子类 ? super E :向上限定,固定下边界,E及其父类 向下限定,E及其子类 Colloection的addAll方法 addAll(Colloction<? extends E> c); //student是person的子类,所以可以调用addAll方法添加 ArrayList<Person> list1 = new ArrayList<>(); ArrayList<Student> list2 = new ArrayList<>(); list1.addAll(list2); 向上限定,固定下边界,E及其父类 TreeMap构造方法 TreeMap(Comparator<? super K> comparator)

优秀的个人博客,低调大师

多线程之并发基础(三)

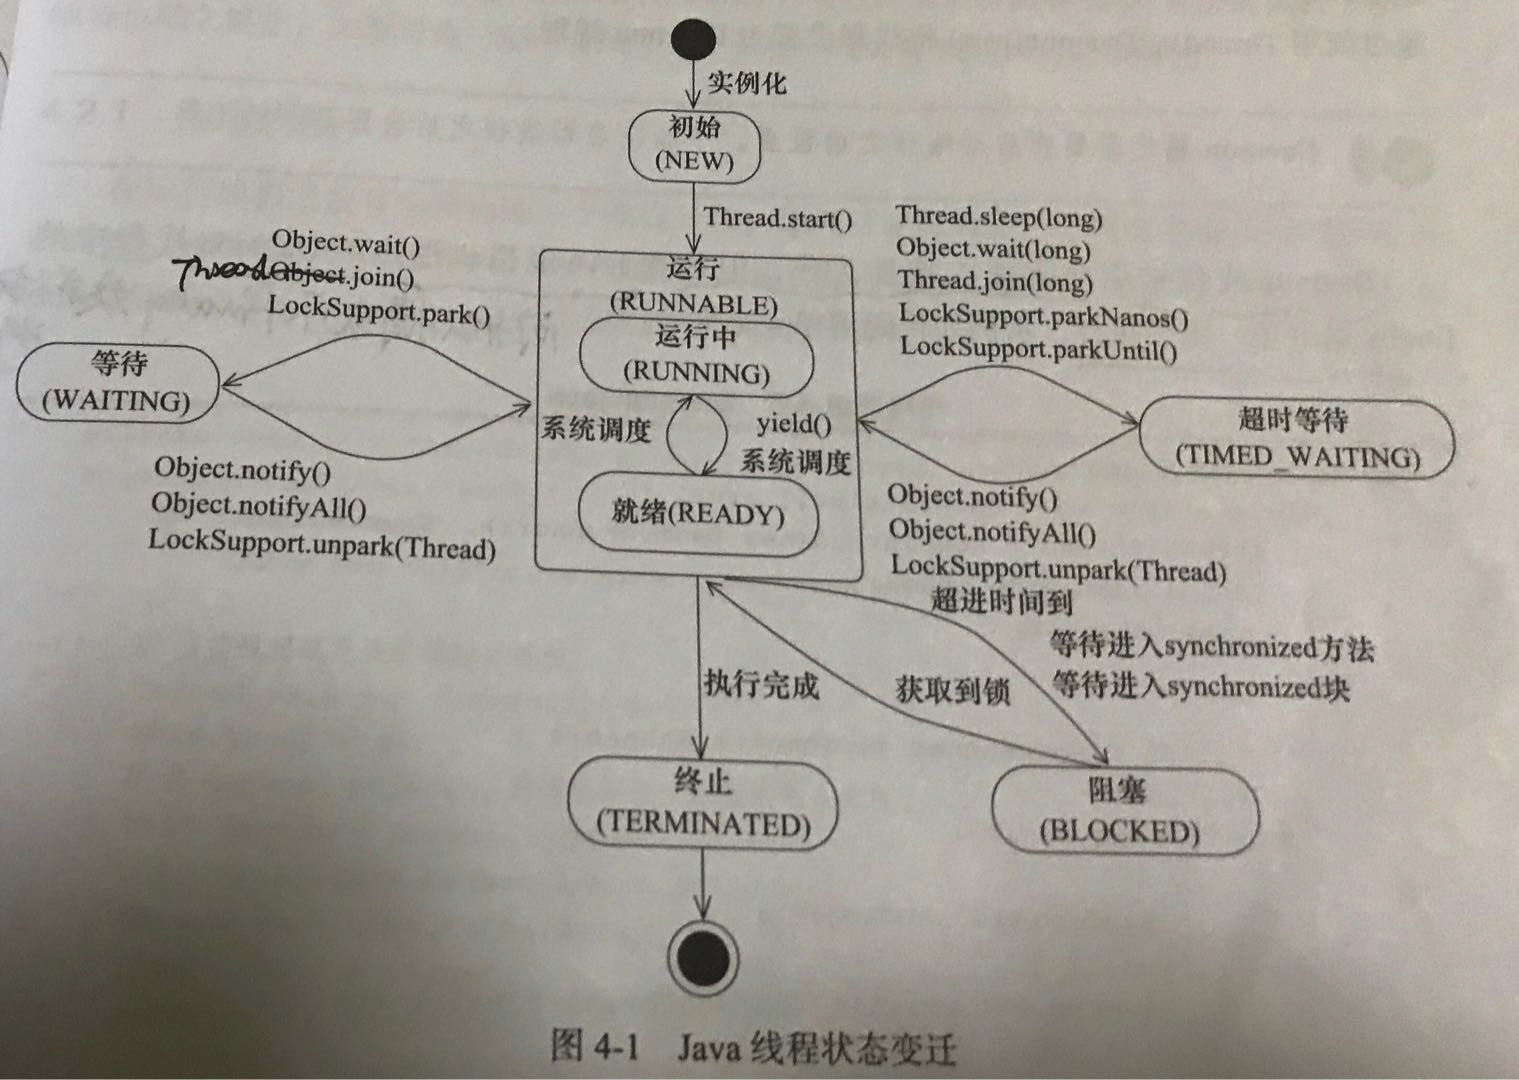
线程是轻量级的进程,进程可以说是线程的容器。线程是程序执行的最小单位。使用多线程而不是使用多进程进行并发程序的设计,因为线程的切换和调度成本远远小于进程。 与文无关 本文知识点目录: 线程的状态 线程的常见操作 Daemon线程 线程优先级 wait与notify 线程的状态 在Java程序中,线程有如下状态 NEW(新建): 新的线程刚刚创建,还没有启动。 Runnable(就绪):线程已经调用了start方法,正在被JVM执行的时候,也有可能正在等待某个操作系统的资源。 Blocked(阻塞):有其它线程占着锁不释放,当前线程阻塞与锁 Waiting(等待):表示当前线程需要等待其它线程做出一些特定动作(通知或中断),当调用以下方法时会进入此状态。 Object.wait()没有时间参数 Thread.join()没有超时参数 LockSupport.park方法 Timed Waiting(等待并计时):指定时间waiting,一边等,一边计时,一般调用如下方法可以j进入此状态。 Thread.sleep Object.wait()带有参数 Thread.join ()带有超时参数 LockSupport.parkNanos LockSupport.parkUntil Terminated(终止) 线程完成了它的操作,也有可能错误的执行而终止。 线程状态图 线程状态图 线程操作 实现多线程 我们想要实现多线程常用的有两种方法 实现Runnable接口 继承自Thread线程 java只能单继承,因此如果是采用继承Thread的方法,那么在以后进行代码重构的时候可能会遇到问题,因为你无法继承别的类了。 如果一个类继承Thread,则不适合资源共享。但是如果实现了Runable接口的话,则很容易的实现资源共享。 注意这是在多线程情况下, 每个人运行的结果可能都不一样。要想保住线程安全性,还需要额外的操作。 // 案例代码,继承线程变量无法共享 public class ThreadOrRunnable extends Thread { private int count=5; private String name; public ThreadOrRunnable(String name) { this.name=name; } @Override public void run() { // super.run(); for (int i = 0; i < 5; i++) { count--; System.out.println(name + "运行 count=" + count); } } public static void main(String[] args) { ThreadOrRunnable threadOrRunnable = new ThreadOrRunnable("A"); ThreadOrRunnable threadOrRunnableB = new ThreadOrRunnable("B"); threadOrRunnable.start(); threadOrRunnableB.start(); } } //运行结果: A运行 count=4 A运行 count=3 A运行 count=2 A运行 count=1 B运行 count=4 A运行 count=0 B运行 count=3 B运行 count=2 B运行 count=1 B运行 count=0 // 案例 继承自Runnable可以共享count变量 public class RunnableTest implements Runnable{ private int count=15; @Override public void run() { for (int i = 0; i < 5; i++) { count--; System.out.println(Thread.currentThread().getName() + "运行: count=" + count); } } public static void main(String[] args) { RunnableTest runnableTest = new RunnableTest(); new Thread(runnableTest,"A").start(); new Thread(runnableTest,"B").start(); } } // 运行结果 B运行: count=13 A运行: count=13 B运行: count=12 A运行: count=11 B运行: count=10 A运行: count=9 A运行: count=7 A运行: count=6 B运行: count=8 B运行: count=5 Daemon线程 Daemon线程是一种支持型线程,在后台调度及支持性工作。它有两个点需要注意: 必须在程序调用start方法之前调用Thread.setDaemon(true)方法才能设置为daemon线程,如果start()之后设置,会报IllegalThreadStateException异常 在所有前台线程执行完毕的时候,daemon线程会自动销毁。 Thread thread = new Thread(); thread.setDaemon(true); thread.start(); 线程优先级 Java中的线程可以有自己的优先级,优先级高的线程在竞争资源时更可能抢占资源,但是这只是一个概览问题,并不是谁的优先级高,谁就一定先执行。 Thread thread = new Thread(); // MIN_PRIORITY = 1; // NORM_PRIORITY = 5; // MAX_PRIORITY = 10; thread.setPriority(int newPriority) thread.start(); wait与notify wait和notify方法不是在Thread类中的,而是在Object类中,意味着任何对象都可以调用这两个方法。 当一个线程A调用了obj.wait()方法,那么线程A就会停止继续执行,而是转为waiting状态。一直都其它线程调用obj.notify()方法为止。 notify与notifyAll 注意: notify方法是从等待队列中的线程随机选择一个,我们无法保证它唤醒的是那一个。notifyAll()方法会唤醒所有等待的线程。 object.wait()方法必须包含在synchronized语句中,wait或notify都需要首先获得目标对象的监视器。 Object.wait和Thread.sleep方法都可以让线程等待若干时间,它们哟徐诶区别。 wait可以被唤醒,sleep不可以 wait会释放目标对象的锁,而sleep不释放任何锁。 public class WaitNotify { static volatile boolean flag = true; static Object lock = new Object(); static class Wait implements Runnable{ @Override public void run() { synchronized (lock){ while (flag){ System.out.println(Thread.currentThread().getName() + " 时间: " + System.currentTimeMillis()); try { lock.wait(); } catch (InterruptedException e) { e.printStackTrace(); } } //条件满足的时候完成了工作 System.out.println("flag=" + flag + "任务完成"); } } } static class Notify implements Runnable{ @Override public void run() { synchronized (lock){ System.out.println(Thread.currentThread().getName() + " 持有锁"); lock.notifyAll(); flag = false; try { Thread.sleep(3000); } catch (InterruptedException e) { e.printStackTrace(); } } synchronized (lock){ System.out.println("再次持有锁"); try { Thread.sleep(3000); } catch (InterruptedException e) { e.printStackTrace(); } } } } public static void main(String[] args) throws InterruptedException { Thread waitThread = new Thread(new Wait(),"waitThread"); waitThread.start(); TimeUnit.SECONDS.sleep(1); Thread notifyThread = new Thread(new Notify(),"notifyThread"); notifyThread.start(); } } //运行结果,调用notify之后,wait状态会变为blocked状态,然后再进入Runnable状态。 运行结果 Wait与notify可以提炼出等待/通知的经典范式,氛围两部分: 等待方规则: 获取对象的锁 如果条件不满足,那么调用wait方法,被通知后仍要检查条件 条件满足则执行相应的逻辑 通知方规则: 获得对象的锁 改变条件 通知等待对象上的线程。 问题 关于Object.wait与notify,最后再留下来一个问题: 为什么wait与notify方法要在Object类中调用而不是在Thread中? 最后 这次提到了一些Thread的基本概念,线程的状态切换,线程的两个属性,最后提了一下wait与notify方法。下次讲一下线程的常见用法。 参考 Lifecycle and States of a Thread in Java 《Java并发编程的艺术》 《Java高并发程序设计》

优秀的个人博客,低调大师

Linux基础 crontab定时任务

linux定时任务: 程序、进程、守护进程 程序:软件,可执行的代码 进程:正在执行的命令、服务,执行完成,就会退出 守护进程(服务):在后台一直运行的进程 sshd: 守护进程:daemon 1)检查crond服务是否允许 /etc/init.d/crond status /etc/init.d/crond start chkconfig crond on 2)定时任务的写法 * * * * * cmd 分 时 日 月 周 执行的命令 3)举例 编辑定时任务crontab -e * * * * * echo 1234567 >>/tmp/oldboy.txt 查看定时任务crontab -l 练习: 每隔两个小时,重启一下sshd服务 4)定时任务 一定要,命令行,先测试!!! 10 */2 * * * 每隔2小时的每分钟,都执行 5)定时任务的取值范围 * * * * * cmd 分 时 日 月 周 执行的命令 0-59 0-23 1-31 1-12 0-6 练习: 每周3,下午6点整,echo jiaozuoye 00 18 * * 3 6)注意 */3 每隔多久执行一次 7)例子: 每天下午的2点整和4点整,京东秒杀 echo jingdongmiaosha 00 14,16 * * * echo jingdongmiaosha 练习: 每年的3、6、11月份,1-7号,早上8点整到晚上8点整 echo 进行大酬宾 00 8-20 1-7 3,6,11 * echo dachoubin 8:注意事项 a.定时任务执行命令的时候,最好使用命令的决对路径。 b.定时任务一定要加注释!(君子协议) c.特殊符号需要转义;例子:* * * * * echo "`date +\%F\ \%T`" >>/tmp/time.txt d.最好不要让直行的命令,有输出,如果避免不了有输出,就把它定向到空(黑洞) e.定时任务中,严禁使用相对路径 f.尽量使用crontab -e命令来添加定时任务!因为crontab带有语法检查。 不加引号:只能输出单行文本;能解析变量 单引号: 可以输出多行文本; 不能解析变量,适合输出带有特殊符号的内容 双引号: 可以输出多行文本;能解析变量 标准输出:1>(默认就是标准输出) 错误输出:2> 黑洞:/dev/null 9:批量添加定时任务 crontab -e编辑定时任务,实际上就是编辑文件/var/spool/cron/root #上课 30 9 * * 0 /oldboy.sh &>/dev/null echo -e '#上课\n30 9 * * 6 /oldboy.sh &>/dev/null' >>/var/spool/cron/root 建个回收站recovery alias rm = "mv -f -t /recovery" 直接删除\rm \取消别名作用 crontab -e * */2 * * * \rm -rf /recovery/* #每两小时清空一次recovery minute hour day month dayofweek command minute是分钟,取值范围:0-59 hour段是小时。取值范围:0-23 day段是一个月中的第几天,取值范围:1-31 month是一年中的第几个月,取值范围:1-12 dayofweek是一个星期中的第几天,以星期天开始依次的取值为0~7,0、7都表示星期天。 command是定时运行的命令。 root表示以root用户身份来运行 run-parts表示后面跟着的是一个文件夹,要执行的是该文件夹下的所有脚本 所有可用值用 * 表示 整数间的连字号(-)表示整数列,例如1-4意思是整数1,2,3,4 指定数值由逗号分开。如:3,4,6,8表示这四个指定整数。 符号“/”指定步进设置。“/<interger>”表示步进值。如0-59/2定义每两分钟执行一次。步进值也可用星号表示。如*/3用来运行每三个月份运行指定任务。 以“#”开头的为注释行,不会被执行。 如果一个cron任务需要定期而不是按小时,天,周,月来执行,则需要添加/etc/cron.d目录。这个目录下的所有文件和文件/etc/crontab语法相同,查看样例: # record the memory usage of the system every monday # at 3:30AM in the file /tmp/meminfo 30 3 * * mon cat /proc/meminfo >> /tmp/meminfo # run custom scrīpt the first day of every month at 4:10AM 10 4 1 * * /root/scrīpts/backup.sh 除了root用户之外的用户可以执行crontab配置计划任务。所有用户定义的crontab存储在目录/var/spool/cron下,任务会以创建者的身份被执行。要以特定用户创建一个crontab,先以该用户登录,执行命令crontab -e,系统会启动在VISUAL或者EDITOR中指定的的编辑软件编辑crontab。文件内容与/etc/crontab格式相同。示例如下: 0 3 * * * /home/dbbackup/db1backup.sh backup 0 4 * * * /home/dbbackup/db2backup.sh backup 表示每天3点执行/home/dbbackup/db1backup.sh backup,4点执行/home/dbbackup/db2backup.sh backup,如果是每五分钟执行一次可改为: */5 * * * * /home/dbbackup/db2backup.sh backup 当更改的crontab需要保存时,文件会保存在成如下文件/var/spool/cron/username。文件名会根据用户名而不同。 cron服务会每分钟检查一次/etc/crontab、/etc/cron.d/、/var/spool/cron文件下的变更。如果发现变化,就会下载到存储器中。因此,即使crontab文件改变了,程序也不需要重新启动。推荐自定义的任务使用crontab -e命令添加,退出后用/etc/init.d/crond restart命令重启crond进程,官方文件说不用重启进程,但我遇到不重启无法运行任务的情况。开始不知道/etc/crontab文件中的run-parts是什么意思,直接把命令按照/etc/crontab的格式加上总是无法运行,后来才知道run-parts是指后面跟着的是文件夹。 四.crontab服务的启动关闭 sbin/service crond start //启动服务 /sbin/service crond stop //关闭服务 /sbin/service crond restart //重启服务 /sbin/service crond reload //重新载入配置

优秀的个人博客,低调大师

java基础学习_常用类小结

看看下面的类,是否都熟悉,简要说明每个类主要是干什么呢? Object:是类层次结构的根类,所有类都直接或者间接的继承自该类。 Scanner:获取键盘录入数据的类。 String:针对字符串的常见操作的类。 StringBuffer/StringBuilder:字符串缓冲区类,提高字符串的操作效率。 Arrays:针对数组进行操作的工具类。 Integer:把int基本数据类型封装成Integer引用数据类型,可以调用方法了,最主要作用是可以把String引用数据类型转换int基本数据类型了。 Character:把char基本类型封装成Character引用数据类型,可以调用方法了。了解几个方法就可以了。 Pattern:正则表达式的编译表示形式。模式对象。 Matcher:匹配器对象。 Math:针对数学运算操作的类。 Random:产生随机数的类。 System:系统类,提供了几个有用方法。 BigInteger:关于大整数的运算的类。 BigDecimal:关于浮点数的运算用这个,不会有精度的丢失。 Date:针对日期操作的类,可以精确到毫秒。 DateFormat:针对日期进行格式化或者针对字符串(文本)进行解析的类。 Calendar:日历类,把所有的日历字段(成员变量)进行了封装,要什么,自己使用获取方法,然后拼接。 Object:是类层次结构的根类,所有类都直接或者间接的继承自该类。 Scanner:获取键盘录入数据的类。 String:针对字符串的常见操作的类。 StringBuffer/StringBuilder:字符串缓冲区类,提高字符串的操作效率。 Arrays:针对数组进行操作的工具类。 Integer:把int基本数据类型封装成Integer引用数据类型,可以调用方法了,最主要作用是可以把String引用数据类型转换int基本数据类型了。 Character:把char基本类型封装成Character引用数据类型,可以调用方法了。了解几个方法就可以了。 Pattern:正则表达式的编译表示形式。模式对象。 Matcher:匹配器对象。 Math:针对数学运算操作的类。 Random:产生随机数的类。 System:系统类,提供了几个有用方法。 BigInteger:关于大整数的运算的类。 BigDecimal:关于浮点数的运算用这个,不会有精度的丢失。 Date:针对日期操作的类,可以精确到毫秒。 DateFormat:针对日期进行格式化或者针对字符串(文本)进行解析的类。 Calendar:日历类,把所有的日历字段(成员变量)进行了封装,要什么,自己使用获取方法,然后拼接。我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

02.Java基础(线程池)

执行异步任务的时候,如果只是new Thread,存在一下弊端 a. 每次new Thread新建对象性能差。 b. 线程缺乏统一管理,可能无限制新建线程,相互之间竞争,及可能占用过多系统资源导致死机或oom。 c. 缺乏更多功能,如定时执行、定期执行、线程中断。 Java本身提供了四种线程池 newCachedThreadPool 创建一个可缓存的线程池。如果线程池的大小超过了处理任务所需要的线程, 那么就会回收部分空闲(60秒不执行任务)的线程,当任务数增加时,此线程池又可以智 能的添加新线程来处理任务。此线程池不会对线程池大小做限制,线程池大小完全依赖于 操作系统(或者说JVM)能够创建的最大线程大小。 newCachedThreadPool是存在内存溢出安全隐患的,因为我们假设新建的线程都在工 作,newCachedThreadPool 只会重用空闲并且可用的线程,所以当所需线程数量足够大 时,会不停地创建新线程,在 64-bit JDK 1.7 中 -Xss 默认是 1024k,也就是 1M(一个线 程占用的空间大小),那就是需要 10000*1M = 10G 的堆外内存空间来给线程使用,就 会 发生OOM ExecutorService cachedThreadPool = Executors.newCachedThreadPool(); for (int i = 0; i < 10; i++) { final int index = i; try { Thread.sleep(index * 1000); } catch (InterruptedException e) { e.printStackTrace(); } cachedThreadPool.execute(new Runnable() { @Override public void run() { System.out.println(index); } }); newFixedThreadPool 创建一个定长线程池,可控制线程最大并发数,超出的线程会在队列中等待 ExecutorService fixedThreadPool = Executors.newFixedThreadPool(3); for (int i = 0; i < 10; i++) { final int index = i; fixedThreadPool.execute(new Runnable() { @Override public void run() { try { System.out.println(index); Thread.sleep(2000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } }); newScheduledThreadPool 创建一个定长线程池,支持定时及周期性任务执行 ScheduledExecutorService scheduledThreadPool = Executors.newScheduledThreadPool(5); scheduledThreadPool.schedule(new Runnable() { @Override public void run() { System.out.println("delay 3 seconds"); } }, 3, TimeUnit.SECONDS); scheduledThreadPool.scheduleAtFixedRate(new Runnable() { @Override public void run() { System.out.println("delay 1 seconds, and excute every 3 seconds"); } }, 1, 3, TimeUnit.SECONDS); newSingleThreadExecutor 创建一个单线程化的线程池,它只会用唯一的工作线程来执行任务,保证所有任务按照指定顺序(FIFO, LIFO, 优先级)执行 ExecutorService singleThreadExecutor = Executors.newSingleThreadExecutor(); for (int i = 0; i < 10; i++) { final int index = i; singleThreadExecutor.execute(new Runnable() { @Override public void run() { try { System.out.println(index); Thread.sleep(2000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } }); 相对于直接new Thread,线程池具有一下优点 a. 重用存在的线程,减少对象创建、消亡的开销,性能佳。 b. 可有效控制最大并发线程数,提高系统资源的使用率,同时避免过多资源竞争,避免堵塞。 c. 提供定时执行、定期执行、单线程、并发数控制等功能

优秀的个人博客,低调大师

objective-c内存管理基础

对于我们.net开发人员来说,.net为我们提供了自动内存管理的机制,我们不需去关心内存的管理。但是iphone开发中却是不能的。这篇文章将简述一下objective-c的内存管理机制和方法和一些特性。 手动的进行内存管理 Cocoa和Objective-C的类都是NSObject的子类。NSObject中有几个方法进行内存管理。alloc方法为对象分配一片内存空间。dealloc方法用于释放对象的空间。但是在我们的代码中将永远都不会使用dealloc方法,因为运行时会为你调用此方法释放内存空间。而你需要做的只是引用计数,稍后介绍什么是引用计数。 除了alloc和dealloc,NSObject的还有retain和release方法两个方法用于引用计数。retain方法给retainCount变量加1,release方法给retainCount变量减1。当使用alloc为对象分配一片内存空间的时候,retainCount会为1。在这个对象的生命周期内,这个对象可能继续被其它变量引用。但有新的变量指向这个对象的时候,你应该调用retain方法,这样运行时才会知道有新的引用指向了这个变量,在这个对象生存期中拥有它的使用权。这个被Objective-C开发人员称之为“拥有”。例如: Foo * myFooOne = [[Foo alloc] init]; // retaincount 为1 Foo * myFooTwo = myFooOne; // myFooTwo 指向了这个对象 // retaincount 仍然为1 [myFooTwo retain]; // 调用retain方法,运行时才知道myFooTwo指向了该对象,retaincount 为2 上面的代码中,myFooTwo通过调用retain方法,取得了Foo对象的拥有权。在这个对象的生命周期中,会有很多变量来指向和引用它。指向这个对象的变量也可以通过release方法来解除这种拥有权。release方法将会告诉运行时,我已经使用完这个变量了,已经不需要它了,retainCount计数减1。 当对象的retainCount的计数大于或者等于1的时候,运行时会继续维持这个对象。当对象的retainCount为0的时候,运行时会释放这个对象,并回收它占得内存空间。 下图展示了一个Foo对象的生命周期。Foo对象首先在内存中分配一个内存空间,并且被myFooOne引用。在这个时候Foo对象的retaincount为1。 Foo * myFooOne = [[Foo alloc] init]; 第二个引用变量指向Foo对象,这个引用变量接着调用retain方法,其实也是调用Foo对象的retain方法。Foo对象的retaincount变成2。 Foo * myFooTwo = myFooOne; [myFooTwo retain]; 接着当myFooOne引用不需要的时候,通过调用release方法,解除与Foo对象的拥有权,Foo对象的retaincount变成1。 [myFooOne release]; 但myFooTwo不在需要的时候,同样通过调用release方法,解除与Foo对象的拥有权,Foo对象的retaincount变成0。 内存泄露 我们经常会在一个方法中声明对象,看下面这个例子: - ( void ) myMethod { // incorrect method NSString * myString = [[NSString alloc] init]; // retainCount = 1 Foo * myFoo = [[Foo alloc] initWithName:myString]; // retainCount = 1 NSLog( @" Foo's Name:%@ " , [myFoo getName]); } 这上面这个方法中,我们为myString 和myFoo分配了内存空间。方法执行结束之后,两个变量超出了作用域的范围,所以不再有效。但是这个方法并没有releases这两个对象。所以运行时没有释放这两个变量占据的内存空间。除非你的应用程序结束,否则这两个变量占据的内存空间一直都是不可用的。我们把它称之为内存泄露。 为了防止内存泄露。无论什么时候,我们创建一个对象,或者创建一个对象的拷贝,我们都必须通过release方法释放。 - ( void ) myMethod { NSString * myString = [[NSString alloc] init]; // retainCount=1 Foo * myFoo = [[Foo alloc] initWithName:myString]; // retainCount=1 NSLog( " Foo's Name:%@ " , [myFoo getName]); [myFoo release]; // retainCount=0 so deallocate [myString release]; // retainCount=0 so deallocate } 弱引用 看下面的例子: - ( void ) myMethod { // an incorrect method Foo * myFooOne = [[Foo alloc] initWithName: @" James " ]; // retainCount=1 Foo * myFooTwo = myFooOne; // retainCount still 1 [myFooOne release]; // retaincount=0 so deallocated NSLog( " Name:%@ " , [myFooTwo printOutName]); // runtime error } nyFooTwo指向了Foo对象,但是没有调用retain方法,就是一种弱引用,上面的代码会在运行时报错。因为myFooOne调用release方法。retaincount变成0,运行时,回收了对象的内存空间。然后myFooTwo调用printPutName自然就报错了,见下图说明。 总结:本文简单的介绍了一下手动的进行内存管理、内存泄露、弱引用等objective-c的知识。 本文转自麒麟博客园博客,原文链接:http://www.cnblogs.com/zhuqil/archive/2011/03/16/1986420.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

2-openstack基础环境准备

说明: linux-node1 控制节点 linux-node2 计算节点 2.1.两台centos7服务器 1 2 3 4 5 主机名: [root@linux-node1~] #hostname linux-node1 [root@linux-node2~] #hostname linux-node2 1 2 3 IP: linux-node1192.168.56.11 /24 linux-node2192.168.56.12 /24 1 2 3 4 5 6 host解析 cat /etc/hosts 127.0.0.1localhostlocalhost.localdomainlocalhost4localhost4.localdomain4 ::1localhostlocalhost.localdomainlocalhost6localhost6.localdomain6 192.168.56.11linux-node1linux-node1.oldboyedu.com 192.168.56.12linux-node2linux-node2.oldboyedu.com 2.2 selinux 和防火墙关闭 1 2 3 4 5 6 7 8 9 [root@linux-node2~] #getenforce Disabled [root@linux-node1~] #getenforce Disabled #可以用sed sed -i '/SELINUX/s/enforcing/disabled/' /etc/selinux/config 防火墙: systemctlstopfirewalld systemctldisablefirewalld 2.3 配置时间同步(两台都做) 1 2 3 4 5 6 yum–y install chrony grep "allow" /etc/chrony .conf #打开 allow192.168 /16 systemctl enable chronyd.service #设置开机自启 systemctlstartchronyd.service #启动 timedatectl set -timezoneAsia /Shanghai #同步时区 2.4 在linux-node1 上安装数据库 1 2 3 4 5 6 7 8 9 10 11 yum install -ymariadbmariadb-serverMySQl-python #安装数据库 \ cp /usr/share/mysql/my-medium .cnf /etc/my .cnf #拷贝配置文件 在 vi /etc/my .cnf添加如下几行 [mysqld] default-storage-engine=innodb #默认的存储引擎 innodb_file_per_table #使用独享的表空间 collation-server=utf8_general_ci #设置校对规则 init-connect= 'SETNAMESutf8' #设置链接的字符集 character- set -server=utf8 #设置默认的字符集 systemctl enable mariadb.service #开机启动数据库 systemctlstartmariadb.service #立马启动数据库 2.5 初始化数据库 2.6 为各个组件创建数据库并收授权 2.6.1 keystone 1 2 3 4 5 6 MariaDB[(none)]>createdatabasekeystone; QueryOK,1rowaffected(0.01sec) MariaDB[(none)]>grantallonkeystone.*to 'keystone' @ 'localhost' identifiedby 'keystonne' ; QueryOK,0rowsaffected(0.00sec) MariaDB[(none)]>grantallonkeystone.*to 'keystone' @ '%' identifiedby 'keystone' ; QueryOK,0rowsaffected(0.00sec) 2.6.2 glance 1 2 3 4 5 MariaDB[(none)]>createdatabaseglance; QueryOK,1rowaffected(0.00sec) MariaDB[(none)]>grantallonglance.*to 'glance' @ '%' identifiedby 'glance' ; QueryOK,0rowsaffected(0.00sec) MariaDB[(none)]>grantallonglance.*to 'glance' @ 'localhost' identifiedby 'glance' ; 2.6.3 nova和nova_api 1 2 3 4 5 6 7 8 9 10 11 MariaDB[(none)]>createdatabasenova; QueryOK,1rowaffected(0.00sec) MariaDB[(none)]>grantallonnova.*to 'nova' @ '%' identifiedby 'nova' ; QueryOK,0rowsaffected(0.00sec) MariaDB[(none)]>grantallonnova.*to 'nova' @ 'localhost' identifiedby 'nova' ; QueryOK,0rowsaffected(0.00sec) MariaDB[(none)]>createdatabasenova_api; QueryOK,1rowaffected(0.00sec) MariaDB[(none)]>grantallonnova_api.*to 'nova' @ 'localhost' identifiedby 'nova' ; QueryOK,0rowsaffected(0.00sec) MariaDB[(none)]>grantallonnova_api.*to 'nova' @ '%' identifiedby 'nova' ; 2.6.4 neutron 1 2 3 4 5 6 7 8 MariaDB[(none)]>createdatabaseneutron; QueryOK,1rowaffected(0.00sec) MariaDB[(none)]>grantallonneutron.*to 'neutron' @ '%' identifiedby 'neutron' ; QueryOK,0rowsaffected(0.00sec) MariaDB[(none)]>grantallonneutron.*to 'neutron' @ 'localhost' identifiedby 'neutron' ;; QueryOK,0rowsaffected(0.00sec) MariaDB[(none)]>flushprivileges; QueryOK,0rowsaffected(0.00sec) 2.6.5 检验数据库 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 MariaDB[(none)]>showdatabases; +--------------------+ |Database| +--------------------+ |information_schema| |glance| |keystone| |mysql| |neutron| |nova| |nova_api| |performance_schema| +--------------------+ 8rowsinset(0.00sec) MariaDB[(none)]> 2.7 安装消息队列(rabbitmq) 2.7.1 基本安装 1 2 3 4 5 6 7 8 9 10 11 yuminstallrabbitmq-server-y systemctl enable rabbitmq-server.service systemctlstartrabbitmq-server.service [root@linux-node1~] #rabbitmqctladd_useropenstackopenstack#创建消息队列认证用户 Creatinguser "openstack" ... ... done . [root@linux-node1~] # #创建的用户得授权才能使用 [root@linux-node1~] #rabbitmqctlset_permissionsopenstack".*"".*"".*"#授权用户才能使用 Settingpermissions for user "openstack" in vhost "/" ... ... done . 2.7.2 web界面安装 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 查看组件 [root@linux-node1~] #rabbitmq-pluginslist []amqp_client3.3.5 []cowboy0.5.0-rmq3.3.5-git4b93c2d []eldap3.3.5-gite309de4 []mochiweb2.7.0-rmq3.3.5-git680dba8 []rabbitmq_amqp1_03.3.5 []rabbitmq_auth_backend_ldap3.3.5 []rabbitmq_auth_mechanism_ssl3.3.5 []rabbitmq_consistent_hash_exchange3.3.5 []rabbitmq_federation3.3.5 []rabbitmq_federation_management3.3.5 []rabbitmq_management3.3.5 []rabbitmq_management_agent3.3.5 []rabbitmq_management_visualiser3.3.5 []rabbitmq_mqtt3.3.5 []rabbitmq_shovel3.3.5 []rabbitmq_shovel_management3.3.5 []rabbitmq_stomp3.3.5 []rabbitmq_test3.3.5 []rabbitmq_tracing3.3.5 []rabbitmq_web_dispatch3.3.5 []rabbitmq_web_stomp3.3.5 []rabbitmq_web_stomp_examples3.3.5 []sockjs0.3.4-rmq3.3.5-git3132eb9 []webmachine1.10.3-rmq3.3.5-gite9359c7 加载组件 rabbitmq-plugins enable rabbitmq_management systemctlrestartrabbitmq-server.service #重启消息队列 说明 rabbitmq监听的是5672 rabbitmq的管理界面监听的是15672 2.7.3 访问测试 默认是用户guest 密码是guest 让openstack用户拥有admistrator的权限进行登录 本文转自 小小三郎1 51CTO博客,原文链接:http://blog.51cto.com/wsxxsl/1883586,如需转载请自行联系原作者

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册