首页 文章 精选 留言 我的

精选列表

搜索[API选型],共10000篇文章
优秀的个人博客,低调大师

JEDI项目重新选型,全球云计算市场迎来新竞争

近日,美国国防部宣布取消早前与微软达成的价值100亿美元(分10年投入)的云计算合同——联合企业防御基础设施(The Joint Enterprise Defense Infrastructure,简称JEDI)。这份合同的取消,终于给长达三年的“云巨头争夺云大单”事件画上了句号。但这场围绕云计算项目的争夺战还未完全结束。美国国防部表示仍然需要企业级的云能力支持,将继续调研其他公司,以考察是否能够满足自身需要。 美国国防部代理首席信息官约翰·谢尔曼表示,整个招标期最长可达五年,并且不会锁定之前100亿美元的金额,将在2025年年初对多个供应商展开“全面和公开”的筛选。 这份利润丰厚的JEDI合同,对五角大楼来说,实现的是IT运营现代化;对中标的企业来说,是由此带来的对公司的肯定。近年来,规模较大的科技巨头都将触角伸向自身领域之外的多个行业,云计算早已成为一个竞争激烈的市场。 新一轮争夺战开打 美国国防部对撤销与微软的这份合同做了解释——由于不断变化的需求、云技术的发展和行业的进步,JEDI需要进行更新补充。于是新的合同又被提出,名为“联合作战人员云能力”(Joint Warfighter Cloud Capability,简称JWCC)。 美国消费者新闻与商业频道(CNBC)称,美国国防部计划向亚马逊和微软征求新合同提案,并称它们是唯一能够满足其需求的云服务提供商。但是,美国国防部也表示将继续进行新的市场研究,考察谷歌、甲骨文、IBM等云服务商是否也能满足其要求。 JEDI合同于2018年7月首次发布,主要涉及五角大楼数字化建设的内容,包括使用更快捷的数据访问及云计算服务。2019年微软击败亚马逊获得了云计算的合同,此前,市场普遍预计亚马逊会是这一合同的获得者,因为当时亚马逊是最大的云计算提供商,微软因起步较晚在云计算领域一直处于追赶状态。 一个月后,亚马逊的云计算部门向美国联邦索赔法院提起诉讼,质疑时任美国总统特朗普因对公司首席执行官贝索斯的偏见而向美国国防部施加了不当压力,进而导致亚马逊没有获得该合同。去年,美国国防部发布报告称,该合同似乎并未受到白宫的影响。不过今年4月,一名法官拒绝驳回亚马逊的指控,称特朗普政府在2020年2月无限期搁置美国国防部对微软的决定后干预了该决定。 根据路透社的报道,特朗普政府时期希望JEDI合同只有一家供应商,但拜登政府可能会将该合同分给多家公司,以避免一家企业独享合同的局面。从2018年到2021年,从选择单一云服务提供商到尝试调研多云方案,多云策略在服务交付、安全性和降低成本等方面的优势正在受到全球大部分企业的关注,从某种程度上也正在引领新一轮的云计算市场争夺。 市场猛增群雄逐鹿 过去十年,很少有什么东西能像“云”这样让人们魂牵梦萦。 根据国际研究机构Gartner发布的最新研究报告,全球云计算IaaS市场在2020年猛增40.7%,达到643亿美元,高于2019年的457亿美元。 从市场格局看,全球云计算市场目前由美国三大科技巨头亚马逊、微软和谷歌以及中国的阿里巴巴主导。亚马逊AWS在2020年依然占据云计算市场第一的宝座,微软Azure、阿里云、谷歌云和华为云紧随其后,五大云计算提供商共拥有80%的市场份额。 根据英国《经济学人》杂志的文章,云计算大约于15年前开始腾飞,那时诸多企业开始将它们的主机托管,并将数据中心、核心计算机系统和许多应用外包给几个大型供应商,特别是亚马逊的AWS这一先行者。 新冠肺炎疫情更是凸显了云的重要性,经济运行的许多主要功能都依赖于它,包括各种电子商务网站和让人们可以居家办公的应用。云计算规模巨大,企业所有技术支出的近10%都花在了云上。这一领域的投资占比也一样。AWS等公司去年在数据中心和其他实体设备上的投入高达约400亿美元。 云带来的好处显而易见。使用云服务的公司可以用可变的服务费替代在传统定制的IT系统上的大笔资金支出,而且云服务可以轻松按需扩展,每个基础设施都有大量用户。这也是ZOOM之类的公司在疫情封锁期间成长如此之快的原因之一。 如今,亚马逊的AWS依然是最大的云计算公司,但是微软正通过自己的云计算服务Azure掀起一场激烈的竞争;谷歌在2017年就把之前的各种零星的云产品整合起来,正式推出云平台;IBM也分拆部分服务业务专注于“多云”;甲骨文想要收购社交媒体TikTok,原因之一是想为其新生的云计算业务争取到一家旗舰客户;苹果公司今年的谷歌云预算为3亿美元,相比去年增加了50%。除谷歌云外,苹果还使用亚马逊云和自己的数据中心(比如其数据储存应用iCloud)来处理呈井喷状态的服务需求。 企业“不能承受之重” 蜂拥挤入“云”时代的步伐几乎没有放缓的趋势。据数据采集公司Gartner预测,今年全球云服务市场的支出将同比增加近1/4,总额超3300亿美元。 然而就是在这样的大环境下,风险投资公司安德森·霍洛维茨(Andreessen Horowitz)却认为,“云”成本可能成为大公司不能承受之重。该公司高管马丁·卡萨多还在社交媒体上说,企业会面临左右为难的困境——不使用云,不明智;使用云,同样不明智。安德森·霍洛维茨还提出了一个让企业在未来几年必须思考的问题:若将所有数据(数字经济的命脉)都托付给寡头垄断的云服务商,那么企业对云成本还有控制权吗? 就在安德森·霍洛维茨发表此番言论的同一天,一家大型软件公司的首席运营官称,目前“云”端成本持续高涨,对公司来说并非长久之计,但单纯抛弃“云”服务也不可取。“这个抉择很艰难,一家公司不可能永远使用云服务,也不可能永远不使用云服务”。 安德森·霍洛维茨为减少云成本的支出做了一个假设,即“云回迁”——企业可以把保存在云端的数据移回本地服务器,这样能节省巨额开支。他引用了文件共享公司Dropbox的真实案例:该公司2017年披露,其在首次公开募股之前的两年内,省下了高达7500万美元成本,这主要就是通过撤回云端负载实现的。如果50家上市软件公司效仿Dropbox的做法,那么它们的云服务开销就能减半——每年可节省40亿美元。以当前可观的市盈率估计,此举能为上述公司增加约1000亿美元市值。 但《经济学人》表示,这个想法在许多方面都过于简单化了。首先,云服务绝非只意味着高昂的开支。云服务具有的灵活性能省却购买机架、服务器、电线和插头等琐事,从而使新公司实现快速扩张,从而加速发布新产品进程以及开拓国际市场。从这个角度来看,云服务在拉动企业营收方面功不可没。此外,云服务供应商能提供的服务绝不止于存储和备用容量。数据分析、预测和机器学习日益成为云服务商最具价值的服务,这恰恰得益于他们所能快速处理的海量数据。而且,他们往往更不容易遭遇黑客的入侵。所以,究竟是花钱购买云服务,还是聘请工程师搭建内部数据中心并自行解决网络安全问题,归根结底取决于哪个回报更高。 其次,从事云服务的工程师有限。在过去,程序员们接受的训练都基于使用本地服务器,而如今,新生代则更擅长使用云服务。流媒体音乐公司Spotify强调说,使工程师们忙于维护内部数据中心而非开发新产品的机会成本过高。 此外,对于云服务能否带来利润,看法因人而异。大多数公司本希望通过降低租用云服务器的成本来提高利润率,但是建立自己的数据中心却需要大量投资。与此同时,人力成本也将随着雇佣工程师的增多并需要进行管理而增加。 《经济学人》指出,上“云”的公司越多,成本控制就越需谨小慎微。一些大用户,如苹果公司,能争取到巨大折扣,而较小的公司则缺乏这种强大的议价能力。为维持低成本,小公司可能需要依托于内部基本储存,并将数据计算分散到多个云端来实现 “多云”架构,让工程师对“云”开支负责。如果足够幸运的话,将能够出现取代最大云端商们的低成本替代方案,就像日本汽车公司向底特律三巨头发起挑战一样。 然而,该过程花了半个世纪才得以实现。不过,总的来说,云市场的繁荣意味着选择更多、价格更低。 【责任编辑:未丽燕 TEL:(010)68476606】
优秀的个人博客,低调大师

从零入门 Serverless | 一文详解 Serverless 技术选型

作者 | 李国强 阿里云资深产品专家 本文整理自《Serverless 技术公开课》。关注“Serverless”公众号,回复“入门”,即可获取 Serverless 系列文章 PPT。 今天来讲,在 Serverless 这个大领域中,不只有函数计算这一种产品形态和应用类型,而是面向不同的用户群体和使用习惯,都有其各自适用的 Serverless 产品。例如面向函数的函数计算、面向应用的 Serverless 应用引擎、面向容器的 Serverless Kubernetes,用户可以根据自己的使用习惯、使用场景或者应用类型,去选择使用什么样的 Serverless 产品。下面通过本文给大家介绍一下,阿里云都有哪些可供大家选择的 Serverless 产品。 Serverless 产品及分层 众所周知,最早提出 Serverless 的

优秀的个人博客,低调大师

选型宝访谈:怎样构建端到端的IT透视能力?

前言 随着移动互联网和云计算时代的到来,企业数字化转型和“互联网+”成为新的热潮,今天的IT系统,变得越来越复杂,越来越重要,用户对体验的要求也越来越高,传统碎片化的、面向IT的运维和性能管理工具,越来越难以满足今天我们对业务稳定性和卓越用户体验的要求。在这样的背景下,一些新的理念和工具应运而生了,比如DEM。那么,DEM到底是怎样一个概念,包含哪些具体功能,它和传统的NPM、AMP有什么不同? 什么是DEM?今天,是什么原因让DEM变得如此重要?DEM能为企业带来怎样的价值? DEM的字面意思是数字体验管理(Digital Experience Management)。DEM并不是一个凭空而来的全新概念。在传统的数据中心机房里,或多或少都运行着一些NPM(网络性能管理)和APM(应用性能管理)工具,但一直以来,这些运维工具都是碎片化的、独立工作的,相互之间无法协同、无法集成。随着云计算和移动互联网时代的到来,企业的IT架构变得越来越复杂,IT基础设施变得越来越分散,出现了像“微服务”这样新的IT能力交付方式。在这样的情况下,传统单打独斗的性能管理工具,就显得越来越捉襟见肘、力不从心了。特别是最近几年,数字化转型的浪潮席卷全球,企业传统业务数字化、云化、互联网化成为大所趋。今天,越来越多的交易会借助数字化系统来达成,通过互联网连接的终端用户数量也出现了爆炸式增长。在“体验为王”的时代,IT系统的1毫秒延迟,都可能为企业造成数百万美元的经济损失或数十万客户的流失。 在这样的背景下,企业亟需一种从用户体验出发、具备全局视角、可以为业务提供更好支持的新一代性能管理解决方案,这就是我们倡导的“数字体验管理”。数字体验管理通过全面管理整个开发周期和应用交付链的数字体验,可以向所有应用和设备的用户提供完整的、一致的、卓越的数字体验。通过提供从终端用户、网络、基础架构到应用的全面视图,DEM让企业的IT系统和终端用户体验变得更加透明可控。DEM是NPM和APM的延伸和发展,它通过提升IT性能和用户体验、可以帮助企业在激烈的市场竞争中获得优势,同时,它也是确保企业数字化转型成功的重要基础。

优秀的个人博客,低调大师

详解主流分布式架构选型与高可用设计

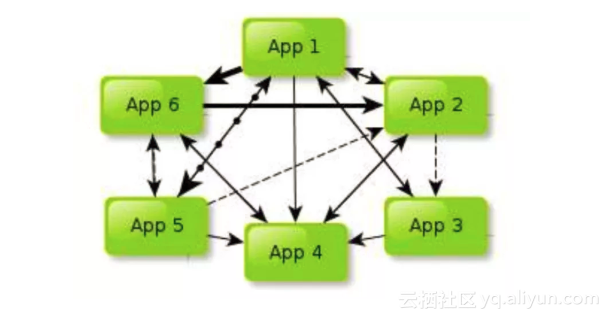
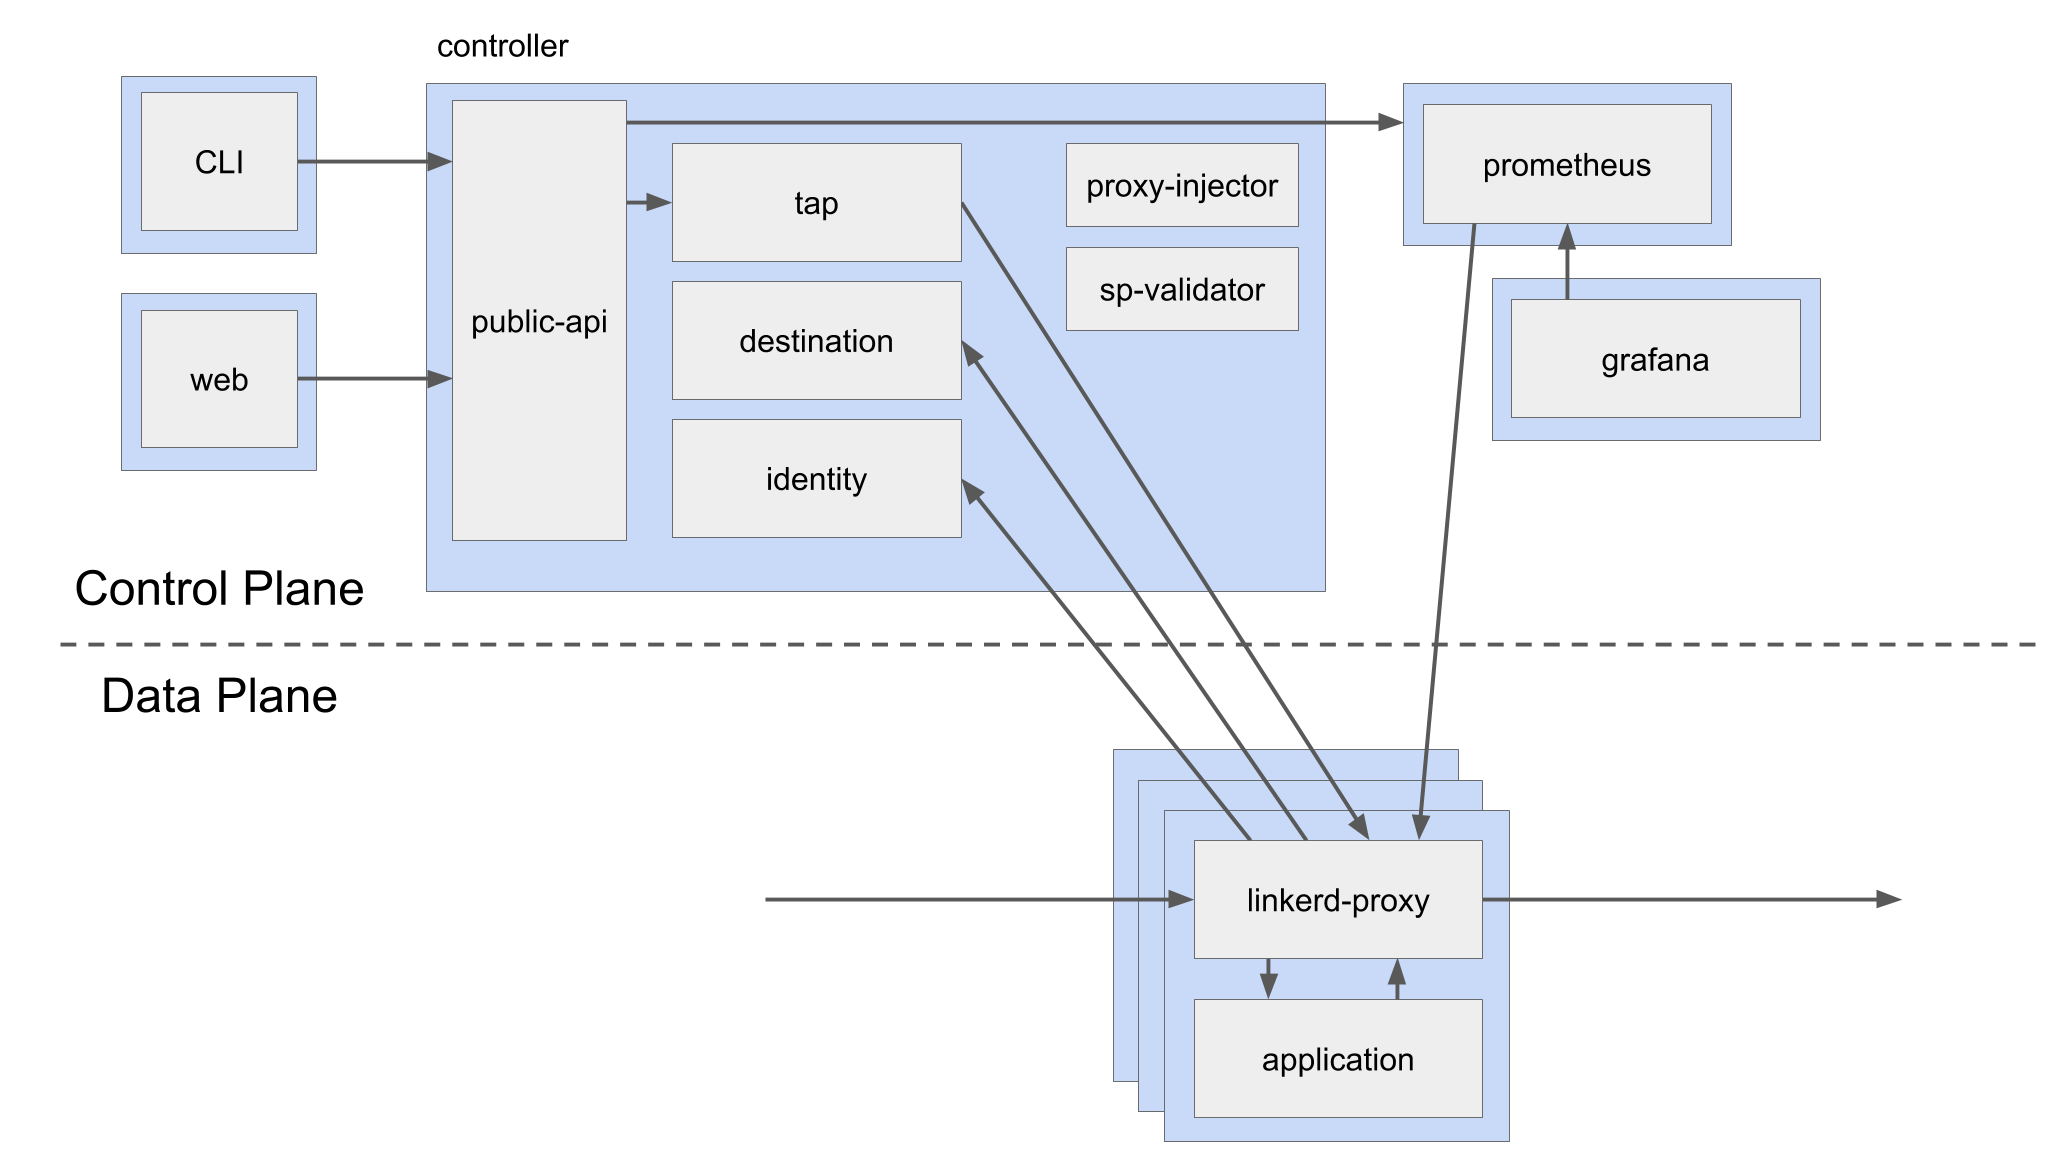
本文主要分享目前主流的分布式架构、分布式架构中常见理论以及如何才能设计出高可用的分布式架构。 分布式架构中,SOA和微服务架构是最常见两种分布式架构,而且目前服务网格的概念也越来越火了,那本文就先从这些常见架构开始说起。 一、SOA架构解析 SOA(Service Oriented Architecture)的中文释义为 “面向服务的架构”,是一种设计理念,其中包含多个服务,服务之间通过相互依赖最终提供一系列完整的功能。各个服务通常以独立的形式部署运行,服务之间通过网络进行调用。架构图如下: 跟SOA相提并论的还有一个ESB(企业服务总线),简单来说ESB就是一根管道,用来连接各个服务节点。ESB的存在是为了集成基于不同协议的不同服务,ESB做了消息的转化、解释以及路由的工作,以此来让不同的服务互联互通;随着我们业务的越来越复杂,会发现服务越来越多,SOA架构下,它们的调用关系会变成如下形式: 很显然,这样不是我们所想要的,那这时候如果我们引入ESB的概念,项目调用就又会很清晰,如下: SOA所要解决的核心问题 系统间的集成:我们站在系统的角度来看,首先要解决各个系统间的通信问题,目的是将原先系统间散乱、无规划的网状结构,梳理成规整、可治理的星形结构。这一步的实现往往需要引入一些概念和规范,比如ESB、以及技术规范、服务管理规范,这一步解决的核心问题是有序。 系统的服务化:我们站在功能的角度,需要把业务逻辑抽象成可复用、可组装的服务,从而通过服务的编排实现业务的快速再生,目的是要把原先固有的业务功能抽象设计为通用的业务服务、实现业务逻辑的快速复用,这步要解决的核心问题是复用。 业务的服务化:我们站在企业的角度,要把企业职能抽象成可复用、可组装的服务,就要把原先职能化的企业架构转变为服务化的企业架构,以便进一步提升企业的对外服务的能力。前面两步都是从技术层面来解决系统调用、系统功能复用的问题。而本步骤则是以业务驱动把一个业务单元封装成一项服务,要解决的核心问题是高效。 二、微服务架构解析 微服务架构和SOA架构非常类似,微服务只是的SOA升华,只不过微服务架构强调的是“业务需要彻底的组件化及服务化”,原单个业务系统会被拆分为多个可以独立开发、设计、部署运行的小应用。这些小应用间通过服务化完成交互和集成。组件表示的就是一个可以独立更换和升级的单元,就像PC中的CPU、内存、显卡、硬盘一样,独立且可以更换升级而不影响其他单元。 若我们把PC中的各个组件以服务的方式构建,那么这台PC只需要维护主板(可以理解为ESB)和一些必要的外部设备就可以。CPU、内存、硬盘等都是以组件方式提供服务,例如PC需要调用CPU做计算处理,只需知道CPU这个组件的地址就可以了。 微服务的特征: 通过服务实现组件化 按业务能力来划分服务和开发团队 去中心化 基础设施自动化(DevOps、自动化部署) 三、SOA和微服务架构的差别 微服务不再强调传统SOA架构里面比较重的ESB企业服务总线,同时以SOA的思想进入到单个业务系统内部实现真正的组件化。 Docker容器技术的出现,为微服务提供了非常便利的条件,比如更小的部署单元,每个服务可以通过类似Spring Boot或者Node等技术独立运行。 还有一个点大家应该可以分析出来,SOA注重的是系统集成,而微服务关注的是完全分离。 四、服务网格架构解析 17 年年底,非侵入式的 Service Mesh 技术慢慢走向了成熟。Service Mesh ,中文释义“服务网格”,作为服务间通信的基础设施层在系统中存在。 如果要用一句话来解释什么叫 Service Mesh,我们可以将它比作是应用程序或者说微服务间的 TCP/IP,负责服务间的网络调用、熔断、限流和监控。 我们都知道在编写应用程序时程序猿一般都无须关心TCP/IP这一层(比如提供HTTP协议的Restful应用),同样如果使用服务网格我们也就不需要关心服务间的那些原来是由应用程序或者其他框架实现的事情(熔断、限流、监控等),现在只要交给Service Mesh就可以了。服务网格架构图如下: 目前流行的Service Mesh开源软件有Linkerd、Envoy和Istio,而最近Buoyant(开源Linkerd的公司)又发布了基于Kubernetes的Service Mesh开源项目Conduit。 关于微服务和服务网格的区别,我这样理解:微服务更注重服务之间的生态,专注于服务治理等方面,而服务网格更专注于服务之间的通信,以及和DevOps更好的结合等。 服务网格的特征: 应用程序间通讯的中间层 轻量级网络代理 应用程序无感知 解耦应用程序的重试/超时、监控、追踪和服务发现 五、分布式架构的基本理论 在说CAP、BASE理论之前,我们先要了解下分布式一致性的问题。实际上对于不同业务的服务,我们对数据一致性的要求是不一样的,如12306,它要求数据的严格一致性,不能把票卖给用户以后却发现没有座位了;再比如银行转账,我们通过银行转账的时候,一般都会收到一个提示:转账申请将会在 24 小时内到账。实际上这个场景满足的是最终钱只要转账成功了即可,同时如果钱没汇出去还要保证资金不丢失。所以说,用户在使用不同的服务的时候对数据一致性的要求是不一样的。 关于分布式一致性问题 分布式系统中要解决的一个非常重要的问题就是数据的复制。在我们的日常开发经验中,相信大多数开发人员都遇过这样的问题:在做数据库读写分离的场景中,假设客户端A将系统中的一个值V由V1变更为V2,但客户端B无法立即读取到V的最新值,需要在一段时间之后才能读取到。 这再正常不过了,因为数据库复制之间是存在延时的。 所谓分布式一致性的问题,就是指在分布式环境中引入数据复制机制后,不同数据节点之间可能会出现的、且无法依靠计算机应用程序自身解决的数据不一致的情况。 简单来说,数据一致性就是指在对一个副本数据进行变更的时候,必须确保也能够更新其它的副本,否则不同副本之间的数据将出现不一致。 那么如何去解决这个问题呢? 按照正常的思路,我们可能会想到既然是网络延迟导致的问题,那么我们就把同步动作进行阻塞,用户2在查询的时候必须要等数据同步完成以后再来做。但这个方案会非常影响性能。如果同步的数据比较多或比较频繁,那么阻塞操作可能会导致整个新系统不可用。故我们没有办法找到一种既能够满足数据一致性、又不影响系统性能的方案,所以就诞生了一个一致性的级别: 强一致性:这种一致性级别是最符合用户直觉的,它要求系统写入的是什么,读出来的也要是什么,用户体验好,但实现起来往往对系统的性能影响较大; 弱一致性:这种一致性级别约束了系统在写入成功后,不保证立即可以读到写入的值,也不保证多久之后数据能够达到一致,但会尽可能地保证到某个时间级别(如秒级别)后,数据能够达到一致状态; 最终一致性:最终一致性其实是弱一致性的一个特例,系统会保证在一定时间内,能够达到数据一致的状态。这里之所以将最终一致性单独提出来,是因为它是弱一致性中非常推崇的一种一致性模型,也是业界在大型分布式系统的数据一致性上用的比较多的一致性模型。 CAP 理论 它是一个经典的分布式系统理论。CAP 理论告诉我们:一个分布式系统不可能同时满足一致性(C:Consistency)、可用性(A:Availability)及分区容错性(P:Partition tolerance)这三个基本要求,最多只能同时满足其中两项。 CAP理论在互联网界有着广泛的知名度,也被称为“帽子理论”,它是由Eric Brewer教授在2000年举行的ACM研讨会提出的一个著名猜想:一致性(Consistency)、可用性(Availability)、分区容错 (Partition-tolerance)三者无法在分布式系统中被同时满足,并且最多只能满足两个。 一致性:所有节点上的数据时刻保持同步 可用性:每个请求都能接收一个响应,无论响应成功或失败 分区容错:系统应该持续提供服务,即使系统内部(某个节点分区)有消息丢失。比如交换机失败、网址网络被分成几个子网,形成脑裂、服务器发生网络延迟或死机,导致某些Server与集群中的其他机器失去联系。 分区是导致分布式系统可靠性问题的固有特性,从本质上来看,CAP理论的准确描述不应该是从3个特性中选取两个,所以我们只能被迫适应,根本没有选择权。CAP并不是一个普适性原理和指导思想,它仅适用于原子读写的NoSQL场景中,并不适用于数据库系统。 BASE 理论 从前面的分析中我们知道:在分布式(数据库分片或分库存在的多个实例上)前提下,CAP理论并不适合数据库事务,因为更新一些错误的数据而导致的失败,无论使用什么高可用方案都是徒劳的,因为数据发生了无法修正的错误。 此外,XA事务虽然保证了数据库在分布式系统下的 ACID (原子性、一致性、隔离性、持久性)特性,但同时也带来了一 些性能方面的代价,对于并发和响应时间要求都比较高的电商平台来说,是很难接受的。 eBay尝试了另外一条完全不同的路,放宽了数据库事务的ACID要求,提出了一套名为BASE的新准则。BASE全称为Basically Available,Soft-state,Eventually Consistent。系统基本可用、软状态、数据最终一致性。相对于CAP来说,它大大降低了我们对系统的要求。 Basically Available(基本可用) 表示在分布式系统出现不可预知的故障时,允许瞬时部分可用性: 比如我们在淘宝上搜索商品,正常情况下是在0.5s内返回查询结果,但是由于后端的系统故障导致查询响应时间变成了2s; 再比如数据库采用分片模式,100W个用户数据分在5个数据库实例上,如果破坏了一个实例,那么可用性还有80%,也就是80%的用户都可以登录,系统仍然可用; 电商大促时,为了应对访问量激增,部分用户可能会被引导到降级页面,服务层也可能只提供降级服务。这就是损失部分可用性的体现。 Soft-state(软状态) 表示系统中的数据存在中间状态,并且这个中间状态的存在不会影响系统的整体可用性,也就是表示系统允许在不同节点的数据副本之间进行数据同步过程中存在延时;比如订单状态,有一个待支付、支付中、 支付成功、支付失败,那么支付中就是一个中间状态,这个中间状态在支付成功以后,在支付表中的状态同步给订单状态之前,中间会存在一个时间内的不一致。 Eventually consistent(数据的最终一致性) 表示的是所有数据副本在一段时间的同步后最终都能达到一个一致的状态,因此最终一致性的本质是要保证数据最终达到一致,而不需要实时保证系统数据的强一致。 BASE理论的核心思想是:即使无法做到强一致性,但每个应用都可以根据自身业务特点,采用适当的方式来使系统达到最终一致性。 六、分布式架构下的高可用设计 避免单点故障 负载均衡技术(Failover、选址、硬件负载、软件负载、去中心化的软件负载(Gossip(Redis- Cluster))) 热备(Linux HA) 多机房(同城灾备、异地灾备) 应用的高可用性 故障监控(系统监控(CPU、内存)/链路监控/日志监控)自动预警 应用的容错设计、(服务降级、限流)自我保护能力 数据量(数据分片、读写分离) 分布式架构下的可伸缩设计 垂直伸缩 提升硬件能力 水平伸缩 增加服务器 加速静态内容访问速度的CDN CDN全称是Content Delivery Network,中文释义是内容分发网络。CDN的作用是把用户需要的内容分发到离用户最近的地方进行响应,这样用户能够快速获取所需要的内容。CDN本质上就是一种网络缓存技术,能够把一些相对稳定的资源放到距离最终用户较近的地方,一方面可以节省整个广域网的带宽消耗,另外一方面也可以提升用户的访问速度、改善用户体验。 现实系统中我们一般会把静态的文件(图片、脚本、静态页面等)放到CDN中。 当用户访问网站页面上的内容URL,经过本地DNS系统解析,DNS系统最终会将域名的解析权交给CNAME指向的CDN专用DNS服务器; CDN的DNS服务器将CDN的全局负载均衡设备IP地址返回用户; 用户向CDN的全局负载均衡设备发起内容URL访问请求; CDN全局负载均衡设备根据用户IP地址,以及用户请求的内容URL, 选择一台用户所属区域的区域负载均衡设备,告诉用户向这台设备发起请求; 区域负载均衡设备会为用户选择一台合适的缓存服务器提供服务。 选择的依据包括:根据用户IP地址,判断哪一台服务器距离用户最近。根据用户所请求的URL中携带的内容名称,判断哪一台服务器上有用户所需内容;查询各个服务器当前的负载情况,判断哪一台服务器上有服务能力。基于以上条件的综合分析之后,区域负载均衡设备会向全局负载均衡设备返回一台缓存服务器的 IP 地址。 局负载均衡设备把服务器的IP地址返回给用户。 用户向缓存服务器发起请求,缓存服务器响应用户请求,将用户所需内容返回到用户终端。如果这台缓存服务器上并没有用户想要的内容,而区域均衡设备依然将它分配给了用户,那么这台服务器就要向它的上一级缓存服务器请求内容,直到追溯到包含该内容的源服务器并将内容拉到本地。 什么情况下用CDN? 最适合的是那些不会经常变化的内容,比如图片,js文件,CSS文件,图片文件包括程序模板中CSS 文件中用到的背景图片,还有就是作为网站内容组成部分的那些图片等等。 灰度发布 我们的应用即使经过了测试部门的测试,也仍然很难全面覆盖用户的使用场景,为了保证万无一失,我们在进行发布的时候一般都会采用灰度发布,也就是会对新应用进行分批发布,逐步扩大新应用在整个及集群中的比例直到最后全部完成。灰度发布是说针对新应用在用户体验方面完全无感知。 灰度发布系统的作用在于,可以根据自己的配置,来将用户的流量导到新上线的系统上,来快速验证新的功能,而一旦出问题,也可以马上的回滚发布,简单的说,就是一套A/BTest系统。 七、总结 通过本文,我们就对主流的SOA架构、微服务架构、服务网格架构做了解析,然后知道了分布式架构中的几个基本理论,还分析了如何设计出高可用的分布式架构。不知大家是否有所收获呢?有意见或建议的朋友欢迎留言与我讨论。 原文发布时间为:2018-07-01本文作者:阿豪说本文来自云栖社区合作伙伴“DBAplus社群”,了解相关信息可以关注“DBAplus社群”。

优秀的个人博客,低调大师

Puppet基础篇6-Puppet更新方式的选型

零基础学习Puppet自动化配置管理系列文档 基于C/S架构的Puppet更新方式一般有两种,一种是Agent端设置同步时间主动去PuppetMaster端拉取配置,另一种是通过PuppetMaster端使用puppet kick命令或者借助mcollctive触发更新配置,两种方式适应不同的生产环境,各具特色。 一、主动更新 主动更新就是节点运行的puppet守护进程到预设的时候后自动去和puppetmaster进行交互直至更新完成的过程。 这种更新方式不易控制,主要表现在以下几个方面: 优点: 节点定期主动更新,无论是谁将节点被puppet管理的配置更改了,都会在规定的时间内自动修复,无须管理员登录查看。 环境搭建简单,不需要很复杂的架构,puppet本身C/S架构便可以完成。 … 缺点: 节点数量过大的情况下同时会向puppetmaster端发起更新请求,会造成puppetmaster性能瓶颈。当然,也有一些解决方案比如设置任务计划,节点分批进行更新。 由于节点会定期向puppetmaster端提取配置进行更新,这要求puppetmaster端的环境要足够的安全。否则,任何人上去修改puppet模板都会造成节点同步更新,如果有人写了可执行资源“rm -rf /”,那损失就大了。 不能手动控制那些服务器需要更新,那些不需要更新。 … 自动更新方式配置很简单的,只需要在节点配置文件puppet.conf添加runinterval字段即可实现自动更新,以下步骤简单测试下 注:默认情况下,puppet.conf配置文件中是没有runinterval字段的,如果不配置,默认是每隔30分钟自动同步一次。 1、添加runinterval字段 为了方便测试,可设置为10秒 1 2 3 4 5 6 7 8 9 10 11 [root@agent1 ~]# vim /etc/puppet/puppet.conf [main] logdir = / var /log/puppet rundir = / var /run/puppet ssldir = $ var dir/ssl [agent] classfile = $ var dir/classes.txt localconfig = $ var dir/localconfig server = puppetmaster.kisspuppet.com certname = agent1_cert.kisspuppet.com runinterval = 10 #设置同步的间隔时间,单位为秒 2、启动puppetagent服务 1 2 [root@agent1 ~]# /etc/init.d/puppet start Starting puppet: [ OK ] 3、打开message日志查看同步状态可以看到日志里面每隔10秒钟agent1向puppetmaster同步一次 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 [root@agent1 ~]# tailf / var /log/messages Mar 11 23 : 39 : 42 agent1 kernel: ide: failed opcode was: 0xec Mar 11 23 : 39 : 42 agent1 smartd[ 3110 ]: Device: /dev/hdc, not ATA, no IDENTIFY DEVICE Structure Mar 11 23 : 39 : 42 agent1 smartd[ 3110 ]: Device: /dev/sda, opened Mar 11 23 : 39 : 42 agent1 smartd[ 3110 ]: Device: /dev/sda, IE (SMART) not enabled, skip device Try 'smartctl -s on /dev/sda' to turn on SMART features Mar 11 23 : 39 : 42 agent1 smartd[ 3110 ]: Monitoring 0 ATA and 0 SCSI devices Mar 11 23 : 39 : 42 agent1 smartd[ 3112 ]: smartd has fork()ed into background mode. New PID= 3112 . Mar 11 23 : 39 : 42 agent1 avahi-daemon[ 3076 ]: Server startup complete. Host name is agent1.local. Local service cookie is 773321440 . Mar 11 23 : 44 : 11 agent1 puppet-agent[ 3210 ]: Reopening log files Mar 11 23 : 44 : 12 agent1 puppet-agent[ 3210 ]: Starting Puppet client version 2.7 . 25 Mar 11 23 : 44 : 16 agent1 puppet-agent[ 3210 ]: Finished catalog run in 1.53 seconds Mar 11 23 : 44 : 29 agent1 puppet-agent[ 3210 ]: Finished catalog run in 0.96 seconds Mar 11 23 : 44 : 40 agent1 puppet-agent[ 3210 ]: Finished catalog run in 0.20 seconds Mar 11 23 : 44 : 51 agent1 puppet-agent[ 3210 ]: Finished catalog run in 0.24 seconds Mar 11 23 : 45 : 02 agent1 puppet-agent[ 3210 ]: Finished catalog run in 0.21 seconds Mar 11 23 : 45 : 13 agent1 puppet-agent[ 3210 ]: Finished catalog run in 0.22 seconds 4、通过命令进行测试 同样,每隔10秒会同步一次 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 [root@agent1 ~]# /etc/init.d/puppet stop Stopping puppet: [ OK ] [root@agent1 ~]# puppet agent --verbose --no-daemonize notice: Starting Puppet client version 2.7 . 25 info: Caching catalog for agent1_cert.kisspuppet.com info: Applying configuration version '1394359075' notice: Finished catalog run in 0.21 seconds info: Caching catalog for agent1_cert.kisspuppet.com info: Applying configuration version '1394359075' notice: Finished catalog run in 0.20 seconds info: Caching catalog for agent1_cert.kisspuppet.com info: Applying configuration version '1394359075' notice: Finished catalog run in 0.20 seconds info: Caching catalog for agent1_cert.kisspuppet.com info: Applying configuration version '1394359075' notice: Finished catalog run in 0.21 seconds info: Caching catalog for agent1_cert.kisspuppet.com info: Applying configuration version '1394359075' notice: Finished catalog run in 0.21 seconds 二、推送更新 推送更新就是通过puppet kick或者mcollective来控制节点什么时候向puppetmaster端获取配置变更信息。这种方式比较容易控制,主要表现在以下几个方面: 优点: 非常容易控制节点的更新周期 安全性比较高,每次更新之前可先检查好代码后再更新 可以针对某一个cluster(一组服务器)进行推送更新,灵活性很强。 扩展性很强,可整合各种其他平台 … 缺点: 环境搭建比较复杂,需要部署N多东西 agent端配置被篡改后,需要手动触发才能够恢复,不能够及时恢复 … 1、puppet kick方式 puppet kick是是通过puppetmaster端的命令触发的方式进行更新的,由于其锁的问题很难解决外加上主机单元控制不是很灵活,逐渐被抛弃了,puppetlabs也看到了这一点,因此收购了mcollecitve。当然,这种方式在很多企业中还在用,这里给几个大家方式参考: http://purplegrape.blog.51cto.com/1330104/1179358 http://dreamfire.blog.51cto.com/418026/1279878 2、mcollective触发方式 需要搭建mcollective+MQ架构,搭建好了之后通过mco命令将puppet命令传输至MQ分配到一组节点上去,关于mcollective+MQ架构搭建会在第三部分详细讲解,也可以参考之前写的一篇文章http://kisspuppet.com/2013/11/10/mcollective-middleware/ 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 [root@webui ~]# mco puppet -v runonce Discovering hosts using the mc method for 2 second(s) .... 3 * [ ============================================================> ] 3 / 3 node3.rsyslog.org : OK {:summary=> "Started a background Puppet run using the 'puppet agent --onetime --daemonize --color=false --splay --splaylimit 30' command" } node2.rsyslog.org : OK {:summary=> "Started a background Puppet run using the 'puppet agent --onetime --daemonize --color=false --splay --splaylimit 30' command" } node1.rsyslog.org : OK {:summary=> "Started a background Puppet run using the 'puppet agent --onetime --daemonize --color=false --splay --splaylimit 30' command" } ---- rpc stats ---- Nodes: 3 / 3 Pass / Fail: 3 / 0 Start Time: Tue Mar 11 17 : 40 : 56 + 0800 2014 Discovery Time: 2003 .85ms Agent Time: 1132 .44ms Total Time: 3136 .29ms 3、封装成WebUI的触发更新 Kermit架构—一个非常完美的基于MCollective和Puppet,并结合Django和Rest组成的Web框架(第四部分会讲) kermit架构图 搭建完成之后的操作界面 选中puppet插件kermit界面 执行puppet推送动作kermit界面 执行过程kermit界面 显示结果 本文转自凌激冰51CTO博客,原文链接:http://blog.51cto.com/dreamfire/1374395,如需转载请自行联系原作者

优秀的个人博客,低调大师

来来来,美女DBA教你MySQL高可用架构选型

2016.12.29 知数堂培训公开课《MySQL体系结构及常见高可用架构》 1、主题 《MySQL体系结构及常见高可用架构》 2、嘉宾介绍 杭星,MySQL OCP,某电信运营商数据库高级主管,IT相关专业硕士,金奖台讲师,多次获得各类奖项和荣誉称号。 负责MySQL架构设计、部署配置、运行维护及自动化提升工作,具备MySQL扎实的理论知识和丰富的实战运维经验。 3、课程大纲 (1)MySQL体系结构 (2)MySQL存储引擎 (3)MySQL常见高可用架构 (4)MySQL自动化运维场景 文章转自老叶茶馆公众号,原文链接:https://mp.weixin.qq.com/s/euqo5wwl2d5xaaE-4HIOUw

优秀的个人博客,低调大师

监控摄像机选型攻略之常见机型选用

监控摄像机类型多样,一般来说主要有枪式摄像机、球型摄像机、半球型摄像机、一体机、鱼眼/全景摄像机、云台摄像机几大类型。 枪式摄像机:需要为其选配合适镜头,一般安装于室外场合较多(搭配护罩);而部分室内场合也可适用,如走廊、出入口等。 半球型摄像机:多应用与室内,如走廊、大堂、出入口、过道、电梯厢、楼梯等。 球型摄像机:自身具备较高防护等级,多应用于室外,如广场、道路,同样适用于室内场合,如机场、车站等。 云台摄像机:为室外机型,一般用作高空瞭望,如城市、森林、边防的制高点等。 一体化摄像机:目前的一体机较模拟时代出现了较大改变,大变倍产品已经很少见,转而以圆形、方形的筒型机样式出现。自身具备变倍、补光甚至星光级夜视功能,同时防护等级较高,兼顾室外、室内应用。具有枪式摄像机的固定视角和球机的光学变倍功能。 鱼眼/全景摄像机:鱼眼和全景为两个不同类型全景监控设备,鱼眼为单镜头,全景为多镜头拼接。新一代产品中,两者均具有较高防护等级,其中鱼眼为室内应用机型;全景则是室内、室外两用型,多用于大堂、车站、马路、机场等监控视野较大的场合。 由此,不同的应用场合有多种不同的选配方案,如出入口,可为半球,也可以是鱼眼摄像机;但若要做人脸识别,枪式摄像机则更为妥当。当然安装条件也很重要,决定了不同类型摄像机的最佳适用性,仍以出入口举例,作为监控、技术统计应用,半球摄像机是最佳选择,直接吊顶安装即可;但作为人脸识别时,最佳选配机型虽然是枪式摄像机,但在正对出入口处需要一个安装支撑点,如墙壁、立杆等,否则达不到应用效果。 当然,产品类型的选用不是绝对的,如既要做全景监控,又要做视频联动,传统方案只有枪机+球机、鱼眼/全景摄像机+球机两种方案可选,但随着集成度越来越高,一个设备也可以满足这些需求,如海康威视推出的鹰眼系列带云台全景摄像机,将更为节省成本投入。 ====================================分割线================================ 本文转自d1net(转载)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册