高性能缓存服务器Squid架构配置
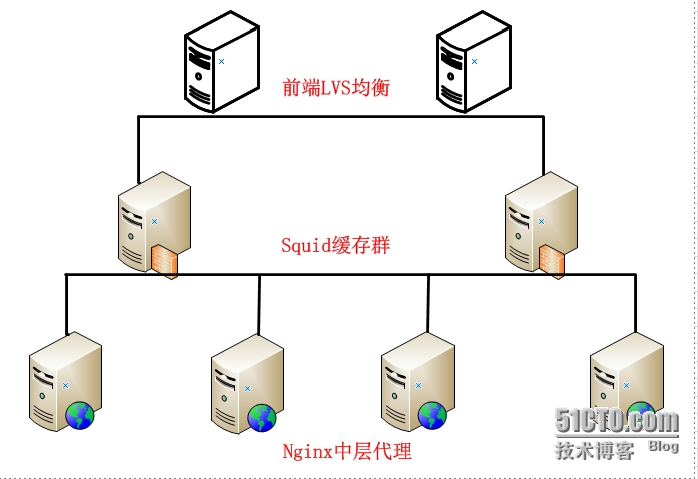
前言*随着网站访问人数越来越多,承受的并发和压力也越来越高,这时候我们需要对网站和架构进行优化,今天我们来讨论使用Squid对架构进行优化,缓存网站。网上对squid描述的文章也有成千上万,我这里简单记录一下实践的步骤。 一、实施环境 1 2 3 系统版本:CentOSx86_645.8 Squid版本:squid-2.6 Nginx版本:nginx-1.4.2 二、正式安装 安装之前我们需要对系统进行优化,主要优化系统内核相关参数,仅供参考: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 vi /etc/sysctl .conf #sysctl.confconfig2014-03-26 net.ipv4.ip_forward=0 net.ipv4.conf.default.rp_filter=1 net.ipv4.conf.default.accept_source_route=0 kernel.sysrq=0 kernel.core_uses_pid=1 net.ipv4.tcp_syncookies=1 kernel.msgmnb=65536 kernel.msgmax=65536 kernel.shmmax=68719476736 kernel.shmall=4294967296 net.ipv4.tcp_max_tw_buckets=10000 net.ipv4.tcp_sack=1 net.ipv4.tcp_window_scaling=1 net.ipv4.tcp_rmem=4096873804194304 net.ipv4.tcp_wmem=4096163844194304 net.core.wmem_default=8388608 net.core.rmem_default=8388608 net.core.rmem_max=16777216 net.core.wmem_max=16777216 net.core.netdev_max_backlog=262144 net.core.somaxconn=262144 net.ipv4.tcp_max_orphans=3276800 net.ipv4.tcp_max_syn_backlog=262144 net.ipv4.tcp_timestamps=0 net.ipv4.tcp_synack_retries=1 net.ipv4.tcp_syn_retries=1 net.ipv4.tcp_tw_recycle=1 net.ipv4.tcp_tw_reuse=1 net.ipv4.tcp_mem=94500000915000000927000000 net.ipv4.tcp_fin_timeout=1 net.ipv4.tcp_keepalive_time=15 net.ipv4.ip_local_port_range=102465535 优化Linux文件打开最大数: 1 2 3 4 5 vi /etc/security/limits .conf *softnproc65535 *hardnproc65535 *softnofile65535 *hardnofile65535 接下来上自动安装Squid脚本,里面分别配置了两个虚拟主机域名,前端有LVS,LVS均衡后端多组squid集群,根据命中率去调整squid集群的数量,Squid后端均衡Nginx或者Apache。(完整的架构LVS+Keepalived+Squid+Nginx+Resin/Tomcat/PHP+MySQL集群) 简单逻辑图如下: 直接上脚本: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 #!/bin/sh #Automakeinstallsquidserver #Authorwugk2014-03-26 SQUID_CNF= /etc/squid/squid .conf CACHE_DIR=( /data/cache1 /data/cache2 ) #Installsquidshell yum install -ysquid #configsquid.conf cat >>$SQUID_CNF<<EOF #globalconfigsquid.conf2014-03-26 http_port80accelvhostvport cache_peer192.168.149.128parent800originservername=wugk1 cache_peer192.168.149.129parent800originservername=wugk2 cache_peer_domainwugk1www.wugk1.com cache_peer_domainwugk2www.wugk2.com visible_hostnamelocalhost forwarded_foroff viaoff cache_varyon #aclconfig aclmanagerprotocache_object acllocalhostsrc127.0.0.1 /32 aclto_localhostdst127.0.0.0 /8 0.0.0.0 /32 acllocalnetsrc10.0.0.0 /8 #RFC1918possibleinternalnetwork acllocalnetsrc172.16.0.0 /12 #RFC1918possibleinternalnetwork acllocalnetsrc192.168.0.0 /16 #RFC1918possibleinternalnetwork aclSSL_portsport443 aclSafe_portsport808080 #http aclSafe_portsport21 #ftp aclSafe_portsport443 #https aclallsrc0.0.0.0 /0 aclCONNECTmethodCONNECT http_accessallowmanagerlocalhost http_accessdenymanager http_accessdeny!Safe_ports http_accessdenyCONNECT!SSL_ports http_accessallowlocalnet http_accessallowlocalhost http_accessallowall aclPURGEmethodPURGE http_accessallowPURGElocalhost http_accessdenyPURGE #squidconfig2014-03-25 cache_diraufs /data/cache1 1024016256 cache_diraufs /data/cache2 1024016256 cache_mem4000MB maximum_object_size8MB maximum_object_size_in_memory256KB hierarchy_stoplistcgi-bin? coredump_dir /var/spool/squid refresh_pattern^ ftp :144020%10080 refresh_pattern^gopher:14400%1440 refresh_pattern-i( /cgi-bin/ |\?)00%0 refresh_pattern\.(jpg|png|gif|mp3|xml|html|htm|css|js)144050%2880ignore-reload refresh_pattern.020%4320 EOF #configcache_dir mkdir -p${CACHE_DIR[@]}; chown -Rsquid:squid${CACHE_DIR[@]} #restartsquidserver /etc/init .d /squid restart if [ "$?" == "0" ]; then echo "TheSquidServerInstallSuccessfully!!" else echo "TheSquidServerInstallFailed!!,PleaseCheckLog......" fi 最后测试,前端LVS截图(注LVS此处不配置了,博客有专门的安装方法) 通过浏览器查看head头,缓存命中情况截图如下: 通过命令 1 squidclient-p 80 mgr:info|egrep "(RequestHitRatios|ByteHitRatios)" 查看缓存命中率如下: 三、批量清空缓存 使用Shell脚本批量清空squid缓存脚本auto_clean_cache.sh 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 #!/bin/sh DIR= /data/cache/ Command= /usr/sbin/squidclient if [ "$1" = "" ]; then echo "Usage:{$0" \$1 ",Exampleexec$0forum.php}" exit fi grep -r-a$1${DIR}|strings| grep "http:" | grep - v "=" >list.txt count=` cat list.txt| wc -l` if [ "$count" - eq "0" ]; then echo -e "---------------------------------\nThe$1cachealreadyupdate,Pleaseexit......" exit fi while read line do $Command-mPURGE-p80 "$line" >> /dev/null if [$?- eq 0]; then echo -e "----------------------------------\nThe$linecacheupdatesuccessfully!" fi done <list.txt 脚本执行: 1 2 3 4 [root@node2~]#shauto_clean_cache.shforum.php ---------------------------------- Thehttp: //www.wugk2.com/forum.phpcacheupdatesuccessfully! [root@node2~]# 更多squid优化及深入配置后期更新。。 本文转自 wgkgood 51CTO博客,原文链接:http://blog.51cto.com/wgkgood/1384580