首页 文章 精选 留言 我的

精选列表

搜索[效率提升],共10000篇文章
优秀的个人博客,低调大师

「性能提升」扩展 Spring Cache 支持多级缓存

为什么多级缓存 缓存的引入是现在大部分系统所必须考虑的 redis 作为常用中间件,虽然我们一般业务系统(毕竟业务量有限)不会遇到如下图 在随着 data-size 的增大和数据结构的复杂的造成性能下降,但网络 IO 消耗会成为整个调用链路中不可忽视的部分。尤其在 微服务架构中,一次调用往往会涉及多次调用 例如pig oauth2.0 的 client 认证 Caffeine 来自未来的本地内存缓存,性能比如常见的内存缓存实现性能高出不少详细对比。 综合所述:我们需要构建 L1 Caffeine JVM 级别缓存 , L2 Redis 缓存。 设计难点 目前大部分应用缓存都是基于 Spring Cache 实现,基于注解(annotation)的缓存(cache)技术,存在的问题如下: Spring Cache 仅支持 单一的缓存来源,即:只能选择 Redis 实现或者 Caffeine 实现,并不能同时使用。 数据一致性:各层缓存之间的数据一致性问题,如应用层缓存和分布式缓存之前的数据一致性问题。 缓存过期:Spring Cache 不支持主动的过期策略 业务流程 如何使用 引入依赖 <dependency> <groupId>com.pig4cloud.plugin</groupId> <artifactId>multilevel-cache-spring-boot-starter</artifactId> <version>0.0.1</version> </dependency> 开启缓存支持 @EnableCaching public class App { public static void main(String[] args) { SpringApplication.run(App.class, args); } } 目标接口声明 Spring Cache 注解 @Cacheable(value = "get",key = "#key") @GetMapping("/get") public String get(String key){ return "success"; } 性能比较 为保证性能 redis 在 127.0.0.1 环路安装 OS: macOS Mojave CPU: 2.3 GHz Intel Core i5 RAM: 8 GB 2133 MHz LPDDR3 JVM: corretto_11.jdk Benchmark Mode Cnt Score Units 多级实现 thrpt 2 2716.074 ops/s 默认 redis thrpt 2 1373.476 ops/s 代码原理 自定义 CacheManager 多级缓存实现 public class RedisCaffeineCacheManager implements CacheManager { @Override public Cache getCache(String name) { Cache cache = cacheMap.get(name); if (cache != null) { return cache; } cache = new RedisCaffeineCache(name, stringKeyRedisTemplate, caffeineCache(), cacheConfigProperties); Cache oldCache = cacheMap.putIfAbsent(name, cache); log.debug("create cache instance, the cache name is : {}", name); return oldCache == null ? cache : oldCache; } } 多级读取、过期策略实现 public class RedisCaffeineCache extends AbstractValueAdaptingCache { protected Object lookup(Object key) { Object cacheKey = getKey(key); // 1. 先调用 caffeine 查询是否存在指定的值 Object value = caffeineCache.getIfPresent(key); if (value != null) { log.debug("get cache from caffeine, the key is : {}", cacheKey); return value; } // 2. 调用 redis 查询在指定的值 value = stringKeyRedisTemplate.opsForValue().get(cacheKey); if (value != null) { log.debug("get cache from redis and put in caffeine, the key is : {}", cacheKey); caffeineCache.put(key, value); } return value; } } 过期策略,所有更新操作都基于 redis pub/sub 消息机制更新 public class RedisCaffeineCache extends AbstractValueAdaptingCache { @Override public void put(Object key, Object value) { push(new CacheMessage(this.name, key)); } @Override public ValueWrapper putIfAbsent(Object key, Object value) { push(new CacheMessage(this.name, key)); } @Override public void evict(Object key) { push(new CacheMessage(this.name, key)); } @Override public void clear() { push(new CacheMessage(this.name, null)); } private void push(CacheMessage message) { stringKeyRedisTemplate.convertAndSend(topic, message); } } MessageListener 删除指定 Caffeine 的指定值 public class CacheMessageListener implements MessageListener { private final RedisTemplate<Object, Object> redisTemplate; private final RedisCaffeineCacheManager redisCaffeineCacheManager; @Override public void onMessage(Message message, byte[] pattern) { CacheMessage cacheMessage = (CacheMessage) redisTemplate.getValueSerializer().deserialize(message.getBody()); cacheMessage.getCacheName(), cacheMessage.getKey()); redisCaffeineCacheManager.clearLocal(cacheMessage.getCacheName(), cacheMessage.getKey()); } } 源码地址 https://github.com/pig-mesh/multilevel-cache-spring-boot-starter https://gitee.com/log4j/pig 项目推荐: Spring Cloud 、Spring Security OAuth2的RBAC权限管理系统 欢迎关注
优秀的个人博客,低调大师

如何提升微服务的幸福感

前言 随着微服务的流行,越来越多公司使用了微服务框架,微服务以其的高内聚、低耦合等特性,提供了更好的容错性,也更适应业务的快速迭代,为开发人员带来了很多的便利性。但是随着业务的发展,微服务拆分越来越复杂,微服务的治理也成了一个比较令人头疼的问题,我相信下面这些场景大家或多或少都遇到过。 场景一: 发布是天大的事情,每一次的发布,都会出现执行到一半的请求中断掉,上游继续调用已经下线的节点导致报错。发布时收到各种报错,同时还影响用户的体验。发布后又需要修复执行到一半的脏数据。 上述场景还是在新版本没有任何问题的情况下,如果新版本有问题,则会导致大量业务直接请求到有问题的新版本,轻则修复数据,重则严重影响用户体验,甚至产生资损。最后不得不每次发版都安排在凌晨两三点发布,心惊胆颤,睡眠不足,苦不可言。 场景二:大半夜某个服务节点出现异常,上游仍旧

优秀的个人博客,低调大师

从面试到技术提升(Java篇-上卷)

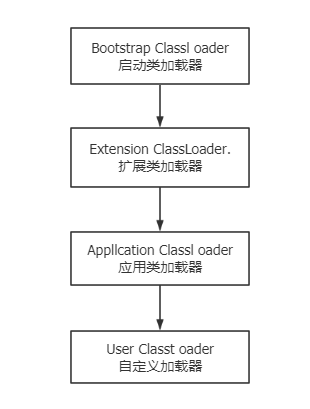
背景 其实,这系列文章我构思了很久。从我大概2016年初断断续续在CSDN上写博客开始,我就想好好整理一篇Android的综合文章。奈何那个时候功力尚浅,没办法驾驭(虽然现在依然彩笔一支)。 时至今日,算是正式开始动笔,其实之前想过很多文章计划,比如2018年开年的周期计划。不过写了8篇便放弃了。今天借着正正经经写公众号(IT面试填坑小分队)的机会,把这个《地表有点强》系列坚持下去,加油! OK,闲话不说。先从Java开始~ 《Java篇-上卷》 1、new一个类会发生什么? Model model= new Model () JVM会通过双亲委派机制将Model .class加载到内存中。 执行类里的静态代码块(如果有的话)。 在堆内存中申请内存空间,并分配内存地址给我们真正的Model对象。 在堆/栈内存里建立对象的属性(基本类型在栈中,引用类型和数组在堆中),并进行初始化赋值。 开始对象的构造代码块初始化(如果有的话)。 调用对象对应的构造方法进行初始化。 将对象的被分配的内存地址赋值给model变量。 概念性的描述: 加载:首相将类的全部信息加载到JVM的方法区中,然后在堆区中实例化一个java.lang.Class对象,作为方法去中这个类的信息入口(可以理解成是这个java代码的数据结构)。 连接:分为三个部分: 验证:验证类是否合法(判断这个代码文件是否符合JVM的标准)。 准备:为静态变量分配内存并设置赋初始值,非静态变量在此时不会被分配内存(还没出生,也就是为什么静态不能调用非静态)。 解析:将常量池里的符号引用转换为直接引用。 初始化:初始化类的静态赋值语句和静态代码块,主动引用(就是那几种可以造成类初始化的行为)会被触发类的初始化,被动引用不会触发类的初始化。 使用:执行类的初始化,主动引用会被触发类的初始化,被动引用不会触发类的初始化。 卸载:卸载过程就是清楚堆里类的信息,以下情况会被卸载:① 类的所有实例都已经被回收。② 类的ClassLoader被回收。③ 类的CLass对象没有被任何地方引用,无法在任何地方通过 反射访问该类。(GC) 2、双亲委派机制? 谈到双亲委派,必须要提到类加载器 类加载器可以分为三类: 启动类加载器(Bootstrap ClassLoader):负责加载<JAVA_HOME>\lib目录下或者被-Xbootclasspath参数所指定的路径的,并且是被虚拟机所识别的库到内存中。 扩展类加载器(Extension ClassLoader):负责加载<JAVA_HOME>\lib\ext目录下或者被java.ext.dirs系统变量所指定的路径的所有类库到内存中。 应用类加载器(Application ClassLoader):负责加载用户类路径上的指定类库,如果应用程序中没有实现自己的类加载器,一般就是这个类加载器去加载应用程序中的类库。 聊一下双亲委派模型,流程图如下所示 双亲委派 简单流程:如果一个类加载器收到了加载类的请求,它不会自己立即去加载类,它会先去请求父类加载器,每个层次的类加载器都是如此。层层传递,直到传递到最高层的类加载器,只有当 父类加载器反馈自己无法加载这个类,才会有当前子类加载器去加载该类。 落实到代码上就是: public abstract class ClassLoader { protected Class<?> loadClass(String name, boolean resolve) throws ClassNotFoundException { //首先,检查该类是否已经被加载 Class c = findLoadedClass(name); if (c == null) { long t0 = System.nanoTime(); try { //先调用父类加载器去加载 if (parent != null) { c = parent.loadClass(name, false); } else { c = findBootstrapClassOrNull(name); } } catch (ClassNotFoundException e) { } if (c == null) { //如果父类加载器没有加载到该类,则自己去执行加载 long t1 = System.nanoTime(); c = findClass(name); } } return c; } } 3、如何判断对象死了? 引用计数法:有对这个对象的引用就+1,不再引用就-1,但是这种方式看起来简单美好,但它却无法解决循环引用的问题。 可达性分析算法:可达性分析算法通过一系列称为GC Roots的对象作为起始点,从这些节点从上向下搜索,搜索走过的路径称为引用链,当一个对象没有任何引用链 与GC Roots连接时就说明此对象不可用,也就是对象不可达。(也就是说可以被回收) 什么样的对象才能被称之为GC Roots对象? 虚拟机栈中引用的对象(栈帧中的本地变量表) 方法去中类的静态属性引用的对象 方法区中常量引用的对象 Native方法引用的对象 4、synchronized理解? synchronized同步的俩种写法: synchronized(this):对象锁 public synchronized void method(){} public void method(){ synchronized(this) {} } synchronized(ClassName.class):类锁 public void method() { synchronized(ClassName.class) {} } public static synchronized method(){} 它们的区别大概可以这么理解:对象锁:Java的所有对象都含有1个互斥锁,这个锁由JVM自动获取和释放。线程进入synchronized方法的时候获取该对象的锁(也就是传入的对象),当然如果已经有线程获取了这个对象的锁,那么当前线程会等待;synchronized方法正常返回或者抛异常而终止,JVM会自动释放对象锁。 类锁:首先来说,Java类可能会有很多个对象,但是只有一个Class对象,也就是说类的不同实例之间共享这一个的Class对象。Class对象就是一个特殊的Java对象。 类锁和对象锁不是同一个东西,一个是类的Class对象的锁,一个是类的实例的锁。也就是说:一个线程访问静态synchronized的时候,允许另一个线程访 问对象的实例synchronized方法。反过来也是成立的,因为他们需要的锁是不同的。 5、如何理解volatile? 首先我们先了解一下JMM,Java内存模型。 Java内存模型规定了所有变量(这些变量包括实例变量、静态变量等,但不包括局部变量、方法参数等,因为这些变量存放在栈中,是线程私有的,并不存在竞争)都存在主内存中,每个线程会有自己的工作内存,工作内存里保存了线程所使用到的变量在主内存里的副本拷贝,线程对变量的操作只能在自己的工作内存里进行,不能直接读写主内存,彼此线程之间也不可见。 Java线程模型 volatile有两条关键的语义: 保证被volatile修饰的变量对所有线程都是可见的 禁止进行指令重排序 非原子性操作除外,也就是说i++这种操作,用volatile修饰是没办法保证同步的,需要用到AtomicInteger 为什么自增不行? 因为i++操作,是多个步骤:首先取出i的值,因为有volatile的修饰,这时候的值是没有问题的。 但是自增的时候,别的线程可能已经把i修改了比如+1,这种情况下就此线程如果写入成功就把i的值改错误了。 6、单例 经典的单例写法:(但是此方式没办法应对反射破坏) public class Singleton { //volatile保证了:1 instance在多线程并发的可见性 2 禁止instance在操作是的指令重排序 private volatile static Singleton instance; private Singleton(){} public static Singleton getInstance() { //第一次判空,保证不必要的同步 if (instance == null) { //synchronized对Singleton加全局所,保证每次只要一个线程创建实例 synchronized (Singleton.class) { //第二次判空时为了在null的情况下创建实例 if (instance == null) { instance = new Singleton(); } } } return instance; } } 枚举的单例方式可以避免反射破坏,目前正在学习其中的原理,不要zhaoji... 7、手写一下生产者和消费者模型 public class Main { private static Integer count = 0; private static final Integer FULL = 10; private static Object LOCK =new Object; public static void main(String[] args) { Main main = new Main(); new Thread(main .new Producer()).start(); new Thread(main .new Consumer()).start(); new Thread(main .new Producer()).start(); new Thread(main .new Consumer()).start(); new Thread(main .new Producer()).start(); new Thread(main .new Consumer()).start(); new Thread(main .new Producer()).start(); new Thread(main .new Consumer()).start(); } class Producer implements Runnable { @Override public void run() { for (int i = 0; i < 10; i++) { try { Thread.sleep(1000); } catch (Exception e) { e.printStackTrace(); } synchronized (LOCK) { while (count == FULL) { try { LOCK.wait(); } catch (Exception e) { e.printStackTrace(); } } count++; Log.d("test",Thread.currentThread().getName() + "生产者生产成功,目前总共有" + count); LOCK.notifyAll(); } } } } class Consumer implements Runnable { @Override public void run() { for (int i = 0; i < 10; i++) { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } synchronized (LOCK) { while (count == 0) { try { LOCK.wait(); } catch (Exception e) { } } count--; Log.d("test",Thread.currentThread().getName() + "消费者消费成功,目前总共有" + count); LOCK.notifyAll(); } } } } } 呃... 写完突然发现,有点随意了。这些内容好像完全不相干。不管了,大家就当琐碎的知识点,学习吧当然如果文中有错误的地方,欢迎评论区之出。因为这毕竟也只是我自己的学习总结~ 推荐一个立志减少IT面试踩坑的公众号 因为身边的同学从事互联网相关职业的比较多,并且大家闲时聊天时总会吐槽找工作有很多坑,所以打算把身边同学找工作的经验,统统收集起来。提供给想从事这方面同学,希望圈内好友可以共同进步,共同少踩坑。 个人公众号

优秀的个人博客,低调大师

MaxCompute Studio提升UDF和MapReduce开发体验

随着 MaxCompute 2.0 的发布,我们提供了MaxCompute Studio,一套基于IntelliJ IDEA的开发插件,让用户在集成开发环境(IDE)中更方便地进行SQL及用户代码开发。MaxCompute Studio 为开发者提供了良好的开发体验,支持项目空间浏览、SQL 脚本开发,UDF开发和调试,作业执行状态展示等功能,本系列将逐一展开进行介绍。 第一弹 - 元数据浏览第二弹 - 玩转SQL编辑器第三弹 - UDF开发与调试第四弹 - 权限那些事儿 UDF全称User Defined Function,即用户自定义函数。MaxCompute提供了很多内建函数来满足用户的计算需求,同时用户还可以创建自定义函数来满足定制的计算需求。用户能扩展的UDF有三种:UDF(User Defined Scalar Funct

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册