首页 文章 精选 留言 我的

精选列表

搜索[快速模式],共10000篇文章
优秀的个人博客,低调大师

PHP学习1——快速入门

主要内容: 搭建PHP开发环境 第一个helloworld程序 PHP(Hypertext Preprocessor)PHP超文本预处理程序,是一种嵌入HTML的脚本语言,运行在服务器。 搭建PHP开发环境 PHP开发环境主要3部分:服务器Apache,编程语言PHP,数据库MySQL。搭建开发环境,直接使用XAMPP集成安装就可以。 XAMPP=Apache+MySQL+PHP+Perl,X表示的是跨平台。 官网下载安装即可:https://www.apachefriends.org/zh_cn/index.html (安装太简单了,没有什么可说的,不过如果以前安装过tomcat,apache,MySQL等,xampp的部分功能可能不能使用,解决办法网上很多,不再赘言) 第一个helloworld程序 php可以使用note++进行编辑。 helloworld.php <?php echo "hello world!"; ?> 然后运行XAMPP的控制面板,点击Apache的start,绿色就是正常运行了。 然后将helloworld.php文件放在路径:C:\xampp\htdocs 浏览器输入:http://localhost/helloworld.php ok,我们的第一个PHP程序就完成了。

优秀的个人博客,低调大师

Dart In Action -Dart快速入门(-)

写在前面 本文基本上是将dart官网部分内容进行翻译,没兴趣的请出门左转至Dart的官网,有兴趣的同志请继续阅读本文。Flutter教程在这里 1.什么是Dart? 以下来自百度百科: Dart是谷歌开发的计算机编程语言,后来被Ecma (ECMA-408)认定为标准 [1] 。它被用于web、服务器、移动应用 [2] 和物联网等领域的开发。它是宽松开源许可证(修改的BSD证书)下的开源软件。 Dart是面向对象的、类定义的、单继承的语言。它的语法类似C语言,可以转译为JavaScript,支持接口(interfaces)、混入(mixins)、抽象类(abstract classes)、具体化泛型(reified generics)、可选类型(optional typing)和sound type system。 事实上,Dart被抛弃过,但Dart这门语言已经发展到2.x了。 2.为什么要学Dart? 大千世界,语言不计其数,这次我们要学习的为是Dart?答案是因为google推出的全新的跨平台UI框架--Flutter,而Flutter所使用的语言便是Dart。 3.初识Dart 以下代码展示了使用频率非常高并且最基础的Dart语法: // 定义一个函数. printInteger(int aNumber) { print('The number is $aNumber.'); // 将内容输出至控制台. } //和很多语言一样,dart选择了main()作为程序入口. main() { var number = 42; // 声明并且定义一个变量. printInteger(number); // 调用一个函数. } 4.Dart的注释 Dart的注释分为三种,举例说明: 单行注释 以//以为开始。在//和行尾之前的内容会被Dart编译器忽略掉。 void main() { // TODO: refactor into an AbstractLlamaGreetingFactory? print('Welcome to my Llama farm!'); } 多行注释 以/*开始并以*/为结束。/*和*/之前的内容会被Dart编译器忽略掉(除非注释是文档注释,下小节会介绍文档注释)。多行注释是可以嵌套的。 void main() { /* * This is a lot of work. Consider raising chickens. Llama larry = Llama(); larry.feed(); larry.exercise(); larry.clean(); */ } 3. 文档注释 文档注释是多行或者单行注释,以///或者/**开始。使用///注释连续的行与多行文档注释有相同的效果。 在文档注释中,Dart编译器会忽略所有文本,除非它被括在括号中。使用方括号,可以引用类、方法、字段、顶级变量、函数和参数。括号中的名称在文档化的程序元素的词法范围中解析。 /// A domesticated South American camelid (Lama glama). /// /// Andean cultures have used llamas as meat and pack /// animals since pre-Hispanic times. class Llama { String name; /// Feeds your llama [Food]. /// /// The typical llama eats one bale of hay per week. void feed(Food food) { // ... } /// Exercises your llama with an [activity] for /// [timeLimit] minutes. void exercise(Activity activity, int timeLimit) { // ... } } 在生成的文档中,[Food]成为指向Food类的API文档的链接。使用这个SDK可以解析Dart代码以及生HTML文档。 第一节结束

优秀的个人博客,低调大师

OpenStack快速入门-queens版本

系统内存要求8G,硬盘100G,操作系统可以连接公网,单网卡即可满足操作。本次实验使用了2块网卡。 操作系统版本:(最小化安装)CentOS Linux release 7.4.1708 (Core)openstack-queens版本centos-release-openstack-queens-1-1.el7.centos.x86_64 1.系统配置:关闭不需要服务:setenforce 0sed -i 's/SELINUX=enforcing/SELINUX=disabled/' /etc/selinux/configsystemctl disable firewalld systemctl stop firewalld systemctl disable NetworkManager systemctl stop NetworkManager 2.OpenStack软件安装:yum install centos-release-openstack-queens.x86_64 -y(安装openstack的yum 源)yum install -y openstack-packstackyum install python-pip -ypackstack --allinone (本次安装环境所有组建部署在一个节点。) 3,登陆dashboardhttp://192.168.0.78密码记录在keystonerc_admin文件中: unset OS_SERVICE_TOKEN export OS_USERNAME=admin export OS_PASSWORD=a8e90bb181da420e export OS_AUTH_URL=http://192.168.0.79:5000/v2.0 export PS1='[\u@\h \W(keystone_admin)]\$ ' export OS_TENANT_NAME=admin export OS_REGION_NAME=RegionOne

优秀的个人博客,低调大师

Docker 快速入门之 Dockerfile

在容器环境中,我们可以通过容器创建一个我们自定义过的镜像,那么我们是否可以直接通过基础的镜像直接自定义镜像呢?答案当然是可以的,在 Docker 中我们可以从名为Dockerfile的文件中读取指令并且自动构建镜像。在本文中,将介绍 Dockerfile 的基本语法以及基本知识。 1 Dockerfile 是什么? Dockerfile 其实是一份文本文档,里面包含了用户可以用来操作镜像的一些指令。通过顺序执行这些指令,最后得到一个自定义的镜像,这有点类似于我们的shell script。 2 Dockerfile 示例 接下来先看一个 Dockerfile 示例: FROM centos LABEL maintainer="Locez <locez@locez.com>" ENV TEST="This is a test env" COPY nginx.repo /etc/yum.repos.d/nginx.repo RUN yum update -y && \ yum install -y nginx COPY nginx.conf /etc/nginx/nginx.conf COPY index.html /usr/share/nginx/html/index.html COPY index_files/ /usr/share/nginx/html/index_files/ EXPOSE 80 CMD ["/usr/sbin/nginx","-g","daemon off;"] 在上面我们可以看到 Dockerfile 中的一些指令,通过名称我们也可以猜到这些指令大概是干嘛的,其中有一些对文件的操作,因此我们先来看看用于存放 Dockerfile 的这个目录的目录结构: # tree . . ├── Dockerfile ├── index_files │ ├── 145049z4og8xyjhx4xy8go.jpg │ ├── 222746e5vh38d7ey3leyps.jpg │ ├── 88x31.png │ ├── archlinux-splash.png │ ├── bdshare.css │ ├── Best-Linux-Markdown-Editors.png │ ├── core.js │ ├── docker-icon.jpg │ ├── hadoop-pic1.png │ ├── jquery_002.js │ ├── jquery.css │ ├── jquery.js │ ├── MathJax.js │ ├── pic.gif │ ├── raspberrypiraspberry-pi-logo.jpg │ ├── script.js │ ├── scrollup.png │ ├── share.js │ ├── style.css │ └── z_stat.js ├── index.html ├── nginx.conf └── nginx.repo 1 directory, 24 files 构建镜像 在当前目录下执行以下命令构建镜像: # docker build -t locez/nginx . Sending build context to Docker daemon 1.851 MB Step 1/10 : FROM centos ---> 196e0ce0c9fb Step 2/10 : LABEL maintainer "Locez <locez@locez.com>" ---> Using cache ---> 9bba3042bcdb Step 3/10 : ENV TEST "This is a test env" ---> Using cache ---> c0ffe95ea0c5 Step 4/10 : COPY nginx.repo /etc/yum.repos.d/nginx.repo ---> Using cache ---> bb6ee4c30d56 Step 5/10 : RUN yum update -y && yum install -y nginx ---> Using cache ---> 6d46b41099c3 Step 6/10 : COPY nginx.conf /etc/nginx/nginx.conf ---> Using cache ---> cfe908390aae Step 7/10 : COPY index.html /usr/share/nginx/html/index.html ---> Using cache ---> 21729476079d Step 8/10 : COPY index_files/ /usr/share/nginx/html/index_files/ ---> Using cache ---> 662f06ec7b46 Step 9/10 : EXPOSE 80 ---> Using cache ---> 30db5a889d0a Step 10/10 : CMD /usr/sbin/nginx -g daemon off; ---> Using cache ---> d29b9d4036d2 Successfully built d29b9d4036d2 然后用该镜像启动容器: # docker run -d -it --rm --name test-nginx -p 8080:80 locez/nginx e06fd991ca1b202e08cf1578f8046355fcbba10dd9a90e11d43282f3a1e36d29 用浏览器访问http://localhost:8080/即可看到部署的内容。 3 Dockerfile 指令解释 Dockerfile 支持FROM,RUN,CMD,LABEL,EXPOSE,ENV,ADD,COPY,ENTRYPOINT,VOLUME,USER,WORKDIR,ARG,ONBUILD,SHELL等指令,这里只选择常用的几个进行讲解,可结合上面的示例进行理解。其它的请自行查阅官方文档。 3.1 FROM FROM指令用于指定要操作的基础镜像,因为在我们构建我们自己的镜像的时候需要一个基础镜像。 语法: FROM <image> [AS <name>] FROM <image>[:<tag>] [AS <name>] 其中[AS <name>]为指定一个名称,在一个 Dockerfile 中多次使用FROM时如有需要,可用COPY --from=<name|index>语法进行复制。 3.2 RUN RUN指令用于执行命令,并且是在新的一层上执行,并把执行后的结果提交,也就是生成新的一层。基于这个问题,我们在使用RUN指令时应该尽可能的把要执行的命令一次写完,以减少最后生成的镜像的层数。语法: RUN <command> RUN ["executable", "param1", "param2"] 3.3 CMD CMD指令用于给容器启动时指定一个用于执行的命令,例如上例中的 nginx 启动命令。 语法: CMD ["executable","param1","param2"] CMD ["param1","param2"] ### 用于给 ENTRYPOINT 指令提供默认参数 CMD command param1 param2 3.4 LABEL LABEL指令用于为镜像指定标签,可用docker inspect命令查看。可用来代替被舍弃的MAINTAINER命令。语法: LABEL <key>=<value> <key>=<value> <key>=<value> ... 3.5 EXPOSE EXPOSE指令用于告诉 Docker 容器监听的特殊端口,但是此时端口还没有暴露给 host ,只有当在运行一个容器显式用参数-p或者-P的时候才会暴露端口。语法: EXPOSE <port> [<port>/<protocol>...] 3.6 ENV ENV指令用于设定环境变量。语法: ENV <key> <value> ENV <key>=<value> ... 3.7 ADD ADD指令用于复制新文件,目录,远程文件到容器中。其中<src>可以为文件,目录,URL,若为可解压文件,在复制后会解压。语法: ADD <src>... <dest> ADD ["<src>",... "<dest>"] 3.8 COPY COPY指令与ADD指令非常相似,但COPY比较直观且简单,它只支持本地的文件以及目录的复制,不像ADD指令可以远程获取文件并解压。语法: COPY <src>... <dest> COPY ["<src>",... "<dest>"] 3.9 ENTRYPOINT ENTRYPOINT指令也跟CMD指令相似,用于指定容器启动时执行的命令。当使用ENTRYPOINT指令时,可用CMD命令配合,这样在启动容器时,可以对CMD指令写入的参数进行覆盖。语法: ENTRYPOINT ["executable", "param1", "param2"] 样例: ENTRYPOINT ["top","-b"] CMD ["-c"] 上面的-c参数可以在启动时覆盖docker run -it --rm --name test top -H。 如果要覆盖ENTRYPOINT指令则用--entrypoint参数启动容器。 3.10 VOLUME VOLUME指令用于为容器创建一个挂载点,这个挂载点可以用来挂载本地文件/文件夹也可以用来挂载数据卷。其中若在启动一个新容器时没有指定挂载目录,则会自动创建一个数据卷,当容器被销毁时,数据卷如果没有被其它容器引用则会被删除。语法: VOLUME ["/data1","/data2"] 3.11 USER USER指令用于设置执行RUN,CMD,ENTRYPOINT等指令的用户以及用户组。默认为root用户。语法: USER <user>[:<group>] 3.12 WORKDIR WORKDIR指令用于设置RUN,CMD,ENTRYPOINT,COPY,ADD等指令的工作目录。语法: WORKDIR /path/to/workdir 4 总结 本文从一个具体的例子出发,讲述了如何利用 Dockerfile 构建镜像,然后解释了 Dockerfile 文件中的指令的语法,有关更多内容可访问官方文档。 5 参考资料 Dockerfile reference 原文发布时间: 2017-12-16 本文来自云栖社区合作伙伴“ Debian社区”,了解相关信息可以关注“ Debian社区”。

优秀的个人博客,低调大师

Mina2.0快速入门

MinaTimeServer.java 复制代码 package com.vista; import java.io.IOException; import java.net.InetSocketAddress; import java.nio.charset.Charset; import org.apache.mina.core.service.IoAcceptor; import org.apache.mina.core.session.IdleStatus; import org.apache.mina.filter.codec.ProtocolCodecFilter; import org.apache.mina.filter.codec.textline.TextLineCodecFactory; import org.apache.mina.filter.logging.LoggingFilter; import org.apache.mina.transport.socket.nio.NioSocketAcceptor; public class MinaTimeServer { private static final int PORT = 6488; public static void main(String[] args) throws IOException { //监听即将到来的TCP连接 IoAcceptor acceptor = new NioSocketAcceptor(); acceptor.getFilterChain().addLast("logger", new LoggingFilter()); acceptor.getFilterChain().addLast("codec", new ProtocolCodecFilter( new TextLineCodecFactory( Charset.forName("UTF-8")))); acceptor.setHandler(new TimeServerHandler()); acceptor.getSessionConfig().setReadBufferSize(2048); acceptor.getSessionConfig().setIdleTime(IdleStatus.BOTH_IDLE, 10); acceptor.bind(new InetSocketAddress(PORT)); System.out.println("服务器启动"); } } 复制代码 TimeServerHandler.java 复制代码 package com.vista; import java.util.Date; import org.apache.mina.core.service.IoHandlerAdapter; import org.apache.mina.core.session.IdleStatus; import org.apache.mina.core.session.IoSession; public class TimeServerHandler extends IoHandlerAdapter { public void exceptionCaught(IoSession session, Throwable cause) throws Exception { cause.printStackTrace(); } public void messageReceived(IoSession session, Object message) throws Exception { String strMsg = message.toString(); if(strMsg.trim().equalsIgnoreCase("quit")) { session.close(); return; } Date date = new Date(); session.write(date.toString()); System.out.println("Message written"); } public void sessionIdle(IoSession session, IdleStatus status) throws Exception { System.out.println("IDLE"+session.getIdleCount(status)); } } 复制代码 测试: Client Output Server Output user@myhost:~> telnet 127.0.0.1 9123 Trying 127.0.0.1... Connected to 127.0.0.1. Escape character is '^]'. hello Wed Oct 17 23:23:36 EDT 2007 quit Connection closed by foreign host. user@myhost:~> MINA Time server started. Message written... 参考资料:1,MINA v2.0 Quick Start Guide 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2008/11/27/1342655.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Quartz 框架快速入门(一)

创建一个 Java 工程,引入几个 JAR 到工程中才能成功构建它们。首先,你需要 Quartz 的二进制版本,包的名字是 quartz-<version>.jar。Quartz 还需要几个第三方库;这依赖于你要用到框架的什么功能而定,Commons Digester 库可以在 <QUARTZ_HOME>/lib/core 和 <QUARTZ_HOME>/lib/optional 目录中找到。如果出现java.lang.NoClassDefFoundError: javax/transaction/UserTransaction的错误,解决办法是:引入jta.jar包,这个包在quartz-1.6.0/lib/build 下。 ·创建一个 Quartz Job 类 每一个 Quartz Job 必须有一个实现了 org.quartz.Job 接口的具体类。这个接口仅有一个要你在 Job 中实现的方法,execute(),方法 execute() 的原型如下: public void execute(JobExecutionContext context) throws JobExecutionException; 当 Quartz 调度器确定到时间要激发一个 Job 的时候,它就会生成一个 Job 实例,并调用这个实例的 execute() 方法。调度器只管调用 execute() 方法,而不关心执行的结果,除了在作业执行中出问题抛出的 org.quartz.JobExecutionException 异常。 下面是我们的第一个 Quartz job,它被设计来扫描一个目录中的文并显示文件的详细信息。 复制代码 package com.vista.quartz; import java.io.File; import java.io.FileFilter; import java.util.Date; import org.apache.commons.logging.Log; import org.apache.commons.logging.LogFactory; import org.quartz.Job; import org.quartz.JobDataMap; import org.quartz.JobDetail; import org.quartz.JobExecutionContext; import org.quartz.JobExecutionException; public class ScanDirectoryJob implements Job { static Log logger = LogFactory.getLog(ScanDirectoryJob.class);//日志记录器 public void execute(JobExecutionContext context) throws JobExecutionException { //Every job has its own job detail JobDetail jobDetail = context.getJobDetail(); // The name is defined in the job definition String jobName = jobDetail.getName();//任务名称 // Log the time the job started logger.info(jobName + " fired at " + new Date());//记录任务开始执行的时间 // The directory to scan is stored in the job map JobDataMap dataMap = jobDetail.getJobDataMap();//任务所配置的数据映射表 String dirName = dataMap.getString("SCAN_DIR");//获取要扫描的目录 // Validate the required input if (dirName == null) {//所需要的扫描目录没有提供 throw new JobExecutionException( "Directory not configured" ); } // Make sure the directory exists File dir = new File(dirName); if (!dir.exists()) {//提供的是错误目录 throw new JobExecutionException( "Invalid Dir "+ dirName); } // Use FileFilter to get only XML files FileFilter filter = new FileExtensionFileFilter(".xml"); //只统计xml文件 File[] files = dir.listFiles(filter); if (files == null || files.length <= 0) {//目录下没有xml文件 logger.info("No XML files found in " + dir); // Return since there were no files return; } // The number of XML files int size = files.length; // Iterate through the files found for (int i = 0; i < size; i++) { File file = files[i]; // Log something interesting about each file. File aFile = file.getAbsoluteFile(); long fileSize = file.length(); String msg = aFile + " - Size: " + fileSize; logger.info(msg);//记录下文件的路径和大小 } } } 复制代码 当 Quartz 调用 execute() 方法,会传递一个 org.quartz.JobExecutionContext 上下文变量,里面封装有 Quartz 的运行时环境和当前正执行的 Job。通过 JobexecutionContext,你可以访问到调度器的信息,作业和作业上的触发器的信息,还有更多更多的信息。在代码中,JobExecutionContext 被用来访问 org.quartz.JobDetail 类,JobDetail 类持有 Job 的详细信息,包括为 Job 实例指定的名称,Job 所属组,Job 是否被持久化(易失性),和许多其他感兴趣的属性。 JobDetail 又持有一个指向 org.quartz.JobDataMap 的引用。JobDataMap 中有为指定 Job 配置的自定义属性。例如,在代码中我们从 JobDataMap 中获得欲扫描的目录名,我们可以在 ScanDirectoryJob 中硬编码这个目录名,但是这样的话我们难以重用这个 Job 来扫描别的目录了。在后面你将会看到目录是如何配置到 JobDataMap 的。 execute() 方法中剩下的就是标准 Java 代码了:获得目录名并创建一个 java.io.File 对象。它还对目录名作为简单的校验,确保是一个有效且存在的目录。接着调用 File 对象的 listFiles() 方法得到目录下的文件。还创建了一个 java.io.FileFilter 对象作为参数传递给 listFiles() 方法。org.quartzbook.cavaness.FileExtensionFileFilter 实现了 java.io.FileFilter 接口,它的作用是过滤掉目录仅返回 XML 文件。默认情况下,listFiles() 方法是返回目录中所有内容,不管是文件还是子目录,所以我们必须过滤一下,因为我们只对 XML 文件感兴趣。 FileExtensionFileFilter 被用来屏蔽名称中不含字符串 “.xml” 的文件。它还屏蔽了子目录--这些子目录原本会让 listFiles() 方法正常返回。过滤器提供了一种很便利的方式选择性的向你的 Quartz 作业提供它能接受的作为输入的文件 复制代码 package com.vista.quartz; import java.io.File; import java.io.FileFilter; public class FileExtensionFileFilter implements FileFilter { private String extension;//文件后缀 public FileExtensionFileFilter(String extension) { this.extension = extension; } public boolean accept(File file) {//只接受指定后缀的文件 // Lowercase the filename for easier comparison String lCaseFilename = file.getName().toLowerCase();//小写化 return (file.isFile() &&(lCaseFilename.indexOf(extension) > 0 )) ? true : false ; } } 复制代码 到目前为止,我们已经创建了一个 Quartz job,但还没有决定怎么处置它--明显地,我们需以某种方式为这个 Job 设置一个运行时间表。时间表可以是一次性的事件,或者我们可能会安装它在除周日之外的每个午夜执行。你即刻将会看到,Quartz Schduler 是框架的心脏与灵魂。所有的 Job 都通过 Schduler 注册;必要时,Scheduler 也会创建 Job 类的实例,并执行实例的 execute() 方法。 ·编程式安排一个 Quartz Job 所有的要 Quartz 来执行的作业必须通过调度器来注册。大多情况下,这会在调度器启动前做好。正如前面说过,这一操作也提供了声明式与编程式两种实现途径的选择。 因为每一个 Job 都必须用 Scheduler 来注册,所以先定义一个 JobDetail,并关联到这个 Scheduler 实例。 下面的程序提供了一个理解如何编程式安排一个 Job 很好的例子。代码首先调用 createScheduler() 方法从 Scheduler 工厂获取一个 Scheduler 的实例。得到 Scheduler 实例之后,把它传递给 schedulerJob() 方法,由它把 Job 同 Scheduler 进行关联。 首先,创建了我们想要运行的 Job 的 JobDetail 对象。JobDetail 构造器的参数中包含指派给 Job 的名称,逻辑组名,和实现 org.quartz.Job 接口的全限类名称。我们可以使用 JobDetail 的别的构造器。 在前面有说过,JobDetail 扮演着某一 Job 定义的角色。它带有 Job 实例的属性,能在运行时被所关联的 Job 访问到。其中在使用 JobDetail 时,的一个最重要的东西就是 JobDataMap,它被用来存放 Job 实例的状态和参数。在代码中,待扫描的目录名称就是通过 scheduleJob() 方法存入到 JobDataMap 中的。 Job 只是一个部分而已。注意我们没有在 JobDetail 对象中为 Job 设定执行日期和次数。这是 Quartz Trigger 该做的事。顾名思义,Trigger 的责任就是触发一个 Job 去执行。当用 Scheduler 注册一个 Job 的时候要创建一个 Trigger 与这个 Job 相关联。Quartz 提供了四种类型的 Trigger,但其中两种是最为常用的,它们就是在下面要用到的 SimpleTrigger 和 CronTrigger. SimpleTrigger 是两个之中简单的那个,它主要用来激发单事件的 Job,Trigger 在指定时间激发,并重复 n 次--两次激发时间之间的延时为 m,然后结束作业。CronTrigger 非常复杂且强大。它是基于通用的公历,当需要用一种较复杂的时间表去执行一个 Job 时用到。例如,四月至九月的每个星期一、星期三、或星期五的午夜。 为更简单的使用 Trigger,Quartz 包含了一个工具类,叫做 org.quartz.TriggerUtils. TriggerUtils 提供了许多便捷的方法简化了构造和配置 trigger. 本文的例子中有用的就是 TriggerUtils 类;SimpleTrigger 和 CronTrigger 会在后面用到。 正如你看到的那样,调用了 TriggerUtils 的方法 makeSecondlyTrigger() 来创建一个每10秒种激发一次的 trigger(实际是由 TriggerUtils 生成了一个 SimpleTrigger 实例,但是我们的代码并不想知道这些)。我们同样要给这个 trigger 实例一个名称并告诉它何时激发相应的 Job;与之关联的 Job 会立即启动,因为由方法 setStartTime() 设定的是当前时间 复制代码 package com.vista.quartz; import java.util.Date; import org.apache.commons.logging.Log; import org.apache.commons.logging.LogFactory; import org.quartz.JobDetail; import org.quartz.Scheduler; import org.quartz.SchedulerException; import org.quartz.Trigger; import org.quartz.TriggerUtils; import org.quartz.impl.StdSchedulerFactory; public class SimpleScheduler { static Log logger = LogFactory.getLog(SimpleScheduler.class); public static void main(String[] args) { SimpleScheduler simple = new SimpleScheduler(); try { // Create a Scheduler and schedule the Job Scheduler scheduler = simple.createScheduler(); simple.scheduleJob(scheduler); // Start the Scheduler running scheduler.start(); logger.info( "Scheduler started at " + new Date()); } catch (SchedulerException ex) { logger.error(ex); } } public Scheduler createScheduler() throws SchedulerException {//创建调度器 return StdSchedulerFactory.getDefaultScheduler(); } //Create and Schedule a ScanDirectoryJob with the Scheduler private void scheduleJob(Scheduler scheduler) throws SchedulerException { // Create a JobDetail for the Job JobDetail jobDetail = new JobDetail("ScanDirectory",Scheduler.DEFAULT_GROUP,ScanDirectoryJob.class); // Configure the directory to scan jobDetail.getJobDataMap().put("SCAN_DIR","D:\\Tomcat\\conf"); //set the JobDataMap that is associated with the Job. // Create a trigger that fires every 10 seconds, forever Trigger trigger = TriggerUtils.makeSecondlyTrigger(10);//每10秒触发一次 trigger.setName("scanTrigger"); // Start the trigger firing from now trigger.setStartTime(new Date());//设置第一次触发时间 // Associate the trigger with the job in the scheduler scheduler.scheduleJob(jobDetail, trigger); } } 复制代码 假如你有不只一个个 Job (你也许就是),你将需要为每一个 Job 创建各自的 JobDetail。每一个 JobDetail 必须通过 scheduleJob() 方法一一注册到 Scheduler 上。而如果你想重用了一个 Job 类,让它产生多个实例运行,那么你需要为每个实例都创建一个 JobDetail。例如,假如你想重用 ScanDirectoryJob 让它检查两个不同的目录,你需要创建并注册两个 JobDetail 实例 复制代码 package com.vista.quartz; import java.util.Date; import org.apache.commons.logging.Log; import org.apache.commons.logging.LogFactory; import org.quartz.JobDetail; import org.quartz.Scheduler; import org.quartz.SchedulerException; import org.quartz.Trigger; import org.quartz.TriggerUtils; import org.quartz.impl.StdSchedulerFactory; public class SimpleScheduler { static Log logger = LogFactory.getLog(SimpleScheduler.class); public static void main(String[] args) { SimpleScheduler simple = new SimpleScheduler(); try { // Create a Scheduler and schedule the Job Scheduler scheduler = simple.createScheduler(); // Jobs can be scheduled after Scheduler is running scheduler.start(); logger.info("Scheduler started at " + new Date()); // Schedule the first Job simple.scheduleJob(scheduler, "ScanDirectory1",ScanDirectoryJob.class,"D:\\conf1", 10); // Schedule the second Job simple.scheduleJob(scheduler, "ScanDirectory2",ScanDirectoryJob.class,"D:\\conf2 ", 15); } catch (SchedulerException ex) { logger.error(ex); } } public Scheduler createScheduler() throws SchedulerException {//创建调度器 return StdSchedulerFactory.getDefaultScheduler(); } private void scheduleJob(Scheduler scheduler, String jobName,Class jobClass, String scanDir, int scanInterval) throws SchedulerException { // Create a JobDetail for the Job JobDetail jobDetail = new JobDetail(jobName,Scheduler.DEFAULT_GROUP, jobClass); // Configure the directory to scan jobDetail.getJobDataMap().put("SCAN_DIR", scanDir); // Trigger that repeats every "scanInterval" secs forever Trigger trigger = TriggerUtils.makeSecondlyTrigger(scanInterval); trigger.setName(jobName + "-Trigger"); // Start the trigger firing from now trigger.setStartTime(new Date()); // Associate the trigger with the job in the scheduler scheduler.scheduleJob(jobDetail, trigger); } } 复制代码 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2008/09/03/1282747.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Django学习笔记----快速入门

上一篇>Django学习笔记----环境搭建基于Windows 基于以下环境: Windows 10 Python 3.6 Django 1.18 开始第一个Django项目 进入Cmder, 进入想创建工程的文件夹, 键入django-admin startproject 项目名 注意不能选择test这样的项目名称, 会于Python已有的模块名称冲突 Begin! 生成成功后, 可以看到如下项目结构 mysite/ manage.py mysite/ __init__.py settings.py urls.py wsgi.py manage.py: 一个实用的命令行工具,可让你以各种方式与该 Django 项目进行交互。 mysite/_init_.py: 一个空文件,告诉 Python 该目录是一个 Python 包。 mysite/settings.py: 该 Django 项目的设置/配置。 mysite/urls.py: 该 Django 项目的 URL 声明; 一份由 Django 驱动的网站"目录"。 mysite/wsgi.py: 一个 WSGI 兼容的 Web 服务器的入口,以便运行你的项目。 建立第一个App 在cmder中键入 django-admin startapp testApp 在settings.py中的INSTALLED_APPS中键入App名称,如此处的testApp # 示例代码 INSTALLED_APPS = [ 'django.contrib.admin', 'django.contrib.auth', 'django.contrib.contenttypes', 'django.contrib.sessions', 'django.contrib.messages', 'django.contrib.staticfiles', # 键入你的App 'testApp', ] 建立视图与路由的映射 views.py中的函数对应url.py中的urlpatterns(url格式) views.py # 首个参数需要是request def hello(request): return HttpResponse("Hello World") urls.py “urlpatterns”列表将URL路由映射到视图。 指向路径(第一个参数)都由此视图代理 ^头部匹配, $尾部匹配 程序从项目的settings.py中找到ROOT_URLCONF定义的urls.py的路径,在此路径中查找对应的url pattern, 进入相应的视图函数中, 通过HttpResponse返回响应的对象经处理后显示在网页上 urlpatterns = [ url(r'^hello/$', views.hello, name='hello'), ] urlpatterns中可以使用正则表达式进行匹配. 配置完毕后在Cmder中键入python manage.py runserver启动Django 需要注意的是处于开发者状态时, Django显示的是对应的错误信息 正式发布时需要将settings.py的DEBUG=True改为False

优秀的个人博客,低调大师

Hbase快速开始——shell操作

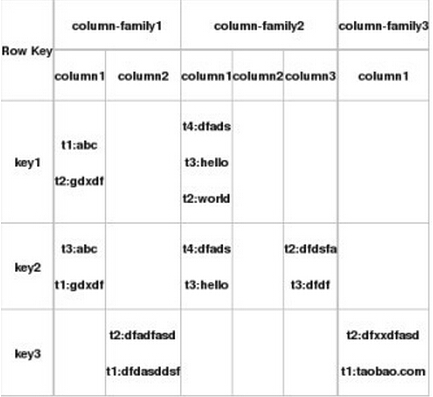
一. 介绍 HBase是一个分布式的、面向列的开源数据库,源于google的一篇论文《bigtable:一个结构化数据的分布式存储系统》。HBase是Google Bigtable的开源实现,它利用Hadoop HDFS作为其文件存储系统,利用Hadoop MapReduce来处理HBase中的海量数据,利用Zookeeper作为协同服务。 HBase以表的形式存储数据。表有行和列组成。列划分为若干个列族/列簇(column family)。 如上图所示,key1, key2, key3是三条记录的唯一的row key值,column-family1, column-family2, column-family3是三个列族,每个列族下又包括几列。比如 column-family1这个列族下包括两列,名字是column1和column2。t1:abc,t2:gdxdf是由row key1和column-family1-column1唯一确定的一个单元cell。这个cell中有两个数据,abc和gdxdf。两个值的时间戳不一样,分别是t1,t2, hbase会返回最新时间的值给请求者。 二. 安装 下载HBase最新版本,放到合适的目录,比如/usr/local 或 /opt 之后解压 tar -zxvf hbase-x.y.z tar.gz 三. 命令行操作 进入解压后的目录,开启hbase,启动hbase shell bin/start-hbase.sh bin/hbase shell 输入 help 可以看到命令分组 部分命令清单 下边分组举例 general操作 查询服务器状态 status 查询hbase版本 version ddl操作 1. 创建一个表 create 'table1', 'tab1_id', 'tab1_add', 'tab1_info' 2. 列出所有的表 list 3. 获得表的描述 describe "table1" 4. 删除一个列族 disable alter enable disable 'table1' alter 'table1', {NAME=>'tab1_add', METHOD=>'delete'} enable 'table1' 5. 查看表是否存在 exists 'table2' 6. 判断表是否为‘enable’ is_enabled 'table1' 判断表是否为‘disable’ is_disabled 'table1' 7. 删除一个表 disable 'table1' drop 'table1' dml操作 1. 插入几条记录 1 2 3 4 5 6 put 'member' , 'scutshuxue' , 'info:age' , '24' put 'member' , 'scutshuxue' , 'info:birthday' , '1987-06-17' put 'member' , 'scutshuxue' , 'info:company' , 'alibaba' put 'member' , 'scutshuxue' , 'address:contry' , 'china' put 'member' , 'scutshuxue' , 'address:province' , 'zhejiang' put 'member' , 'scutshuxue' , 'address:city' , 'hangzhou' 2. 全表扫描 scan 3. 获得数据 get 3.1 获得一行的所有数据 3.2 获得某行,某列族的所有数据 3.3 获得某行,某列族,某列的所有数据 4. 更新一条记录 put(把scutshuxue年龄改为99) put 'member', 'scutshuxue', 'info:age', 99 5. 删除 delete、 deleteall 5.1 (删除行'scutshuxue', 列族为‘info' 中age的值 delete 'member', 'scutshuxue', 'info:age' 5.2 删除整行 deleteall 'member', 'scutshuxue' 6. 查询表中有多少行 count 'member' 7.给‘xiaoming’这个id增加'info:age'字段,并使用counter实现递增 incr 'member', 'xiaoming', 'info:age' 8. 将整个表清空 truncate 'member' tools操作 1. 创建一个表 四. 参考 http://smallwildpig.iteye.com/blog/1705718 本文转自jihite博客园博客,原文链接:http://www.cnblogs.com/kaituorensheng/p/3814925.html,如需转载请自行联系原作者
优秀的个人博客,低调大师

.Net Micro Framework 快速入门

一、简介 Microsoft .NET Micro Framework 2001年由微软研究院开始研发,并随后在其MSN Direct项目中使用该技术,2007年9月微软对外发布2.0,2008年10月 V3.0、2009年11月 V4.0、2010年5月 V4.1 beta,2009年并入.NET产品组,Digi、Atmel、飞思卡尔等半导体公司都先后为其推出了开发板,该技术可以应用到远程控制、智能家电、教育类机器、医疗电子、零售终端、Sideshow以及汽车电子等行业应用场景;此外由于.Net MF集成了各种接口,如串口、网口、Wifi、Zigbee、I2C、SPI、SDIO、USB等通信接口,加上其应用开发简便,所以在物联网时代,将大有作为。 <1>.Net Micro Framework 低价开发板 http://blog.csdn.net/yefanqiu/archive/2010/06/03/5645129.aspx <2>.Net Micro Framework 所有博文 http://blog.csdn.net/yefanqiu/category/633947.aspx ----------------------------- Microsoft .NET Micro Framework 将 .NET 的可靠性和效率与 Visual Studio的高生产率结合起来,以针对价格较低、资源受限的小型设备开发应用程序,可帮助人们使用熟悉的 Visual Studio 工具来构建托管的嵌入式应用程序。2009年5月,.Net Micro Framework采用Apache 2.0 license,比Linux等开源软件更为彻底的方式实现了源代码完全开放。 1.哪些领域可以采用.NET Micro Framework技术? .NET Micro Framework技术可以应用到:Sideshow、远程控制、智能家电、教育类机器、医疗电子、零售终端以及汽车电子等行业应用场景;此外由于.Net MF集成了各种接口,如串口、网口、Wifi、Zigbee、I2C、SPI、SDIO、USB等通信接口,加上其应用开发简便,所以在物联网时代,将大有作为。 2.NET Micro Framework与Window CE和Windows XP Embedded的区别? .NET Micro Framework对存储器和处理器的要求更低。开发人员可以在低功耗、低成本的ARM7、ARM9、Blackfin和Cortex-M3处理器上使用该框架(不需要MMU支持),所开发出来的软件仅需要几百Kbytes的RAM或Flash/ROM存储空间。而Windows Embedded CE的托管代码环境需要约10~12Mbytes的存储空间,基于.NET的应用编程设备只需要较少的存储空间,降低了产品成本。 3.NET Micro Framework与其他.NET平台的区别? 作为.NET家族的一员,.Net Micro Framework是微软专门针对超轻量级平台设计的软件架构。与.Net Framework和.Net Compact Framework不同的地方是,.Net Micro Framework具有自启动的特性,并且在HAL层,微软将操作系统的必要特性引入,如:启动管理、中断处理、线程调度、内存管理等。.Net Micro Framework可以单独使用,不需要依托其它操作系统,因此占用空间很小。 二、应用开发 1、.Net Micro Framework研究—Digi开发板初探http://yfsoft.blog.51cto.com/1635641/323413 2、.Net Micro Framework研究—IO读写http://yfsoft.blog.51cto.com/1635641/323412 3、.Net Micro Framework研究—串口操作http://yfsoft.blog.51cto.com/1635641/323411 4、.Net Micro Framework研究—TCP/IP通信http://yfsoft.blog.51cto.com/1635641/323409 5、.Net Micro Framework研究—模拟器改造http://yfsoft.blog.51cto.com/1635641/3234098 6、.Net Micro Framework研究—中文显示 http://yfsoft.blog.51cto.com/1635641/3234097 7、 .Net Micro Framework研究—绘图http://yfsoft.blog.51cto.com/1635641/323402 8、.Net Micro Framework研究—Shapes命名空间http://yfsoft.blog.51cto.com/1635641/323401 9、.Net Micro Framework研究—窗体控件http://yfsoft.blog.51cto.com/1635641/323400 10、.Net Micro Framework研究—应用实例http://yfsoft.blog.51cto.com/1635641/322945 11、.Net Micro Framework研究—Tinyfnt字体研究http://yfsoft.blog.51cto.com/1635641/322943 12、.Net Micro Framework研究—带IO的模拟器http://yfsoft.blog.51cto.com/1635641/322942 13、 .Net Micro Framework研究—带AD的模拟器http://yfsoft.blog.51cto.com/1635641/322939 14、 .Net Micro Framework研究—带I2C总线的模拟器http://yfsoft.blog.51cto.com/1635641/322937 15、..Net Micro Framework研究—Windows桌面http://yfsoft.blog.51cto.com/1635641/322933 16、.Net Micro Framework研究—模拟器直接运行MF程序http://yfsoft.blog.51cto.com/1635641/322928 17、.Net Micro Framework研究—用MF编写俄罗斯方块http://yfsoft.blog.51cto.com/1635641/322921 18、.Net Micro Framework研究—让MF支持鼠标http://yfsoft.blog.51cto.com/1635641/322917 19、.Net Micro Framework研究—用MF控制机器人http://yfsoft.blog.51cto.com/1635641/323874 20、.Net Micro Framework研究—数据的永久存储http://yfsoft.blog.51cto.com/1635641/322911 21、.Net Micro Framework研究—实现SideShow窗体界面http://yfsoft.blog.51cto.com/1635641/322900 22、.Net Micro Framework研究—让MF支持英文输入法http://yfsoft.blog.51cto.com/1635641/321212 23、.Net Micro Framework研究—MF驱动继电器 http://yfsoft.blog.51cto.com/1635641/321288 24、.Net Micro Framework研究—串口部署的困惑 http://yfsoft.blog.51cto.com/1635641/321286 25、.Net Micro Framework研究—串口部署释疑 http://yfsoft.blog.51cto.com/1635641/321212 26、.Net Micro Framework研究— http://yfsoft.blog.51cto.com/1635641/321282 三、系统移植 1、【.Net Micro Framework PortingKit - 01】移植初步:环境搭建http://yfsoft.blog.51cto.com/1635641/321243 2、【.Net Micro Framework PortingKit - 02】STM3210E平台构建http://yfsoft.blog.51cto.com/1635641/321240 3、【.Net Micro Framework PortingKit - 03】调试初步:点亮LED灯http://yfsoft.blog.51cto.com/1635641/321238 4、【.Net Micro Framework PortingKit - 04】修改启动代码&重写向量表http://yfsoft.blog.51cto.com/1635641/321235 5、【.Net Micro Framework PortingKit - 05】SRAM初始化&设置NVIC中断表偏移http://yfsoft.blog.51cto.com/1635641/321234 6、【.Net Micro Framework PortingKit - 06】设置芯片时钟http://yfsoft.blog.51cto.com/1635641/321233 7、【.Net Micro Framework PortingKit - 07】NVIC中断处理http://yfsoft.blog.51cto.com/1635641/321229 8、【.Net Micro Framework PortingKit - 08】GPIO驱动http://yfsoft.blog.51cto.com/1635641/321228 9、【.Net Micro Framework PortingKit – 09】串口驱动http://yfsoft.blog.51cto.com/1635641/321224 10、【.Net Micro Framework PortingKit – 10】世界首款Cortex-M3内核MFV4诞生http://yfsoft.blog.51cto.com/1635641/323881 11、【.Net Micro Framework PortingKit – 11】NandFlash驱动开发http://yfsoft.blog.51cto.com/1635641/321222 12、【.Net Micro Framework PortingKit – 12】SysTick驱动开发http://yfsoft.blog.51cto.com/1635641/321221 13、【.Net Micro Framework PortingKit – 13】LCD驱动开发http://yfsoft.blog.51cto.com/1635641/321220 14、【.Net Micro Framework PortingKit – 14】TinyCLR编译与测试http://yfsoft.blog.51cto.com/1635641/321219 15、【.Net Micro Framework PortingKit – 15】移植总结(兼谈MF未来发展)http://yfsoft.blog.51cto.com/1635641/321218 四、高级开发 1、【玩转.Net MF – 01】Flash远程读写 http://yfsoft.blog.51cto.com/1635641/321217 2、【玩转.Net MF – 02】让PC成为MF的鼠标键盘 http://yfsoft.blog.51cto.com/1635641/321216 3、【玩转.Net MF – 03】远程文件查看器 http://yfsoft.blog.51cto.com/1635641/321214 4、【玩转.Net MF – 04】远程屏幕截图 http://yfsoft.blog.51cto.com/1635641/321215 5、【玩转.Net MF – 05】加载文件系统中的Pe文件 http://yfsoft.blog.51cto.com/1635641/321213 五、功能扩展 1、支持横竖屏切换的.Net Micro Framework模拟器 http://yfsoft.blog.51cto.com/1635641/321248 2、Micro Framework 3.0模拟器改造 http://yfsoft.blog.51cto.com/1635641/321260 3、开源System.Windows.Forms库,让.Net Micro Framework界面开发和上位机一样简单 http://yfsoft.blog.51cto.com/1635641/321246 六、相关网址 1、官方网址 http://www.microsoft.com/netmf/default.mspx 2、官方博客 http://blogs.msdn.com/netmfteam/ 3、中文博客 http://yfsoft.blog.51cto.com http://www.cnblogs.com/yefanqiu 4、中文讨论组 http://space.cnblogs.com/group/MFSoft 5、SDK下载 http://www.microsoft.com/downloads/details.aspx?FamilyId=77dbfc46-14a1-4dcf-a809-eda7ccfe376b&displaylang=en 6、源码下载 http://www.microsoft.com/downloads/details.aspx?displaylang=en&FamilyID=16fa5d31-a583-4c0d-af74-f4d5e235d5bc 更多文章,请随时关注:http://yfsoft.blog.51cto.com 本文转自yefanqiu51CTO博客,原文链接:http://blog.51cto.com/yfsoft/321212,如需转载请自行联系原作者

优秀的个人博客,低调大师

HBase伪快速分页查询

之前有两个功能,都是查询历史数据的一个分页查询,系统刚上线的时候,没有太多的数据,就一直扔在mysql里面,后来里面数据上亿之后,就查不到了,而且数据还在以指数级增长方式上报,后来,这部分业务单独迁移到hbase集群去存放,之前页面的查询也改查hbase了。但是hbase对分页查询这种东西支持不好,如果按照以往查询mysql的思路,查询出一个总的count,再查询出这一页的数据,这种方式去查询hbase,那么如果你仔细去跟代码计算时间的话,你会发现hbase去查count,无论哪种方式,都会引起全表扫描,是非常慢的。整个页面加载出来,看了下响应事件,大概要45s,等的我都喝了两杯茶了。 so,我想了个比较伪的分页查询方法,去掉查询count操作,值查询一页数据: public Page<BatteryData> findBatterHisData(BatteryHisDto dto)throws Exception { Page<BatteryData> dataPage=new Page<BatteryData>(); List<BatteryData> dataList=new ArrayList<>(); int totalSize=0; Table table=runner.getTable(tableName); Scan dataScan=new Scan(); ResultScanner dataScanner=null; List<Filter> dataFilters = new ArrayList<Filter>(); if(StringUtils.isNotBlank(dto.getBatteryNo())){//电池组编号过滤 Filter filter=new RowFilter(CompareFilter.CompareOp.EQUAL, new SubstringComparator(dto.getBatteryNo()+"_")); dataFilters.add(filter); } Filter pageFilter=new PageFilter(dto.getPage()+dto.getPageSize()); dataFilters.add(pageFilter); FilterList dataFilterList = new FilterList(FilterList.Operator.MUST_PASS_ALL, dataFilters); dataScan.setFilter(dataFilterList); dataScanner=table.getScanner(dataScan); dataList= rsh.handle(tableName,dataScanner); if(dataList==null || dataList.size()<1){ dataPage.setTotalCount(0); dataPage.setResult(null); return dataPage; } int startNo = dto.getPage(); int endNo=startNo+dto.getPageSize(); dataPage.setTotalCount(dto.getPage()+dto.getPageSize()+1); dataPage.setResult(dataList.subList(startNo,endNo)); table.close(); return dataPage; } 因为用户关注的,通常是前几页的数据,所有我每次查询的时候,返回总页数,都返回个随便的数(跟前端的分页表格配合,实际上,我的前端只提供了上下分页,哈哈),然后查询有限条的数据,通常hbase表都是上亿甚至是百亿的,所以,用户时不太可能通过只点击上一页下一页,这样点到我最后一页的,可以放心了。最多他点个几千页,也就手疼到不行了。这样下来,响应速度控制在800ms内,无压力。 PS,看到很多网友通过rowkey去做分页,具体思路是,每次记录下起始的rowkey和结束的rowkey,然后根据rowkey搜索,这样也是很快的,个人认为,也ok。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册