首页 文章 精选 留言 我的

精选列表

搜索[多模态理解],共10000篇文章
优秀的个人博客,低调大师

Java 8 Stream原理解析

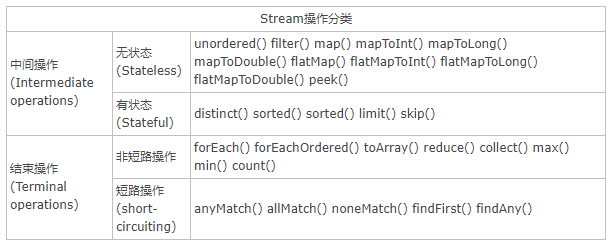
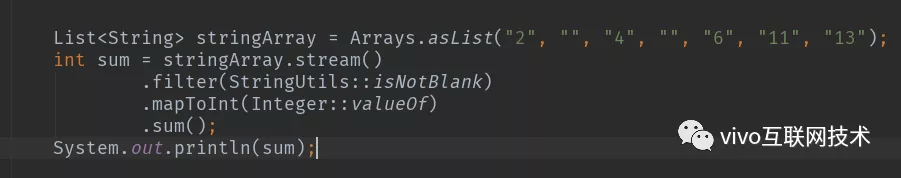
说起 Java 8,我们知道 Java 8 大改动之一就是增加函数式编程,而 Stream API 便是函数编程的主角,Stream API 是一种流式的处理数据风格,也就是将要处理的数据当作流,在管道中进行传输,并在管道中的每个节点对数据进行处理,如过滤、排序、转换等。 首先我们先看一个使用Stream API的示例,具体代码如下: code1 Stream example 这是个很简单的一个Stream使用例子,我们过滤掉空字符串后,转成int类型并计算出最大值,这其中包括了三个操作:filter、mapToInt、sum。相信大多数人再刚使用Stream API的时候都会有个疑问,Stream是指怎么实现的,是每一次函数调用就执行一次迭代吗?答案肯定是否,因为如果真的是每一次函数调用就执行一次迭代,这个效率是很难接受的,Stream也不会那么受欢迎。 其实Stream内部是通过流水线(Pipeline)的方式来实现的,基本思想是在迭代的时候顺着流水线尽可能的执行更多的操作,从而避免多次迭代。为了对Stream的操作有更清晰的认识,我们汇总了Stream的所有操作。 从上表可以看出Stream将所有操作分为两类:中间操作和终止操作。其中中间操作分为无状态和有状态,终止操作分为非短路操作和短路操作,下面是针对这几个操作的含义说明: 1、中间操作:中间操作只是一种标记,只有结束操作才会触发实际计算 无状态:指元素的处理不受前面元素的影响; 有状态:有状态的中间操作必须等到所有元素处理之后才知道最终结果,比如排序是有状态操作,在读取所有元素之前并不能确定排序结果。 2、终止操作:顾名思义,就是得出最后计算结果的操作 短路操作:指不用处理全部元素就可以返回结果; 非短路操作:指必须处理所有元素才能得到最终结果。 Stream流水线解决方案 通过上面的介绍,我们了解到Stream在执行中间操作时仅仅是记录,当用户调用终止操作时,会在一个迭代里将已经记录的操作顺着流水线全部执行掉。沿着这个思路,有几个问题需要解决: 用户的操作如何记录? 操作如何叠加? 叠加之后的操作如何执行? 1、操作如何记录 图1-1 关于操作如何记录,在JDK源码注释中多次用(操作)stage来标识用户的每一次操作,而通常情况下Stream的操作又需要一个回调函数,所以一个完整的操作是由数据来源、操作、回调函数组成的三元组来表示。而在具体实现中,使用实例化的ReferencePipeline来表示,即图1-1中的Head、StatelessOp、StatefulOp的实例。接下来我们来看下Stream几个常用方法的源码。 code2 Collection.Stream() code3StreamSupport.stream() code4 ReferencePipeline.map() 从上面源码中可以看出来,我们调用stream()方法时最终会创建一个Head实例来表示流操作的头,当调用map()方法时则会创建无状态的中间操作实例StatelessOp,同样调用其他操作对应的方法也会生成一个ReferencePipeline实例,在这里就不一一列举。在用户调用一系列操作后,最终会形成一个双向链表,如下图所示: 图1-2 2、操作如何叠加 上面我们说明了Stream是通过stage记录操作,但stage只保存当前操作,它并不知道下个stage如何操作,需要什么操作。所以要执行的话还需要某种协议将各个stage关联起来。jdk中就是使用Slink接口来实现的,Slink接口定义begin()、end()、cancellationRequested()、accept()四个方法,如下表所示。 往回看code3 ReferencePipeline.map()的方法,我们会发现我们在创建一个ReferencePipeline实例的时候,需要重写opWrapSink方法来生成对应Sink实例。而且通过阅读源码会发现常用的操作都会创建一个ChainedReference实例。我们可以看下code5 ChainedReference抽象类的源码实现,因为ChainedReference只是个抽象实现,不携带具体操作的特性,所以是更能体现作者的设计理念。 通过查看源码可以发现ChainedReference会持有下一个操作的Slink,并在调用begin、end、cancellationRequested方法会调用下一个操作的Slink的相应方法,以此来达到叠加的效果。 code5ChainedReference 3、叠加之后的操作如何执行 Sink完美封装了Stream每一步操作,并给出了[处理->转发]的模式来叠加操作。这一连串的齿轮已经咬合,就差最后一步拨动齿轮启动执行。是什么启动这一连串的操作呢?也许你已经想到了启动的原始动力就是结束操作(Terminal Operation),一旦调用某个结束操作,就会触发整个流水线的执行。 结束操作之后不能再有别的操作,所以结束操作不会创建新的流水线阶段(Stage),直观的说就是流水线的链表不会在往后延伸了。结束操作会创建一个包装了自己操作的Sink,这也是流水线中最后一个Sink,这个Sink只需要处理数据而不需要将结果传递给下游的Sink(因为没有下游)。对于Sink的[处理->转发]模型,结束操作的Sink就是调用链的出口。 我们再来考察一下上游的Sink是如何找到下游Sink的。一种可选的方案是在PipelineHelper中设置一个Sink字段,在流水线中找到下游Stage并访问Sink字段即可。但Stream类库的设计者没有这么做,而是设置了一个Sink AbstractPipeline.opWrapSink(int flags, Sink downstream)方法来得到Sink,该方法的作用是返回一个新的包含了当前Stage代表的操作以及能够将结果传递给downstream的Sink对象。为什么要产生一个新对象而不是返回一个Sink字段?这是因为使用opWrapSink()可以将当前操作与下游Sink(上文中的downstream参数)结合成新Sink。试想只要从流水线的最后一个Stage开始,不断调用上一个Stage的opWrapSink()方法直到最开始(不包括stage0,因为stage0代表数据源,不包含操作),就可以得到一个代表了流水线上所有操作的Sink,用代码表示就是这样: code6AbstractPipeline.wrapSink 现在流水线上从开始到结束的所有的操作都被包装到了一个Sink里,执行这个Sink就相当于执行整个流水线,执行Sink的代码如下: code7AbstractPipeline.copyInto 上述代码首先调用wrappedSink.begin()方法告诉Sink数据即将到来,然后调用spliterator.forEachRemaining()方法对数据进行迭代,最后调用wrappedSink.end()方法通知Sink数据处理结束。逻辑如此清晰。 作者:Huang Rongpeng

优秀的个人博客,低调大师

Reactor:深入理解reactor core

简介 上篇文章我们简单的介绍了Reactor的发展史和基本的Flux和Mono的使用,本文将会进一步挖掘Reactor的高级用法,一起来看看吧。 自定义Subscriber 之前的文章我们提到了4个Flux的subscribe的方法: Disposable subscribe(); Disposable subscribe(Consumer<? super T> consumer); Disposable subscribe(Consumer<? super T> consumer, Consumer<? super Throwable> errorConsumer); Disposable subscribe(Consumer<? super T> consumer, Consumer<? super Throwable> errorConsumer, Runnable completeConsumer); Disposable subscribe(Consumer<? super T> consumer, Consumer<? super Throwable> errorConsumer, Runnable completeConsumer, Consumer<? super Subscription> subscriptionConsumer); 这四个方法,需要我们使用lambda表达式来自定义consumer,errorConsumer,completeSonsumer和subscriptionConsumer这四个Consumer。 写起来比较复杂,看起来也不太方便,我们考虑一下,这四个Consumer是不是和Subscriber接口中定义的4个方法是一一对应的呢? public static interface Subscriber<T> { public void onSubscribe(Subscription subscription); public void onNext(T item); public void onError(Throwable throwable); public void onComplete(); } 对的,所以我们有一个更加简单点的subscribe方法: public final void subscribe(Subscriber<? super T> actual) 这个subscribe方法直接接收一个Subscriber类。从而实现了所有的功能。 自己写Subscriber太麻烦了,Reactor为我们提供了一个BaseSubscriber的类,它实现了Subscriber中的所有功能,还附带了一些其他的方法。 我们看下BaseSubscriber的定义: public abstract class BaseSubscriber<T> implements CoreSubscriber<T>, Subscription, Disposable 注意,BaseSubscriber是单次使用的,这就意味着,如果它首先subscription到Publisher1,然后subscription到Publisher2,那么将会取消对第一个Publisher的订阅。 因为BaseSubscriber是一个抽象类,所以我们需要继承它,并且重写我们需要自己实现的方法。 下面看一个自定义的Subscriber: public class CustSubscriber<T> extends BaseSubscriber<T> { public void hookOnSubscribe(Subscription subscription) { System.out.println("Subscribed"); request(1); } public void hookOnNext(T value) { System.out.println(value); request(1); } } BaseSubscriber中有很多以hook开头的方法,这些方法都是我们可以重写的,而Subscriber原生定义的on开头的方法,在BaseSubscriber中都是final的,都是不能重写的。 我们看一个定义: [@Override](https://my.oschina.net/u/1162528) public final void onSubscribe(Subscription s) { if (Operators.setOnce(S, this, s)) { try { hookOnSubscribe(s); } catch (Throwable throwable) { onError(Operators.onOperatorError(s, throwable, currentContext())); } } } 可以看到,它内部实际上调用了hook的方法。 上面的CustSubscriber中,我们重写了两个方法,一个是hookOnSubscribe,在建立订阅的时候调用,一个是hookOnNext,在收到onNext信号的时候调用。 在这些方法中,给了我们足够的自定义空间,上面的例子中我们调用了request(1),表示再请求一个元素。 其他的hook方法还有: hookOnComplete, hookOnError, hookOnCancel 和 hookFinally。 Backpressure处理 我们之前讲过了,reactive stream的最大特征就是可以处理Backpressure。 什么是Backpressure呢?就是当consumer处理过不来的时候,可以通知producer来减少生产速度。 我们看下BaseSubscriber中默认的hookOnSubscribe实现: protected void hookOnSubscribe(Subscription subscription){ subscription.request(Long.MAX_VALUE); } 可以看到默认是request无限数目的值。 也就是说默认情况下没有Backpressure。 通过重写hookOnSubscribe方法,我们可以自定义处理速度。 除了request之外,我们还可以在publisher中限制subscriber的速度。 public final Flux<T> limitRate(int prefetchRate) { return onAssembly(this.publishOn(Schedulers.immediate(), prefetchRate)); } 在Flux中,我们有一个limitRate方法,可以设定publisher的速度。 比如subscriber request(100),然后我们设置limitRate(10),那么最多producer一次只会产生10个元素。 创建Flux 接下来,我们要讲解一下怎么创建Flux,通常来讲有4种方法来创建Flux。 使用generate 第一种方法就是最简单的同步创建的generate. 先看一个例子: public void useGenerate(){ Flux<String> flux = Flux.generate( () -> 0, (state, sink) -> { sink.next("3 x " + state + " = " + 3*state); if (state == 10) sink.complete(); return state + 1; }); flux.subscribe(System.out::println); } 输出结果: 3 x 0 = 0 3 x 1 = 3 3 x 2 = 6 3 x 3 = 9 3 x 4 = 12 3 x 5 = 15 3 x 6 = 18 3 x 7 = 21 3 x 8 = 24 3 x 9 = 27 3 x 10 = 30 上面的例子中,我们使用generate方法来同步的生成元素。 generate接收两个参数: public static <T, S> Flux<T> generate(Callable<S> stateSupplier, BiFunction<S, SynchronousSink<T>, S> generator) 第一个参数是stateSupplier,用来指定初始化的状态。 第二个参数是一个generator,用来消费SynchronousSink,并生成新的状态。 上面的例子中,我们每次将state+1,一直加到10。 然后使用subscribe来将所有的生成元素输出。 使用create Flux也提供了一个create方法来创建Flux,create可以是同步也可以是异步的,并且支持多线程操作。 因为create没有初始的state状态,所以可以用在多线程中。 create的一个非常有用的地方就是可以将第三方的异步API和Flux关联起来,举个例子,我们有一个自定义的EventProcessor,当处理相应的事件的时候,会去调用注册到Processor中的listener的一些方法。 interface MyEventListener<T> { void onDataChunk(List<T> chunk); void processComplete(); } 我们怎么把这个Listener的响应行为和Flux关联起来呢? public void useCreate(){ EventProcessor myEventProcessor = new EventProcessor(); Flux<String> bridge = Flux.create(sink -> { myEventProcessor.register( new MyEventListener<String>() { public void onDataChunk(List<String> chunk) { for(String s : chunk) { sink.next(s); } } public void processComplete() { sink.complete(); } }); }); } 使用create就够了,create接收一个consumer参数: public static <T> Flux<T> create(Consumer<? super FluxSink<T>> emitter) 这个consumer的本质是去消费FluxSink对象。 上面的例子在MyEventListener的事件中对FluxSink对象进行消费。 使用push push和create一样,也支持异步操作,但是同时只能有一个线程来调用next, complete 或者 error方法,所以它是单线程的。 使用Handle Handle和上面的三个方法不同,它是一个实例方法。 它和generate很类似,也是消费SynchronousSink对象。 Flux<R> handle(BiConsumer<T, SynchronousSink<R>>); 不同的是它的参数是一个BiConsumer,是没有返回值的。 看一个使用的例子: public void useHandle(){ Flux<String> alphabet = Flux.just(-1, 30, 13, 9, 20) .handle((i, sink) -> { String letter = alphabet(i); if (letter != null) sink.next(letter); }); alphabet.subscribe(System.out::println); } public String alphabet(int letterNumber) { if (letterNumber < 1 || letterNumber > 26) { return null; } int letterIndexAscii = 'A' + letterNumber - 1; return "" + (char) letterIndexAscii; } 本文的例子learn-reactive 本文作者:flydean程序那些事 本文链接:http://www.flydean.com/reactor-core-in-depth/ 本文来源:flydean的博客 欢迎关注我的公众号:「程序那些事」最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现!

优秀的个人博客,低调大师

深入理解Java线程池

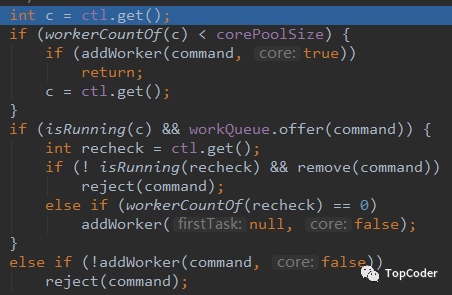
编者注:Java中的线程池是运用场景最多的并发组件,几乎所有需要异步或并发执行任务的程序都可以使用线程池。 在开发过程中,合理地使用线程池能够带来至少以下几个好处。 降低资源消耗:通过重复利用已创建的线程降低线程创建和销毁造成的消耗。 提高响应速度:当任务到达时,任务可以不需要等到线程创建就能立即执行。 提高线程的可管理性:线程是稀缺资源,如果无限制地创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一分配、调优和监控。但是,要做到合理利用线程池,必须了解其实现原理。 代码解耦:比如生产者消费者模式。 线程池实现原理 当提交一个新任务到线程池时,线程池的处理流程如下: 如果当前运行的线程少于corePoolSize,则创建新线程来执行任务(注意,执行这一步骤需要获取全局锁)。 如果运行的线程等于或多于corePoolSize,则将任务加入BlockingQueue。 如果无法将任务加入BlockingQueue(队列已满),则创建新的线程来处理任务(注意,执行这一步骤也需要获取全局锁)。 如果创建新线程将使当前运行的线程数超出maximumPoolSize,该任务将被拒绝,并调用相应的拒绝策略来处理(RejectedExecutionHandler.rejectedExecution()方法,线程池默认的饱和策略是AbortPolicy,也就是抛异常)。 ThreadPoolExecutor采取上述步骤的总体设计思路,是为了在执行execute()方法时,尽可能地避免获取全局锁(那将会是一个严重的可伸缩瓶颈)。在ThreadPoolExecutor完成预热之后(当前运行的线程数大于等于corePoolSize),几乎所有的execute()方法调用都是执行步骤2,而步骤2不需要获取全局锁。 线程池任务 拒绝策略包括 抛异常、直接丢弃、丢弃队列中最老的任务、将任务分发给调用线程处理。 线程池的创建:通过ThreadPoolExecutor来创建一个线程池。 newThreadPoolExecutor(corePoolSize,maximumPoolSize,keepAliveTime,timeUnit,runnableTaskQueue,handler); 创建一个线程池时需要输入以下几个参数: corePoolSize(线程池的基本大小):当提交一个任务到线程池时,线程池会创建一个线程来执行任务,即使其他空闲的基本线程能够执行新任务也会创建线程,等到线程池的线程数等于线程池基本大小时就不再创建。如果调用了线程池的prestartAllCoreThreads()方法,线程池会提前创建并启动所有基本线程。 maximumPoolSize(线程池最大数量):线程池允许创建的最大线程数。如果队列满了,并且已创建的线程数小于最大线程数,则线程池会再创建新的线程执行任务。值得注意的是,如果使用了无界的任务队列这个参数就没什么效果。 keepAliveTime(线程活动保持时间):线程池的工作线程空闲后,保持存活的时间。所以,如果任务很多,并且每个任务执行的时间比较短,可以调大时间,提高线程的利用率。 TimeUnit(线程活动保持时间的单位):可选的单位有天(DAYS)、小时(HOURS)、分钟(MINUTES)、毫秒(MILLISECONDS)、微秒(MICROSECONDS,千分之一毫秒)和纳秒(NANOSECONDS,千分之一微秒)。 runnableTaskQueue(任务队列):用于保存等待执行的任务的阻塞队列。可以选择以下几个阻塞队列。 - ArrayBlockingQueue:是一个基于数组结构的有界阻塞队列,此队列按FIFO(先进先出)原则对元素进行排序。 LinkedBlockingQueue:一个基于链表结构的阻塞队列,此队列按FIFO排序元素,吞吐量通常要高于ArrayBlockingQueue。静态工厂方法Executors.newFixedThreadPool()使用了这个队列。 SynchronousQueue:一个不存储元素的阻塞队列。每个插入操作必须等到另一个线程调用移除操作,否则插入操作一直处于阻塞状态,吞吐量通常要高于LinkedBlockingQueue,静态工厂方法Executors.newCachedThreadPool使用了这个队列。 PriorityBlockingQueue:一个具有优先级的无界阻塞队列。 线程的状态 在HotSpot VM线程模型中,Java线程被一对一映射到本地系统线程,Java线程启动时会创建一个本地系统线程;当Java线程终止时,这个本地系统线程也会被回收。操作系统调度所有线程并把它们分配给可用的CPU。 thread运行周期中,有以下6种状态,在 java.lang.Thread.State 中有详细定义和说明: //Thread类publicenumState{/***刚创建尚未运行*/NEW,/***可运行状态,该状态表示正在JVM中处于运行状态,不过有可能是在等待其他资源,比如CPU时间片,IO等待*/RUNNABLE,/***阻塞状态表示等待monitor锁(阻塞在等待monitor锁或者在调用Object.wait方法后重新进入synchronized块时阻塞)*/BLOCKED,/***等待状态,发生在调用Object.wait、Thread.join(withnotimeout)、LockSupport.park*表示当前线程在等待另一个线程执行某种动作,比如Object.notify()、Object.notifyAll(),Thread.join表示等待线程执行完成*/WAITING,/***超时等待,发生在调用Thread.sleep、Object.wait、Thread.join(intimeout)、LockSupport.parkNanos、LockSupport.parkUntil*/TIMED_WAITING,/***线程已执行完成,终止状态*/TERMINATED;} 线程池操作 向线程池提交任务,可以使用两个方法向线程池提交任务,分别为execute()和submit()方法。execute()方法用于提交不需要返回值的任务,所以无法判断任务是否被线程池执行成功。通过以下代码可知execute()方法输入的任务是一个Runnable类的实例。 threadsPool.execute(newRunnable(){@Overridepublicvoidrun(){//TODOAuto-generatedmethodstub}}); submit()方法用于提交需要返回值的任务。线程池会返回一个future类型的对象,通过这个future对象可以判断任务是否执行成功,通过future的get()方法来获取返回值,future的get()方法会阻塞当前线程直到任务完成,而使用get(long timeout,TimeUnit unit)方法则会阻塞当前线程一段时间后立即返回,这时候有可能任务还没有执行完。 Future<Object>future=executor.submit(harReturnValuetask);try{Objects=future.get();}catch(InterruptedExceptione){//处理中断异常}catch(ExecutionExceptione){//处理无法执行任务异常}finally{//关闭线程池executor.shutdown();} 合理配置线程池 要想合理配置线程池,必须先分析任务的特点,可以从以下几个角度分析: 任务的性质:CPU密集型任务、IO密集型任务和混合型任务。 任务的优先级:高、中和低。 任务的执行时间:长、中和短。 任务的依赖性:是否依赖其他系统资源,如数据库连接。 性质不同的任务可以用不同规模的线程池分开处理。CPU密集型任务应配置尽可能少的线程,如配置Ncpu+1个线程的线程池。由于IO密集型任务线程并不是一直在执行任务,则应配置多一点线程,如2*Ncpu。混合型的任务,如果可以拆分,将其拆分成一个CPU密集型任务和一个IO密集型任务,只要这两个任务执行的时间相差不是太大,那么分解后执行的吞吐量将高于串行执行的吞吐量。如果这两个任务执行时间相差太大,则没必要进行分解。可以通过Runtime.getRuntime().availableProcessors()方法获得当前设备的CPU个数。 优先级不同的任务可以使用优先级队列PriorityBlockingQueue来处理。它可以让优先级高的任务先执行。执行时间不同的任务可以交给不同规模的线程池来处理,或者可以使用优先级队列,让执行时间短的任务先执行。依赖数据库连接池的任务,因为线程提交SQL后需要等待数据库返回结果,等待的时间越长,则CPU空闲时间就越长,那么线程数应该设置得越大,这样才能更好地利用CPU。 线程池中线程数量未达到coreSize时,这些线程处于什么状态? 这些线程处于RUNNING或者WAITING,RUNNING表示线程处于运行当中,WAITING表示线程阻塞等待在阻塞队列上。当一个task submit给线程池时,如果当前线程池线程数量还未达到coreSize时,会创建线程执行task,否则将任务提交给阻塞队列,然后触发线程执行。(从submit内部调用的代码也可以看出来) ScheduledThreadPoolExecutor ScheduledThreadPoolExecutor继承自ThreadPoolExecutor。它主要用来在给定的延迟之后运行任务,或者定期执行任务。ScheduledThreadPoolExecutor的功能与Timer类似,但ScheduledThreadPoolExecutor功能更强大、更灵活。Timer对应的是单个后台线程,而ScheduledThreadPoolExecutor可以在构造函数中指定多个对应的后台线程数。 ScheduledThreadPoolExecutor继承自ThreadPoolExecutor,ScheduledThreadPoolExecutor和ThreadPoolExecutor的区别是,ThreadPoolExecutor获取任务时是从BlockingQueue中获取的,而ScheduledThreadPoolExecutor是从DelayedWorkQueue中获取的(注意,DelayedWorkQueue是BlockingQueue的实现类)。 ScheduledThreadPoolExecutor把待调度的任务(ScheduledFutureTask)放到一个DelayQueue中,其中ScheduledFutureTask主要包含3个成员变量: sequenceNumber:任务被添加到ScheduledThreadPoolExecutor中的序号; time:任务将要被执行的具体时间; period:任务执行的间隔周期。 ScheduledThreadPoolExecutor会把待执行的任务放到工作队列DelayQueue中,DelayQueue封装了一个PriorityQueue,PriorityQueue会对队列中的ScheduledFutureTask进行排序,具体的排序比较算法实现如下: ScheduledFutureTask在DelayQueue中被保存在一个PriorityQueue(基于数组实现的优先队列,类似于堆排序中的优先队列)中,在往数组中添加/移除元素时,会调用siftDown/siftUp来进行元素的重排序,保证元素的优先级顺序。 staticclassDelayedWorkQueueextendsAbstractQueue<Runnable>implementsBlockingQueue<Runnable>{privatestaticfinalintINITIAL_CAPACITY=16;privateRunnableScheduledFuture<?>[]queue=newRunnableScheduledFuture<?>[INITIAL_CAPACITY];privatefinalReentrantLocklock=newReentrantLock();privateintsize=0;privateThreadleader=null;privatefinalConditionavailable=lock.newCondition();} 从DelayQueue获取任务的主要逻辑就在take()方法中,首选获取lock,然后获取queue[0],如果为null则await等待任务的来临,如果非null查看任务是否到期,是的话就执行该任务,否则再次await等待。这里有一个leader变量,用来表示当前进行awaitNanos等待的线程,如果leader非null,表示已经有其他线程在进行awaitNanos等待,自己await等待,否则自己进行awaitNanos等待。 //DelayedWorkQueuepublicRunnableScheduledFuture<?>take()throwsInterruptedException{finalReentrantLocklock=this.lock;lock.lockInterruptibly();try{for(;;){RunnableScheduledFuture<?>first=queue[0];if(first==null)available.await();else{longdelay=first.getDelay(NANOSECONDS);if(delay<=0)returnfinishPoll(first);first=null;//don'tretainrefwhilewaitingif(leader!=null)available.await();else{ThreadthisThread=Thread.currentThread();leader=thisThread;try{available.awaitNanos(delay);}finally{if(leader==thisThread)leader=null;}}}}}finally{if(leader==null&&queue[0]!=null)available.signal();lock.unlock();}} 获取到任务之后,就会执行task的run()方法了,即ScheduledFutureTask.run(): publicvoidrun(){booleanperiodic=isPeriodic();if(!canRunInCurrentRunState(periodic))cancel(false);elseif(!periodic)ScheduledFutureTask.super.run();elseif(ScheduledFutureTask.super.runAndReset()){setNextRunTime();reExecutePeriodic(outerTask);}} 推荐阅读 JMM Java内存模型 happens-before那些事儿 为什么说LockSupport是Java并发的基石? FutureTask 原理剖析 你的ThreadLocal线程安全么 欢迎小伙伴 关注【TopCoder】 阅读更多精彩好文。 本文分享自微信公众号 - TopCoder(gh_12e4a74a5c9c)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册